【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
242、【AI】【模型部署】基座模型研究:注意力机制深入
背景
上篇 blog
把损失这一族概念理清了:信息量 − log p -\log p −logp 按真实分布加权平均得到熵 H ( P ) H(P) H(P),交叉熵 H ( P , Q ) = H ( P ) + K L ( P ∥ Q ) H(P,Q)=H(P)+\mathrm{KL}(P\|Q) H(P,Q)=H(P)+KL(P∥Q),其中 H ( P ) H(P) H(P) 与模型无关,所以最小化交叉熵 ⇔ 最小化 KL;真实标签 one-hot 时交叉熵退化为负对数似然,而从最大似然连乘、取负对数也走到同一个目标。
到这里,损失、logits、softmax、反向都讲完了,但模型内部最核心的部件注意力 一直被一笔带过------第 238 篇只说"Block = 归一化 + 注意力 + 前馈",第 240 篇只提到"softmax 也用在注意力里"。本篇把它展开:查询、键、值到底是什么,为什么要除以 d \sqrt{d} d ,因果掩码在遮什么,多头与 GQA 又省了什么。
模型部署
注意力(Attention)是 Transformer 的心脏。它的核心思想只有一句话:让每个位置,按"相似度"从其他位置收集信息。 本篇顺这条主线,把从 q / k / v q/k/v q/k/v 到加权求和的每一步讲清,并解释那些"看起来没道理、其实都有原因"的设计------缩放、掩码、多头、位置编码。
🧩 注意力要解决什么
一句话:每个位置都要从序列里的其他位置"取信息",而"取多少"由相似度决定。
最朴素的做法是取平均,但那意味着"所有位置同等重要",显然不合理。注意力做的改进是:加权平均------与当前词越相关的位置,权重越大;越不相关的,权重越小。至于"相关"怎么算,交给模型自己学。
举两个例子:在"小明把书递给小红,因为她要复习"里,理解"她"指向谁,就需要把"她"与前文每个词分别比对;写代码时,某个变量该取哪一行的定义,也靠这种相似度检索。这类"当前词该向谁取信息"的问题,正是注意力要回答的。
🧩 查询、键、值:一次带权检索
把注意力想成一次带权检索 :手里拿一个**查询(Query, q q q)去和每个位置的 键(Key, k k k)比对,比得越像,就从对应的 值(Value, v v v)**里取得越多:
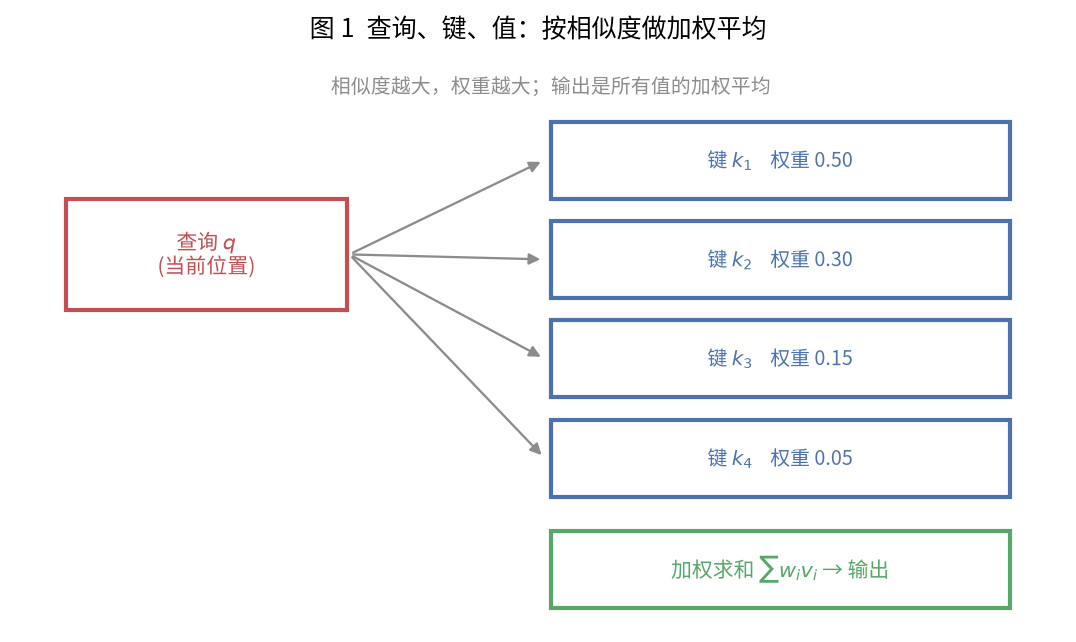
图 1 里,查询与四个键的相似度决定了四个权重( 0.50 / 0.30 / 0.15 / 0.05 0.50/0.30/0.15/0.05 0.50/0.30/0.15/0.05,和为 1),最终输出就是四个值按这些权重的加权和。一个经典类比是图书馆检索:查询是"要找什么",键是"每本书的标签",值是"书的内容"------先用查询匹配标签,再按匹配度把内容汇总。
要注意:q q q、 k k k、 v v v 都不是原向量,而是原向量经三个线性层投影得到的,投影矩阵是要训练的。
🧩 为什么是三个投影
为什么不直接拿输入向量当 q / k / v q/k/v q/k/v,而要各自过一次线性层?因为"用什么特征去检索 ""用什么特征被检索 ""提取什么内容"本来就是三件不同的事:同一句话在不同任务里,需要的检索角度、提取角度都不一样。三个独立的投影矩阵让模型分别学习这三种角色,灵活性远高于三者共用一套表示------这也是注意力能学到丰富关系的前提。
📊 一次注意力的完整流程
把上面的直觉写成计算步骤:
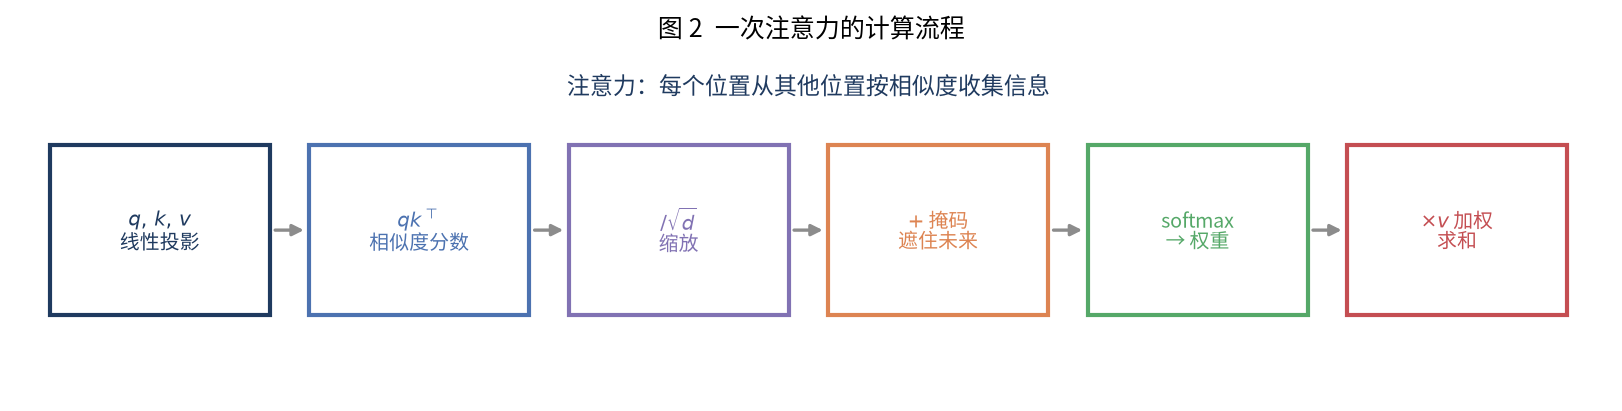
图 2 是整条链:线性投影得到 q , k , v q,k,v q,k,v → 用 q k ⊤ q k^{\top} qk⊤ 算相似度分数 → 除以 d \sqrt{d} d 缩放 → 加掩码遮住不该看的位置 → softmax 变成权重 → 用权重对 v v v 加权求和。 对应的代码(model.py 的 Attention.forward)核心就几行:
python
att = (q @ k.transpose(2, 3)) / math.sqrt(self.head_dim)  # 相似度 / 缩放
att = att.masked_fill(~mask, float("-inf"))               # 因果掩码
att = F.softmax(att, dim=-1)                              # 归一化成权重
out = (att @ v)                                           # 加权求和
用一个极小的例子走一遍:设某个 q q q 与三个 k k k 的相似度分数是 3 , 1 , 0 3,\\,1,\\,0 3,1,0,softmax 后约得权重 0.84 , 0.11 , 0.05 0.84,\\,0.11,\\,0.05 0.84,0.11,0.05;再用这三个权重对三个 v v v 加权求和,就得到该位置的输出。整个注意力层对每个位置做的,就是这么一次"看别人、取信息"的操作。
顺带把涉及到的张量形状过一次( H H H 为头数、 d h = d / H d_h=d/H dh=d/H):
| 步骤 | 形状 | 作用 |
|---|---|---|
| 投影 | ( B , H , S , d h ) (B,H,S,d_h) (B,H,S,dh) | 得到多头的 q / k / v q/k/v q/k/v |
| 相似度 q k ⊤ q k^{\top} qk⊤ | ( B , H , S , S ) (B,H,S,S) (B,H,S,S) | 两两位置比对 |
| softmax | ( B , H , S , S ) (B,H,S,S) (B,H,S,S) | 变成权重 |
| 加权 ( att ) v (\text{att})v (att)v | ( B , H , S , d h ) (B,H,S,d_h) (B,H,S,dh) | 收集信息 |
| 拼接 | ( B , S , d ) (B,S,d) (B,S,d) | 融合多头 |
注意力的"临时账本"正是那个 ( B , H , S , S ) (B,H,S,S) (B,H,S,S) 矩阵------它随 S S S 平方增长,是显存的大头,后面讲 KV cache 也绕不开它。
🧩 为什么要除以 d \sqrt{d} d
这是最容易被当成"魔法数字"的一步。原因是量级 : q q q 和 k k k 的点积是对 d d d 个数相乘再求和,若各分量近似独立、方差为 1,则点积的方差约为 d d d,标准差约为 d \sqrt{d} d ------维度越高,点积越大。
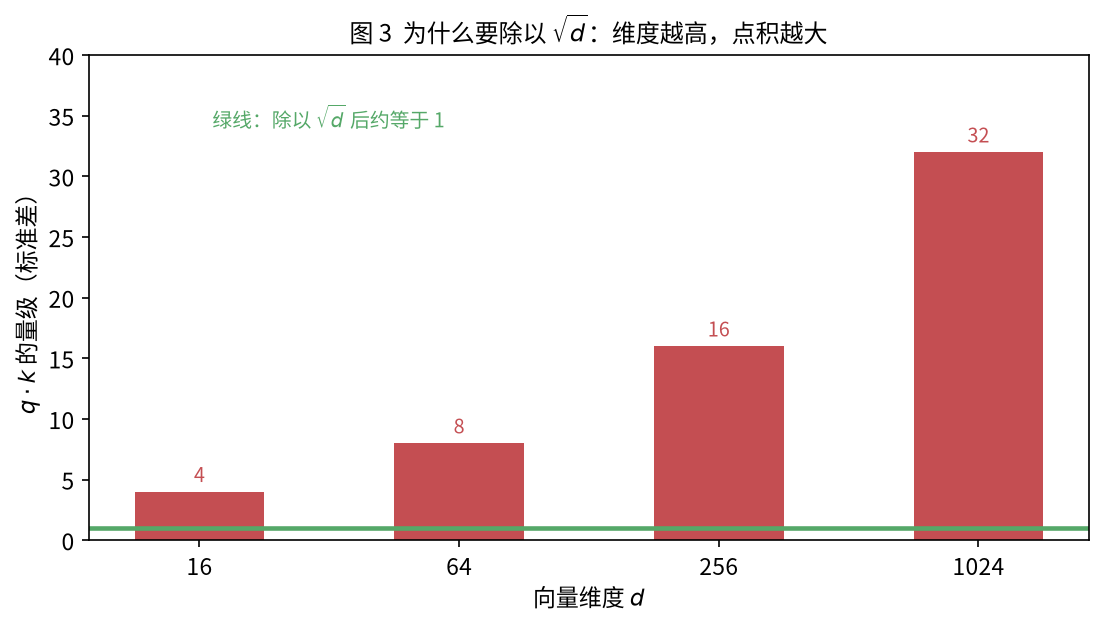
图 3 画出这个增长: d = 1024 d=1024 d=1024 时点积的量级可达 32 32 32。分数一大,softmax 就会被"推到饱和"------最大的那个占尽几乎全部权重、其余接近 0,于是梯度消失、学不动。除以 d \sqrt{d} d 把量级拉回约 1,让 softmax 处在"能平滑分配权重"的工作区间。它不是可调超参,而是按方差推导出的固定常数。
这里可以和第 240 篇的温度对照着看:温度是在 softmax 前对 logits 除以 T T T,同样在调"送进 softmax 的分数尺度";区别在于温度是推理时人为可调的旋钮,而 d \sqrt{d} d 是训练时固定、用于稳定的常数。
🧩 因果掩码:不许看未来
语言模型是自回归的:预测第 t t t 个 token 时,只能看到它之前 的内容,不能偷看后面。做法是把"未来位置"的相似度分数在 softmax 之前 设成 − ∞ -\infty −∞,softmax 之后它们的权重就变成 0:
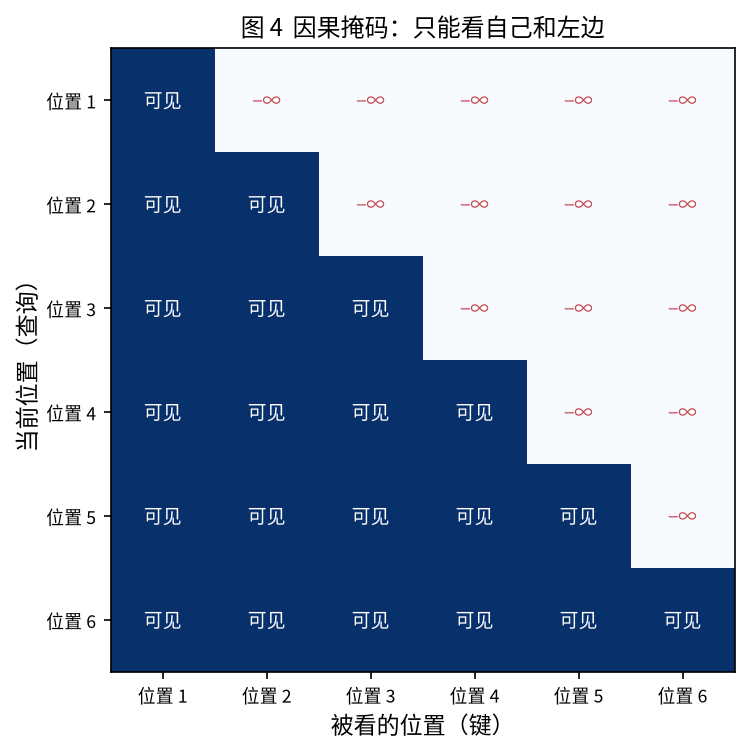
图 4 是掩码矩阵(下三角可见、上三角全遮)。注意必须在 softmax 之前遮:若先 softmax 再置零,权重和就不再是 1,等于破坏了"加权平均"。对角线也保留(每个位置能看自己),所以是"看自己和左边"。
🧩 多头与 GQA:把注意力做多份
多头注意力(Multi-Head Attention,MHA) 的思路是:一组 q / k / v q/k/v q/k/v 只能捕捉一种"相似度",那就并行做多组------每个头负责一种关系(有的头可能看语法、有的看指代),最后把各头输出拼接、再经一个输出投影融合。这让模型能同时关注多种模式,表达力显著增强。
代价是显存:推理时需要缓存每个头的 k k k 和 v v v(第 243 篇要讲),头越多缓存越大。分组查询注意力(Grouped-Query Attention,GQA) 的对策是:查询头保持多个,键值头只留少数几组,让多个查询头共享同一组 k / v k/v k/v:
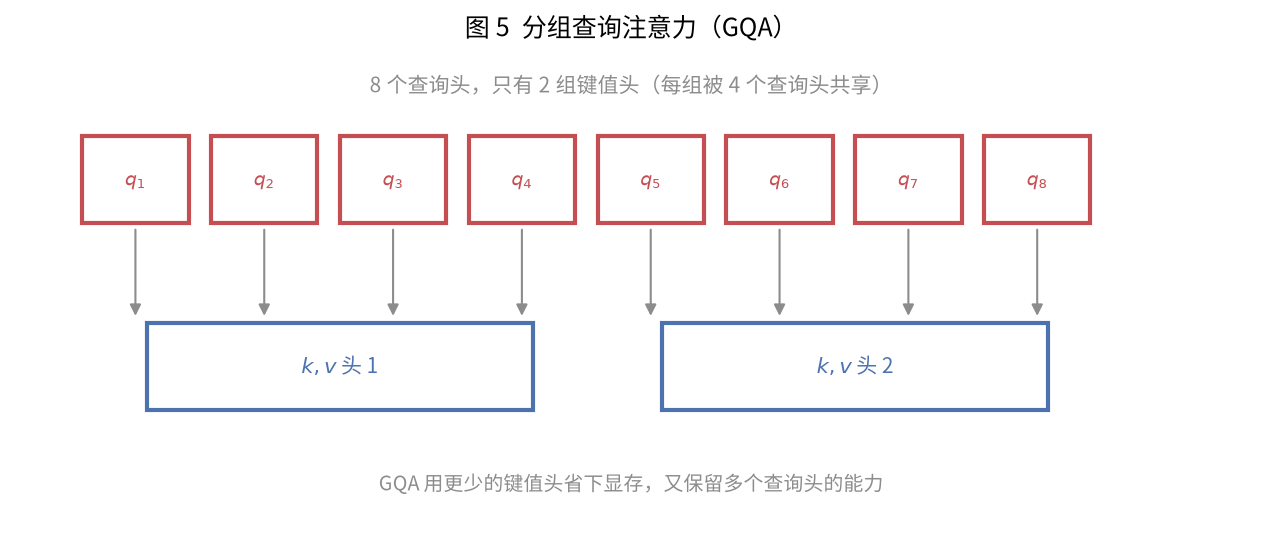
图 5 里 8 个查询头只对应 2 组键值头(每组被 4 个查询头共享),既省下 k / v k/v k/v 缓存,又基本保留多头的表达力------这也是 Qwen2 等模型普遍采用的折中(第 228 篇展开过)。
🧩 自注意力与交叉注意力
上面讲的 q / k / v q/k/v q/k/v 都取自同一段序列,这叫自注意力(self-attention) ------"在自己内部互相看"。若查询来自一端、键值来自另一端(如解码器看编码器、或模型看外部检索结果),就是交叉注意力(cross-attention)。语言模型(解码器架构)的主体是自注意力,这也是"上下文里的 token 互相交换信息"的实现方式。
🧩 位置从哪来:RoPE
注意力本身只算相似度、不看顺序 ------如果打乱 token 顺序,结果不变。所以必须把位置信息注入 进去。旋转位置编码(Rotary Position Embedding,RoPE)的做法是:按位置给 q q q、 k k k 的每一对分量做旋转,让"相对位置"体现在点积里(第 227 篇展开)。这样注意力在算相似度时,就天然带上了"谁在前、谁在后"。
🧩 拼回一个 Block
把这些部件装回第 238 篇的 Block,前向顺序是:
python
x = x + self.attn(self.input_layernorm(x), cos, sin)          # 注意力子层
x = x + self.mlp(self.post_attention_layernorm(x)) # 前馈子层每个子层都是"归一化 → 子层 → 残差相加 ":归一化(RMSNorm)稳定数值,残差连接让梯度能顺畅回传。注意力负责"在位置之间 交换信息",前馈网络负责"在每个位置内部做变换"------一横一纵,构成了 Transformer 的基本单元。
📊 注意力的代价:随长度平方增长
最后提一句工程账:相似度矩阵是 S × S S\times S S×S 的( S S S 是序列长度),所以注意力的计算量与显存都随 S S S 平方增长------序列翻倍、开销变四倍。这正是"长上下文"昂贵、以及各种高效注意力方案被不断提出的根本原因。理解这一点,第 243 篇讲的 KV cache 才显得顺理成章。
🧩 三个常见误区
- 注意力不是"把整段记住" :它是一次加权平均 ,输出维度与单个 v v v 相同,并不会把上下文"存进"输出;
- 掩码必须在 softmax 之前加:否则权重不再归一化,"加权平均"就失真了;
- d \sqrt{d} d 不是玄学超参:它是把点积方差拉回 1 的固定常数,目的是避免 softmax 饱和。
📌 一句话记忆
注意力让每个位置按相似度从其他位置收集信息:用线性投影得到查询 q q q、键 k k k、值 v v v,以 q k ⊤ q k^{\top} qk⊤ 算相似度,除以 d \sqrt{d} d 把量级拉回 1(否则 softmax 饱和、梯度消失),加因果掩码遮住未来(且必须在 softmax 之前),softmax 得到权重后对 v v v 加权求和;多头并行捕捉多种关系,GQA 用共享的键值头省显存,RoPE 以旋转注入位置;它的开销随序列长度平方增长,最后与归一化、残差、前馈一起拼成 Block。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!更多内容见下篇 blog