大宗商品销采运储系统・六层架构连载(基础服务篇)
前面两篇我们完成报表服务基础架构、元数据、查询引擎、缓存权限的落地。传统报表服务已经可以稳定支撑销采运储绝大多数统计查询需求。
当前很多企业都在探索 AI 在报表场景的集成落地,但必须先明确一个前提:
AI 不是报表服务的必选项,不是架构升级的必经之路,更不存在"不引入 AI 就不能运行"的强制要求。
AI 是在原有稳定报表底座之上,做能力增强的可选方案。
一句话定边界:
报表底座负责稳、准、可控;AI 负责降低门槛、提升效率、辅助发现。AI 故障,报表必须还能正常用。
一、先定边界:哪些能做,哪些不要做
适合 AI 增强的场景
-
自然语言查询:业务人员输入"查一下上个月华东仓螺纹钢库存",自动转成报表查询条件;
-
指标异常检测:自动识别库存突增、销量暴跌、运费异常,输出告警和简单归因;
-
报表辅助生成:根据业务描述,辅助生成报表元数据、查询脚本草稿,人工审核后发布;
-
报表内容智能解读:对报表结果做文字总结,帮助业务快速看懂数据。
不建议交给 AI 的场景
-
直接让大模型生成 SQL 并执行;
-
让 AI 绕过报表权限直接查数据;
-
让 AI 直接写业务库、改单据、删数据;
-
让 AI 替代数仓 ETL 和复杂统计;
-
让 AI 在没有校验的情况下决定指标口径。
核心原则:
AI 只生成"查询意图"和"参数草稿",不直接生成可执行 SQL。最终 SQL 仍由报表查询引擎根据元数据、权限、参数化规则生成。
二、AI 集成架构:插件化,不侵入主链路
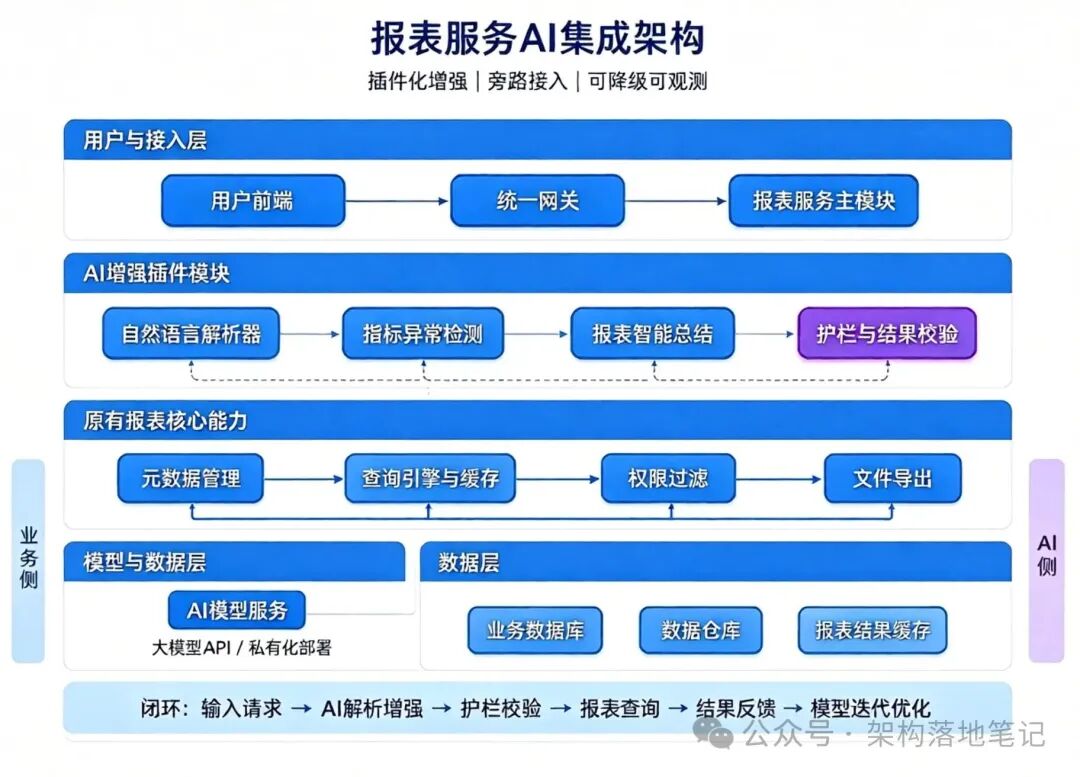
结合上图,核心落地要求如下:
-
业务侧与AI侧严格隔离:AI 插件在旁路,不直接触碰底层数据库。
-
护栏与结果校验是必经之路:AI 解析出的结果,必须经过紫框的校验,才能进入原有报表核心能力。
-
原有报表核心能力是底座:即使 AI 侧链路(紫框以上)全部断开,原有的元数据、查询引擎、权限过滤和文件导出依然能独立工作。
-
数据层闭环:底部的模型迭代优化闭环,意味着 AI 效果不是一次性配置,而是通过结果反馈持续运营的。
三、落地优先级:先底座,后增强
如果你们正在建设报表服务,建议按这个顺序推进:
| 优先级 | 能力 | 说明 |
|---|---|---|
| P0 | 传统报表底座 | 元数据、查询引擎、缓存、权限、慢查询治理 |
| P1 | 自然语言转查询参数 | 只读、参数化、不直接生成 SQL |
| P2 | 指标异常检测 | 规则/统计模型优先,LLM 做解释 |
| P3 | 报表智能总结 | 对脱敏后的结果做文字总结 |
| P4 | 报表辅助生成 | 生成元数据草稿,人工审核发布 |
不要一上来就做"AI 自动生成 SQL 并执行",这是高风险路径。
四、核心场景一:自然语言转报表查询
1. 正确链路
用户自然语言 → 意图识别:查哪张报表 → 参数抽取:时间、仓库、客户、物料、指标 → 生成 ReportQueryDSL → 护栏校验 → 报表查询引擎根据元数据生成参数化 SQL → 注入行级权限 → 执行查询 → 返回结果
不要让模型直接输出:
select * from orders where ...而是输出:
{
  "reportCode": "INV_MONTHLY_SUMMARY",
  "params": {
    "startDate": "2026-01-01",
    "endDate": "2026-01-31",
    "warehouseId": "WH001"
  },
  "dimensions": ["warehouse", "material"],
  "metrics": ["qty", "amount"],
  "sort": [{"field": "amount", "order": "desc"}],
  "limit": 1000
}
然后由查询引擎根据 reportCode 找到元数据,生成参数化 SQL,并自动追加行级权限条件。
2. Prompt 模板示例
你是大宗商品销采运储报表查询参数解析器。你只能输出 JSON,不能输出 SQL,不能输出解释。可用报表:- INV_MONTHLY_SUMMARY:月度进销存汇总,参数:startDate, endDate, warehouseId- SALE_DAILY_SUMMARY:当日成交汇总,参数:statDate, customerId维度字典:warehouse, material, customer, org指标字典:qty, amount, weight, fee用户问题:{userInput}请输出符合以下 JSON Schema 的结果:{schema}如果无法确定,请输出 {"error": "无法识别"}
3. Java 伪代码
@Component
public class ReportAiAssistPlugin {

    private final ReportMetaService reportMetaService;
    private final UserService userService;
    private final ModelClient modelClient;
    private final AiGuard aiGuard;
    private final ReportQueryEngine queryEngine;

    public AiQueryResp nl2Query(String userInput, Long reportId, Long userId) {
        ReportMeta meta = reportMetaService.getById(reportId);
        UserDataScope scope = userService.getUserDataScope(userId);

        String prompt = buildPrompt(userInput, meta, scope);
        String modelResult = modelClient.callModel(prompt);

        AiGuardResult guardResult = aiGuard.check(modelResult, meta, scope);
        if (!guardResult.pass()) {
            throw new BusinessException("AI生成查询条件存在风险:" + guardResult.reason());
        }

        ReportQueryDSL dsl = parseResult(modelResult);
        return queryEngine.queryByDsl(dsl, userId);
    }
}
4. 护栏必须做
输入护栏:
-
限制输入长度;
-
过滤注入类字符;
-
识别越权意图;
-
不允许"查所有客户""导出全表"等高风险表达。
输出护栏:
-
JSON Schema 校验;
-
报表编码必须在白名单;
-
参数必须在元数据定义范围内;
-
枚举值必须来自字典;
-
日期范围必须有限制;
-
禁止出现
delete、update、drop、insert、;、--等关键字; -
最大行数、最大时间跨度限制。
执行护栏:
-
只读账号;
-
参数化 SQL;
-
超时终止;
-
最大行数;
-
行级权限二次注入;
-
全量审计。
AI 不能成为权限绕过通道。AI 生成的查询,必须和普通报表查询走同一套权限、缓存、限流、审计链路。
五、核心场景二:指标异常检测
不要直接让大模型判断"有没有异常"。更稳的做法是:
规则/统计模型检测异常 → 输出异常指标、时间、维度、偏离程度 → LLM 基于异常结果做解释和归因建议 → 人工确认
常用检测方法
-
同比/环比;
-
3σ;
-
MAD 中位数绝对偏差;
-
EWMA 指数加权移动平均;
-
阈值规则;
-
季节性分解。
输出示例
{
  "anomaly": true,
  "level": "HIGH",
  "metric": "库存数量",
  "dimension": "华东仓 / 螺纹钢",
  "time": "2026-01",
  "currentValue": 125000,
  "expectedValue": 82000,
  "deviation": "+52.4%",
  "possibleReasons": [
    "采购集中入库",
    "销售出库减少",
    "跨仓调拨未及时出库"
  ],
  "suggestion": "建议核查采购入库单和调拨单"
}
LLM 只基于给定异常数据总结,不允许编造不存在的原因。原因最好从候选集中选择,或标记为"可能原因,需人工确认"。
六、核心场景三:报表辅助生成
AI 可以根据业务描述生成报表元数据草稿:
业务描述:我要一张月度进销存汇总,按仓库和物料统计数量、金额,支持按日期和仓库筛选。AI 输出:
{
  "reportCode": "INV_MONTHLY_SUMMARY_DRAFT",
  "name": "月度进销存汇总",
  "category": "仓储",
  "params": [
    {"name": "startDate", "type": "date", "required": true},
    {"name": "endDate", "type": "date", "required": true},
    {"name": "warehouseId", "type": "select", "required": false}
  ],
  "dimensions": ["warehouse", "material"],
  "metrics": ["qty", "amount"],
  "queryDraft": "select warehouse_id, material_id, sum(qty), sum(amount) from ..."
}
注意:
-
只生成草稿;
-
必须人工审核;
-
必须走元数据发布流程;
-
禁止 AI 直接上线报表;
-
禁止 AI 直接修改生产元数据。
七、核心场景四:报表智能总结
对报表结果做总结时,先脱敏,再送模型。
适合总结:
-
本月库存变化;
-
销售 Top10 客户;
-
异常波动说明;
-
同比环比变化;
-
区域/品类对比。
不适合:
-
包含成本价、毛利、供应商敏感信息未脱敏的数据;
-
超大数据集;
-
需要精确法律口径的财务结论。
建议:
LLM 总结只作为辅助阅读,不替代正式报表口径和财务确认。
八、模型选型与环境搭建
两种路线
| 维度 | 私有化部署开源模型 | 调用大模型 API |
|---|---|---|
| 数据安全 | 高,数据不出网 | 需脱敏,依赖厂商 |
| 成本 | 前期高,长期可控 | 按量付费,验证快 |
| 效果 | 取决于模型和调优 | 通常更强 |
| 运维 | 需要 GPU、推理服务 | 运维轻 |
| 适用阶段 | 生产、敏感数据 | 验证、非敏感场景 |
| 信创环境 | 适合 | 需评估合规 |
推荐路线:
-
测试验证阶段:API + 脱敏数据;
-
小流量阶段:私有化模型 + 灰度;
-
生产阶段:模型网关统一接入,支持多模型切换。
模型网关要统一
不要让业务代码直接调用某家模型 API。建议封装 ModelClient:
-
统一超时、重试、限流;
-
统一日志、审计、成本统计;
-
支持模型切换;
-
支持脱敏;
-
支持缓存常见问题;
-
支持降级。
九、评估与测试
测试集要提前准备
-
100~500 条真实业务自然语言问题;
-
覆盖采购、销售、仓储、运输;
-
覆盖模糊表达、错别字、多条件、时间范围;
-
构造异常样本和正常样本;
-
构造越权、注入、诱导性输入。
评估指标
| 指标 | 说明 |
|---|---|
| 意图识别准确率 | 是否找到正确报表 |
| 参数抽取 F1 | 时间、仓库、客户、物料是否抽对 |
| DSL 合法率 | 输出是否符合 Schema |
| 查询执行成功率 | 最终能否查到结果 |
| 异常召回率 | 异常是否被发现 |
| 异常误报率 | 正常是否被误判 |
| 人工采纳率 | 业务是否愿意用 |
| 平均耗时 | 端到端响应时间 |
| 单次成本 | Token 成本 |
测试通过标准建议
-
DSL 合法率 ≥ 99%;
-
查询执行成功率 ≥ 95%;
-
越权拦截率 100%;
-
异常召回率 ≥ 80%,误报率 ≤ 10%;
-
AI 故障降级成功率 100%。
十、灰度上线与风险控制
灰度阶段
-
阶段 0:AI 关闭,只保留传统报表;
-
阶段 1:内部研发、产品试用;
-
阶段 2:业务专家试用,收集问题;
-
阶段 3:小流量账号开放;
-
阶段 4:逐步放量,保留一键关闭开关。
风险控制
-
数据脱敏:客户、价格、供应商、成本等敏感字段脱敏;
-
权限隔离:AI 查询必须走用户权限;
-
只读限制:AI 只能生成查询,不能写数据;
-
护栏校验:输入、输出、执行三层护栏;
-
全量审计:记录输入、输出、耗时、用户、报表、是否命中护栏;
-
成本控制:Token 预算、缓存、小模型优先、异步执行;
-
降级方案:AI 超时/异常直接走传统报表。
十一、落地效果对比
| 能力项 | 传统报表 | AI 增强报表 |
|---|---|---|
| 查询方式 | 手动选维度、填条件 | 自然语言描述自动生成查询条件 |
| 异常发现 | 人工查看对比 | 自动识别指标异动,推送告警 |
| 报表配置 | 人工配置元数据、写 SQL | AI 辅助生成草稿,人工审核 |
| 数据解读 | 人工看表 | 自动生成文字总结 |
| 故障影响 | 报表正常使用 | AI 异常,原有报表完全可用 |
| 安全边界 | 权限、只读、审计 | 同样权限、只读、审计,外加 AI 护栏 |
十二、本篇小结
AI 对报表服务属于可选增强,核心思路是:
插件化集成,和原有报表主链路解耦;做好安全护栏、灰度发布、数据脱敏;优先在测试环境验证准确率,再逐步放量上线。
落地记住三句话:
-
AI 不直接生成 SQL,只生成查询 DSL 和参数草稿;
-
AI 不绕过权限,必须走报表查询引擎;
-
AI 故障不影响报表,传统能力始终可用。
报表服务三篇连载到此完成。
下篇预告:报表服务之后,我们将进入基础服务的收尾模块,继续完整走完大宗商品销采运储六层架构的基础服务拆解