文章目录
-
- [一、从 C 字符数组出发](#一、从 C 字符数组出发)
-
- [1.1 C 字符串的麻烦之处](#1.1 C 字符串的麻烦之处)
- [1.2 `string`是对象,不是一个换名字的 `char` 指针](#1.2
string是对象,不是一个换名字的char指针)
- 二、创建和输入:先得到一段可靠的文本
-
- [2.1 构造的区别,首先看"输入是什么"](#2.1 构造的区别,首先看“输入是什么”)
- [2.2 复制与赋值怎样对应类和对象](#2.2 复制与赋值怎样对应类和对象)
- [2.3 判断是输入一个单词,还是完整的一行](#2.3 判断是输入一个单词,还是完整的一行)
- 三、访问和遍历:分清字符、下标与迭代器
-
- [3.1 安全访问先看 size,而不是 capacity](#3.1 安全访问先看 size,而不是 capacity)
- [3.2 三种遍历方式](#3.2 三种遍历方式)
- [3.3 auto 类型](#3.3 auto 类型)
- [3.4 迭代器可以像指针使用,但不一定就是指针](#3.4 迭代器可以像指针使用,但不一定就是指针)
- [四、长度与容量:reserve 与 resize 的区分](#四、长度与容量:reserve 与 resize 的区分)
-
- [4.1 四个问题,四类接口](#4.1 四个问题,四类接口)
- [4.2 通过代码观察,把 reserve 和 resize 分开](#4.2 通过代码观察,把 reserve 和 resize 分开)
- 五、修改字符串:先想清楚位置和数量
-
- [5.1 追加一个字符,还是创建一个新结果](#5.1 追加一个字符,还是创建一个新结果)
- [5.2 一个可运行例子,观察每次修改之后的状态](#5.2 一个可运行例子,观察每次修改之后的状态)
- [5.3 字符串的插入、删除和替换,一定要准确理解参数](#5.3 字符串的插入、删除和替换,一定要准确理解参数)
- [5.4 修改之后,原位置还代表原字符吗](#5.4 修改之后,原位置还代表原字符吗)
- [5.5 给性能建立数量级认识,不必背实现参数](#5.5 给性能建立数量级认识,不必背实现参数)
- 六、查找、截取与比较:结果也有边界
-
- [6.1 find 返回位置,不是布尔值](#6.1 find 返回位置,不是布尔值)
- [6.2 起点和空模式,有明确的规则](#6.2 起点和空模式,有明确的规则)
- [6.3 substr 返回新对象,不修改原串](#6.3 substr 返回新对象,不修改原串)
- [6.4 比较的是字典序,不是整数大小或长度大小](#6.4 比较的是字典序,不是整数大小或长度大小)
- [6.5 数值转换是另一项任务,不是拼接的隐含动作](#6.5 数值转换是另一项任务,不是拼接的隐含动作)
- [七、与 C 接口衔接:拿到指针不等于拥有内存](#七、与 C 接口衔接:拿到指针不等于拥有内存)
-
- [7.1 `c_str` 返回的是借用,不是新分配的副本](#7.1
c_str返回的是借用,不是新分配的副本) - [7.2 指针有效期需要跟着对象和操作走](#7.2 指针有效期需要跟着对象和操作走)
- [7.1 `c_str` 返回的是借用,不是新分配的副本](#7.1
- 八、把接口串起来:读取一行配置
-
- [8.1 从需求倒推接口,而不是从接口拼凑需求](#8.1 从需求倒推接口,而不是从接口拼凑需求)
- [8.2 为什么不把所有不规整输入都叫作 `string` 的问题](#8.2 为什么不把所有不规整输入都叫作
string的问题)
下篇:
学会使用std::string类,并理解其内部是如何管理字符串的详细阐述(下)
代码仓库:《string类模拟实现》
一、从 C 字符数组出发
1.1 C 字符串的麻烦之处
学过 C 语言后,对下面这段代码应该很熟悉。:
c
char name[16] = "hello";
strcat(name, " C++"); //strcat:往目标字符串后追加字符串运行时,strcat 先找 name 的结尾零字符,再把新字符及末尾 \0 复制过去。这里成功的前提,是因为 16 个字节放得下 9 个文本字符和一个终止符。函数本身并不会自动把数组变大。
随着需求的变化,我们不得不反复地考虑一些问题:
- 空间够不够?
- 末尾有没有终止符?
- 长度是多少?
- 复制时谁负责申请和释放资源?
这个时候如果还是按照 C 语言的写法的话将会非常麻烦且易出错,所以,C++ 中出现的string就是专门为字符串而打造的类。
std::string 将一段字符序列及其相关操作封装为对象。对象维护长度,需要时调整存储,并在销毁时清理自己管理的资源。这就让我们能够更多地把注意力放在"处理什么文本"上,而不是每一步都手动安排空间。
但是,自动管理资源不等于所有操作都安全:错误下标、失效指针、没有判断的查找结果,仍然是我们在使用中需要多加注意的问题。
C 字符数组:内存固定大小,一切靠程序员自己手动保证正确性。
std::string:自动扩容自动释放,但下标、迭代器、find仍需要小心处理。
1.2 string是对象,不是一个换名字的 char 指针
使用string前包含 <string>头文件,这边建议不写 using namespace std;,因为后续增强理解时我们可以尝试自己实现一个简单完整的string,明确写出命名空间可以避免与自己实现的同名类混淆。
cpp
#include <string>

int main()
{
	std::string message("hello");
	return 0;
}
message 是一个类对象,离开作用域时对象自动析构,使用者不需要对它的内部存储手动 delete[]。
std::string 是标准库字符类型为 char 的字符串类型;它背后的模板名称是 std::basic_string<char>
此处知道两者关系即可,不需要先学习整个模板实现。
可以用"连续字符序列 + 已记录的长度 + 自动存储管理"理解它的行为。
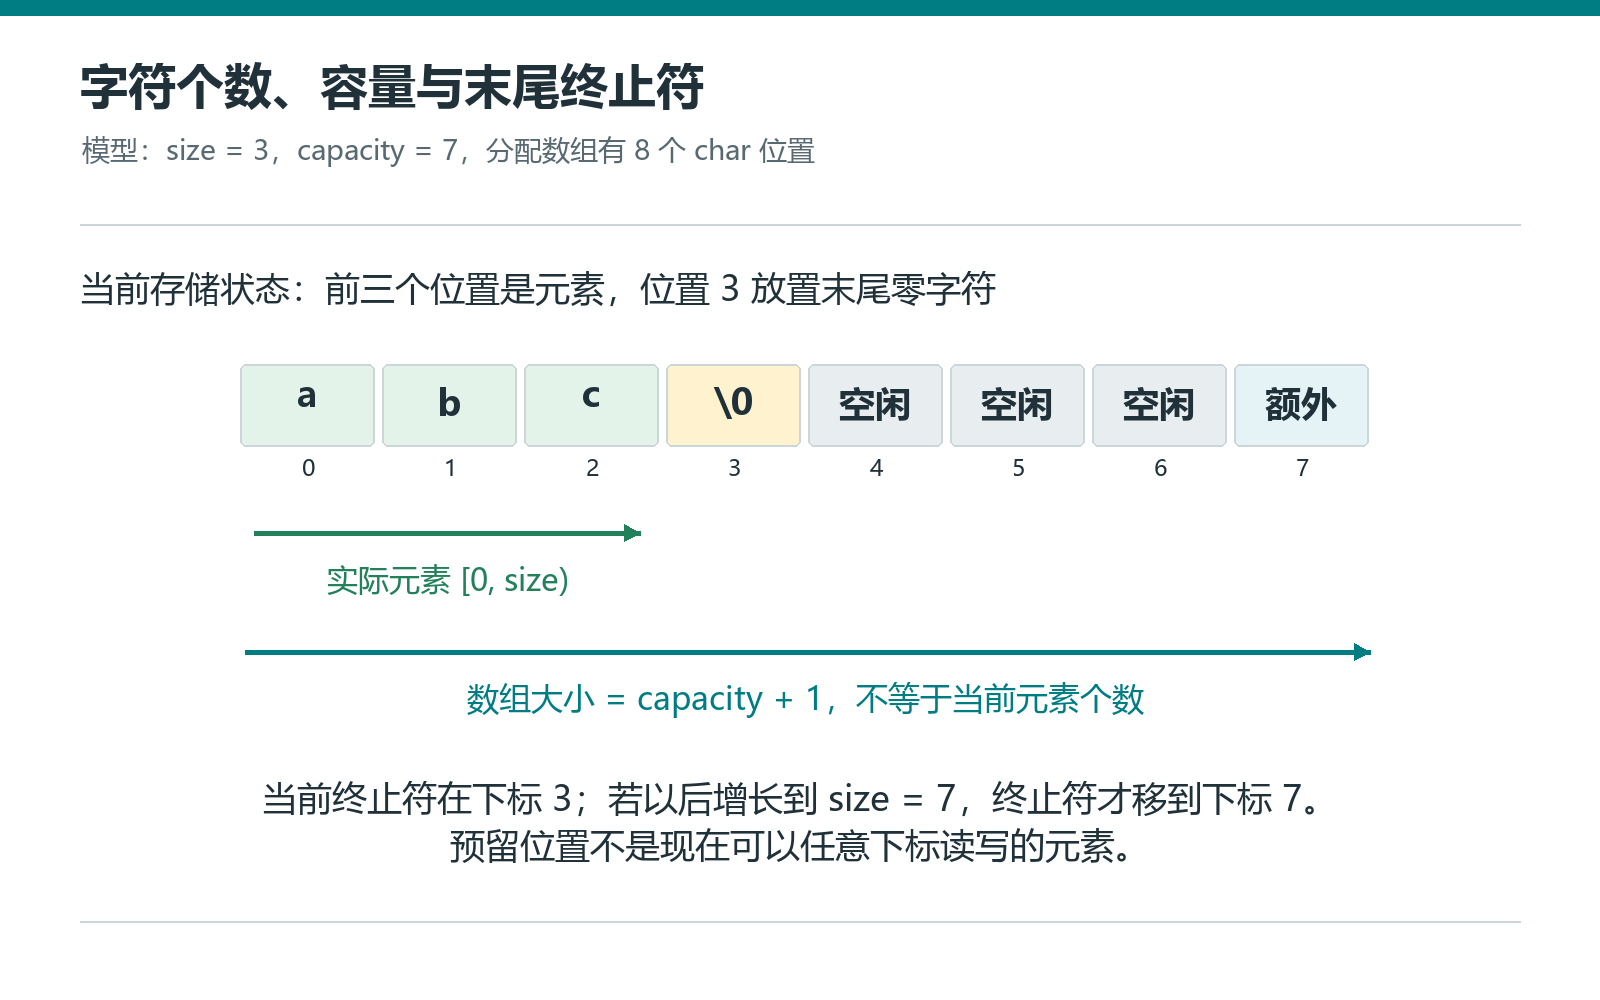
观察图中三个不同的范围:实际元素、预留空间、末尾终止符。其中预留空间不是可以随意下标写入的元素;末尾终止符也不计入 size()。
可以先把其底层当作是一个顺序表理解。
二、创建和输入:先得到一段可靠的文本
2.1 构造的区别,首先看"输入是什么"
string最常见的构造方式可以按需求来理解:
| 表达式 | 意图 | 需要注意 |
|---|---|---|
std::string s; |
创建空串 | size() == 0,不是空指针 |
std::string s("hello"); |
从 C 字符串复制 | 输入必须有效且以零字符结束 |
std::string s = "hello"; |
用文本初始化对象 | 是初始化,不是先默认构造再赋值 |
std::string b(a); 或 std::string b = a; |
从已有对象创建新对象 | 使用拷贝构造,两个对象可独立修改 |
std::string s(5, 'x'); |
创建五个字符 x |
参数顺序是数量、字符 |
std::string s(ptr, n); |
从指定位置复制恰好 n 个字符 | 指针后必须确实存在 n 个可读字符,不要求这 n 个字符包含终止符 |
std::string s(other, pos, count); |
从另一字符串的一部分构造 | pos 可以等于长度,不能大于长度 |
代码示例:
cpp
#include <iostream>
#include <string>

int main()
{
	//常用构造方式
	std::string empty;
	std::string a("hello");
	std::string b(a);
	std::string c;
	c = a;  //c是已存在的对象,使用赋值
	b[0] = 'H';  //可通过下标修改对应元素
	std::string repeated(5, 'x');
	const char data[] = { 'a', 'b', 'c', 'd' };
	std::string prefix(data, 3);
	std::string binary("a\0b", 3);

	//输出验证
	std::cout << empty.size() << ' ' << empty.empty() << std::endl;
	std::cout << a << ' ' << b << ' ' << c << std::endl;
	std::cout << repeated << ' ' << prefix << std::endl;
	std::cout << binary.size() << ' ' << (binary[1] == '\0') << std::endl;
}
运行结果(布尔值默认以 0/1 表示):
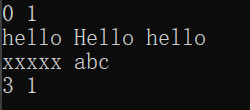
从运行的顺序拆开看:
text
b(a) 创建新对象 -> c=a 把内容赋给已经存在的对象 -> 修改 b[0] 只改变 b
所以第二行三个字符串并不完全一样。

data 没有结尾零字符,但我们明确指定读取三个元素,因此构造 prefix 合法;
如果改成 `std::string(data)`,就会越过数组继续寻找终止符,产生未定义行为。此外,"" 和 "\0" 作为 C 字符串都在第一个字符处结束,长度都是零;
后者只是字面量数组中还多了一个隐式终止符。它们都不等同于 nullptr。
2.2 复制与赋值怎样对应类和对象
std::string b = a; 虽然写了等号,但仍然是在定义新对象,会使用拷贝构造。判断是拷贝构造还是赋值,先问左侧对象是否已经存在,而不是只盯着符号。
常见赋值还有 s = "text"、s = 'x'、s.assign(3,'x')。
对于函数参数也有同样的思考方法:
cpp
void inspect(const std::string& text); // 只读,不为传参复制整个字符串
void change(std::string& text);        // 修改调用者的字符串
std::string makeText();               // 返回一个字符串值,调用者取得结果
传值参数也合法,适合函数明确需要一份独立副本的情况。
不要为了省一次复制而返回局部字符串的引用,局部对象销毁后它们会悬空,反而不安全。
2.3 判断是输入一个单词,还是完整的一行
std::cin >> s 是格式化输入:通常先跳过空白,遇到下一个空白停止。空白不只是普通空格,还包括制表符、换行等。当输入 hello world时,对象一次提取只得到 hello。
使用std::getline(std::cin,s) 默认读到换行符,保留行内空格,取走换行符但不把它放进结果。它是非成员函数,因此不能写成 s.getline()。
传第三个字符参数可以改变分隔符,如
std::getline(std::cin,s,',')。
| 场景 | 选择 |
|---|---|
| 读一个以空白分隔的单词 | std::cin >> s |
| 读可能有空格的一行 | std::getline(std::cin,s) |
| 持续读取直到输入结束 | 把读取操作放在 while 条件中 |
真正容易卡住的是"先读数字,再读一行"。提取数字后,行末换行往往还在输入缓冲区里,接下来的 getline 会立即读取这个换行,得到空串。
cpp
#include <iostream>
#include <limits>
#include <string>

int main()
{
    int count = 0;
    //读取数字直到负数结束
    if (!(std::cin >> count) || count < 0)
    {
        std::cout << "invalid count" << std::endl;
        return 1;
    }
    // 读到换行就停止,换行也一起忽略
    std::cin.ignore(std::numeric_limits<std::streamsize>::max(), '\n');

    //按行读取字符串
    for (int i = 0; i < count; ++i)
    {
        std::string line;
        if (!std::getline(std::cin, line))
        {
            std::cout << "missing line" << std::endl;
            return 1;
        }
        std::cout << line << std::endl;
    }
}
运行示例:
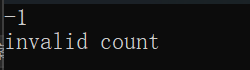
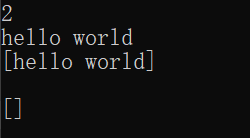
图2运行过程:
cin >> count读取2;缓冲区剩下\nignore(..., '\n')丢弃这个换行,缓冲区清空- for 循环 i=0:
getline读到hello world,遇到回车;line ="hello world",输出[hello world]
- for 循环 i=1:
getline直接遇到回车,line =""(空字符串),输出[]
循环结束,程序正常退出。
三、访问和遍历:分清字符、下标与迭代器
3.1 安全访问先看 size,而不是 capacity
对实际字符做处理时,下标范围是 [0,s.size())(左闭右开)。
s[i] 对非 const 对象返回字符引用,才能支持 s[i] = 'A'修改;const 对象则只能读取。
重载的方括号operator[] 不负责帮你检查一般越界,使用时仍需注意。
| 操作 | 前提 | 结果 |
|---|---|---|
s[i] |
处理实际元素时 i < size() |
读取或修改一个字符 |
s.front()、s.back() |
!s.empty() |
第一个、最后一个实际元素 |
s[s.size()] |
C++11 起可读取该位置 | 读到结尾零字符,不是一个实际元素 |
最后一行是 std::string 的特殊契约,不能推广到任意数组或容器。也不要向这个位置写入非零字符,也不要继续访问更大下标。实际有效的遍历仍然使用 < size(),而不是 <= size()。
空串不能调用 front/back,也不能计算 size()-1 后直接访问。长度类型通常是无符号整数,零减一会变成很大的数,而不是得到一个可用的负下标。
3.2 三种遍历方式
- 需要下标或者下标获取方便就用下标循环;
- 只关心每个字符就用范围
for; - 需要用库函数提供的位置表示,就使用迭代器。
cpp
#include <iostream>
#include <string>

int main()
{
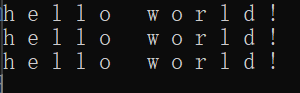
    std::string s1("hello world!");
    //三种遍历方式
    //范围for循环(加引用才能修改原字符串,不然只是原字符串元素的拷贝),适用于容器和数组
    for (char a : s1)
    {
        std::cout << a << ' ';
    }
    /*for (char& a : s1)
    {
        a += 2;
        std::cout << a << ' ';
    }*/
    std::cout << std::endl;

    //下标循环
    for (int i = 0; i < s1.size(); i++)
    {
        std::cout << s1[i] << ' ';
    }
    std::cout << std::endl;

    //迭代器(可以直接修改对应字符串内的值)
    std::string::iterator it = s1.begin();
    while (it != s1.end())
    {
        //*it += 1;
        std::cout << *it << ' ';
        ++it;
    }
    std::cout << std::endl;
    return 0;
}
运行示例:
3.3 auto 类型
auto 会在编译时根据初始化表达式推导类型。在这里最有价值的用法,是省去迭代器的长类型名,同时保留静态类型检查。
auto是从 C++11 开始具有的类型推导含义。
auto不能作为普通函数的参数,可以做返回值,但是建议谨慎使用
auto不能直接用来声明数组
cpp
auto it = s.begin();             // 推导迭代器类型
auto ch = s[0];                  // 字符副本;前提是 s 非空
auto& ref = s[0];                // 字符引用
auto literal = "abc";            // const char*,不是 std::string
auto text = std::string("abc");  // 才是 std::string
普通 auto 不会因为右侧是引用,就自动把新变量也变成引用。auto& 中的 & 是明确要求保留引用关系。定义普通 auto 变量需要初始化。
范围 for 中的三种写法必须区分:
| 写法 | 循环变量代表什么 | 修改它会不会改变原串 |
|---|---|---|
for(char ch:s) / for(auto ch:s) |
当前字符的副本 | 不会 |
for(char& ch:s) / for(auto& ch:s) |
当前字符的引用 | 会,要求原串可修改 |
for(const auto& ch:s) |
当前字符的只读引用 | 不允许修改 |
3.4 迭代器可以像指针使用,但不一定就是指针
现在可以先把迭代器理解为表示序列位置的工具:*it 访问当前位置,++it 前进,it != end() 判断是否还在有效遍历范围。
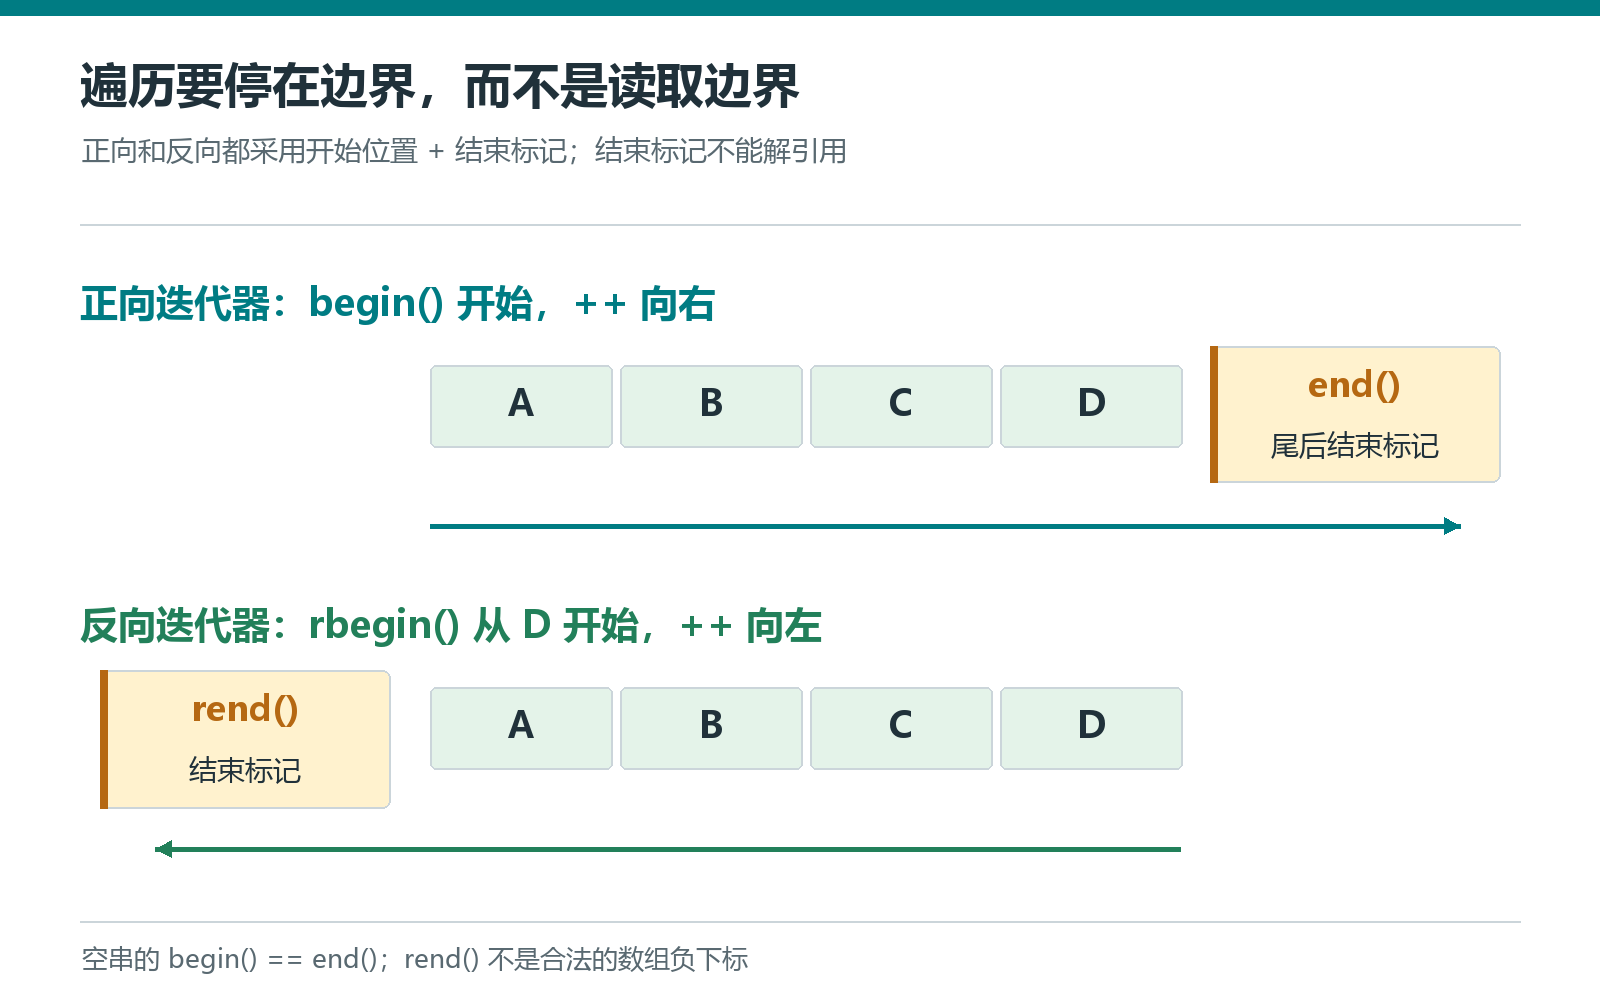
begin() 表示第一个元素,end() 表示尾后位置。空串满足 begin() == end()。end() 是结束标记,不能解引用。
反向遍历从 rbegin() 开始,每次 ++ 沿反方向推进,直到 rend()。rend() 也是结束标记,不是可以访问的"第负一个字符",不能把它画成真正合法的数组负下标。
| 需求 | 类型与接口 |
|---|---|
| 可修改的正向遍历 | iterator,begin/end |
| 只读的正向遍历 | const_iterator,const 对象的 begin/end,或 cbegin/cend |
| 可修改的反向遍历 | reverse_iterator,rbegin/rend |
| 只读的反向遍历 | const_reverse_iterator,const 对象的 rbegin/rend,或 crbegin/crend |
const_iterator 表示不能通过它修改字符;const iterator 表示迭代器变量本身不能被重新赋值或前进。它们不是同一概念,注意区分。
范围 for 的底层遍历机制可以用 begin() / end() 迭代器近似理解。
循环期间只修改字符值较容易推理,而插入、删除、扩容则可能使保存的迭代器失效,也会改变遍历边界。所以不要在范围
for中随意改变原串的长度。
四、长度与容量:reserve 与 resize 的区分
4.1 四个问题,四类接口
string设计中,size() 和 length() 都给出元素个数,含义相同。
capacity() 则表示当前能容纳多少个字符而不必为增长重新分配存储,不包含额外的末尾终止符,也不是系统实际分配字节的完整统计。
empty() 问的是元素个数是否为零,而不是指针是不是空。
| 目的 | 接口 | 长度变化 | 关键区别 |
|---|---|---|---|
| 查询长度 | size/length |
不变 | 中间的零字符也算元素 |
| 查询容量 | capacity |
不变 | 容量至少与长度一样大 |
| 判断空串 | empty |
不变 | 与 size() == 0 等价 |
| 清空内容 | clear |
变成零 | 不应当作强制释放存储的接口 |
| 预留空间 | reserve(n) |
不变 | 不是创建 n 个可下标访问的字符 |
| 改变元素个数 | resize(n,ch) |
变成 n | 增长时创建并填充新元素 |
4.2 通过代码观察,把 reserve 和 resize 分开
cpp
#include <cassert>
#include <iostream>
#include <string>

int main()
{
    //初始化字符串
    std::string s("abc");
    //预开辟空间
    s.reserve(100);
    assert(s.capacity() >= 100 && s.size() == 3);
    std::cout << s.size() << std::endl;
    //设置元素个数并初始化为指定字符
    s.resize(5, 'x');
    std::cout << s << ' ' << s.size() << std::endl;

    s.resize(1);
    std::cout << s << ' ' << s.size() << std::endl;

    s.resize(4);
    std::cout << s.size() << ' ' << (s[1] == '\0') << std::endl;

    s.clear();
    std::cout << s.size() << ' ' << s.empty() << std::endl;
}
运行示例:
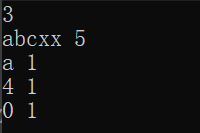
- 第一个
resize先预留空间,但仍然只有三个元素,随后再真正创建了两个新元素; - 第二个
resize把元素数量压缩到了 1 ,所以只有第一个元素a被保留; - 第三个
resize又重新预留至 4 个元素空间,但没有指定填充值,因此新增位置填入零字符;
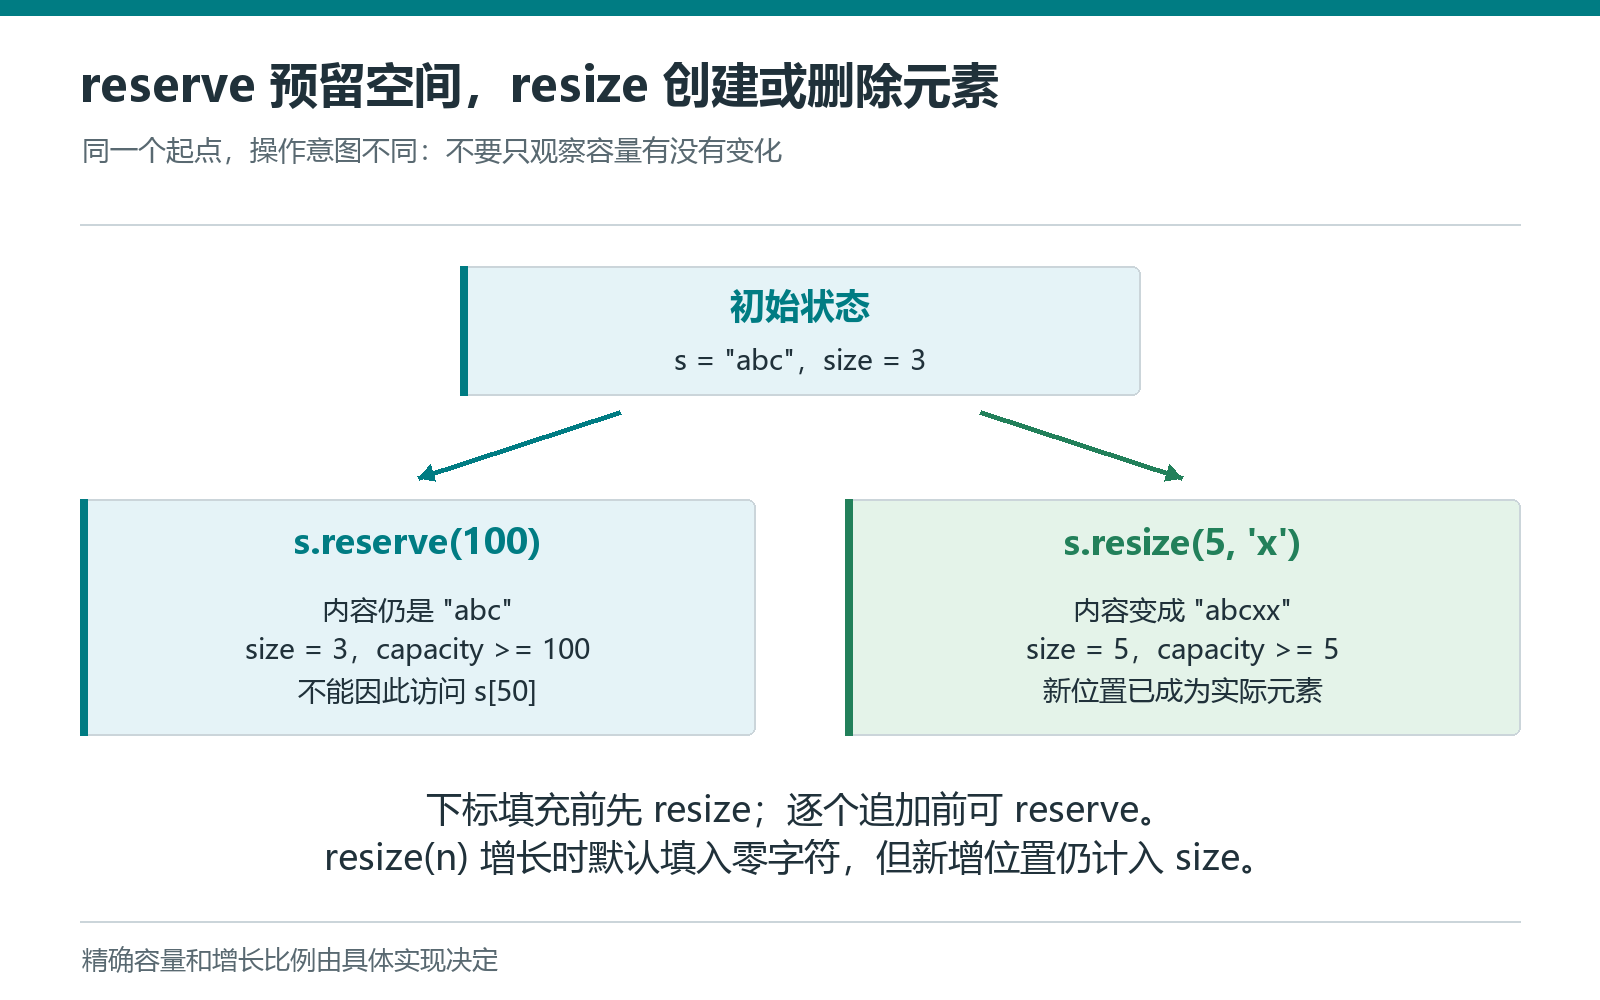
- 如果要用下标一次写出 n 个字符 ,先
resize(n); - 如果要不断追加字符而且知道最终大致长度 ,先
reserve(n)。
五、修改字符串:先想清楚位置和数量
5.1 追加一个字符,还是创建一个新结果
push_back(ch) 表达追加一个字符,append(text) 表达追加一段字符串,+= 对两种情况都很直观。
a + b 则构造拼接结果,不修改 a 和 b。
逐字符构建时写 result += ch 更符合意图,反复地 resul t= result + ch 常常会重复处理已有前缀,随着结果增长产生不必要的工作。
a = a + b:生成临时对象,再赋值给 a;a += b:直接原地追加,性能一般更好,少一次临时对象。
5.2 一个可运行例子,观察每次修改之后的状态
cpp
#include <iostream>
#include <string>

int main()
{
    //初始化为"hello"
    std::string s("hello");
    //追加空格' '
    s.push_back(' '); //hello
    //追加"C"
    s.append("C");  //hello C
    //追加后续字符及字符串
    s += "++";  //hello C++
    s += '!';   //hello C++!
    std::cout << s << std::endl;

    //在0下标处插入指定元素
    s.insert(0, "[ ");  //[ hello C++!
    //删除下标0开始, 长度为2的元素
    s.erase(0, 2);  //hello C++!
    //使用指定字符串代替下标0开始,长度为5的元素
    s.replace(0, 5, "C++");  //C++ C++!
    //删除一个尾部元素
    s.pop_back();  //C++ C++
    //追加字符
    s += '?';   //C++ C++?
    std::cout << s << std::endl;

    std::string doubled("abc");
    doubled += doubled;
    std::cout << doubled << std::endl;
    std::string a("abc"), b("def");
    const std::string result = a + " " + b;
    std::cout << result << std::endl;
}
运行示例:
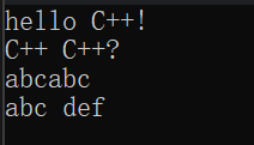
执行过程:
- 初始五个字符,追加后形成
hello C++!。 insert(0,"[ ")在原第零个字符之前插入两个字符,形成[ hello C++!;- 紧接着的
erase(0,2)恰好删掉它们,此时字符串为hello C++!。 replace(0,5,"C++")删除开头五个字符,再用三个字符替换,所以字符串变短,此时字符串为C++ C++!。- 最后删除感叹号并追加问号
C++ C++?。
doubled += doubled 是标准库支持的自追加情形,结果是两份原内容。
两个字符串字面量不能直接相加得到字符串对象,例如
"abc"+"def"不是合法拼接。表达式中应有std::string对象,比如std::string("abc")+"def"。
"abc" + 1也不是拼数字,它表示指针移动,const char*向后偏移 1,得到"bc";
s += 1也不是追加文本数字"1",而是会把数字当成 ASCII 字符,追加一个转换后的字符值。
5.3 字符串的插入、删除和替换,一定要准确理解参数
常用的是以位置和数量表示范围的重载:
| 操作 | 解释 | 位置边界 |
|---|---|---|
s.insert(pos, str) |
在 pos 前插入字符串 |
pos <= size(),等于长度表示尾插 |
s.insert(pos, n, ch) |
在 pos 前插入 n 个 ch |
同上,数量不是结束下标 |
s.erase(pos, count) |
从 pos 开始删除至多 count 个字符 |
pos <= size();等于长度时无元素可删 |
s.erase(pos) |
删除 pos 到末尾(有缺省值) | 不能把它理解为只删除一个字符 |
s.replace(pos,count,str) |
把指定范围替换为 str |
替换前后长度可以不同 |
s.pop_back() |
删除最后一个字符 | 要求非空 |
s.swap(other) |
交换两串的内容 | 不是复制一串到另一串 |
对于这些重载,合法位置之后没有足够多字符时,删除或替换范围会截到末尾,而不是越界读取。count == 0 在 erase 中不删除,在 replace 中相当于插入。
删除首尾字符时,还会见到 s.erase(s.begin()) 和 s.erase(--s.end()),它们使用的是另一组迭代器重载。删除一个元素时要求迭代器指向实际元素,不能传 end();
理解重载时,先辨认参数类型,再判断范围含义。
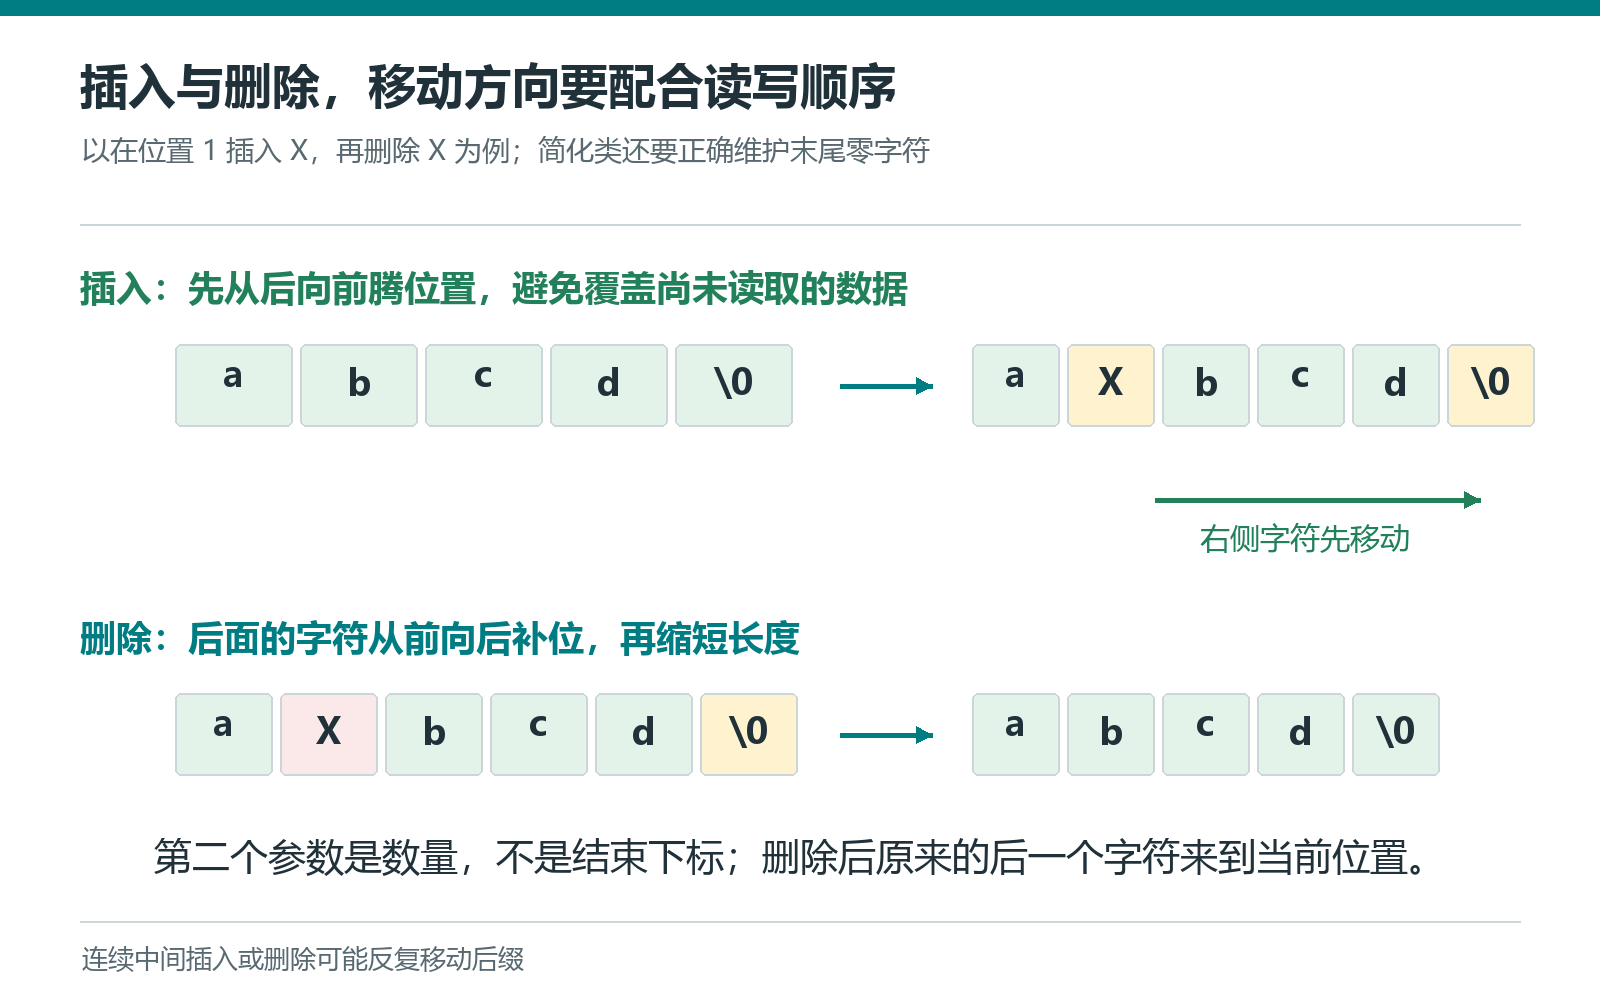
插入时,后面的字符需要腾位置;删除时,后面的字符向前补位。
5.4 修改之后,原位置还代表原字符吗
下标本身只是一个整数,不会像指针一样悬空,但它代表的字符可能已经变化。例如删除 s[0],原本的 s[1] 就来到位置零。如果循环仍然无条件 ++i,就跳过了刚补到这里的字符。
发生插入、删除、替换、容量调整等操作后,需要继续访问就重新从对象取得位置或指针,并重新判断边界。
如果使用迭代器删除,erase(it) 返回删除位置之后的下一个有效迭代器。应使用这个返回值继续循环,而不是继续递增已经失效的 it。
5.5 给性能建立数量级认识,不必背实现参数
-
查询已记录的长度、读取一个下标通常是常数时间。
-
尾部增长在不扩容时只需处理新增字符;
-
扩容需要搬运已有内容。几何式增长能把多次单字符追加的总搬运量控制在合理范围,常见实现的尾部追加具有均摊常数成本。
-
中间插入或删除常需移动后缀,处理的字符越多,工作量越大;
-
substr产生独立结果,需要复制选出的字符。 -
反复头插 n 个字符,可能累计移动约
1+2+...+n个字符。
六、查找、截取与比较:结果也有边界
6.1 find 返回位置,不是布尔值
找到时 find 返回匹配开始的下标,找不到时返回 std::string::npos。位置零完全可能是成功结果,因此不能写 if(s.find("abc")) 判断找到:它会把位置零当成假,还可能把没找到当成真。
代码示例:
cpp
#include <iostream>
#include <string>

int main()
{
    //初始化只读字符串
    const std::string line("name = Alice Smith");
    //查找'='位置并接受下标
    const size_t pos = line.find('=');
    //打印左右部分内容
    if (pos != std::string::npos)
    {
        std::cout << line.substr(0, pos) << " | " << line.substr(pos + 1) << std::endl;
    }


    const std::string repeated("aba aba");
    //输出正向查找与反向查找的下标
    std::cout << repeated.find("aba") << ' ' << repeated.rfind("aba") << std::endl;
    //输出查找'?'的结果
    std::cout << (line.find('?') == std::string::npos) << std::endl;

    const std::string path("dir/file.txt");
    //反向查找第一个'/'
    const auto slash = path.rfind('/');
    const auto start = slash == std::string::npos ? 0 : slash + 1;
    std::cout << path.substr(start) << std::endl;
    //输出字符串比较结果
    std::cout << (std::string("10") < std::string("2")) << std::endl;
}
运行示例:
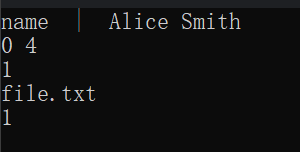
执行过程:
- 第一行,等号下标为 4。
substr(0,4)拿到前四个字符,substr(5)拿到后续全部字符。 - 第二行同一文本出现两次,正向得到位置零,反向得到位置四。
- 第三行显式判断没找到问号。
- 第四行输出反向找到
'/'后面的内容。 - 第五行比较字符串,
"10"首字'1'比"2"小,返回1。
find("aba"):正向查找,返回第一个匹配下标;找不到返回std::string::nposrfind("aba"):反向查找,返回子串最后一次出现的起始下标,不是子串末尾位置
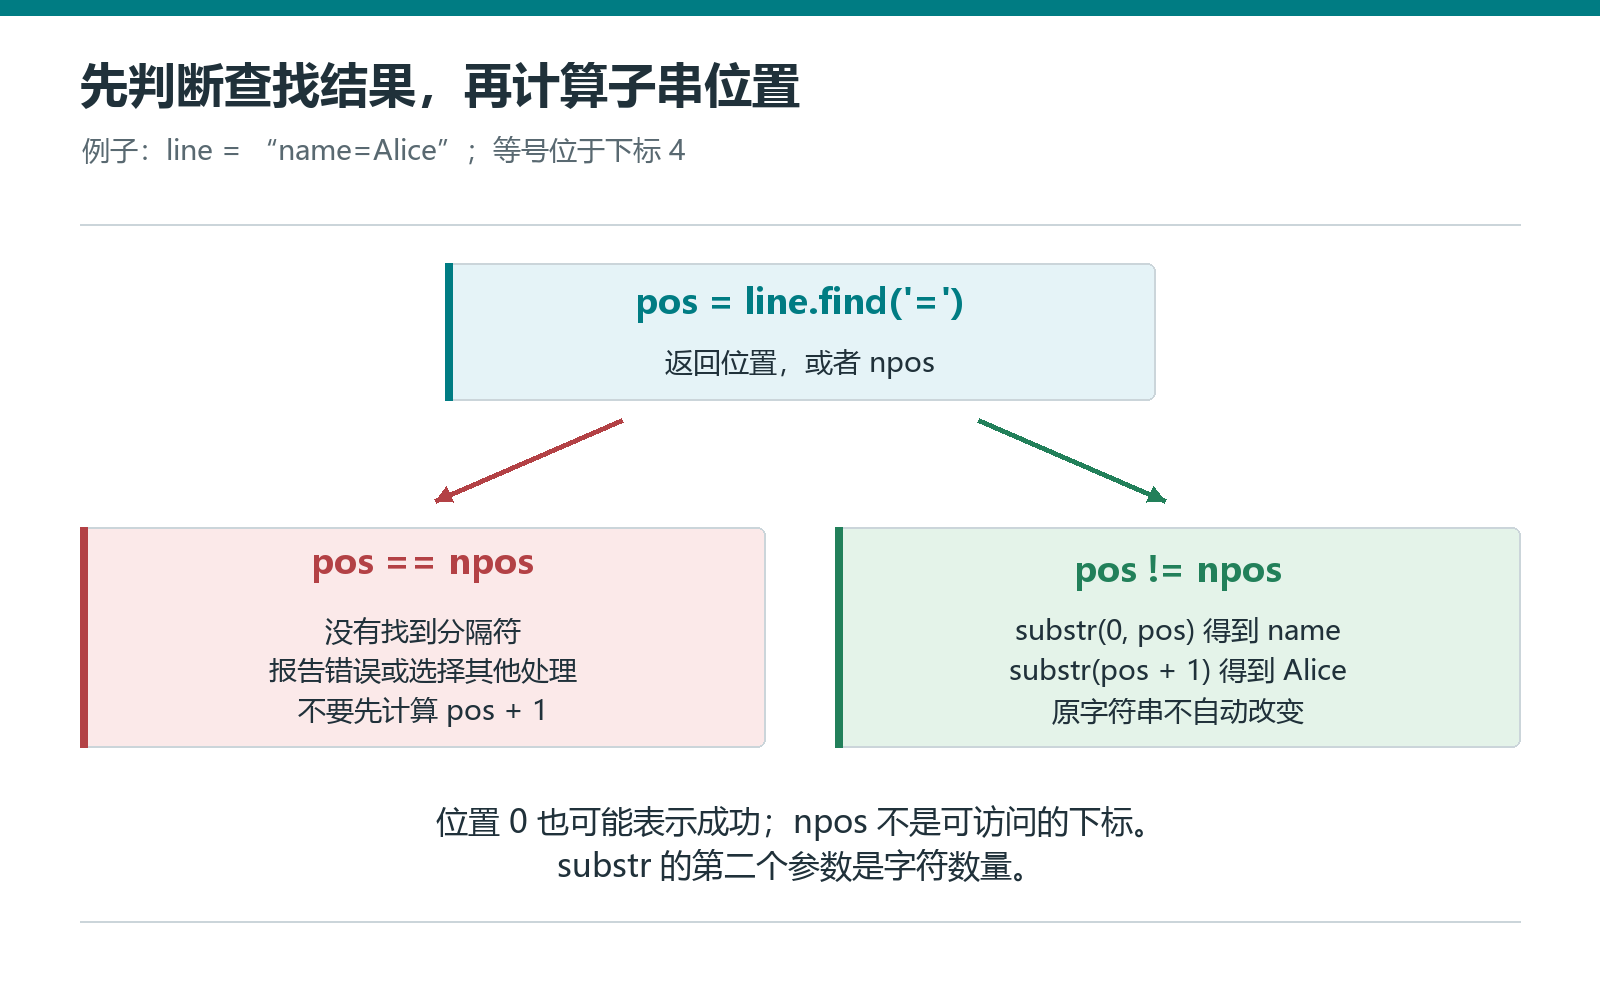
npos是长度类型的最大值形式的特殊标记,不是一个可用于访问的下标,也不应先转成int去跟-1比较。最直接的写法是保留返回类型,并与std::string::npos比较。
6.2 起点和空模式,有明确的规则
s.find(text,pos) 从 pos 开始向后找,但返回的仍是相对整条字符串的下标,不是相对 pos 的偏移。s.rfind(text,pos) 从不晚于 pos 的候选开始位置向前寻找;默认从能够匹配的最靠右位置开始。搜索方向变了,字符串下标方向没有变。
| 操作 | 含义或边界 |
|---|---|
s.find('x',s.size()) |
找不到实际字符,返回 npos |
s.find("",pos) |
pos <= size() 时返回 pos;空模式能在合法边界匹配 |
s.find(text,pos),pos > size() |
返回 npos,而不是把非法位置用于访问 |
s.rfind("aba") |
找到最靠右的一次,仍返回正向下标 |
另外有 find_first_of、find_last_of:查找字符集合中任意一个字符,而不是寻找整段子串。
例如 find_first_of(" ,;") 找三个分隔符中最先出现的一个。find_first_not_of、find_last_not_of 寻找不属于字符集合的位置,适合做简单的首尾空白定位;它们同样需要判断 npos。
6.3 substr 返回新对象,不修改原串
s.substr(pos,count) 的第二个参数是数量,不是结束下标。省略 count 表示直到末尾;数量超过剩余长度会截到末尾。
表达式,假设 s 为 "abcde" |
结果 |
|---|---|
s.substr(1,3) |
"bcd" |
s.substr(2) |
"cde" |
s.substr(5) |
空串,合法 |
s.substr(6) |
报告越界 |
s.substr(0,0) |
空串 |
新字符串有自己的值。修改子串并不会修改原串。
6.4 比较的是字典序,不是整数大小或长度大小
==、!=、<、>、<=、>= 对 std::string 比较内容。字典序从前向后比较字符,首次不同决定大小;若共同前缀相同,则较短的一串在前。
因此 "10" 和 "2" 构造成字符串后,前者更小,不是因为数字十小于二,而是第一个字符 '1' 在 '2' 之前。"abc" < "abcd" 为真,"b" < "aaa" 为假;长度短不意味着字典序小。
compare() 用负数、零、正数表达小于、等于、大于,但是不要假设它只能返回 -1/0/1。
字符指针之间的 == 默认比较地址,不能替代 string 的内容比较。
6.5 数值转换是另一项任务,不是拼接的隐含动作
从 C++11 开始,std::to_string(123) 可以产生文本 "123",std::stoi(text) 可以解析为 int。
但 stoi 使用时可能报告"无法转换"或"超出 int 范围",而且默认可以只解析前面的合法数字部分;
例如 "12abc" 不会自动被认定为整段无效。
七、与 C 接口衔接:拿到指针不等于拥有内存
7.1 c_str 返回的是借用,不是新分配的副本
当 C 风格接口需要 const char*,可以调用 s.c_str()。它返回指向对象内部、以零字符结尾的字符存储的只读指针。
这个调用不会把存储的所有权交给你,不需要也不能对返回值 delete[] 或 free。
cpp
#include <cstring>
#include <iostream>
#include <string>

int main()
{
    //初始化字符串
    std::string s("hello");
    //返回C接口字符串
    const char* borrowed = s.c_str();
    //输出观察
    std::cout << borrowed << ' ' << s << std::endl;

    char* owned = new char[s.size() + 1];
    std::memcpy(owned, s.c_str(), s.size() + 1);
    delete[] owned;

    const std::string binary("a\0b", 3);
    std::cout << binary.size() << ' ' << std::strlen(binary.c_str()) << std::endl;
    //定义中文字符串
    const std::string chinese("中文");
    std::cout << (chinese.size() == 6) << std::endl;
}
运行示例:
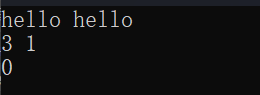
- 第一行借用指针和直接输出字符串都显示
hello。 owned则是真正由我们申请的另一块数组,复制长度是元素个数加一个末尾终止符,所以配对delete[]的是owned。
new char[s.size() + 1]如果误写成 new char[s.size() - 1] 后调用复制函数,问题不是少显示了两个字符,而是目标空间根本不足,写入会越界。
这里使用
memcpy按已知长度复制,能保留内部零字符;如果换成strcpy,只会复制到第一个零字符为止。所以不要把strcpy当成一般string值的完整复制方式。
7.2 指针有效期需要跟着对象和操作走
保存 const char* p = s.c_str() 后,字符串销毁,p 就失效;字符串发生可能重分配的修改后,p 也可能失效。
一个尤其隐蔽的错误是:
cpp
// 错误示例:不要执行后续的解引用
const char* p = std::string("hello").c_str();
// 这一行结束,临时 string (匿名对象)已销毁,p 成为悬空指针。std::string("hello")是临时匿名对象 ,这行语句执行完毕,临时对象立刻销毁。
p拿着已经释放的内存地址,后续解引用属于未定义行为,程序可能崩溃、乱码。
正确思路是先把结果保存在一个具名 std::string 中,再在它的有效期内借用指针。若把指针传给外部函数,还要知道那个函数是立即读取,还是把指针保存到以后再用。
八、把接口串起来:读取一行配置
8.1 从需求倒推接口,而不是从接口拼凑需求
假设每行文本形如 name=Alice Smith。规则是:第一个等号分开键和值;键不能为空;值可以为空,可以包含空格,也可以包含后续等号。空行忽略,不自动清理首尾空格。对于 enabled=yes,把值规范化成 true。
这个需求自然导出三个动作:getline 保留行内空格;find 定位第一个等号;substr 取得两段独立字符串。判断输入是否合法,应发生在下标计算之前。
cpp
#include <iostream>
#include <string>

int main()
{
    std::string line;
    while (std::getline(std::cin, line))
    {
        if (line.empty())
            continue;
        //找到串中'='位置
        const auto pos = line.find('=');
        //没找到则输出错误信息
        if (pos == std::string::npos)
        {
            std::cout << "invalid: missing =\n";
            continue;
        }
        //若在开头也输出错误信息
        if (pos == 0)
        {
            std::cout << "invalid: empty key\n";
            continue;
        }
        //分割'='前后子串
        const std::string key = line.substr(0, pos);
        std::string value = line.substr(pos + 1);

        if (key == "enabled" && value == "yes")
            value = "true";
        std::cout << key << " -> " << value << std::endl;
    }
}
运行示例:
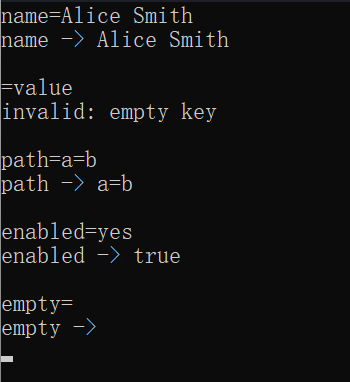
最后一行的值为空,箭头后没有内容。substr(size()) 合法,恰好体现了允许空值的规则。
value = "true" 修改的是新对象,不会把 line 中的原内容自动改成另一段文本。
8.2 为什么不把所有不规整输入都叫作 string 的问题
如果想允许键两侧空格,需要自己定义并实施修剪规则;如果值允许转义等号,需要进一步设计语法。string 提供存储和操作,不负责决定配置格式应该怎样解释。
把输入规则先写下来,再选择接口,能够避免代码在正常例子上输出正确,却在空行、多个分隔符、找不到分隔符时没有一致行为。
到这里,已经可以把 std::string 当作日常工具使用。接下来,我们将会在下一篇的阐述中继续理解string的模拟实现,这不是为了使用字符串之前必须先写一个标准库,而是为了把前面"自动管理"四个字落到具体机制上。
继续下篇: