从连续轨迹到动作 Token:读懂 π0.5 中的 FAST Tokenizer
FAST 的全称是 Frequency-space Action Sequence Tokenization 。
目的:把一段连续的机器人动作轨迹压缩成离散 token,使视觉-语言模型能够像预测文字一样预测动作。
为什么要变成离散 token? 因为VLM就是prefix token 预测下一句话,前人有很多相关经验。所以把动作输出VLA变成类似预测文字一样预测动作能更快,准确输出。
1. FAST 要解决什么问题?
VLA(Vision-Language-Action)模型接收图像和语言指令,并输出机器人动作。为了复用大语言模型成熟的"预测下一个 token"训练范式,一种自然做法是把连续动作离散化。
早期方法通常逐时刻、逐维度分桶。例如,长度为 H H H、动作维数为 D D D 的动作块
A = a 1 , a 2 , ... , a H , a t ∈ R D A = a_1,a_2,\\ldots,a_H, \qquad a_t\in\mathbb{R}^D A=a1,a2,...,aH,at∈RD
会被转换成 H × D H\times D H×D 个 token。若双臂机器人有 14 个动作维度,以 50 Hz 预测未来 1 秒,模型一次就要自回归预测
50 × 14 = 700 50\times 14=700 50×14=700
个动作 token。
这不只是"序列太长"的问题。机器人轨迹通常很平滑,控制频率越高,相邻动作越相似。于是模型只要复制上一个 token,往往就能得到很低的 next-token loss。换句话说,每个新 token 所携带的边际信息量越来越小:
- 训练信号弱,收敛慢;
- 模型容易学成"重复上一动作",而不是理解完整轨迹;
- token 数随控制频率线性增长,训练和自回归推理都很昂贵;
- 高速、灵巧操作尤其难学。
FAST 论文中的实验很直观:同样是 1 秒动作,逐时刻分桶在 BridgeV2(7 维、5 Hz)需要 35 个 token,在 14 维、50 Hz 的衬衫折叠任务中则需要 700 个;FAST 分别只需约 20 和 53 个,后者压缩了约 13.2 倍。
因此,FAST 的核心目标不是单纯把连续数值"变成整数",而是:
把高频轨迹中大量重复、低信息的时域采样,变成更短、信息密度更高的频域 token 序列。
2. FAST 如何解决?
FAST 把动作序列当作多维时间信号,流水线可以概括为:
text
动作块
  -> 分位数归一化
  -> 逐动作维度做 DCT (类似傅里叶变换,核心)
  -> 缩放并取整
  -> 按频率优先展平
  -> BPE 压缩
  -> 动作 token
2.1 分位数归一化
对每个动作维度,使用训练集的第 1 和第 99 百分位数,将数值大致映射到 − 1 , 1 -1,1 −1,1,并裁剪超出范围的值:
a ~ = 2 ⋅ clip ( a , q 0.01 , q 0.99 ) − q 0.01 q 0.99 − q 0.01 − 1 \tilde a = 2\cdot \frac{\operatorname{clip}(a,q_{0.01},q_{0.99})-q_{0.01}} {q_{0.99}-q_{0.01}}-1 a~=2⋅q0.99−q0.01clip(a,q0.01,q0.99)−q0.01−1
相比使用最小值和最大值,分位数对偶发异常值更稳健;统一尺度也方便混合不同机器人、不同控制空间的数据。
2.2 用 DCT 从时域转到频域
FAST 对每个动作维度沿时间轴做离散余弦变换(DCT):
C k , d = DCT ( A ~ : , d ) C_{k,d}=\operatorname{DCT}(\tilde A_{:,d}) Ck,d=DCT(A~:,d)
低频系数描述轨迹的整体位置和缓慢变化,高频系数描述快速抖动或突变。真实机器人动作通常是平滑的,因此能量集中在少量低频系数中,许多高频系数接近零。
这里的思想类似 JPEG:不要逐点记录一个平滑信号,而是记录"它由哪些频率成分组成"。
2.3 缩放、取整,让系数变稀疏
对 DCT 系数乘以尺度 γ \gamma γ 后取整:
C ˉ k , d = round ( γ C k , d ) \bar C_{k,d}=\operatorname{round}(\gamma C_{k,d}) Cˉk,d=round(γCk,d)
较小的系数变成 0,矩阵因而非常稀疏。 γ \gamma γ 控制重建精度与压缩率的权衡:
- γ \gamma γ 较大:保留更多细节,误差更小,但 token 更多;
- γ \gamma γ 较小:压缩更强,但会丢失更多动作细节。
FAST 论文的单数据集实验使用 γ = 10 \gamma=10 γ=10、BPE 词表大小 1024。它们是论文设置,不是所有机器人都必须照搬的常数。
需要注意:DCT 可以逆变换,BPE 也可以无损解码,但取整会产生量化误差,所以完整 FAST 流程是有损压缩。
2.4 频率优先展平
量化矩阵的形状是 H × D H\times D H×D。FAST 不按"先放完关节 1 的所有频率"排列,而是按频率优先:
text
[所有维度的 0 频系数,
 所有维度的 1 频系数,
 所有维度的 2 频系数, ...]
这样,自回归模型首先预测决定轨迹整体形状的低频信息,再补充高频细节。论文发现这种顺序能让策略 rollout 更稳定。
2.5 用 BPE 合并常见模式(相邻token合并)
展平后的整数序列仍包含大量 0 和重复局部模式。FAST 再训练一个 BPE(Byte-Pair Encoding)词表,反复把常见的相邻符号组合成一个新 token。
BPE 在这里不理解词义,只负责压缩。例如,训练数据中如果 [0, 0] 和 [12, 0, 0] 经常出现,它们可以被合并成单个词表项。最终得到长度可变、词表大小固定的动作 token 序列,可以直接并入 VLM 的离散词表。
FAST 的 DCT 部分不需要学习;需要从数据中学习的只有 BPE 词表。FAST+ 则是在约 100 万段、每段 1 秒的跨机器人动作块上训练出的通用词表,可直接用于多种机器人和控制频率。
eg:我->10, 们->20 ,我们要两个token表示,但是实际时候我 们,通常一起出现,所以直接合并为 我们->23
DCT 系数的选择与噪声对 FAST 的影响
详细见:Ilia 的 π0.5 视频
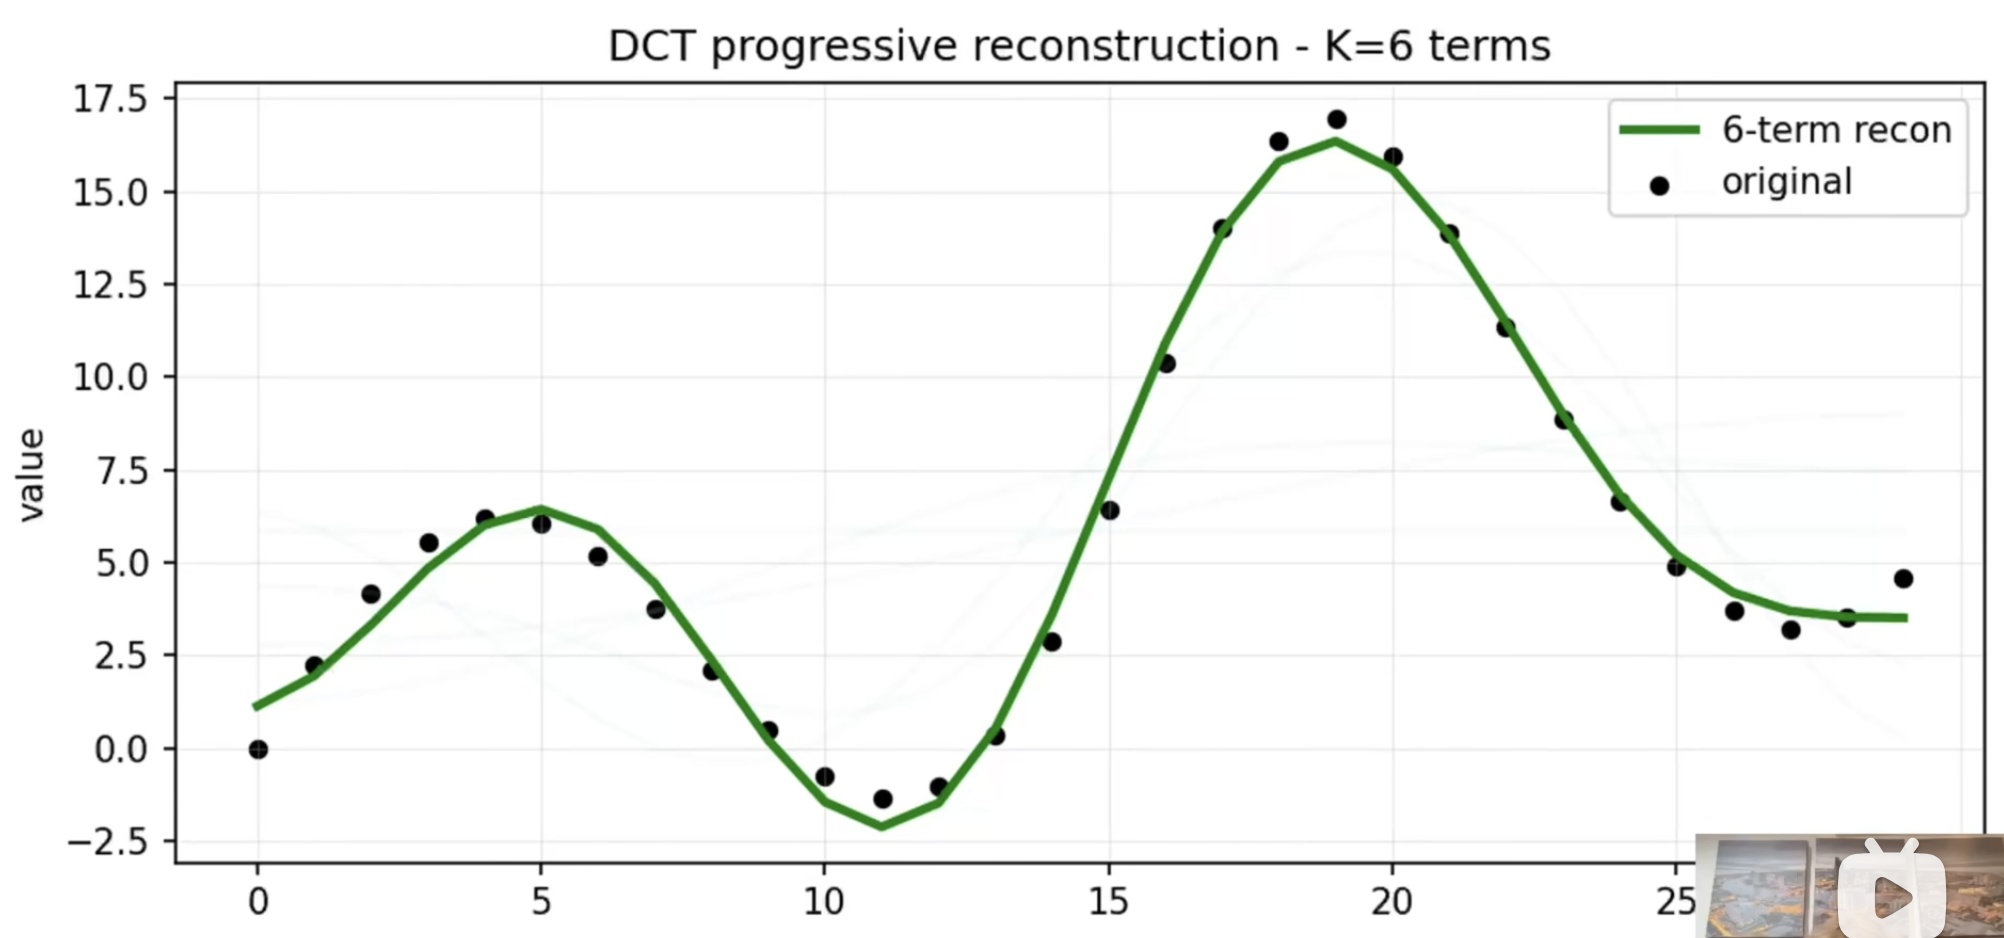
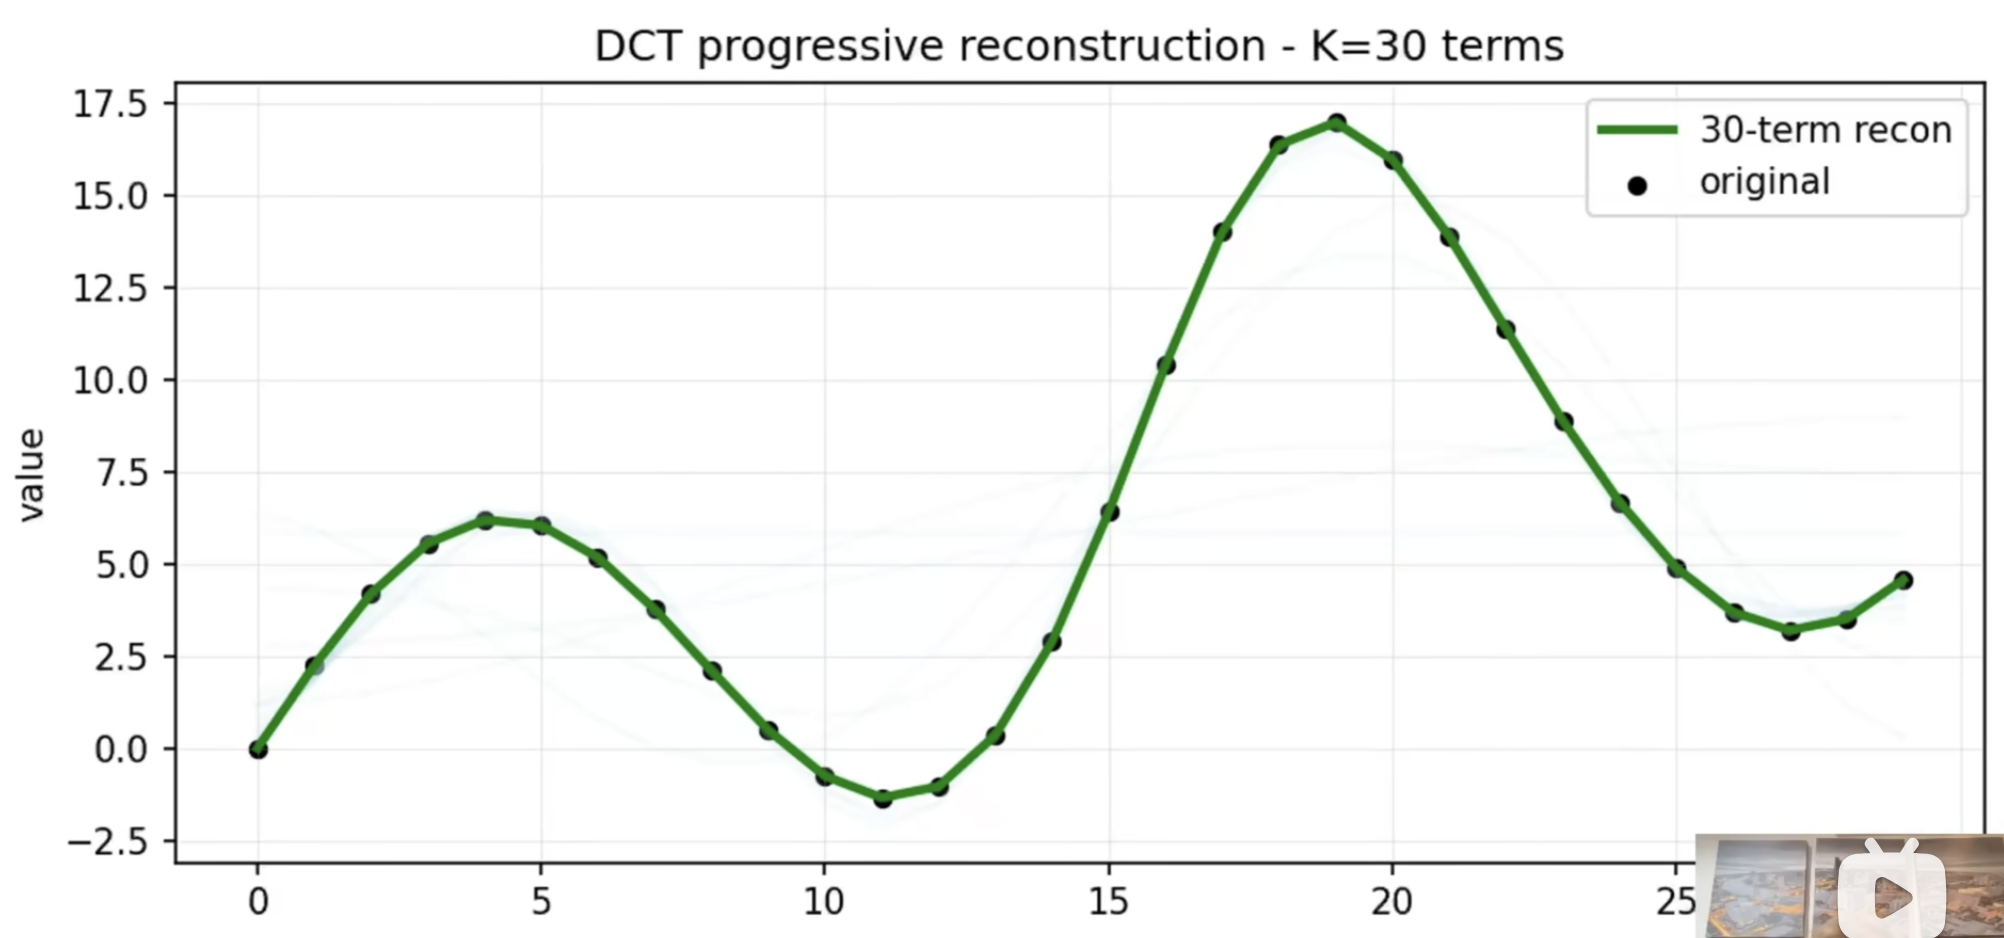
用两个一维动作序列直观展示了 DCT 的作用:一条平滑的 30 点轨迹只用大约 6 个低频分量,就能恢复整体形状;保留约 20 个分量时,重建结果与使用全部 30 个分量已经很难用肉眼区分。可是,当轨迹中加入逐时刻振荡后,高频系数不再接近零,必须保留接近全部分量才能精确重建。
加入噪声时:
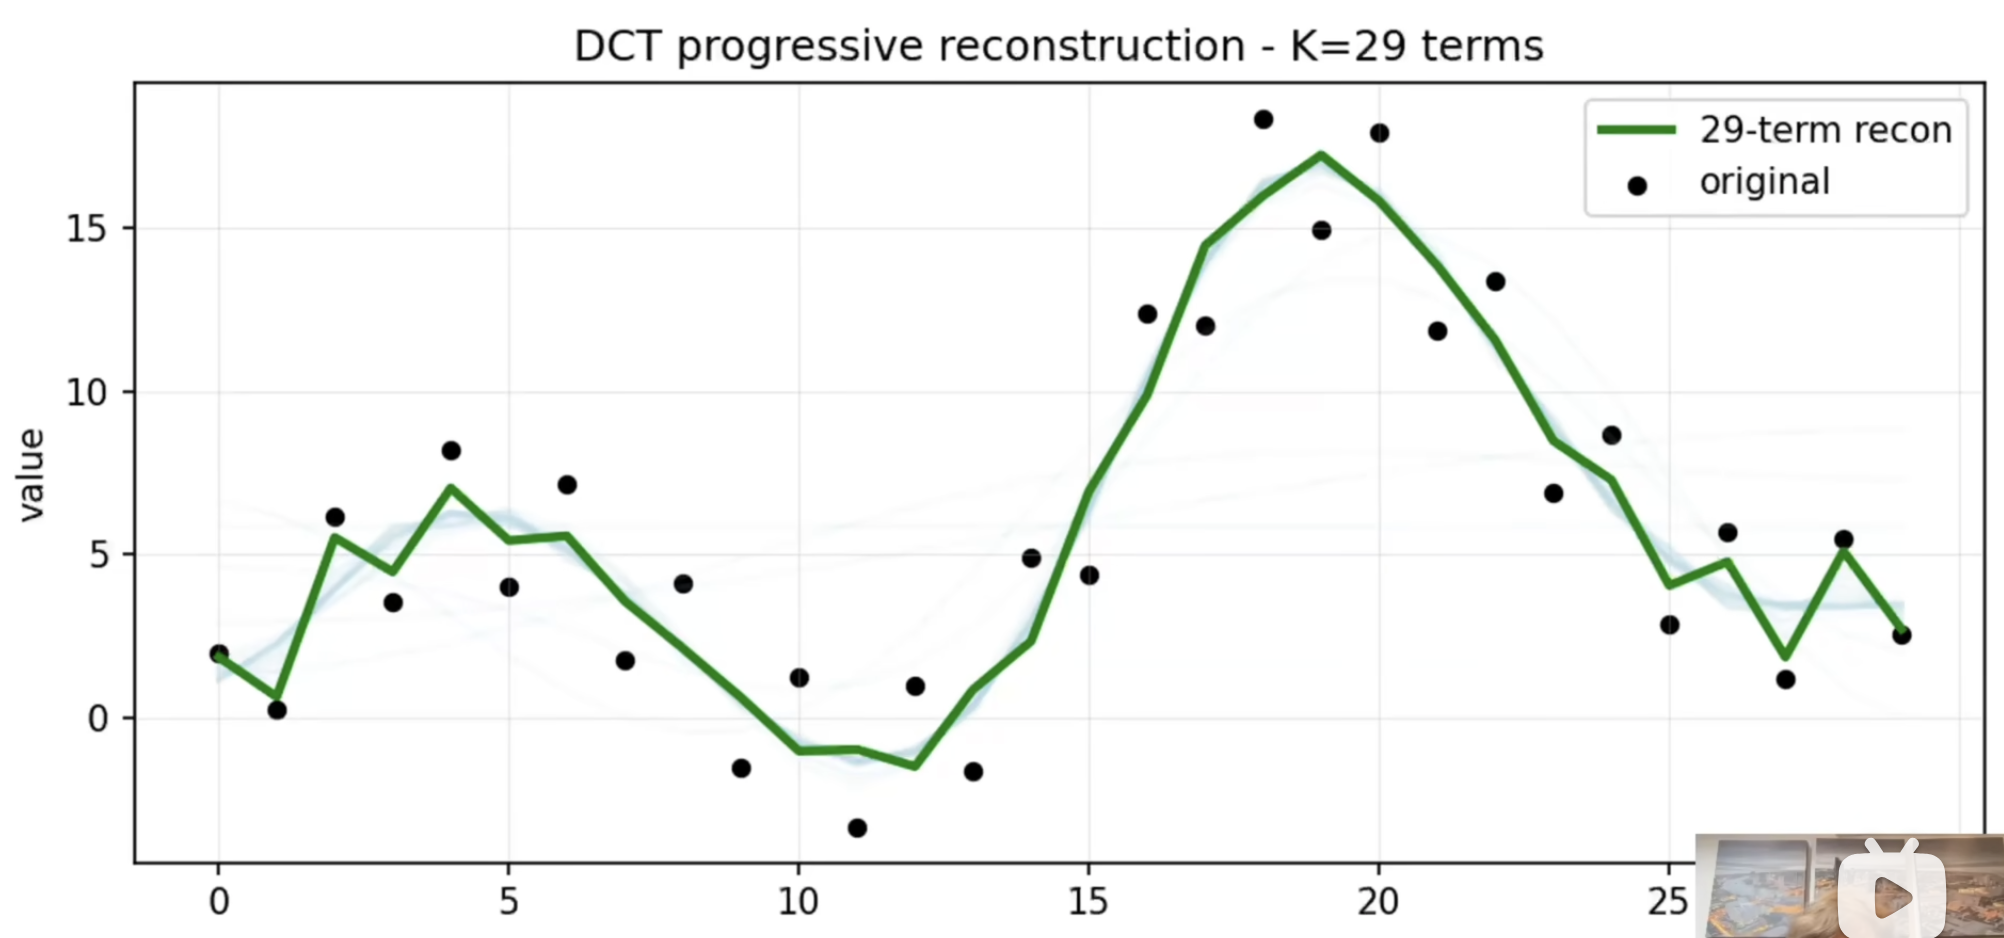
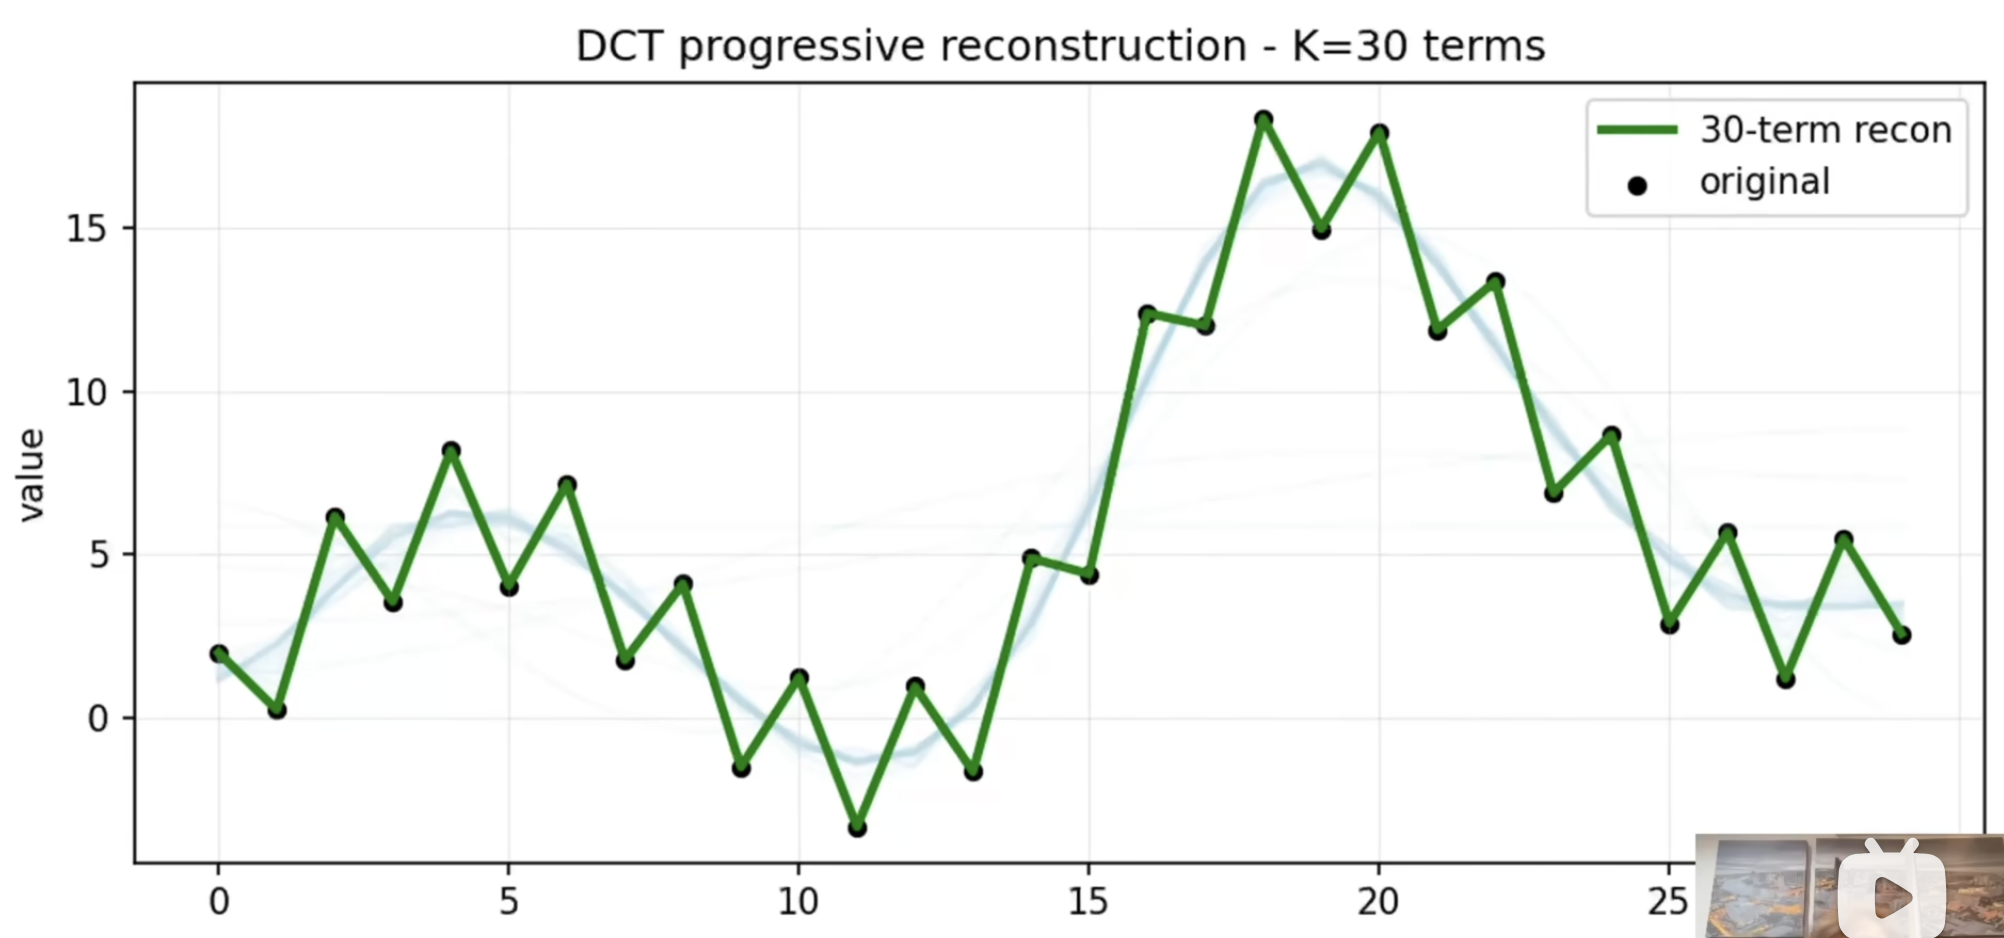
这个对比揭示了 FAST 能否有效压缩动作的关键:轨迹的信息是否集中在少量低频 DCT 系数中。
1. 不同 DCT 系数分别表达什么?
对于长度为 H H H 的单维动作序列 x 0 , ... , x H − 1 x_0,\ldots,x_{H-1} x0,...,xH−1,DCT 将它表示为一组不同频率的余弦基:
x n = ∑ k = 0 H − 1 α k X k cos π H ( n + 1 2 ) k x_n=\sum_{k=0}^{H-1}\alpha_k X_k \cos\left\\frac{\\pi}{H}\\left(n+\\frac12\\right)k\\right xn=k=0∑H−1αkXkcosHπ(n+21)k
其中 X k X_k Xk 是第 k k k 个 DCT 系数。 k k k 越大,对应的时间变化越快:
| 保留的系数 | 能表达的动作信息 | 重建结果 |
|---|---|---|
| 仅 X 0 X_0 X0 | 动作块的平均值,也称 DC 分量 | 一条常数轨迹 |
| 少量低频系数 | 整体方向、幅度和缓慢转弯 | 平滑,但细节不足 |
| 更多中频系数 | 加减速、局部弯曲和纠偏 | 更贴近原轨迹 |
| 高频系数 | 尖锐变化、接触冲击、快速振动,也可能是噪声 | 细节更多,但可能重现抖动 |
| 全部系数 | 原始离散序列的全部信息 | 未量化时可精确重建 |
如果只保留前 K K K 个系数,重建为
x ^ n ( K ) = ∑ k = 0 K − 1 α k X k cos π H ( n + 1 2 ) k . \hat x_n^{(K)}=\sum_{k=0}^{K-1}\alpha_k X_k \cos\left\\frac{\\pi}{H}\\left(n+\\frac12\\right)k\\right. x^n(K)=k=0∑K−1αkXkcosHπ(n+21)k.
随着 K K K 增大,重建误差通常下降,但轨迹会经历"常数 → 大致趋势 → 局部变化 → 完整细节"的过程。这与渐进式 JPEG 先出现轮廓、后出现纹理的现象相似。
需要注意,FAST 并没有直接规定固定保留前 K K K 个系数。它对全部系数进行缩放和取整:
X ˉ k = round ( γ X k ) . \bar X_k=\operatorname{round}(\gamma X_k). Xˉk=round(γXk).
因此,满足
∣ X k ∣ < 1 2 γ |X_k|<\frac{1}{2\gamma} ∣Xk∣<2γ1
的系数通常会量化为 0。平滑轨迹的高频系数往往很小,于是效果看起来像"自动丢弃高频",但实际保留多少系数由轨迹本身和量化尺度 γ \gamma γ 共同决定,而不是一个固定的 K K K。
2. 保留太少或太多系数会怎样?
较强压缩 ⟷ 更短、更平滑,但细节更少 \text{较强压缩} \quad\longleftrightarrow\quad \text{更短、更平滑,但细节更少} 较强压缩⟷更短、更平滑,但细节更少
较弱压缩 ⟷ 更精确、token 更多,也更容易保留噪声 \text{较弱压缩} \quad\longleftrightarrow\quad \text{更精确、token 更多,也更容易保留噪声} 较弱压缩⟷更精确、token 更多,也更容易保留噪声
总结:FAST 对平滑动作具有很高的压缩效率,但如果有高频的噪声会让压缩效率大打折扣。
(傅里叶变换去噪声原理相同)
2.6 如何还原动作?
解码按相反方向执行:
text
动作 token
  -> BPE 解码为整数序列
  -> 还原频率系数矩阵
  -> 除以 gamma
  -> 逆 DCT
  -> 反归一化
  -> 连续动作块
3. π0.5 中是如何使用 FAST 的?
理解 π0.5 的关键,是不要把"训练表示"和"最终控制输出"混为一谈。π0.5 采用两阶段训练,把 FAST 和 flow matching 的长处组合起来。
3.1 预训练:用 FAST 学动作语言
π0.5 从 PaliGemma VLM 初始化。在预训练阶段,机器人动作块先经 FAST 编成离散 token,模型和预测文字一样,通过交叉熵学习 next-token prediction:
L FAST = − ∑ i log p θ ( z i ∣ z < i , o , ℓ ) \mathcal{L}{\text{FAST}}= -\sum_i \log p\theta(z_i\mid z_{<i},o,\ell) LFAST=−i∑logpθ(zi∣z<i,o,ℓ)
其中 o o o 是图像和本体状态, ℓ \ell ℓ 是语言指令, z i z_i zi 是 FAST 动作 token。图像、文本、本体状态和动作由同一个 Transformer 上下文联系起来。
这样做有三个直接收益:
- 机器人数据、视觉问答、目标定位等任务都可放进统一的离散 token 训练框架;
- FAST 压缩后的动作序列更短、信息密度更高,适合大规模预训练;
- 离散动作训练有助于模型保持较好的语言理解和指令遵循能力。
论文中这一阶段训练 280k 步。各数据集动作先按每维的 1%/99% 分位数归一化到 − 1 , 1 -1,1 −1,1;不同机器人的动作维数不一致时,会补零到统一维度。
3.2 后训练:增加连续动作专家
离散动作适合训练,却不适合实时控制:自回归解码必须一个 token 接一个 token 地生成。为此,π0.5 在后训练阶段加入一个约 300M 参数的 action expert,用 flow matching 直接生成连续动作块。
此时模型联合优化两类目标:
L = L token + α L flow \mathcal{L}= \mathcal{L}{\text{token}} +\alpha\mathcal{L}{\text{flow}} L=Ltoken+αLflow
- L token \mathcal{L}_{\text{token}} Ltoken 包含文本以及 FAST 动作 token 的交叉熵(预训练loss);
- L flow \mathcal{L}_{\text{flow}} Lflow 训练动作专家预测连续动作的向量场;
- 论文后训练 80k 步,取 α = 10 \alpha=10 α=10。
两种动作表示之间通过 attention mask 隔离,避免相互泄漏答案:FAST token 可以看图像、语言和本体状态,并因果地看此前的 FAST token;动作专家可以看公共前缀以及自己的 noisy action token,但不能看 FAST 动作 token。
3.3 推理:FAST 不在实时动作生成主路径上
π0.5 推理分为两层:
- VLM 自回归生成高层子任务,例如把"收拾厨房"分解为"拿起盘子";
- 动作专家以该子任务、视觉和状态为条件,经过 10 个去噪/积分步骤生成连续动作块。
论文中的 action horizon 为 50(从 t t t 到 t + 49 t+49 t+49),机器人以 50 Hz 执行控制。也就是说,FAST 主要在预训练及联合训练中提供高质量的离散学习信号;部署时的低层连续动作主要由 flow-matching action expert 产生。将 π0.5 简化成"用 FAST 解码动作的自回归 VLA"是不准确的。
4. 一个直观例子
假设单个关节未来 8 个时刻的归一化动作是:
text
[0.00, 0.10, 0.20, 0.30, 0.40, 0.50, 0.60, 0.70]这是一条平滑上升的轨迹。逐时刻分桶需要 8 个离散值。DCT 后,大部分信息会集中在表示平均值和整体斜率的前几个低频系数,高频项接近 0。示意结果如下:
text
DCT:       [0.99, -0.64, 0.00, -0.07, 0.00, -0.02, 0.00, -0.01]
乘以 10:  [9.90, -6.40, 0.00, -0.70, 0.00, -0.20, 0.00, -0.10]
取整:      [10,   -6,    0,   -1,    0,    0,    0,    0]
数值会随 DCT 归一化约定而变化,这里只展示结构。可以看到,8 个时域采样变成了"少数显著系数 + 大量 0"。多关节情况下按低频优先交错展平,再由 BPE 把常见的零串及系数组合合并成更少的 token。
例如,量化后的序列是:
text
[10, -6, 0, -1, 0, 0, 0, 0]若 BPE 词表中已有如下合并:
text
Z2 = [0, 0]
Z4 = [Z2, Z2]
那么它可以编码成类似:
text
[10, -6, 0, -1, Z4]真实 FAST 的整数还会先映射到基础符号,BPE 合并规则也由整个训练集统计得到;上例只是解释压缩机制。
5. 用官方 FAST+ 接口编码动作
FAST 论文发布了 Hugging Face AutoProcessor 形式的通用 FAST+ tokenizer。下面是论文给出的最小用法:
python
import numpy as np
from transformers import AutoProcessor

tokenizer = AutoProcessor.from_pretrained(
    "physical-intelligence/fast",
    trust_remote_code=True,
)

# 推荐输入约 1 秒动作,并事先按训练集分位数归一化到 [-1, 1]。
# 例:50 Hz、7 个动作维度,形状为 [time, action_dim]。
action_chunk = np.random.uniform(-1, 1, size=(50, 7)).astype(np.float32)
tokens = tokenizer(action_chunk)

print(tokens)
如果要针对自己的机器人数据训练 BPE 词表,论文接口为:
python
new_tokenizer = tokenizer.fit(action_dataset)其中 action_dataset 应包含许多形状为 [H, D] 的动作块。实践中还需注意:
- 用训练集统计每个动作维度的 1%/99% 分位数,并在训练、验证和部署时复用同一组统计量;
- 以约 1 秒为动作块通常能获得较好的压缩效果;
- 必须记录动作维度含义、单位、顺序以及 absolute/delta action 定义;
- 用"解码后的轨迹误差"选择 γ \gamma γ,不能只追求 token 越少越好;
trust_remote_code=True会执行模型仓库中的代码,应固定版本并审查来源后再用于生产环境。
6. 用伪代码串起完整过程
下面的代码省略了 BPE 的基础符号映射等工程细节,但准确表达了算法骨架:
python
import numpy as np
from scipy.fft import dct, idct

def fast_pre_bpe_encode(actions, q01, q99, gamma=10):
    """actions: [H, D],返回频率优先的量化整数序列。"""
    normalized = 2 * (actions - q01) / (q99 - q01) - 1
    normalized = np.clip(normalized, -1, 1)

    # 沿时间轴对每个动作维度做 DCT。
    coeff = dct(normalized, axis=0, norm="ortho")       # [H, D]
    quantized = np.rint(gamma * coeff).astype(np.int32) # [H, D]

    # NumPy 的 C-order 正好按每个频率依次放入所有动作维度。
    return quantized.reshape(-1)

def fast_pre_bpe_decode(integer_sequence, horizon, action_dim,
                        q01, q99, gamma=10):
    quantized = integer_sequence.reshape(horizon, action_dim)
    coeff = quantized.astype(np.float32) / gamma
    normalized = idct(coeff, axis=0, norm="ortho")
    return (normalized + 1) * 0.5 * (q99 - q01) + q01

# 真实 FAST:
# integer_sequence -> BPE.encode(...) -> action tokens
# action tokens -> BPE.decode(...) -> integer_sequence -> 上面的逆过程
这段代码适合帮助理解或检查数据管线,不应被当作官方 FAST tokenizer 的等价替代:正式实现还包括整数到 BPE 符号的编码、词表训练、padding、批处理和元数据管理。
7. 总结
FAST 抓住了高频机器人动作的本质:采样点很多,不等于有效信息很多。逐时刻分桶把平滑轨迹变成长而重复的序列;FAST 则通过 DCT 把信息集中到频域、通过量化制造稀疏性,再用 BPE 压缩重复模式,从而得到短而高信息密度的动作 token。
π0.5 对 FAST 的使用体现了一个很实用的系统设计:
- 用 FAST 离散 token 获得稳定、统一、可扩展的预训练;
- 用 flow matching 动作专家获得细粒度、低延迟的连续控制;
- 用联合损失和 attention mask 让两种动作表示共享视觉语言能力,同时避免标签泄漏。
一句话概括:FAST 让 π0.5 更容易"学会动作",flow matching 让它更快地"做出动作"。
参考资料
- Pertsch et al., FAST: Efficient Action Tokenization for Vision-Language-Action Models, 2025.
- Physical Intelligence et al., π0.5: a Vision-Language-Action Model with Open-World Generalization, 2025.
- Physical Intelligence, FAST+ tokenizer on Hugging Face.
- Physical Intelligence, OpenPI repository.