论文:Zitkovich et al. , RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control , CoRL 2023。
论文:Black et al. , π₀: A Vision-Language-Action Flow Model for General Robot Control , RSS 2025。
论文:Pertsch et al. , FAST: Efficient Action Tokenization for Vision-Language-Action Models , 2025。
论文:Bjorck et al. , GR00T N1: An Open Foundation Model for Generalist Humanoid Robots, 2025。
VLA(Vision-Language-Action,视觉-语言-动作)并不是简单地把"视觉模型 + 大语言模型 + 机器人控制器"串在一起。它真正要解决的问题是:如何把互联网尺度的语义知识,与机器人连续、实时、受物理约束的动作空间统一到一个可以训练、泛化和部署的策略中。
从 2022---2026 年的发展看,VLA 的主线并非只是模型参数不断增大,而是发生了三次更关键的结构迁移:第一阶段把机器人动作"语言化",即将连续动作离散成 token,并直接交给 VLM/LLM 自回归预测;第二阶段把动作建模从逐步离散 token 转向 action chunk、Diffusion、Flow Matching、专用 Action Expert,解决高频连续控制和多模态动作分布问题;第三阶段则进一步形成"慢语义推理 + 快视觉运动控制 + 更快全身稳定控制"的多时间尺度层级,并加入记忆、在线强化学习与跨本体迁移。
本文先用一张中文总结图串联整条 VLA 技术主线。该图用于建立全文阅读框架,不替代后续各论文的原始 Figure。
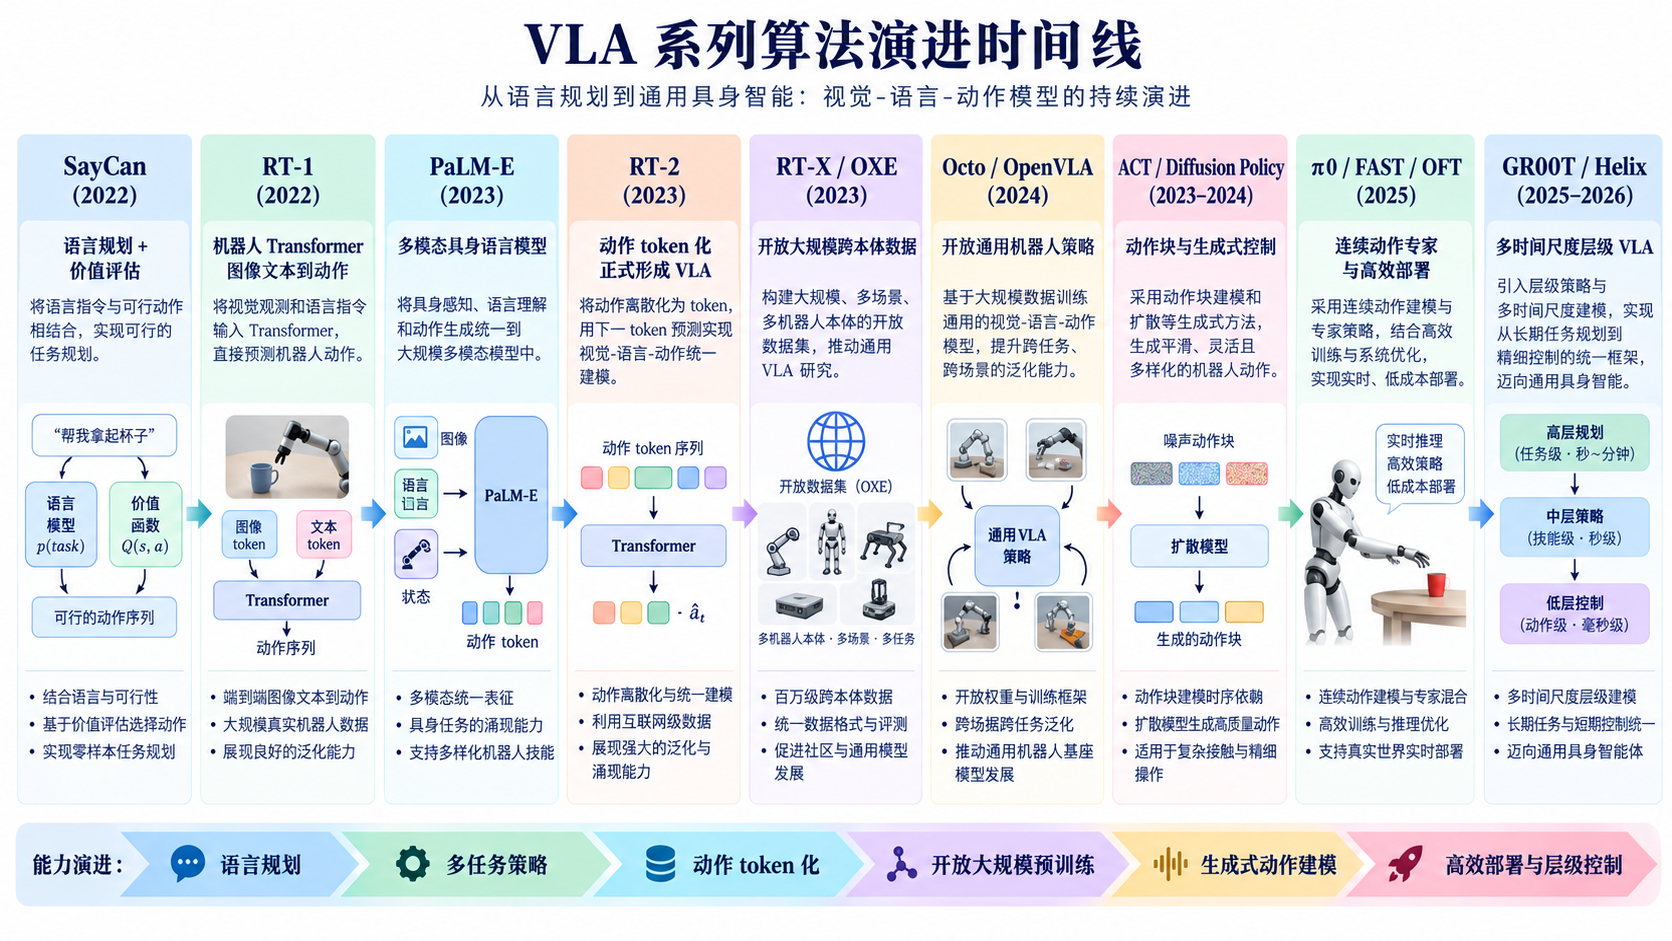
图 1 VLA 系列算法演进时间线:从语言规划到通用具身智能控制。本文根据 SayCan、RT-1、PaLM-E、RT-2、RT-X / OXE、Octo、OpenVLA、ACT / Diffusion Policy、π₀ / FAST / OFT、GR00T / Helix 等工作的技术关系整理绘制,用于全文总览。
作为对照,下面保留综述论文中的原始时间线,展示 VLA、基础模型与机器人数据源在文献体系中的对应关系。
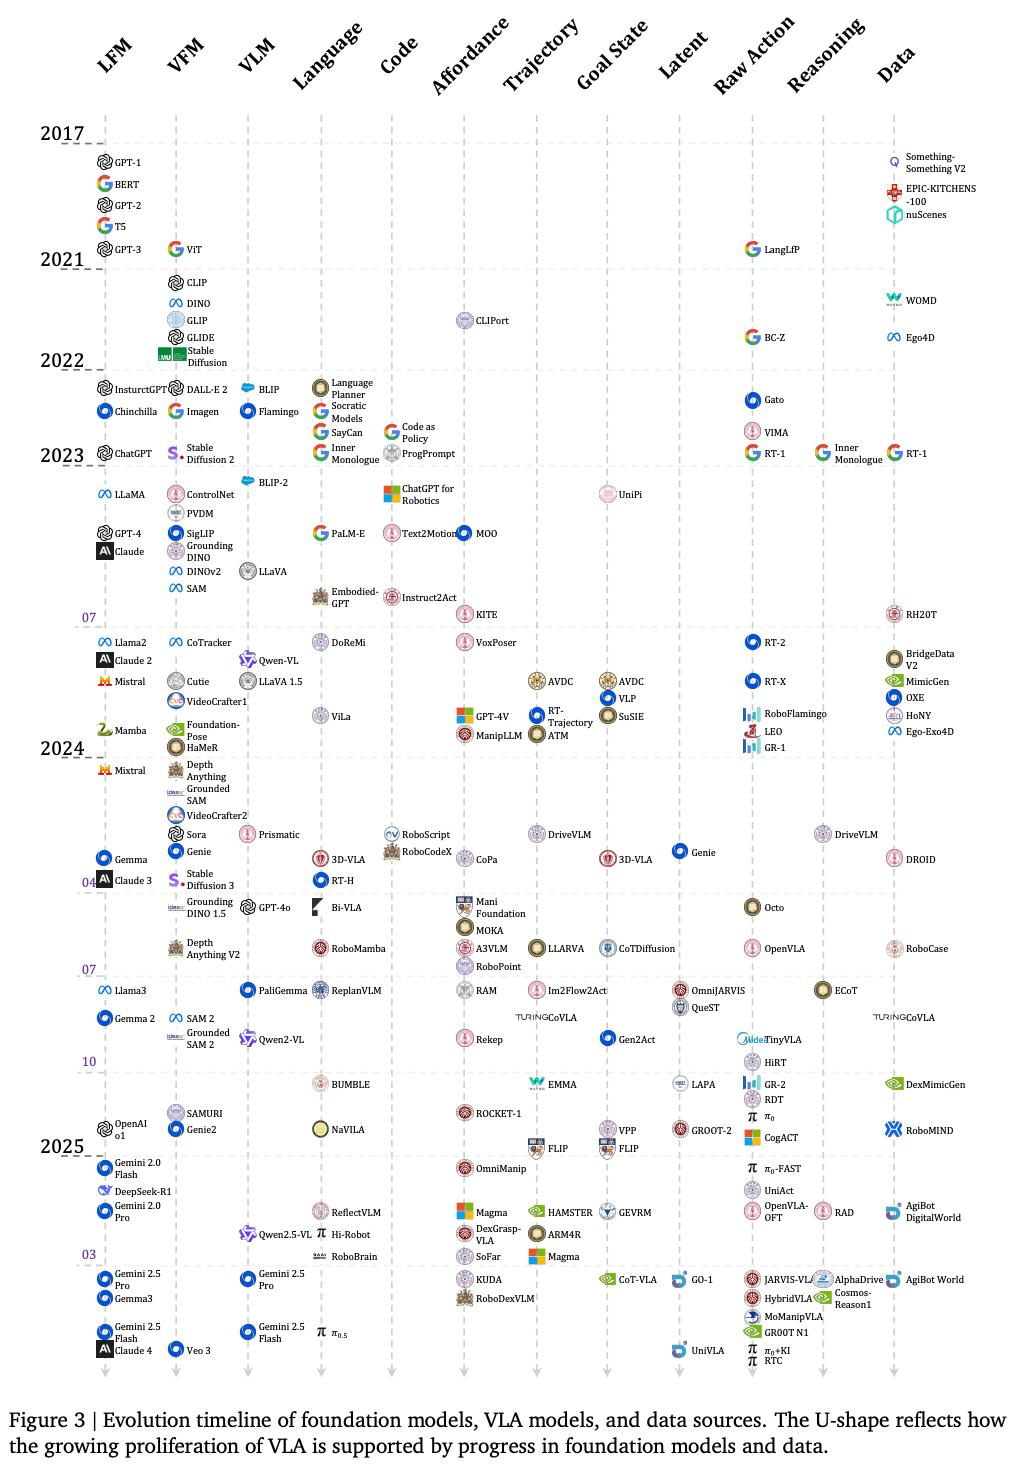
图 2 VLA / Foundation Model 演进时间线。采用 Zhong et al., A Survey on Vision-Language-Action Models: An Action Tokenization Perspective 的原论文 Figure 3,用于建立全文的时间坐标与 VLA、基础模型及数据源之间的演进关系。原图:<images/original/fig01_vla_survey_timeline.png>。
1. VLA 到底是什么
传统视觉语言模型学习的是
( I , L ) → Y t e x t , (I, L) \rightarrow Y_{text}, (I,L)→Ytext,
其中 I I I 是图像或视频, L L L 是语言提示,输出通常仍是文本 token。机器人策略则更接近
π θ ( a t ∣ o t , q t ) , \pi_\theta(a_t\mid o_t, q_t), πθ(at∣ot,qt),
其中 o t o_t ot 是视觉、深度、触觉等观测, q t q_t qt 是关节位置、速度、末端位姿等本体状态, a t a_t at 是关节目标、末端增量、速度或力矩等动作。
VLA 要把两者统一为
π θ ( A t ∣ O ≤ t , L , q t , m t ) , \pi_\theta(A_t\mid O_{\le t}, L, q_t, m_t), πθ(At∣O≤t,L,qt,mt),
其中 A t = a t , a t + 1 , ... , a t + H − 1 A_t=a_t,a_{t+1},\\ldots,a_{t+H-1} At=at,at+1,...,at+H−1 可以是单步动作,也可以是长度为 H H H 的动作块; m t m_t mt 则在较新的模型中表示短期或长期记忆。
从结构上,可以把现有 VLA 分成四类:
- 单体自回归 VLA:视觉、语言、动作都进入统一 Transformer,动作以离散 token 预测,典型是 RT-2、OpenVLA。
- VLM + 连续 Action Expert:VLM 负责语义,专门的动作网络负责连续控制,典型是 π₀、CogACT、GR00T N1。
- 分层双系统 / 三系统 VLA:慢速语义系统与高速视觉运动系统分开,必要时再增加 kHz 级低层身体控制,典型是 Helix / Helix 02。
- 轻量端侧 VLA:压缩视觉 token、减小 VLM、异步执行,在较弱硬件上保持可用控制频率,典型是 SmolVLA、Gemini Robotics On-Device 2。
这四类并不是互斥的。2026 年的趋势恰恰是把它们组合起来:语义模块负责"做什么",动作专家负责"怎么连续地做",记忆负责"前面发生了什么",RL/在线学习负责"失败后怎么变得更好",低层控制器负责"如何稳定地把动作落到真实机器人上"。
2. 数学底座:VLA 里反复出现的几个核心模块
2.1 Transformer 与跨模态注意力
VLA 的视觉 token、语言 token、本体状态 token 和动作 token 最终都需要发生信息交互。标准缩放点积注意力为
A t t e n t i o n ( Q , K , V ) = s o f t m a x ( Q K ⊤ d k ) V . \mathrm{Attention}(Q,K,V)=\mathrm{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)V. Attention(Q,K,V)=softmax(dk QK⊤)V.
早期模型倾向于把所有模态拼成一个长序列做统一自注意力;后续模型越来越多地采用交叉注意力、专家网络或分层交互,以避免高频动作生成把语义主干拖入过高计算频率。
2.2 条件调制 FiLM
RT-1 等机器人 Transformer 常使用 FiLM(Feature-wise Linear Modulation,逐特征线性调制)把语言条件注入视觉特征:
F i L M ( h ∣ c ) = γ ( c ) ⊙ h + β ( c ) . \mathrm{FiLM}(h\mid c)=\gamma(c)\odot h+\beta(c). FiLM(h∣c)=γ(c)⊙h+β(c).
这里 c c c 可以是语言嵌入, γ , β \gamma,\beta γ,β 由条件网络生成。它的作用不是直接产生动作,而是让视觉特征在"拿红杯子""放入抽屉"等不同指令下呈现不同的任务相关表示。
2.3 连续动作离散化
RT-1、RT-2、OpenVLA 等路线通常先把连续动作每一维离散成 B B B 个 bin:
q ( a ) = c l i p ( r o u n d ( a − a min a max − a min ( B − 1 ) ) , 0 , B − 1 ) . q(a)=\mathrm{clip}\left(\mathrm{round}\left(\frac{a-a_{\min}}{a_{\max}-a_{\min}}(B-1)\right),0,B-1\right). q(a)=clip(round(amax−amina−amin(B−1)),0,B−1).
反量化为
a ^ = a min + q ( a ) B − 1 ( a max − a min ) . \hat a=a_{\min}+\frac{q(a)}{B-1}(a_{\max}-a_{\min}). a^=amin+B−1q(a)(amax−amin).
优势是能直接复用语言模型的交叉熵训练与自回归解码;问题是高频、细粒度动作会被量化误差和逐 token 生成延迟限制。FAST、OFT、π₀ 等工作的出现,本质上都在解决这个瓶颈。
第一阶段:从"语言规划机器人"到通用序列策略(2022)
3. SayCan:语言模型做高层决策,技能价值函数保证可执行
论文:Ahn et al. , Do As I Can, Not As I Say: Grounding Language in Robotic Affordances , CoRL 2022。
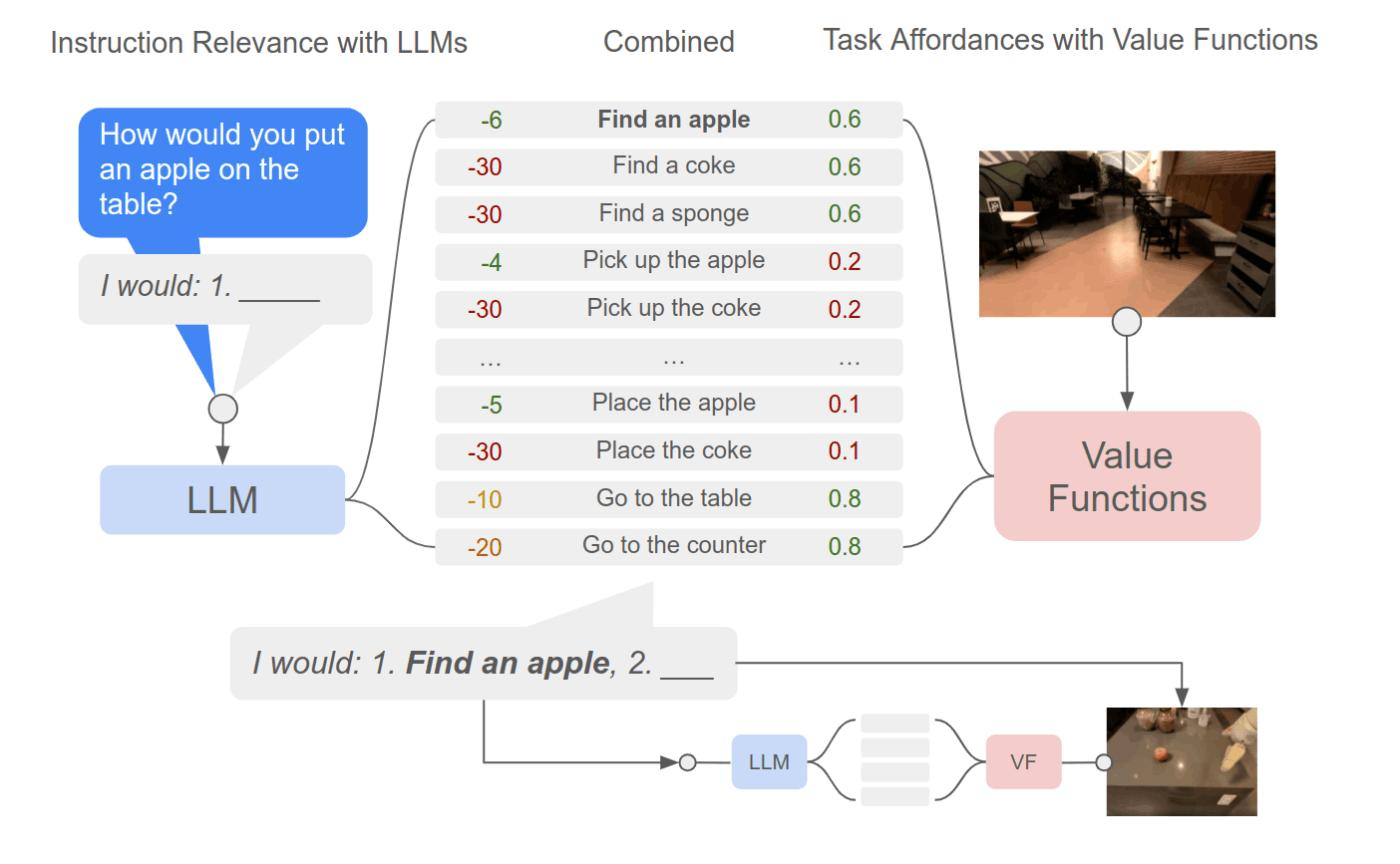
图 3 SayCan 方法框架。LLM 给出候选技能的语言相关性,价值函数估计当前状态下的 affordance(可供性),两者联合选择下一技能。来源:Ahn et al., Do As I Can, Not As I Say: Grounding Language in Robotic Affordances,对应论文 Figure 3 的核心机制;原图:<images/original/fig02_saycan_framework.png>。
SayCan 不是今天意义上的端到端 VLA,但它明确提出了一个至今仍然重要的分工:语言模型擅长知道"应该做什么",机器人价值函数擅长判断"当前做不做得到"。
给定自然语言目标 L L L、状态 s s s 和技能候选 a a a,SayCan 可以概括为
a ∗ = arg max a p L M ( a ∣ L ) V ( a ∣ s ) . a^*=\arg\max_a p_{\mathrm{LM}}(a\mid L)\,V(a\mid s). a∗=argamaxpLM(a∣L)V(a∣s).
其中 p L M p_{\mathrm{LM}} pLM 衡量技能在语言计划中的合理性, V ( a ∣ s ) V(a\mid s) V(a∣s) 衡量技能在当前环境中的可实现性。比如"把饮料拿给我"可能在语言层面分解成"去冰箱---打开冰箱---拿饮料---返回",但如果冰箱当前不可达,价值函数会降低对应技能得分。
SayCan 的局限也非常明确:动作空间是预定义技能库,LLM 并不直接生成连续机器人动作。因此它代表的是LLM + 技能库的层级式具身智能,而非真正的视觉语言动作统一建模。但 Helix、Gemini Robotics ER、π₀.5 等后续系统重新出现的"高层语义 / 低层动作"分解,本质上与 SayCan 的思想一脉相承。
4. Gato:把不同任务、模态和动作都当作统一序列
论文:Reed et al. , A Generalist Agent , 2022。
论文:https://arxiv.org/abs/2205.06175
项目:https://deepmind.google/blog/a-generalist-agent/
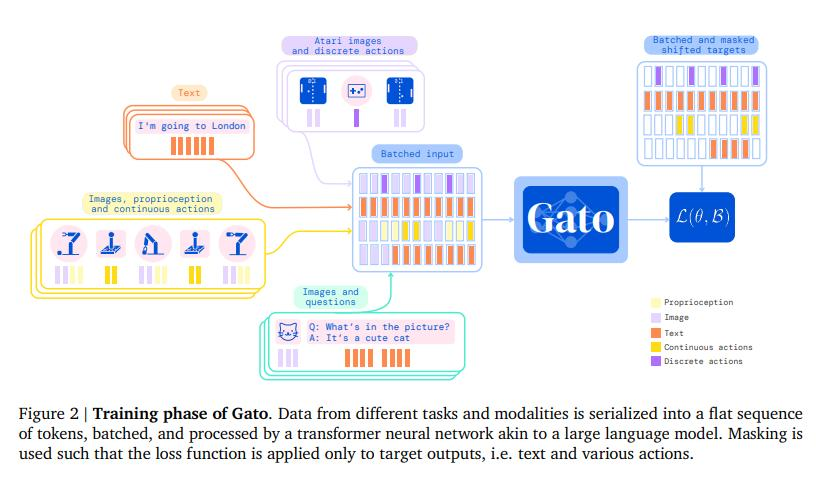
图 4 Gato 训练阶段的统一序列化框架。原论文 Figure 2:文本、Atari 图像与离散动作、机器人图像/本体感觉/连续动作以及视觉问答数据都被序列化,再由同一个 Transformer 进行条件序列建模。来源:Reed et al., A Generalist Agent;原图:<images/original/fig03_gato_figure2.png>。
Gato 的重要性在于它证明了:文本、图像、游戏状态以及真实机器人控制序列可以通过统一 token 接口交给同一个 Transformer。模型不再为每种任务设计一套完全独立的网络,而是将输入序列化后统一预测后续 token。
其训练目标可以抽象为条件序列建模:
L G a t o = − ∑ t ∈ M log p θ ( x t ∣ x < t ) , \mathcal L_{\mathrm{Gato}}=-\sum_{t\in\mathcal M}\log p_\theta(x_t\mid x_{<t}), LGato=−t∈M∑logpθ(xt∣x<t),
其中 M \mathcal M M 是需要预测的文本或动作位置。Gato 并未建立后来 VLA 中强大的互联网视觉语言语义主干,但它奠定了一个重要思想:动作本身也可以被视为序列模型中的"另一种 token"。
5. VIMA:多模态 Prompt 驱动的机器人操作
论文:Jiang et al. , VIMA: General Robot Manipulation with Multimodal Prompts , ICML 2023。
论文:https://arxiv.org/abs/2210.03094
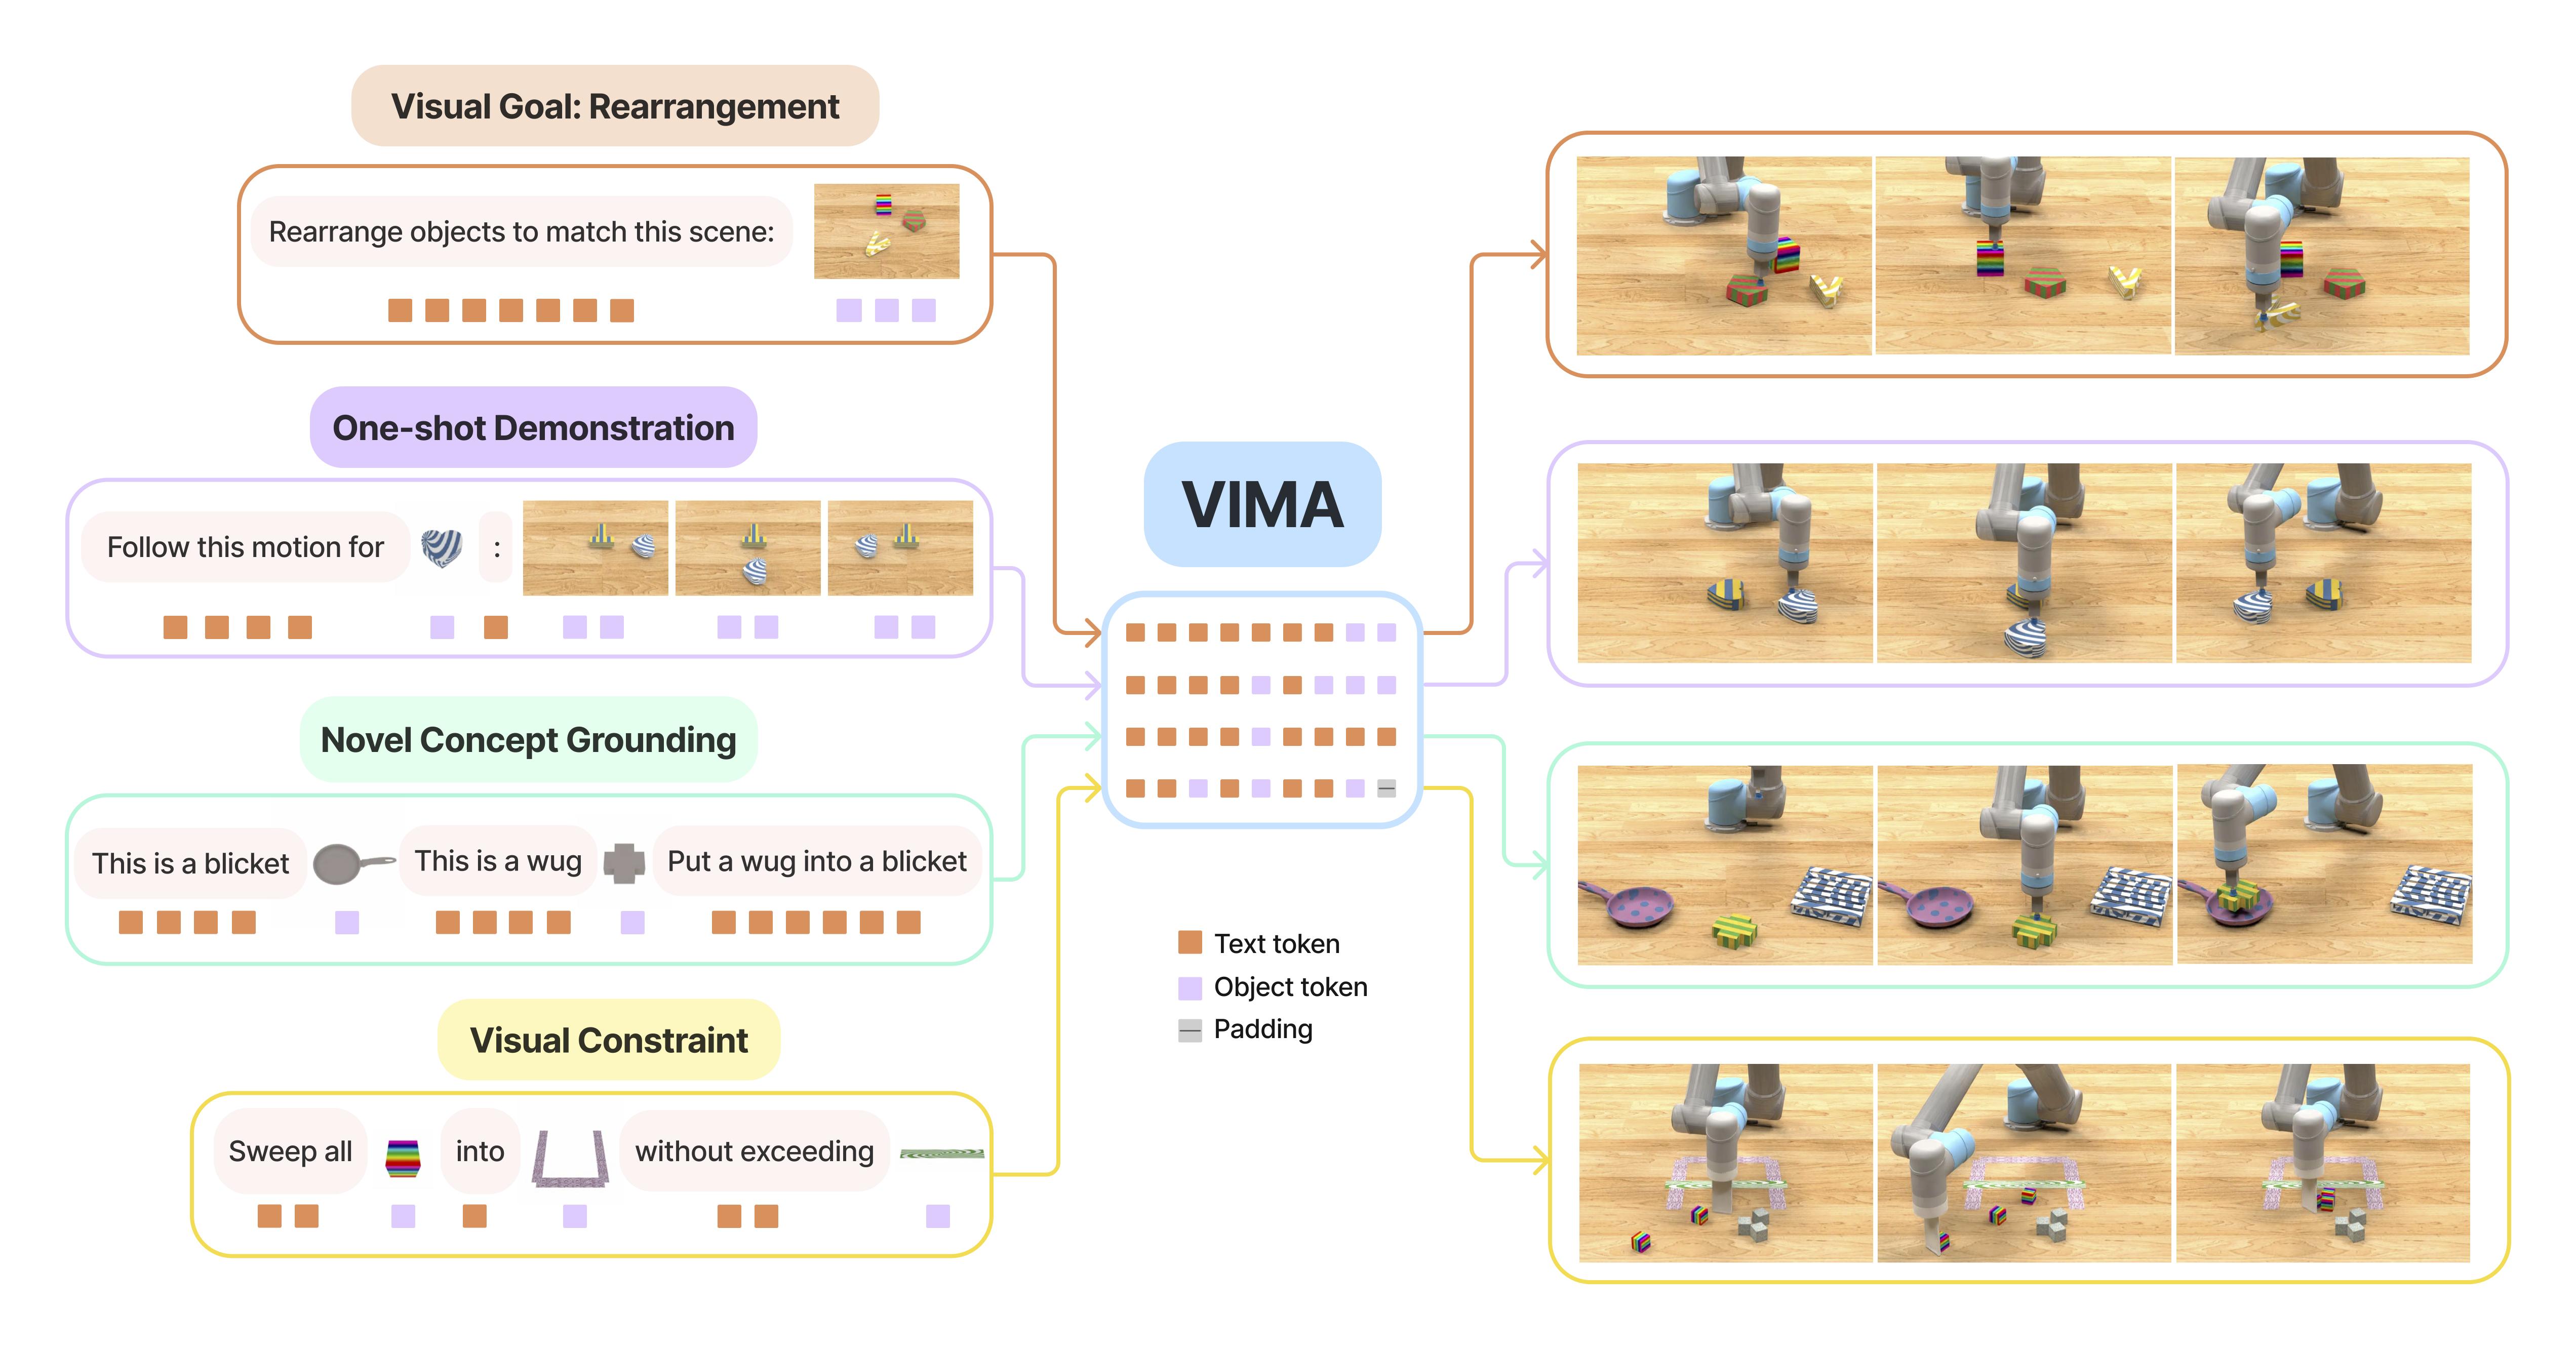
图 5 VIMA 的多模态 Prompt 任务接口。官方项目原图展示 visual goal、one-shot demonstration、novel concept grounding 与 visual constraint 如何与文本和对象视觉表示共同驱动机器人操作。来源:Jiang et al., VIMA: General Robot Manipulation with Multimodal Prompts;原图:<images/original/fig04_vima_multimodal_prompt.png>。
VIMA 进一步把机器人任务描述从纯语言扩展到文本和视觉对象交错的多模态 Prompt。例如 Prompt 不只说"把这个物体放到那个容器",还可以直接在指令中插入目标物体、容器的视觉 token。
其核心结构可以概括为:
text
Multimodal Prompt
(text + object image tokens)
        ↓
Prompt Encoder
        ↓
Causal Transformer Controller
        ↓
Robot observation tokens → action prediction
这条路线给 VLA 留下两个关键启发:第一,机器人条件不必只有自然语言,还可以是目标图像、对象图像、轨迹提示等;第二,Prompt 本身可以成为统一任务接口。Octo 的 goal-image conditioning、π₀.7 的多种 steering 条件都延续了这一思想。
第二阶段:机器人 Transformer 与具身 VLM 汇合(2022---2023)
6. RT-1:把大规模真实机器人数据训练成通用 Transformer 策略
论文:Brohan et al. , RT-1: Robotics Transformer for Real-World Control at Scale , RSS 2023。
RT-1 解决的核心问题不是互联网语义,而是真实机器人数据如何规模化训练。它在来自真实机器人的大规模轨迹上训练视觉-语言条件策略,将图像历史和自然语言任务映射到离散动作。
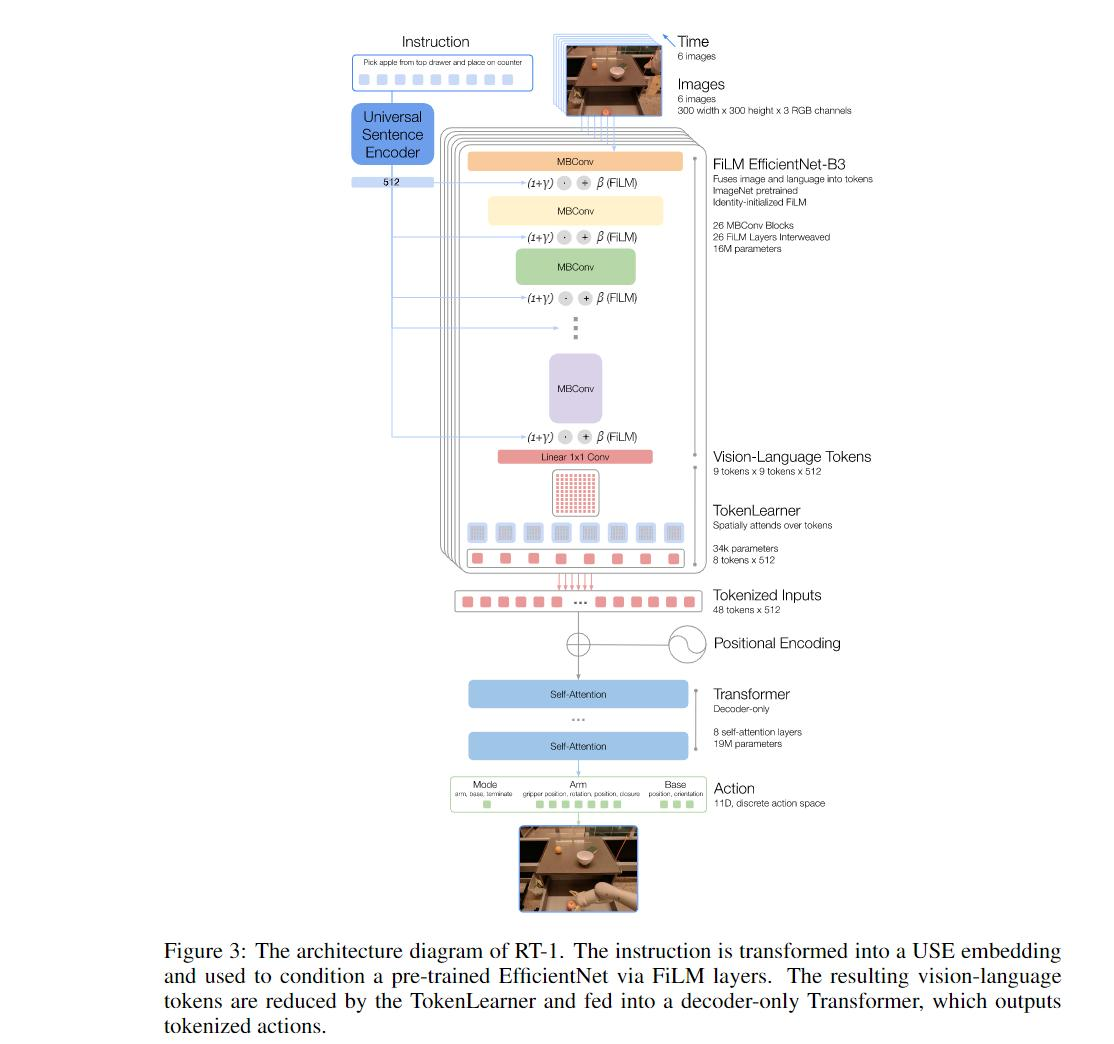
图 6 RT-1 完整模型架构。原论文架构图:语言指令先经 Universal Sentence Encoder 编码,并通过 FiLM 调制 EfficientNet-B3;视觉特征再经 TokenLearner 压缩,最后由 decoder-only Transformer 输出离散动作。来源:Brohan et al., RT-1: Robotics Transformer for Real-World Control at Scale;原图:<images/original/fig05_rt1_architecture.png>。
RT-1 的典型流程是:
text
图像历史 + 语言指令
        ↓
EfficientNet 视觉编码器
        ↓  FiLM(language)
空间视觉特征
        ↓
TokenLearner 压缩视觉 token
        ↓
Transformer
        ↓
每个动作维度离散分类
        ↓
反量化 → 机器人控制命令
RT-1 使用 256 个区间量化多个动作维度。其意义在于把机器人控制变成可以由标准 Transformer 直接处理的离散预测问题,并证明数据规模能够显著提升多任务泛化。它仍然不是严格意义上的"互联网知识 VLA",但已经具备后续 RT-2 所需的动作 token 接口。
7. PaLM-E:把视觉和机器人状态嵌入语言模型
论文:Driess et al. , PaLM-E: An Embodied Multimodal Language Model , ICML 2023。
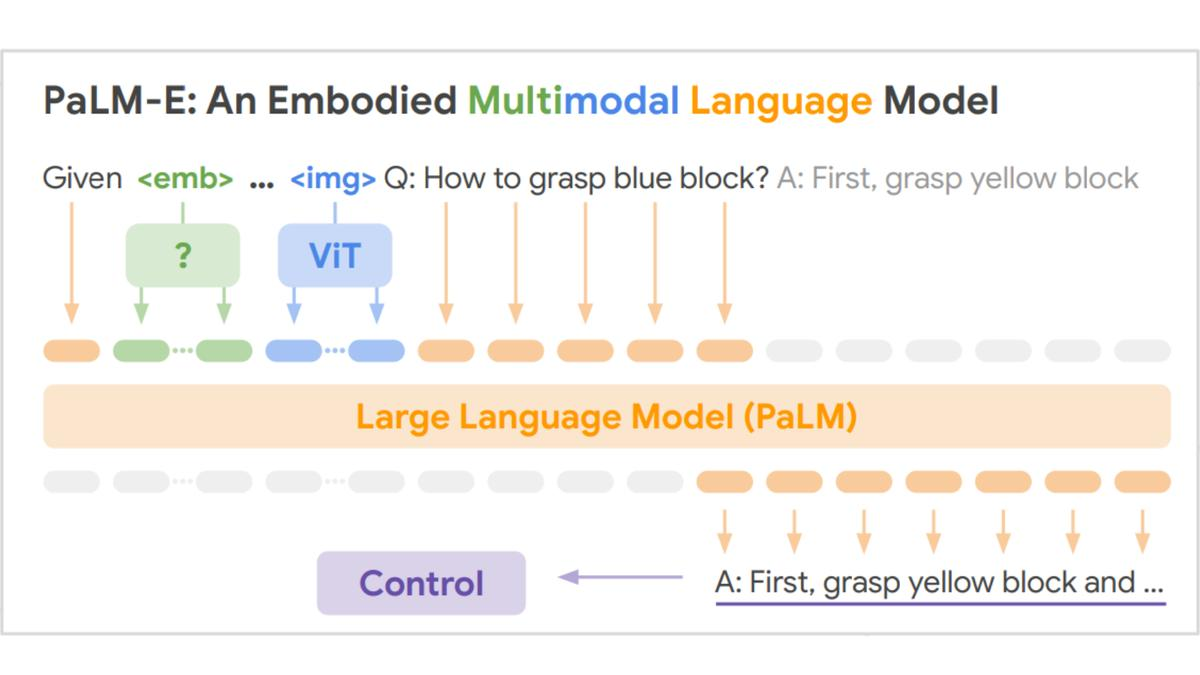
图 7 PaLM-E 的 Embodied Multimodal Language Model 接口。官方原图展示连续传感器/视觉输入经编码后与文本 token 交错进入语言模型,使同一模型同时处理视觉问答、具身推理与机器人相关任务。来源:Driess et al., PaLM-E: An Embodied Multimodal Language Model;原图:<images/original/fig06_palme_approach.png>。
PaLM-E 把连续传感器输入、视觉 token 和文本 token 组成"multimodal sentences",并注入大型语言模型。其目标重点是具身问答、计划和语义推理,而不是直接以高频方式预测低层关节动作。
PaLM-E 的意义是让研究社区看到:VLM/LLM 的预训练语义知识可以通过适配器接收机器人状态,并在具身任务中被调用。RT-2 随后完成了关键一步------不只把机器人状态输入 VLM,还把机器人动作也变成 VLM 的输出语言。
8. RT-2:VLA 概念正式成形------把动作变成"另一种语言"
论文:Zitkovich et al. , RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control , CoRL 2023。
RT-2 是 VLA 演进中最明确的分水岭。论文直接提出 Vision-Language-Action Model 这一类别:把机器人动作写成文本 token,与互联网视觉问答、图像描述等数据一起对预训练 VLM 做 co-fine-tuning。
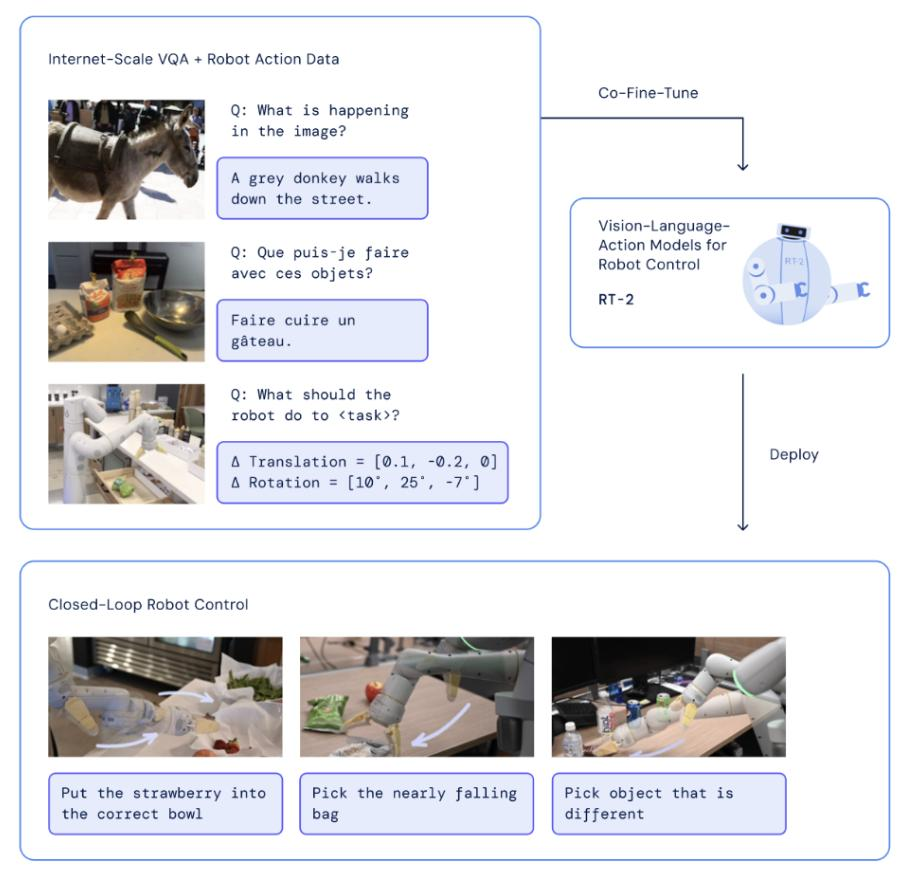
图 8 RT-2 的训练与推理框架。原论文 Figure 1:互联网尺度视觉语言数据与机器人轨迹共同用于 co-fine-tuning,模型把动作编码为文本 token,并在闭环中直接生成机器人动作。来源:Zitkovich et al., RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control;原图:<images/original/fig07_rt2_figure1.png>。
设离散动作 token 序列为 y 1 : N y_{1:N} y1:N,RT-2 使用标准自回归目标:
p θ ( y 1 : N ∣ I , L ) = ∏ n = 1 N p θ ( y n ∣ I , L , y < n ) , p_\theta(y_{1:N}\mid I,L)=\prod_{n=1}^{N}p_\theta(y_n\mid I,L,y_{<n}), pθ(y1:N∣I,L)=n=1∏Npθ(yn∣I,L,y<n),
L A R = − ∑ n = 1 N log p θ ( y n ∣ I , L , y < n ) . \mathcal L_{\mathrm{AR}}=-\sum_{n=1}^{N}\log p_\theta(y_n\mid I,L,y_{<n}). LAR=−n=1∑Nlogpθ(yn∣I,L,y<n).
其联合训练可以概念性表示为
L = λ r o b o t L r o b o t + λ w e b L V L , \mathcal L=\lambda_{robot}\mathcal L_{robot}+\lambda_{web}\mathcal L_{VL}, L=λrobotLrobot+λwebLVL,
这里并不意味着所有实现都使用固定同一组 λ \lambda λ,而是说明 robot data 与 web-scale vision-language data 同时参与训练。
RT-2 为什么是一次关键跃迁
第一,知识来源发生变化 。RT-1 的泛化主要来自机器人数据本身,RT-2 则试图直接继承互联网 VLM 中的类别、关系、符号和常识知识。第二,接口统一 。模型不需要额外设计一个完全不同的机器人输出头,而是把动作 token 当作自然语言词表中的新符号。第三,语义推理开始直接影响动作。诸如"把最小的物体拿过来""把适合作为锤子的东西拿来"等任务,可以借助 VLM 的概念知识映射到机器人行为。
RT-2 的根本瓶颈
其优势同时也是其限制:动作被塞进语言模型的自回归 token 生成机制后,高频控制需要连续地生成、反量化多个 token,带来三类问题:
- 量化误差:连续控制被映射到有限 bin;
- 自回归延迟:每个动作 token 依次解码;
- 动作分布表达能力不足:多种可行运动轨迹往往是连续、多峰的,逐维分类并不自然。
此后两年的 VLA 研究,核心之一就是把"语义理解"与"动作生成"逐步拆开。
第三阶段:动作块、Diffusion 与连续生成成为新的动作底座(2023---2024)
9. ACT:Action Chunking Transformer,把"下一步"改成"未来一段"
论文:Zhao et al. , Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware , RSS 2023。
论文:https://arxiv.org/abs/2304.13705
ACT 本身不是 VLA,但它对后来 VLA 的动作表示影响非常大。它用条件 VAE(CVAE)和 Transformer 一次预测未来一段动作,而不是每次只预测 a t a_t at。
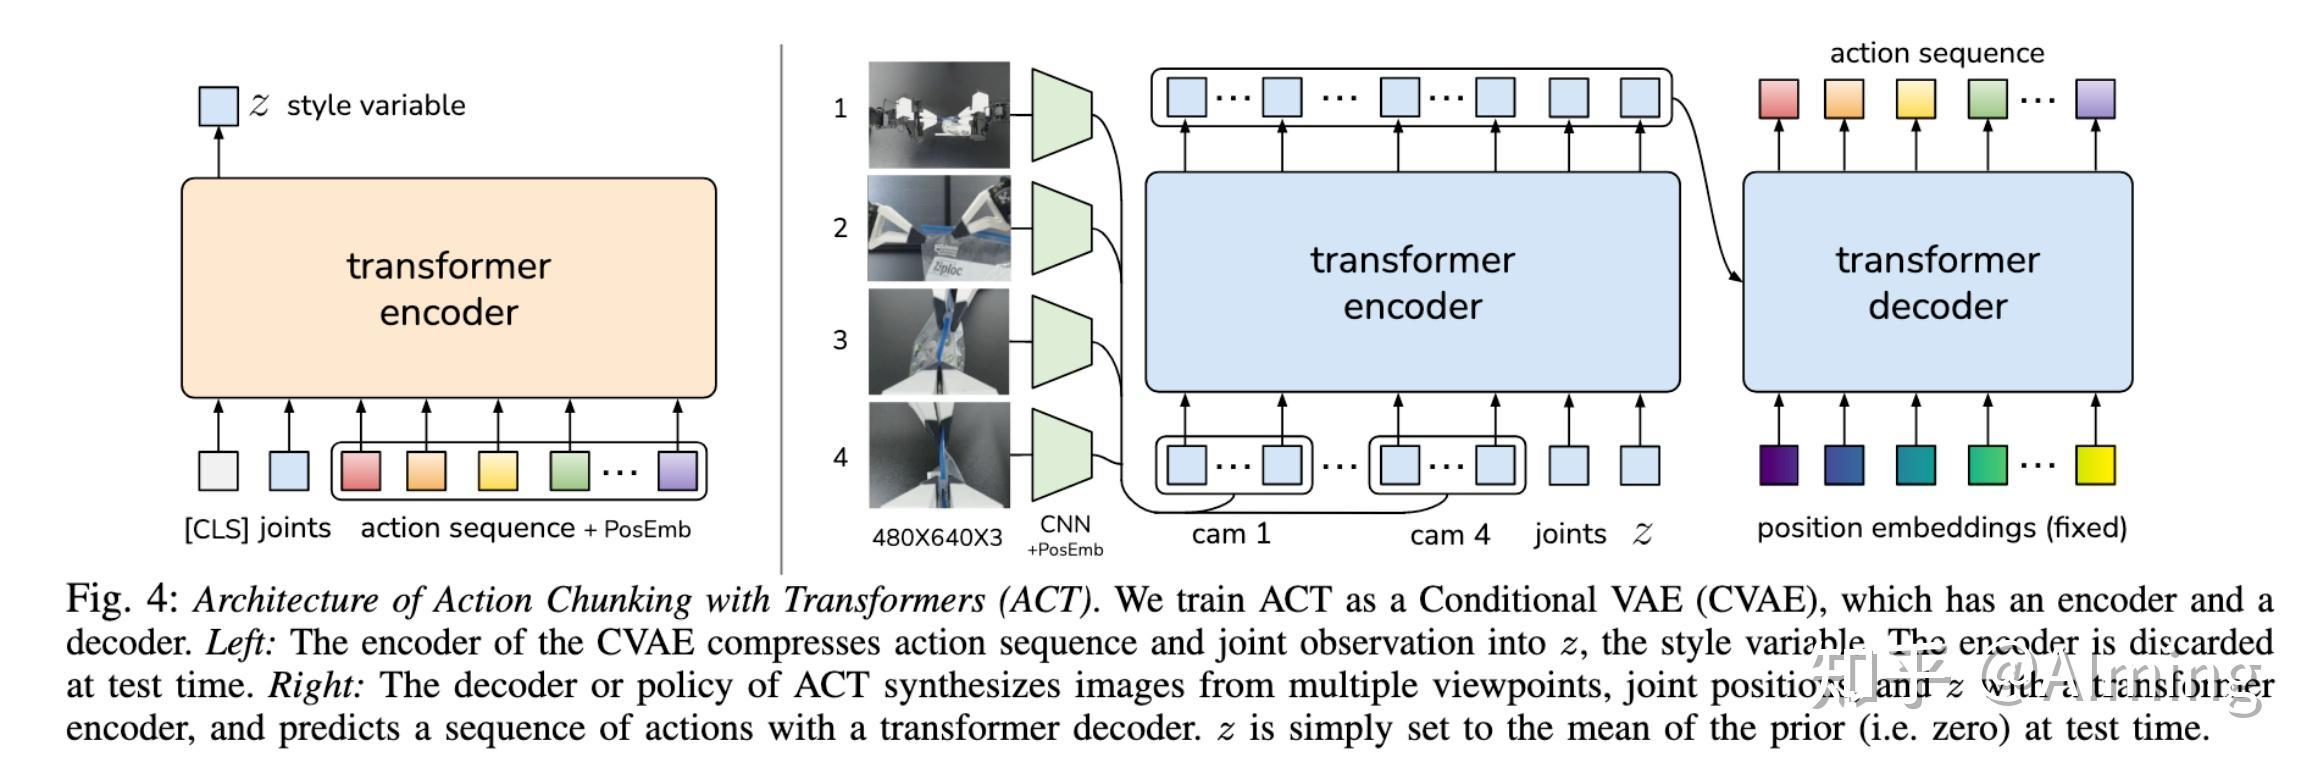
图 9 ACT 原论文 / ALOHA 官方算法架构图。CVAE encoder 将示范动作块压缩为 style variable z z z,camera / joint observations 与 z z z 一起进入 Transformer encoder-decoder,一次预测未来 action chunk。来源:Zhao et al., Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware;作者官方项目原图:<images/original/fig08_act_architecture.png>。
ACT 的 CVAE 目标可以写成
L A C T = E q ϕ ( z ∣ A , o ) ∥ A − A \^ ∥ 1 + β D K L ( q ϕ ( z ∣ A , o ) ∥ N ( 0 , I ) ) . \mathcal L_{ACT}=\mathbb E_{q_\phi(z\mid A,o)}\left\\\|A-\\hat A\\\|_1\\right+\beta D_{KL}\left(q_\phi(z\mid A,o)\|\mathcal N(0,I)\right). LACT=Eqϕ(z∣A,o)∥A−A\^∥1+βDKL(qϕ(z∣A,o)∥N(0,I)).
动作块的意义是把有效决策步数从 T T T 降到近似 T / H T/H T/H,从而减少长时序行为克隆的误差累积。同时,重叠动作块可以通过 temporal ensembling 平滑:
a t = ∑ i w i a ^ t ∣ i ∑ i w i . a_t=\frac{\sum_i w_i\hat a_{t\mid i}}{\sum_iw_i}. at=∑iwi∑iwia^t∣i.
后来的 OpenVLA-OFT、π₀、GR00T、SmolVLA 都不再满足于"单步离散动作",action chunk 已经成为现代 VLA 的常见设计。
10. Diffusion Policy:把机器人控制看成条件轨迹生成
论文:Chi et al. , Diffusion Policy: Visuomotor Policy Learning via Action Diffusion , RSS 2023 / IJRR。
论文:https://arxiv.org/abs/2303.04137
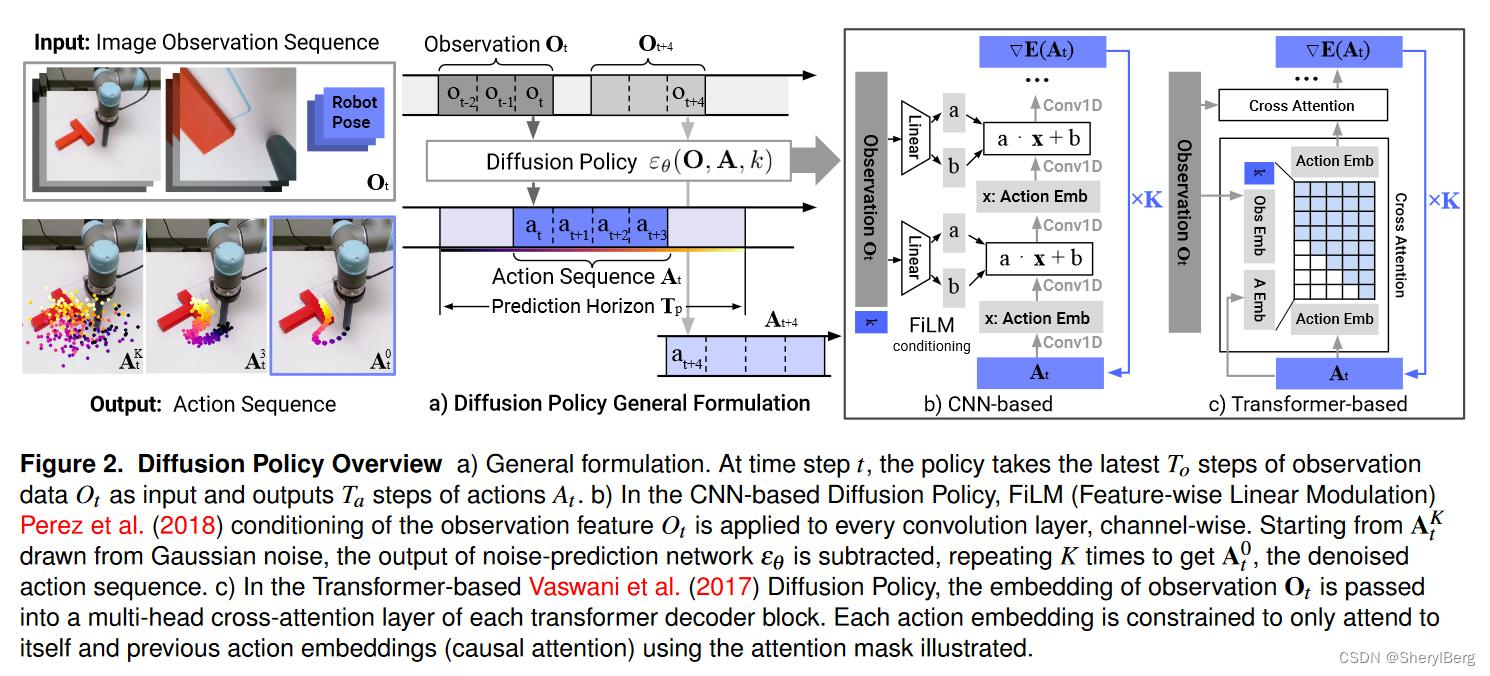
图 10 Diffusion Policy 的观测窗口、预测窗口与执行窗口。原论文 Figure 2 同时给出 CNN + FiLM 与 Transformer 两类实现,核心是以条件去噪方式一次生成连续动作序列,而不是逐维离散分类。来源:Chi et al., Diffusion Policy: Visuomotor Policy Learning via Action Diffusion;原图:<images/original/fig09_diffusion_policy_figure2.png>。
Diffusion Policy 也不是 VLA,因为它并不以大型视觉语言模型为语义骨干;但它奠定了 VLA 中"连续生成式 Action Head"的技术基础。
给定干净动作块 A A A,扩散过程逐步加噪:
A k = α ˉ k A + 1 − α ˉ k ϵ , ϵ ∼ N ( 0 , I ) , A^k=\sqrt{\bar\alpha_k}A+\sqrt{1-\bar\alpha_k}\epsilon, \quad \epsilon\sim\mathcal N(0,I), Ak=αˉk A+1−αˉk ϵ,ϵ∼N(0,I),
训练网络预测噪声:
L d i f f = E k , ϵ ∥ ϵ − ϵ θ ( A k , o , k ) ∥ 2 2 . \mathcal L_{diff}=\mathbb E_{k,\epsilon}\left\|\epsilon-\epsilon_\theta(A^k,o,k)\right\|_2^2. Ldiff=Ek,ϵ ϵ−ϵθ(Ak,o,k) 22.
推理时从噪声动作序列开始,多步反向去噪得到可执行动作。与逐维离散 token 相比,Diffusion 的优势是可以更自然地表达连续、多峰、时间相关的动作分布。
这一点对双臂操作、柔性物体、插拔、擦拭等任务尤其重要:同一个目标往往存在多条正确轨迹,动作维度之间也具有强耦合。2024---2025 年大量 VLA 因此转向"VLM 负责语义 + Diffusion/Flow 动作专家负责运动"的结构。
第四阶段:跨本体数据和开源通用策略(2023---2024)
11. Open X-Embodiment / RT-X:模型扩展之前,先统一机器人数据
论文:Open X-Embodiment Collaboration et al. , Open X-Embodiment: Robotic Learning Datasets and RT-X Models , ICRA 2024。
论文:https://arxiv.org/abs/2310.08864
Open X-Embodiment(OXE)把来自大量实验室、不同机器人、不同相机、不同动作空间的数据统一成可联合训练的形式。其真正贡献不只是"数据更多",而是推动了三个标准化问题:
- 不同本体如何统一 episode、observation、action 表示;
- 不同动作单位、坐标系和控制频率如何归一化;
- 不同任务语言和数据质量如何在同一训练混合中共存。
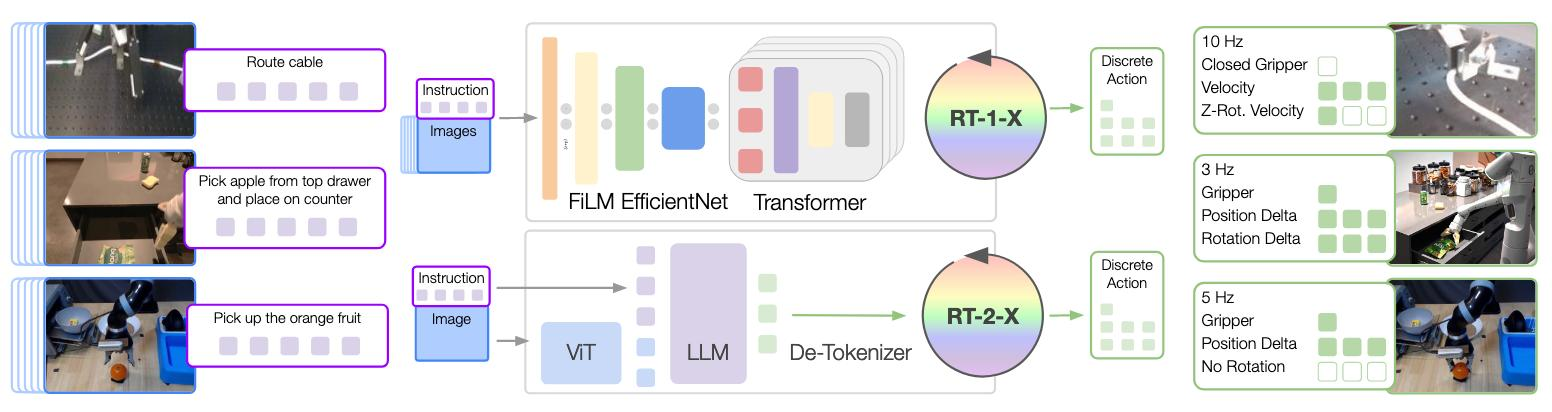
图 11 Open X-Embodiment / RT-X 的官方 Model Overview。不同机器人数据先被映射到统一的数据接口,再用于训练跨本体 RT-X 策略,核心价值在于让 heterogeneous embodiment data 可以进入同一训练分布。来源:Open X-Embodiment Collaboration et al., Open X-Embodiment: Robotic Learning Datasets and RT-X Models;原图:<images/original/fig10_rtx_algorithm.png>。
Open X-Embodiment 使 VLA 的研究瓶颈发生变化:此前大家主要讨论"网络怎么设计",此后必须同时讨论数据混合、动作标准化、embodiment metadata 和后训练适配。
12. Octo:跨本体数据 + Transformer + Diffusion 的开源通用机器人策略
论文:Ghosh et al. , Octo: An Open-Source Generalist Robot Policy , RSS 2024。
论文:https://www.roboticsproceedings.org/rss20/p090.html
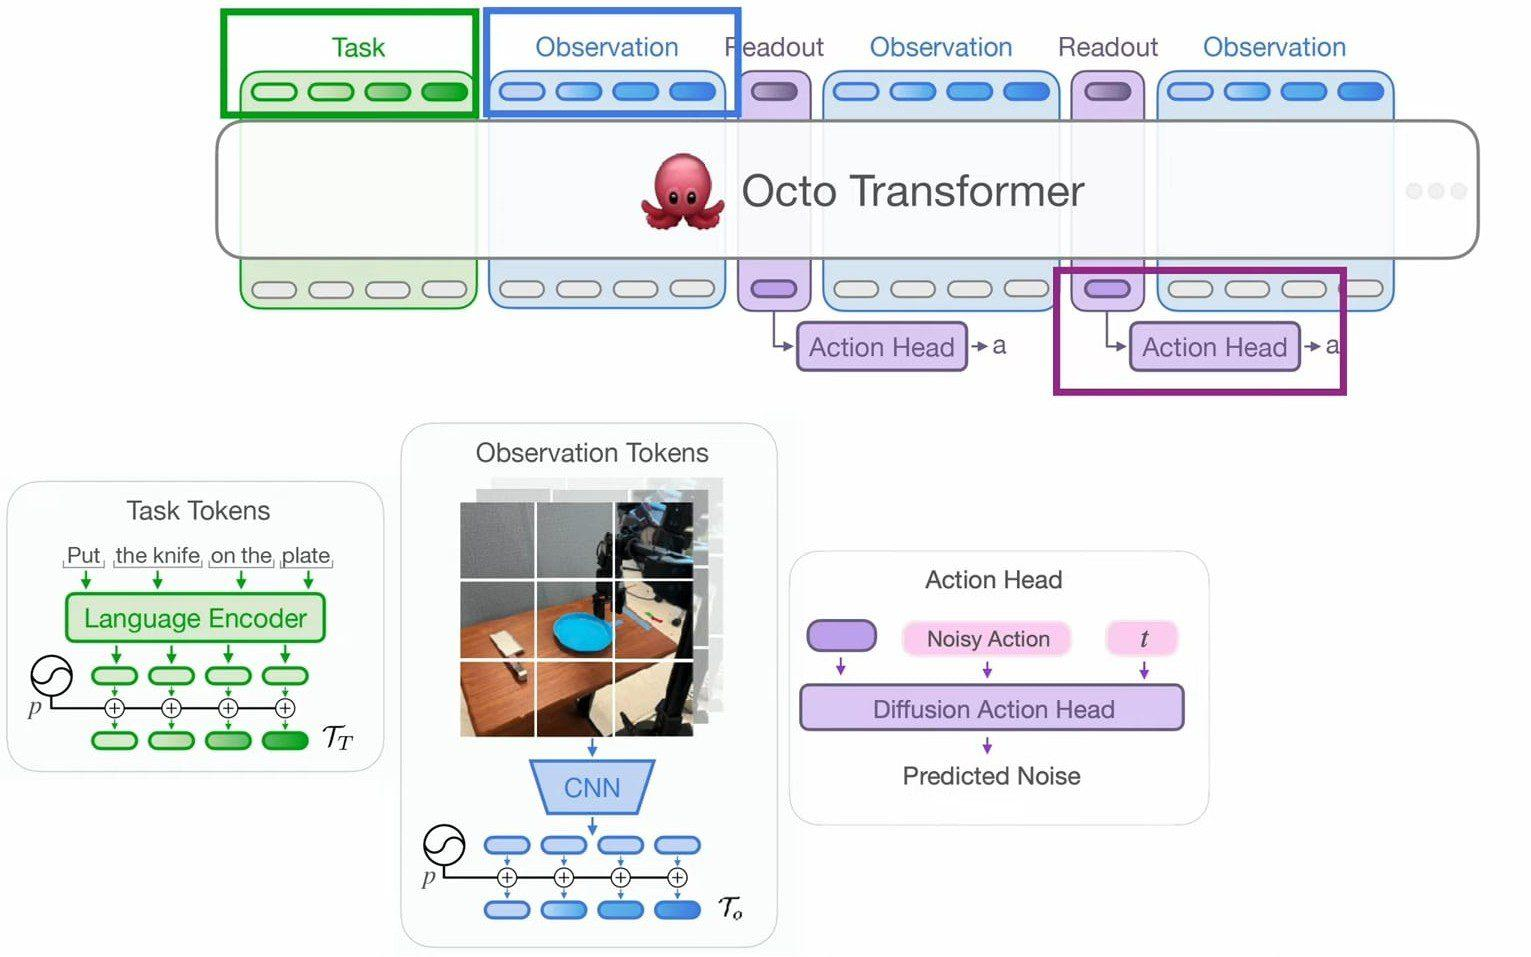
图 12 Octo 官方模型架构。不同任务定义、观测和机器人状态经 tokenization 后进入 Transformer backbone,再由 readout heads / diffusion action head 适配不同动作空间。来源:Ghosh et al., Octo: An Open-Source Generalist Robot Policy;原图:<images/original/fig11_octo_architecture.jpg>。
Octo 在约 80 万条 Open X-Embodiment 轨迹上预训练,支持语言或目标图像条件,并能适配新的传感器输入和动作空间。与 RT-2 相比,Octo 没有把所有重点都压在巨型 VLM 上,而是更强调可迁移的机器人策略初始化。
它的重要意义在于将两条路线合流:
text
跨本体大规模机器人数据
        +
灵活任务条件(language / goal image)
        +
Transformer 表征
        +
Diffusion 动作输出
        ↓
可快速微调到新机器人、新传感器和新动作空间
因此,Octo 可以被看作从"动作 token VLA"迈向"生成式机器人 foundation policy"的桥梁。
13. OpenVLA:把 RT-2 路线真正开源化
论文:Kim et al. , OpenVLA: An Open-Source Vision-Language-Action Model , CoRL 2024。
论文:https://arxiv.org/abs/2406.09246
OpenVLA 是开源 VLA 生态的重要节点。模型将视觉编码器(DINOv2 + SigLIP 的融合表征)投影到 Llama 系列语言模型空间,再以离散动作 token 输出机器人控制。
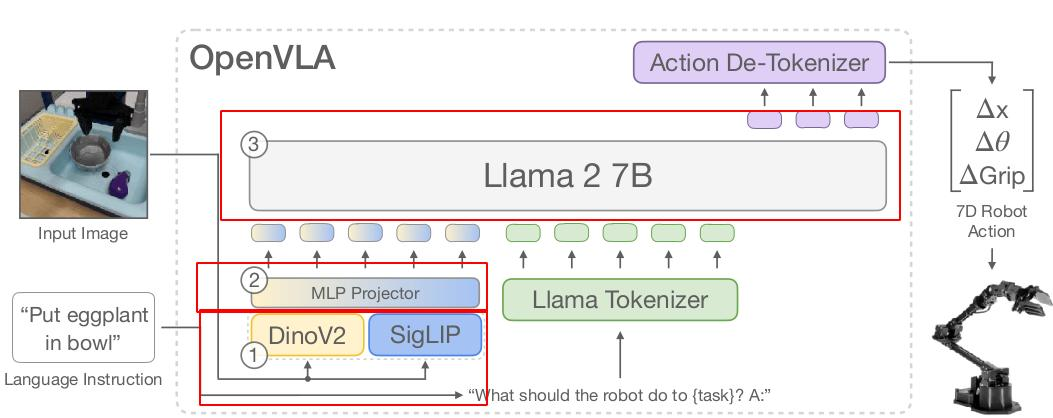
图 13 OpenVLA 模型架构。官方原图展示融合视觉编码器、投影层、语言模型与动作 token 解码的完整数据流。来源:Kim et al., OpenVLA: An Open-Source Vision-Language-Action Model;原图:<images/original/fig12_openvla_model.jpg>。
OpenVLA 的价值主要体现在:
- 给出完整开放的 VLA 权重、训练和微调路径;
- 证明较小的开源 VLA 也能在机器人基准上获得强泛化;
- 让 LoRA、量化、不同机器人数据微调等工程问题进入主流 VLA 研究。
但它同样保留了 RT-2 风格的动作 token 瓶颈。OpenVLA 官方代码也明确提醒,高频控制数据通常需要适当降采样;这成为后续 OpenVLA-OFT 大改动作头与解码方式的直接动机。
第五阶段:VLM 不再直接"说动作",Action Expert 成为主角(2024---2025)
14. RDT-1B:把 Diffusion Transformer 做成机器人动作基础模型
论文:Liu et al. , RDT-1B: a Diffusion Foundation Model for Bimanual Manipulation , ICLR 2025。
论文:https://arxiv.org/abs/2410.07864
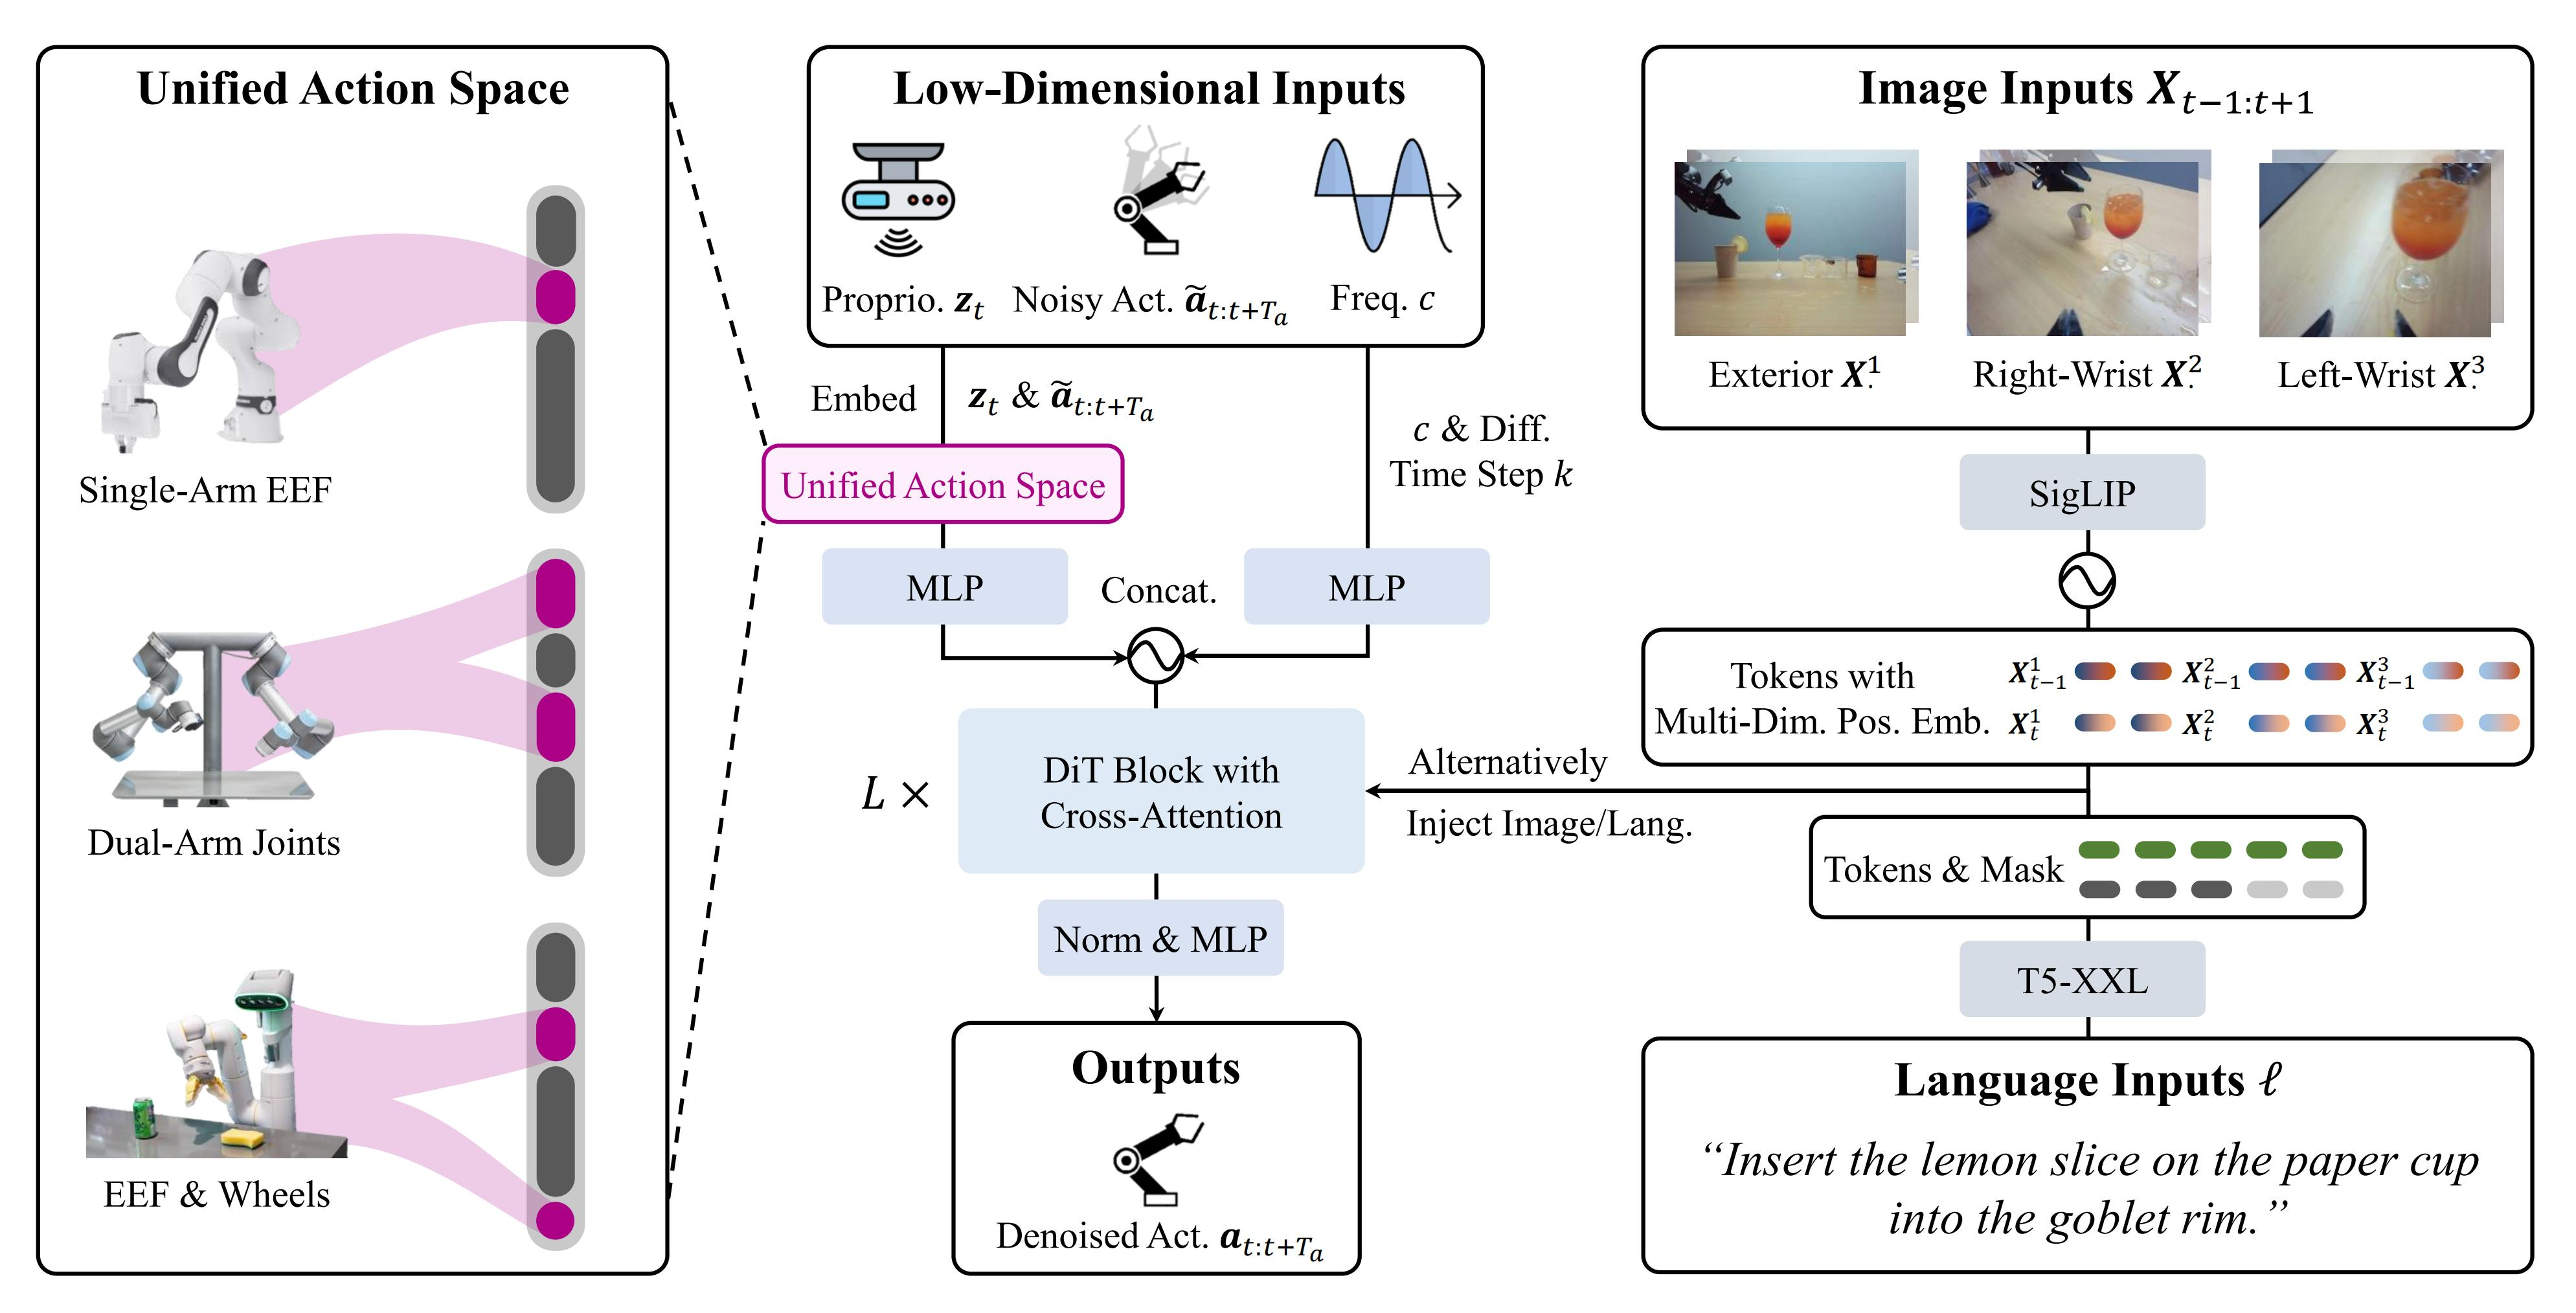
图 14 RDT-1B 官方 Framework。图像、语言与本体状态被编码为条件,Diffusion Transformer 直接在高维连续动作空间中生成双臂动作序列,并通过统一动作表示适配不同机器人。来源:Liu et al., RDT-1B: a Diffusion Foundation Model for Bimanual Manipulation;原图:<images/original/fig13_rdt1b_framework.png>。
RDT-1B 把动作生成本身提升到 foundation model 的地位。它使用大规模多机器人数据预训练 Diffusion Transformer,并重点解决不同机器人动作空间不一致的问题。与 RT-2/OpenVLA 的"语言模型输出离散动作"不同,RDT 更接近
condition tokens → Diffusion Transformer → A t : t + H − 1 . \text{condition tokens} \rightarrow \text{Diffusion Transformer} \rightarrow A_{t:t+H-1}. condition tokens→Diffusion Transformer→At:t+H−1.
其启发是:机器人动作分布可能值得拥有自己的大模型,而不是永远附着在语言 token 头上。这一思想与 π₀ 的 Action Expert、GR00T 的 DiT action head 在 2025 年形成明显汇流。
15. π₀:VLM + Flow Matching Action Expert,现代 VLA 结构的代表
论文:Black et al. , π₀: A Vision-Language-Action Flow Model for General Robot Control , RSS 2025。
论文:https://www.roboticsproceedings.org/rss21/p010.html
π₀ 是 VLA 演进中第二个非常明确的结构分水岭。它不再让一个语言模型独自承担所有动作生成,而是使用预训练 VLM + 专用 Action Expert。视觉和语言走语义主干,机器人状态和带噪动作进入动作专家,两者通过注意力交互。
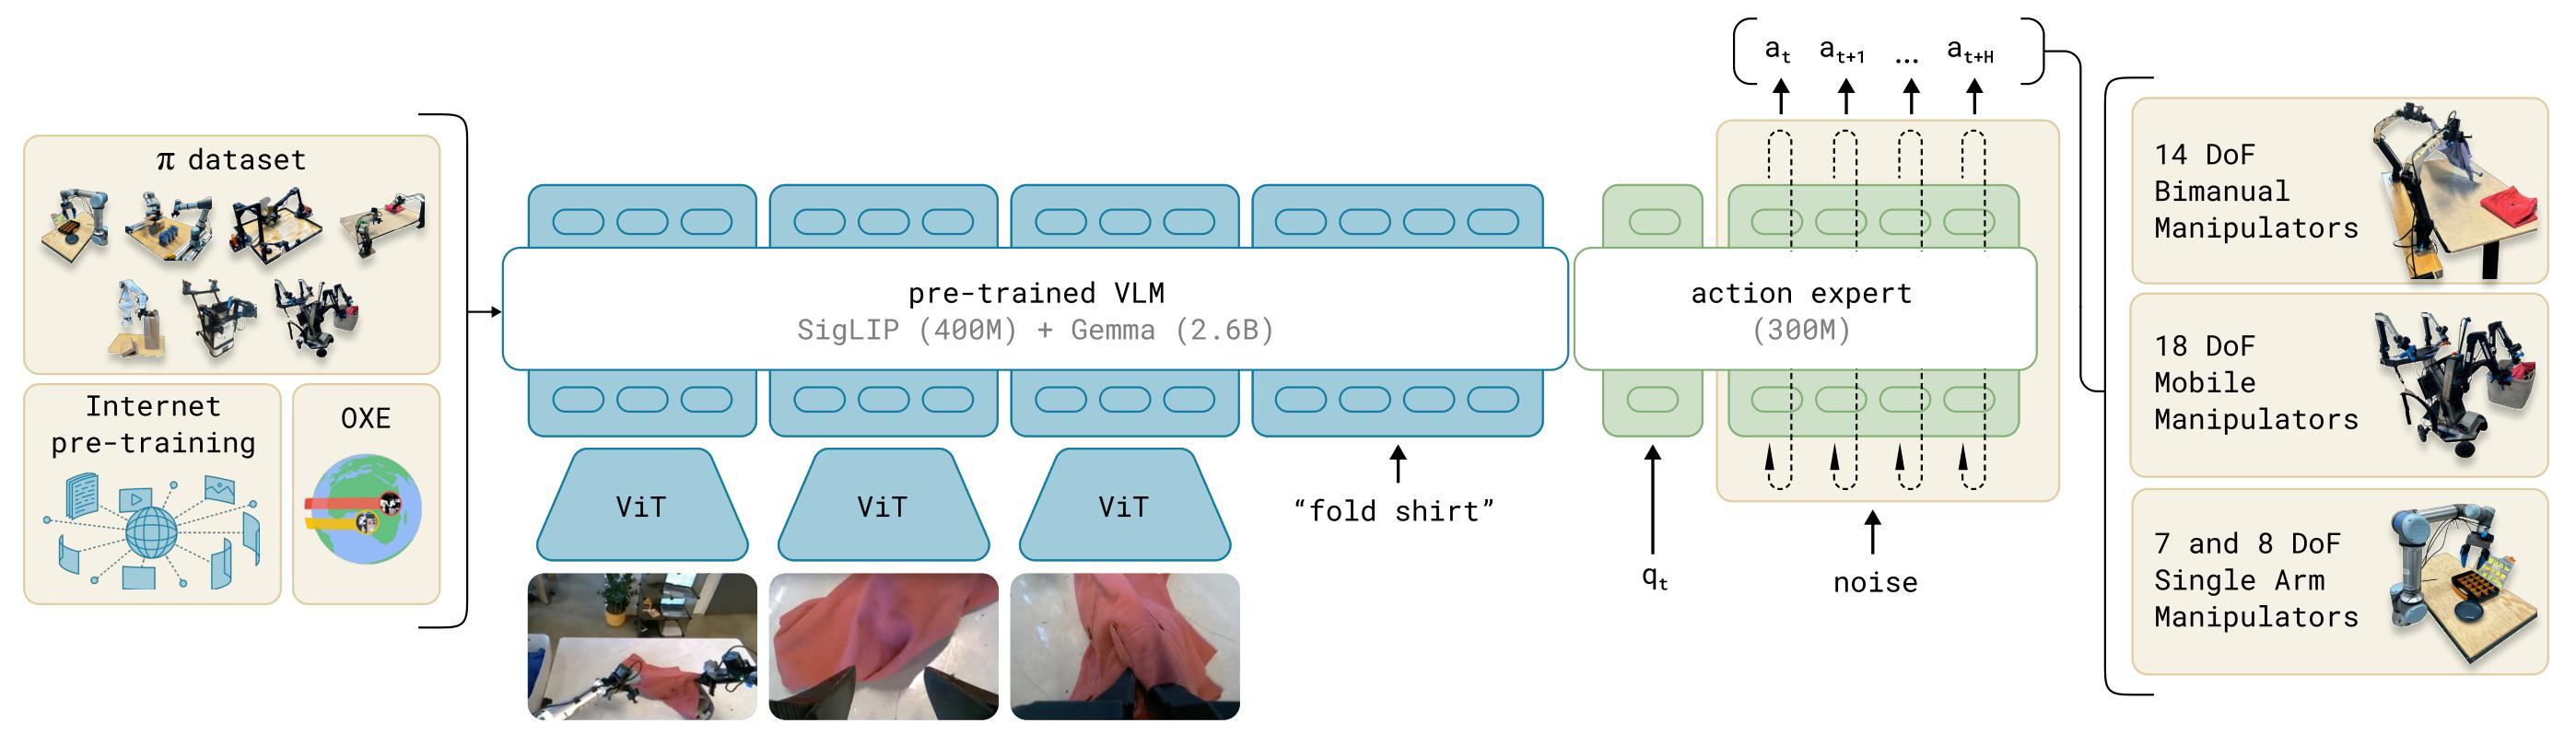
图 15 π₀ 的 VLM + Action Expert 架构。原论文 Figure 3:预训练 VLM 提供视觉语言语义表征,机器人状态与带噪动作进入专用 Action Expert,并通过 Flow Matching 生成连续动作块。来源:Black et al., π₀: A Vision-Language-Action Flow Model for General Robot Control;原图:<images/original/fig14_pi0_figure3.png>。
π₀ 的 Action Expert 使用 Flow Matching。令真实动作块为 A A A,高斯噪声为 ϵ ∼ N ( 0 , I ) \epsilon\sim\mathcal N(0,I) ϵ∼N(0,I),构造插值路径
A τ = τ A + ( 1 − τ ) ϵ , τ ∈ 0 , 1 . A^\tau=\tau A+(1-\tau)\epsilon, \qquad \tau\in0,1. Aτ=τA+(1−τ)ϵ,τ∈0,1.
目标向量场为
u ( A τ ∣ A ) = A − ϵ . u(A^\tau\mid A)=A-\epsilon. u(Aτ∣A)=A−ϵ.
网络训练为
L F M = E A , ϵ , τ ∥ v θ ( A τ , o ) − ( A − ϵ ) ∥ 2 2 . \mathcal L_{FM}=\mathbb E_{A,\epsilon,\tau}\left\|v_\theta(A^\tau,o)-\left(A-\epsilon\right)\right\|_2^2. LFM=EA,ϵ,τ∥vθ(Aτ,o)−(A−ϵ)∥22.
推理时从噪声动作开始沿向量场积分,例如 Euler 步:
A τ + Δ τ = A τ + Δ τ v θ ( A τ , o ) . A^{\tau+\Delta\tau}=A^\tau+\Delta\tau\,v_\theta(A^\tau,o). Aτ+Δτ=Aτ+Δτvθ(Aτ,o).
Flow Matching 相比 Diffusion 的意义
两者都属于连续生成式模型,但 Flow Matching 可以把训练理解为直接学习"从噪声流向动作数据"的速度场,推理时用较少 ODE 积分步数完成生成。对机器人来说,推理步数直接关系控制延迟,因此这种结构非常适合高频动作块生成。
π₀ 的核心贡献不是"用了更大的 VLM",而是把 VLA 的结构明确拆成:
text
语义世界模型 / VLM       运动生成模型 / Action Expert
理解物体、语言、任务      生成连续、高维、时间相关动作块
          \                 /
           \------ attention ------/
                   ↓
            可执行连续动作
从这里开始,现代 VLA 的主要问题从"如何把动作塞进语言模型"转向"语义特征如何高效条件化一个专门的动作生成器"。
16. CogACT:把"认知"和"动作"显式分工
论文:Li et al. , CogACT: A Foundational Vision-Language-Action Model for Synergizing Cognition and Action in Robotic Manipulation , 2024。
论文:https://arxiv.org/abs/2411.19650
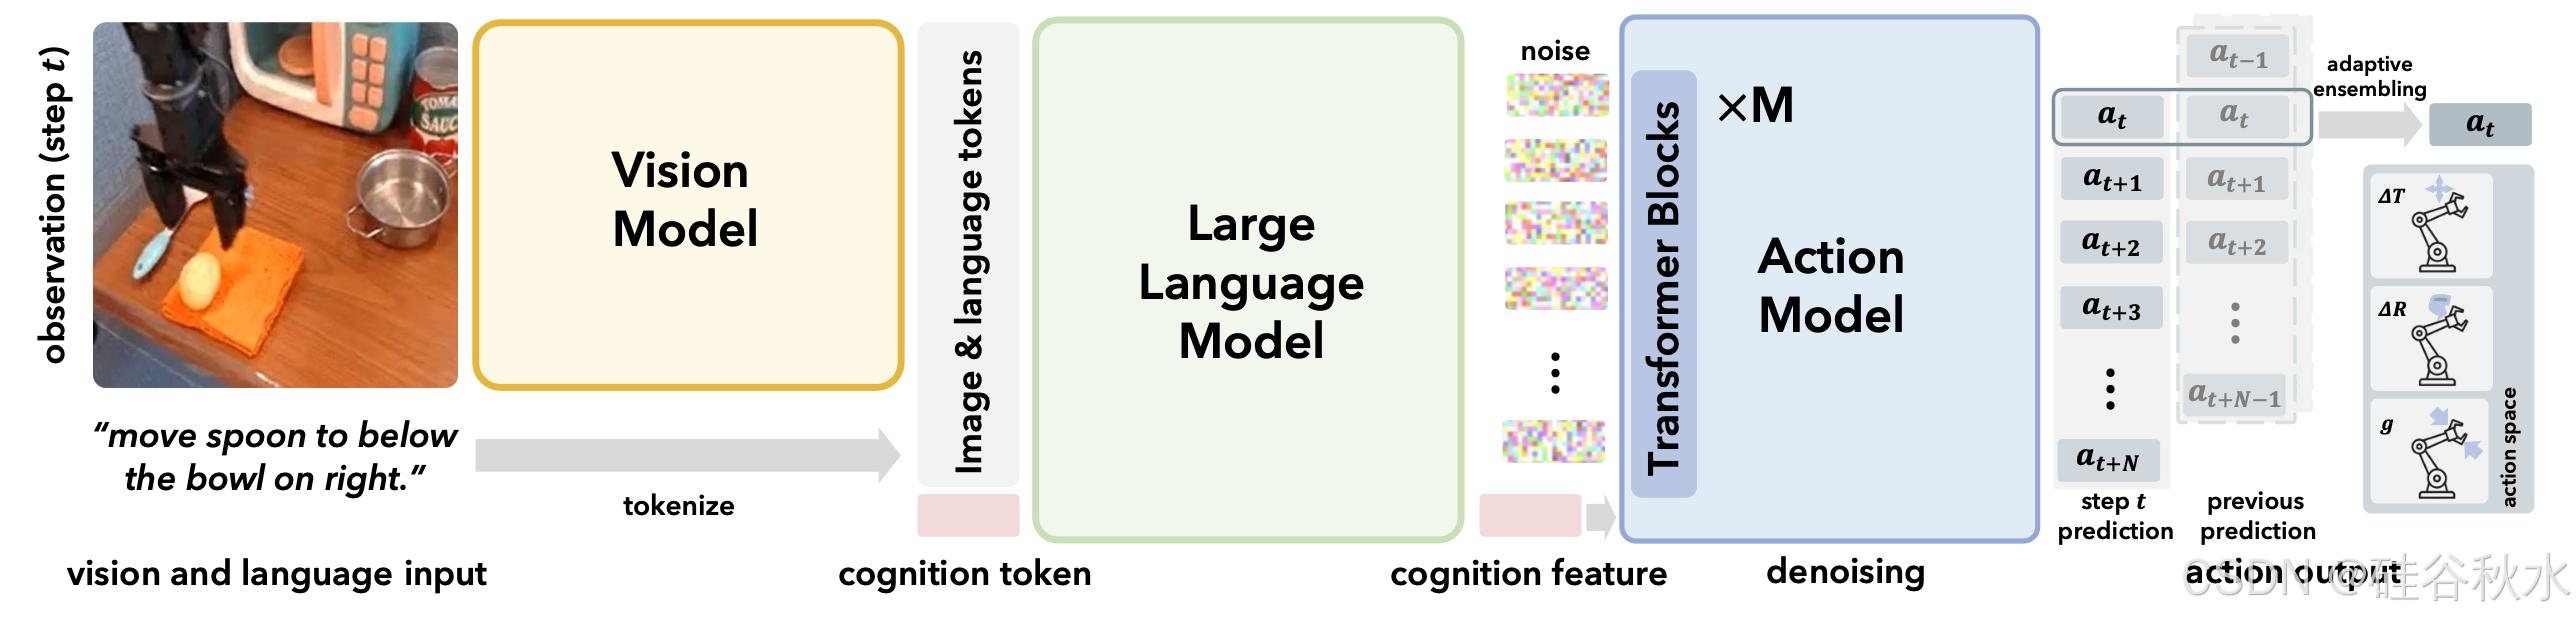
图 16 CogACT 官方模型架构。视觉语言认知模块负责抽象语义与场景理解,专用 action module / diffusion Transformer 负责连续动作生成,体现"Cognition--Action"显式分工。来源:Li et al., CogACT: A Foundational Vision-Language-Action Model for Synergizing Cognition and Action in Robotic Manipulation;原图:<images/original/fig15_cogact_model.png>。
CogACT 同样采用"强视觉语言认知模块 + 专用连续动作模块"的思路。视觉侧使用 DINOv2、SigLIP 等表征,语言侧由大型语言模型承载语义,再由 diffusion action Transformer 生成动作。
CogACT 的意义在于强化了一个正在形成的共识:
VLM 的目标是语义抽象,不应被迫承担所有高频运动细节;Action Model 的目标是物理轨迹分布,不必重复学习整个互联网语义世界。
这种模块化并不意味着两者完全独立,关键在于中间的认知特征如何作为动作条件,并通过联合训练让"看懂"真正影响"做对"。
第六阶段:动作表示反过来决定 VLA 的训练效率(2025)
17. FAST:不放弃 Token,但把 Token 从"逐维量化"升级为"频域压缩"
论文:Pertsch et al. , FAST: Efficient Action Tokenization for Vision-Language-Action Models , 2025。
论文:https://arxiv.org/abs/2501.09747
FAST 提出了非常关键的问题:自回归 VLA 真正失败的可能不是"token 化本身",而是使用了过于幼稚的逐时间步、逐动作维度量化。
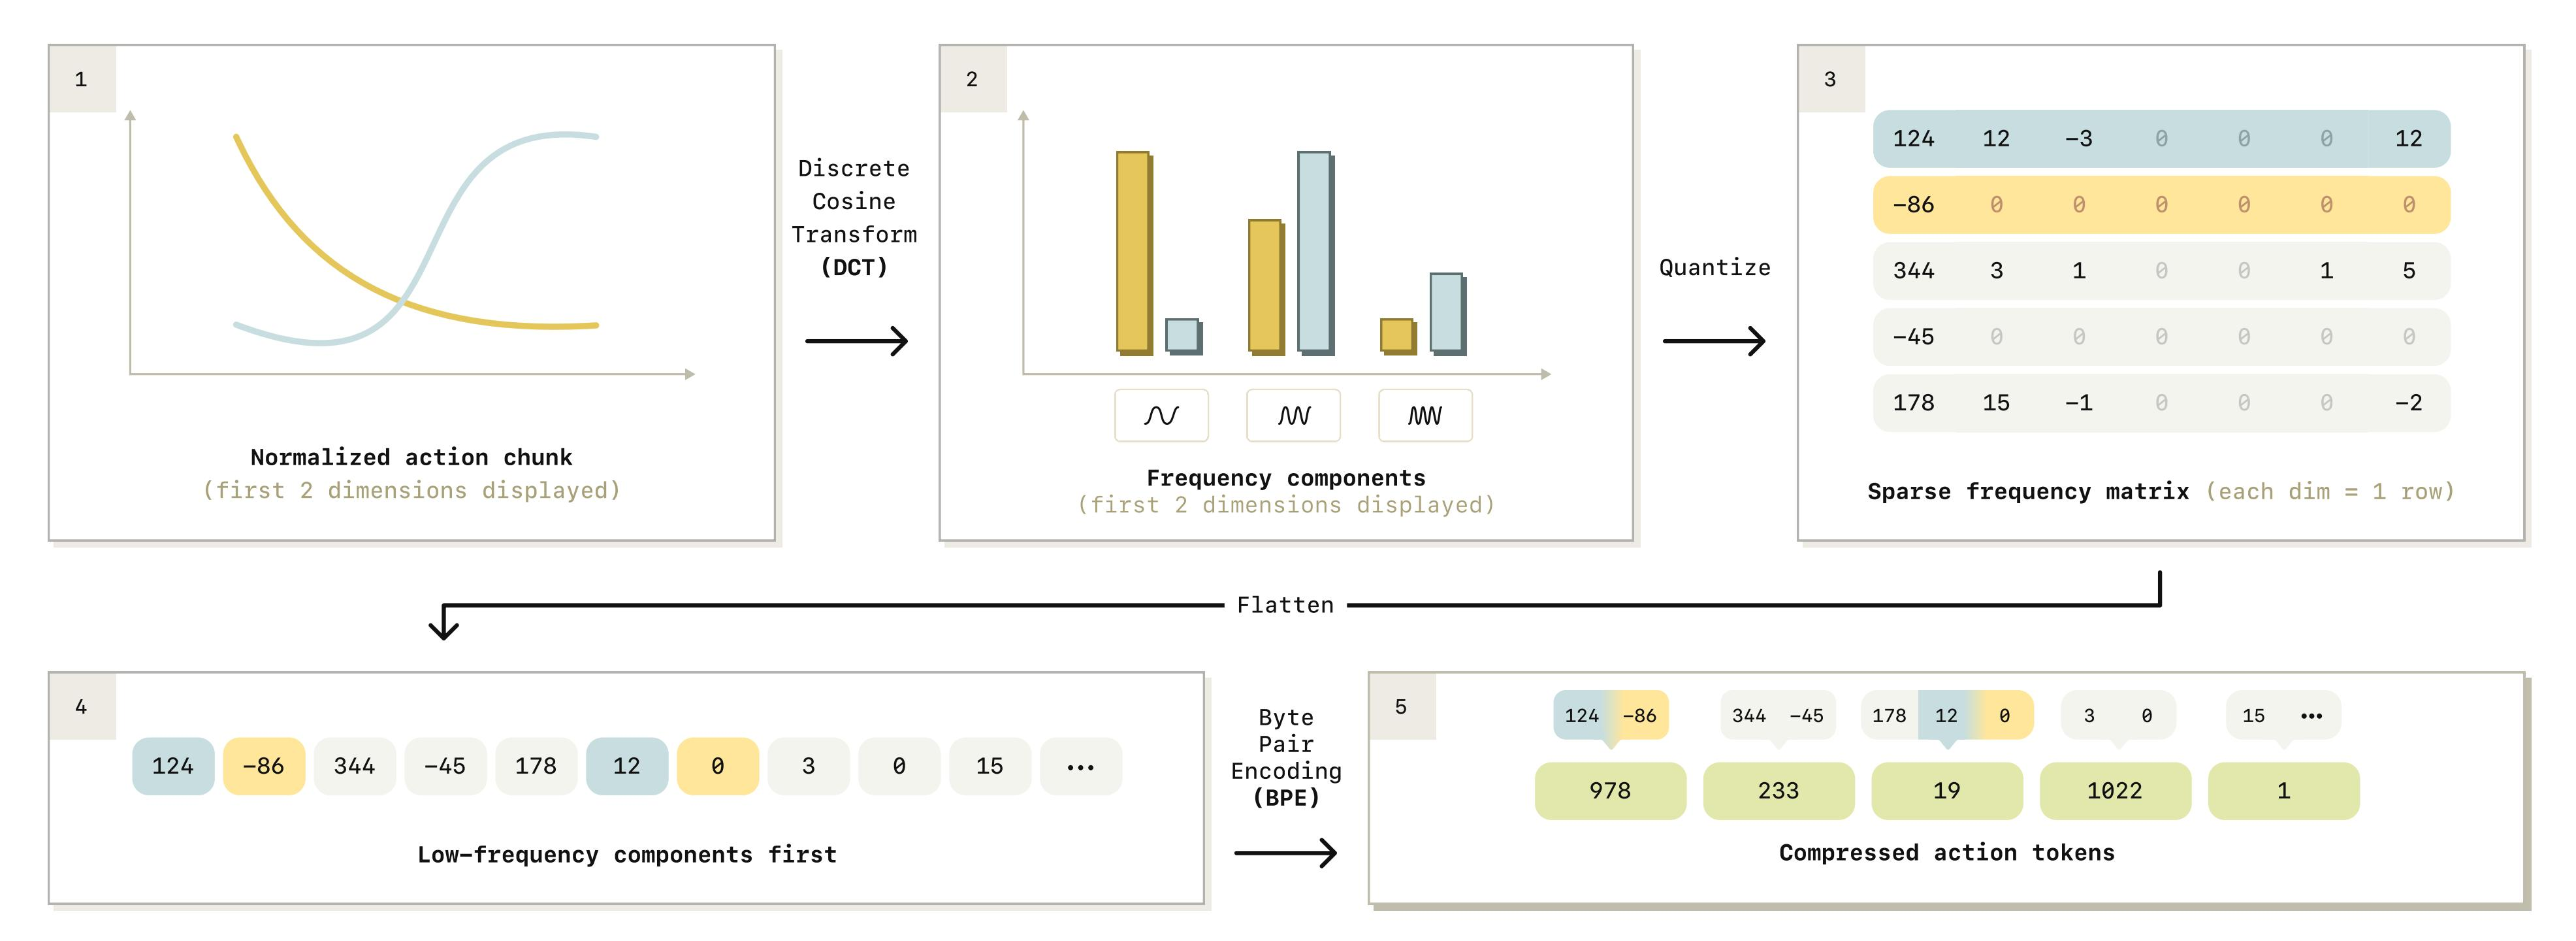
图 17 FAST 原论文 Figure 4。动作块先标准化,再进行 DCT 频域变换、量化与低频优先展平,随后通过 BPE 压缩为紧凑的动作 token 序列。来源:Pertsch et al., FAST: Efficient Action Tokenization for Vision-Language-Action Models;原图:<images/original/fig16_fast_figure4.png>。
对长度 H H H 的动作序列,每个动作维度做 DCT-II:
C k , d = α k ∑ n = 0 H − 1 a n , d cos π H ( n + 1 2 ) k . C_{k,d}=\alpha_k\sum_{n=0}^{H-1}a_{n,d}\cos\left\\frac{\\pi}{H}\\left(n+\\frac12\\right)k\\right. Ck,d=αkn=0∑H−1an,dcosHπ(n+21)k.
然后量化
C ˉ = r o u n d ( γ C ) , \bar C=\mathrm{round}(\gamma C), Cˉ=round(γC),
再按低频到高频展开,并用 BPE(Byte Pair Encoding)做无损序列压缩。低频成分描述动作总体趋势,往往比逐时间步坐标更容易被序列模型预测。
FAST+ 则进一步将 tokenizer 在百万级真实机器人动作轨迹上训练成通用动作 tokenizer。其意义是把"动作词表"从人为均匀量化,升级成符合机器人时间序列统计结构的压缩编码。
18. OpenVLA-OFT:直接把离散自回归动作头改成连续并行 Action Chunk
论文:Kim et al. , Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success , 2025。
论文:https://arxiv.org/abs/2502.19645
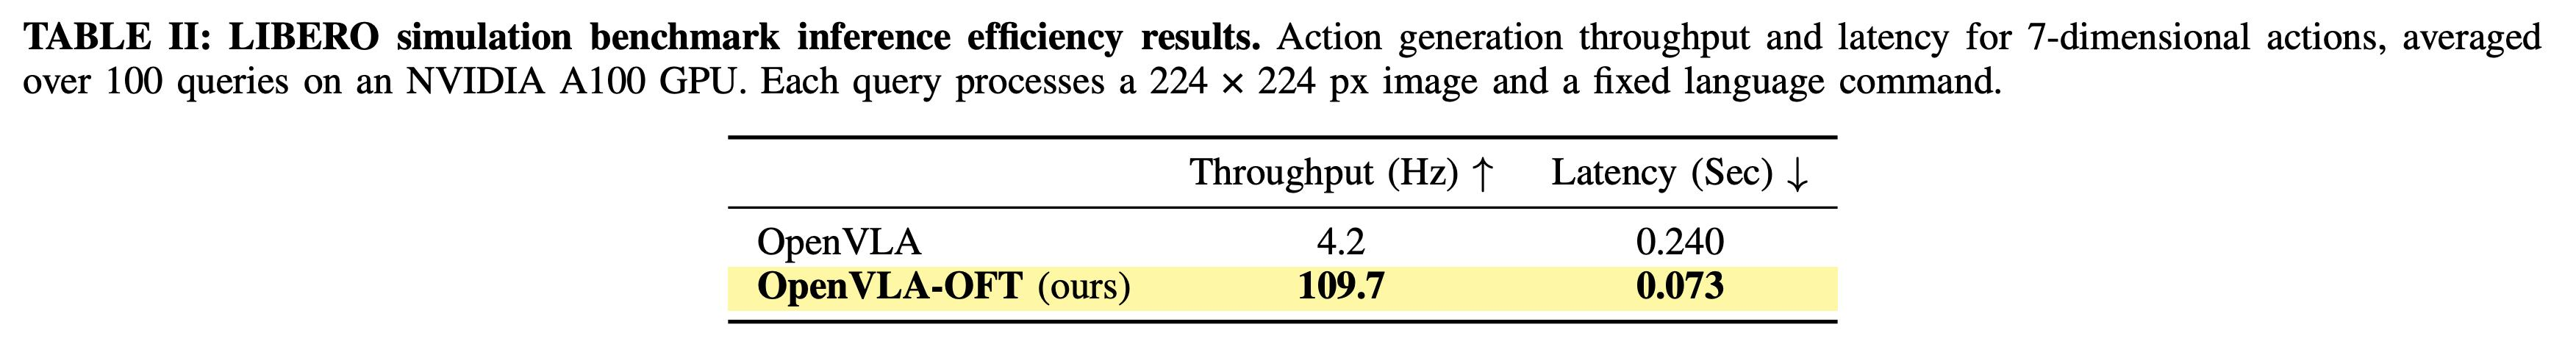
图 18 OpenVLA-OFT 官方推理效率结果。该图直接展示 OFT 在改变动作解码策略后带来的动作生成吞吐与推理效率变化,用于对应本节"并行连续 Action Chunk + 高效微调"的工程动机。来源:Kim et al., Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success;原图:<images/original/fig17_openvla_oft_inference_efficiency.png>。
OpenVLA-OFT 给出了一个很有说服力的实验事实:**保留强 VLM 主干的同时,单纯修改动作解码方式,就能同时提高任务成功率和推理速度。**其 OFT 配方包括并行解码、action chunking、连续动作表示和 L 1 L_1 L1 回归。
L O F T = 1 H d ∥ A ^ − A ∥ 1 . \mathcal L_{OFT}=\frac{1}{Hd}\|\hat A-A\|_1. LOFT=Hd1∥A^−A∥1.
官方项目页报告 OpenVLA-OFT 在 LIBERO 四个套件平均成功率达到 97.1%,并给出约 25--50 倍更快的动作生成范围。这里必须注意:这是特定模型、硬件和基准条件下的结果,不能直接等价为所有真实机器人控制的同比加速。
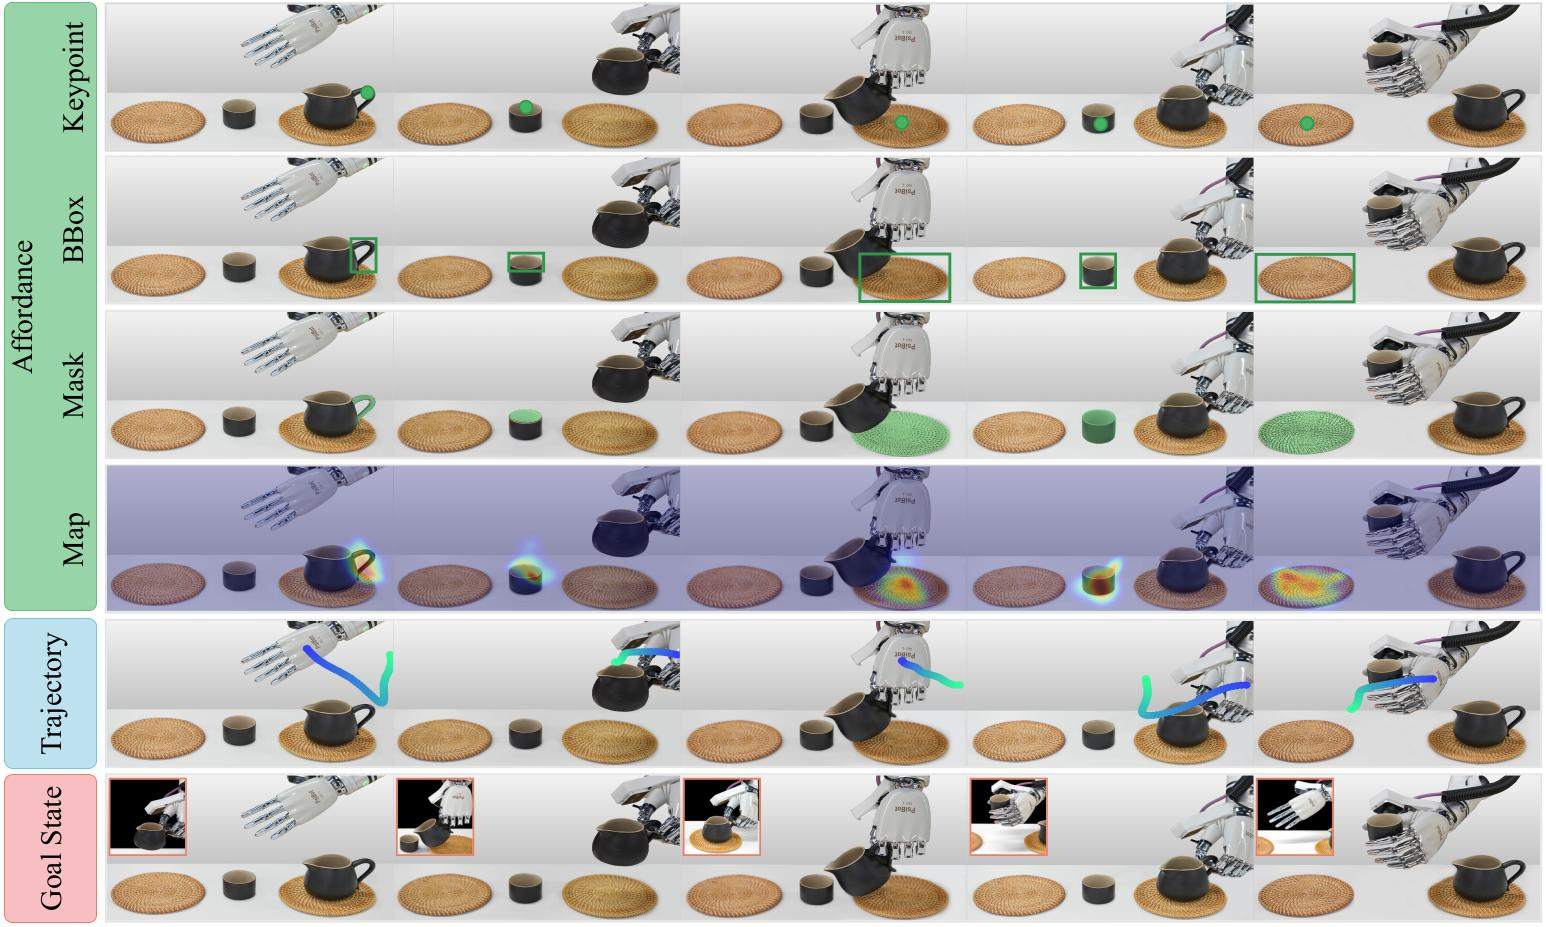
图 19 VLA Action Token 的统一分类。采用 Zhong et al., A Survey on Vision-Language-Action Models: An Action Tokenization Perspective 原论文 Figure 2:在同一具身任务下比较 language description、code、affordance、trajectory、goal state、latent representation、raw action 与 reasoning 等 action-token 形式。原图:<images/original/fig18_action_token_taxonomy.png>。
这一工作揭示了 VLA 的一个重要工程规律:当视觉语言表示已经足够强时,最终效果可能主要受动作接口限制,而不是受 VLM 参数量限制。
在进入轻量化与多时间尺度系统之前,可以把前面的动作接口变化压缩成一条更清晰的主线:早期 VLA 通过离散动作 token 复用语言模型的序列建模能力;随后 ACT / Diffusion Policy 把预测单位从"下一步"扩展到 action chunk / 生成式轨迹;再到 π₀、RDT-1B、OFT 等方法,语义主干与连续 Action Expert 逐渐解耦。
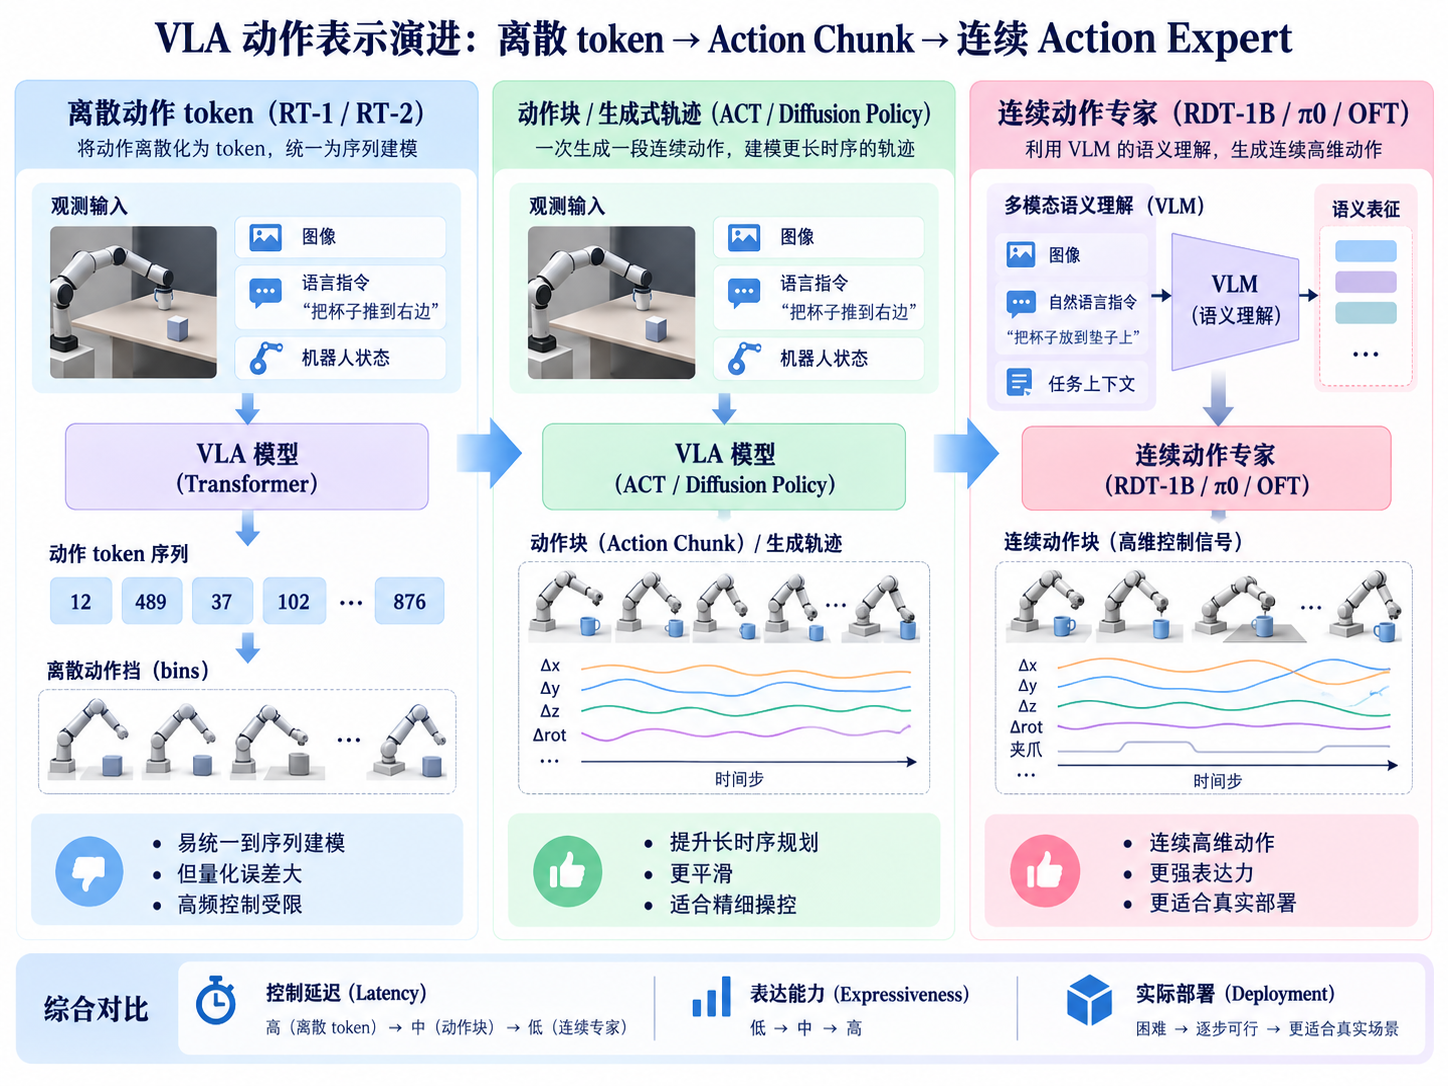
图 20 VLA 动作表示演进:离散 Token → Action Chunk / 生成式轨迹 → 连续 Action Expert。本文整理绘制,用于总结 RT-1 / RT-2、ACT / Diffusion Policy 与 RDT-1B / π₀ / OFT 在动作表示、时序建模与部署方式上的结构变化。
19. SmolVLA:450M 级轻量 VLA,把"能部署"重新放到核心位置
论文:Shukor et al. , SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics , 2025。
论文:https://arxiv.org/abs/2506.01844
代码:https://github.com/huggingface/lerobot
项目:https://huggingface.co/blog/smolvla
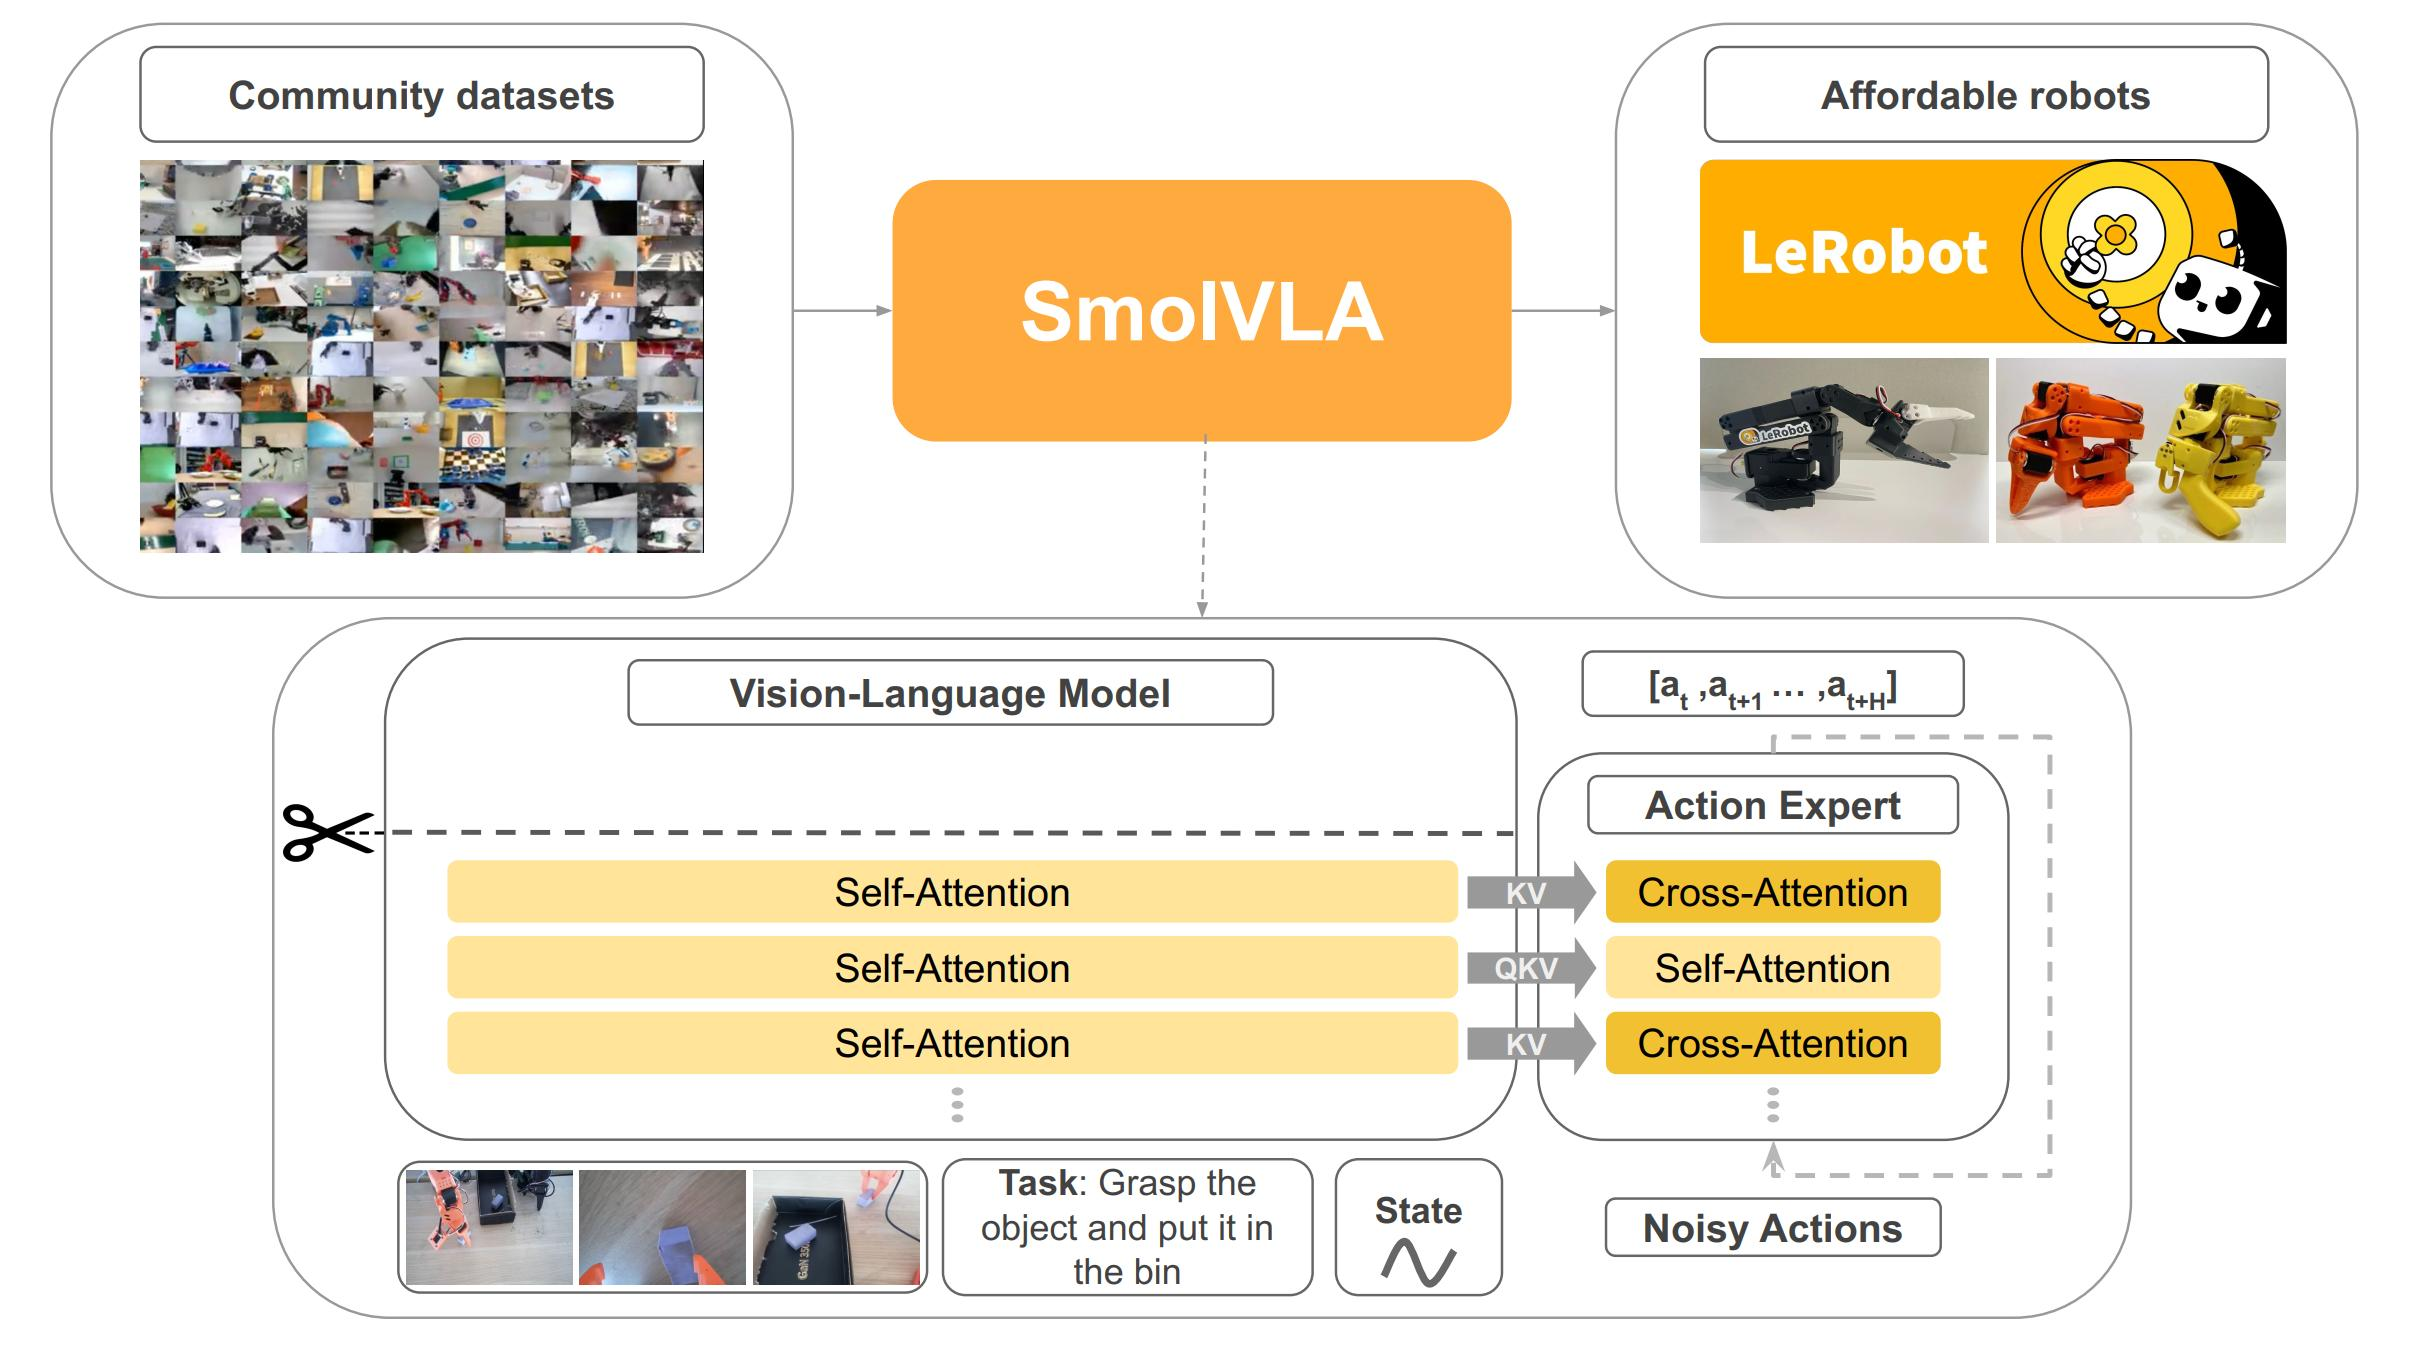
图 21 SmolVLA 官方 Figure 2。多相机视觉、本体状态与语言指令进入小型 VLM,随后通过交错 self-attention / cross-attention 的 Action Expert 生成动作块;该结构强调低参数量、较少视觉 token 与异步执行。来源:Shukor et al., SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics;原图由 Hugging Face 官方文章提供:<images/original/fig19_smolvla_figure2.png>。
SmolVLA 代表另一条重要分支:不是继续把 VLA 做大,而是通过更少视觉 token、更小 VLM、交错 self/cross-attention、flow-matching action expert 和异步推理,使 VLA 可以在消费级设备上运行。
Hugging Face 官方资料给出的模型规模约为 450M,并强调可在 CPU、消费级 GPU 等平台使用。其"异步推理"尤其值得关注:模型推理和机器人执行不必严格串行等待,而可以在当前动作块执行时预取下一动作块,从系统层面隐藏部分推理延迟。
这说明端侧 VLA 的竞争不只是参数量,更重要的是
effective control latency = model latency − latency hidden by asynchronous execution . \text{effective control latency} =\text{model latency}-\text{latency hidden by asynchronous execution}. effective control latency=model latency−latency hidden by asynchronous execution.
第七阶段:VLA 从单体模型演进为多时间尺度具身系统(2025---2026)
20. π₀.5:加入高层语义预测,面向开放世界泛化
论文:Physical Intelligence, π₀.5: a Vision-Language-Action Model with Open-World Generalization , 2025。
项目:https://www.pi.website/blog/pi05
代码:https://github.com/Physical-Intelligence/openpi
原论文图对应 :π₀.5 论文 Figure 1 给出了"异构多模态数据 / 跨本体机器人数据 → π₀.5 VLA → 新家庭环境部署"的整体框架;官方 PDF:https://www.pi.website/download/pi05.pdf。官方项目页还展示了高层 subtask prediction 与低层 Flow-Matching Action Expert 的推理关系。。
π₀.5 不再只依靠"语言指令 + 当前视觉 → 动作",而是联合训练多种异质数据,包括机器人动作、语义子任务、视觉语言数据、对象检测或高层预测等。这样模型内部开始出现更明确的高低层分工:高层描述"接下来应完成什么子任务",低层 Action Expert 生成具体动作。
这可以抽象成
z t h i g h = f s e m ( O t , L , m t ) , z_t^{high}=f_{sem}(O_t,L,m_t), zthigh=fsem(Ot,L,mt),
A t = f a c t ( O t , q t , z t h i g h ) . A_t=f_{act}(O_t,q_t,z_t^{high}). At=fact(Ot,qt,zthigh).
其中 z t h i g h z_t^{high} zthigh 不一定显式暴露为文本,但在训练目标上承担比单纯动作 token 更强的任务结构建模职责。
Knowledge Insulation:防止动作学习破坏语义主干
文章:Physical Intelligence, VLAs that Train Fast, Run Fast, and Generalize Better , 2025。
当 VLM 和 Action Expert 联合训练时,一个现实问题是:大量机器人动作损失可能把预训练 VLM 的语义表示"拉偏"。Knowledge Insulation 的核心思想是在某些训练路径上使用 stop-gradient,让动作专家利用 VLM 特征,但限制动作梯度反向破坏语义主干。
概念上可写为
L = L A R - V L A + λ L F l o w - V L A , \mathcal L=\mathcal L_{AR\text{-}VLA}+\lambda\mathcal L_{Flow\text{-}VLA}, L=LAR-VLA+λLFlow-VLA,
而 Flow 分支对 VLM 主干的部分连接采用
h ~ V L M = s t o p g r a d ( h V L M ) . \tilde h_{VLM}=\mathrm{stopgrad}(h_{VLM}). h~VLM=stopgrad(hVLM).
这反映了 VLA 训练正在从"全部端到端一起更新"转向更精细的知识保护与专家协同。
21. GR00T N1 → N1.7:面向人形机器人的 VLM + Flow-Matching DiT
论文:Bjorck et al. , GR00T N1: An Open Foundation Model for Generalist Humanoid Robots , 2025。
论文:https://arxiv.org/abs/2503.14734
GR00T N1 同样采用双系统式思路:视觉语言主干处理语义,Diffusion Transformer 风格 Action Head 使用 Flow Matching 生成动作。其训练数据进一步形成"数据金字塔":互联网/人类视频提供广泛语义和运动先验,仿真/合成数据扩大可控分布,真实机器人数据完成落地。
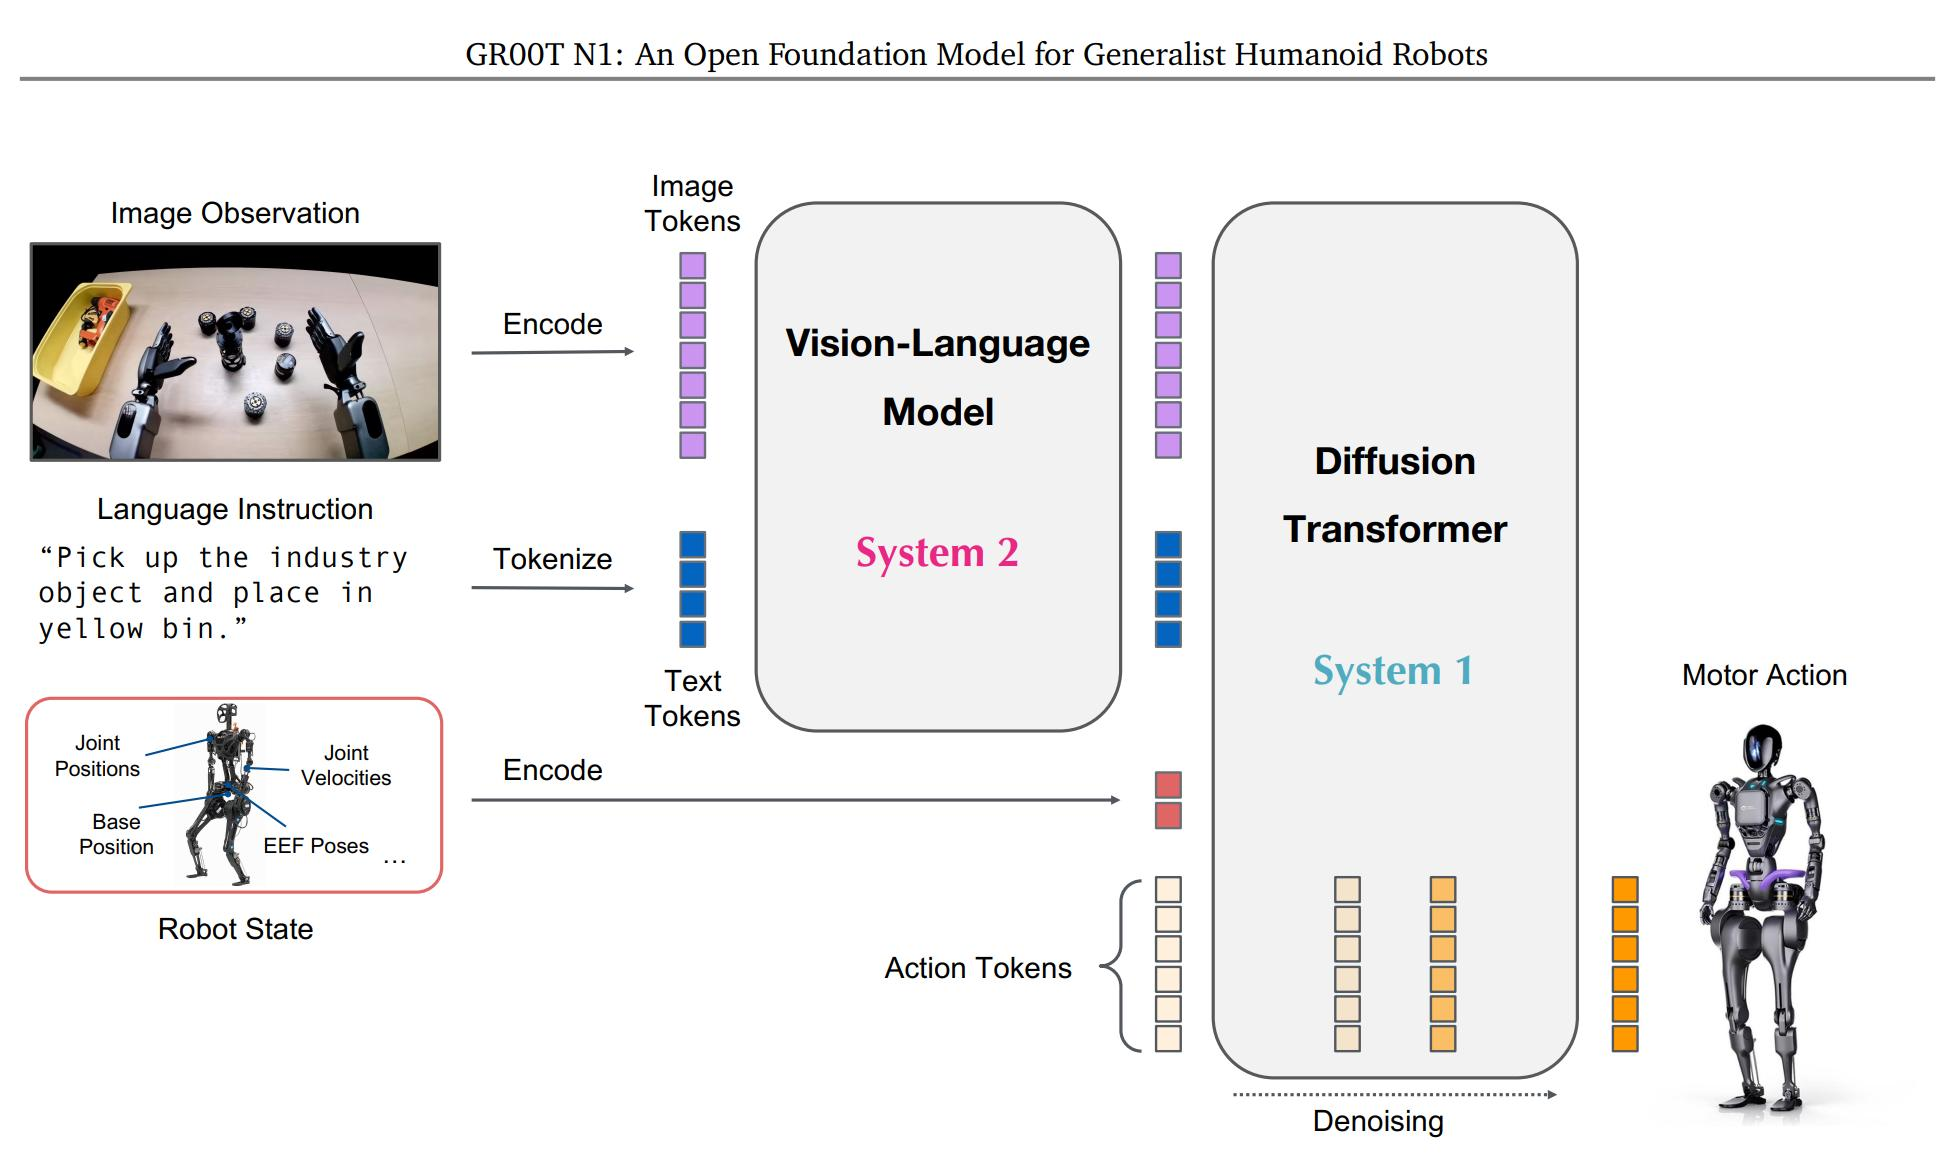
图 22 GR00T N1 官方 Figure 2。图像/传感器 token 与文本 token 进入 Vision-Language Model(System 2),随后由 Diffusion Transformer(System 1)生成动作。来源:NVIDIA, GR00T N1 官方技术博客;原图:<images/original/fig20_gr00t_n1_figure2.png>。
截至 2026 年 7 月,NVIDIA 官方发布的 N1.7 主线进一步更换为 Cosmos-Reason2-2B / Qwen3-VL 架构语义骨干,并保持 flow-matching DiT 动作头;官方代码将 action horizon 从 16 扩展到 40,状态和动作维度也显著扩展。官方技术博客同时报告约 3B 参数基础 checkpoint,并支持 ONNX / TensorRT 导出。
对 VLA 演进而言,N1.7 的信号很明确:动作专家已经不是实验性附加头,而是工业 VLA 的标准组成;部署链路也开始从研究代码进入编译、推理引擎和机器人开发平台。
22. Helix → Helix 02:从 System 2 / System 1 到 System 2 / 1 / 0
技术文章:Figure, Helix: A Vision-Language-Action Model for Generalist Humanoid Control , 2025。
项目:https://www.figure.ai/news/helix
技术文章:Figure, Introducing Helix 02: Full-Body Autonomy , 2026。
Helix 并非一篇传统学术论文,而是工业界 VLA 系统设计中非常重要的一条路线。它明确把 VLA 拆成两个运行频率不同的系统:
- System 2:约 7--9 Hz 的预训练 VLM,负责场景理解、语言和慢速语义;
- System 1:约 200 Hz 的视觉运动策略,消费 System 2 的语义表示并输出连续上肢动作。
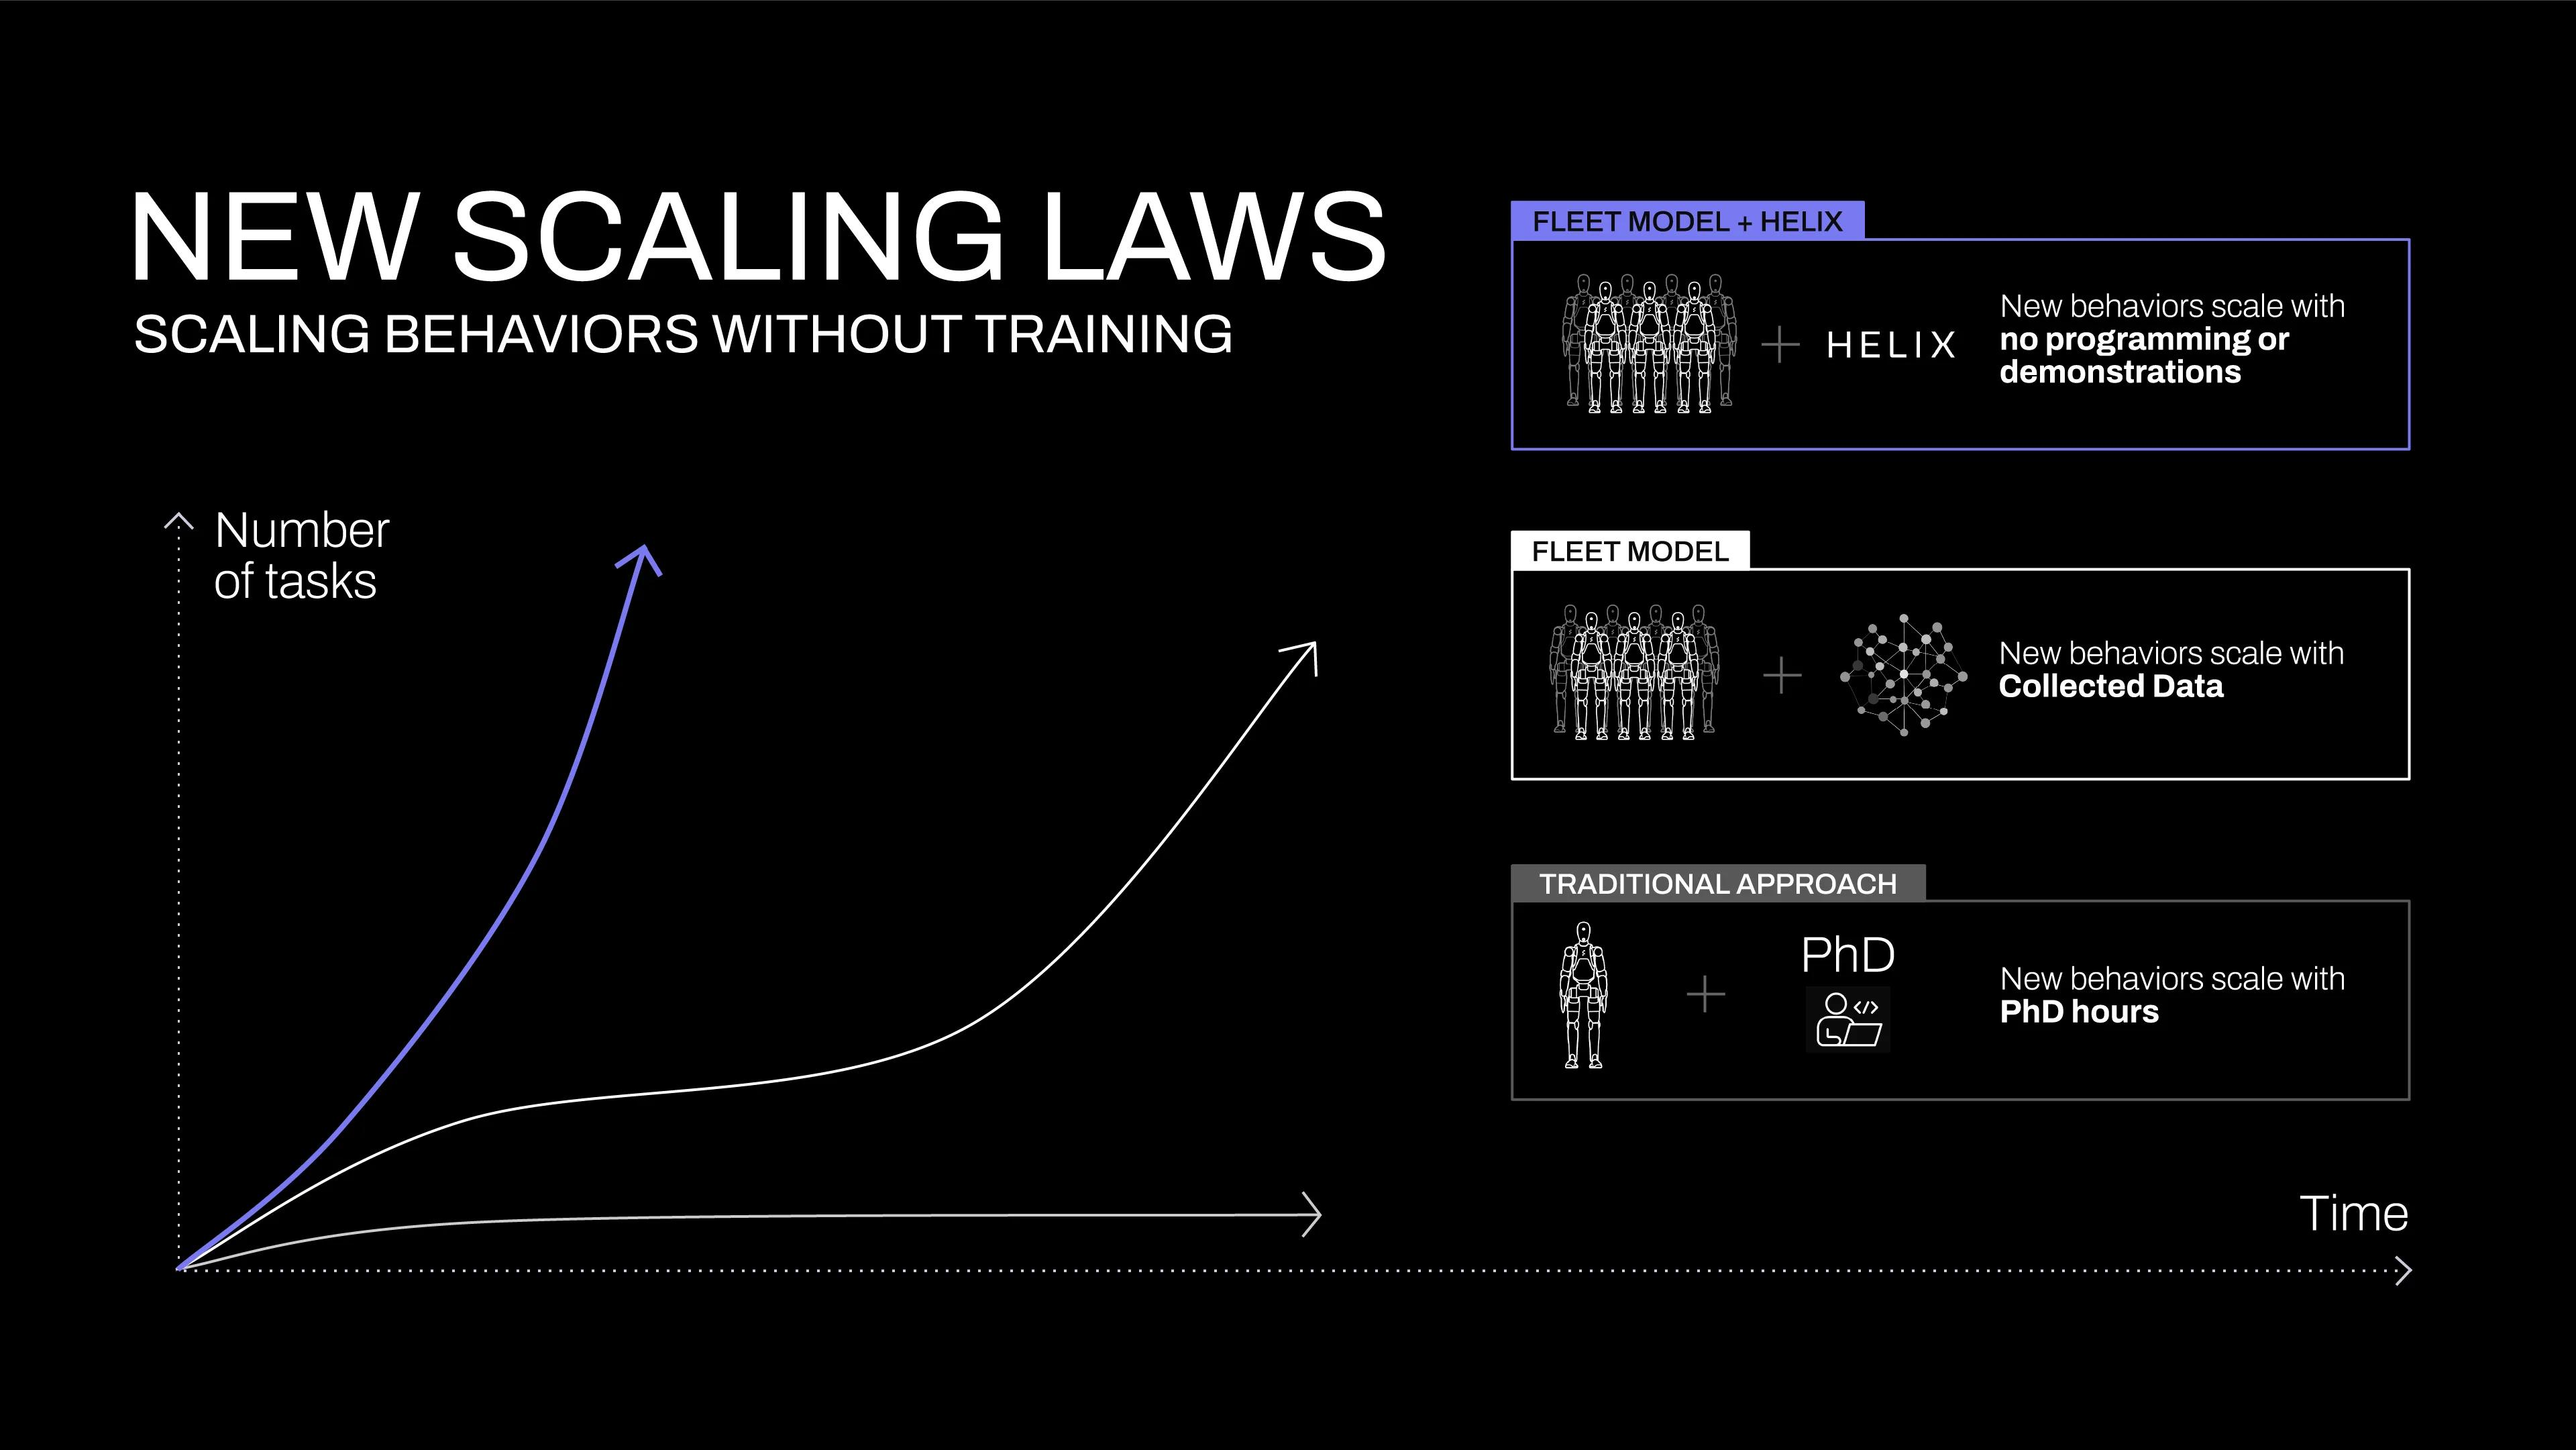
图 23 Helix 官方 Figure 1:New Scaling Laws --- Scaling Behaviors Without Training 。Figure 官方没有公开可稳定下载的 System 1 / System 2 静态架构图,架构部分以网页交互动画呈现,因此此处改用作者机构官方技术文章中的原始 Figure 1,不再自行重绘。该图强调 Helix 用自然语言即时指定新行为、改变技能扩展方式的核心动机。来源:Figure, Helix: A Vision-Language-Action Model for Generalist Humanoid Control;官方原图:<images/original/fig21_helix_official_figure1.webp>。
Helix 02 进一步加入:
- System 2:慢速任务理解与行为序列;
- System 1:200 Hz,全身关节目标;
- System 0:1 kHz,平衡、接触、全身协调与底层物理执行。
从控制理论视角,这几乎可以理解为把传统机器人里的
text
任务规划 → 运动规划 / 视觉伺服 → WBC / 低层伺服重新用学习系统实现,并通过统一表征连接起来。
这条路线解决了一个单体大模型很难回避的问题:语义推理所需的计算规模与闭环控制所需的频率天然冲突。让 7B 级 VLM 以 200 Hz 或 1 kHz 运行既不经济也没有必要;相反,语义可以低频更新,而身体稳定必须高频闭环。
23. Gemini Robotics 1.x → Robotics 2:从 VLA 操作扩展到全身与跨本体
论文:Google DeepMind, Gemini Robotics: Bringing AI into the Physical World , 2025。
论文:https://arxiv.org/abs/2503.20020
项目:https://deepmind.google/blog/gemini-robotics-brings-ai-into-the-physical-world/
技术文章:Google DeepMind, Gemini Robotics 2 brings whole body intelligence to robots , 2026。
项目:https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/
Gemini Robotics 系列把通用多模态模型能力系统化迁移到机器人。2025 年的 Gemini Robotics 强调空间理解、语言、灵巧操作和新任务泛化;Gemini Robotics 1.5 又进一步强调 Motion Transfer 和内部推理,使不同机器人本体之间的行为迁移成为核心目标。
到 2026 年的 Gemini Robotics 2,官方重点已经扩展到全身控制、精细灵巧操作、多机器人协作和更广泛的机器人形态。
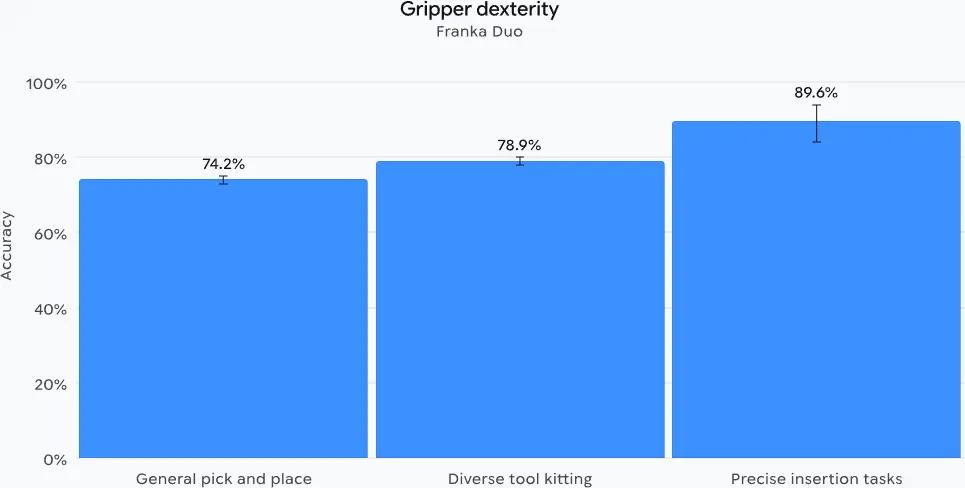
图 24 Gemini Robotics 2 官方发布原图。Google DeepMind 该版本主要通过官方技术文章、视频和评测图发布,而不是以一张统一静态网络架构 Figure 呈现;本图取自官方文章中 Gemini Robotics On-Device 2 的跨本体适配展示,用于说明同一 VLA 面向不同机器人本体的快速适配能力。来源:Google DeepMind, Gemini Robotics 2 brings whole body intelligence to robots ;官方原图入口:https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/。
同时,Gemini Robotics On-Device 2 把 VLA 部署推进本地设备,官方模型卡明确将其定义为基于端侧 Gemma 系列的通用 VLA。这个方向说明未来 VLA 不会只有"云端巨型模型"一种形态,而是会形成类似自动驾驶计算栈的分层:云端/离线用于大规模预训练,机器人端运行压缩后的实时策略。
第八阶段:VLA 开始"记住、反思、在线改进、可操控"(2025---2026)
24. π*₀.₆ / RECAP:从离线行为克隆迈向经验驱动改进
论文:Physical Intelligence, π*₀.₆: a VLA That Learns From Experience , 2025。
传统 VLA 主要依赖 behavior cloning:给定专家演示,最大化演示动作似然。但机器人部署后会产生大量新数据,包括成功轨迹、失败轨迹和人类纠正。如果这些数据仍然被简单当作同等质量的监督样本,模型很难真正"从失败中学习"。
RECAP(RL with Experience and Corrections via Advantage-conditioned Policies)的核心是用价值函数区分更好与更差的行为。回报与优势可以写成
G t = ∑ k = 0 ∞ γ k r t + k , G_t=\sum_{k=0}^{\infty}\gamma^kr_{t+k}, Gt=k=0∑∞γkrt+k,
A ( s t , a t ) = Q ( s t , a t ) − V ( s t ) . A(s_t,a_t)=Q(s_t,a_t)-V(s_t). A(st,at)=Q(st,at)−V(st).
再把优势转成条件,例如
c t = I A ( s t , a t ) \> 0 , c_t=\mathbb IA(s_t,a_t)\>0, ct=IA(st,at)\>0,
让策略学习"在 positive/improved 条件下应该输出什么行为"。这样就能把演示、自动 rollout 和人工 intervention 融合到统一后训练过程中。
它代表 VLA 训练范式的重要变化:
text
过去:收集专家数据 → 离线训练 → 部署
现在:预训练 → 部署 → 收集经验/纠正 → 价值评估 → 再训练 → 再部署
25. Multi-Scale Embodied Memory:给 VLA 增加短期与长期记忆
技术文章:Physical Intelligence, VLAs with Long and Short-Term Memory , 2026。
如果任务持续十几分钟,当前相机画面无法回答"我刚才把哪件衣服放进哪个抽屉""已经完成了哪些步骤"。因此 2026 年的 VLA 开始显式建模记忆。
一般形式可写为
m t = f m e m ( m t − 1 , o t , a t − 1 ) , m_t=f_{mem}(m_{t-1},o_t,a_{t-1}), mt=fmem(mt−1,ot,at−1),
a t ∼ π θ ( ⋅ ∣ o t , L , m t ) . a_t\sim\pi_\theta(\cdot\mid o_t,L,m_t). at∼πθ(⋅∣ot,L,mt).
多尺度记忆进一步拆成
m t = ( m t s h o r t , m t l o n g ) , m_t=(m_t^{short},m_t^{long}), mt=(mtshort,mtlong),
其中短期记忆保留最近一段高带宽视觉历史,长期记忆则通过摘要、文本化状态或稀疏高层事件记录任务进度。这样 VLA 从"反应式策略"逐步变成具有内部任务状态的具身 agent。
26. RL Token:冻结大 VLA,用小型 RL 模块快速适配精细操作
技术文章:Physical Intelligence, Precise Manipulation with Efficient Online RL , 2026。
RL Token(RLT)的思路不是重新对整个 VLA 做高成本强化学习,而是从 VLA 的内部表示中抽取一个紧凑 token:
z R L = E ( h V L A ) . z_{RL}=E(h_{VLA}). zRL=E(hVLA).
小型 actor-critic 接收 z R L z_{RL} zRL 与 VLA 原动作,学习动作修正:
δ A ∼ π ϕ ( ⋅ ∣ z R L , A V L A ) , \delta A\sim\pi_\phi(\cdot\mid z_{RL},A_{VLA}), δA∼πϕ(⋅∣zRL,AVLA),
A = A V L A + δ A . A=A_{VLA}+\delta A. A=AVLA+δA.
这相当于把大 VLA 视为"强先验 + 稳定基础策略",在线 RL 只负责局部精修。对插接、精密对齐等任务,这种设计比从头训练 RL 策略更具有数据效率,也避免大模型参数被在线探索破坏。
27. π₀.7:VLA 从"听一句指令"走向可 Steer 的通用物理模型
技术文章:Physical Intelligence, π₀.7: a Steerable Model with Emergent Capabilities , 2026。
π₀.7 的重点不只是再扩大训练数据,而是让模型可以接受更丰富的 steering 条件:语言、视觉目标、任务元数据、控制模式等都可以成为行为约束。同时,官方展示了技能组合、跨场景迁移和部分涌现式能力。
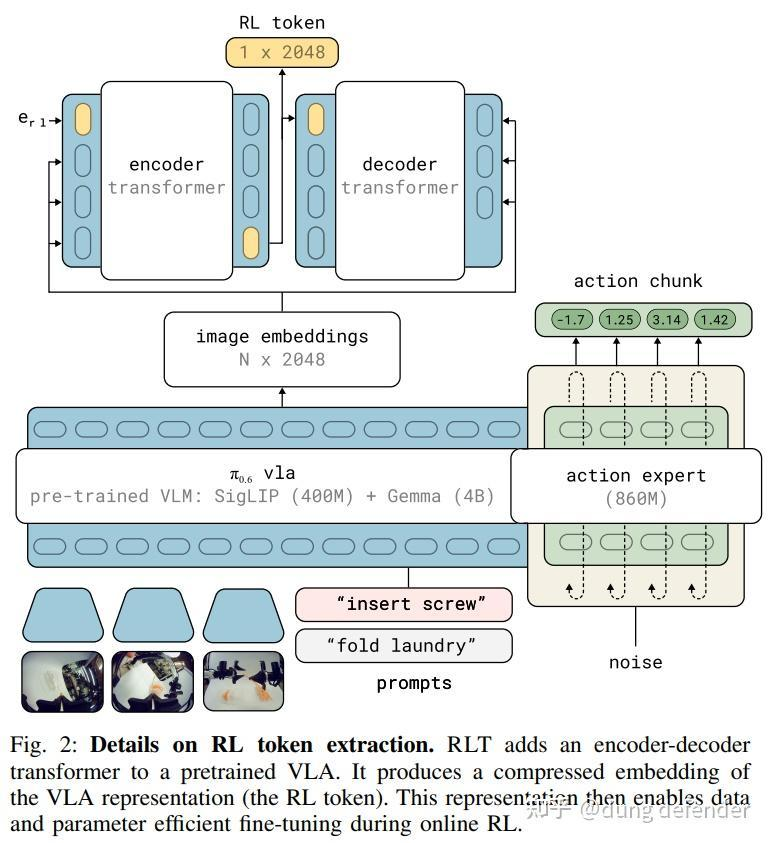
图 25 RL Token 原论文 Figure 2:RL token extraction architecture。预训练 VLA 的视觉---语言表征经 encoder / decoder 提炼为紧凑 RL token,并与 Action Expert 结合用于在线强化学习阶段的策略改进。来源:RL Token: Reinforcement Learning for Vision-Language-Action Models;原图:<images/original/fig23_rl_token_figure2.png>。本节其余 Memory、RECAP 与 steering 工作分别在正文中讨论。
至此,VLA 的系统定义已经从
( i m a g e , t e x t ) → a c t i o n (image,text)\rightarrow action (image,text)→action
扩展为
( v i s i o n , l a n g u a g e , p r o p r i o c e p t i o n , m e m o r y , e x p e r i e n c e , s t e e r i n g ) → a c t i o n c h u n k s . (vision,language,proprioception,memory,experience,steering)\rightarrow action\ chunks. (vision,language,proprioception,memory,experience,steering)→action chunks.
它更接近一个完整的具身智能体,而不再只是多模态网络中的一个动作输出头。
9. 一张表看懂 VLA 主线演进
表 1 代表性 VLA / 通用机器人策略的演进与动作表示
| 阶段 | 代表工作 | 年份 | 语义主干 | 动作表示 | 主要贡献 | 主要限制 |
|---|---|---|---|---|---|---|
| 技能规划 | SayCan | 2022 | LLM | 预定义技能 | LLM 语义 × 可供性/价值 | 不是端到端连续控制 |
| 统一序列 | Gato | 2022 | 通用 Transformer | 离散 token | 多任务、多模态、动作统一序列化 | 机器人语义与规模有限 |
| 多模态提示 | VIMA | 2022/23 | T5 + Transformer | 离散操作动作 | 文本/视觉 Prompt 统一任务接口 | 仿真操作为主 |
| 机器人 Transformer | RT-1 | 2022/23 | EfficientNet + Transformer | 256-bin 单步动作 | 大规模真实机器人策略 | 缺少互联网语义迁移 |
| VLA 成形 | RT-2 | 2023 | PaLI-X / PaLM-E | 文本式动作 token | Web 语义直接迁移到控制 | 离散、自回归、控制频率受限 |
| 跨本体数据 | RT-X / OXE | 2023/24 | 多种 | 统一动作 schema | 数据标准化与正迁移 | 本体异质性仍困难 |
| 生成式通用策略 | Octo | 2024 | Transformer | Diffusion action chunk | 800k 轨迹、灵活传感器/动作空间 | 语义主干弱于大 VLM |
| 开源 VLA | OpenVLA | 2024 | DINOv2+SigLIP+LLM | 离散动作 token | 开源、易微调 | 动作 token 瓶颈 |
| 动作基础模型 | RDT-1B | 2024/25 | 条件编码器 | Diffusion Transformer | 高维双臂、多机器人动作建模 | 语义通用性依赖条件模块 |
| 连续 VLA | π₀ | 2024/25 | PaliGemma 系 VLM | Flow Matching Action Expert | 语义与运动专家解耦 | 推理仍需连续生成步骤 |
| 认知/动作协同 | CogACT | 2024/25 | DINOv2+SigLIP+LLM | Diffusion Action Transformer | cognition/action 模块化 | 系统复杂度上升 |
| 高效动作 token | FAST | 2025 | 任意 AR VLA | DCT + quantization + BPE | 高频动作也可高效 token 化 | 仍是自回归序列预测 |
| 优化微调 | OpenVLA-OFT | 2025 | OpenVLA | 连续 action chunk + L1 | 大幅改善吞吐和 LIBERO 成功率 | 依赖后训练数据分布 |
| 轻量 VLA | SmolVLA | 2025 | 小型 VLM | Flow Matching | 450M、异步、消费级硬件 | 绝对容量与世界知识有限 |
| 人形 VLA | GR00T N1/N1.7 | 2025/26 | VLM | Flow-Matching DiT | 人形、多本体、训练部署链路 | 数据与算力要求高 |
| 双/三系统 | Helix / Helix 02 | 2025/26 | VLM + visuomotor | 连续动作 / 低层身体控制 | 7--9 Hz / 200 Hz / 1 kHz 分层 | 细节主要来自工业披露 |
| 全身多模态 | Gemini Robotics 2 | 2026 | Gemini/Gemma 系 | VLA actions | 全身、跨本体、端侧版本 | 权重与训练细节非完全开放 |
| 自我改进 | π*₀.₆ / MEM / RLT / π₀.7 | 2025/26 | VLA backbone | chunk + RL correction | 经验学习、记忆、steering | 评测标准仍在快速变化 |
10. 动作表示:为什么它是 VLA 真正的"控制瓶颈"
表 2 VLA 常见动作表示机制对比
| 动作机制 | 代表工作 | 训练目标 | 优点 | 缺点 | 适合场景 |
|---|---|---|---|---|---|
| 逐维离散 Token | RT-1、RT-2、OpenVLA | Cross Entropy | 直接复用 LLM;实现简单 | 量化误差;AR 延迟;长序列 | 中低频末端增量控制 |
| 频域 Token | FAST | Cross Entropy | 保留 AR 框架;高频序列更短 | tokenizer 复杂;仍需解码 token | 高频但希望复用 VLM decoder |
| 连续并行 Action Chunk | ACT、OFT | L1/L2、CVAE | 快;低延迟;训练稳定 | 多模态分布表达弱于生成模型 | 单一任务或后训练 |
| Diffusion | Diffusion Policy、Octo、RDT、CogACT | Noise prediction | 多峰、连续、轨迹相关性强 | 多步去噪有计算开销 | 灵巧操作、双臂、长动作块 |
| Flow Matching | π₀、GR00T、SmolVLA | Vector-field regression | 连续、多峰;可用较少积分步 | ODE 生成仍有推理成本 | 通用 VLA Action Expert |
| RL Residual / Correction | RLT 等 | Actor-Critic | 可在线精修,数据效率高 | 安全探索和稳定性要求高 | 精密插接、局部适应 |
从控制视角看,动作输出的质量至少由五件事共同决定:
control quality = f ( semantic correctness , action representation , latency , feedback rate , low-level controller ) . \text{control quality} =f(\text{semantic correctness},\text{action representation},\text{latency},\text{feedback rate},\text{low-level controller}). control quality=f(semantic correctness,action representation,latency,feedback rate,low-level controller).
因此,VLA 不能仅用"语言理解能力"评价。一个模型即使正确理解"把杯子放进抽屉",如果动作头每秒只能稳定更新 2---3 次、动作存在明显量化抖动,真实机器人仍可能失败。
11. Diffusion 与 Flow Matching:现代 VLA 为什么偏爱连续生成式动作头
11.1 Diffusion 的直观解释
Diffusion Policy 学的是"如何把随机动作轨迹一步步去噪成可执行轨迹"。其优势是能表示多峰分布。例如面对一个杯子,机械臂可能从左侧或右侧绕开障碍,两条轨迹都正确;普通 L2 回归可能把两条轨迹平均成一条穿过障碍的错误轨迹,而生成式模型可以保留多个模式。
11.2 Flow Matching 的直观解释
Flow Matching 不必显式学习一整套离散噪声反演马尔可夫链,而是直接学习随"时间" τ \tau τ 变化的速度场:
d A τ d τ = v θ ( A τ , o , τ ) . \frac{dA^\tau}{d\tau}=v_\theta(A^\tau,o,\tau). dτdAτ=vθ(Aτ,o,τ).
推理是从噪声初值解这个 ODE。它尤其适合 VLA,因为 Action Expert 可以在较少积分步下生成整个动作块,而 VLM 语义特征在动作生成过程中作为条件保持不变或低频更新。
11.3 为什么不是所有 VLA 都应该用 Diffusion / Flow
连续生成式动作头并非没有代价:
- 需要多次网络前向或数值积分;
- Action Expert 与 VLM 之间需要额外融合结构;
- 对端侧小硬件,AR + FAST 或直接回归有时更简单;
- 如果任务动作分布本来单峰、控制器反馈足够强,L1/L2 chunk 可能已经很好。
所以当前并不存在唯一最优动作表示。更合理的判断标准是:任务动作频率、动作维数、多模态程度、硬件延迟和后训练数据规模。
12. VLA 的另一条主线:从单机器人到 Cross-Embodiment
VLA 的"通用"至少包含三层含义:
- 任务泛化:同一个机器人做更多任务;
- 场景/物体泛化:未见物体、未见环境仍能做;
- 本体泛化:不同机械臂、双臂、移动操作机器人甚至人形机器人共享一套模型或初始化。
跨本体最困难的不是视觉,而是动作语义不一致。两个机器人都说"向前 5 cm",但关节维数、工作空间、末端执行器、坐标系和控制接口都可能不同。因此现代 VLA 常见三种解决方案:
- 统一到末端增量空间 :把不同本体投影到 Δ x , Δ R , g \Delta x,\Delta R,g Δx,ΔR,g 等近似通用控制变量;
- padding + mask + embodiment embedding:允许模型在统一最大动作维度中区分本体;
- 专用 action head / adapter:语义主干共享,动作输出按本体适配。
Gemini Robotics 的 Motion Transfer、OXE/Octo 的统一 schema、GR00T 的 embodiment configuration 都属于这条主线。
13. 多时间尺度:VLA 与经典机器人控制并不是替代关系
现代人形 VLA 越来越清楚地表明,学习模型并没有消灭控制层级,反而重新发现了控制系统一直在使用的多频率结构。
表 3 VLA 多时间尺度与经典机器人栈的对应关系
| 时间尺度 | 典型频率 | VLA 模块 | 类比传统机器人模块 | 主要职责 |
|---|---|---|---|---|
| 慢 | 1--10 Hz | VLM / System 2 / embodied reasoning | 任务规划、行为树、语义规划 | 目标、对象、任务顺序、语义判断 |
| 中 | 10--200 Hz | Action Expert / System 1 | 局部运动规划、视觉伺服、MPC policy | 连续动作块、反应式修正、操作轨迹 |
| 快 | 200 Hz--1 kHz+ | System 0 / low-level policy | WBC、关节伺服、阻抗控制 | 平衡、接触、协调、力矩/位置闭环 |
关键不是"VLA 替代 MPC/WBC"还是"传统控制替代 VLA",而是确定接口:例如 VLA 可以输出末端动作块或全身参考,而 WBC/阻抗控制器负责动力学可行性和高频稳定;在人形端到端系统中,System 0 也可能用 RL/模仿学习取代部分手工 WBC,但它仍承担同样的物理时间尺度职责。
14. 数据范式的演进:从专家示范到互联网、人类视频和部署经验
VLA 的数据源已经明显经历四步:
text
单机器人专家示范
      ↓
多任务真实机器人数据
      ↓
Open X 等跨本体机器人数据 + Web VLM 数据
      ↓
人类视频 / 仿真合成 / 自动 rollout / 人类纠正 / 在线 RL
对应地,训练目标也从单一行为克隆变成多目标混合:
L = λ V L L V L + λ B C L B C + λ g e n L D i f f / F l o w + λ a u x L s e m a n t i c + λ R L L R L . \mathcal L=\lambda_{VL}\mathcal L_{VL} +\lambda_{BC}\mathcal L_{BC} +\lambda_{gen}\mathcal L_{Diff/Flow} +\lambda_{aux}\mathcal L_{semantic} +\lambda_{RL}\mathcal L_{RL}. L=λVLLVL+λBCLBC+λgenLDiff/Flow+λauxLsemantic+λRLLRL.
这个式子是对现代 VLA 训练目标的统一抽象,并非某篇论文固定采用的精确权重形式。它说明 2026 年的 VLA 已经不再是单一损失训练的"机器人版 VLM"。
16. VLA统一架构
把目前最成熟的思想合在一起,一个现代通用 VLA 可以抽象成以下计算图:
text
                  Web / video / language pretraining
                              ↓
Camera / Language ───────→ Semantic VLM / System 2
          │                       │
          │                       ├── high-level subtask / reasoning
          │                       │
Proprioception ───┐               ↓
Memory ───────────┼────→ Fusion / shared latent
Embodiment ID ────┘               │
                                  ↓
                     Action Expert / System 1
                     Diffusion / Flow / Chunk
                                  │
                                  ↓
                         Action chunk A_t:t+H
                                  │
                           receding-horizon
                                  ↓
                     Low-level control / System 0
                     WBC / impedance / RL prior
                                  │
                                  ↓
                               Robot
                                  ↑
                         visual/tactile feedback
它与 2023 年 RT-2 的最大区别是:RT-2 尝试让一个 VLM 直接"说出动作";2026 年的主流前沿更倾向于让 VLM 成为语义大脑 ,让动作专家成为运动皮层 ,让高速低层控制成为脊髓/反射层,再用记忆和 RL 把系统闭环起来。
17. VLA 的核心矛盾与未来方向
17.1 语义泛化与控制实时性的矛盾
更大的 VLM 通常带来更强语义能力,但机器人需要严格低延迟。Helix 的 7--9 Hz / 200 Hz / 1 kHz、SmolVLA 的端侧与异步执行、GR00T 的专用 action head 都在说明:未来不会简单靠"把最大的 VLM 跑得更快",而是靠分层计算和缓存语义特征。
17.2 互联网知识与真实物理经验的差距
Web 数据告诉模型"杯子是什么",但不告诉它杯子有多重、塑料袋怎么变形、抽屉摩擦系数是多少。动作模型必须从机器人数据、人类视频、仿真和在线经验中学习这些物理规律。因此未来的数据体系会越来越像:
Web semantics + human motion + simulation + real robot experience . \text{Web semantics} + \text{human motion} + \text{simulation} + \text{real robot experience}. Web semantics+human motion+simulation+real robot experience.
17.3 Behavior Cloning 与自主提升的矛盾
离线行为克隆的上限受演示数据限制。π*₀.₆、RL Token 等路线表明,下一阶段会把成功/失败 rollout、人工 intervention 和在线强化学习引入 VLA 后训练。难点将转向安全探索、reward 设计、off-policy 稳定性和灾难性遗忘。
17.4 Cross-Embodiment 仍然没有"机器人版统一词表"
语言有天然 token 词表,但机器人动作没有。FAST 试图学习通用动作 tokenizer,OXE/GR00T/Gemini 则从 schema、adapter、motion transfer 等方向解决。最终可能出现类似"机器人动作中间表示(Robot Action IR)"的标准层,将语义动作与具体机器人动力学解耦。
17.5 长时任务需要世界状态和记忆
单帧 VLA 适合短时反应,但家庭整理、做饭、装配等任务必须知道先前发生过什么。MEM 等工作正在把历史压缩、任务摘要和记忆读写引入模型。未来 VLA 可能不再把所有历史硬塞进 context window,而是形成显式的具身记忆管理器。
17.6 安全、可验证性和失效恢复将成为下一阶段主战场
当前大多数 VLA 成果以任务成功率为主,但真实部署还需要:碰撞约束、速度/力矩限制、接触安全、异常检测、置信度估计、策略 fallback、传统规划/控制安全层。这也是 VLA 与 MPC、CBF、WBC、状态机、行为树等传统方法长期共存的原因。
18. 最终结论:VLA 的真正演进不是"VLM 越来越大"
VLA 的演进可以浓缩成六句话:
- Gato / SayCan / VIMA 证明了语言、视觉、动作或技能可以进入统一序列与任务接口;
- RT-1 → RT-2 完成了从大规模机器人 Transformer 到"动作作为语言"的 VLA 定义;
- OXE / Octo / OpenVLA 把问题从单一模型扩展到跨本体数据、开源训练与通用策略;
- ACT / Diffusion Policy → RDT / π₀ / CogACT 使动作输出从单步离散 token 转向动作块、连续生成和专用 Action Expert;
- FAST / OFT / SmolVLA 证明动作 tokenizer、解码结构、异步执行和端侧效率本身就是决定 VLA 成败的核心;
- π₀.5 / GR00T / Helix 02 / Gemini Robotics 2 / π₀.7 则把 VLA 推向具有多时间尺度控制、跨本体、记忆、在线学习和 steering 的完整物理智能体。
因此,理解 VLA 时最值得抓住的不是某个模型名字,而是下面这条结构性变化:
Action as Tokens → Action Chunks / Generative Actions → Semantic VLM + Motor Expert → Hierarchical Physical Agent \boxed{ \text{Action as Tokens} \;\rightarrow\; \text{Action Chunks / Generative Actions} \;\rightarrow\; \text{Semantic VLM + Motor Expert} \;\rightarrow\; \text{Hierarchical Physical Agent} } Action as Tokens→Action Chunks / Generative Actions→Semantic VLM + Motor Expert→Hierarchical Physical Agent
这也是未来几年最可能继续延伸的方向。
19. 参考论文与项目
论文:Ahn et al. , Do As I Can, Not As I Say: Grounding Language in Robotic Affordances , CoRL 2022。
论文:https://arxiv.org/abs/2204.01691
项目:https://say-can.github.io/
论文:Reed et al. , A Generalist Agent , 2022。论文:https://arxiv.org/abs/2205.06175
项目:https://deepmind.google/blog/a-generalist-agent/
论文:Jiang et al. , VIMA: General Robot Manipulation with Multimodal Prompts , ICML 2023。论文:https://arxiv.org/abs/2210.03094
代码:https://github.com/vimalabs/VIMA
论文:Brohan et al. , RT-1: Robotics Transformer for Real-World Control at Scale , RSS 2023。论文:https://arxiv.org/abs/2212.06817
RSS:https://www.roboticsproceedings.org/rss19/p025.html
论文:Driess et al. , PaLM-E: An Embodied Multimodal Language Model , ICML 2023。论文:https://proceedings.mlr.press/v202/driess23a.html
论文:Zitkovich et al. , RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control , CoRL 2023。论文:https://proceedings.mlr.press/v229/zitkovich23a.html
项目:https://robotics-transformer2.github.io/
论文:Zhao et al. , Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware , RSS 2023。论文:https://arxiv.org/abs/2304.13705
代码:https://github.com/tonyzhaozh/act
论文:Chi et al. , Diffusion Policy: Visuomotor Policy Learning via Action Diffusion , RSS 2023 / IJRR。论文:https://arxiv.org/abs/2303.04137
代码:https://github.com/real-stanford/diffusion_policy
论文:Open X-Embodiment Collaboration et al. , Open X-Embodiment: Robotic Learning Datasets and RT-X Models , ICRA 2024。论文:https://arxiv.org/abs/2310.08864
代码:https://github.com/google-deepmind/open_x_embodiment
论文:Ghosh et al. , Octo: An Open-Source Generalist Robot Policy , RSS 2024。论文:https://www.roboticsproceedings.org/rss20/p090.html
代码:https://github.com/octo-models/octo
论文:Kim et al. , OpenVLA: An Open-Source Vision-Language-Action Model , CoRL 2024。论文:https://arxiv.org/abs/2406.09246
代码:https://github.com/openvla/openvla
论文:Liu et al. , RDT-1B: a Diffusion Foundation Model for Bimanual Manipulation , ICLR 2025。论文:https://arxiv.org/abs/2410.07864
代码:https://github.com/thu-ml/RoboticsDiffusionTransformer
论文:Black et al. , π₀: A Vision-Language-Action Flow Model for General Robot Control , RSS 2025。论文:https://www.roboticsproceedings.org/rss21/p010.html
代码:https://github.com/Physical-Intelligence/openpi
论文:Li et al. , CogACT: A Foundational Vision-Language-Action Model for Synergizing Cognition and Action in Robotic Manipulation , 2024。论文:https://arxiv.org/abs/2411.19650
代码:https://github.com/microsoft/CogACT
论文:Pertsch et al. , FAST: Efficient Action Tokenization for Vision-Language-Action Models , 2025。论文:https://arxiv.org/abs/2501.09747
模型:https://huggingface.co/physical-intelligence/fast
论文:Kim et al. , Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success , 2025。论文:https://arxiv.org/abs/2502.19645
代码:https://github.com/moojink/openvla-oft
论文:Shukor et al. , SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics , 2025。论文:https://arxiv.org/abs/2506.01844
代码:https://github.com/huggingface/lerobot
论文:Bjorck et al. , GR00T N1: An Open Foundation Model for Generalist Humanoid Robots , 2025。论文:https://arxiv.org/abs/2503.14734
代码:https://github.com/NVIDIA/Isaac-GR00T
技术文章:Figure, Helix: A Vision-Language-Action Model for Generalist Humanoid Control , 2025。项目:https://www.figure.ai/news/helix
技术文章:Figure, Introducing Helix 02: Full-Body Autonomy , 2026。项目:https://www.figure.ai/news/helix-02
论文:Google DeepMind, Gemini Robotics: Bringing AI into the Physical World , 2025。论文:https://arxiv.org/abs/2503.20020
项目:https://deepmind.google/blog/gemini-robotics-brings-ai-into-the-physical-world/
技术文章:Google DeepMind, Gemini Robotics 2 brings whole body intelligence to robots , 2026。项目:https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/
On-Device 2 模型卡:https://deepmind.google/models/model-cards/gemini-robotics-on-device-2/
论文:Physical Intelligence, π*₀.₆: a VLA That Learns From Experience , 2025。论文:https://arxiv.org/abs/2511.14759
项目:https://www.pi.website/blog/pistar06
技术文章:Physical Intelligence, VLAs with Long and Short-Term Memory , 2026。项目:https://www.pi.website/research/memory
技术文章:Physical Intelligence, Precise Manipulation with Efficient Online RL , 2026。项目:https://www.pi.website/research/rlt
技术文章:Physical Intelligence, π₀.7: a Steerable Model with Emergent Capabilities , 2026。