第1题:exp(0) 的结果
正确
题目:
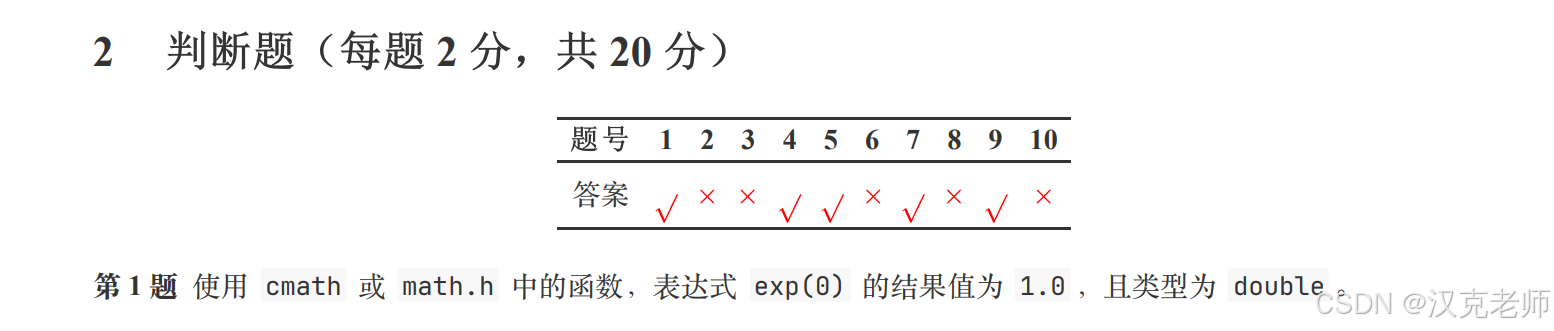
使用 cmath 或 math.h 中的函数,表达式 exp(0) 的结果值为 1.0,且类型为 double。
第一步:认识 exp 函数
exp(x) 是C++数学库中的一个函数,它表示:
exp(x) = e^x
这里的 e 是一个数学常数,约等于:
e ≈ 2.71828
因此:
exp(0) = e^0 =1
所以,结果确实是1.0。
第二步:为什么结果类型是 double?
在C++中,exp() 函数返回的是 double 类型。
例如:
C++
#include <iostream>
#include <cmath>
using namespace std;

int main() {
    double a = exp(0);
    cout << a << endl;

    return 0;
}
输出:
1注意:虽然屏幕上显示的是 1,但它的实际返回类型仍然是 double。
这是因为输出时,默认情况下不会特意显示小数点后面的零。
如果想让它显示为 1.000000,可以使用:
C++
#include <iostream>
#include <cmath>
#include <iomanip>
using namespace std;

int main() {
    cout << fixed << setprecision(6);
    cout << exp(0) << endl;

    return 0;
}
输出:
1.000000第三步:举一反三
记住下面这些常见数学函数:
| 函数 | 含义 | 例子 |
|---|---|---|
exp(x) |
e^x | exp(0)=1 |
sqrt(x) |
平方根 | sqrt(9)=3 |
pow(a,b) |
a^b | pow(2,3)=8 |
fabs(x) |
浮点数绝对值 | fabs(-3.5)=3.5 |
log(x) |
自然对数 | log(exp(1))=1 |
记忆口诀:
exp 是 e 的指数函数,零次方等于1,返回类型是 double。

第2题:开放定址法删除元素
❌️ 错误
题目:
采用开放定址法处理冲突的哈希表中,删除一个元素后可以直接将该位置置空,不会影响后续查找。
这道题考查哈希表中一个非常重要的细节:删除元素时,不能随便把位置清空!
第一步:先认识哈希表
我们可以把哈希表想象成一个带编号的储物柜。
每个数据经过哈希函数计算后,就会得到一个柜子编号。
例如:
C++
int pos = x % 10;如果:
C++
x = 23;那么:
C++
pos = 23 % 10 = 3;于是,数字23就想存入编号3的柜子。
但是,如果编号3已经有人了怎么办?
这就发生了哈希冲突。
第二步:什么是开放定址法?
开放定址法的思路是:
如果原来的位置被占用了,就继续寻找其他空位置。
假设23和33发生冲突,33经过探测后存放在位置4。
现在,我们想查找33。
查找过程:
-
先计算33的哈希位置,得到3。
-
发现位置3存放的是23,不是33。
-
按照开放定址法继续向后寻找。
-
找到位置4,发现33,查找成功。
第三步:为什么不能直接删除?
假设我们删除23,直接把位置3清空:
错误删除后,
现在查找33会出现问题!
查找程序先检查位置3,发现它是空的,就可能认为33根本不存在,于是停止查找。但33实际上还在位置4。
这就是错误的地方。

第3题:哈夫曼树中,出现次数更多的叶子结点,其深度总是更小
❌️ 错误
这道题考查哈夫曼树,也是七级中非常值得掌握的知识点。
第一步:先认识哈夫曼树
假设我们有一个文字压缩任务。
现在有四个字母,它们出现的次数不同:
| 字母 | 出现次数 |
|---|---|
| A | 40 |
| B | 30 |
| C | 20 |
| D | 10 |
如果某个字母出现得特别频繁,我们希望给它安排比较短的编码。
如果某个字母很少出现,就可以给它安排稍长的编码。
这样整体编码长度就能尽量短。
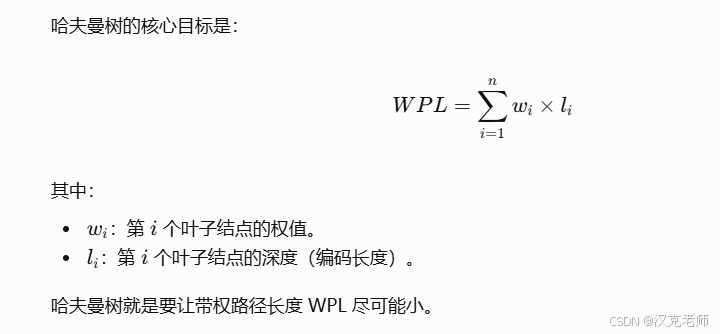
这就是哈夫曼编码的核心思想。
第二步:哈夫曼树怎么建立?
哈夫曼树的建树方法是:
每次选出权值最小的两个结点,合并成一个新结点。
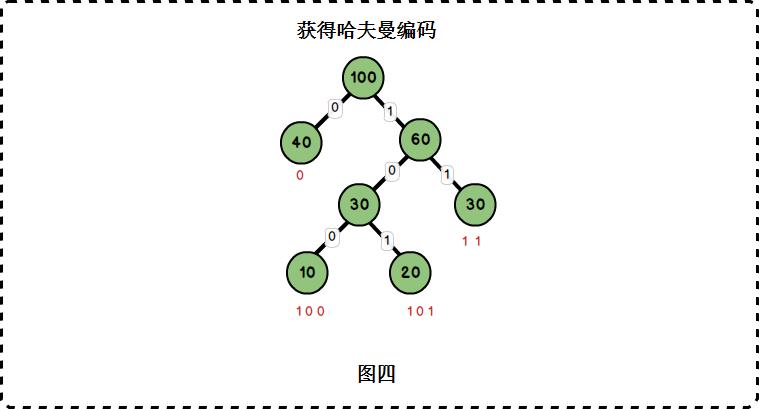
对于上面的例子:
-
第一次:10和20合并,得到30。
-
第二次:30和30合并,得到60。
-
第三次:40和60合并,得到100。
可以画成一棵树:
第三步:出现次数越多,深度一定越小吗?
题目中最关键的是两个字:
总是。
哈夫曼树的目标是让出现频率高的字符尽可能使用较短的编码,但不能因此简单地说每个频率更高的叶子结点都必然比其他叶子结点浅。
举一个特殊情况:
假设只有两个字符:
| 字母 | 出现次数 |
|---|---|
| A | 5 |
| B | 6 |
那么建立出来的哈夫曼树是:
       11
      /  \
     A    B
A和B的深度都是1。
它们出现次数不同,但是深度相同。
所以,不能把"频率越高,深度总是严格更小"当成绝对规律。
本题结论:错误❌️。
第四步:真正需要记住什么?
记忆口诀:
哈夫曼树,找最小;两个合并,再找最小;目标是让WPL最小。

第4题:有向图中,所有顶点的入度之和等于所有顶点的出度之和
✅️ 正确
这道题考查图论中的入度和出度。
第一步:什么是有向图?
有向图可以理解成一个单向道路网络。
例如:
A ----> B
 \      |
  \     v
   ---> C
箭头表示道路只能朝一个方向走。
第二步:什么是入度和出度?
对于一个顶点:
-
入度:有多少条边指向它。
-
出度:有多少条边从它出发。
例如:
A ----> B
 \      |
  \     v
   ---> C
我们数一下:
| 顶点 | 入度 | 出度 |
|---|---|---|
| A | 0 | 2 |
| B | 1 | 1 |
| C | 2 | 0 |
| 合计 | 3 | 3 |
所有顶点的入度之和:
0+1+2 = 3
所有顶点的出度之和:
2+1+0 = 3
两者相等!
第三步:为什么一定相等?
我们换一种思考方式。
假设整个图有10条有向边。
每一条有向边:
-
一定从一个顶点出发,所以贡献1次出度。
-
一定指向另一个顶点,所以贡献1次入度。
因此:
每条边都给出度总和贡献1,也给入度总和贡献1。
如果图中有 m 条边,那么:
∑入度 = m
∑出度 = m
所以:
∑入度 = ∑出度
第四步:举一反三
注意,这个结论对有向图成立。
对于无向图,每条边连接两个顶点,对总度数贡献2,因此:
∑度数 = 2m
记忆口诀:
有向图中,入度总和等于出度总和;无向图中,所有度数加起来等于边数的两倍。

第5题:BFS使用队列,DFS使用栈或递归
✅️正确
这道题考查了图论中两种经典搜索算法。
第一步:什么是BFS?
BFS,全称:
Breadth First Search
中文叫作:广度优先搜索。
我们可以把它想象成一块石头扔进水池里。
水波从中心向四周扩散:
-
第一圈:距离起点1步的点。
-
第二圈:距离起点2步的点。
-
第三圈:距离起点3步的点。
一层一层向外扩展。
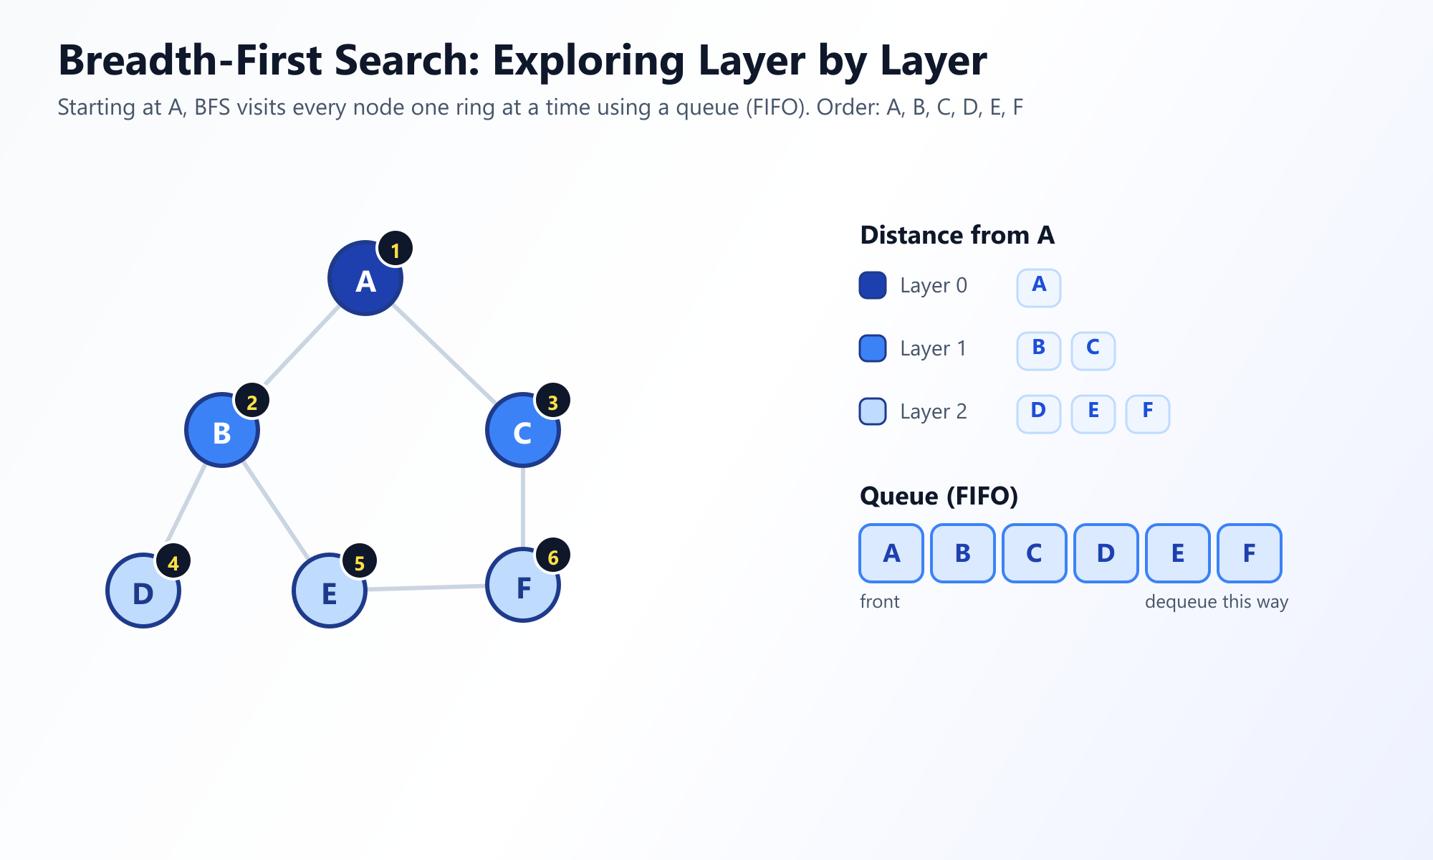
BFS的特点是:
先发现的点,先处理。
这和排队买票非常相似。
因此,BFS通常使用 queue 队列。
参考代码:
#include <iostream>
#include <queue>
using namespace std;

int main() {
    queue<int> q;

    q.push(1);
    q.push(2);
    q.push(3);

    while (!q.empty()) {
        int x = q.front();
        q.pop();

        cout << x << " ";
    }

    return 0;
}
输出:
1 2 3队列的特点是:
先进先出(FIFO)。
第二步:什么是DFS?
DFS,全称:
Depth First Search
中文叫作:深度优先搜索。
可以把它想象成一个探险家进入迷宫。
探险家遇到岔路口时:
-
先选择一条路。
-
沿着这条路一直往前走。
-
走不通了,就退回上一个岔路口。
-
再尝试其他道路。
这就是深度优先搜索。
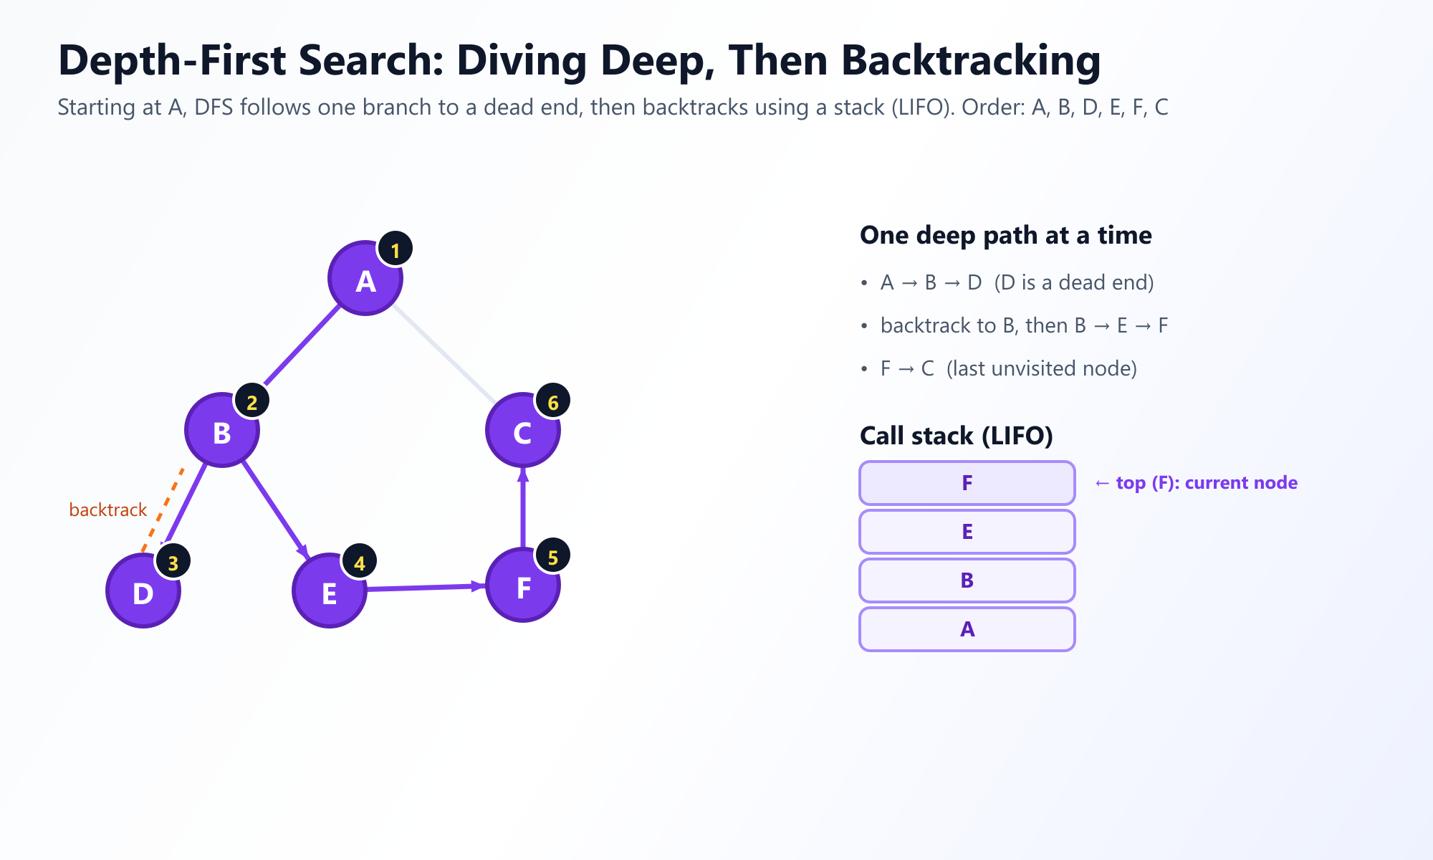
DFS通常有两种实现方式:
方式一:递归
C++
void dfs(int x) {
    vis[x] = 1;

    for (int i = 0; i < n; i++) {
        if (!vis[i] && 有边) {
            dfs(i);
        }
    }
}
递归调用会使用系统提供的调用栈。
方式二:手动使用栈
C++
stack<int> s;

s.push(1);

while (!s.empty()) {
    int x = s.top();
    s.pop();

    // 处理结点x
}
栈的特点是:
后进先出(LIFO)。
第三步:BFS和DFS对比
| 比较项目 | BFS | DFS |
|---|---|---|
| 中文名称 | 广度优先搜索 | 深度优先搜索 |
| 搜索方式 | 一层一层扩展 | 一条路走到底 |
| 常用数据结构 | queue | stack |
| 递归实现 | 通常不需要 | 很常见 |
| 无权图最短路 | 可以求 | 通常不能直接保证 |
记忆口诀:
BFS像水波,队列来帮忙;DFS像探险,递归或栈登场。
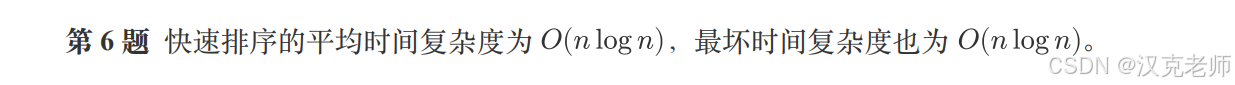
第6题:快速排序的平均时间复杂度和最坏时间复杂度都是 O(n log n)
❌️错误
这道题是时间复杂度中的经典陷阱。
第一步:先认识快速排序
快速排序的基本思想是:
找一个基准数(pivot),把数组分成两部分:
-
一部分比基准数小。
-
另一部分比基准数大。
然后对左右两部分继续进行快速排序。
例如:
8 3 6 2 9 1 5假设选择5作为基准数。
分区后可以得到:
3 2 1 | 5 | 8 6 9接着分别处理左右两边。
第二步:什么是平均时间复杂度?
如果每次分区都比较均匀:
          8个数
         /     \
      4个数    3个数
      /  \      / \
     2    1    1   1
每一层处理所有元素,大约需要 O(n) 的时间。
而树的层数大约是:
O(logn)
所以平均时间复杂度为:
O(nlogn)
第三步:最坏情况是什么?
如果每次选择的基准数都特别差,导致一边有 n−1n-1n−1 个数,另一边没有数:
        9
       /
      8
     /
    7
   /
  6
 /
...
就像一个歪得非常厉害的树。
此时:
-
第一次处理 nnn 个数。
-
第二次处理 n−1个数。
-
第三次处理 n−2个数。
总时间大约是:
n+(n−1)+(n−2)+⋯+1
根据等差数列求和:
=n(n+1) / 2
因此:
O(n^2)
第四步:正确结论
| 情况 | 快速排序时间复杂度 |
|---|---|
| 最好情况 | O(nlogn) |
| 平均情况 | O(nlogn) |
| 最坏情况 | O(n^2) |
题目把平均情况和最坏情况都写成了 O(nlogn),所以错误。
记忆口诀:
快速排序,平均很快;最坏退化,平方等待。

第7题:0/1背包一维数组优化时,容量应该从大到小枚举
✅️ 正确
这道题是动态规划中的经典考点。
第一步:先理解0/1背包
假设我们有一个背包,最大容量为8。
有一个宝物:
-
重量:3
-
价值:5
这个宝物只能拿一次。
我们希望在不超过背包容量的前提下,获得尽可能大的价值。
这就是0/1背包问题。
为什么叫0/1?
因为每个物品只有两种选择:
-
0:不拿。
-
1:拿一次。
第二步:二维DP怎么理解?
假设:
dpic
表示考虑前 i 个物品,背包容量为 c 时的最大价值。
如果使用第 i 个物品:
dpic=max(dpi−1c,dpi−1c−wi+vi)
如果不使用:
dpic = dpi−1c
这里的关键是:
无论拿不拿第i个物品,都要从上一层状态转移。
第三步:为什么可以压缩成一维数组?
我们发现,计算第 i 层时,只需要第 i−1 层的数据。
因此可以使用一维数组:
C++
int dp[1005] = {0};但是,压缩后有一个非常重要的问题:
容量循环必须从大到小!
C++
for (int c = W; c >= w; c--) {
    dp[c] = max(dp[c], dp[c - w] + v);
}
第四步:为什么必须从大到小?
还是使用重量3、价值5的宝物,背包容量为8。
如果从大到小:
c = 8
dp[8] = max(dp[8], dp[5] + 5)

c = 7
dp[7] = max(dp[7], dp[4] + 5)

c = 6
dp[6] = max(dp[6], dp[3] + 5)

c = 5
dp[5] = max(dp[5], dp[2] + 5)

c = 4
dp[4] = max(dp[4], dp[1] + 5)

c = 3
dp[3] = max(dp[3], dp[0] + 5)
由于从大到小枚举,更新 dp[8] 时,dp[5] 还是上一轮的数据,没有使用当前物品。
所以当前物品不会被重复使用。
如果从小到大呢?
C++
for (int c = w; c <= W; c++) {
    dp[c] = max(dp[c], dp[c - w] + v);
}
当计算 dp[6] 时,dp[3] 已经被当前物品更新过了。
这样就相当于可以使用两次重量为3的物品。
这就变成了完全背包的思路,而不是0/1背包。
第五步:0/1背包与完全背包对比
| 背包类型 | 物品使用次数 | 一维DP容量方向 |
|---|---|---|
| 0/1背包 | 每件最多一次 | 从大到小 |
| 完全背包 | 每件可以多次 | 从小到大 |
记忆口诀:
0/1背包,只能拿一次,容量倒着走;完全背包,可以拿多次,容量正着走。

第8题:邻接表遍历某个顶点的所有邻边,时间与图中顶点数成正比
❌️错误
这道题考查图的存储方式,是图论中一个很容易混淆的知识点。
第一步:什么是邻接表?
假设有这样一张图:
    1
   / \
  2   3
   \ /
    4
我们可以用邻接表记录每个顶点有哪些邻居。
例如:
| 顶点 | 邻接点 |
|---|---|
| 1 | 2,3 |
| 2 | 1,4 |
| 3 | 1,4 |
| 4 | 2,3 |
邻接表就像一本通讯录:
-
找到某个人。
-
查看他的联系人。
-
不需要把所有人的联系人全部检查一遍。
第二步:遍历某个顶点的邻边需要多少时间?
假设我们要遍历顶点1的所有邻边。
顶点1只有两个邻居:
1 → 2
1 → 3
只需要访问这两个邻接点。
如果一个顶点有3条邻边,那么就需要遍历3条邻边。
所以,遍历顶点 u 的邻接表,时间复杂度是:
其中:
deg(u)
表示顶点 u 的度数(有向图中要根据具体遍历的是入边还是出边来理解)。
第三步:那什么时候是 O(n)?
假设图有 n 个顶点。
如果某个顶点连接了所有其他顶点,那么它的邻边数量最多可以达到 n−1 。
这时遍历它的邻边才是:
O(n)
但是,并不是所有顶点都连接了这么多点。
例如:
1 → 2

3 → 4

5 → 6
图中有6个顶点,但每个顶点最多只有1条出边。
遍历某个顶点的邻边,只需要常数级别的时间。
第四步:记住三种常见复杂度
| 操作 | 邻接表的时间复杂度 |
|---|---|
| 遍历顶点u的所有邻边 | O(deg(u)) |
| 遍历所有顶点的邻边 | O(n+m) |
| 查找两个指定顶点之间是否有边 | 一般需要遍历邻接表,最坏可达 O(deg(u)) |
这里:
-
n :顶点数量。
-
m :边的数量。
因此,题目说遍历某个顶点的所有邻边,时间与顶点总数成正比,并不总是成立。
本题结论:错误❌️。
记忆口诀:
邻接表,找邻居;遍历多少条边,就看这个点有多少邻边。

第9题:完全二叉树的父结点编号
✅️正确
题目:
在按层序从1开始对结点编号的完全二叉树中,编号为 i (i >1) 的结点的父结点编号为:
⌊i / 2⌋
第一步:什么是完全二叉树?
完全二叉树就是:
-
除了最后一层,其他层都必须填满。
-
最后一层的结点从左向右连续排列。
例如:
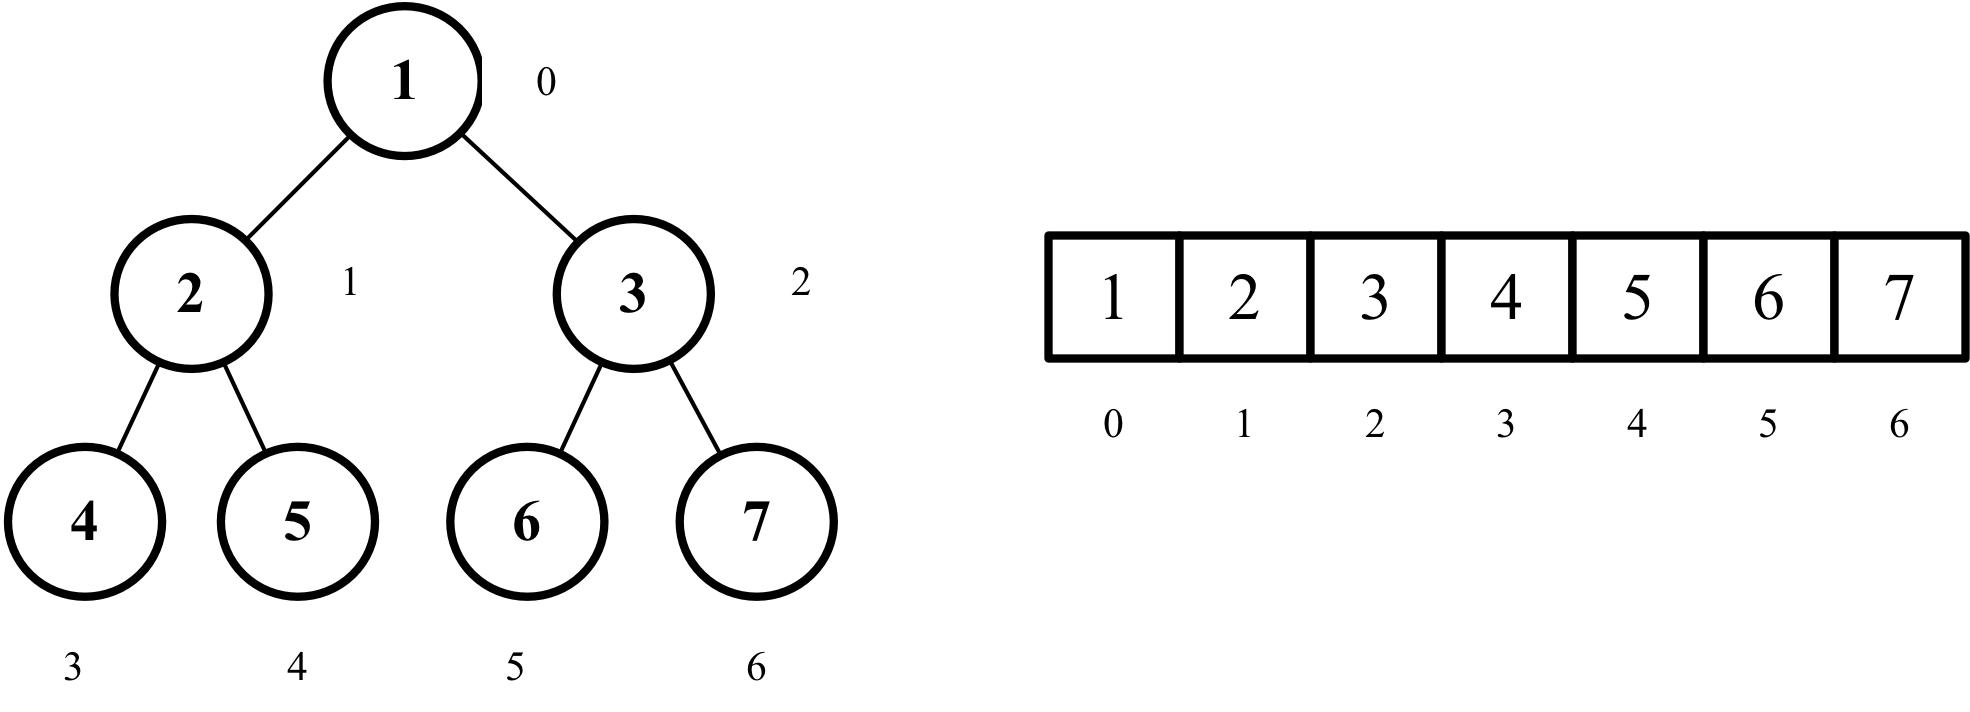
第二步:给结点编号
按照从上到下、从左到右的顺序编号:
             1
           /   \
          2     3
         / \   / \
        4   5 6   7
观察一下:
-
结点1是根结点。
-
结点2和3的父结点是1。
-
结点4和5的父结点是2。
-
结点6和7的父结点是3。
我们发现:
结点编号    父结点编号

2           1
3           1
4           2
5           2
6           3
7           3
第三步:找规律
结点2:
2/2 = 1
结点3:
3/2 =1.5
整数除法结果为1。
结点4:
4/2 = 2
结点5:
5/2 = 2.5
整数除法结果为2。
结点6:
6/2 = 3
结点7:
7/2 = 3.5
整数除法结果为3。
所以:
父结点编号 = i / 2
在C++中,两个整数相除会自动舍去小数部分,因此可以直接写:
C++
int fa = i / 2;第四步:再记住两个重要公式
如果一个结点的编号是 iii,那么:
| 结点 | 编号公式 |
|---|---|
| 父结点 | i / 2 |
| 左孩子 | 2 * i |
| 右孩子 | 2* i + 1 |
例如:
C++
int fa = i / 2;
int left = 2 * i;
int right = 2 * i + 1;
注意:这些公式适用于从1开始编号的完全二叉树数组表示。
记忆口诀:
父亲除以2,左孩子乘以2,右孩子乘以2再加1。

第10题:数组名 arr 和 &arr0 总是等价
错误
这道题考查数组和指针的关系,是C++中非常容易出错的地方。
第一步:先看代码
C++
int arr[10];这段代码定义了一个数组:
-
数组名称:
arr -
数组长度:10
-
每个元素类型:
int
数组元素分别是:
arr[0]
arr[1]
arr[2]
arr[3]
...
arr[9]
第二步:什么是 &arr0 ?
arr[0] 表示数组的第一个元素。
&arr[0] 表示第一个元素的地址。
例如:
C++
int arr[5] = {10, 20, 30, 40, 50};

cout << &arr[0] << endl;
这会输出第一个元素的内存地址。
第三步:数组名 arr 又是什么?
在大多数表达式中,数组名 arr 会自动转换为指向第一个元素的指针。
所以:
C++
arr和:
C++
&arr[0]在大多数普通表达式中,确实指向同一个位置。
例如:
C++
int arr[5] = {10, 20, 30, 40, 50};

cout << *arr << endl;
cout << *(&arr[0]) << endl;
两行输出都是:
10
10
那么为什么本题还是错的?
关键就在于题目说的是:
总是等价。
第四步:最重要的陷阱------sizeof
看下面的程序:
C++
#include <iostream>
using namespace std;

int main() {
    int arr[10];

    cout << sizeof(arr) << endl;
    cout << sizeof(&arr[0]) << endl;

    return 0;
}
假设一个 int 占4个字节,一个指针占8个字节。
那么:
C++
sizeof(arr)计算的是整个数组占用的内存:
10×4 = 40
而:
C++
sizeof(&arr[0])计算的是一个指针占用的内存:
8
于是输出:
40
8
两者显然不相等!
两个表达式的区别
sizeof(arr):
计算整个数组的大小:10个int元素。
sizeof(&arr00)
只计算一个地址所占的大小。
本题结论:错误 ❌️。
记忆口诀:
数组名通常代表首元素地址,但数组名不等于普通指针变量;特别注意 sizeof 和 &arr!
二、10道判断题的核心知识点总结
这10道题涉及的知识点,我们可以把它们整理成一张复习表。
| 知识点 | 必须掌握的结论 |
|---|---|
| 数学函数 | exp(0)=1.0,返回类型为 double |
| 哈希表 | 开放定址法删除元素,不能随意置空 |
| 哈夫曼树 | 每次合并两个最小权值,目标是WPL最小 |
| 有向图 | 入度总和等于出度总和 |
| BFS | 通常使用队列 |
| DFS | 通常使用递归或栈 |
| 快速排序 | 平均 O(nlogn),最坏 O(n^2) |
| 0/1背包 | 一维DP容量从大到小枚举 |
| 邻接表 | 遍历顶点u的邻边,复杂度 O(deg(u)) |
| 完全二叉树 | 父亲编号 i/2 ,左孩子 2i,右孩子 2i+1 |
| 数组与指针 | 数组名与首元素地址在很多表达式中相同,但并非总是等价 |
三、给大家特别提醒
我建议学生们重点记住下面五组容易混淆的知识点。
第一组:BFS和DFS
-
BFS:队列,先进先出。
-
DFS:栈,后进先出;递归也可以实现。
第二组:快速排序
-
平均复杂度:O(nlogn)。
-
最坏复杂度:O(n^2)。
第三组:0/1背包和完全背包
-
0/1背包:从大到小。
-
完全背包:从小到大。
第四组:图的邻接表
-
遍历某个点的邻边:O(deg(u))。
-
遍历整张图:O(n+m)。
第五组:数组与指针
-
arr:大多数表达式中会转换为首元素地址。 -
&arr[0]:首元素的地址。 -
sizeof(arr):整个数组的大小。 -
sizeof(&arr[0]):指针的大小。
四、课堂小测:看看学生是否真正掌握了
课后练习。
七级判断题知识巩固
单选题
第1题:开放定址法中,删除一个元素时,通常应该怎么做?
A. 直接将位置清空
B. 标记为已删除状态
C. 把整个哈希表清空
D. 把所有元素乘以2
第2题:快速排序的最坏时间复杂度是?
A. O(1)
B. O(log n)
C. O(n log n)
D. O(n²)
第3题:使用一维数组解决0/1背包时,容量应该怎样枚举?
A. 从小到大
B. 从大到小
C. 随机枚举
D. 只枚举奇数
第4题:邻接表中,遍历顶点u的所有邻边,时间复杂度通常是?
A. O(1)
B. O(deg(u))
C. O(n²)
D. O(2^n)
第5题:从1开始编号的完全二叉树中,编号为13的结点,其父结点编号是多少?
A. 5
B. 6
C. 7
D. 8
七级判断题真正考查的不是死记硬背,而是能不能发现一句话里的关键条件。
特别是看到下面这些词时,一定要停下来想一想:
-
"总是"
-
"一定"
-
"所有"
-
"平均"
-
"最坏"
-
"只能"
-
"必须"
这些词往往就是判断题的陷阱所在。
做判断题,不要只看它讲的知识点对不对,还要看它说得是不是太绝对。 这也是从初级C++学习走向算法思维的重要一步。