目录
[二、Langchain 多类型消息使用](#二、Langchain 多类型消息使用)
[2.1 Langchain 消息说明](#2.1 Langchain 消息说明)
[2.2 Langchain 消息内部结构](#2.2 Langchain 消息内部结构)
[2.3 LangChain 消息类型](#2.3 LangChain 消息类型)
[2.3.1 系统消息](#2.3.1 系统消息)
[2.3.2 用户消息](#2.3.2 用户消息)
[2.3.3 助手(AI)消息](#2.3.3 助手(AI)消息)
[2.3.4 工具调用消息](#2.3.4 工具调用消息)
[2.4 消息格式](#2.4 消息格式)
[2.4.1 格式1:JSON格式](#2.4.1 格式1:JSON格式)
[2.4.2 格式2:对象格式](#2.4.2 格式2:对象格式)
[2.4 消息对象字段说明](#2.4 消息对象字段说明)
[2.4.1 SystemMessage 参数列表](#2.4.1 SystemMessage 参数列表)
[2.4.2 HumanMessage 参数列表](#2.4.2 HumanMessage 参数列表)
[2.4.3 AIMessage 参数列表](#2.4.3 AIMessage 参数列表)
[2.4.4 ToolMessage 参数列表](#2.4.4 ToolMessage 参数列表)
[2.5 对话历史管理](#2.5 对话历史管理)
[2.5.1 会话记忆介绍](#2.5.1 会话记忆介绍)
[2.5.2 对话历史优化](#2.5.2 对话历史优化)
[三、Langchain 消息扩展](#三、Langchain 消息扩展)
[3.1 content 使用](#3.1 content 使用)
一、前言
在使用Langchain 与大模型进行对话过程中,涉及到不同类型的消息,这些不同类型消息的组合使用从而完成多轮复杂的对话任务,本文将通过实际案例详细介绍在Langchain 中多种类型的消息使用。
二、Langchain 多类型消息使用
2.1 Langchain 消息说明
大模型没有记忆,它的输出只和输入模型的内容有关(上下文)。很多大模型API服务也没有在服务端维护会话历史,是" 无状态 "的。因此,如果应用需要"记住"对话历史,需要在程序中维护消息列表。
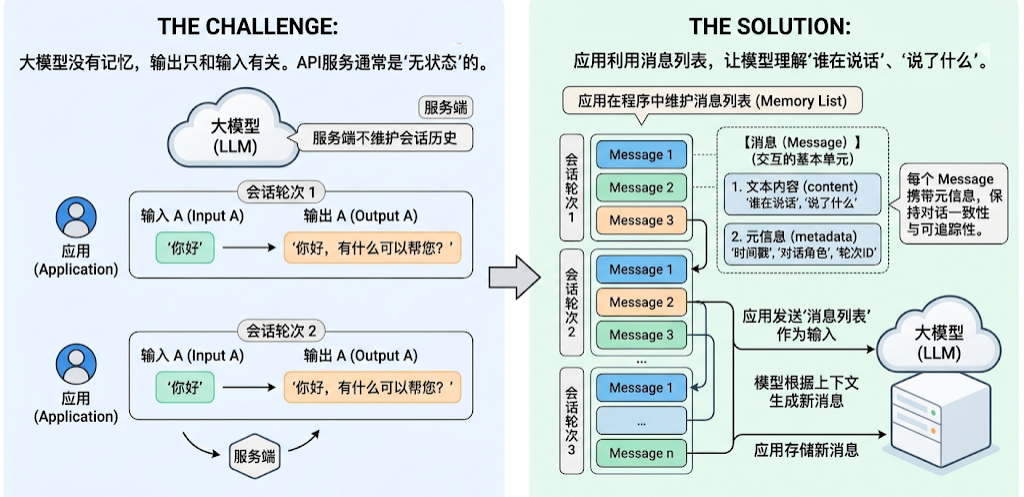
**在 LangChain 中,Message(消息)是模型交互的最基本单元。**它既代表模型接收到的 输入(Input) ,也代表模型生成的 输出(Output) 。
每一轮与大模型的对话,都由一条或多条 Message 构成。每个 Message 不仅包含 文字内容 ,还携带描述上下文状态的 元信息(metadata) ,用于保持对话的一致性和可追踪性。比如,模型在多轮交互中理解"谁在说话"、"说了什么"、"这条信息属于哪一轮对话"。
LangChain 在 1.0 中提供了跨模型统一的 Message 标准。无论你使用的是 OpenAI、Anthropic、
Gemini 还是本地模型,这一标准都能保持一致的行为。这样的好处是:
-
兼容性强 :不同模型的消息格式自动对齐。
-
可扩展性高 :方便添加多模态内容或自定义字段。
-
可追踪性好 :为 LangSmith 等调试工具提供一致的上下文数据结构。
2.2 Langchain 消息内部结构
LangChain的消息(Message)对象包含三种字段:
-
Role:消息所属的角色或类型,如 system 、 user 、 assistant 。
-
Content:消息内容
-
Metadata:(可选)元数据,存储额外信息。如:消息ID、响应时间、token消耗量、消息标签等
2.3 LangChain 消息类型
LangChain定义了很多消息类型,通过 role 进行区分,常用的有四种。
2.3.1 系统消息
也称为系统提示词,用于在对话开始时为模型设定角色、行为准则和上下文背景。它像是给AI助手的一份工作说明书,决定了其回答问题的风格、领域和专业范围。
bash
{"role": "system", "content": "你是个精通编程的软件架构师}2.3.2 用户消息
也称为用户提示词,在多轮对话中,它表示用户的一次输入。可以包含简单的文本问题,也可以是复杂的多模态内容(如图片、音频、文档等)。
bash
{"role": "user", "content": "你好啊~"}2.3.3 助手(AI)消息
代表模型的回复,包括生成的文本、工具调用、元数据等
bash
{"role": "assistant", "content": "我也很高兴认识你"}或者下面这样
bash
{
"role": "assistant",
"content": "",
"tool_calls": [{
"name": "get_weather",
"args": {"location": "北京"},
"id": "call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"
}]
}
2.3.4 工具调用消息
工具调用结果匹配的消息类型。将此消息返回给模型,让模型基于这个结果继续生成回复。在后面分享Tools的时候 详细介绍。
bash
{"role": "tool", "content": "今天天气很好", "tool_call_id":
"call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"}
问题:为什么使用不同的消息类型?
-
明确角色 :清晰区分系统提示、用户输入和 AI 回复
-
控制行为 :通过 SystemMessage 精确控制 AI 的行为
-
对话历史 :构建完整的多轮对话上下文
-
调试友好 :更容易追踪和调试对话流程
2.4 消息格式
在具体调用大模型API传递消息的时候,不同消息类型传递的格式也不一样,LangChain支持两种消息格式。
2.4.1 格式1:JSON格式
系统消息
bash
{"role": "system", "content": "你是个善解人意的助手"}用户消息
bash
{"role": "user", "content": "你好啊~"}助手消息
bash
{"role": "assistant", "content": "我也很高兴认识你"}工具调用消息
bash
{"role": "tool", "content": "<工具输出>", "tool_call_id":
"call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"}
如下是Json格式消息调用的完整示例
python
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
llm_model = init_chat_model(
    model="deepseek-v4-pro",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

# 通过JSON初始化
messages = [
    {"role": "system", "content": "你是一个善于给出通俗易懂解释的AI助手"},
    {"role": "user", "content": "你好"},
    {"role": "assistant", "content": "你好!我能帮你什么?"},
    {"role": "user", "content": "什么是机器学习"}
]
response = llm_model.invoke(messages)

print(response.content)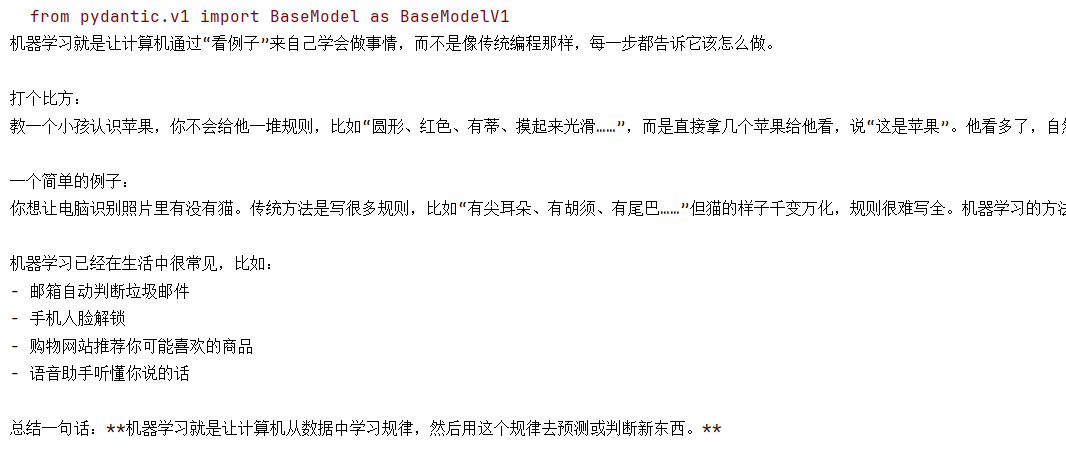
2.4.2 格式2:对象格式
在一些大型的项目中,对象格式是一种比较常见的,针对不同的角色也不相同
系统消息
bash
SystemMessage(content="你是个善解人意的助手")用户消息
python
HumanMessage(content="你好啊~")助手消息
bash
AIMessage("我也很高兴认识你")工具调用消息
bash
ToolMessage(
    content="<工具输出>",
    tool_call_id="call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s" # 一定要和AI消息中的调用ID匹配
)
比如下面的示例
python
# 消息列表示例
messages = [
    SystemMessage(content="你是一个助手"),
    HumanMessage(content="你好"),
    AIMessage(content="你好!有什么可以帮你?"),
    HumanMessage(content="天气怎么样?"),
    AIMessage(content="让我查询一下..."),
    ToolMessage(content="北京:晴天", tool_call_id="call_123"),
    AIMessage(content="北京今天是晴天")
]
下面是对象格式消息调用的完整示例
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage,HumanMessage,AIMessage
from dotenv import load_dotenv
import os

# 1、读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2、模型初始化
llm_model = init_chat_model(
    model="deepseek-v4-pro",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

# 通过JSON初始化
messages = [
    SystemMessage("你是一个善于给出通俗易懂解释的AI助手"),
    HumanMessage("你好"),
    AIMessage("你好!我能帮你什么?"),
    HumanMessage("什么是机器学习"),
]

response = llm_model.invoke(messages)

print(response.content)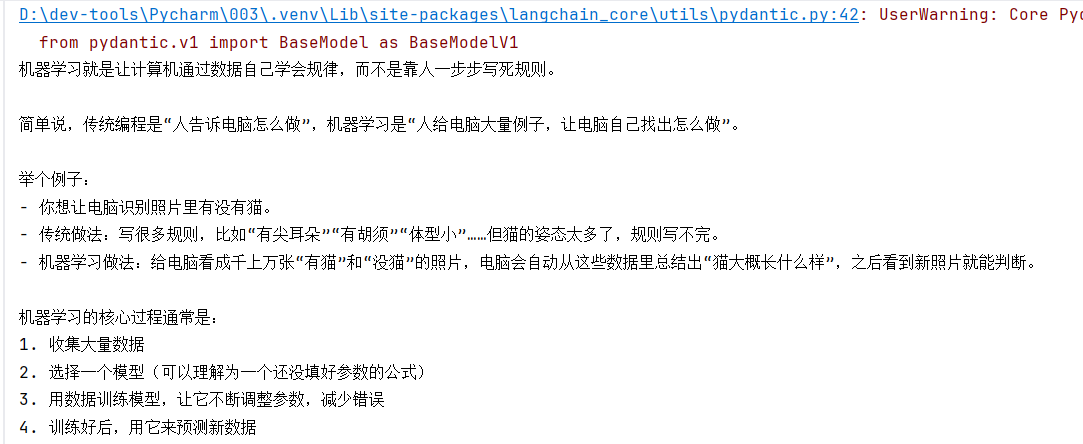
小结:
|-----------|----------------------------|--------------------|-------------------|----------------------|
| 角色 | 字典格式 | 对象格式 | 用途 | 示例 |
| System | {"role": "system", ...} | SystemMessage(...) | 设定 AI 的行 为、角色、规 则 | "你是一个专业的 数学老师" |
| User | {"role": "user", ...} | HumanMessage(...) | 用户输入 | "什么是微积分?" |
| Assistant | {"role": "assistant", ...} | AIMessage(...) | AI 的回复 | "微积分是研究变 化率的数学分支..." |
| Tool | {"role": "tool", ...} | ToolMessage(...) | 工具执行的结果 | "今天北京天气晴 朗,万里无云" |
2.4 消息对象 字段 说明
接下来对消息对象中的常用字段做深入的说明,此处仅说明常用 字段,完整字段列表可以通过查阅官方手册 或阅读 源码。
2.4.1 SystemMessage 参数列表
content :消息内容,字段名可以省略
bash
SystemMessage("你是个善解人意的助手")等同于
bash
SystemMessage(content = "你是个善解人意的助手")2.4.2 HumanMessage 参数列表
content :消息内容,字段名可以省略
bash
HumanMessage("你好啊~")相当于
python
HumanMessage(content = "你好啊~")metadata :元数据字段,可以有很多,自定义
举例:带有元数据字段
python
HumanMessage(
    content="Hello!",
    name="alice", # 可选,用户名
    id="msg_123", # 可选,message的ID
)
name 和 id 都属于元数据字段,当消息类型相同,对消息进行区分。但不是所有模型都支持这一功
能,是否支持取决于模型供应商,需要查看官方手册。比如:
-
OpenAI的API手册告诉我们,HumanMessage支持 name 作为元数据字段,如下图所示。
-
而 DeepSeek的API官方文档明确支持 name 作为元数据,但实测发现模型无法识别。
如下是使用OpenRouter进行调用的示例代码
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage
from dotenv import load_dotenv
import os

from langchain_openrouter import ChatOpenRouter

# 加载配置文件
load_dotenv(override=True)

OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")
OPENROUTER_API_BASE = os.getenv("OPENROUTER_API_BASE")

# 2、模型初始化
model = ChatOpenRouter(
    model="deepseek/deepseek-v3.2",
    api_key=OPENROUTER_API_KEY,
    base_url=OPENROUTER_API_BASE,
)

messages = [
    SystemMessage(
        "你是一个信息抽取器。你会收到多条来自不同发言者的 user 消息。每条消息可能带有 name 字段。你的任务是:严格根据每条消息的 name 提取发言者及其观点,并输出JSON。"
        "禁止使用"第一个人/第二个人"这种相对称呼。若某条消息没有 name,则输出 unknown。输出格式:{\"speakers\":[{\"name\":\"...\",\"claim\":\"...\"}]}"
    ),
    HumanMessage(
        content="我认为 1+1=2",
        name="Bob"
    ),
    HumanMessage(
        content="我认为 1+1>2",
        name="Tom"
    ),
    HumanMessage(
        content="请列出谁说了什么,不要判断对错。",
        name="audience"
    )
]

response = model.invoke(messages)
print(response.content)
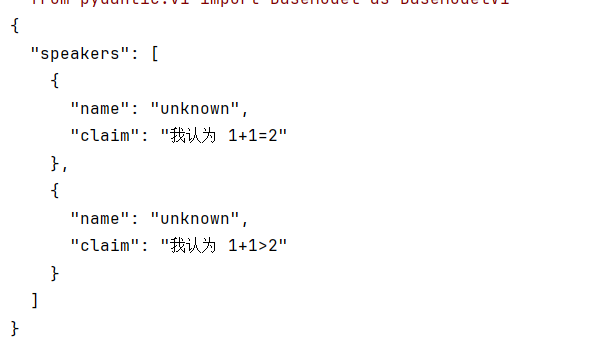
通过执行结果可以看到,name 输出为unknown,说明OpenRouter不支持
2.4.3 AIMessage 参数列表
content :模型输出的原始内容,字段名可以省略
bash
AIMessage("你好~")相当于
bash
AIMessage(content="你好~")response_metadata :AIMessage特有属性,LLM的响应中附加元数据,根据不同模型会有不同,如可能会包含本次token使用量等信息。
tool_calls :AIMessage特有属性,表示工具调用信息。当LLM决定调用工具时,在AIMessage 中就会包含这个属性,没有工具调用则为空。
- tool_calls属性是一个ToolCall 列表,每个ToolCall 是一个字典,包含字段见上。
结构如下:
python
tool_calls=[
    {
        'name': 'get_weather', // 应调用的工具名
        'args': {'city': '杭州'}, // 调用工具的参数
        'id': 'call_00_gIXYOD1Q1OkEXmdDBqXR1578', // 工具调用的唯一标识ID
        'type': 'tool_call'
    },
    {
        'name': 'get_news',
        'args': {},
        'id': 'call_01_jD3phD5PEaIZf0mVLhKt0861',
        'type': 'tool_call'
    }
]
比如下面的代码中,展示了如何在AIMessage 中调用工具
python
AIMessage(
    content="",
    tool_calls=[{
        'name': 'get_weather',
        'args': {'city': '北京'},
        'id': 'call_xxx'
    }]
)
下面是一个完整的调用案例
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage
from dotenv import load_dotenv
import os

from langchain_openrouter import ChatOpenRouter

# 加载配置文件from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage
from dotenv import load_dotenv
import os

from langchain_openrouter import ChatOpenRouter

# 加载配置文件
load_dotenv(override=True)

OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")
OPENROUTER_API_BASE = os.getenv("OPENROUTER_API_BASE")

# 2、模型初始化
model = ChatOpenRouter(
    model="deepseek/deepseek-v3.2",
    api_key=OPENROUTER_API_KEY,
    base_url=OPENROUTER_API_BASE,
)

messages = [
    SystemMessage("你叫小智,是一名助人为乐的助手。"),
    HumanMessage("你好,好久不见,请介绍下你自己。")
]
response = model.invoke(messages)
print(response)
响应结果如下
- usage_metadata :模型调用时用量信息
python
AIMessage(
    content='你好呀!很高兴再次与你相遇!✨\n\n我是小智,一个由深度求索公司创造
的AI助手。我的核心使命就是尽我所能为你提供帮助------无论是回答问题、协助思考、解决
实际问题,还是陪你聊聊天放松心情,我都会用热情和专业来回应你。\n\n简单来说:\n
🔹
**知识范围**:涵盖科学、技术、人文、生活等广泛领域(但知识截止于2024年7月)\n🔹
**能力特点**:支持长文本处理、文件上传(可读取图像/文本/PDF等格式内容)、联网搜
索(需要你手动开启)\n🔹 **风格**:倾向于细致、耐心且带一点温暖感的交流方式\n🔹
**初心**:不做价值判断,尊重你的视角,专注提供实用信息\n\n距离上次聊天可能已经
有一段时间了,如果你有任何新的问题或想聊的话题,我随时在这里等你开口~ 🌟',
    additional_kwargs={},
    response_metadata={
        'model_name': 'deepseek/deepseek-v3.2',
        'id': 'gen-1789000800-SbvYOpJwOKLlQnCAMuxH',
        'created': 1789000800,
        'object': 'chat.completion',
        'finish_reason': 'stop',
        'logprobs': None,
        'model_provider': 'openrouter',
        'cost': 7.794e-05,
        'cost_details': {
            'upstream_inference_completions_cost': 7.144e-05,
            'upstream_inference_prompt_cost': 6.5e-06,
            'upstream_inference_cost': 7.794e-05
        }
    },
    id='lc_run--01a088c1-d432-7212-8caf-169810195498-0',
    tool_calls=[],
    invalid_tool_calls=[],
    usage_metadata={
        'input_tokens': 25,
        'output_tokens': 188,
        'total_tokens': 213,
        'input_token_details': {'cache_read': 0, 'cache_creation': 0},
        'output_token_details': {'reasoning': 0}
    }
)
2.4.4 ToolMessage 参数列表
核心参数:
-
content :文件内容
-
name :工具名称
-
tool_call_id :工具调用唯一ID,ToolMessage必须紧邻匹配的AIMessage,和前者tool_calls中的id一致
参数消息结构如下:
python
ToolMessage(
    content="<工具输出>",
    name="get_weather",
    tool_call_id="call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"
)
看下面完整示例
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage
from dotenv import load_dotenv
import os

from langchain_openrouter import ChatOpenRouter

# 加载配置文件
load_dotenv(override=True)

OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")
OPENROUTER_API_BASE = os.getenv("OPENROUTER_API_BASE")

# 2、模型初始化
model = ChatOpenRouter(
    model="deepseek/deepseek-v3.2",
    api_key=OPENROUTER_API_KEY,
    base_url=OPENROUTER_API_BASE,
)

def get_weather(city: str) -> str:
    return "天气很好"

# 模拟模型绑定工具
model_with_tools = model.bind_tools([get_weather])

ai_message = {
    "role": "assistant",
    "content": "",
    "tool_calls": [{
        "name": "get_weather",
        "args": {"location": "北京"},
        "id": "call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"
    }]
}

tool_message = {
    "role": "tool",
    "content": "今天北京天气晴朗,万里无云~",
    "tool_call_id": "call_00_nUD2NC9QRN5Cg1GaoIkBJQ4s"
}

messages = [
    {"role": "user", "content": "北京天气如何"},
    ai_message,
    tool_message
]

response = model.invoke(messages)

from rich import print as rprint
rprint(response)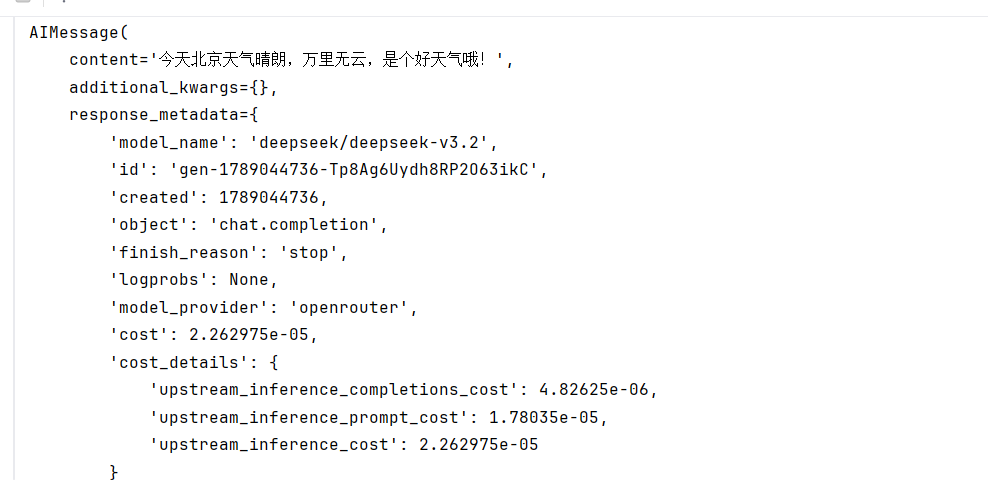
2.5 对话历史管理
2.5.1 会话记忆介绍
在学习大模型对话的时候应该还有印象,大模型是没有记忆的,如果不做记忆管理,下一轮对话时大模型就不记得上一轮对话内容了,解决这个会话记忆一种最简单的方式就是每次调用必须传递完整的对话历史,比如下面这样:
python
第 1 轮:
[system, user] → AI回复 → 保存回复

第 2 轮:
[system, user, assistant, user] → AI回复 → 保存回复

第 3 轮:
[system, user, assistant, user, assistant, user] → AI回复
注意:
- 这种方式下,每次对话都要在原有的消息列表中添加新消息 ,不可重新创建新的列表。
下面是几个错误的示例
python
# 第一次
response1 = model.invoke("我叫张三")

# 第二次(没传历史)
response2 = model.invoke("我叫什么?") # AI 不记得!
python
conversation = [{"role": "user", "content": "问题1"}]
response1 = model.invoke(conversation)

conversation = [{"role": "user", "content": "问题2"}] # 重新创建!
response2 = model.invoke(conversation) # 丢失了历史
python
conversation = []
conversation.append({"role": "user", "content": "问题1"})
response1 = model.invoke(conversation)

# 忘记保存 response1.content!
conversation.append({"role": "user", "content": "问题2"})
response2 = model.invoke(conversation) # AI 不知道之前的回答
2.5.2 对话历史优化
如果使用上面的方式,对话历史会越来越长,不可避免的会消耗大量 tokens ,增加成本。
解决方案:只保留最近 N 轮对话,具体来说:
-
总是保留 system 消息(定义角色)
-
只保留最近 N 轮对话,丢弃更早的历史
在下面的案例中,定义一个保留最近对话轮数的函数,后面在多轮对话中调用
python
def keep_recent_messages(messages, max_pairs=3):
    """
    保留最近的 N 轮对话
    max_pairs: 保留的对话轮数(每轮 = user + assistant)
    """
    # 分离 system 和对话
    system_msgs = [m for m in messages if m.get("role") == "system"]
    conversation_msgs = [m for m in messages if m.get("role") != "system"]
    # 只保留最近的
    recent_msgs = conversation_msgs[-(max_pairs * 2):]
    # 返回:system + 最近对话
    return system_msgs + recent_msgs
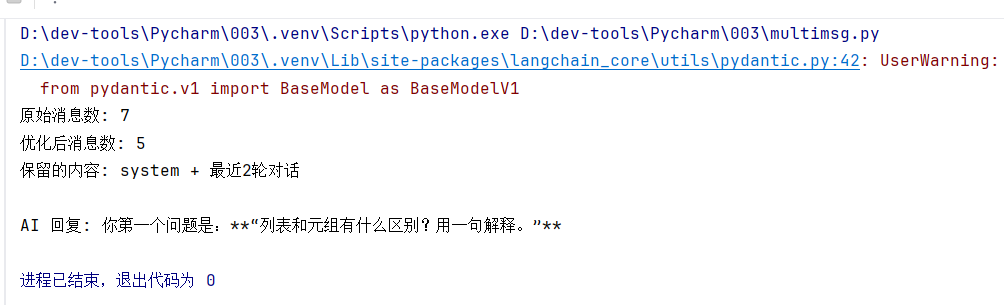
完整的示例如下,在下面的案例代码中,进行了3轮对话,通过上面的方式对多轮对话进行优化
python
from langchain.chat_models import init_chat_model
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage
from dotenv import load_dotenv
import os

from langchain_openrouter import ChatOpenRouter

# 加载配置文件
load_dotenv(override=True)

OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")
OPENROUTER_API_BASE = os.getenv("OPENROUTER_API_BASE")

# 2、模型初始化
model = ChatOpenRouter(
    model="deepseek/deepseek-v3.2",
    api_key=OPENROUTER_API_KEY,
    base_url=OPENROUTER_API_BASE,
)

def keep_recent_messages(messages, max_pairs=3):
    """
    保留最近的 N 轮对话
    max_pairs: 保留的对话轮数(每轮 = user + assistant)
    """
    # 分离 system 和对话
    system_msgs = [m for m in messages if m.get("role") == "system"]
    conversation_msgs = [m for m in messages if m.get("role") != "system"]
    # 只保留最近的
    recent_msgs = conversation_msgs[-(max_pairs * 2):]
    # 返回:system + 最近对话
    return system_msgs + recent_msgs


# 初始化
long_conversation = [
    {"role": "system", "content": "你是 Python 导师"}
]

# 第 1 轮
long_conversation.append({"role": "user", "content": "什么是列表?用一句解释"})
r1 = model.invoke(long_conversation)
long_conversation.append({"role": "assistant", "content": r1.content})

long_conversation.append({"role": "user", "content": "列表和元组有什么区别?用一句解释"})
r2 = model.invoke(long_conversation)
long_conversation.append({"role": "assistant", "content": r2.content})

# 第 3 轮
long_conversation.append({"role": "user", "content": "什么是字典呢?用一句解释"})
r3 = model.invoke(long_conversation)
long_conversation.append({"role": "assistant", "content": r3.content})

print(f"原始消息数: {len(long_conversation)}")

# 优化:只保留最近 2 轮
optimized = keep_recent_messages(long_conversation, max_pairs=2)

print(f"优化后消息数: {len(optimized)}")
print(f"保留的内容: system + 最近2轮对话")

# 添加新的用户问题
optimized.append({"role": "user", "content": "我第一个问题问的是什么?"})
# 使用优化后的历史
response = model.invoke(optimized)
print(f"\nAI 回复: {response.content}")
通过这种方式可以让大模型在对话时记住前面的对话内容
三、Langchain 消息扩展
Langchain 除了上文中的几个类型的消息,还有一些扩展的属性,下面做一些介绍。
3.1 content 使用
消息的 content 可以理解为数据内容,它是弱类型的,支持字符串和列表(列表元素通常为字典)
1、存储字符串
这是比较常见的一种形式,如果只是纯文本内容,直接传递字符串就好
- 当content内容只有字符串时,可以省略参数名称
python
from LangChain.messages import HumanMessage
msg1 = HumanMessage(content = "你好啊")
msg2 = HumanMessage("你好啊")
print(msg1)
print(msg2)
2、存储字典列表
如果需要发送的不只是文本,如多模态内容,则需要content的 字典列表 形式。
字典内容遵循模型供应商的API规范,以 openai: gpt-4.1 为例。
参考官网文档:Create chat completion | OpenAI API Reference
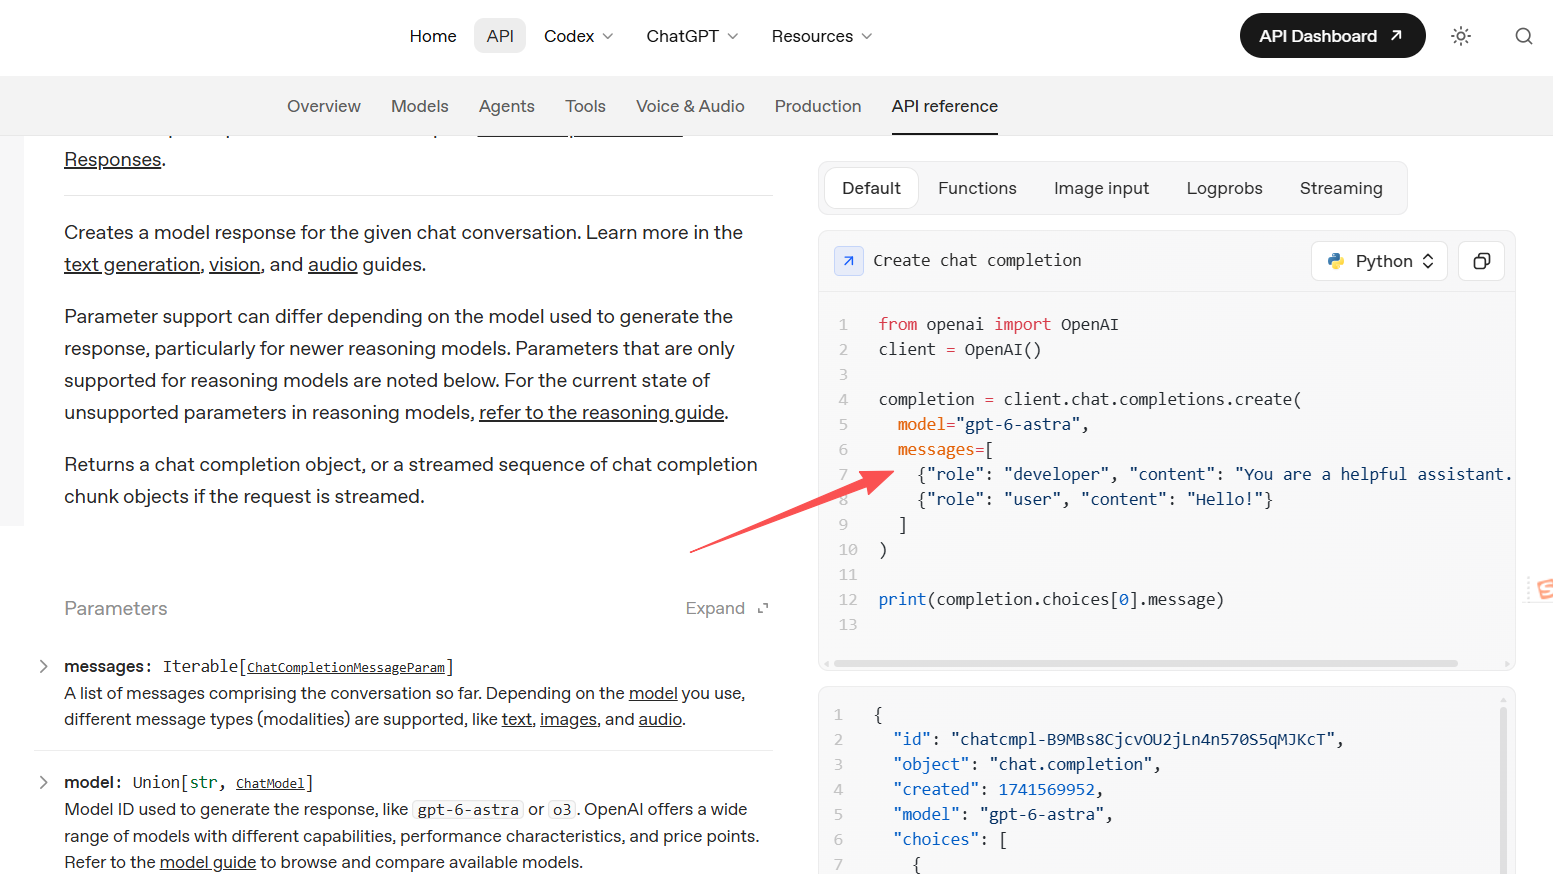
如下示例:
python
from openai import OpenAI
client = OpenAI()

completion = client.chat.completions.create(
  model="gpt-6-astra",
  messages=[
    {"role": "developer", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Hello!"}
  ]
)

print(completion.choices[0].message)
四、写在最后
本文详细介绍了Langchain中各种类型消息的使用,希望对看到的同学有帮助,本篇到此结束,感谢观看。