一、起点:我不是需要一个聊天平台,我是需要一个能聊天的窗口
先说清楚问题。我要的能力只有两条:
- 用本地模型聊天,数据不出本机;
- 聊过的东西能被留下来,以后翻得到。
结果我第一版方案上的是 Open WebUI。功能确实全------多用户、知识库、RAG、工具调用、插件系统,一样不缺。
代价是:为了"聊天"这两个字,我引入了一个完整的应用平台。
它的崩溃方式也很有代表性。某天它起不来了,启动脚本报的是这样一行:
swift
FileNotFoundError: [Errno 2] No such file or directory:
'/Users/<me>/.workbuddy/open-web-ui-venv/bin/open-web-ui'看起来像"入口文件丢了",实际是整个 venv 没了 。而 venv 没了意味着 requests、向量库客户端、open_webui.utils.auth 这一串依赖全没了------换一个解释器根本跑不起来。于是它从那天起一直躺到现在,我的自动任务每天照点跑、每天跳过,日志里连续好几天写着同一句"WebUI 未运行"。
这段经历给我的结论很直接:只想要窗口,就别请一整套平台。要平台能力,就别指望它只有一个二进制。
下面是我换成的结构。
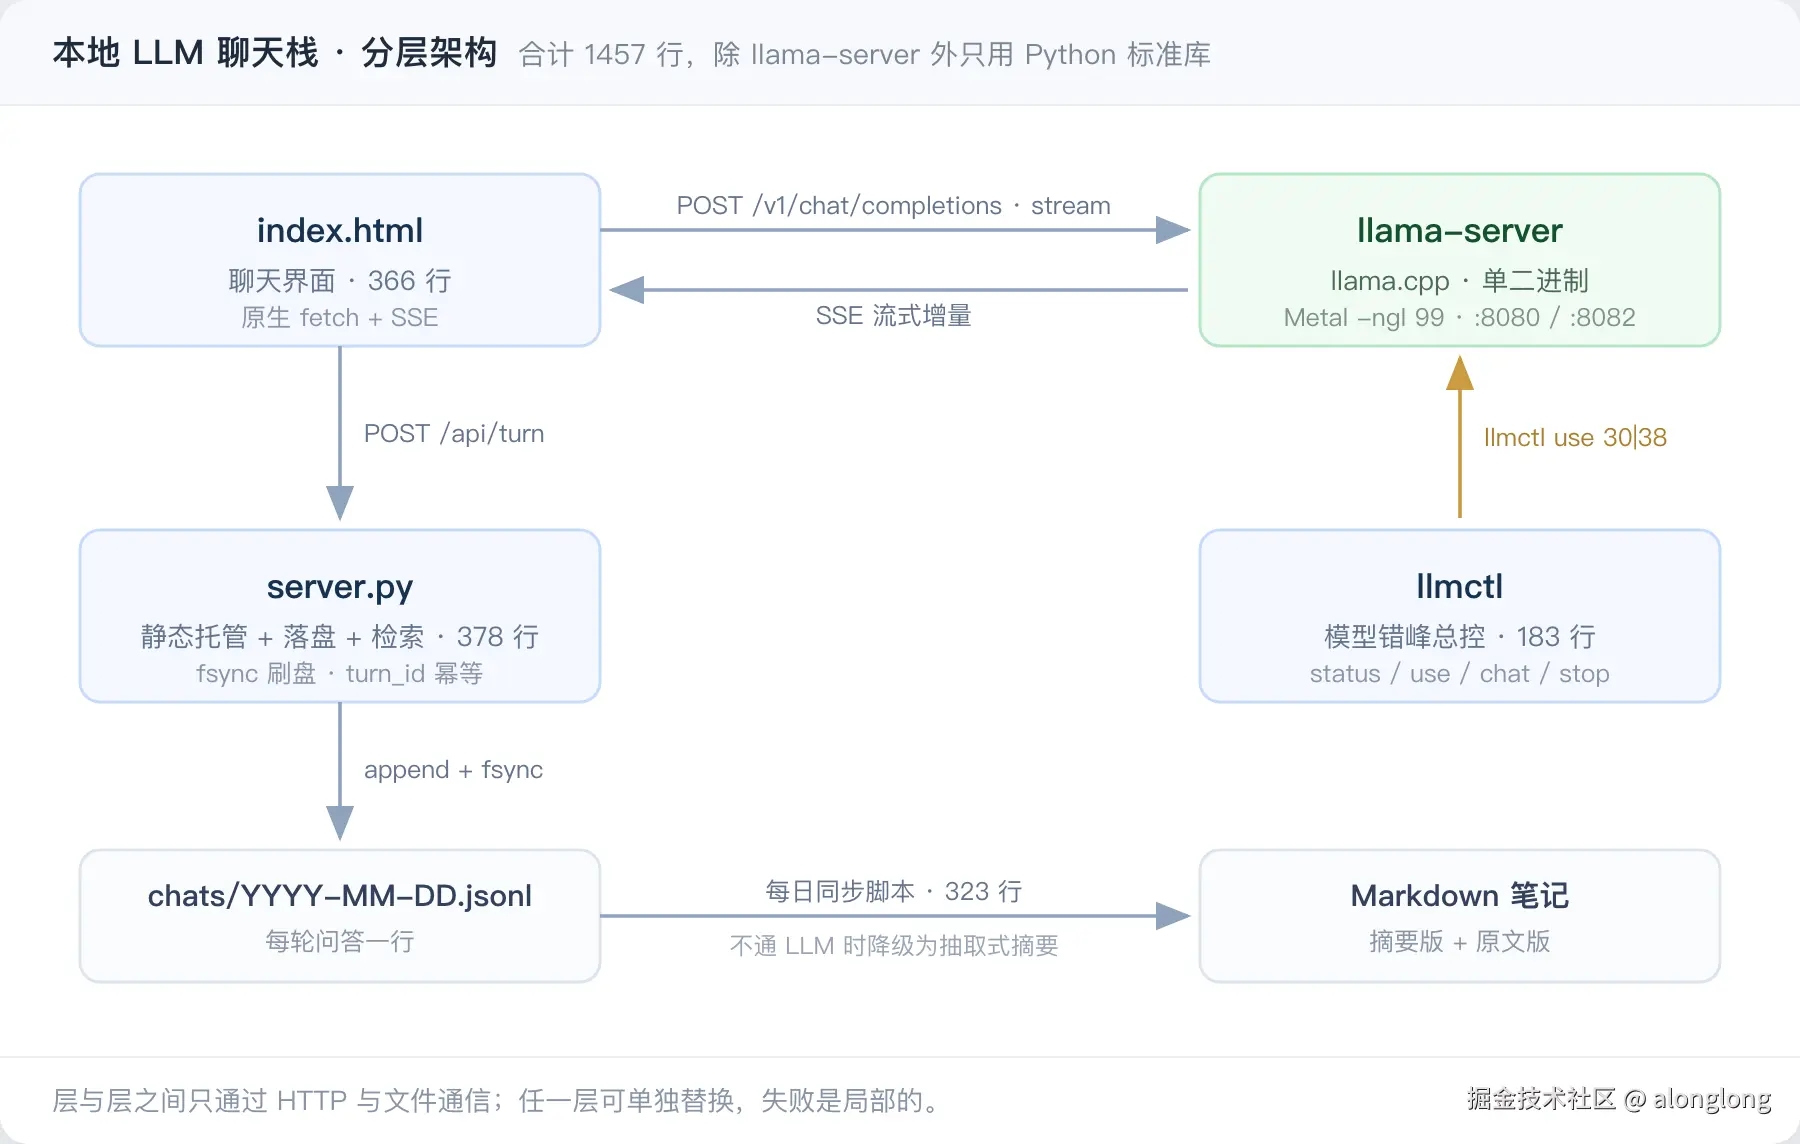
二、新架构:三层,每层都可以单独换掉
vbscript
┌─────────────┐   fetch + SSE    ┌──────────────────┐
│  index.html │ ───────────────▶ │  llama-server     │
│  (366 行)   │ ◀─────────────── │  :8080 / :8082    │
└──────┬──────┘   OpenAI 兼容     └──────────────────┘
       │ POST /api/turn                    ▲
       ▼                                   │ llmctl use 30|38
┌─────────────┐                    ┌──────┴───────┐
│  server.py  │                    │   llmctl     │
│  (378 行)   │                    │  (183 行)    │
└──────┬──────┘                    └──────────────┘
       ▼
chats/YYYY-MM-DD.jsonl ──▶ 每日同步脚本 ──▶ Markdown 笔记拆开说:推理 交给 llama.cpp 的 llama-server;界面 就是一个 HTML 文件;调度交给一个 shell 脚本。三层之间只通过 HTTP 和文件通信------任何一层我不满意,单独换掉,不用动另外两层。
三、推理层:为什么选 llama.cpp
关键理由是它不需要 Python。
- 直接吃 GGUF 量化权重,一个二进制就是一台服务;
- Apple Silicon 上走 Metal 后端(
-ngl 99把全部层丢给 GPU); - 自带 OpenAI 兼容端点
/v1/chat/completions,前端不用为它写适配; - 可选多模态:加一个
--mmproj指向视觉投影文件,就能直接发图。
启动命令就一行核心:
bash
llama-server \
  --model /path/to/Qwen3.8-27B-Q8_0.gguf \
  --alias qwen3.8-27b-local \
  -ngl 99 -c 16384 \
  --host 127.0.0.1 --port 8082 \
  --mmproj /path/to/mmproj-Qwen3.8-27B-Q8_0.gguf
对比 Open WebUI 那条链,这里没有 venv、没有 pip、没有迁移脚本。一个二进制起不来,就只有一个原因。
四、取舍一:64GB 内存装不下"全都要",那就错峰
我这台机器是 64GB 统一内存。实际要跑的两个模型:
| 模型 | 量化 | 体积 |
|---|---|---|
| Qwen3-Coder-30B-A3B-Instruct | Q8_0 | 32.5 GB |
| Qwen3.8-27B | Q8_0 | 28.6 GB(+ 视觉模块 629 MB) |
两个随便并排就超过 60GB。加上系统、浏览器、各种常驻服务,同时开必然触发 swap,然后就是全程卡顿。
所以我把设计从"服务多模型"改成"服务一个模型":同一时刻只跑一个,靠一个总控脚本切换。
llmctl 的核心就是 use <key> 这四步:
bash
use() {
  # 1) 先杀掉当前所有本地模型,等端口真正释放
  pkill -f "llama-b11306/llama-server"
  while lsof -nP -iTCP:"$PORT" -sTCP:LISTEN >/dev/null 2>&1 && [ $i -lt 20 ]; do
    sleep 0.5; i=$((i+1))
  done
  # 2) 起新模型
  nohup "$LLAMA" --model "$PATH_" --alias "$ALIAS" -ngl 99 -c 16384 \
    --host 127.0.0.1 --port "$PORT" $EXTRA > "/tmp/llm_${key}.log" 2>&1 &
  # 3) 轮询 /health 直到真的就绪(最多 120 秒)
  while ! curl -s -o /dev/null -m 2 "http://127.0.0.1:$PORT/health" && [ $i -lt 120 ]; do
    sleep 1; i=$((i+1))
  done
  # 4) 落一份 active_model.json,让前端知道现在是谁在服务
  cat > "$STATE" <<JSON
{ "port": $PORT, "model": "$ALIAS", "name": "$NAME", "vision": $VISION }
JSON
}
这里有两个细节值得单独说:
第一个是"等端口真正释放"。 pkill 之后立刻起新模型,端口可能还被旧进程攥着,结果是新进程绑不上、静默退出,你还以为是模型加载慢。所以必须 lsof 轮询到端口真空。
第二个是 active_model.json。 前端不该写死模型名和端口------那样每换一次模型都要改前端。让总控产出一个状态文件、前端读它,切换就成了单边动作:
js
fetch('./active_model.json', {cache:'no-store'})
  .then(r => r.json())
  .then(s => {
    const key = Object.keys(MODELS).find(k => MODELS[k].port === s.port);
    if (key) modelSel.value = key;
  });
错峰的代价要讲清楚 :换模型不是瞬时的。杀掉旧模型 + 加载 30GB 权重,一次大约要等十几秒到几十秒。所以这个设计适合"一段时间内用同一个模型",不适合"每句话换个模型聊"。如果你的内存够同时装下,那就不需要这套东西------这是我为了 64GB 做的妥协,不是通用最优解。
五、取舍二:界面不引框架,366 行够用
聊天窗口要做的事其实很少:流式渲染回答、能发图、能连上正确的端口。原生就够了。
流式部分用 ReadableStream 手动切 SSE,不需要任何 SDK:
js
const resp = await fetch(`http://127.0.0.1:${m.port}/v1/chat/completions`, {
  method: 'POST',
  headers: { 'Content-Type': 'application/json', 'Authorization': 'Bearer sk-local' },
  body: JSON.stringify({ model: m.model, messages, stream: true })
});
const reader = resp.body.getReader();
const dec = new TextDecoder();
let buf = '';
while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buf += dec.decode(value, { stream: true });
  const lines = buf.split('\n');
  buf = lines.pop();                 // 最后一段可能不完整,留到下一轮
  for (const line of lines) {
    const s = line.trim();
    if (!s.startsWith('data:')) continue;
    const data = s.slice(5).trim();
    if (data === '[DONE]') continue;
    acc += JSON.parse(data).choices?.[0]?.delta?.content || '';
  }
}两个容易踩的点:buf = lines.pop() 不能省 (网络分片会把一行 JSON 从中间切开,不缓存残片就会 JSON.parse 炸);[DONE] 要显式跳过(它不是 JSON)。
多模态也简单------模型带视觉时把消息体换成数组形态:
js
[{ type: 'text', text: '描述一下这张截图' },
 { type: 'image_url', url: 'data:image/png;base64,...' }]
界面按钮只在该模型 vision: true 时才出现。
六、取舍三:对话要留得下来,落盘得自己补
这一节是我这次新补的,之前确实没有。 原来的界面是纯静态托管(python -m http.server),刷新页面、关掉标签页,对话就没了------一个不能留存对话的聊天窗口,严格说只是个调试工具。
静态服务器收不了 POST,所以要换掉。我写了一个 154 行的后端,做三件事:
python
do_GET:  /api/health          → {"ok": true, "date": "...", "turns": 12}
do_GET:  /api/turns?date=...  → 回读当天落盘结果
do_POST: /api/turn            → 追加一行到 chats/YYYY-MM-DD.jsonl
(说明:这个文件现在是 378 行,多出来的部分是后来加的本地语义检索端点------那是另一条链路,单独一篇写。)
写入这段是重点:
python
with _lock:
    with open(path, "a", encoding="utf-8") as f:
        f.write(json.dumps(rec, ensure_ascii=False) + "\n")
        f.flush()
        os.fsync(f.fileno())     # 不加这行,进程被 kill 时最后几轮会丢
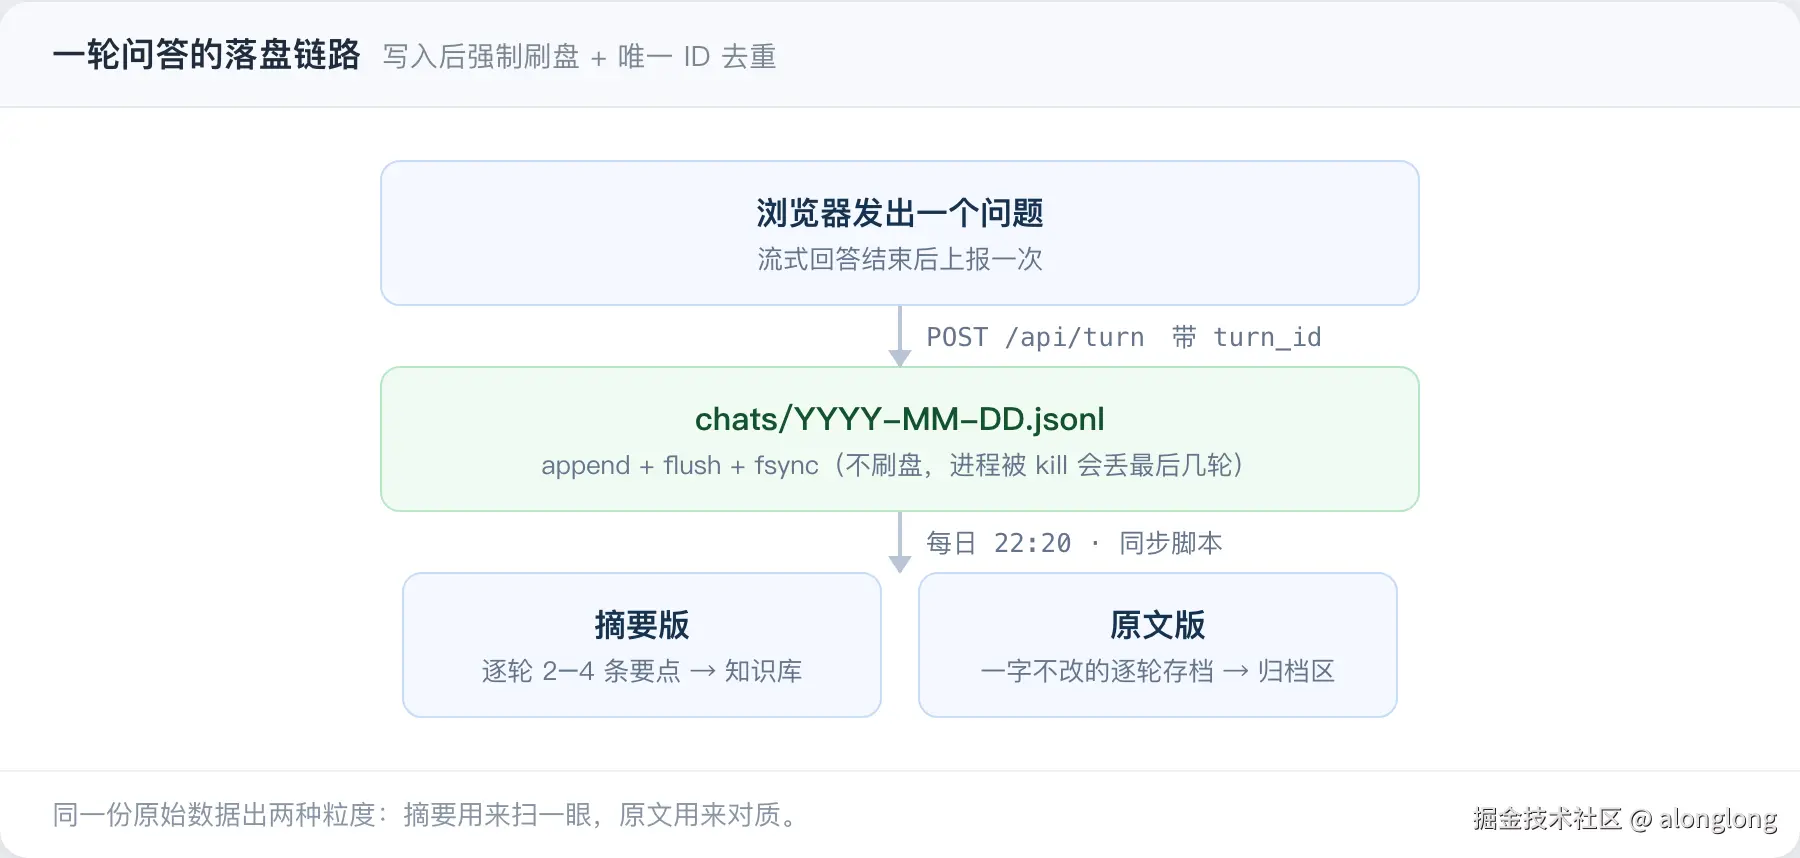
为什么 fsync 不能省 :flush() 只把数据推给操作系统,掉电或进程被强杀时仍可能丢。聊天记录这种"丢了就不可重建"的东西,值得多花这点 IO。
幂等 :每条记录带 turn_id,同一天内重复投递直接返回 duplicated: true 不入库。这样前端重试逻辑可以放心写。
前端一侧,每轮回答结束后 POST 一次,失败就进 localStorage 队列、下次打开页面自动补交:
js
async function logTurn(userText, assistantText, m) {
  const rec = { turn_id: 生成ID(), ts: new Date().toISOString(),
                model: m.model, model_name: m.name,
                user: userText, assistant: assistantText };
  try { await postTurn(rec); }
  catch (e) {
    const q = JSON.parse(localStorage.getItem(LS_KEY) || '[]');
    q.push(rec); localStorage.setItem(LS_KEY, JSON.stringify(q));
  }
}这层兜底很关键:后端没起来的时候,用户不需要知道,也不该因此丢数据。 顺带一个设计细节------后端是同一个进程顺带托管静态文件的,所以前端调用 /api/* 是同源请求,不用碰 CORS。
有了 jsonl 之后,把它们变成人看得懂的东西就是纯加工了。每天一个同步脚本(323 行):
- 读当天
chats/YYYY-MM-DD.jsonl; - 优先调本机
llama-server逐轮出 2--4 条要点;三个端点依次探测/health,全不通就降级为抽取式摘要(截首句 + 截回答首段); - 写两份 Markdown------摘要版进知识库、原文版进归档目录;
- 落一份状态文件,记录当天轮数、摘要引擎、产出路径。
同一份原始数据出两种粒度,是有意的:摘要用来"扫一眼今天聊了什么",原文用来"当时那句话到底是怎么说的"。
七、最硬的一个坑:Codex 新版把 chat 接口禁了
我除了聊天页,还希望桌面版 Codex 能直接跑本地模型。这一步踩的坑最多。
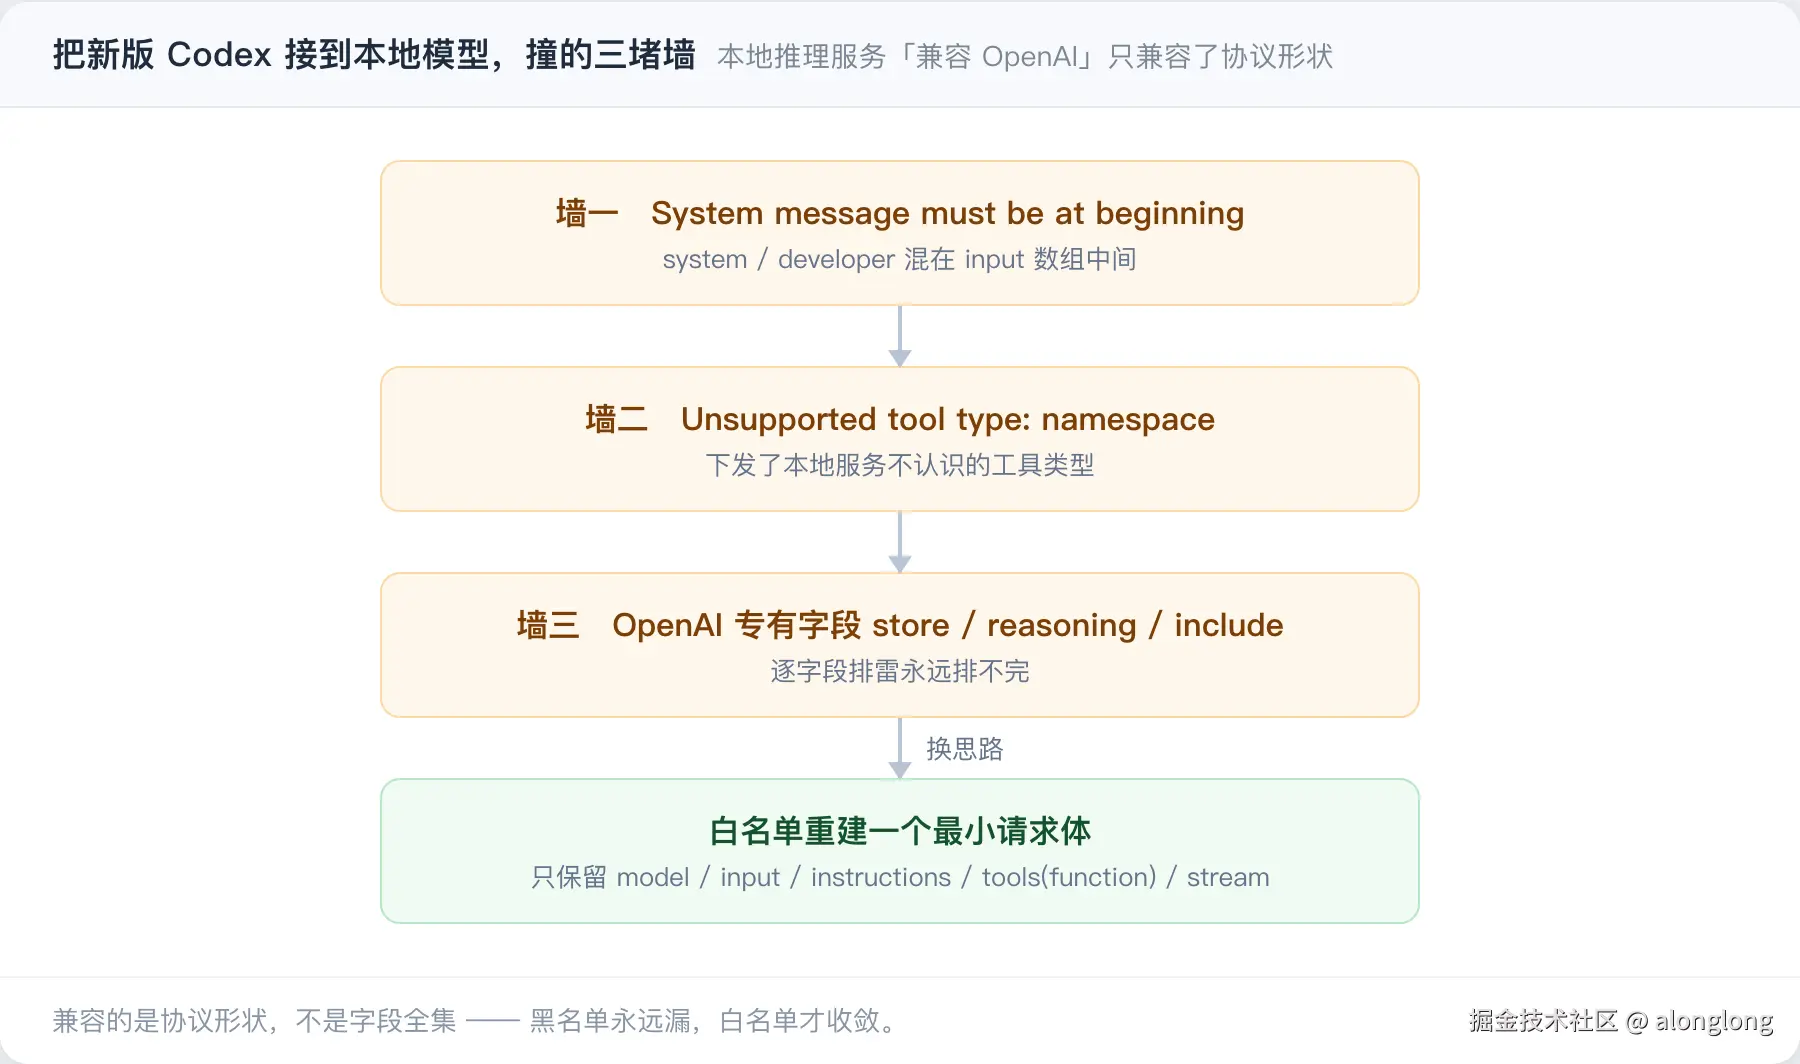
问题 :Codex 新版不再接受 chat completions 作为 wire API,只认 responses(参见 openai/codex#7782)。而本地 llama.cpp 虽然号称 OpenAI 兼容,实际对接时会撞三堵墙:
墙一:System message must be at beginning
Codex 会把 system / developer 消息混在 input 数组里下发,而 llama.cpp 要求 system 必须在最前面。必须在代理里把它们抽出来、合并进 instructions 字段:
python
# 伪码:把 input 里的 system/developer 合并进 instructions
sys_msgs = [m for m in payload.get("input", []) if m.get("role") in ("system", "developer")]
if sys_msgs:
    payload["instructions"] = "\n\n".join(提取文本(m) for m in sys_msgs) + "\n\n" + payload.get("instructions", "")
payload["input"] = [m for m in payload["input"] if m.get("role") not in ("system", "developer")]墙二:Unsupported tool type: namespace
Codex 会下发一些 namespace 形态的工具组,llama.cpp 不认。得在转发前把非 function 类型的工具整个丢掉。
墙三:OpenAI 专有字段
store、reasoning、include 这类字段 llama.cpp 不认识,会直接报错。与其逐字段排雷,不如重建一个最小 payload ------只保留 model / input / instructions / tools(仅 function) / stream / max_output_tokens。
最后写成 207 行代理,监听 :8083 转发到 :8082:/v1/responses 消毒后转发、SSE 原样透传,GET /v1/models 直接放行。
这里有个通用教训 :所谓"XX 兼容 OpenAI 接口",兼容的是协议形状 ,不是字段全集 。真实客户端总会带上你没预料的字段。代理的正确写法是白名单重建,不是黑名单剔除------黑名单永远漏。
八、现状、代价和没做完的
不吹,说具体状态:
跑通的:两个本地模型错峰切换;聊天页流式输出 + 多模态附图;每轮对话落盘 jsonl;每日自动生成摘要版 + 原文版两份笔记;模型不运行时摘要自动降级为抽取式,链路不会断。
有代价的:
- 换模型要等十几秒到几十秒,不适合高频切换;
- 聊天记录落在应用同目录下,外接盘没挂载时落盘目录直接不存在------脚本会明确报错并退出,而不是假装成功(这点我特意做成硬失败:宁可让你看到红字,也不要你以为在存其实全丢);
- 单机单用户设计,没有权限、没有多账号。不需要,也不打算加。
没做完的:
- 前端还没有对话列表/历史管理,只有"今天"这一个维度;
- 摘要仍是一轮一轮做,没做跨轮的话题聚合;
- 原文归档目前一天一个文件,聊得多了会很长,该按话题切。
九、小结
如果重来一次,我的判断标准会是这样:
- 只想要一个本地模型的聊天窗口:llama-server 加一个 HTML 就够了,别上平台;
- 确实需要多用户、RAG、插件:老老实实用成熟平台,但请接受它"依赖一断就整体趴下"的运维成本;
- 内存装不下多个模型:别硬并排,做错峰,并且把"切换有成本"这件事写进使用习惯里;
- 说了"兼容 OpenAI":按白名单重建请求,别按黑名单删字段。
从 Open WebUI 换成这套,功能是变少的,但我清楚每一行为什么在那儿,也知道它坏的时候会怎么坏。 对我这种一个人维护一条链路的情况,这个确定性比功能数量值钱。
复现清单
| 文件 | 行数 | 职责 |
|---|---|---|
index.html |
366 | 聊天界面(原生 fetch + SSE + 多模态 + 检索) |
server.py |
378 | 静态托管 + 对话落盘 API + 语义检索端点 |
llmctl |
183 | 模型错峰总控(status / use / chat / stop / codex) |
llm38-proxy.py |
207 | Codex ↔ llama.cpp 协议适配 |
llm-chat-sync.py |
323 | 对话 → Markdown 每日沉淀 |
合计 1457 行。除 llama-server 外,只有检索部分用到 numpy,其余全部是 Python 标准库。
行数为发布当日实测(wc -l)。其中 index.html 与 server.py 含后来追加的检索部分;本文正文只讲替换与落盘,检索那条链路另篇详述。