大家好,我是晚安code。
谷歌 9 月 30 日甩出了 Gemini 4 Argon,官方口径是"前沿智能的新时代",DeepSWE 跑分 77.9% 直接压过 GPT-6 Astra 和 Claude Opus 5.5。朋友圈当天就刷屏了。
但我翻了十几家报道之后,发现两件更值得说的事:第一,这个价格是推广价,过后要翻倍;第二,谷歌压根没公布它的上下文窗口,而一堆媒体已经把"100 万输出 token"写成了"100 万上下文"。
这篇把价格、用途、对比三件事讲透,看完你能判断自己现在到底该不该盯它。
一、先把结论放前面
Gemini 4 Argon(Google DeepMind 于 2026 年 9 月 30 日发布的前沿模型):谷歌首个 Gemini 4 系列模型,官方定位是长周期软件工程、企业知识工作、网络安全防御三类重活。你可以理解成"不是更聪明的聊天机器人,而是能连续干几小时活的实习生"。
它的核心升级只有一个:单次输出上限从上一代的 6.4 万 token 提到 100 万。上下文窗口、参数量、架构,官方全都没说。
这个升级方向很说明问题。以前的模型比的是"一次能读进去多少",Argon 比的是"一次能自己吐出多少"。差别在于:读得多是为了回答问题,写得多是为了把活干完------一次生成几十万 token,意味着它能在单次推演里写完整套重构方案、跑完一轮漏洞排查、产出几十个文件。
说白了,谷歌这次不是在优化"问答",是在优化"交活"。
二、它到底接什么活
按官方给的三个方向拆:
1、长周期软件工程
这是主战场。谷歌说自家工程师已经在用它做日常除错、算法设计和大规模代码库迁移。公开案例是把 C/C++ 代码库迁到 Rust------从 re2、libgav1 这类核心库的几万行,到 Fuchsia Zircon 内核的 80 万行以上。其中 libgav1 那次,代理替换了 3.2 万行 SIMD 代码,产出的内存安全视频解码器比原 Rust 版本快 2.7 倍,输出画面一致。
2、企业知识工作
法律、金融、税务这类需要翻一堆材料再下判断的活。它在按行业对美国 GDP 贡献加权的 Vals Index 上排第一,金融研究、法律代理这两个专项基准也领先。多模态能力能读专业图表、长视频细节(LVBench 91.7%)。
3、网络安全防御
这是旗舰卖点。它号称能自主发现、验证并修补关键软件漏洞,在 CWE-bench v1 上得 68%,与对手并列第一。安全公司 Wiz 通过"Scan for Good"计划试用后,说它找到了一个影响全球医院所用医疗软件的高危漏洞,此前的前沿模型都没发现。
不是说它全能,而是说它的能力边界画得很清楚------凡是"要连续做很多步、中间产出量巨大"的任务,都在它的射程里;凡是你只问一句话要个答案,它都属于杀鸡用牛刀。
三、价格:2 美元和 10 美元都只是推广价
先把两个容易混的概念钉死:
输出 token 上限 :模型单次回复最多能吐多少个 token。Argon 是 100 万,GPT-6 Astra 和 Claude Opus 5.5 都停在 12.8 万。它不是上下文窗口------后者指一次能读进去多少,Argon 这项官方至今没公布。
推广期定价:谷歌给的临时价,只覆盖窗口期内。窗口什么时候关,官方没说。
现在的价目:
| 模型 | 输入(每百万 token) | 输出(每百万 token) | 单次输出上限 |
|---|---|---|---|
| Gemini 4 Argon(推广期) | $2 | $10 | 100 万 |
| Gemini 4 Argon(标准期) | $4 | $20 | 100 万 |
| GPT-6 Astra | $10 | $50 | 12.8 万 |
| Claude Opus 5.5 | $4 | $20 | 12.8 万 |
| Claude Fable 5.1 | $10 | $50 | 12.8 万 |
| Claude Sonnet 5 | $2 | $10 | 12.8 万 |
缓存输入还便宜 95%------如果你的 prompt 前缀固定,这块能省不少。
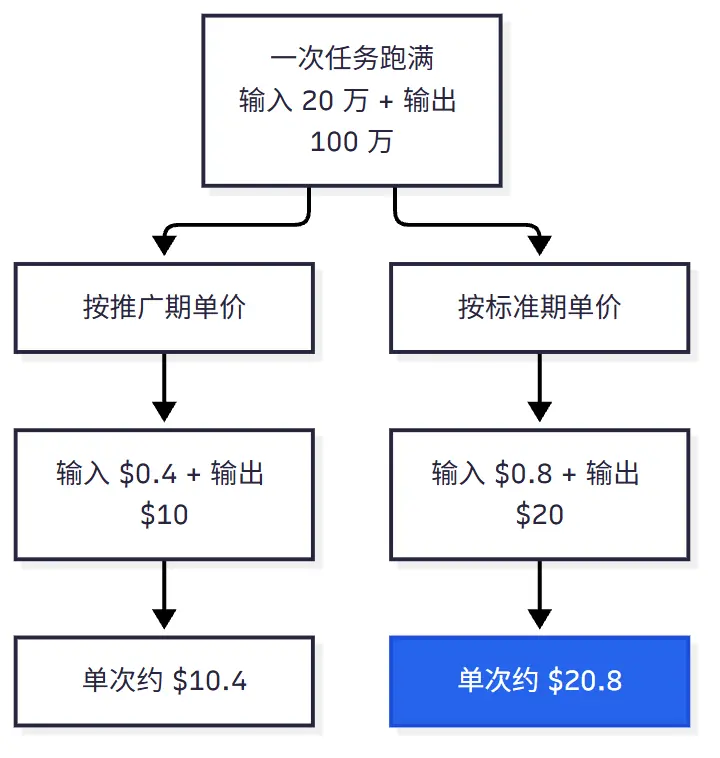
表面看 Argon 推广期和 Sonnet 5 同价,比 GPT-6 Astra 便宜一大截,像是捡漏。但"每百万 token"这个单位特别容易麻痹人。我按一次真实的长任务算笔账:
假设任务输入 20 万 token、输出跑满 100 万 token:
- 推广期:输入 0.2M × 2=0.4,输出 1M × 10=10,合计约 $10.4
- 标准期:输入 0.2M × 4=0.8,输出 1M × 20=20,合计约 $20.8
这就是我要说的第一件事:$10/M 的输出价听着温和,但它的设计目标就是让你一次烧掉一整百万个 token------单次任务十几二十美元,是它的常态成本,不是极端值。
如果你的智能体要跑几十次这样的循环,账单会非常快。
推广期结束价格直接翻倍,这一条没有任何报道给出缓冲期。 现在做成本模型,请按 4/20 算,别按 2/10 算。
四、和 GPT-6 Astra、Claude Opus 5.5 排排坐
先看谷歌自己最得意的那个数:
| 基准(测什么) | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| DeepSWE v1.1(长周期真实工程任务) | 77.9% | 74.2% | 74.1% | 67.4% |
| FrontierSWE v2(前沿工程) | 55.0% | 62.3% | 65.5% | --- |
| Terminal-bench 4.0(终端操作) | ~57% | ~66% | --- | --- |
| Vals Index(按 GDP 加权综合) | 68.9% | 67.0% | 63.1% | 65.8% |
| Gray Swan 间接提示注入(越低越好) | 0.7% | 1.0% | 8.5% | 1.0% |
DeepSWE v1.1(评估真实世界长周期软件工程任务的基准):题目取自长、乱、脏的真实工程场景,不是算法题。Argon 在这里的 77.9% 是全场最高。
但有两处要留神。
一是口径不统一。 Argon 那格是谷歌自己跑的,对手那几格来自公开榜单和各家自报。顺手说一句,上个月 Gemini 3.6 Flash 在同一个基准上是 49%------四个月涨了近 30 个点,这个斜率本身就值得多问一句。
二是这个领先被挑过。 谷歌在 18 项基准里赢了 12 项、平 1 项、输 5 项。输的那 5 项里包括 FrontierSWE v2(55.0% vs GPT-6 Astra 的 65.5%)和 Terminal-bench 4.0(约 57% vs Opus 5.5 的约 66%)。
翻译成人话:Argon 擅长"一次交一大坨活",但在需要反复横跳、跟终端来回交互的场景里,Opus 5.5 更稳。
顺带一提,Bloomberg 报道称谷歌内部有人担心 Argon"在实际工作中处理某些编码任务吃力",外界也质疑谷歌在"刷榜"。谷歌否认了这一说法。这个争议我倾向于暂时挂起------等它真正开放给普通开发者,让第三方跑一轮再说。
五、现在能用吗?大概率还不能
这是最容易被标题带偏的一点。
Argon 没有公开网页入口、没有开发者 playground、没有开放 API 。它通过 Fairwind 计划分阶段放出------第一波只给经过审核的网络安全防御专家,而且这批人据说是关掉安全护栏用的,为的是发挥完整防御能力。
Fairwind 计划:谷歌为 Gemini 4 Argon 设计的分阶段发布通道,先给受信任的防御方,再逐级放开;谷歌同期还参与了美国政府的前置安全评估流程。
后续顺序官方给了:先付费 API 客户和 Google AI Ultra 订阅者,然后才是开发者、企业和普通消费者。全面开放的时间表:没有。
而且那个"100 万输出",也不是每个端点都给。Vals AI 测试时拿到的配置上限是 26.2 万。所以别拿"100 万"当既定能力做架构设计。
可能有人会问:100 万输出 token,是不是意味着我能把整个代码库丢进去让它一次重构完?
不是。100 万是输出上限,不是输入上下文。这个模型能读进去多少,谷歌没公布。按输出反推输入,是这次传播里最常见的误读。
六、我的判断
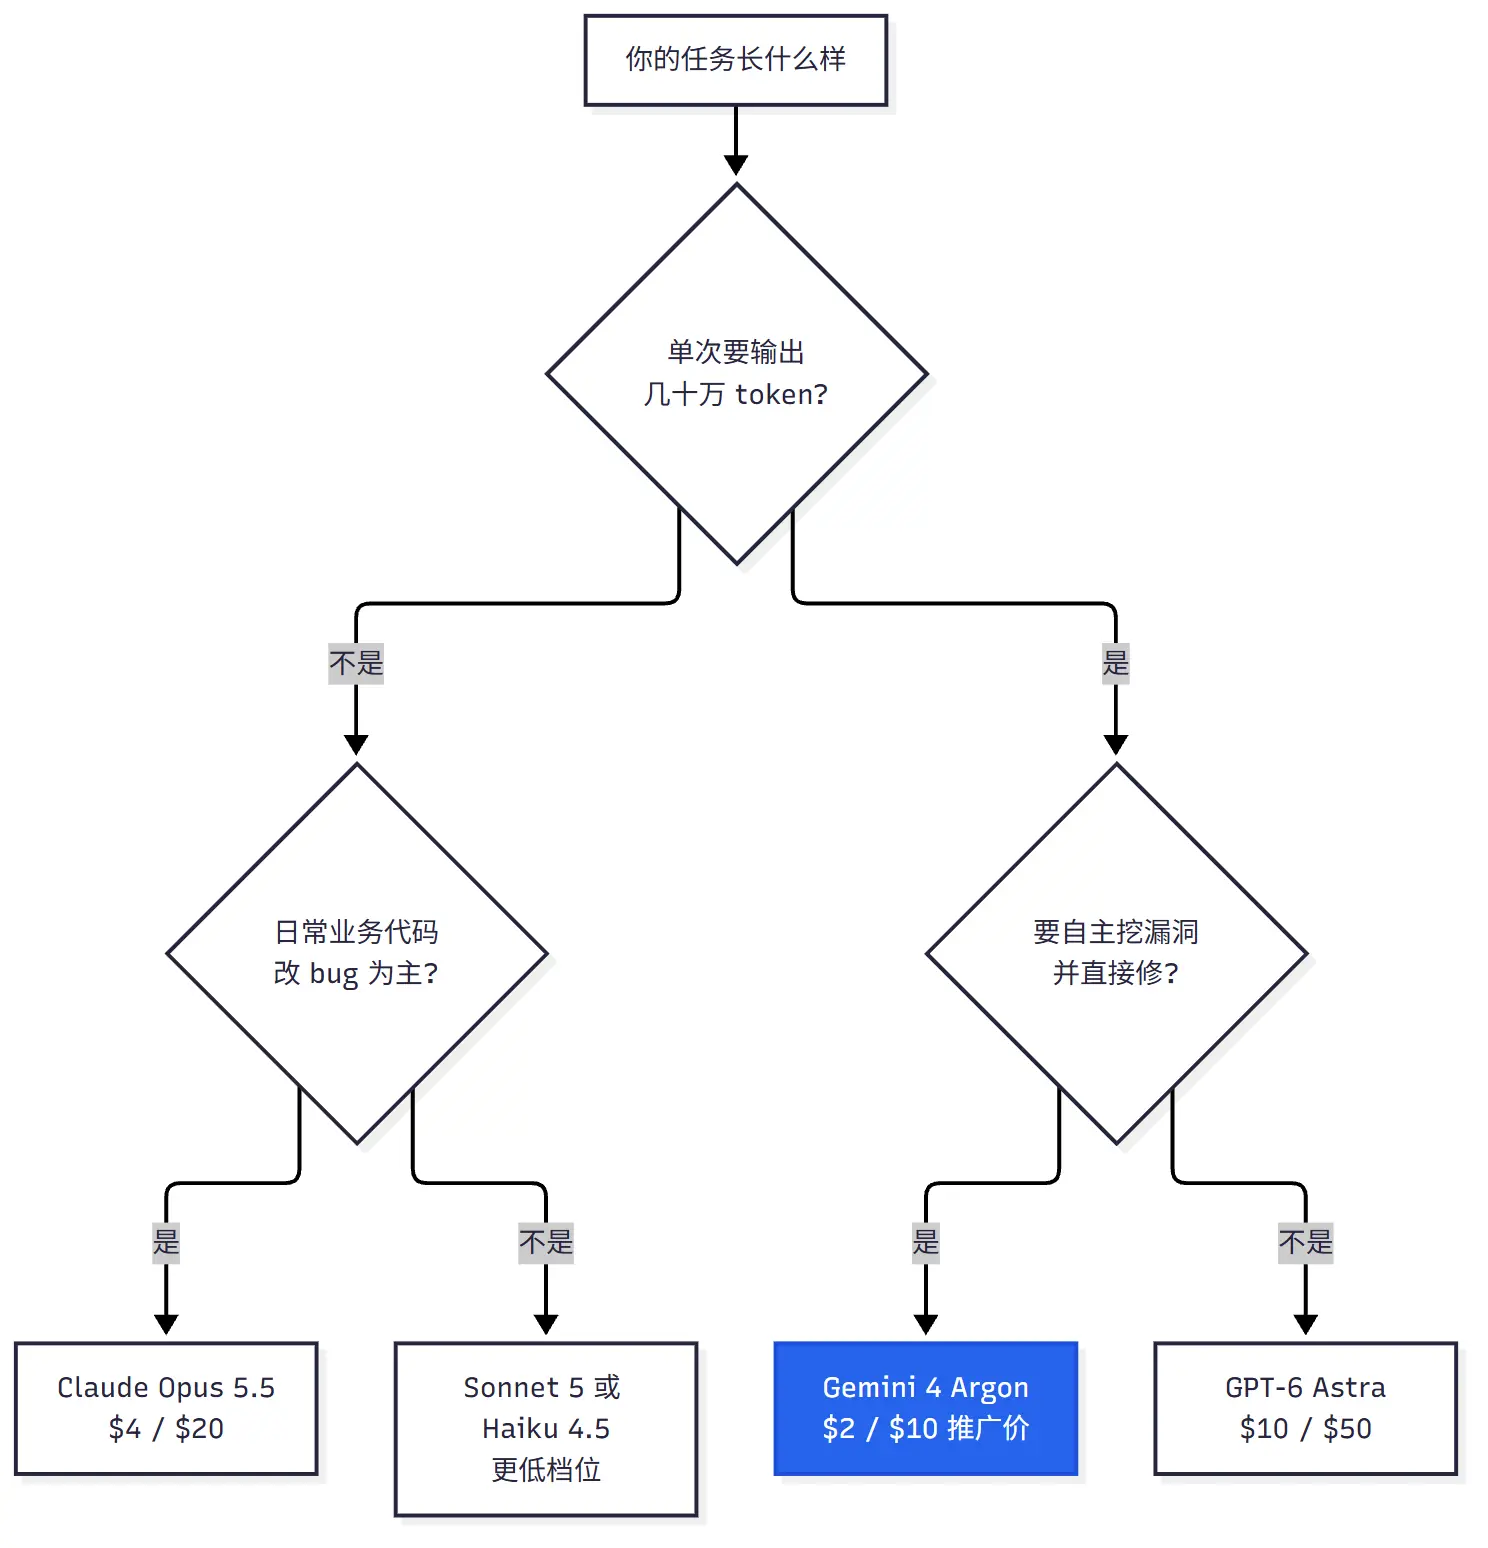
给你一张决策图,先看自己的任务长什么样:
然后是我的三句结论:
1、如果你的活是"让智能体连续干几小时、一次产出几十万字",Argon 现在是第一梯队里唯一解 ,100 万输出上限这一点没有对手,推广期价格也确实便宜。但成本要按 4/20 建模,别按 2/10。
2、如果你的活是日常写业务代码、改 bug,别等它。 Claude Opus 5.5 是 4/20、12.8 万输出,跟 Argon 标准期同价,而它在 Terminal-bench 这类交互式场景上更强。为用不上的 100 万输出多付钱,没道理。
3、现在最大的信息风险不是价格,是上下文窗口。 谷歌只公布了输出上限,一堆文章把两者混为一谈。在看到官方公布输入上下文之前,任何"能一次吃下整个代码库"的说法都别信。
以 2026 年 10 月初的口径,Gemini 4 Argon 是一把给长任务定制的重锤,不是万能钥匙------你大概率还用不上,但等它开放时,你该知道自己属于哪一类。
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:Gemini 4 Argon 的 100 万输出 token,你觉得能变成真生产力吗?