TL;DR
Coding Agent 干长活时,早期翻代码、试错、跑测试的痕迹会把上下文越堆越满,而现有的自动压缩(compaction)都是撞到窗口上限才动手 ------就像从不整理工位、堆到没地方放纸才被迫大扫除。新加坡管理大学、南洋理工与哈佛的团队在 arXiv 发布的 AutoCompact 换了个思路:给模型一个 compact() 动作,让它在任务进行中自己决定何时压缩、保留什么、压缩后怎么继续 ,用 judge 在线纠错的数据教、用任务成败的奖励练。结果 SWE-bench Verified 通过率从 30.4% 涨到 39.6%(绝对 +9.2%),而且推理预算越紧、收益越大。
导语:那个「Compacting conversation」的转圈时刻
先问一个可能戳到你的问题:你有没有发现,Coding Agent 干活超过半小时就开始「变笨」?
它开始重复搜已经搜过的文件、忘掉自己五分钟前的结论、改着改着又回到最初的方案。你以为是模型不行,其实多半是上下文出了问题------早期的探索痕迹(失败的尝试、被否决的假设、一大坨工具输出)还堆在上下文里,把真正重要的工作状态淹没了。
然后你会看到那个熟悉的场面:Claude Code 弹出「Compacting conversation」,或者 Codex 开始生成 handoff summary------压缩只在上下文快满的时候才发生。这时候才整理,就像堆到没地方下脚才大扫除:该留的和该扔的混在一起,慌忙之中经常把还需要的证据也扔了。
想自己动手试?
- 📄 论文:arXiv 2610.02163
一篇 2026 年 10 月 1 日提交的新论文对这件事给出了系统性方案。来自新加坡管理大学、南洋理工大学和哈佛的研究者提出的 AutoCompact,把「收拾上下文」从被动应急变成了模型的主动技能------而且是用训练的方式,不是往 system prompt 里加几句「请注意整理上下文」的废话。
上下文堆满,到底坏在哪?
要理解 AutoCompact 的价值,先得看清现有方案的两个盲区。
第一个盲区:触发时机错了。 主流 harness(Codex、Claude Code 都算)的压缩是长度触发的------剩余窗口低于阈值才压缩。这意味着过期信息会一路堆积到临界点,而且压缩经常发生在任务做得一半的尴尬时刻:bug 刚定位到一半,证据还在上下文里发挥着作用,咔,被压缩了。
第二个盲区:压缩之后没人管。 近一年的「主动压缩」研究让模型可以提前决定何时压缩,但压缩的质量和压缩后的行为是脱节的:摘要可能漏掉关键文件路径,模型也可能无视摘要、转头又把压缩前搜过的东西重搜一遍。论文里这个观察很扎心------会触发压缩 ≠ 会用压缩。
论文用一组数字把这两个盲区的代价摆上了台面:在 16K 强制压缩设置下,朴素的固定阈值压缩(Fixed Compaction)通过率 28.8%,比完全不压缩的全历史基线(30.4%)还低。压缩压得不好,比不压更糟。
AutoCompact 的思路:把「收拾工位」学成本能
AutoCompact 的机制本身不复杂:在标准的编码 Agent 循环(查文件、搜索、改代码、跑测试)之外,多给模型一个 compact() 动作。模型判断当前阶段已经收敛------比如 bug 根因刚定位完、马上要进入改代码阶段------就主动调用它,把之前堆积的交互历史替换成一份自己生成的「工作状态摘要」(保留已确认的结论、相关代码与工作区状态、下一步动作),然后轻装上阵继续干活。
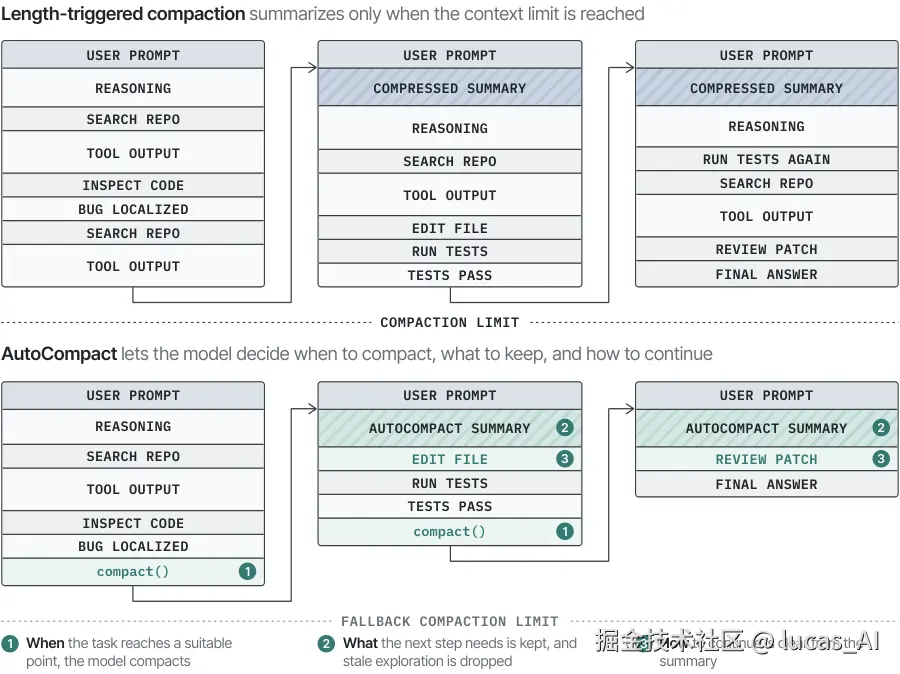
图说:三种决策------何时压缩(When)、保留什么(What)、如何继续(How)------就是 AutoCompact 要训练的全部内容。
那问题来了:为什么非得「训练」,prompt 里写清楚规则不行吗?
答案是:这个行为根本不在基座模型的本能里 。论文预实验发现,就算把压缩规则写进 agent prompt,基座模型几乎从不会在撞上限之前主动调用 compact()------毕竟「打断一段本来执行得好好的轨迹、亲手重写自己的记忆」是个反直觉动作。所以作者设计了两阶段训练:
第一阶段:judge 在线纠错采数据。 让基座模型在真实任务上干活,一个更强的 judge 模型(GPT-5.5-Codex)在旁边逐步盯着,专挑三类毛病下手:
- 时机不对:bug 已经定位完了还在继续乱搜?纠正------此时就该压缩。
- 摘要漏关键信息:工作状态里没写目标文件路径?纠正------补上。
- 压缩后不听摘要:明明摘要里写了下一步要改哪,转头又去重搜旧内容?纠正------把动作掰回摘要说的方向。
关键在「在线」两个字:judge 的纠正不是事后打标签,而是直接改写、让环境执行改写后的动作,轨迹从纠正点继续往下走。这样每条轨迹同时示范了「怎么压」和「压完之后怎么干活」------后者是此前所有方法都没监督过的盲区。用这批 1,052 条纠错轨迹做监督微调(SFT),模型就有了主动压缩的「行为初始化」。
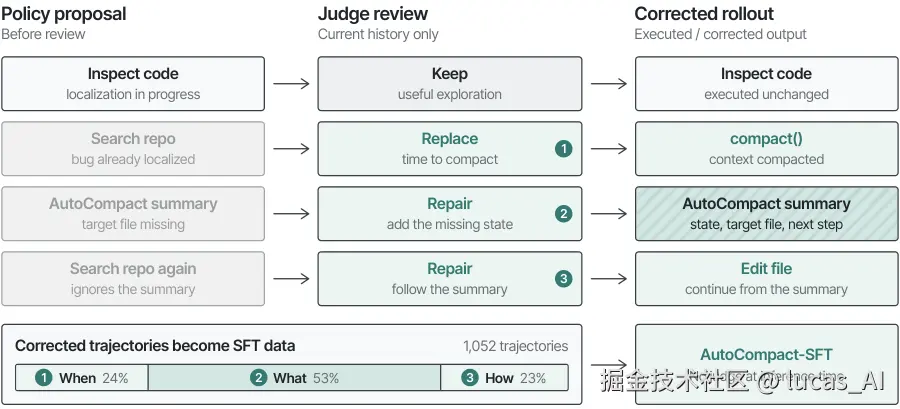
图说:judge 只在训练期存在,推理时的 Agent 完全独立运行,不增加任何额外成本。
第二阶段:任务成败当奖励的强化学习。 SFT 只会模仿,不保证压缩真的有利于完成任务。于是从 SFT 检查点出发,在 SWE-Gym 环境上用 GRPO(Group Relative Policy Optimization,一种按组内相对表现计算优势的强化学习算法)继续训练,奖励只有一个:最终补丁过没过测试。压缩调用、摘要内容、压缩后的动作,和普通编码动作一起分摊同一条轨迹的成败信号------不设任何压缩专用的奖励项,让模型自己摸索「什么时候压缩划得来」。
一个值得工程师留意的训练细节:每次压缩都会重写上下文前缀,轨迹就断成好几截。作者的处理是把轨迹在压缩点切段、段内保持前缀连续、整条轨迹共享同一个结果优势------这是让 RL 能处理「上下文重写」的通用工程方案,做 Agent 训练的团队可以直接抄。
效果:+9.2%,而且预算越紧越明显
主结果先看总账。同一基座模型(Qwen3-Coder-30B)、同一脚手架,SWE-bench Verified 全量 500 题、三次运行取平均:
| 方法 | 怎么触发 | 怎么训练 | 通过率 |
|---|---|---|---|
| 全历史基线 | 不压缩 | --- | 30.4% |
| 固定阈值压缩 | 长度触发 | --- | 28.8% |
| CompactionRL | 长度触发 | RL | 32.7% |
| SelfCompact | 推理时 rubric | 不训练 | 31.7% |
| SWE-Compressor | 模型学习 | SFT | 31.0% |
| AutoCompact-SFT | 模型学习 | SFT | 32.2% |
| AutoCompact | 模型学习 | SFT+RL | 39.6% |
SWE-PolyBench Verified 上趋势一致:24.5% 对基线的 19.5%(+5.0%)。
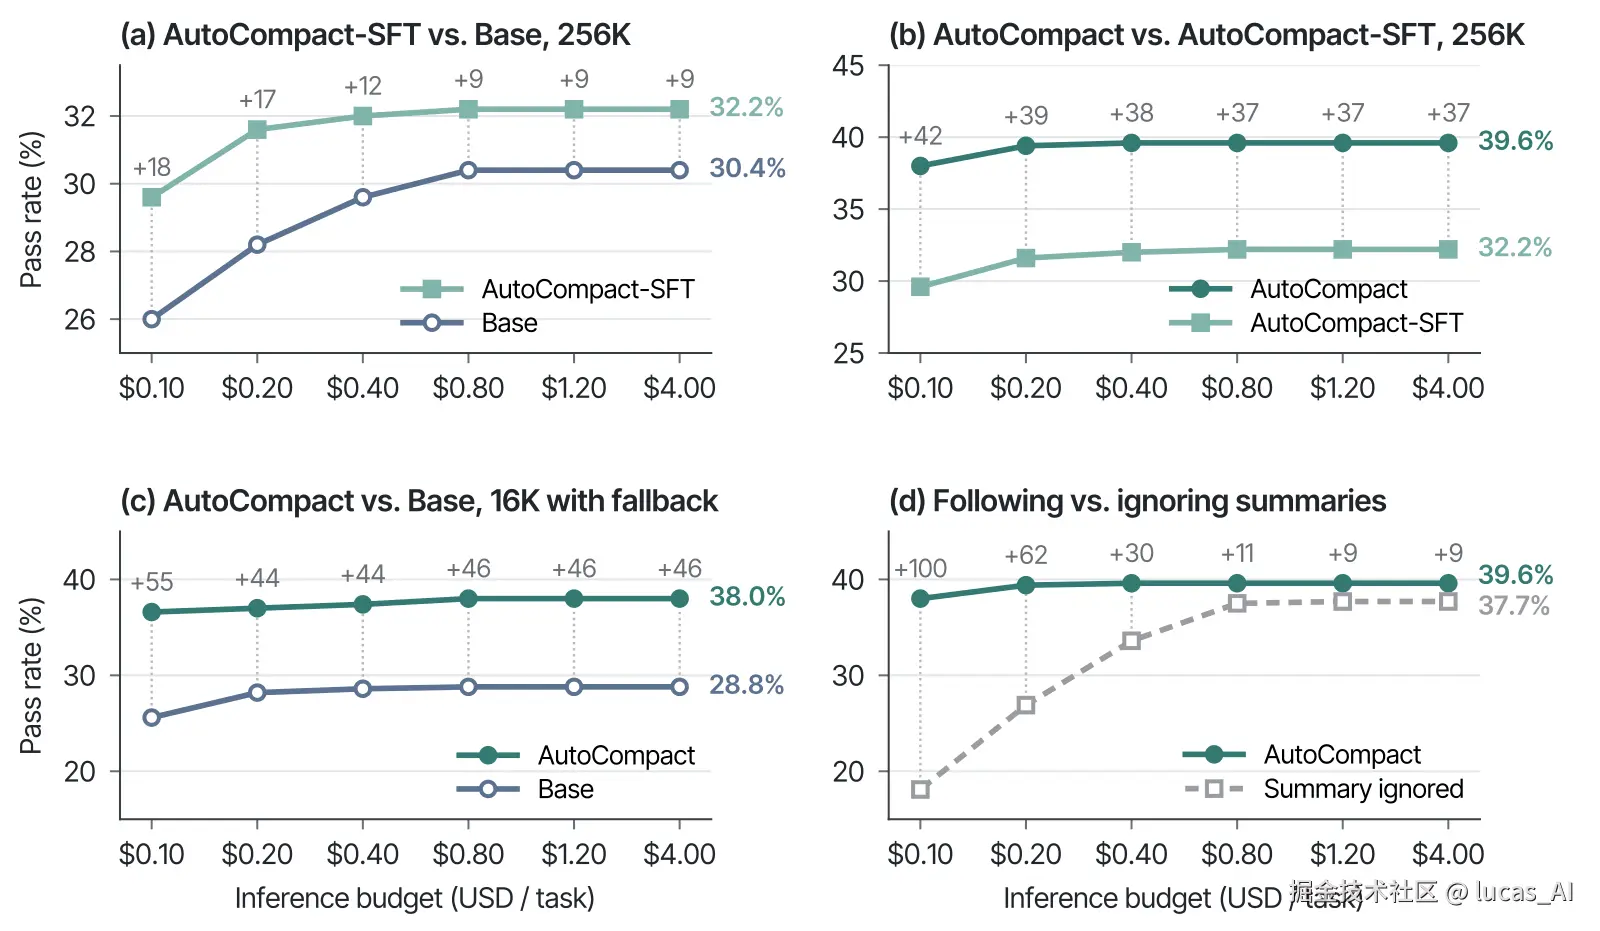
图说:横轴是每道题的推理预算( 0.10到4.00),纵轴是通过率------AutoCompact 的优势在每一档预算都成立,低预算档差距最大。
这张图里我认为最值得看的是右下角那组(3d):同一个训练完的模型,把它的压缩调用全部跳过 (参数一个不动,只是不执行摘要),$0.10 预算下通过率直接掉 19.9 个百分点。这个消融干净地回答了一个质疑------增益是不是单纯「训练让模型变强」,跟压缩没关系?答案是不是:压缩行为本身就是性能来源,而且穷的时候最有用。
行为层面的变化也支持这个结论:RL 之后模型在 58.5% 的任务上主动压缩(SFT 后是 44.3%,基座几乎为零),同时摘要漏关键状态的比例从 3.1% 降到 0.2%,漏下一步动作从 8.2% 降到 2.2%------用得更多,却漏得更少。任务成败的奖励逼着模型学会了「压缩时该小心什么」。
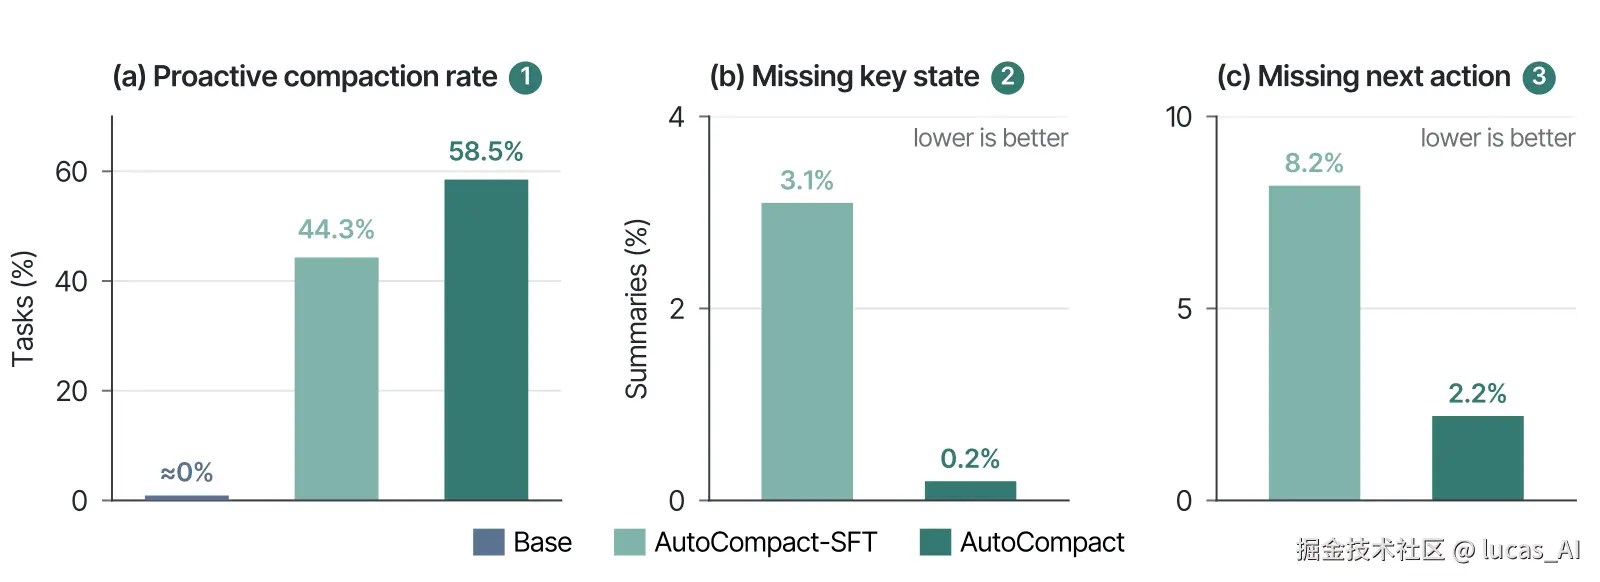
图说:(a) 主动压缩占比;(b) 摘要漏关键状态占比;(c) 摘要漏下一步动作占比------后两者越低越好。
还有个细节很有意思,值得单独说:摘要也会「自相矛盾」 。在一个 django 任务的案例里,SFT 模型的摘要如实记录了「还有个语法错误没解决」,下一步动作却写着「可以收尾了」------记录的状态约束不了提出的动作。RL 之后的模型则写出「改动已完成,先验证再提交」这种和状态一致的摘要。前者那道题最终因 SyntaxError 挂掉,后者通过。作者把这叫摘要自一致性(summary self-consistency)------这不只是这篇论文的细节,任何做 Agent 记忆/压缩系统的团队,都值得把「状态和计划是否自洽」加进摘要质量的检查清单。
为什么你要关心?
就算你不训练模型,这篇论文也有三处能直接落到你的工作上。
- 「上下文没满就不用管」是错觉。 论文的 256K 实验里没有任何一条轨迹撞到上限,SFT 后的模型仍然全面超过全历史基线。过期假设、失败尝试、冗长工具输出堆在那里,本身就在干扰模型。如果你在自建 Agent,别把「窗口够大」当成不做上下文管理的理由。
- 长度触发兜底 + 主动压缩,是可以叠加的。 16K 受限实验里,AutoCompact 在共享强制压缩兜底的情况下依然全面占优。Codex、Claude Code 这类产品现在的自动压缩都是长度触发------论文明说了,把两者结合是留给大家的功课。对做 Agent 平台的团队,这是下一个值得抢的改进点。
- 「压缩后行为」是被普遍忽略的监督盲区。 你的 Agent 压缩完之后是接着干活,还是把压缩前的事重做一遍?如果只测压缩触发和摘要质量,永远发现不了这类问题。judge 在线纠错 + 纠正后真实执行的采集范式,可以搬到任何「模型缺一种非本能行为」的训练场景。
再往远看一步:上下文管理正在从「工程 trick」变成「模型能力」。前有 ReCAP 把压缩延迟砍掉 95%,后有 AutoCompact 把压缩时机学进策略------这条线的产品含义很直白:同样一个 30B 模型,会不会管上下文,任务成功率差出 9 个点。模型不够大,习惯来凑。
理性看待
照例泼点冷水。全文所有实验都基于 Qwen3-Coder-30B 这一个基座和同一种终端脚手架,结论能不能迁移到别的模型和 harness,论文没给证据。更值得注意的是贡献的拆分:纯推理时不训练的 SelfCompact 就能涨 1.3 个点,AutoCompact-SFT 也只比 SWE-Compressor 高 1.2 个点------9.2% 的大头(7.4 个点)来自 RL 阶段,而 RL 的收益有多少该记在「压缩」头上、多少只是「在 SWE-Gym 上做了一次成功的 GRPO」,论文用图 3d 的消融部分回答了,但没有对照「同样 RL 预算、不做压缩」的版本。另外 RL 训练只用 32K 序列、评测却跑 256K 窗口,这个跨度是作者自承的妥协;论文也未开源代码和权重,judge 的标注协议只有文字描述,想复刻还有不少坑。