桥梁、道路、建筑上的裂缝又细又淡,人工巡检费时费力还容易漏检。新论文 YOLO-AMC,把 YOLOv11 拆掉一处、加装三处「注意力」,在自建裂缝数据集上把 mAP@0.5:0.95 从 0.9112 拉到 0.9506,还能在树莓派 5 上跑到约 5 FPS。
背景与问题
在结构健康监测(SHM)里,早一天发现裂缝,就能早一天判断隐患、安排维护。可现实是,人工巡检要人爬上爬下、贴脸去看,耗时费力不说,还受经验和疲劳影响,根本没法覆盖大范围的基础设施。
YOLOv11 自己带了 C2PSA 注意力模块来增强空间感知,但对这类细弱目标,内置注意力未必用在了刀刃上。YOLO-AMC(YOLO with Attention Mechanisms for Crack Detection),思路很朴素:把内置注意力拆掉,在特征融合最关键的部位,换上更对症的外加注意力。
模型一眼看懂
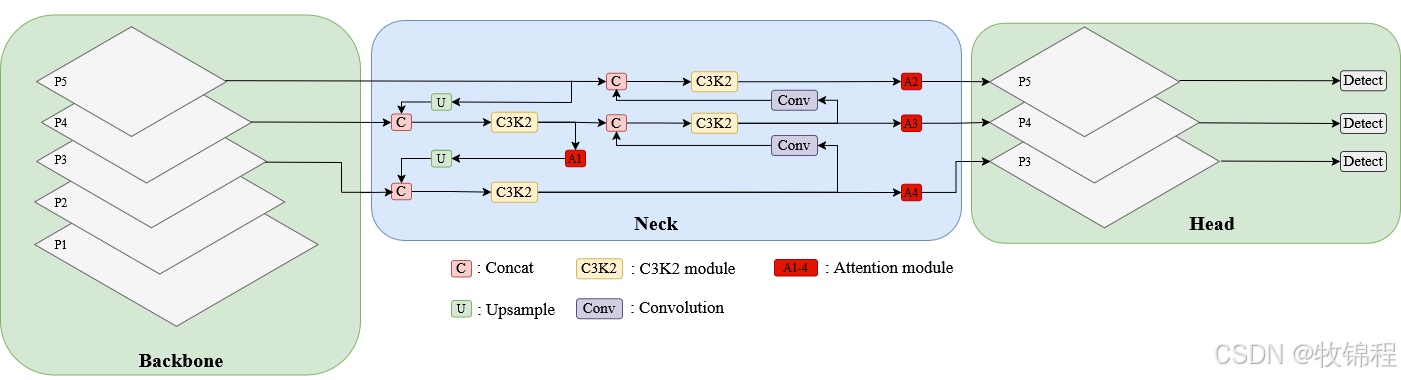
图注:注意力模块(A1--A4 红色方块)插在 Neck 的多尺度融合路径上,检测头仍从 P3/P4/P5 取特征。
在网络结构上,论文并没有大动 Backbone 和检测头,而是精准地只动了两个地方:
| 位置 | 基线 YOLOv11 | YOLO-AMC |
|---|---|---|
| Backbone | 自带 C2PSA 注意力 | 整体移除,避免两种注意力互相干扰 |
| Neck | 纯卷积融合,无特征重加权 | 在 A1--A4 四个候选位置插入注意力模块(GAM / Res-CBAM / SA) |
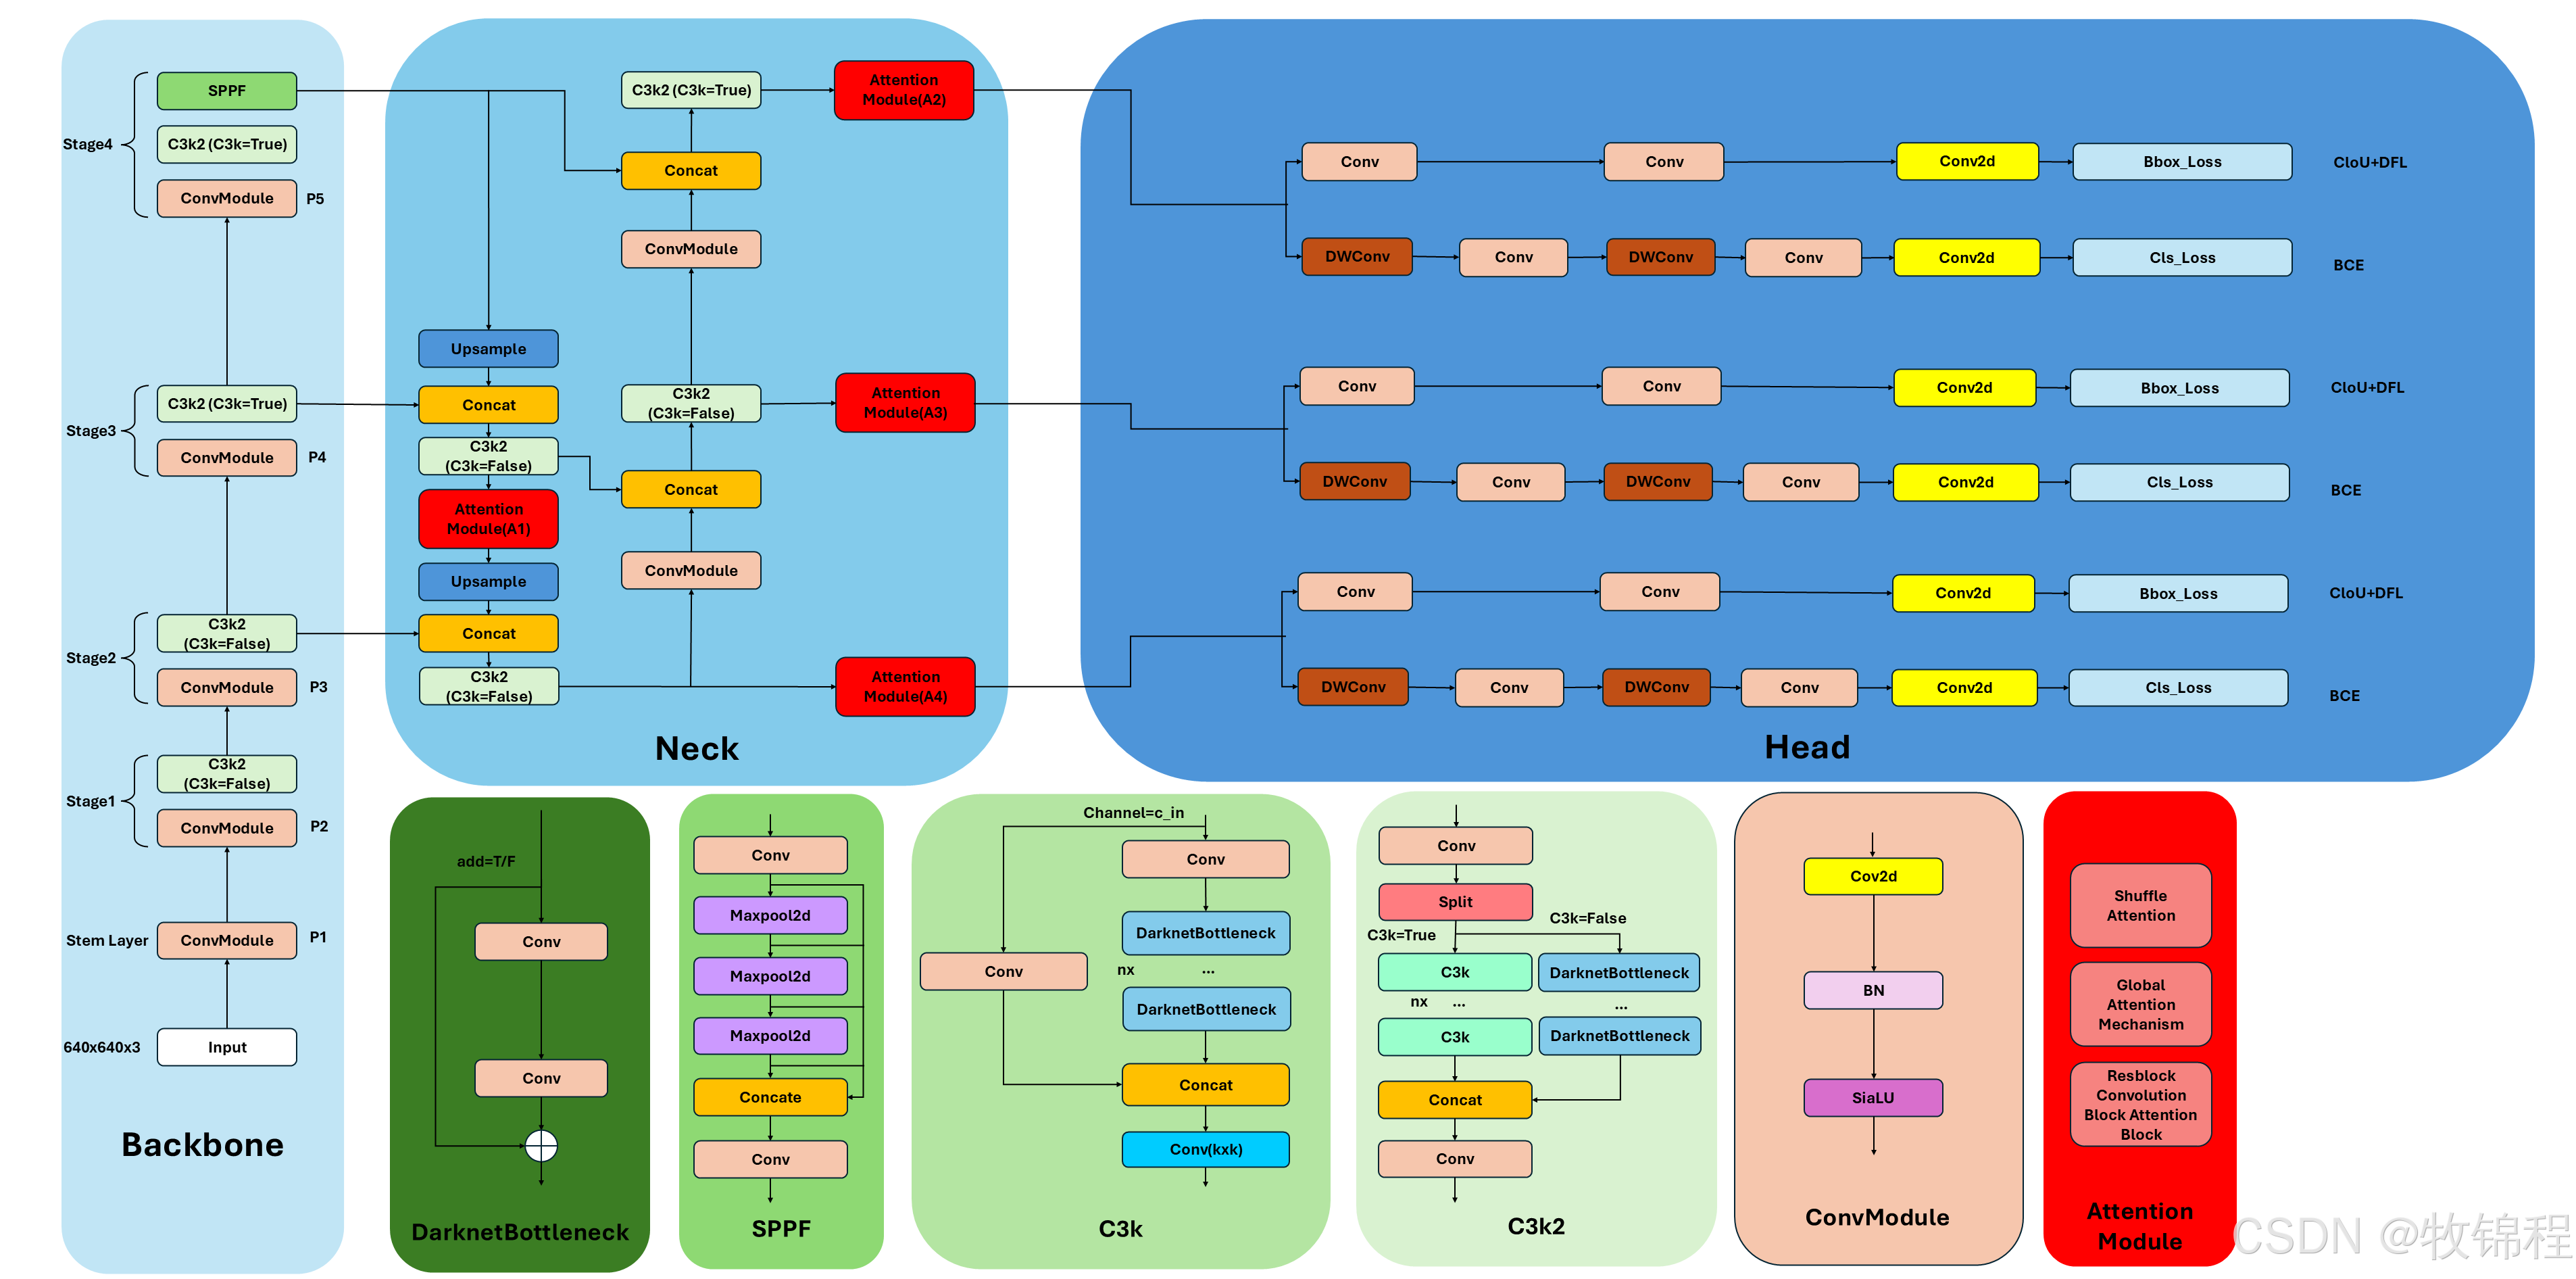
图注:完整模型架构与三种注意力模块的内部结构(最右侧红色块)。
为什么要动 Neck?因为 Neck 正是多尺度特征融合的枢纽------高分辨率纹理和低分辨率语义在这里汇合。裂缝的判别信息恰恰分散在不同尺度上,在这里做「特征重加权」,等于在融合的关键路口给裂缝特征「开绿灯」、给背景噪声「踩刹车」。
改动一:先做减法,拆掉自带的注意力
拆内置注意力,很多人会觉得反直觉:不是要增强注意力吗,怎么先拆一个?
关键在于 YOLOv11 的 C2PSA 本身就是一种注意力,如果留着它再外加注意力,两种注意力会互相纠缠,涨点了也说不清到底是谁的功劳。所以论文干脆把它拆掉,让所有外加注意力都站在同一张「白纸」上公平对比,谁强谁弱一目了然。
事后证明这步「减法」很值:论文又把 C2PSA 加回去做了补充实验,发现确实还能小幅涨点------GAM 版 +0.0017、Res-CBAM 版 +0.0024、SA 版 +0.0030(mAP@0.5:0.95)------但代价是参数量增加近 40 万。说明真正的精度主力是外加注意力,内置 C2PSA 只提供了边际收益。
效果如何:三种注意力同台竞技
论文挑了三种风格迥异的注意力,统一插到 Neck 上做对比,它们各自的「性格」很清楚:
- GAM(全局注意力):通道、空间两步都做全局建模,表达力最强,是「大力出奇迹」型,开销也最大;
- Res-CBAM(残差注意力):在 CBAM 之后加一条残差直连,原始特征流一路保底,是「稳妥不翻车」型;
- SA(混洗注意力):通道分组再混洗,参数最少,是「轻装上阵」型。
它们在测试集上的完整成绩单:
| 模型 | 参数量 | GFLOPs | mAP@0.5 | mAP@0.5:0.95 | FPS(RTX 4090) |
|---|---|---|---|---|---|
| GAM(本文参考模型) | 3.02M | 7.6 | 0.9917 | 0.9506 | 110.95 |
| Res-CBAM | 3.57M | 8.7 | 0.9903 | 0.9430 | 108.32 |
| SA | 2.34M | 6.2 | 0.9893 | 0.9398 | 118.74 |
| YOLOv11 基线 | 2.59M | 6.4 | 0.9833 | 0.9112 | 113.84 |
| YOLOv8 基线 | 3.01M | 8.2 | 0.9707 | 0.8921 | 138.78 |
三个注意力变体全部超越两个基线。最值得玩味的是 SA:它的参数量(2.34M)比 YOLOv11 还小、算力(6.2 GFLOPs)也更低,精度反而更高。这说明涨点靠的是「把特征看对地方」,而不是简单堆参数。
再看得细一点:GAM 的精确率与召回率分别达到 0.9829 / 0.9866,是所有变体里最均衡的,因此被定为参考模型。整体上,注意力模型把裂缝这种「又细又淡」的目标召回得更全、框得更准。
改动二:插在哪、插几层,也有讲究
光会选模块还不够,插在哪、插几层,直接决定效果。论文做了三组精细消融,这套方法论对做 YOLO 改进的人很有参考价值。
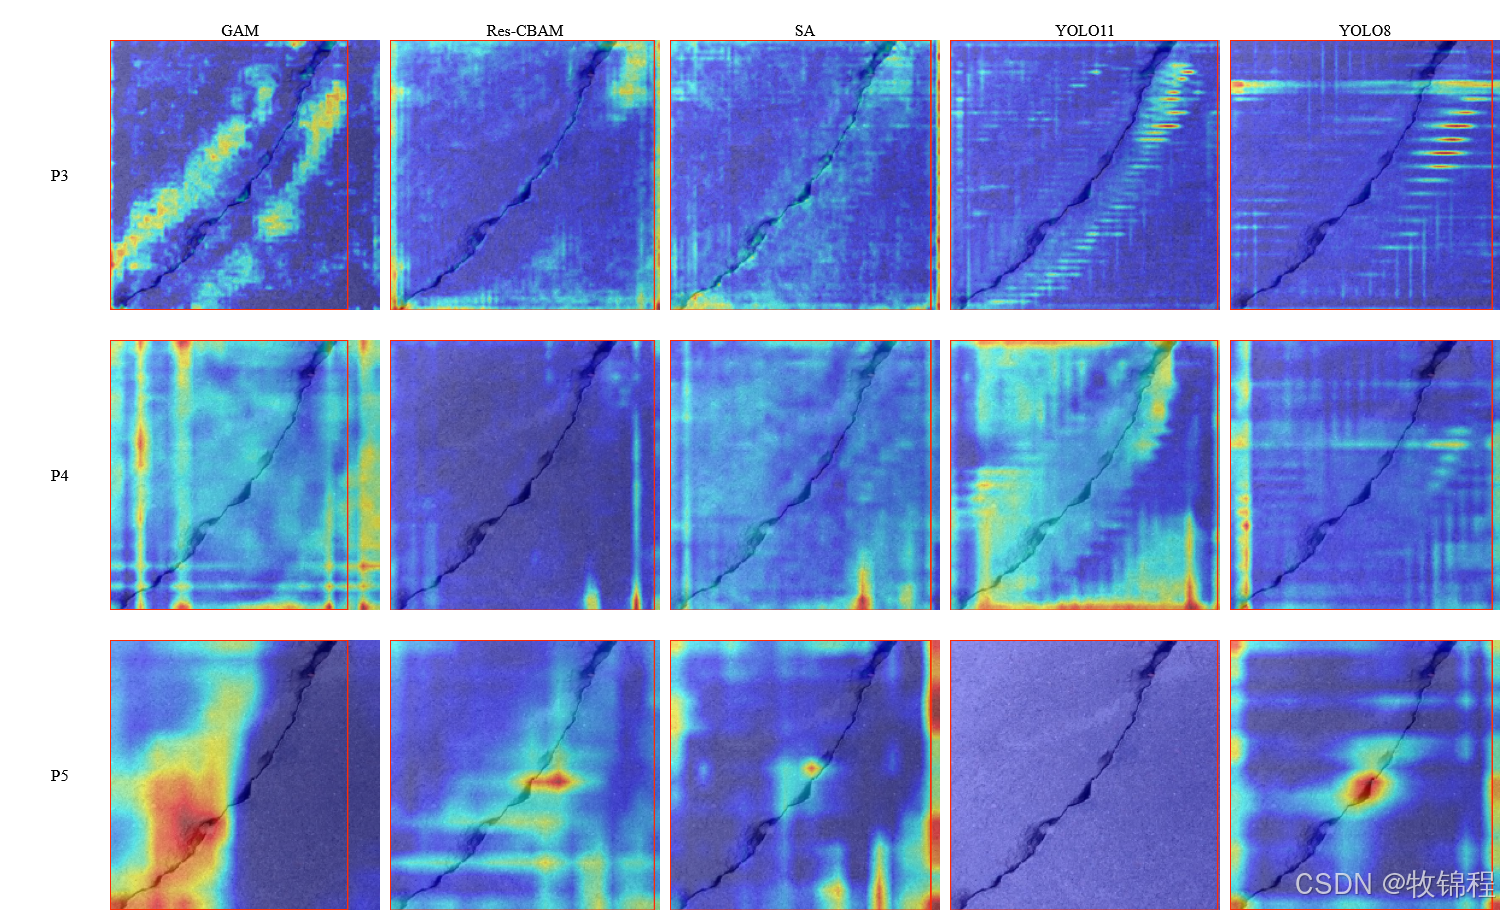
图注:基线模型(右两列)出现明显条纹状伪响应;注意力模型沿裂缝走向的响应更连续,说明它真正「盯住」了裂缝。
第一组:单层插哪最合适? 把注意力分别插到 A1、A2、A3、A4,测下来三个模块的最优位置不约而同地落在中间层 A3------GAM 0.9441、Res-CBAM 0.9420、SA 0.9418(mAP@0.5:0.95)。A3 恰好是空间细节与高层语义的平衡点,把注意力放在这,既能看清细线、又不丢语义。
第二组:插一层还是插多层? 在 A2+A3+A4 三层同时插,结果分化明显:GAM 继续受益,从 0.9441 涨到 0.9482(增益 +0.0041);Res-CBAM 几乎原地踏步(+0.0009);SA 反而掉点(−0.0040)。轻量模块叠加多了会互相打架,反而不如单点发力。
第三组:能不能混搭? 把不同模块分配到不同层级,结果惊喜:A1 放 Res-CBAM、A2+A3+A4 放 GAM 的组合,拿到了全场最高的 mAP@0.5 = 0.9941、mAP@0.5:0.95 = 0.9568。不过论文认为单 GAM 结构更简洁、更好解释,最终仍把单 GAM 定为参考模型。
一句话总结这一节:注意力的「选型」和「插在哪」要一起设计,没有放之四海皆准的万能插法。
边缘设备上能跑吗
好的检测模型不能只在 4090 上逞强,落得了地才算数。论文把各模型转成 ONNX,部署到树莓派 5 上做了端到端测速。
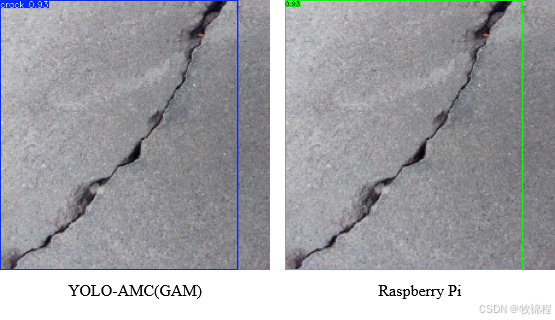
图注:同一张裂缝图,GPU 与树莓派 5 的检测结果高度一致。
结果:SA 最快,178 毫秒/图(约 5.6 FPS);GAM 约 203 毫秒(4.9 FPS);Res-CBAM 约 200 毫秒(5.0 FPS)。三者都快于 YOLOv11 基线(225 毫秒,4.45 FPS)。也就是说,加注意力不仅更准,边缘端也没有变慢,反而因为结构精简更快了一点点。对于巡检机器人、无人机这类低功耗场景,这个结论很有现实意义。
代码与数据
- 代码:已开源,基于 Ultralytics 框架,仓库地址为 github.com/CY-Tsai24/YOLO-AMC。
- 数据:训练用的是作者整合 5 个公开裂缝数据集自建的复合数据集(训练 15,524 / 验证 2,276 / 测试 1,665 张),并重新划分防止数据泄漏。整合数据集本身未提供直接下载,但 5 个来源均为 Roboflow Universe、Mendeley、Kaggle 上的公开数据。
- 论文:arXiv:2606.12958,页面地址 arxiv.org/abs/2606.12958。
结语
这篇论文的价值不在「又堆了一个新模块」,而在给了一套可复用的设计方法:先清场(拆掉内置注意力)、再对比(同框架下测不同模块)、后定位(分析插入位置敏感性)。照这个流程走,做任何 YOLO 改进都能少走弯路。