颜色与相机成像专题(1):为什么照片不是对真实世界的直接测量?
本文是"从颜色科学到相机 ISP"专题的开篇,基于 Michael S. Brown 的 ICCV 2019 教程整理。适合计算机视觉、图像处理与相机开发入门读者。阅读后,你将能区分传感器测量、相机渲染和图像编码,并判断自己的算法应使用 RAW 还是成品照片。
关键词:计算机视觉、ISP、RAW、sRGB、颜色科学
1. 同一场景,为什么三台相机拍出三种颜色?
设想一个实验:拍摄同一个人,尽量保持光圈、快门、ISO、白平衡设置一致,分别使用三台相机。你可能以为输出的 RGB 值应该接近,但肤色、衣服颜色和阴影对比度仍可能明显不同。
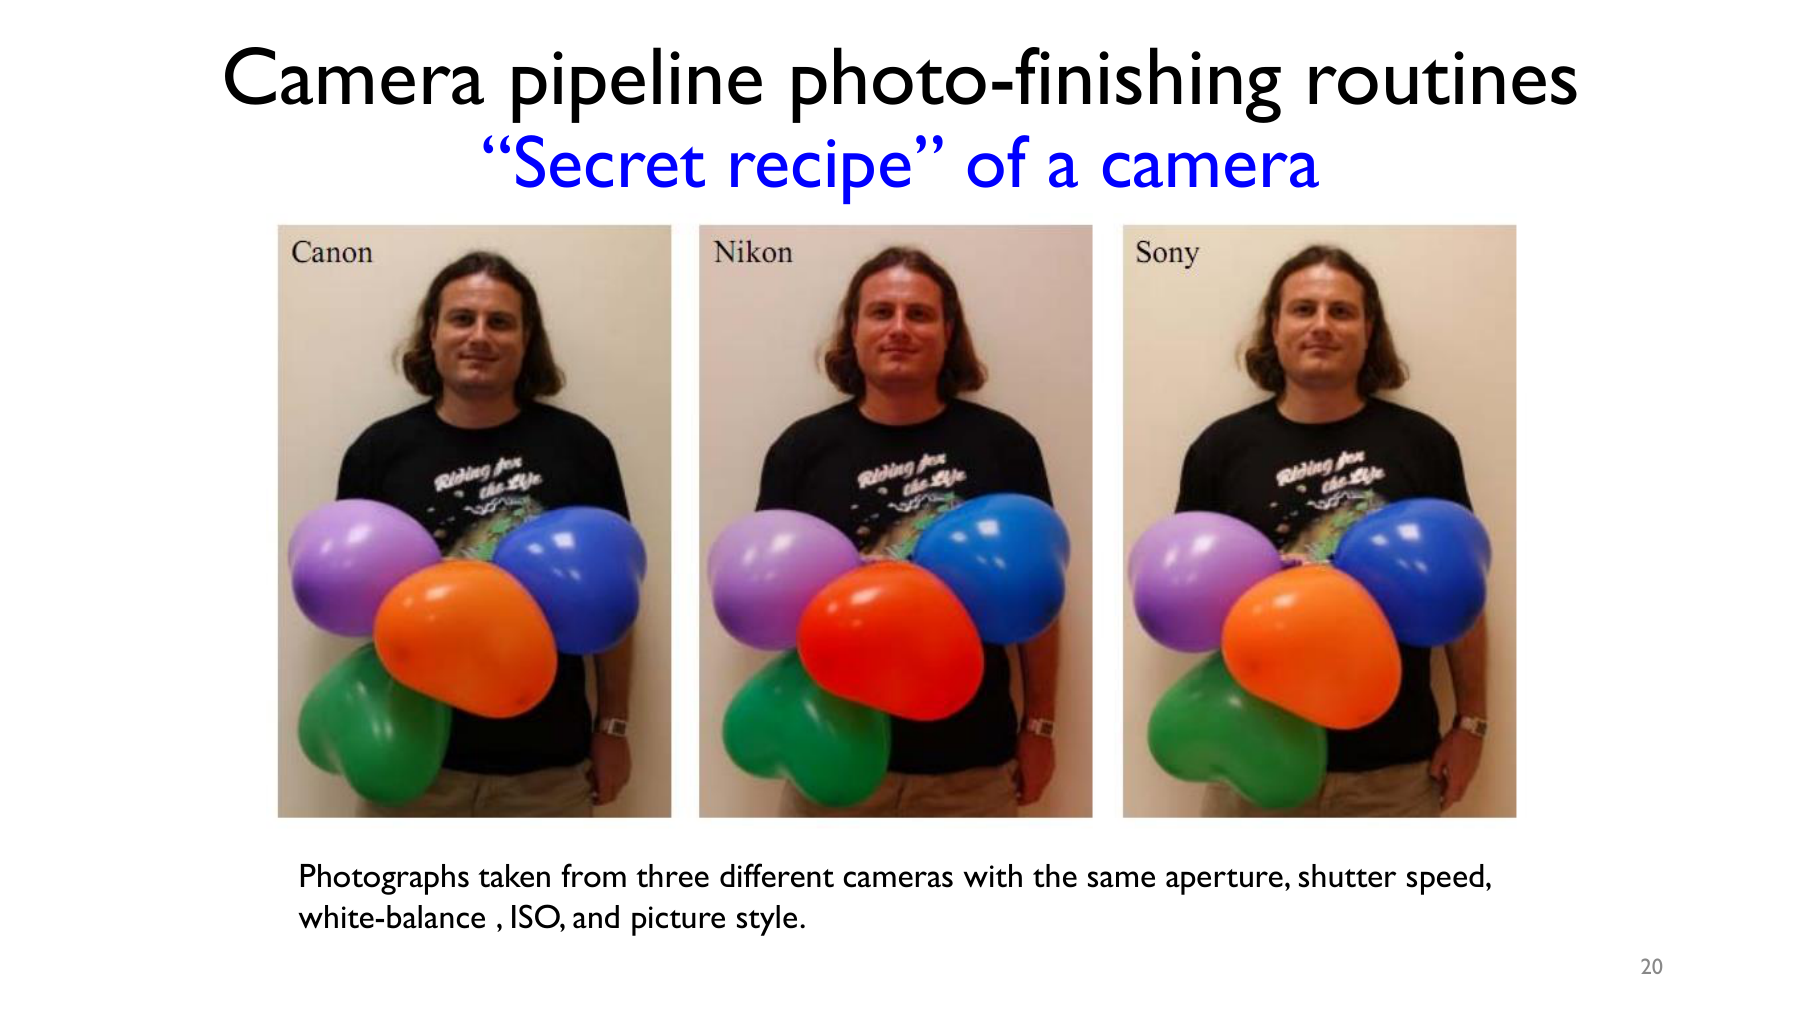
图 1:讲义 PDF 第 20 页。不同相机的成像结果说明,统一拍摄设置并不等于统一整条成像流程。图中实验来自原讲义,并非本专题重新拍摄。
这并不必然是某台相机"测错了"。消费级相机的目标通常包括漂亮的肤色、清晰的细节、讨喜的对比度和可接受的噪声。摄影风格也是产品的一部分。相机输出可能非常适合观看,却不满足某个物理算法所假设的线性关系。
这里需要同时保留两个事实:传感器在一定工作范围内可以近似测量光;相机最终输出的照片通常已经经过大量处理。
2. 一个像素经历了什么?
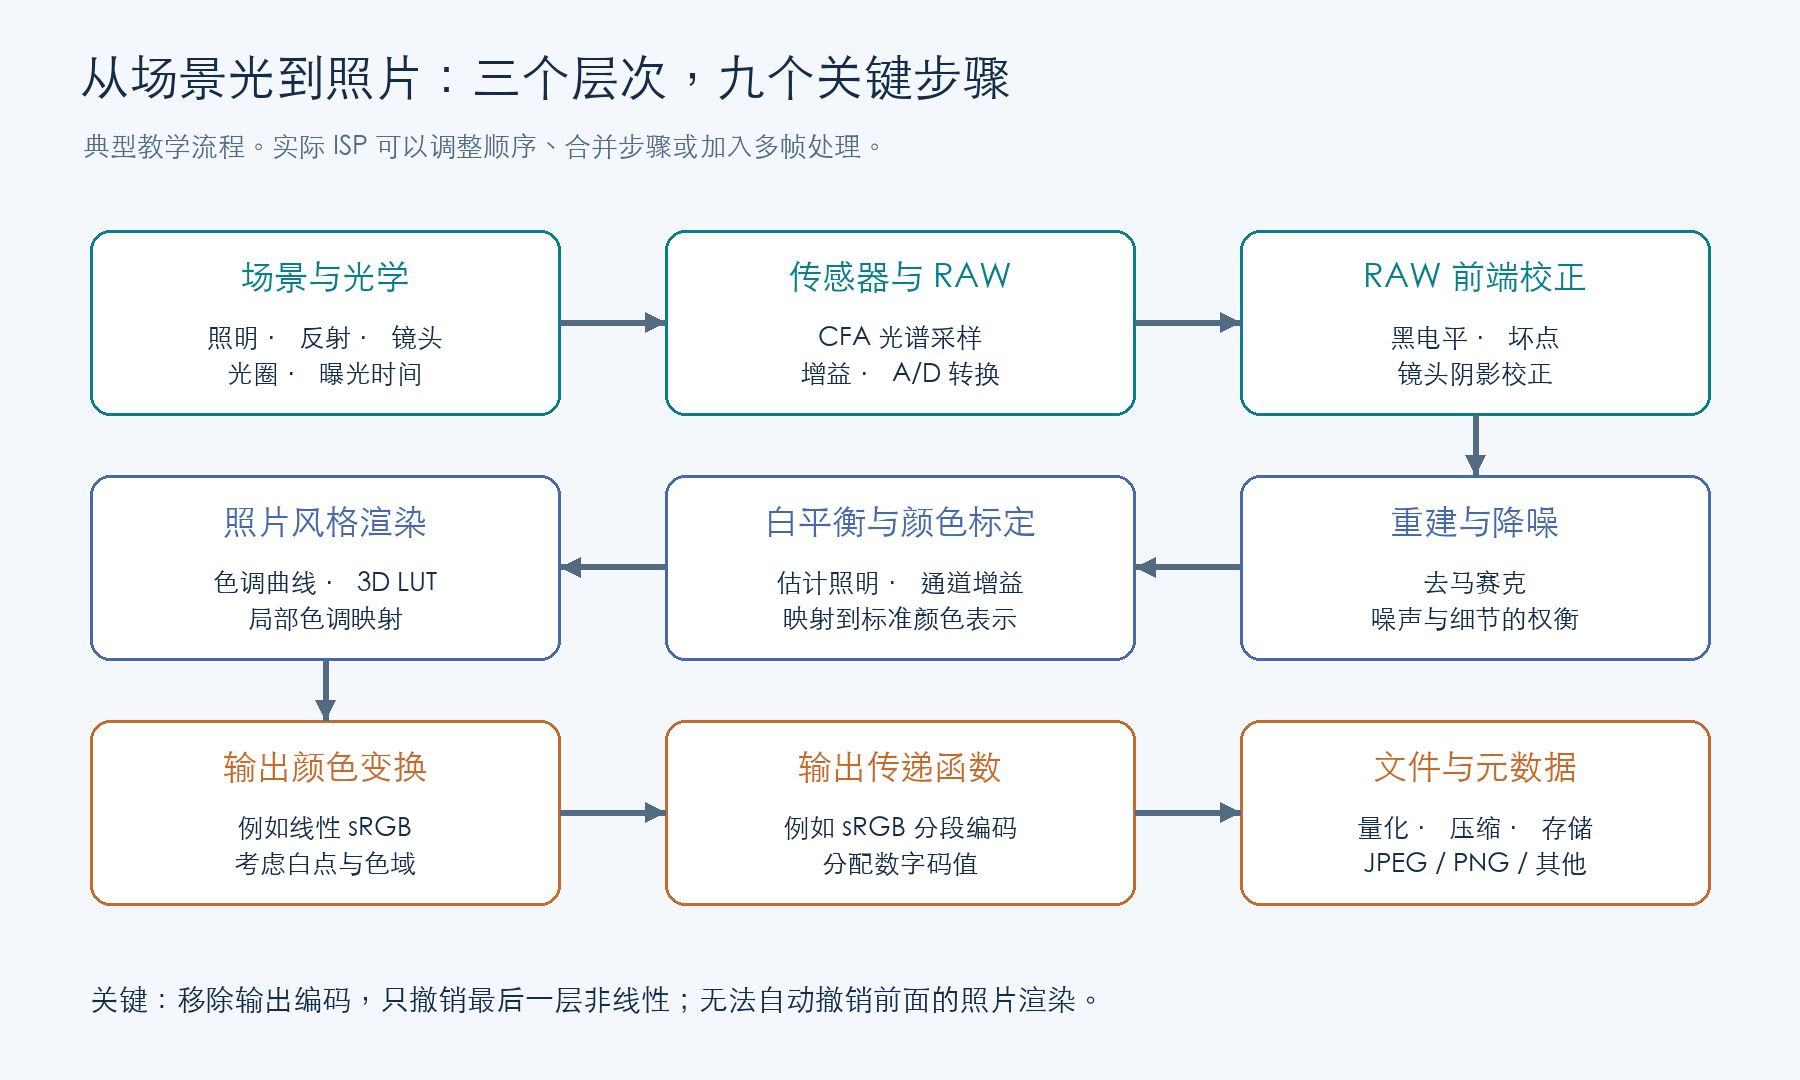
图 2:
教学示意图。实际设备可能交换步骤、合并模块,或插入多帧融合等处理。
可以把流程分成三段:
- 光学成像和传感器采样:场景光经过镜头、光圈与快门,由传感器转换为电信号,再经增益和模数转换得到数字值。
- ISP 图像处理:完成黑电平校正、坏点处理、去马赛克、降噪、白平衡、颜色转换和视觉风格调整。ISP 通常指 Image Signal Processor,即图像信号处理器,也常泛指这套处理流程。
- 编码与存储:转换到输出色彩空间,应用规定的传递函数,再按 JPEG 等格式保存。
"RGB 图像"只说明有三个通道,远远不足以说明数据含义。RAW 中的 camera RGB、线性 sRGB 和已经编码的 sRGB,都可能被程序存成三通道数组,但不能互换使用。
3. 用一个简化模型看清问题
对某个像素、某个传感器颜色通道,可以写出教学模型:
d c = b c + g c t ∫ E ( λ ) q c ( λ ) d λ + n c d_c=b_c+g_c t\int E(\lambda)q_c(\lambda)\,d\lambda+n_c dc=bc+gct∫E(λ)qc(λ)dλ+nc
其中, d c d_c dc 是数字读数, b c b_c bc 是黑电平, g c g_c gc 是有效增益, t t t 是曝光时间, E ( λ ) E(\lambda) E(λ) 是传感器处的光谱辐照度, q c ( λ ) q_c(\lambda) qc(λ) 是该通道的光谱响应, n c n_c nc 是噪声项。光学几何和标定比例因子在这里被简化了。
在没有饱和、完成必要校正、固定增益等条件下,增加曝光时间通常会近似按比例增加有效信号。注意,是减去黑电平后的信号,而不一定是文件里的原始整数。
3.1 这里的"线性关系"到底指什么?
这里的线性,不是说红、绿、蓝三种颜色彼此成固定比例,而是说:在拍摄设置和光谱组成不变时,某个像素、某个颜色通道接收到的光量增加几倍,它扣除黑电平后的有效信号也近似增加几倍。
例如,固定曝光时间、光圈和增益,只把照在灰卡上的同一种光增强一倍。假设绿色通道扣除黑电平后的读数原来是 100,理想线性响应应接近 200。这里的比例系数即使未知,我们仍可以判断相对光量翻了一倍;这不代表已经得到以瓦特或 lux 表示的绝对测量。
用公式表示,若进入某通道的有效光量为 L L L,有效传感器信号为 S S S,则在线性工作区间内:
S ( k L ) ≈ k S ( L ) S(kL)\approx kS(L) S(kL)≈kS(L)
线性还包含可加性。例如两部分光分别产生 S ( L 1 ) S(L_1) S(L1) 和 S ( L 2 ) S(L_2) S(L2),同时到达时应近似满足:
S ( L 1 + L 2 ) ≈ S ( L 1 ) + S ( L 2 ) S(L_1+L_2)\approx S(L_1)+S(L_2) S(L1+L2)≈S(L1)+S(L2)
这件事与颜色有关,但关系发生在每个传感器通道内部 。红、绿、蓝通道分别用自己的光谱响应 q c ( λ ) q_c(\lambda) qc(λ) 对入射光谱积分;如果光谱形状改变,各通道变化比例本来就可能不同。这里讨论的并不是"所有颜色一起等比例变化"。
成品照片通常不再保持这种简单比例。仅考虑 sRGB 编码,不考虑其他相机美化,线性分量从 0.1 增加到 0.2 时,物理量翻了一倍,但编码后的 8 位数值大约只从 89 变为 124,而不是从 89 变为 178:
| 线性分量 | sRGB 编码值 | 8 位近似值 |
|---|---|---|
| 0.1 | 0.349 | 89 |
| 0.2 | 0.485 | 124 |
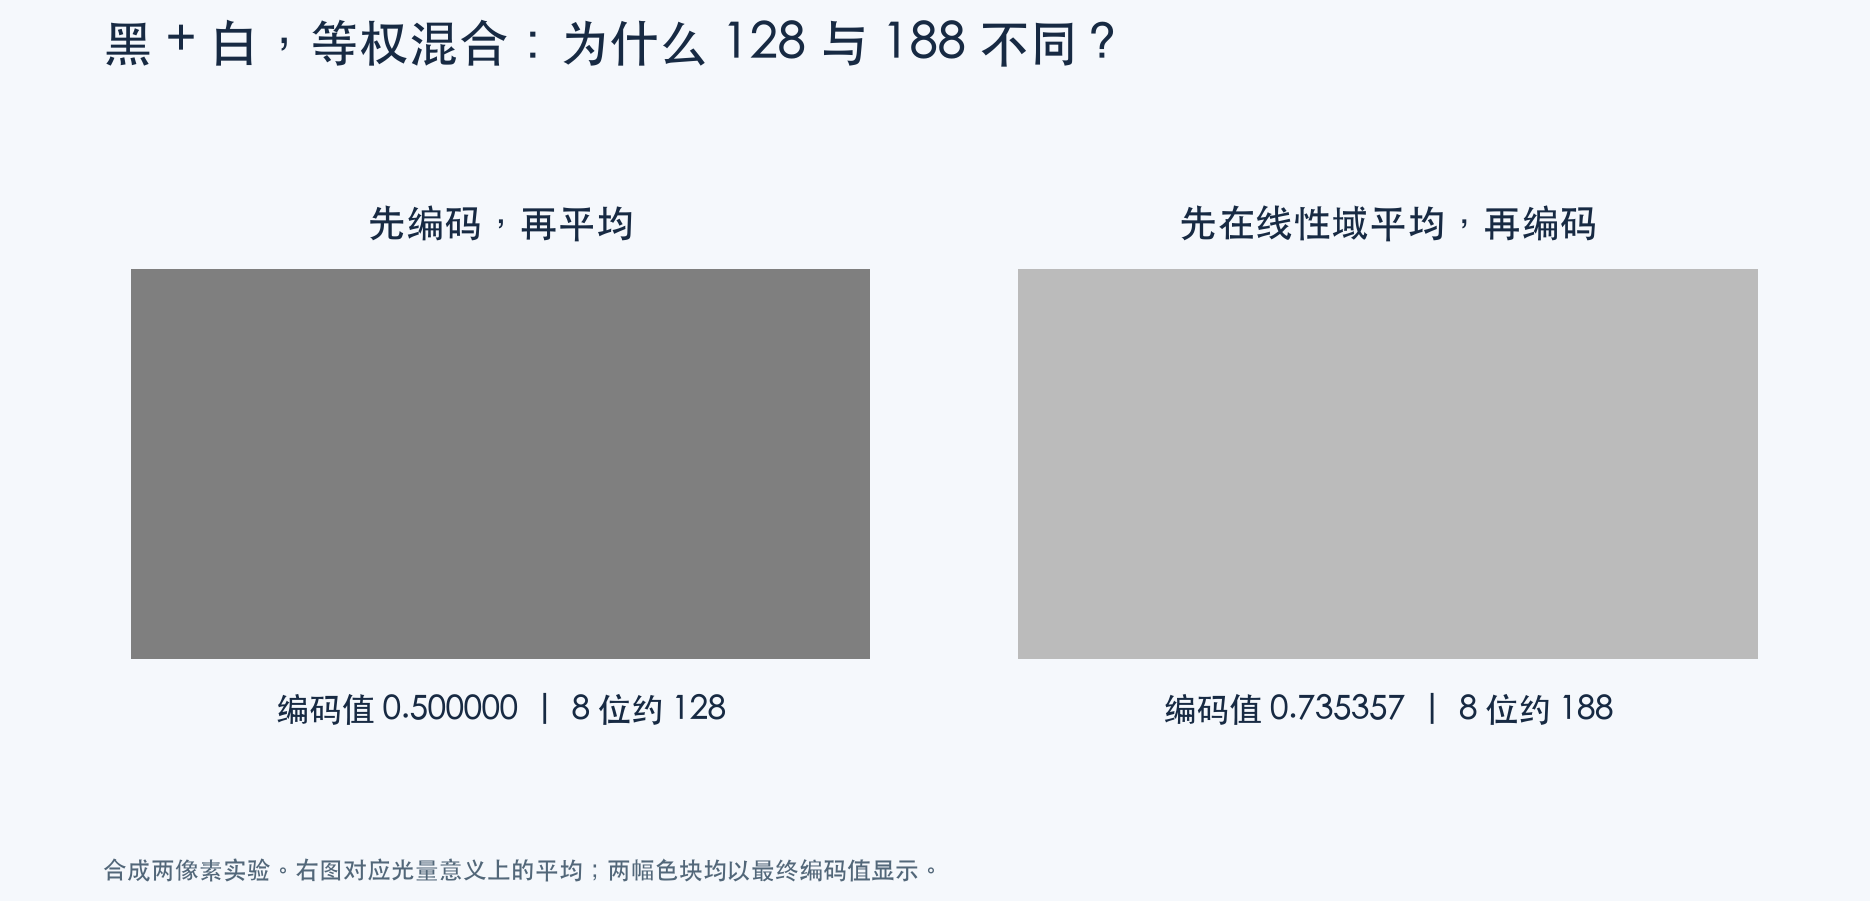
图 3:本专题的合成数值实验。黑色和白色在线性光量域等权平均后再编码,结果约为 188;直接平均两个 8 位编码值则约为 128。它说明非线性编码与线性混合不能随意交换顺序。
但保存的照片更接近:
I o u t = Q ( Γ ( F ( M W D ( R ) ) ) ) I_{\mathrm{out}}=Q\bigl(\Gamma(F(MWD(R)))\bigr) Iout=Q(Γ(F(MWD(R))))
R R R 表示经过必要预处理的 RAW 数据, D D D 表示去马赛克等重建操作, W W W 是白平衡, M M M 是颜色变换, F F F 汇总色调和颜色渲染, Γ \Gamma Γ 是输出编码, Q Q Q 表示量化、压缩等过程。这是解释问题的抽象模型,不是所有相机的固定执行顺序。
即使已知并去掉 Γ \Gamma Γ,你得到的仍然是经过 F F F 处理的结果。去掉 sRGB 编码,不等于倒退回原始传感器测量。
4. 三个容易混淆的层次
| 层次 | 它回答的问题 | 典型例子 |
|---|---|---|
| 场景与测量 | 相机实际接收到多少光? | 光谱、曝光、传感器响应 |
| 颜色表示与渲染 | 这些颜色如何表示、如何呈现? | camera RGB、XYZ、白平衡、色调映射 |
| 编码与文件 | 数值如何编码和存储? | sRGB 传递函数、JPEG、PNG、HEIF |
JPEG 是文件编码体系,sRGB 是色彩空间规范,它们不是同一个维度。JPEG 可能携带其他颜色配置;HEIF/HEIC 也不天然意味着某一种色彩空间。判断图像时需要看配置文件、元数据和实际生成流程,不能只看扩展名。
5. 计算机视觉什么时候会踩坑?
5.1 去模糊为什么会出现"额外振铃"?
去模糊常把观测过程写成:
y = k ∗ x + n y=k*x+n y=k∗x+n
x x x 是清晰图像, k k k 是模糊核, ∗ * ∗ 表示卷积, n n n 是噪声。这个模型假设:曝光期间积累的是线性光量,不同位置、不同时间的光可以按权重相加。
用一个没有噪声的一维黑白边缘说明。清晰信号为:
text
x = 0, 0, 1, 1, 1, ...假设模糊核只是将相邻两个像素等权平均,则:
text
y = 0, 0, 0.5, 1, 1, ...已知 y i = ( x i + x i − 1 ) / 2 y_i=(x_i+x_{i-1})/2 yi=(xi+xi−1)/2,可以递推恢复 x i = 2 y i − x i − 1 x_i=2y_i-x_{i-1} xi=2yi−xi−1。在线性数据上,算法能恢复出原来的 0, 0, 1, 1, 1。
但相机若先对模糊结果进行 sRGB 编码,中间的 0.5 会变成约 0.735。去模糊算法如果仍把这些编码值当成线性光量,就会计算出:
text
错误输入:0, 0, 0.735, 1,    1,    ...
错误恢复:0, 0, 1.470, 0.530, 1.470, ...
本来应该恒定为 1 的白色区域,出现了 1.47 的过冲和 0.53 的欠冲。在二维照片中,这通常表现为高对比度边缘附近的亮线、暗线或明暗交替的光晕,这就是振铃伪影。
从运算顺序看,真实输入更接近:
y p h o t o = f ( k ∗ x ) y_{\mathrm{photo}}=f(k*x) yphoto=f(k∗x)
f f f 表示 Gamma、色调曲线或局部色调映射。去模糊算法却按 y = k ∗ x y=k*x y=k∗x 求解。由于一般情况下:
f ( k ∗ x ) ≠ k ∗ f ( x ) f(k*x)\ne k*f(x) f(k∗x)=k∗f(x)
算法会把非线性造成的数值变化误认为需要恢复的图像细节,通过增强高频去"纠正",从而产生或加重边缘过冲和欠冲。
"额外"是为了区分两类来源:去卷积本来就是病态问题,噪声、模糊核估计误差和高频放大都可能造成振铃;非线性色调处理又增加了一层模型失配。它不意味着每张非线性照片都必然出现明显振铃,程度还取决于算法的正则化、模糊核、噪声和相机处理方式。
如果只有标准 sRGB 编码,而且没有其他未知处理,可以先按精确 sRGB 公式解码到线性 sRGB,再使用相应模型。但真实相机还可能进行局部色调映射、降噪、锐化和颜色渲染,所以"做一次逆 Gamma"并不保证恢复到原始传感器测量。
光度立体和明暗恢复形状依赖像素值与光照、材质和几何的关系。自动曝光、局部提亮和风格渲染都可能改变这些关系。
颜色检测与跨相机识别依赖颜色分布。一个在相机 A 上有效的阈值,换到相机 B,或者仅切换图像风格,就可能失效。
深度学习可以从照片中学习有效特征,但并不会让输入数据自动满足物理假设。部署时更换设备或 ISP,仍会引入分布变化。
这不意味着视觉任务都必须使用 RAW。目标检测、人像分类等任务完全可以在成品照片上训练。关键是让输入域、训练分布和算法假设相匹配。
6. 到底选哪种输入?
| 任务目标 | 建议起点 | 仍需核实 |
|---|---|---|
| 科学测量、曝光响应、物理成像建模 | RAW 或经过标定的线性数据 | 黑电平、饱和、增益、曝光与隐藏处理 |
| 拍照应用、视觉观感优化 | 已知配置的标准颜色图像 | 输出白点、色域、渲染风格 |
| 常规识别与检测 | 与部署相匹配的真实输入 | 跨设备、光照与 ISP 的域差异 |
| 跨设备颜色比较 | 标定后的共同颜色表示 | 光源、白点、色卡与颜色误差 |
工程上,最有价值的第一步往往不是立即修改网络,而是写清一句话:"我们的输入是某设备产生的、带某颜色配置的、经过某种处理的图像。"
7. 这个专题接下来讲什么?
第 2 篇解释颜色怎样从光谱变成三个数;第 3 篇区分 XYZ、sRGB、Lab 和各种"亮度";第 4~6 篇拆解 RAW、白平衡与相机渲染;第 7 篇集中排查视觉算法的颜色误区;第 8 篇整理讲义涉及的研究路线;第 9 篇用 Python 验证关键结论。
读完后应能回答三个问题:手上的数值属于哪个空间,经历过哪些操作,是否还满足算法要求。
参考与出处
- Michael S. Brown, Understanding color & the in-camera image processing pipeline for computer vision, ICCV 2019 Tutorial,用户提供 PDF 第 1~23、107、111、175~176、238~242 页。
- 文中模型、中文流程图与任务建议为本专题的教学整理。所有页码均指 PDF 文件实际页序,不是幻灯片页脚编号。