自回归
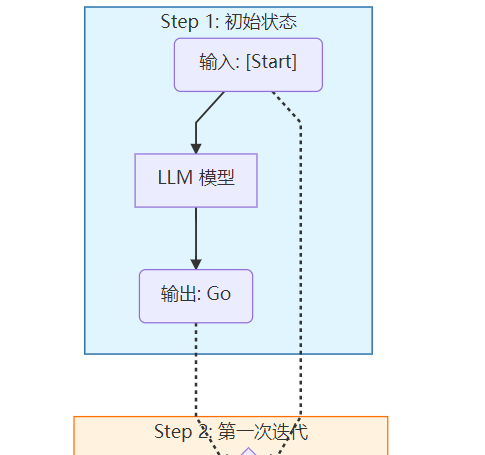
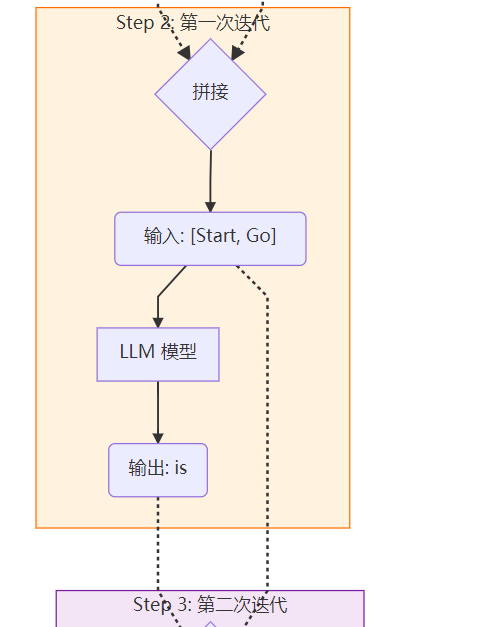
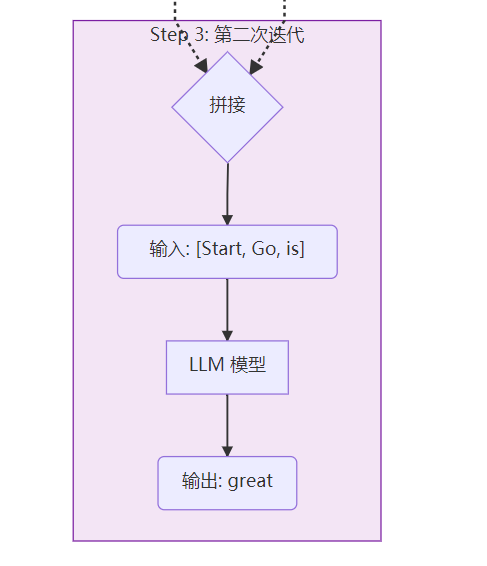
自回归 (Autoregression) 的字面意思是:"用自己(Auto)过去的值来预测/回归(Regression)未来的值"。
在 LLM 的语境下,就是Next Token Prediction(预测下一个词)。
上下文长度核心定义:Input + Output 的总和
上下文长度是指模型在一次推理中能够处理的 Token 总数量上限。
这个公式非常重要:
Context\\ Window \\ge (Prompt\\ Input + Generated\\ Output)
-
Prompt Input: 包含你的系统提示词 (System Prompt)、历史对话 (History)、RAG 检索到的文档 (Context)。
-
Generated Output: 模型生成的回答。
为什么会有上下文限制?(底层原理)
主要原因在于 Attention 机制的计算复杂度。
输入翻倍 (2x)→计算量翻四倍 (4x) →显存占用翻四倍。
当 Context 从 4K 增加到 128K 时,如果不加优化(如 Ring Attention),计算量和显存需求是天文数字。
应对策略:滑动窗口 (Sliding Window)
当对话越来越长,超过 Context 限制时,Agent 必须学会"遗忘"。最常见的策略是 FIFO (先进先出)。