✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
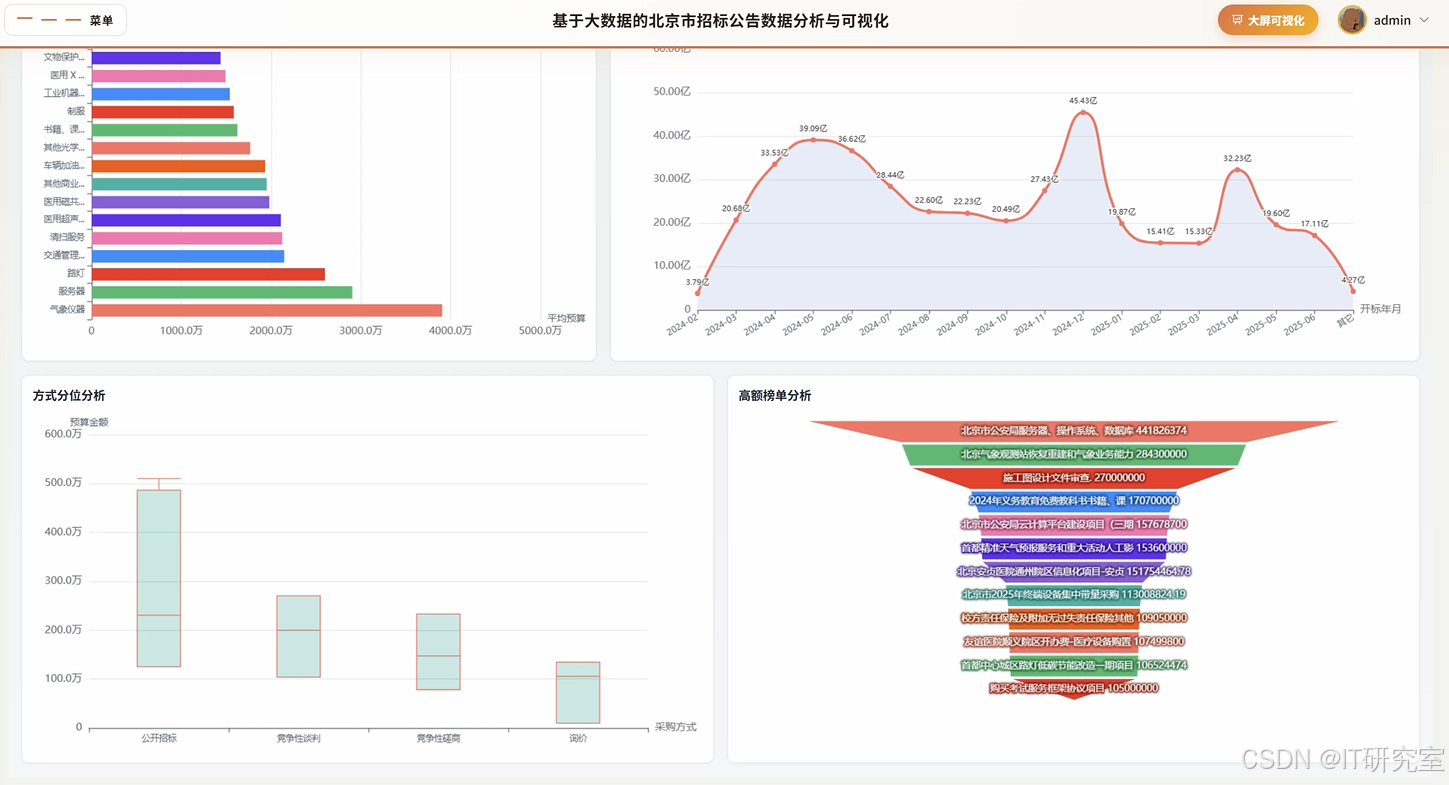
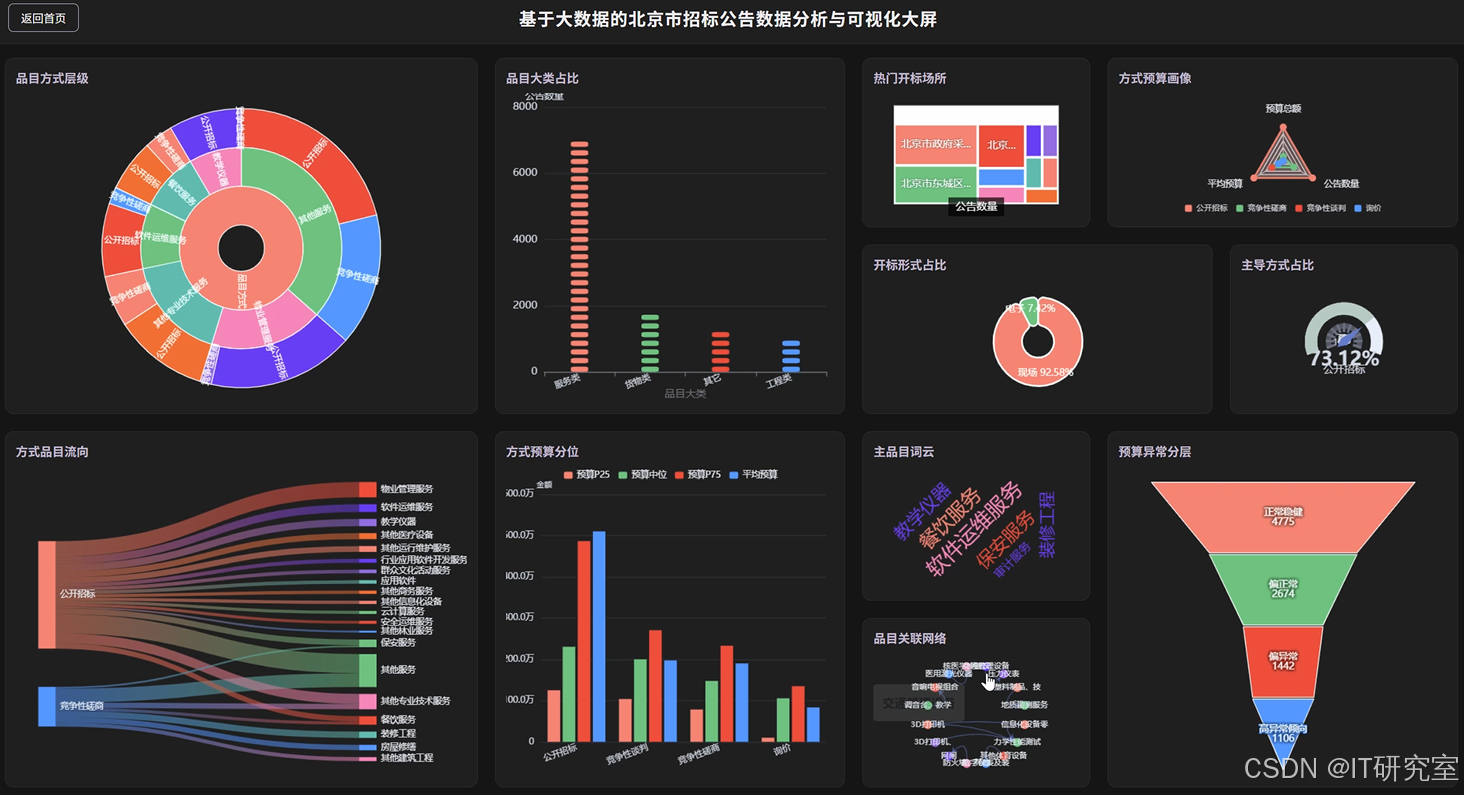
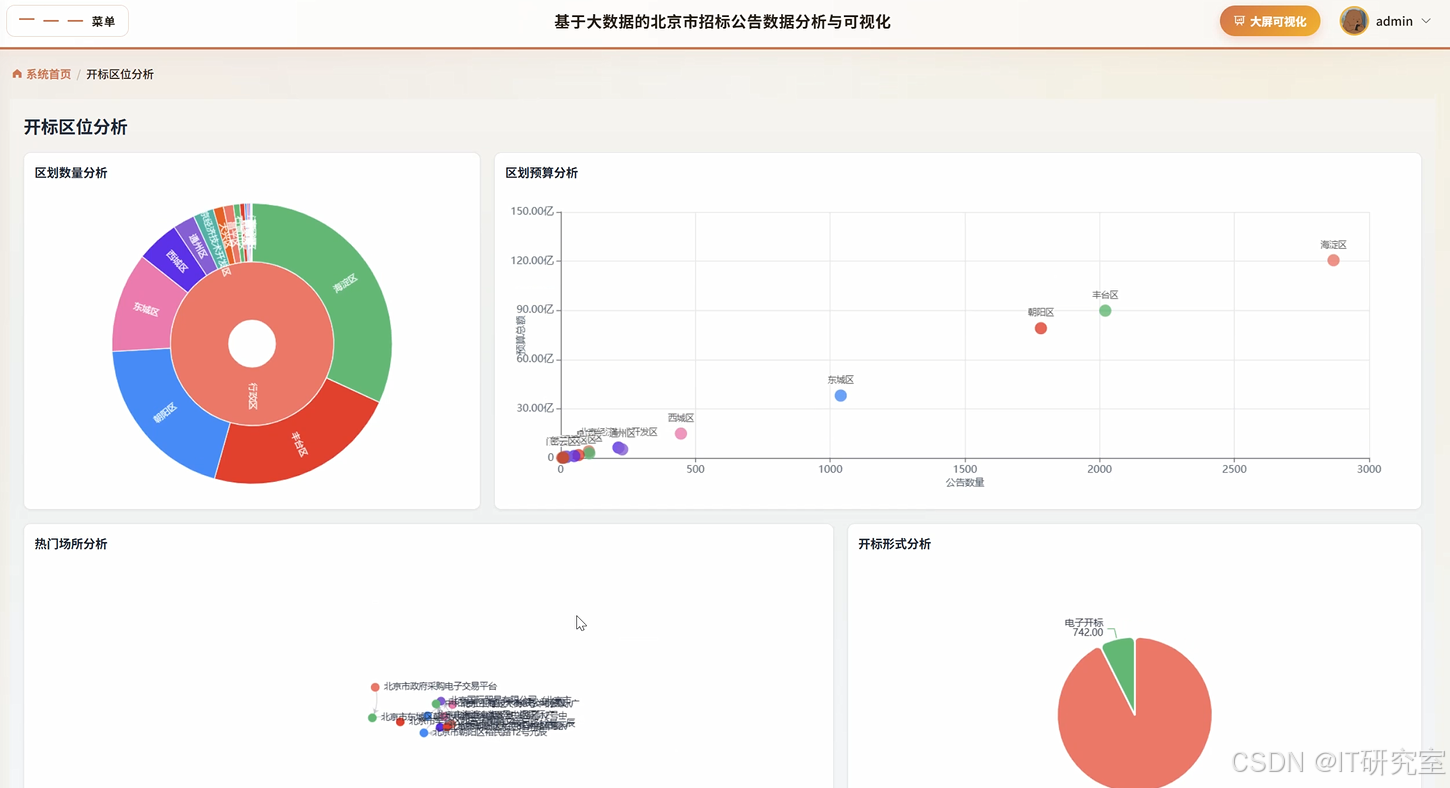
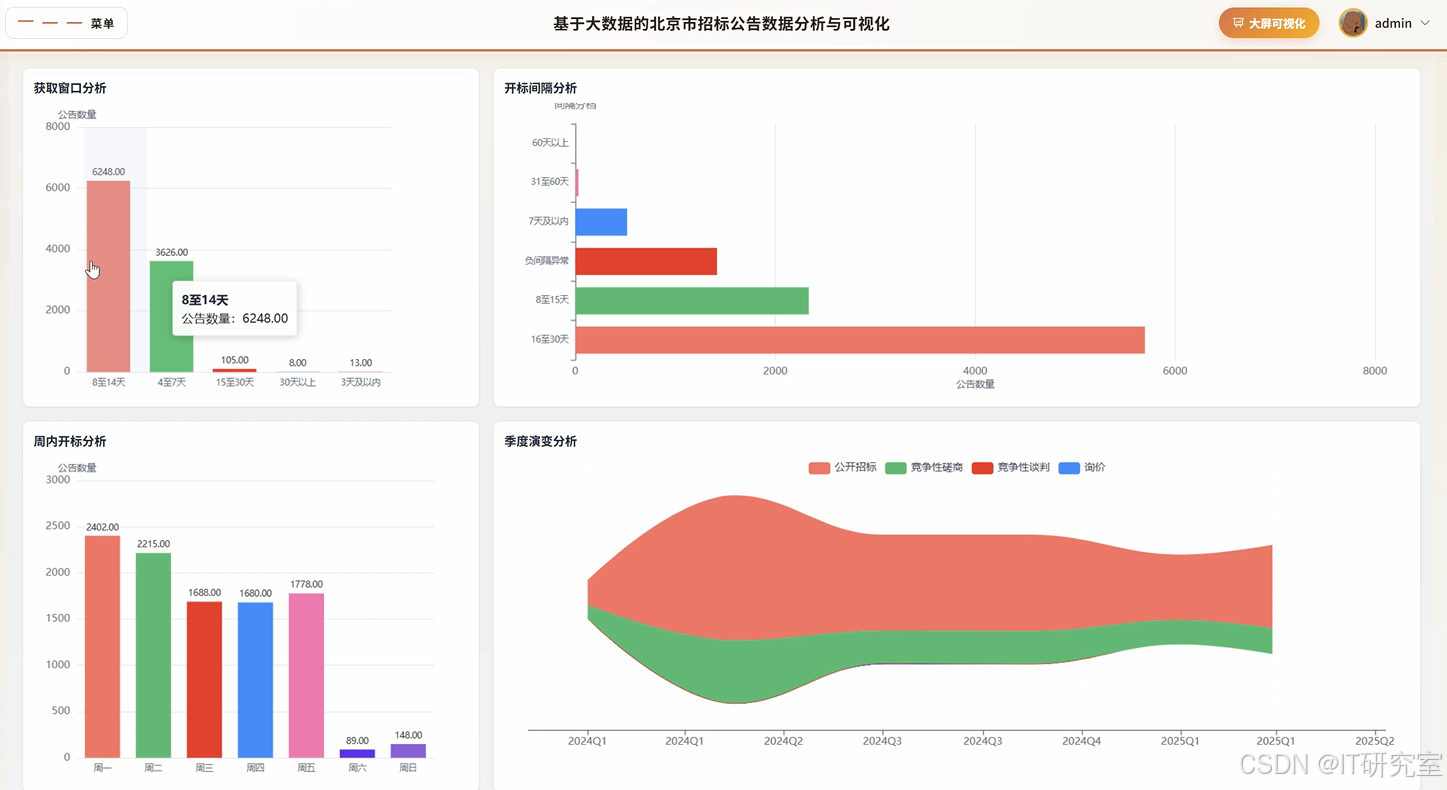
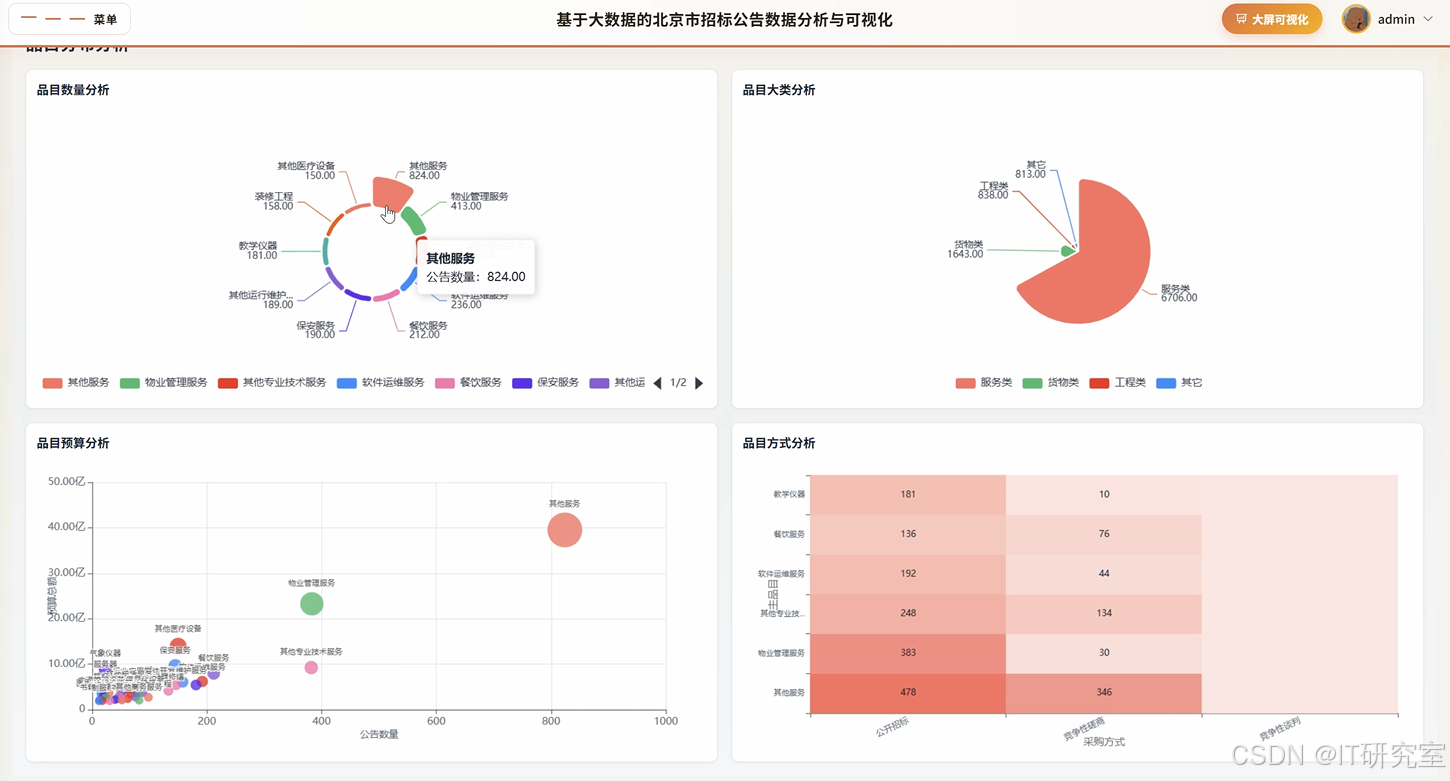
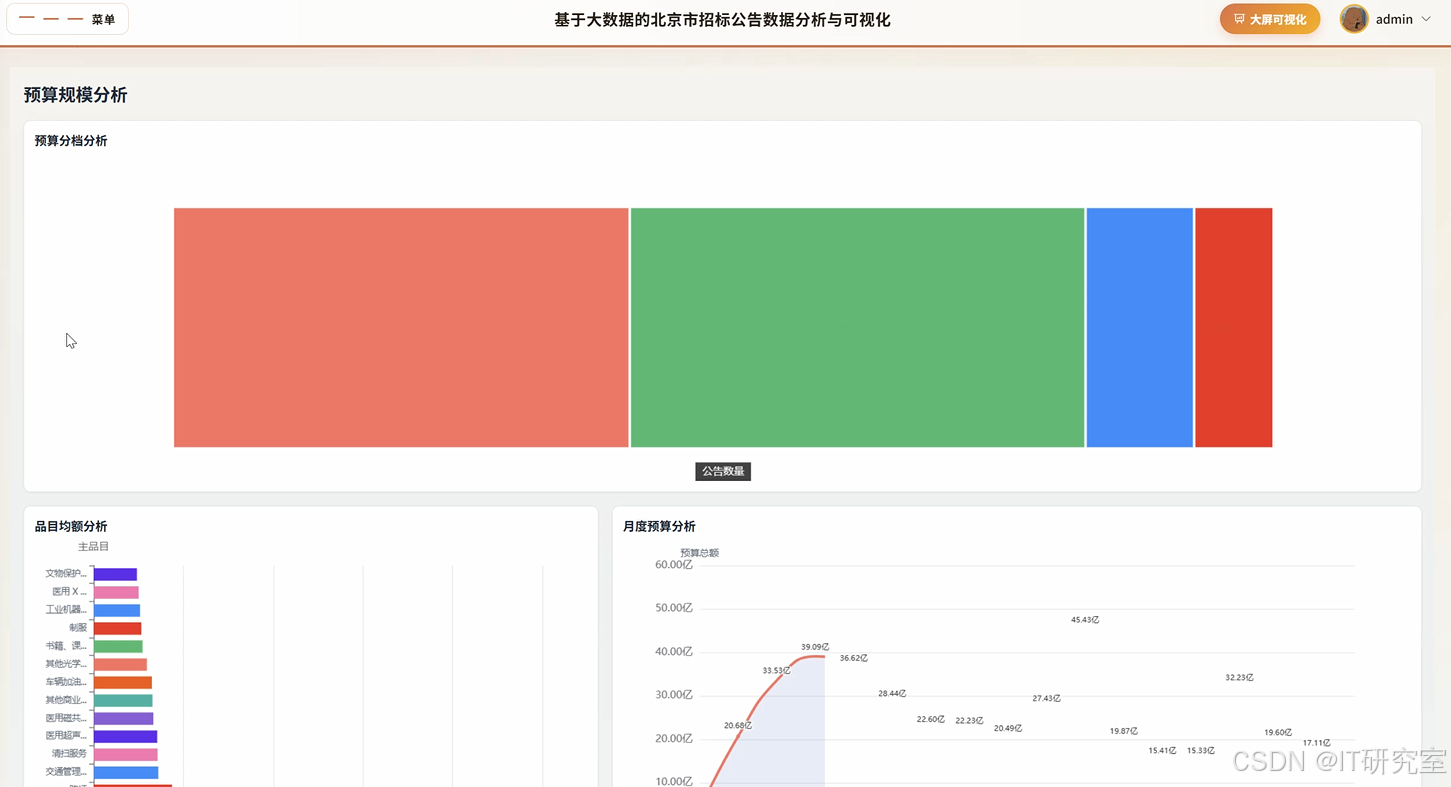
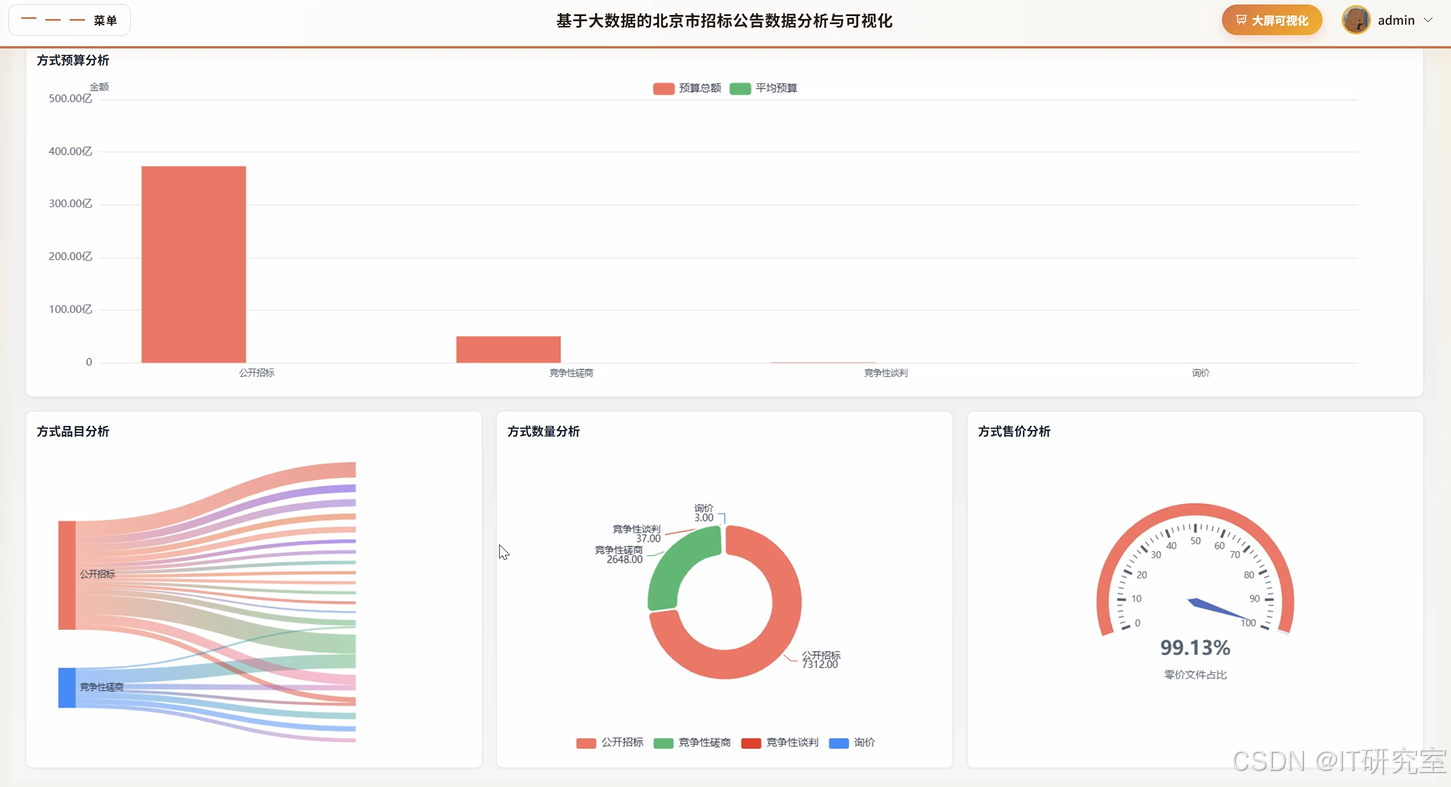
《基于大数据的北京市招标公告数据分析与可视化》系统是一个以Hadoop分布式文件系统和Spark分布式计算引擎为核心技术栈的数据处理与分析平台。系统通过采集北京市公开的招标公告数据,利用HDFS进行海量原始数据的可靠存储,再借助Spark SQL和Spark Core API完成数据的清洗、转换、聚合等预处理操作,最终将处理结果存入MySQL数据库供前端展示。在功能层面,系统提供了招标信息管理、品目分布统计、采购画像构建、采购方式偏好分析、开标区位热度分析、预算规模分级统计以及发布趋势时序分析等多个分析模块,并配有ECharts驱动的可视化大屏和系统首页,用于综合展示各类分析图表。用户可通过Vue与ElementUI构建的管理界面进行权限管理和数据检索,从而实现对北京市招标公告数据的全链条、多维度分析,为相关决策提供数据支撑。
选题背景
北京市作为全国公共资源交易最活跃的地区之一,其招标公告数据蕴含着丰富的采购趋势、市场竞争格局与政策导向信息。长期以来,这些数据以非结构化或半结构化的文本形式发布在各级政府采购网站上,数据量庞大且更新频繁,人工难以有效整合与利用。随着大数据技术的成熟,利用分布式存储与计算框架对海量招标数据进行系统化采集、清洗和分析成为可能。当前,将大数据分析手段应用于公共资源交易领域的研究尚处于发展阶段,缺乏针对区域招标数据的完整分析案例。因此,设计一套能够对北京市招标公告数据进行高效处理与多维度可视化展示的系统,既顺应了数字政府建设背景下数据驱动决策的趋势,也能为相关专业学生提供一个贴合真实业务场景的毕业设计实践课题,帮助其掌握从数据采集到分析展示的完整工程流程。
选题意义
本课题的意义主要体现在实践训练与业务参考两个层面。从个人能力培养角度看,完成该系统有助于将大数据课程中的Hadoop、Spark等理论知识落地为可运行的工程项目,通过实际编码加深对分布式计算原理、数据清洗流程和可视化设计方法的理解,积累从环境搭建到系统部署的全过程经验。从应用价值角度看,系统输出的品目分布、采购方式倾向、区位热度等分析结果,能够辅助小型供应商或创业团队快速了解北京市招标市场的活跃领域与竞争强度,为其参与投标提供方向参考;招标代理机构也可借此观察不同采购方式的使用频率变化,优化自身服务策略。同时,系统积累的时序数据对观察政府采购政策在特定区域的实际执行效果具有一定参考意义。当然,受限于数据来源与分析深度,本系统的分析结论仅供辅助参考,不能替代专业决策,但其设计与实现方法可为同类区域招标数据分析系统的开发提供可借鉴的技术方案。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
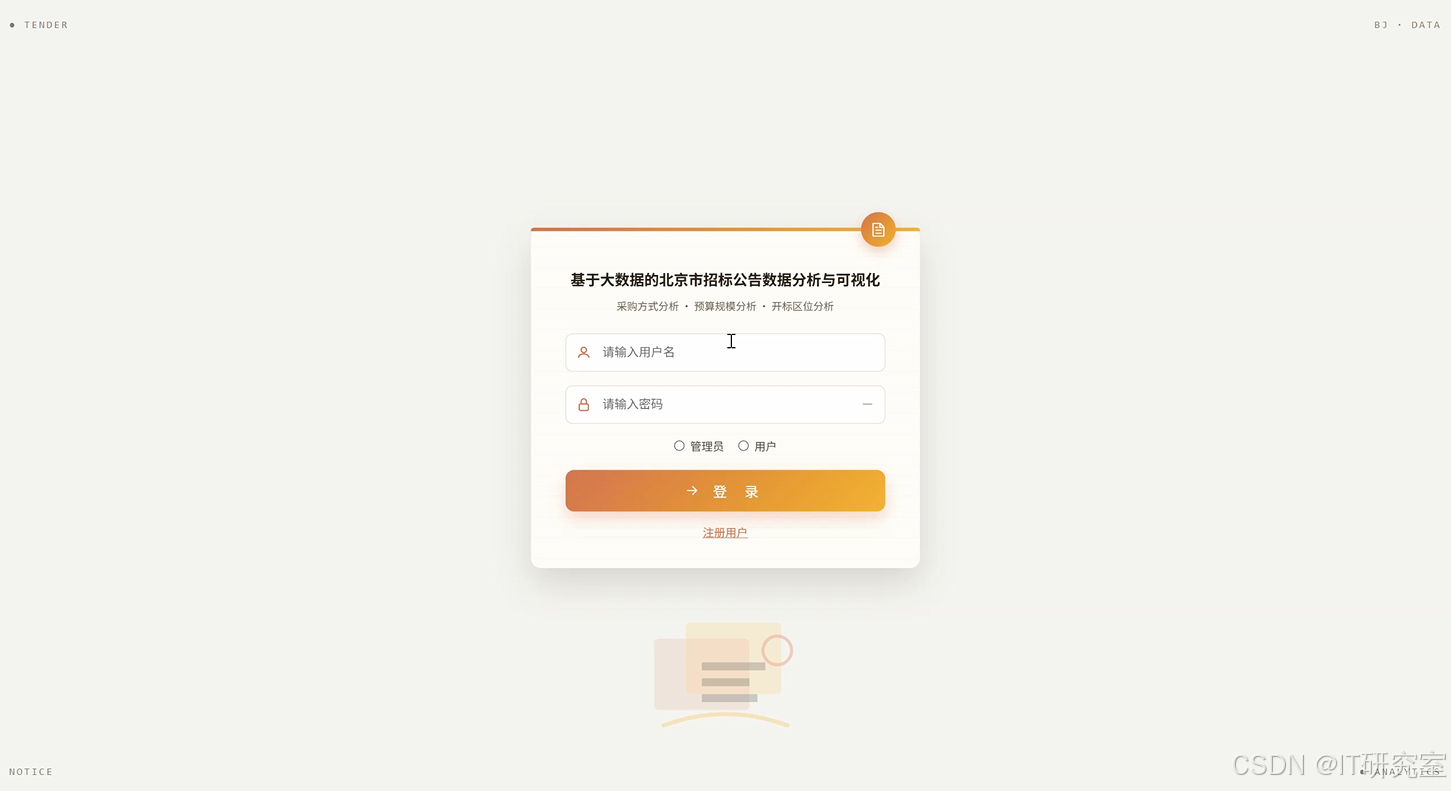
- 基于大数据的北京市招标公告数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, year, month, dayofmonth, hour, weekofyear, date_format, to_date, sum as spark_sum, count as spark_count, avg, when, lit, udf, desc, asc, split, explode, regexp_extract, substring, length, isnan, isnull, round
from pyspark.sql.types import StructType, StructField, StringType, IntegerType, DoubleType, LongType, DateType, DecimalType
spark = SparkSession.builder.appName("BeijingTenderAnalysis").config("spark.sql.shuffle.partitions", "200").config("spark.serializer", "org.apache.spark.serializer.KryoSerializer").getOrCreate()
hadoop_conf = spark.sparkContext._jsc.hadoopConfiguration()
hadoop_conf.set("fs.hdfs.impl", "org.apache.hadoop.hdfs.DistributedFileSystem")
df = spark.read.option("header", "true").option("inferSchema", "true").option("encoding", "UTF-8").csv("hdfs://localhost:9000/user/tender_data/raw/*.csv")
df_clean = df.dropDuplicates(["tender_id"]).filter(col("budget").isNotNull()).filter(col("budget") > 0).filter(col("publish_date").isNotNull()).filter(length(col("publish_date")) >= 10)
df_with_date = df_clean.withColumn("publish_date_parsed", to_date(col("publish_date"), "yyyy-MM-dd")).filter(col("publish_date_parsed").isNotNull())
df_with_year = df_with_date.withColumn("year", year(col("publish_date_parsed"))).withColumn("month", month(col("publish_date_parsed"))).withColumn("day", dayofmonth(col("publish_date_parsed")))
df_budget_level = df_with_year.withColumn("budget_level", when(col("budget") < 100000, "10万以下").when((col("budget") >= 100000) & (col("budget") < 1000000), "10-100万").when((col("budget") >= 1000000) & (col("budget") < 5000000), "100-500万").when((col("budget") >= 5000000) & (col("budget") < 10000000), "500-1000万").otherwise("1000万以上"))
df_with_location = df_budget_level.withColumn("district", regexp_extract(col("address"), "(北京市|北京)(.{0,10}?(区|县))", 2)).withColumn("district", when(col("district") == "", "其他区县").otherwise(col("district")))
def categorize_purchase_method(method):
    if method is None: return "未知"
    m = str(method).strip()
    if "公开" in m or "招标" in m: return "公开招标"
    elif "竞争" in m and "磋商" in m: return "竞争性磋商"
    elif "竞争" in m and "谈判" in m: return "竞争性谈判"
    elif "询价" in m: return "询价"
    elif "单一" in m: return "单一来源"
    else: return "其他方式"
purchase_udf = udf(categorize_purchase_method, StringType())
df_with_method = df_with_location.withColumn("purchase_method", purchase_udf(col("purchase_method_original")))
df_category = df_with_method.withColumn("category_main", regexp_extract(col("category"), "([^/]+)", 1)).withColumn("category_main", when(col("category_main") == "", "未分类").otherwise(col("category_main")))
df_industry = df_category.withColumn("industry", regexp_extract(col("tender_name"), "(信息|医疗|教育|交通|环保|能源|建筑|农业|金融|服务)", 0)).withColumn("industry", when(col("industry") == "", "其他行业").otherwise(col("industry")))
df_with_purchase_count = df_industry.withColumn("purchase_count", when(col("purchase_quantity").isNotNull(), col("purchase_quantity")).otherwise(lit(1)))
result_publish_trend = df_with_purchase_count.groupBy("year", "month").agg(spark_count("tender_id").alias("tender_count"), spark_sum("budget").alias("total_budget_month")).orderBy("year", "month")
result_category_distribution = df_with_purchase_count.groupBy("category_main").agg(spark_count("tender_id").alias("count"), spark_sum("budget").alias("total_budget"), avg("budget").alias("avg_budget")).orderBy(desc("count"))
result_purchase_method = df_with_purchase_count.groupBy("purchase_method").agg(spark_count("tender_id").alias("count"), spark_sum("budget").alias("total_budget"), round(avg("budget"), 2).alias("avg_budget")).orderBy(desc("count"))
result_location_analysis = df_with_purchase_count.groupBy("district").agg(spark_count("tender_id").alias("tender_count"), spark_sum("budget").alias("total_budget"), round(avg("budget"), 2).alias("avg_budget")).orderBy(desc("tender_count"))
result_budget_scale = df_with_purchase_count.groupBy("budget_level").agg(spark_count("tender_id").alias("count"), spark_sum("budget").alias("total_budget"), round(avg("budget"), 2).alias("avg_budget")).orderBy(desc("count"))
result_industry_distribution = df_with_purchase_count.groupBy("industry").agg(spark_count("tender_id").alias("count"), spark_sum("budget").alias("total_budget"), round(avg("budget"), 2).alias("avg_budget")).orderBy(desc("count"))
result_purchase_profile = df_with_purchase_count.groupBy("year").agg(spark_count("tender_id").alias("total_tenders"), spark_sum("budget").alias("annual_total_budget"), round(avg("budget"), 2).alias("annual_avg_budget"), spark_sum("purchase_count").alias("total_purchase_quantity")).orderBy(desc("year"))
df_with_tender_month = df_with_purchase_count.withColumn("tender_month", date_format(col("publish_date_parsed"), "yyyy-MM"))
result_monthly_trend = df_with_tender_month.groupBy("tender_month").agg(spark_count("tender_id").alias("monthly_count"), spark_sum("budget").alias("monthly_budget_total")).orderBy("tender_month")
df_with_day_of_week = df_with_purchase_count.withColumn("day_of_week", date_format(col("publish_date_parsed"), "E"))
result_weekday_distribution = df_with_day_of_week.groupBy("day_of_week").agg(spark_count("tender_id").alias("count"), spark_sum("budget").alias("total_budget")).orderBy(desc("count"))
df_with_hour = df_with_day_of_week.withColumn("publish_hour", hour(col("publish_time")))
result_hour_distribution = df_with_hour.filter(col("publish_hour").isNotNull()).groupBy("publish_hour").agg(spark_count("tender_id").alias("count")).orderBy("publish_hour")
result_top_agencies = df_with_purchase_count.groupBy("procurement_agency").agg(spark_count("tender_id").alias("tender_count"), spark_sum("budget").alias("total_budget")).orderBy(desc("tender_count")).limit(20)
result_top_bidders = df_with_purchase_count.groupBy("bidder_name").agg(spark_count("tender_id").alias("win_count"), spark_sum("budget").alias("total_win_budget")).orderBy(desc("win_count")).limit(20)
df_cleaned_for_export = df_with_purchase_count.select("tender_id", "tender_name", "procurement_agency", "bidder_name", "budget", "publish_date_parsed", "district", "category_main", "industry", "purchase_method", "budget_level")
df_cleaned_for_export.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="tender_analysis_results", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_publish_trend.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="publish_trend", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_category_distribution.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="category_distribution", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_purchase_method.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="purchase_method_stats", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_location_analysis.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="location_analysis", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_budget_scale.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="budget_scale", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_industry_distribution.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="industry_distribution", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_purchase_profile.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="purchase_profile", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_monthly_trend.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="monthly_trend", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_weekday_distribution.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="weekday_distribution", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_hour_distribution.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="hour_distribution", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_top_agencies.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="top_agencies", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
result_top_bidders.write.mode("overwrite").option("truncate", "true").jdbc(url="jdbc:mysql://localhost:3306/tender_db?useSSL=false&serverTimezone=Asia/Shanghai", table="top_bidders", properties={"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"})
spark.stop()
五、系统视频
基于大数据的北京市招标公告数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的北京市招标公告数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇