你把一篇论文交给 AI,它很快给出一份总结:研究背景、方法创新、实验结果、主要贡献。
每句话都像是懂了。
但合上回答,试着自己讲一遍:这个方法的输入是什么?中间做了什么?为什么要多这一步?实验究竟支持了哪个结论?
你可能又得回到原文。
我想做一个更适合这个过程的工具:先帮人看清论文主线,再把关键机制、论证和证据展开。遇到难点,还能沿着同一篇论文继续讨论。
于是有了 PaperUnfold,一个面向跨学科研究人员的开源项目。
知道论文提出了什么,还需要理解它如何得到结果,以及证据支持到哪里。此图为阅读结构示意。
灵感来自一个很简单的问题:解释能不能换一种形式?
此前看到 Karpathy 关于清晰表达和定制讲解产物的讨论,我对其中一个方向很感兴趣:模型可以为眼前的问题生成图示、网页等产物,让人更容易理解已经完成的工作。
读论文恰好需要这件事。
文字适合交代背景,流程图适合展示步骤关系,公式需要逐项解释,实验结果需要连回作者的判断。把这些都塞进一段连续文字,读者就要自己在脑中重新组织一遍。
PaperUnfold 因此把清晰表达落实到具体的阅读结构:术语前后一致,每一步有明确作用,重要结论带着条件和原文位置。
它也参考了 asd-ste100-skill 的清晰表达思路。这里的目标是保留论文含义,并把关系讲明白。
两个 Skill,分别处理"看清全局"和"拆开难点"
PaperUnfold 目前包含两个可以独立使用的 Skill。Skill 可以理解为交给 Agent 的一套工作说明,配合必要的辅助工具,约束它如何阅读、解释和保存结果。
paper-guide 生成可视化 HTML 导读。
先交代论文想解决什么、核心思路是什么、主要结论成立在什么条件下,再展开关键机制或论证。相关流程、公式、结果和证据放在对应的解释旁边。
paper-tutor 在对话中处理一个具体难点。
比如"这一层为什么要做聚合",或者"这组实验能支持因果结论吗"。它围绕选定的问题推进,结合你的回答给反馈,也支持直接讲解、提示、跳过和暂停。
两者可以连着用,也可以直接把论文交给 paper-tutor。从导读进入教学时,页面提供可复制的提示词,教学发生在 Agent 对话中。
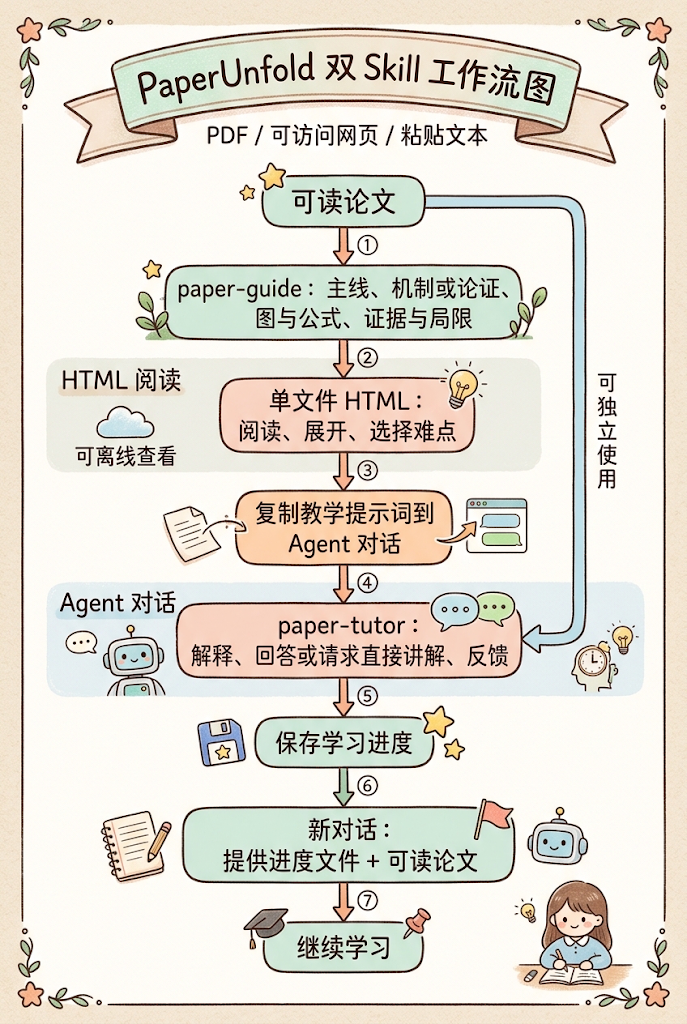
paper-guide 帮你定位主线和难点,paper-tutor 沿着具体问题继续讲解;两个 Skill 也能独立使用。
导读要讲到哪一层?用 FOCUS 举个例子
我们曾用 FOCUS:Internal MLLM Representations for Efficient Fine-Grained Visual Question Answering 做实际导读测试。
这篇论文研究细粒度视觉问答:图像中某个对象较小、细节较多时,怎样找到值得进一步查看的区域,并让模型回答问题。
如果只写"利用模型内部表示定位目标区域,再进行视觉问答",你能记住方法的大意,却很难解释它怎么工作。
导读需要继续展开:
- 从问题中识别要寻找的对象。
- 读取模型内部的文本和视觉 value 表示,计算对象相关性图。
- 根据相关性图提出候选区域。
- 对候选区域进行目标存在性验证和重排。
- 按问题组织区域,再交给底座模型完成问答。
读到这里,一个容易混淆的区别就清楚了:相关性图帮助提出候选区域;目标存在性验证进一步筛选候选;最终问答再处理问题本身。
这几个步骤承担不同任务。导读还需要交代它们的输入、输出、连接关系和适用条件。
流程图也要把这些关系画出来:箭头上标注传递的内容,每个节点对应可核查的原文位置。公式放在相关步骤旁边,说明符号含义和它在流程中的作用。
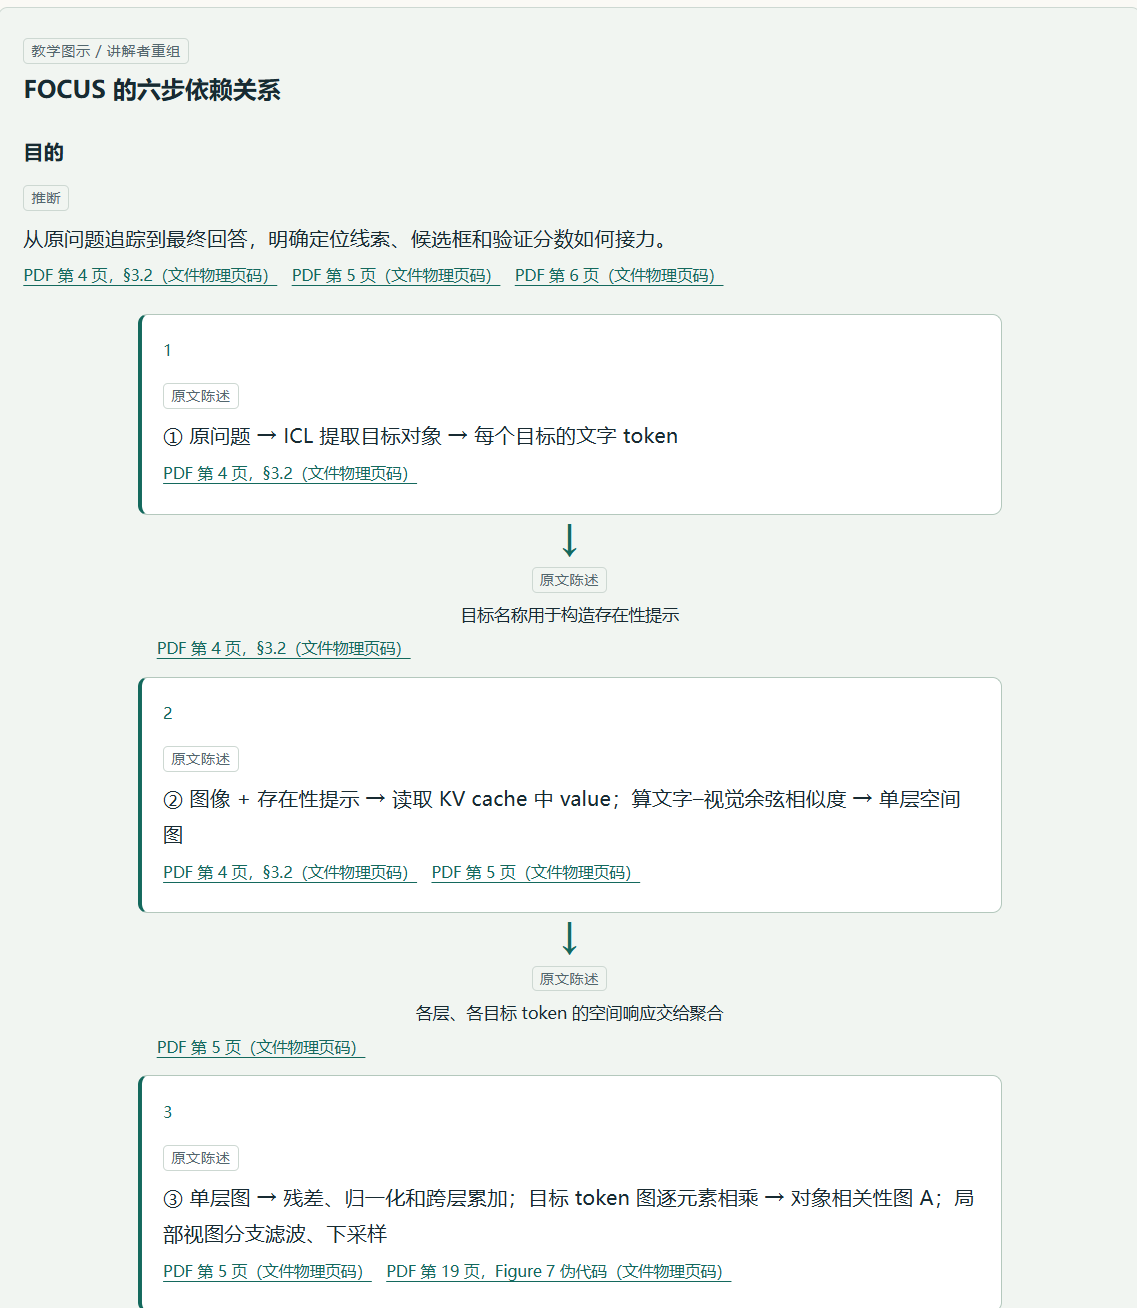
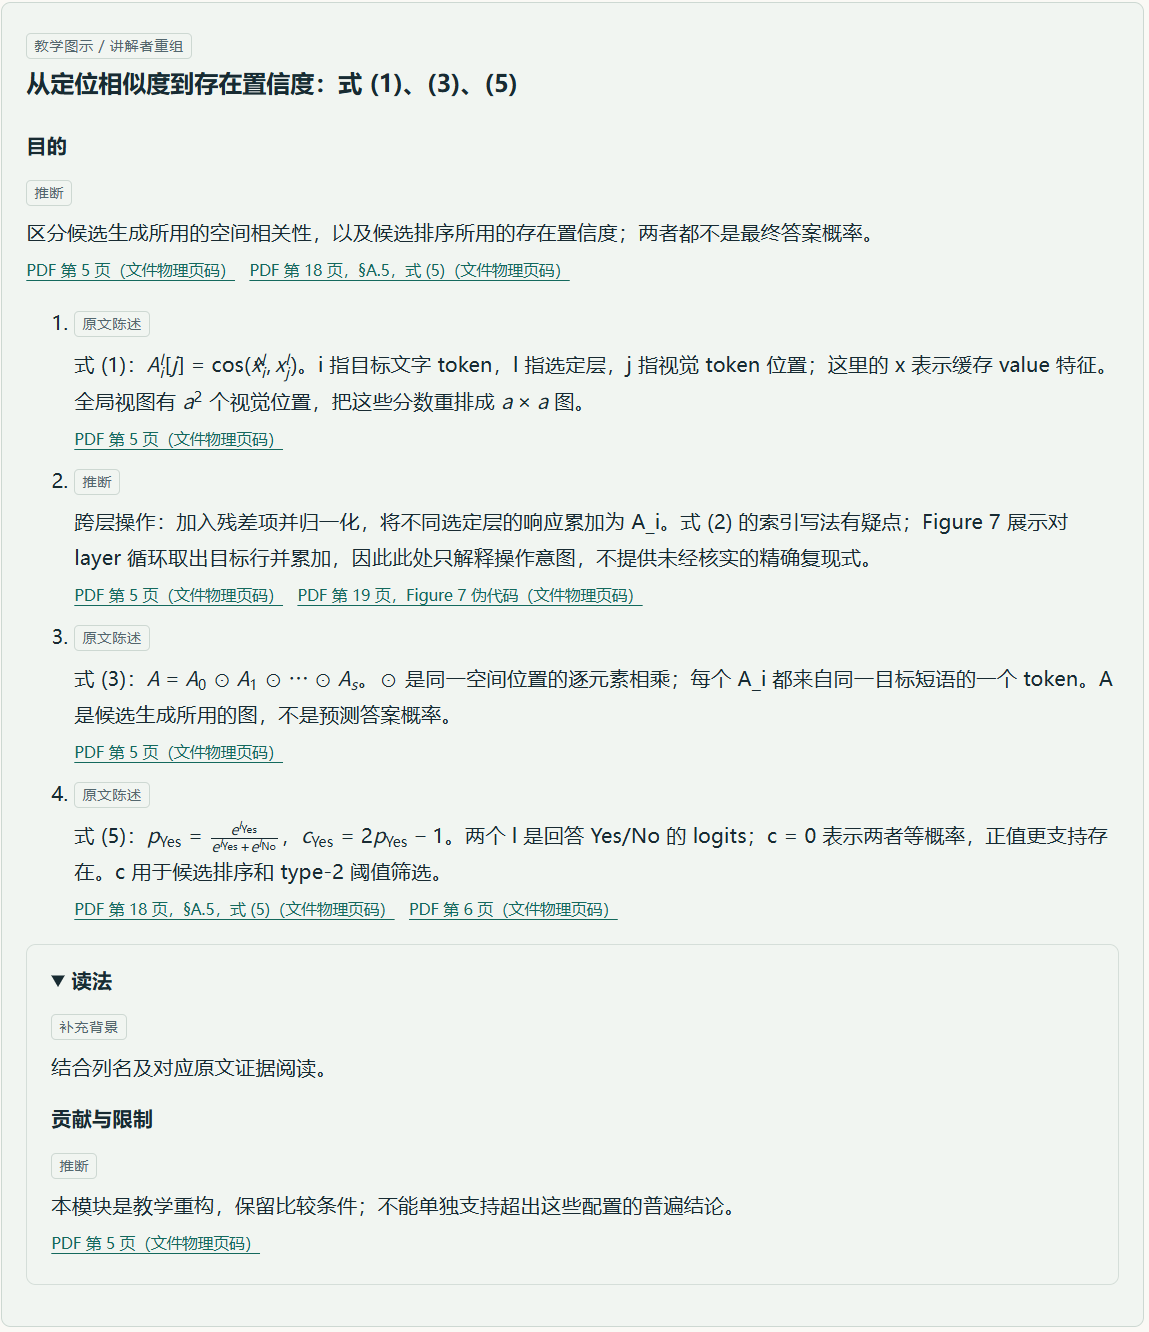
FOCUS 导读把候选区域生成、目标验证和最终问答分开解释。流程为依据原文整理的教学图,公式在 HTML 中渲染显示。
通用的是阅读方法,呈现方式跟着论文走
PaperUnfold 面向全球各类学科的研究人员,讲解跟随对话语言,并保留论文原始术语,方便回到原文查找。
我认为这里有一套通用方法:找到研究问题,追踪作者怎样推进,检查证据与结论之间的关系。
但不同论文需要不同的展开方式。
算法论文适合追踪数据和步骤。实证论文要看研究设计、变量、比较方式和结果。理论或论证型论文则要明确前提、推导关系和结论边界。
因此,用户不必先选一个学科模板。导读根据论文内容组织解释:该画 pipeline 时画 pipeline,该画证据关系或论证结构时,就采用对应的图。
仓库已经提供算法、实证和理论论证三类示例。不过,这些示例展示的是方法如何适配不同研究结构,尚不能证明它在所有学科中的质量。
看懂一页,不等于已经掌握
读论文时,最值得继续讨论的往往是一个很小的推断。
比如一篇研究心理学可重复性的论文中,"样本量在某个模型里不显著",能否推出"增加样本量没有用"?这涉及跨研究的统计关联与改变同一研究条件之间的区别。
paper-tutor 会围绕这样的区别展开。你可以先回答一个问题,让它判断哪些部分已有依据,哪些推断还需要修正。遇到陌生概念,再补充相关背景。
如果你只想让它直接解释,也可以明确提出。教学不需要每一步都变成测验。
暂停时,可以保存学习进度。下次把进度文件和可读论文一起提供,它便能从已记录的位置继续。进度会区分讲过的内容、回答中体现出的理解,以及仍未解决的问题。
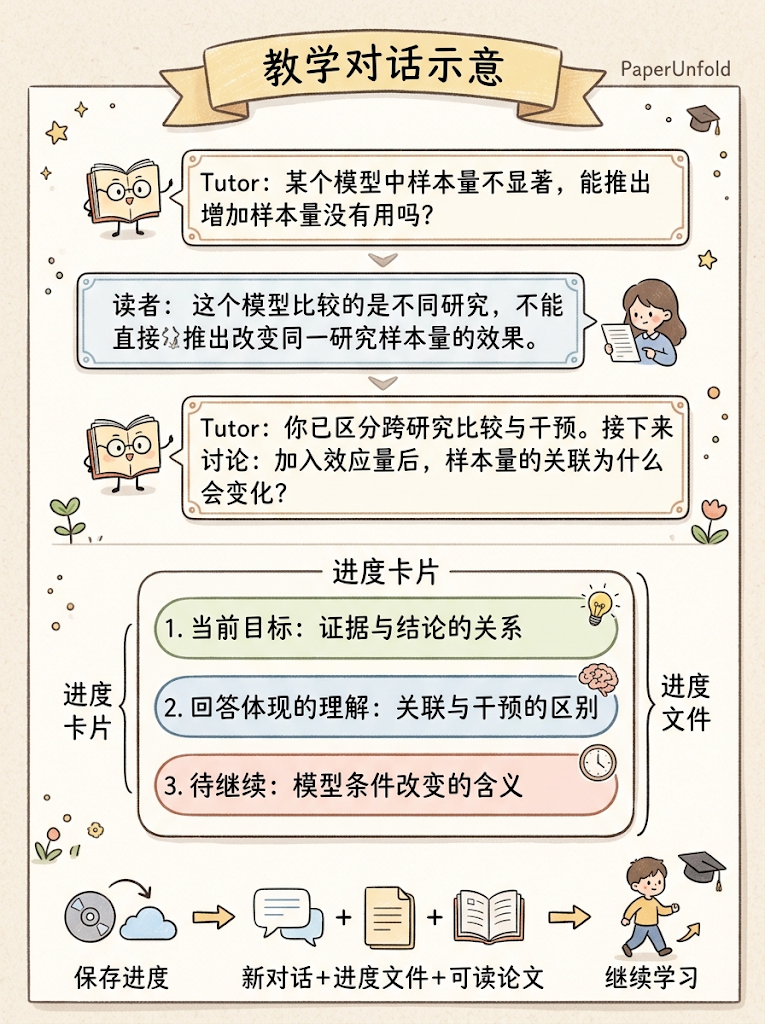
围绕一个具体推断展开讲解和反馈,再记录尚未解决的问题。对话内容为教学示意,进度文件用于继续学习,不代表掌握认证。
解释旁边,要留一条回到原文的路
AI 讲得顺畅,很容易让人忘记检查。
PaperUnfold 的导读保留原文位置和证据摘录,并说明实际读到了哪些材料、哪些内容没有覆盖。重要判断可以沿引用回到对应的证据。
为了让正文保持易读,证据默认折叠,需要核查时再展开。摘录帮助定位,判断仍应结合原文上下文。
这也是项目的一条边界:有 DOI 或摘要,不代表已经读到全文;提取了 PDF 文字,不代表核查了每张图。扫描件、复杂公式和图表仍可能需要额外检查。
保存的 HTML 导读可以离线打开和分享。继续生成讲解或进行教学,则需要你的 Agent 和相应的论文材料。
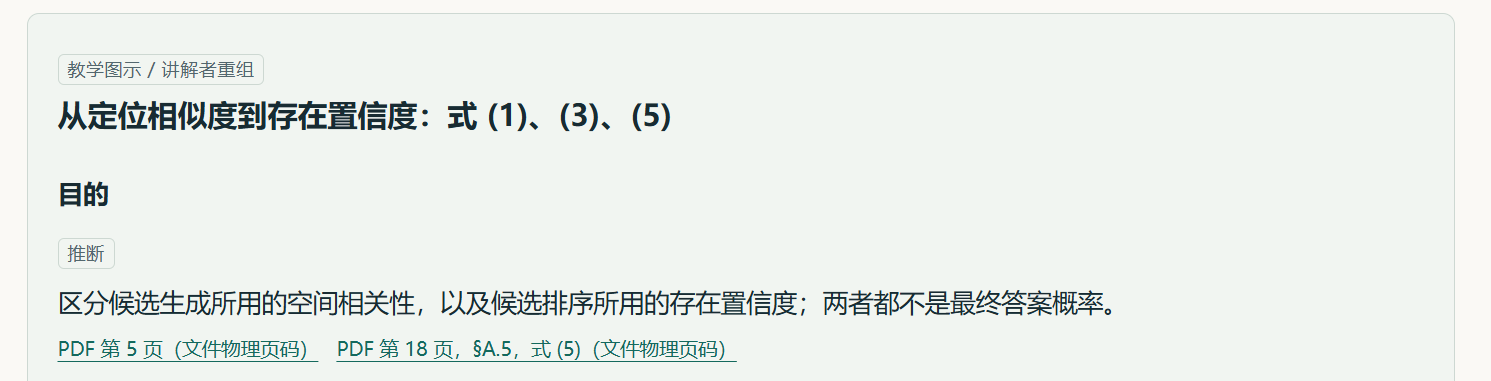
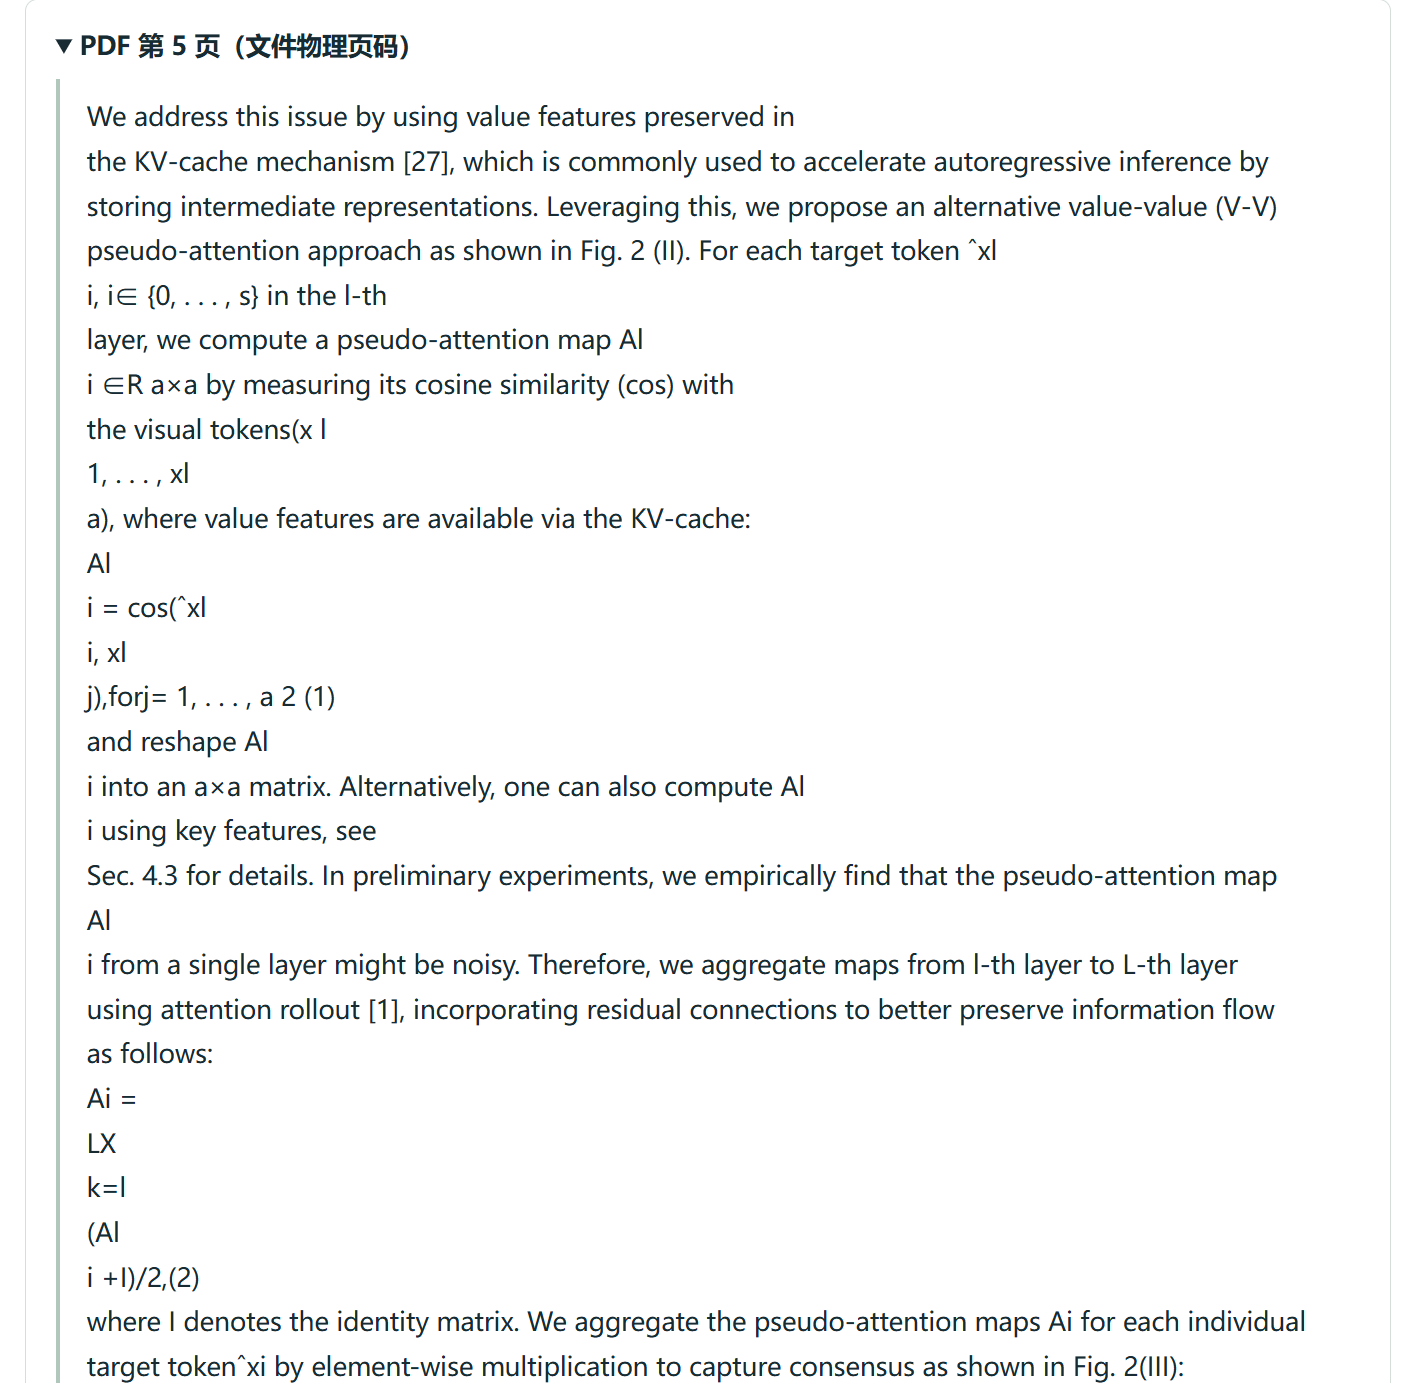
先保持正文阅读连贯,需要核查时再展开原文位置和摘录。证据入口帮助定位,不能替代对原文上下文的判断。
带一篇你正在读的论文试试
项目已经开源:Kstheme/PaperUnfold。
在目标项目目录安装两个 Skill,以 Codex 为例:
powershell
npx skills add Kstheme/PaperUnfold --skill paper-guide paper-tutor --agent codex --copy --yes如果要读取 PDF,再安装提取依赖:
powershell
python -m pip install -r .agents/skills/paper-guide/requirements.txt然后在 Agent 对话里输入:
text
读取 .agents/skills/paper-guide/SKILL.md 并按其执行。
用中文解读 inputs/paper.pdf,讲清核心机制或论证、可视化结构、关键证据和局限。
将 HTML 导读保存到 outputs/guide.html。
选中一个难点后,可以继续:
text
读取 .agents/skills/paper-tutor/SKILL.md 并按其执行。
基于 inputs/paper.pdf,帮助我理解主要证据如何支持论文结论。
每轮推进一个问题,等待我的回答后继续。
安装需要 Node.js/npm,辅助工具需要 Python 3.10+。目前已验证的是 Windows 上 Codex 桌面的显式调用;其他 Agent 和平台的兼容性还需要进一步验证。
你也可以先看仓库里的 导读示例及来源说明,感受它怎样组织机制、证据和结论。
如果觉得这个方向有用,欢迎给项目一个 Star。更欢迎带着具体论文来提 Issue:指出哪一步讲不清、哪张图缺关系、哪条证据需要核查。这些反馈会直接帮助改进阅读体验。
读论文时,最卡住你的,是公式、方法流程,还是实验结论?