MCP 从概念到落地:Java(Spring AI Alibaba)与 .NET 双栈接入实操对比
MCP(Model Context Protocol)在 2026 年的后端语境里,已经从"一个新名词"变成"存量系统要不要开一个标准化工具口子"的工程问题4。对同时持有 Java 与 .NET 存量服务的团队来说,真正困难的不是理解协议概念,而是两件事:第一,同一条协议在两套技术栈上落地形态完全不同;第二,改造范围、传输层选择、工具粒度三者的取舍会直接决定上线后的可维护性。
本文以两条真实链路为骨架:Java 侧基于 Spring AI Alibaba 1.1.2.0 自建 MCP Server 并与客户端互通,同时打通流式 SSE 对话1;.NET 9 侧把一个已有、带 Swagger 文档的 ASP.NET Core WebApi 零改造暴露为 MCP Server,并在 AI 智能体运行时动态连接远程 MCP Server,把远程工具与本地 AIFunctionFactory 注册的函数合并交给模型2。最后收敛到 Spring AI 框架级集成、轻量框架、旁路服务三条落地路径的决策矩阵3,给出存量系统的选型建议。
在进入正文前先说明证据边界:本文引用的实操记录主要来自中文技术社区的二手博文,其中 12 含具体配置片段与链路描述,3 自述"案例描述无一手出处",其数据仅作观点参考。凡涉及具体注解名、包名、SDK 签名、规范版本号,本文一律标注"需以实际 SDK / 官方规范核实",不把未经一手确认的版本号与性能数字当作事实。32 条采集来源的热度字段均为 0,因此本文不以"热度"作为论据。
一、先把概念边界划清:MCP 解决什么、不解决什么
1.1 Function Calling 与 MCP 的分工
大模型的原生能力存在边界:企业私有业务数据、内部工具、第三方接口无法被模型直接访问,行业内主流的两种方案是 Function Calling 与 MCP 协议工具调用1。两者不是替代关系,而是不同层次的机制:
- Function Calling 解决的是"这一次模型会话里,模型能不能按约定 Schema 调用一个函数"。工具定义写在调用方代码里,与具体模型、具体 Agent 绑定。
- MCP 解决的是"工具能不能被多个客户端、多次会话复用"。工具被包装成标准化服务,暴露名字、描述、参数 Schema 与调用入口,Claude Desktop、Cursor、通义灵码这类 MCP 客户端都能发现并调用同一份工具2。
这个差别在只有一个 Agent 时几乎感觉不到,一旦出现第二个客户端就立刻显现:没有 MCP 时,每个 Agent 都要为同一套内部接口写一遍适配层;有了 MCP,工具侧只维护一份 Server,客户端侧只关心端点与传输。
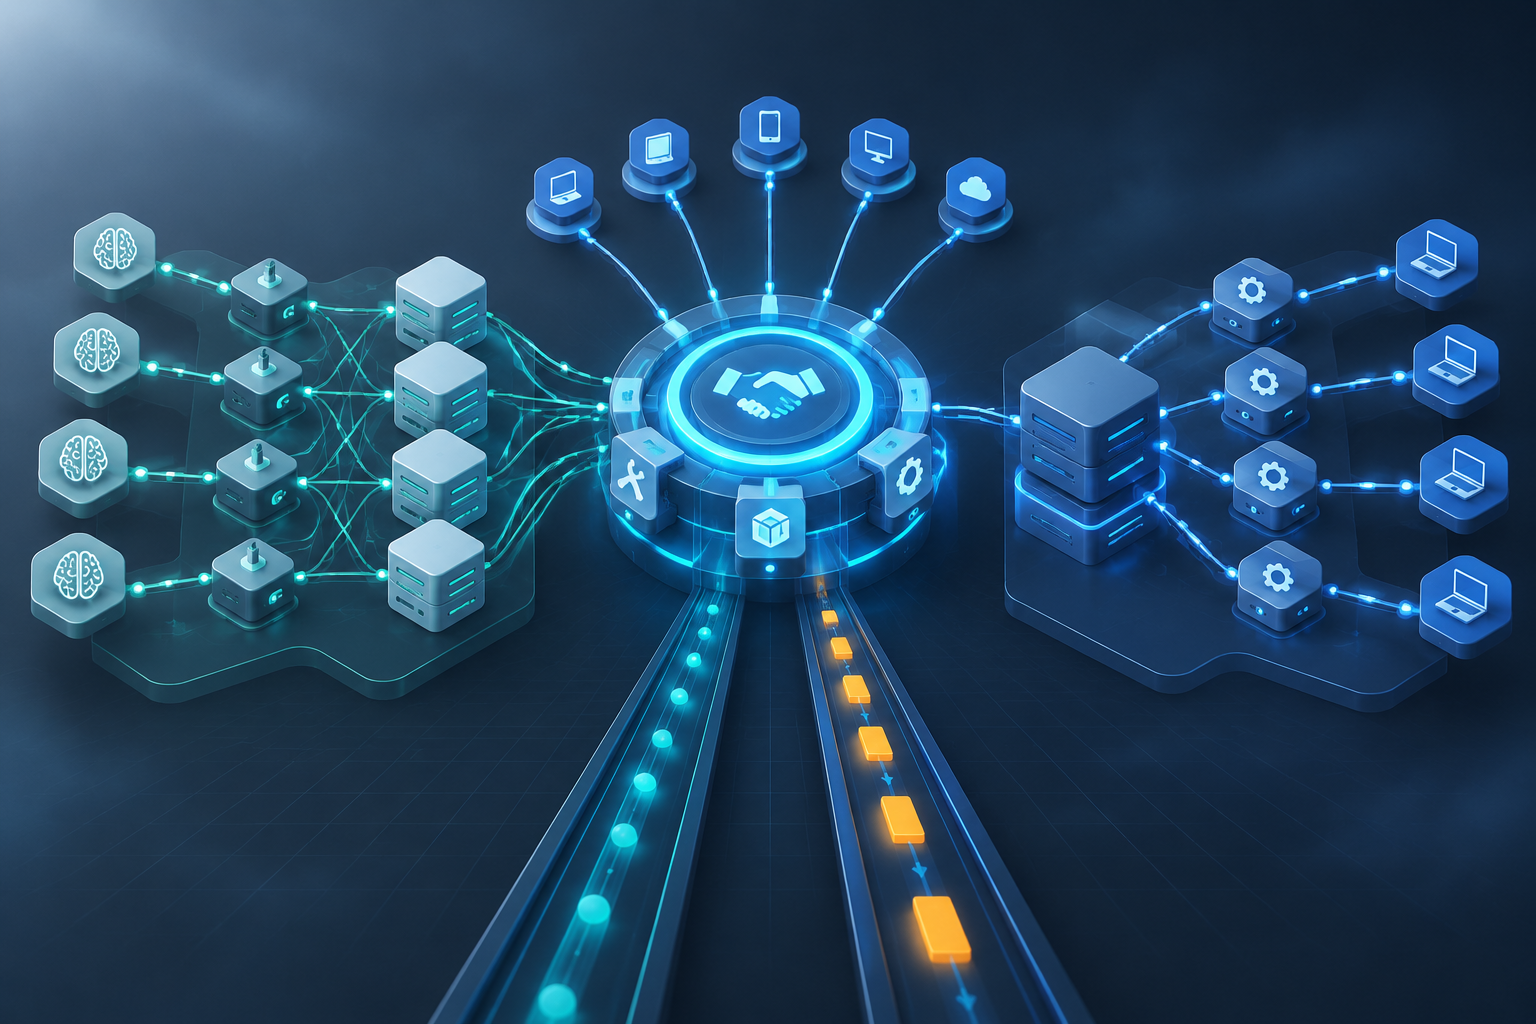
需要澄清的一点是:MCP 标准化的是"工具暴露与调用",它不负责提示词工程、不负责模型选择、也不天然解决鉴权与审计。把内部接口暴露成 MCP 工具之后,权限边界反而更需要显式设计------近期生态中已有操作系统厂商针对 AI 智能体的磁盘访问权限收紧动作,这从侧面说明"智能体可调用面"正在被当作独立的安全问题对待6。
1.2 一个最小闭环的时序
一次完整的 MCP 工具调用大致经过这些步骤:
- MCP 客户端按配置的 Transport 连接 MCP Server;
- 客户端发起工具发现请求,获取工具列表(名称、描述、参数 Schema);
- 客户端把工具清单连同用户问题交给模型;
- 模型决定调用某个工具,客户端向 MCP Server 发起调用;
- MCP Server 内部执行业务方法,或继续调用企业内部 HTTP/RPC 接口;
- 结果回传给客户端,再作为上下文交给模型生成最终回答。
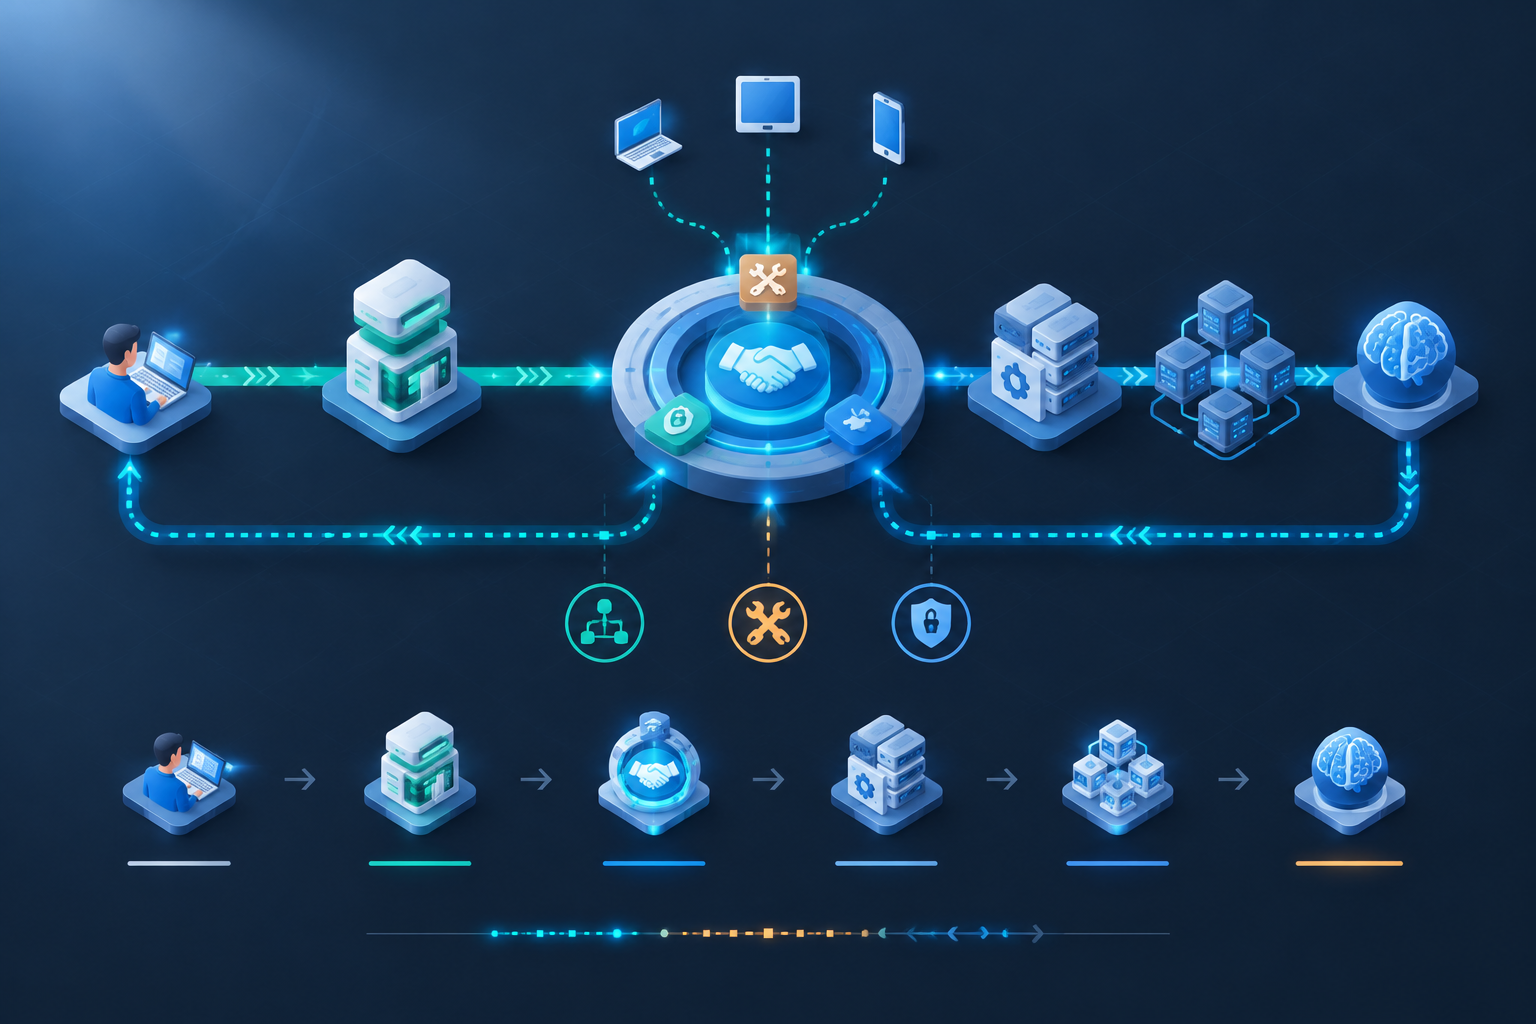
值得注意的是,第 2 步的"发现"与第 4 步的"调用"是两次独立交互,因此"服务启动成功"并不能证明链路可用,必须以"客户端列出工具 + 一次真实调用返回正确结果"作为验收口径。
二、全景图:两条链路、三个 Transport、三条路径
先区分两个维度,避免后文混淆:链路 指具体的 Java / .NET 实现路径,路径指第 7 节的架构落地方式(框架级集成、轻量框架、旁路服务)。
| 维度 | 链路 A(Java) | 链路 B(.NET 9) |
|---|---|---|
| 技术基座 | Spring AI Alibaba 1.1.2.0 | 已有 ASP.NET Core WebApi |
| 服务端形态 | 新建/改造 Spring Boot 工程,自建 MCP Server | 零改造暴露已有 WebApi 为 MCP Server |
| 客户端形态 | 自建客户端与自建 Server 互通 | 运行时动态连接远程 MCP Server,同时可被 Claude Desktop / Cursor / 通义灵码调用 |
| 工具来源 | Java 业务方法(示例为天气查询) | WebApi 接口(带 Swagger 文档)+ 本地 C# 函数 |
| 流式能力 | 有 SSE 流式对话与流式问答记录 | 素材未给出流式细节 |
| 改造成本 | 中:需引入依赖与配置 | 服务端接近零改造,客户端需接 SDK |
| 典型场景 | 内部工具服务化、Agent 调用企业能力 | 存量 API 快速接入 AI 客户端 |
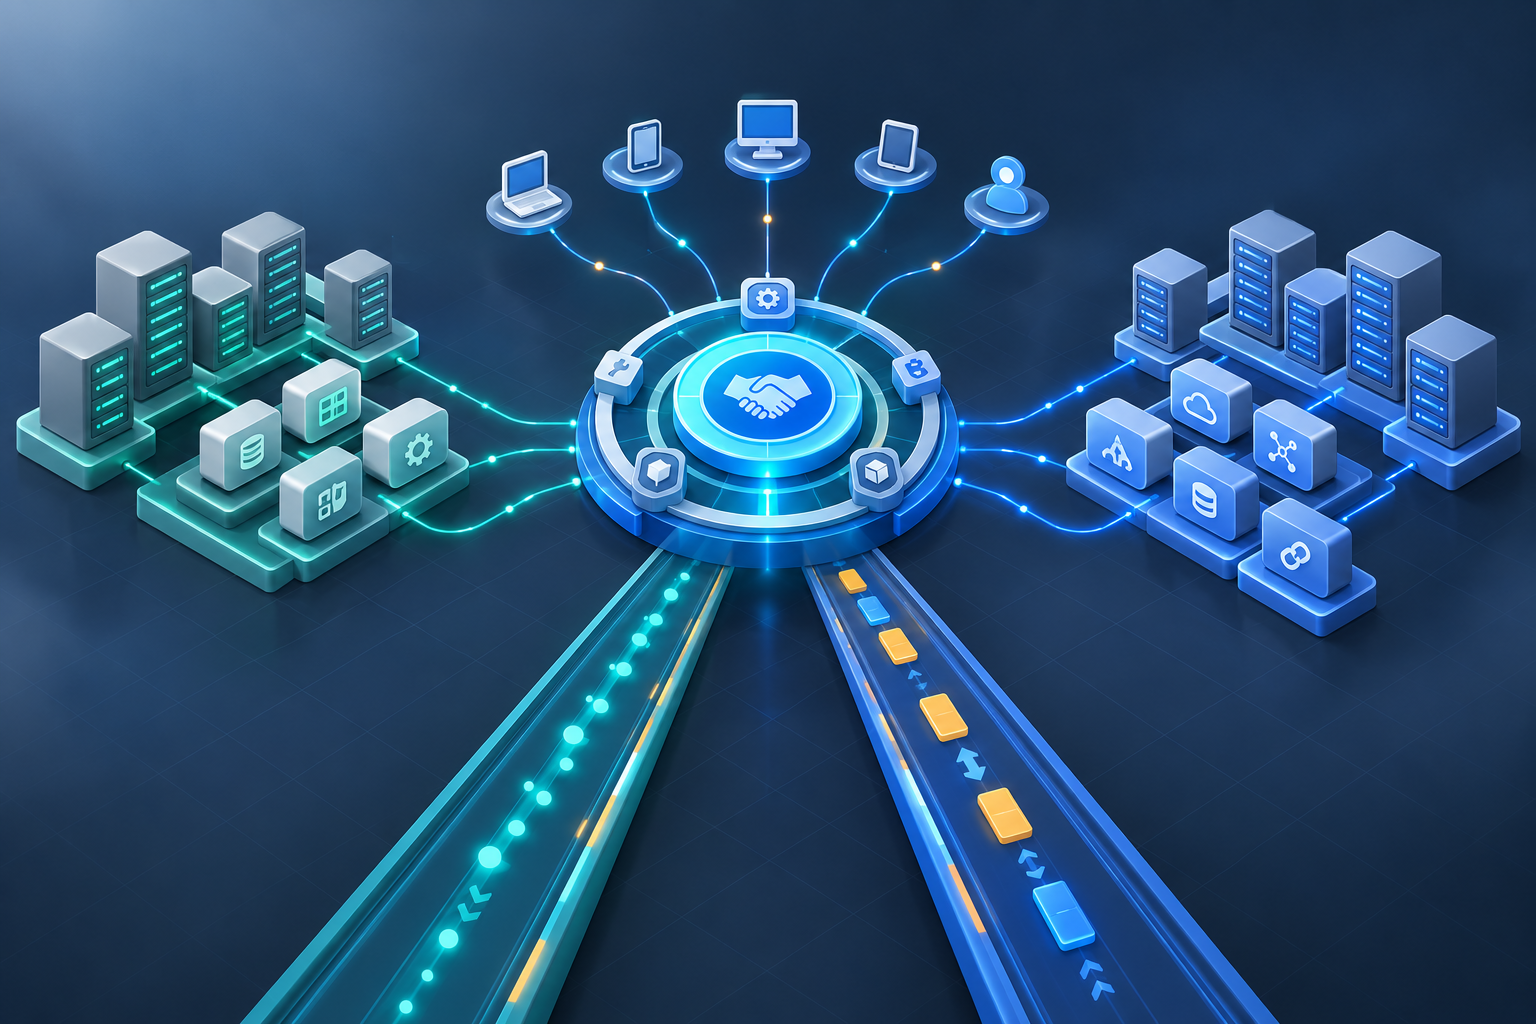
三、Java 链路:Spring AI Alibaba 1.1.2.0 自建 MCP 服务端
3.1 工程搭建与依赖清单
Java 侧的实操记录以 Spring AI Alibaba 1.1.2.0 为基座,整体是标准 Spring Boot 工程形态:一个承载 MCP Server 的应用(示例端口 8301),一个承载 ChatClient 调用的应用(示例端口 8311)1。
工程结构上的关键点是把"工具实现"与"工具暴露"分开:业务方法只负责业务,MCP 相关配置负责把它暴露出去。这样后续即使换传输方式或换客户端,业务代码不动。
关于依赖坐标,本文必须给出谨慎说明:Spring AI Alibaba 1.1.2.0 的准确 groupId/artifactId、要求的 JDK 与 Spring Boot 版本,本文所依据的实操记录没有完整给出,也未提供一手 POM 链接,因此不在此罗列未经核实的坐标。落地时请以该版本对应的官方依赖管理与 BOM 为准,并在 dependencyManagement 中统一锁定版本,避免 Spring AI 与 Spring Boot 小版本错配。
xml
<!-- 结构示意:坐标与版本以 Spring AI Alibaba 1.1.2.0 官方依赖管理为准 -->
<dependencyManagement>
    <dependencies>
        <!-- 引入 Spring AI Alibaba 1.1.2.0 对应的 BOM,锁定传递依赖版本 -->
    </dependencies>
</dependencyManagement>

<dependencies>
    <!-- Web 运行时 -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>
    <!-- MCP Server 能力:具体 artifactId 以该版本发布清单为准 -->
</dependencies>
3.2 工具注册:从业务方法到 MCP Tool
工具注册要回答三件事:方法名如何映射为工具名、参数如何映射为 JSON Schema、返回值如何序列化。以实操记录中的天气查询为例(服务名沿用 springai-mcp-server-weather)1:
java
/**
 * 天气查询工具实现。
 * 说明:以下方法签名与返回结构可直接使用;
 * "方法如何被标记为 MCP Tool" 取决于 1.1.2.0 实际提供的注解或 ToolCallback 注册入口,
 * 本文引用的实操记录未给出注解原文,落地时请以 SDK 提供的工具注册 API 为准。
 */
public class WeatherTools {

    /**
     * @param city 城市名称,映射为工具入参 schema 中的 string 字段
     * @return 天气结果对象,整体序列化为工具返回内容
     */
    public WeatherResult queryWeather(String city) {
        // 无副作用的演示实现:真实场景应在此调用内部气象服务或第三方 API
        WeatherResult result = new WeatherResult();
        result.setCity(city);
        result.setSummary("晴,适合作为工具调用演示");
        return result;
    }
}
工具注册对照表如下,落地时逐项核对 SDK 的实际映射规则:
| 工程元素 | MCP 中的含义 | 需要确认的问题 |
|---|---|---|
| 方法名 / 显式工具名 | 工具唯一标识 | 是否允许重名、是否支持版本后缀 |
| Javadoc 或注解描述 | 工具描述,影响模型选择 | 描述长度与语言是否有要求 |
| 方法参数 | 参数 Schema | 嵌套对象、集合、可选参数如何映射 |
| 返回值 | 工具调用结果 | 复杂对象是否会被序列化为 JSON 文本 |
| 抛出异常 | 调用失败 | 错误码是否会透传给客户端,堆栈是否脱敏 |
两个工程习惯值得提前定下来:其一,工具描述写"何时该用我",而不只是"我做什么",这直接决定模型在多工具场景下的选择准确率;其二,工具入参尽量自解释,避免依赖调用方才知道的隐式上下文(如"当前租户")。
3.3 MCP Server 配置与互通验证
实操记录给出的 Server 端配置形态如下1(配置键名以实际 SDK 为准):
yaml
server:
  port: 8301
spring:
  application:
    name: springai-mcp-server-weather
  ai:
    mcp:
      server:
        # MCP 服务器名称
        name: springai-mcp-server-weather
        version: 0.0.1
        # 调用模式,实操记录取值为 SYNC
        type: SYNC
客户端侧(示例端口 8311)需要开启 ChatClient 的监控日志,用于观察工具选择与调用过程1:
yaml
server:
  port: 8311
logging:
  level:
    # ChatClient 监控日志等级
    org.springframework.ai.chat.client.advisor: debug
type: SYNC 的语义需要在落地时确认:实操记录只给出了 SYNC 取值,未说明是否存在 ASYNC 分支以及各自适用场景1。按常规工程直觉推断(此为推断,非素材结论),同步模式意味着工具执行完成才返回结果,适合短耗时、无流式诉求的工具;如果工具本身是长耗时任务或需要分片返回,应确认 SDK 是否提供异步或流式工具返回形态,否则会把整个调用链的超时风险集中到一次同步调用上。
"互通"的验收建议按四步走,缺一不可:
- 启动 Server,确认 MCP 端点可访问,日志中无注册失败;
- 用客户端连接,拉取工具列表,确认工具名、描述、参数 Schema 与预期一致;
- 发起一次真实工具调用,检查入参绑定与返回结构;
- 打开客户端 debug 日志,确认模型确实选择了目标工具,而不是"模型自己编了个答案"。
其中第 4 步最容易被忽略。很多"调用失败"其实不是协议层问题,而是工具描述写得含糊,模型压根没有选择该工具,最终回答是幻觉。
3.4 流式 SSE 配置与调用
这里要先厘清一个高频混淆:SSE 流式对话与 MCP 工具调用是两件事。SSE 解决的是"模型生成的长文本如何逐字推送给前端",MCP 解决的是"模型如何调用外部工具"。它们可以出现在同一个应用里,但不是同一条链路的两个阶段。
传统接口在 AI 问答场景有明显短板:模型生成数千字需要数秒,前端长时间空白、用户以为卡死,还会遇到网关超时与熔断5。SSE 基于 HTTP 长连接由服务端持续推送,不需要 WebSocket 的握手复杂度,且是单向推送,恰好匹配"服务端产出、客户端展示"的问答形态5。这是 5 作者的选型论证,本文认可其工程逻辑,但要补充一点:SSE 的代价是连接被中间层(网关、代理、负载均衡)的空闲超时切断,生产环境必须配置心跳与超时对齐。
Spring MVC 下可以用 SseEmitter 实现一个最小可用的流式端点:
java
@RestController
@RequestMapping("/ai")
public class AiStreamController {

    /**
     * 流式问答:返回 SseEmitter,由服务端持续推送文本片段。
     * 注意:生产环境需补齐心跳、异常结束事件、客户端断连清理与超时配置。
     */
    @GetMapping(value = "/chat", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
    public SseEmitter chat(@RequestParam String prompt) {
        SseEmitter emitter = new SseEmitter(0L); // 0 表示不设该对象级超时,实际建议给上限
        // 真实实现:把大模型返回的 token 流逐条转成 emitter.send(...)
        // 结束时调用 emitter.complete(),异常时调用 emitter.completeWithError(ex)
        return emitter;
    }
}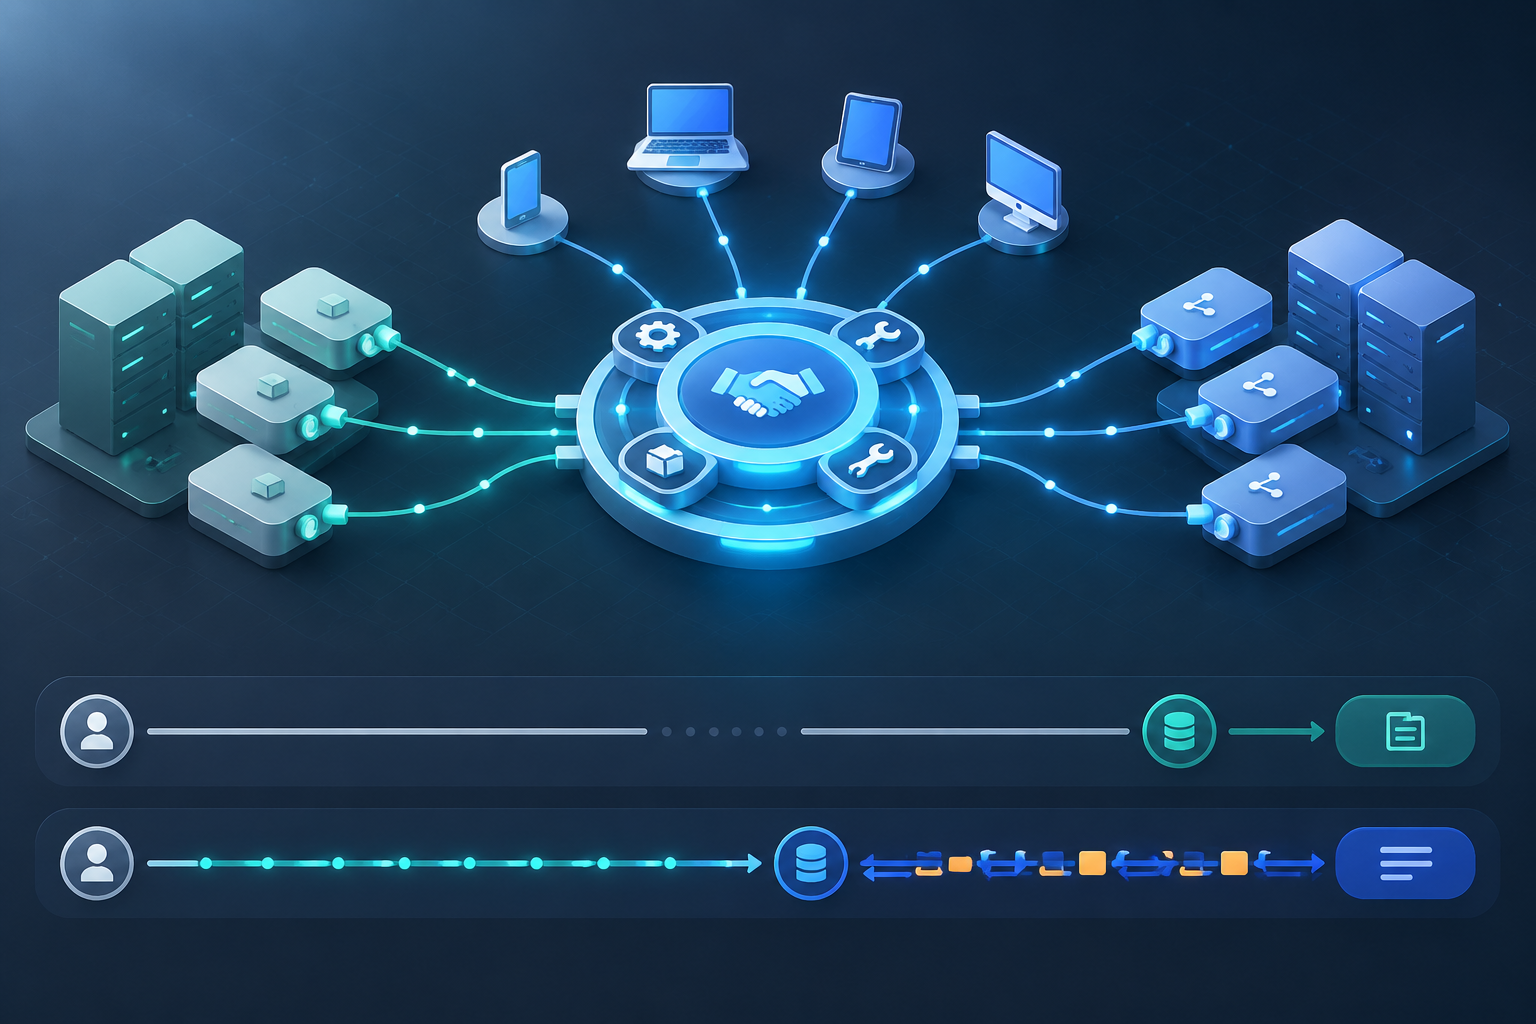
工程上需要一并配置的有:网关侧的响应超时与 SSE 长连接放行、心跳间隔小于中间层空闲超时、客户端断连时取消上游模型请求(否则会产生无谓计费)、以及失败时的可观察事件。若前端还需要双向通信(如语音场景),再考虑 WebSocket;单向流式问答用 SSE 更简单,这也是 5 的核心主张。
四、.NET 链路:把已有 WebApi 变成 MCP Server
4.1 "零改造"的边界与前提
.NET 侧实操以 NetCoreKevin 项目的真实落地为例:在 .NET 9 环境下,把一个已有、带 Swagger 文档的 ASP.NET Core WebApi 零改造变成 MCP Server,让 Claude Desktop、Cursor、通义灵码等 MCP 客户端直接调用2。
"零改造"是一个有条件的结论,边界至少包括:
- 输入是接口元数据。WebApi 本身已有 Swagger/OpenAPI 描述,工具的名称、参数与返回结构可以从文档推导。如果接口文档缺失或描述质量差,"零改造"会退化为"工具描述质量差"。
- 工具粒度等于接口粒度。一个 HTTP 接口就是一个工具,无法自动获得"把三个接口编排成一个业务动作"的语义。
- 鉴权未必自动继承 。原有接口的鉴权体系是否被 MCP Server 透传,需要显式验证,不能假设 WebApi 的
[Authorize]语义自动等价于 MCP 调用方的身份。 - Schema 质量决定调用质量。文档中参数描述模糊、类型为宽松对象的接口,模型侧的参数填充会明显变差。
改造量对比如下:
| 改造点 | 零改造方案 | 精细注册方案 |
|---|---|---|
| 接口代码 | 不动 | 可选:为工具补充描述与参数校验 |
| 工具描述 | 来自 Swagger 文档 | 手写工具描述,语义更准 |
| 参数 Schema | 由接口签名推导 | 可裁剪、可重命名、可加默认值 |
| 鉴权 | 需确认透传规则 | 可按工具粒度定义权限 |
| 工具数量 | 全量接口可能都被暴露 | 白名单控制 |
| 工作量 | 小 | 中 |
结论:零改造适合"快速验证 + 内部试点",精细注册适合"面向生产 + 面向跨团队共享"。两者的分界不是技术能力,而是工具是否需要承担业务语义。
4.2 服务端:暴露为 MCP Server 供外部客户端调用
接入后,Claude Desktop、Cursor、通义灵码等客户端可以在工具列表中看到这些接口并触发调用2。服务端接入属于配置驱动型改动:引入 MCP 服务端能力、指定端点与暴露范围,业务 Controller 不需要重写。
由于素材未给出具体 NuGet 包名与版本,本文不罗列未经核实的坐标,仅给出接入结构:
csharp
// 结构示意:NuGet 包名与版本以 .NET 9 环境下实际 MCP SDK 为准
// 关键动作:把现有 WebApi 的接口元数据(Swagger/OpenAPI)注册为 MCP 工具
var builder = WebApplication.CreateBuilder(args);

builder.Services.AddControllers();
builder.Services.AddEndpointsApiExplorer();
builder.Services.AddSwaggerGen();

// TODO: 注册 MCP Server 能力,并指定工具来源为现有 API 元数据
// builder.Services.AddMcpServer()...;

var app = builder.Build();
app.UseSwagger();
app.UseSwaggerUI();
app.MapControllers();
// TODO: 映射 MCP 端点
app.Run();
上线前建议做三件小事:第一,做工具白名单,只暴露明确需要给 Agent 的接口,避免把管理类、写入类接口全量开放;第二,把工具命名统一成"动作 + 对象"的形式,便于模型判断;第三,为每个工具准备一次成功的样例调用,作为回归基线。
4.3 客户端:运行时动态连接远程 MCP Server
客户端链路的形态是:AI 智能体运行时动态连接远程 MCP Server,把它暴露的 Tools 与本地通过 AIFunctionFactory 注册的 C# 函数一起喂给大模型2。也就是工具来源是两路合并:
text
最终交给模型的工具集 = 远程 MCP Server 的 Tools ∪ 本地 AIFunctionFactory 注册的函数
这个设计的价值在于"本地高频、远程共享"的分层:私密的、与进程内状态强相关的逻辑用本地函数;跨应用复用的、需要独立运维的能力放 MCP Server。需要注意的两个工程点:
- 命名冲突。远程工具与本地函数可能重名,合并前要建立命名规范(如远程工具加服务前缀)。
- Schema 平面化。合并后模型面对的是同一个工具清单,工具描述必须能独立表达用途,不能依赖"它是远程的"这类元信息。
AIFunctionFactory 的归属包与版本在素材中未明确给出(推断属于 Microsoft.Extensions.AI 系列,需核实),落地时请先确认其所在包与目标框架兼容性。
4.4 Transport 配置:https / sse / stdio 的表单到参数映射
实操记录中,前端配置表单的字段与后端传输参数一一对应2:
| 表单字段 | 含义 | 对应后端参数 |
|---|---|---|
| Mcp 地址 | 远程 MCP 端点 | McpUrl → Endpoint |
| Mcp 类型 | https / sse / stdio | McpType → 决定 TransportMode 或走 stdio 分支 |
| (stdio 分支) | 本地子进程启动 | StdioClientTransportOptions 中的进程与启动参数 |
结构上大致是这样(类型名以实际 SDK 为准,HttpClientTransportOptions / StdioClientTransportOptions 为素材中出现的命名):
csharp
// 结构示意,签名以实际 SDK 为准
if (string.Equals(mcpType, "stdio", StringComparison.OrdinalIgnoreCase))
{
    var stdioOptions = new StdioClientTransportOptions
    {
        // 指定本地可执行程序与命令行参数,用于拉起一个 stdio 形态的 MCP Server
        // 注意:路径必须是绝对路径或在运行进程的 PATH 中,工作目录要显式设置
    };
    // 按 stdio 分支建立连接
}
else
{
    var httpOptions = new HttpClientTransportOptions
    {
        Endpoint = new Uri(mcpUrl),   // McpUrl → Endpoint
        // McpType 为 https / sse 时映射到对应 TransportMode
    };
    // 按 HTTP/SSE 分支建立连接
}
stdio 分支的典型陷阱是子进程路径、工作目录与环境变量没有随部署环境传递,导致本地能跑、容器里启动失败。因此 stdio 配置应当被视为"部署清单的一部分",纳入 CI 校验。
五、Transport 选型:https / sse / stdio 各自的适用场景
三者的选择本质上是"工具进程与客户端进程是否在同一台机器、是否跨网络边界"的问题。
| 判据 | https / HTTP | sse | stdio |
|---|---|---|---|
| 部署形态 | 独立服务,可多实例 | 独立服务 | 本地子进程 |
| 网络边界 | 跨网可用 | 跨网可用 | 不跨网,本机 |
| 鉴权 | 可接网关/OAuth/令牌 | 同左 | 依赖进程启动环境,通常无网络鉴权 |
| 连接特征 | 请求/响应为主 | 长连接、服务端推送 | 管道读写,无网络监听 |
| 并发与扩展 | 易水平扩展 | 受长连接数与网关超时影响 | 与客户端进程同生命周期 |
| 调试 | 抓包方便 | 需看长连接与事件流 | 需看子进程日志 |
| 典型客户端 | 服务端 Agent、远程客户端 | 需要流式推送的场景 | Claude Desktop、Cursor 等桌面客户端 |
| 何时不该用 | 无 | 网关不放行长连接时 | 跨机器、跨团队共享工具时 |
选型建议可以简化成三句话:跨机器共享工具就用 HTTP 类传输;需要服务端持续推送才考虑 SSE;桌面客户端拉起本地工具进程才用 stdio。
必须补充的规范风险提示:MCP 规范对传输层的约定在演进,社区存在向 Streamable HTTP 迁移的讨论,HTTP+SSE 组合是否被标记为废弃、各 SDK 当前支持哪些传输,需要以你所用 SDK 对应的规范版本为准。本文所依据的素材没有给出 MCP 规范版本号,因此不在此断言规范现状,只强调两点工程原则:一是优先选择客户端与服务端 SDK 都明确支持的传输;二是在网关层为长连接配置超时与心跳,避免"本地联通、过网关就断"。
六、双向视角对照:Server 侧与 Client 侧的同一份心智模型
切换 Server / Client 视角时,关注点完全不同:
| 视角 | 核心问题 | Java 链路 | .NET 链路 |
|---|---|---|---|
| Server:工具来源 | 哪些能力可以被外部调用 | 业务方法注册为工具1 | WebApi 接口经 Swagger 元数据暴露2 |
| Server:注册方式 | 名称、描述、Schema 如何定义 | 注解/注册入口(以 SDK 为准) | 由接口文档推导,可转精细注册 |
| Server:暴露控制 | 谁能调、调多少 | 配置项 + 白名单(需补) | 白名单 + 鉴权透传(需补) |
| Client:连接配置 | 端点与传输如何填 | 自建客户端连接自建 Server1 | 表单字段映射到 Transport 参数2 |
| Client:工具合并 | 远程与本地工具如何共存 | 素材未展开 | 远程 Tools ∪ 本地 AIFunction2 |
| Client:调用入口 | 谁决定调用哪个工具 | ChatClient + 工具注册 | 模型按工具清单选择 |
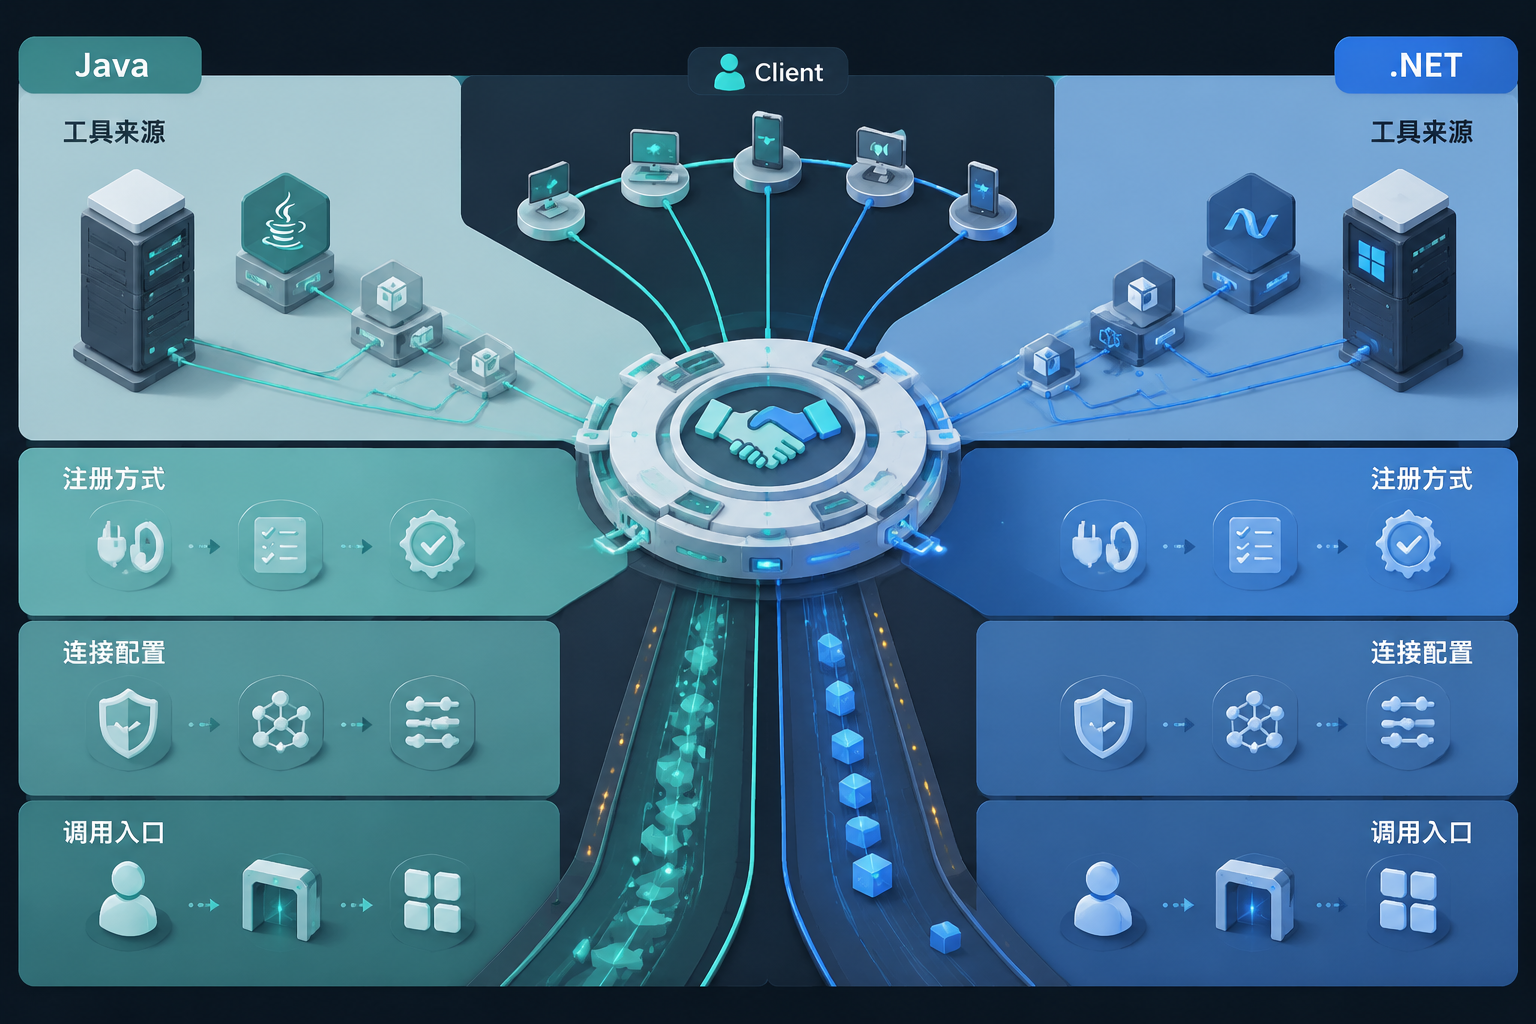
需要诚实标注证据强度:Java 链路的"自建 Server 与客户端互通"在素材中给出了配置与端口记录1;.NET 链路的两条方向(作为 Server 被外部客户端调用、作为 Client 动态连接远程 Server)在素材中均有明确描述2。但本文写作所依据的是他人实操记录,并非本文现场复现的运行日志,因此第 9 节给出的是验证清单而非"实测报告"。
七、三条落地路径的决策矩阵
7.1 路径定义
- 路径 A:Spring AI 框架级集成(Agent 内嵌)。在 Spring 应用内引入 Spring AI 能力,模型调用、工具编排、MCP 客户端都由框架承载,Agent 逻辑成为应用的一部分。
- 路径 B:轻量框架。只引入必要的模型调用与工具封装能力,不引入完整框架,尽量低侵入地接入。
- 路径 C:旁路服务。业务系统完全不动,另起一个独立服务承接 AI 能力,通过既有接口与业务系统交互。
7.2 决策矩阵
下表的判据框架来自 3,具体结论为本文基于两条实操链路的重估;3 自述其案例无一手出处,故不照搬其数值型描述。
| 判据 | 路径 A:Spring AI | 路径 B:轻量框架 | 路径 C:旁路服务 |
|---|---|---|---|
| JDK / Boot 版本要求 | 高,通常要求较新版本 | 相对宽松 | 无强制要求 |
| 对存量代码侵入 | 中 | 低到中 | 低 |
| 学习成本 | 中(需掌握框架抽象) | 低 | 中(多一个服务要运维) |
| 运维边界 | 与业务应用同进程、同发布 | 同业务应用 | 独立发布、独立扩缩容 |
| 可观测性 | 与业务日志同源,易串 trace | 依赖自建 | 需打通跨服务 trace |
| 降级与回滚 | 回滚耦合业务版本 | 回滚耦合业务版本 | 独立降级,最友好 |
| 团队规模适配 | 中大型、已有 Spring 体系 | 小团队、快速试点 | 多团队共享、存量系统多 |
| 典型风险 | 框架升级牵动业务 | 能力碎片化、重复造轮子 | 两套发布节奏、接口契约漂移 |
7.3 三个关键判据的权重
版本要求往往是一票否决项。 存量 Java 系统若卡在旧 JDK / 旧 Spring Boot,升级框架的回归成本通常远高于新增一个旁路服务。这不是技术优劣问题,而是发布风险问题。
降级友好性决定架构位置。 旁路服务天然具备"关掉它,业务照常"的属性;Agent 内嵌则意味着 AI 相关故障可能影响主链路,需要更强的超时、熔断与降级设计。这也是把 LLM 当作"后端基础设施层"时必须补的工程能力------社区已有讨论认为 AI 正在从独立问答服务变为类似数据库、消息队列的基础设施层7,但随之而来的可观测性与降级设计尚未形成统一实践。
工具共享范围决定是否独立。 如果工具只服务一个应用,Agent 内嵌最省事;如果工具要被多个客户端复用,独立 MCP Server(即链路 A 的 Server 形态或链路 B 的零改造暴露形态)才是正确抽象。
八、存量 Java / .NET 系统的接入建议
8.1 Java 存量系统分流
- 新 Boot + 新 JDK,且团队已有 Spring 体系:走路径 A,直接在应用内做 Agent 编排与 MCP 客户端接入。
- 老 Boot、无法在窗口期升级:走路径 C,另起旁路服务承接 AI 能力,通过既有 HTTP/RPC 接口访问业务系统。
- 只需把少数内部工具开放给外部 Agent:不必引 Agent 框架,直接做 MCP Server 即可(本文链路 A 的服务端部分),改造面最小。
- 工具要跨多个 Java / .NET 应用共享:独立部署 MCP Server,统一治理鉴权、审计与版本。
8.2 .NET 存量系统分流
- 已有 Swagger 文档、接口语义清晰:优先零改造路径,快速验证工具质量与模型选择准确率。
- 需要细粒度工具语义、强鉴权或工具白名单:转精细注册路径,把接口映射为显式定义的工具。
- 跨团队共享工具、需要独立发布节奏:独立 MCP Server,避免与业务应用版本耦合。
- 桌面客户端本地调用:stdio 传输,把工具进程纳入部署与日志体系。
8.3 共通的工程护栏
接入 MCP 之后,无论哪条链路,以下四项都要补齐:
- 鉴权与工具白名单:明确"谁可以调用哪些工具",写入类工具必须单独授权。
- 超时与熔断:工具调用、上游业务接口、模型调用三段都要有超时;网关侧为长连接单独配置。
- 调用审计:记录工具名、入参摘要、调用方、耗时与结果状态,敏感字段脱敏。
- 降级路径:模型或 MCP 不可用时,业务必须能退回到纯人工或纯接口链路。
九、验证清单与排查路径
本节不提供"实测故障表"------本文写作所依据的是二手实操记录,未进行现场复现,凭经验编造故障现象会误导读者。下面给出的是可执行的验证清单,以及由两条链路配置形态推导出的排查路径,均需在你的环境中自测确认。
验证清单(最小闭环)
- 服务启动无异常,MCP 端点可访问;
- 客户端能拉到工具列表,工具名与描述符合预期;
- 一次真实调用成功,入参与返回结构正确;
- 客户端日志显示模型确实选择了目标工具;
- SSE 场景下前端能持续收到分片,且网关不提前切断连接;
- 断开客户端后,服务端能释放资源、取消上游请求;
- 未授权调用被拒绝,写入类工具不能被匿名触发。
排查路径
| 现象 | 可能原因(需自测确认) | 验证方法 |
|---|---|---|
| 客户端连不上 Server | 端点/传输类型填错;网关未放行;鉴权失败 | 直连端点绕过网关测试,比对配置与 Transport 参数 |
| 连上了但工具列表为空 | 工具未注册成功;暴露范围/白名单过滤;配置键未生效 | 查看 Server 启动日志中的工具注册条目 |
| 工具存在但模型不调用 | 工具描述不清晰;参数 Schema 太复杂;工具太多 | 打开 ChatClient debug 日志,观察工具选择过程 |
| 调用报参数错误 | Schema 与方法签名不一致;嵌套对象映射异常 | 用固定 JSON 直接调用工具,绕开模型 |
| SSE 前端中途断流 | 网关空闲超时;无心跳;代理缓冲 | 调整网关超时并加心跳,关闭响应缓冲 |
| stdio 模式本地能跑、容器失败 | 子进程路径/工作目录/环境变量不一致 | 在目标环境打印进程启动命令并手动执行 |
| .NET 工具被调用但鉴权不通过 | MCP 调用身份未透传到 WebApi 鉴权体系 | 记录实际 Principal,核对鉴权中间件执行顺序 |
最后强调一个容易被低估的判断标准:MCP 落地的成败,一半取决于协议层是否跑通,另一半取决于工具描述质量、鉴权边界与降级设计。前者一两天可以验证,后者决定它能否长期留在生产环境。
参考资料
1 Spring AI Alibaba 1.1.2.0 实操完整记录:基础对话、流式 SSE、自建 MCP 服务端互通实践,掘金,2026-07-18,https://juejin.cn/post/7663374871137681444
2 让 AI 直接调你的 .NET 接口:MCP 服务端与客户端落地实战,掘金,2026-09-18,https://juejin.cn/post/7686396501736783935
3 2026 后端 AI 集成实战:Spring AI 2.0、MCP 协议与 Agent 内嵌的三条落地路径,CSDN,2026-10-01,https://blog.csdn.net/m0_74899094/article/details/166905088(二手技术文章,文中自述部分案例无一手出处,本文仅采纳其决策矩阵的判据框架)
4 收藏!2026 年 AI 后端开发终极指南:Spring AI 2.0 vs LangChain vs NestJS,生产级项目到底怎么选?,CSDN,2026-09-25,https://blog.csdn.net/weixin_44705473/article/details/163311682
5 Java 后端对接 AI 大模型 SSE 流式输出实战|实现打字机效果、实时流式问答,掘金,2026-07-23,https://juejin.cn/post/7665594166467395624
6 AI 日报(2026 年 10 月 3 日):苹果宣布将升级 macOS 完全磁盘访问权限管控以应对 AI 智能体风险,掘金,2026-10-03,https://juejin.cn/post/7692309953159757864
7 2026 云原生后端架构演进:事件驱动、虚拟线程与 AI Agent 内嵌,三驾马车如何重塑技术栈,CSDN,2026-09-25,https://blog.csdn.net/m0_53142039/article/details/163447357(与《从云原生到 AI 原生》一文框架高度相似,不作为独立交叉信源)
注:Spring AI Alibaba 1.1.2.0、Spring AI 2.0、.NET MCP SDK 的官方依赖坐标、JDK/框架版本要求、MCP 规范版本与传输层现状,本次资料中未提供一手官方链接,本文已逐处标注待核实,未作事实性断言。