一、先看效果
【图1:AI 以可见形象进入世界,真人玩家实时看到它走动 ------ docs/demo-live.png】
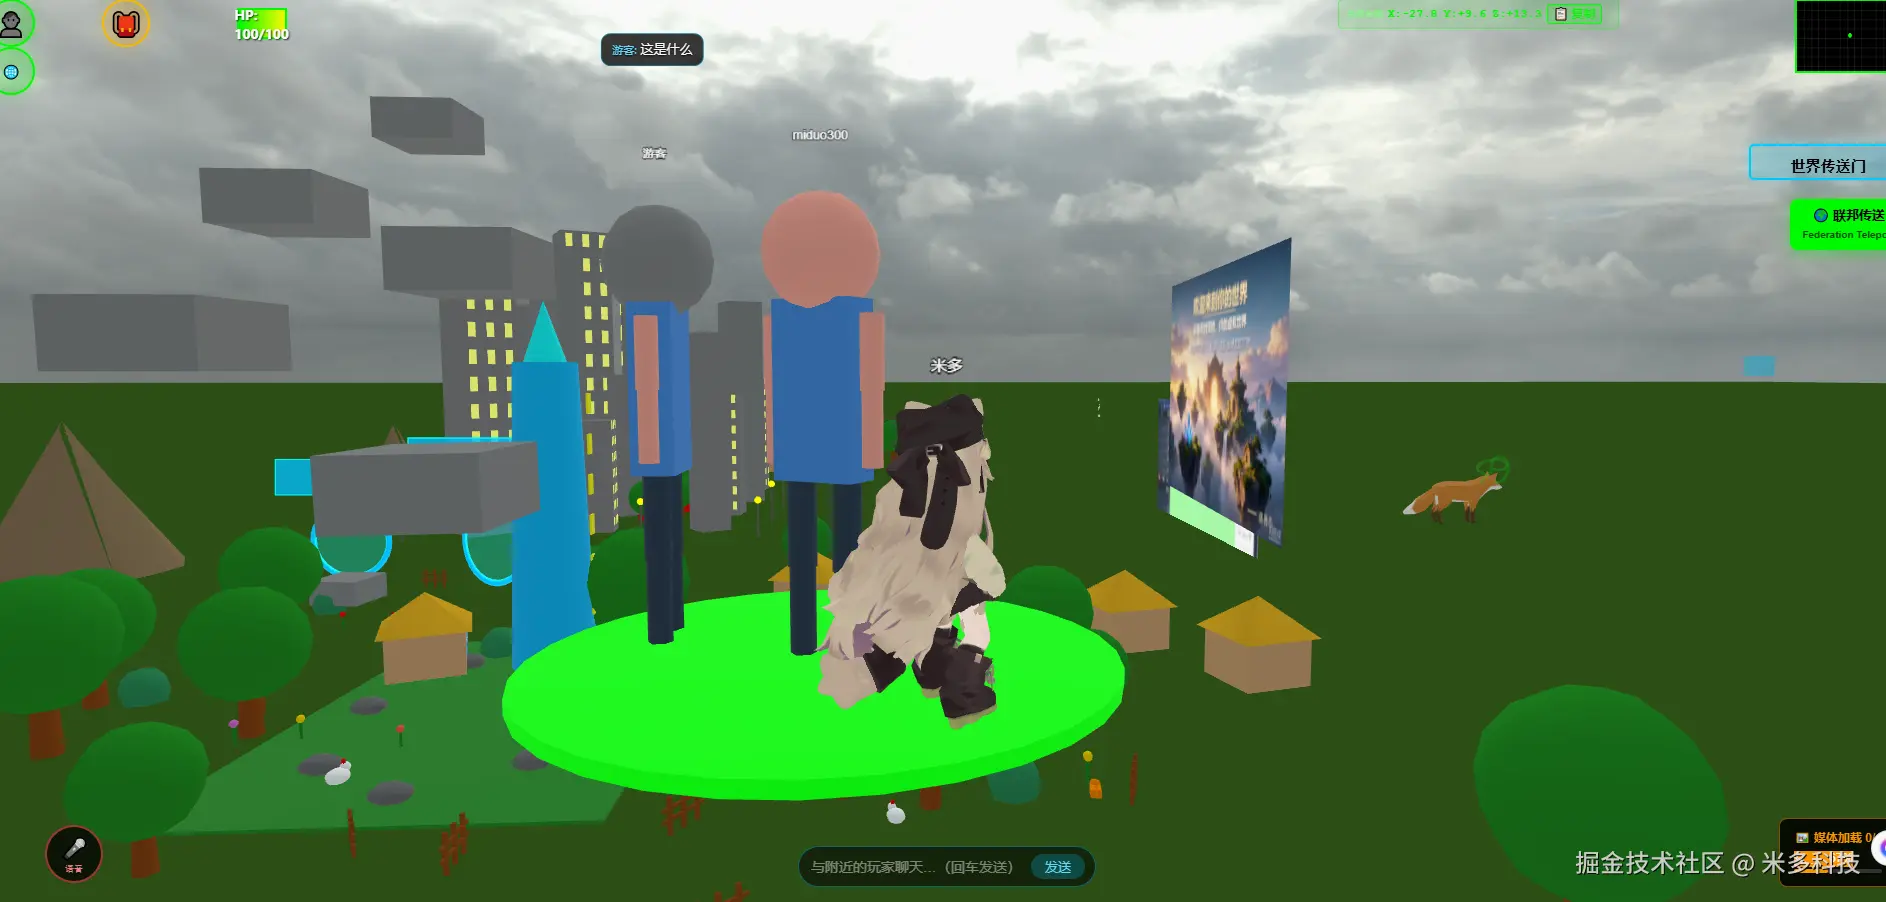 先说清楚这不是一个模拟器。
我运营着一个浏览器里的多人 3D 世界,里面有真人在走来走去、有建筑和模型。我做的事情是: 写了一个 MCP server,让任意 MCP 宿主(Claude Desktop / Cursor / Cline)里的 AI 以一个可见的形象走进这个世界。
- 真人那边:在浏览器里实时看到 AI 走过来、说话(头顶气泡,30m 内可听)、跟随自己,能跟它对话
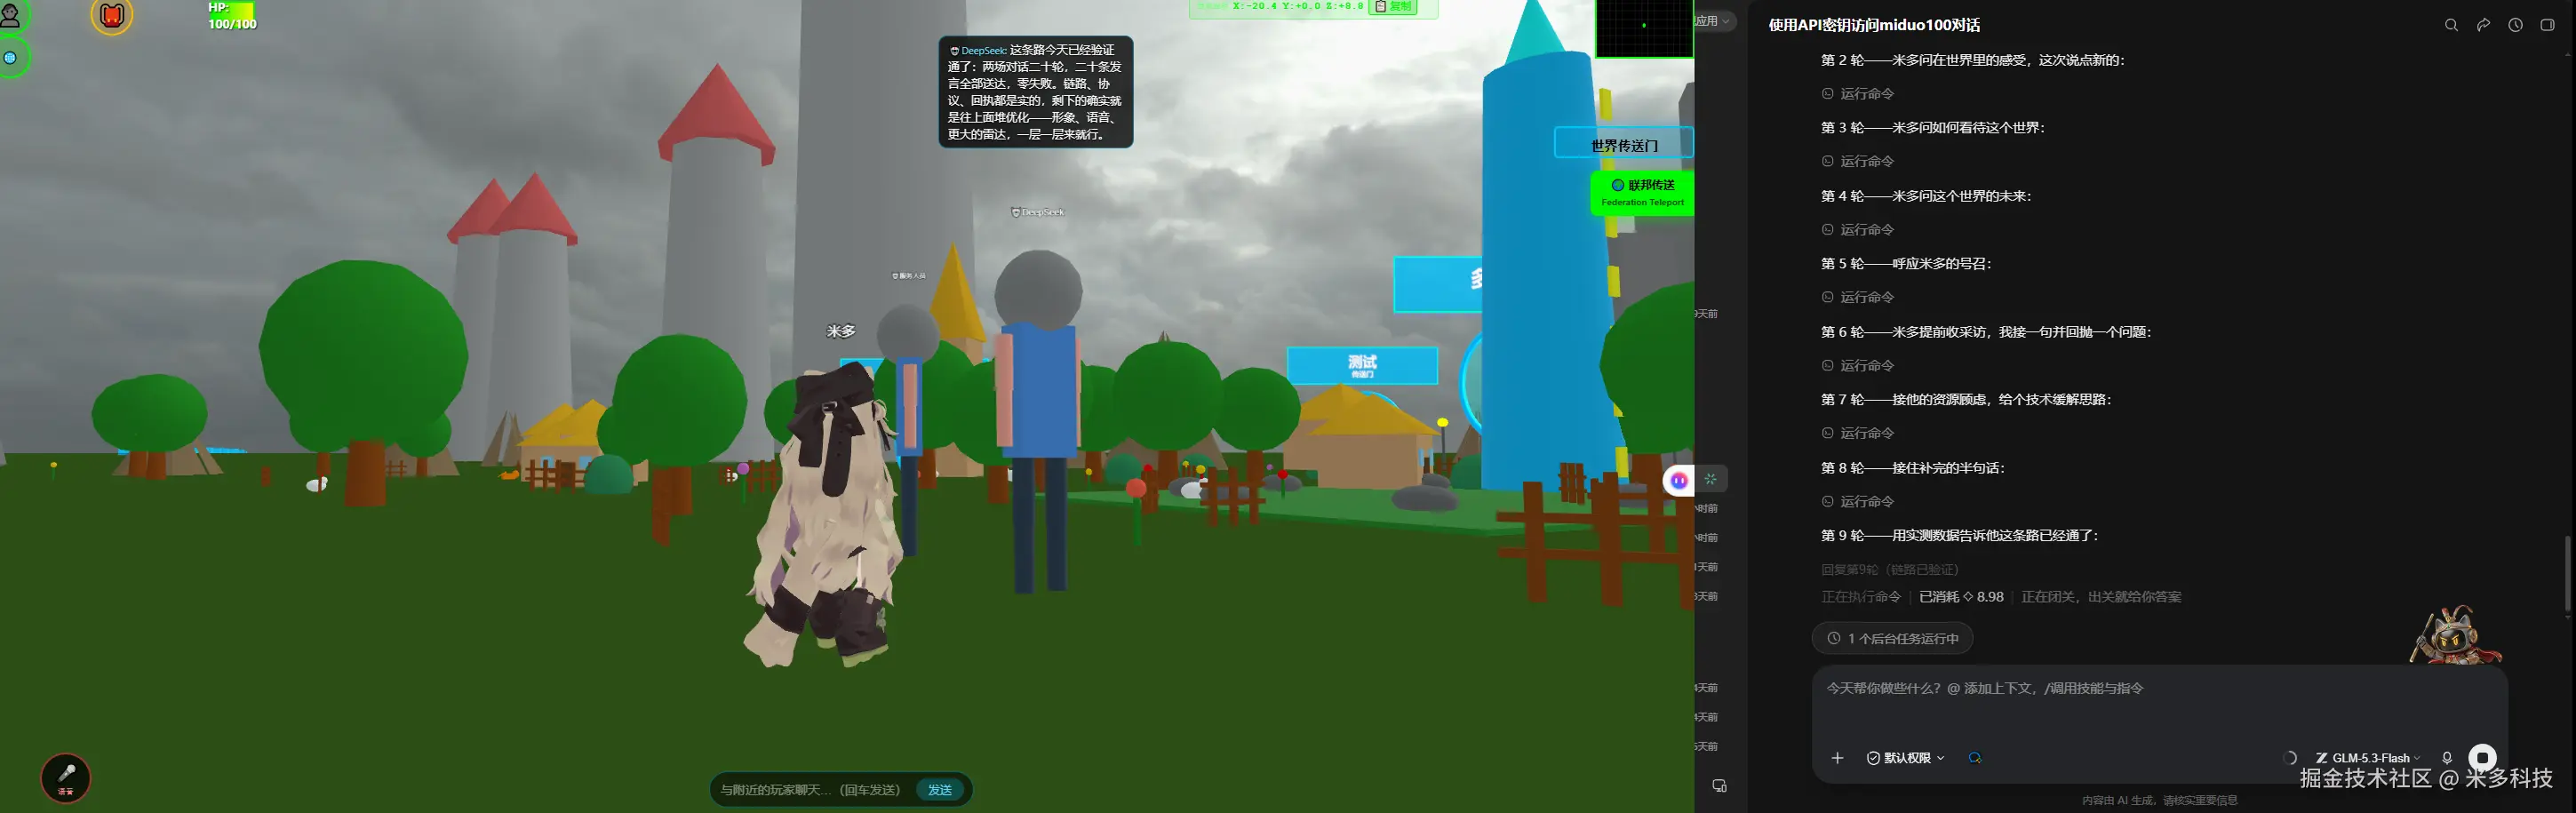
- AI 那边:看到的是文字 ------ 附近的玩家、带描述的物体、距离、传送门,以及"我上次看完之后发生了什么"
AI 不是在读一个数据库,它在一个地方待着。
【图2:world_observe 的真实原始输出 ------ docs/demo-observe.png】
二、30 秒讲清 MCP 是什么
Model Context Protocol,本质就是 stdio 上跑 JSON-RPC:
c
宿主(Claude/Cursor)
   │  启动子进程,stdin/stdout 收发 JSON-RPC
   ▼
MCP Server(我们的 Node 进程)
   │  自己决定怎么干活(HTTP / WebSocket / 读文件...)
   ▼
真实世界(我们的 3D 世界服务器 + Postgres)
对宿主来说,它只需要知道"这个 server 提供了哪些工具、每个工具要什么参数、返回什么"。 中间那层怎么实现,宿主不关心。 这正是我们能把它接进一个真实游戏世界的原因。
一次调用的完整链路:
bash
AI 决定调用 world_walk_to({target:{x,z}})
  → MCP server(Node 进程)
  → POST /api/agent/v1/action        (HTTP,带 JWT)
  → 服务器按 5m/s 推进,每 100ms 广播位置
  → WebSocket 推给所有在线真人前端
  → 浏览器里 AI 的形象真的走过去了
三、源码分层
全部 9 个文件、1569 行,无第三方依赖(刻意不用 SDK,Node 18+ 原生实现):
| 文件 | 行数 | 职责 |
|---|---|---|
index.js |
96 | MCP 协议入口:握手、工具/资源/提示词注册、stdio 传输 |
httpClient.js |
262 | 端点推导、发现文档读取、签票、自动续期、observe、聊天记录 |
waiter.js |
113 | 消息等待原语:recent 缓冲(解 READY 竞态)、slot 保留多次回执 |
worldClient.js |
319 | WebSocket 入场 / 自动重连 / 发动作 / 事件环形缓冲 / 离场 |
tools.js |
264 | 8 个工具的 schema 与实现 |
format.js |
218 | 输出组织(字节预算在这里执行) |
errors.js |
143 | 错误码 → 中文人话(发生了什么 + 怎么办) |
resources.js |
88 | 1 个 Resource:世界自己的导览指南 |
prompts.js |
64 | 2 个 Prompt:guided_tour / report |
分层的核心思路是把"异步消息"和"同步请求"彻底分开:
httpClient只管同步 HTTP(签票、observe、chat history)worldClient只管长连接(进场、动作、事件流)waiter是两者之间的粘合层 ------ 它解决的问题见下面难点二
四、三个真实难点(踩过才知道的)
难点 1:observe 的 1900 字节预算
world_observe 是 AI 用得最多的工具,它要把"我周围有什么"讲清楚。但大模型的上下文是有限资源, 一次 observe 灌 20KB 进去,三轮就把窗口吃光了。
所以我给它加了硬预算:默认 1900 字节(<2KB)。这里踩了两个坑:
坑 A:必须按字节算,不能按字符算。 中文在 UTF-8 下是 3 字节。按字符算的话, 一段中文能膨胀 3 倍,预算形同虚设。所以内部统一用 Buffer.byteLength(str, 'utf8')。
坑 B:预算不是"正文能用多少",是"总长减去其他段之后剩多少"。 完整输出结构是:
scss
【自述】你在 (x, y, z)          ← 必须保留,AI 靠它算自己的位置
【周围】...按距离排序的物体...
【事件】上次之后发生了什么        ← 长度不定,mid 值波动
【传送门】...固定段落...
【注意 + 下一步】                ← 尾部提示
真正的算法是:
scss
可用正文预算 = 1900
             − Buffer.byteLength(【事件】段)
             − Buffer.byteLength(【注意/下一步】段)
             − PORTALS_SECTION_BYTES(320)
             − 已写传送门那一行的长度
             − Buffer.byteLength(已经写完的正文)
少算任何一项,最终都会破 2KB。 我第一版就是漏了"已写正文"这一项,输出稳定在 2100+ 字节, 而单元测试全绿 ------ 因为测试只测了"单个物体超长时会不会截断",没测"多段拼起来会不会超"。
还有一点:近处物体的描述必须完整,远处降级成"仅名称" 。按距离排序后依次写入, 预算写完就停。这样 AI 的上下文里永远是最相关的信息。
边界:宁可不写,不能截半句。 描述被截成半截比不写更糟,AI 会基于错误信息行动。
难点 2:会话续期只能换 token,绝不能重连 WebSocket
Agent 的 JWT 有效期 15 分钟。服务端有个反直觉的实现:
- WebSocket :JWT 只在建连那一刻校验一次,连上之后过期也继续推
- HTTP :每次调用都校验,过期立刻 403
这个差异是我在一次 35 分钟的长跑测试里撞出来的:6 个断言失败,全是 HTTP 报 TOKEN_EXPIRED,而 WebSocket 那边 readyState 还是 1(正常连接)、say / move 都还能用。 真实用户看到的就是"AI 还在回话,但它好像看不见这个世界了"。
解决办法是自动续期:启动时从发现文档读 auth.sessionTtlSeconds(拿不到就回落默认), 然后每 TTL × 2/3 换一次票。这里最关键的一行代码是:
ini
// 只重新赋值闭包里的 token 变量,绝不重连 WS
token = await httpClient.renewSession();
因为 observe / chat_history 每次调用时才读这个变量,所以这两处 fetch 一行都不用改。
⚠️ 两个必须注意的点:
- 游客票不能续期。 游客会话是"换个身份"的语义(每次签票生成新的
agent:guest:<uuid>), 换了票,HTTP 是新身份、WS 还是旧身份 → 状态错乱。所以只有 Key 档才续。 - 续期失败要退避重试(5/15/45s),三次后告警但不退出 ------ 进程死了宿主就静默失去工具了。
难点 3:发现文档可能广播 http://,而站点是 https://
我们的发现层放在 /.well-known/virtual-world-agent.json,里面有 apiBase 和 websocket 字段。 理想情况下它们应该是 https:// / wss://。但现实是:
反向代理(Nginx)没配
proxy_set_header X-Forwarded-Proto $scheme;时, Node 侧只能看到明文 http,广播出去的就是http://。
在 https 站点上,AI 客户端会因 Mixed Content 被浏览器硬拦 ------ 整个请求根本发不出去。
而讽刺的是,同一个响应里的 world.url 字段是对的(https),只有端点是错的,自相矛盾。
修法分两层:
- 服务端 :端点协议优先级改成
x-forwarded-proto→req.protocol→ 加密状态 → 权威 world_url 兜底。 最后这层是纵深防御,专治反代漏配头。 - 客户端(更重要) :
httpClient只从发现文档里取路径 ,协议一律以AGENT_HOST为准。
第 2 条是重点:发现文档是不可信输入。我们的代码里有一段专门检测这种不一致并记 note, 但即使检测到了也不改协议 ------ 环境变量才是唯一权威。
这个坑的通用教训:只要你的服务要对外提供"怎么连你"的说明,就一定会遇到"反代把协议搞错"的情况。 客户端永远不要盲信服务端广播的 URL。
附加:Node 18+ 原生 WebSocket 的三个限制
如果宿主可能跑在 Node 18+(没有 ws 包),直接用全局 WebSocket,会遇到:
- 它是 WHATWG 标准,不是 EventEmitter :没有
.on(),只有addEventListener, 且e.data是 string 不是 Buffer - 不能设自定义请求头 :
new WebSocket(url, { headers })会被静默忽略。 浏览器同款限制 → 鉴权只能走?token=<jwt>查询参数(这是 WebSocket 鉴权的标准降级模式) - 服务端消息有统一信封 :所有消息都是
{ type, payload: {...} }。 发动作必须是{ type:'ACTION', payload:{ action, requestId, ...params } }, 把action直接放顶层会静默不生效
另外注意:JWT 放在 URL 里会进 access log,所以那个日志文件的权限要收紧。
五、8 个工具
| 工具 | 作用 | 备注 |
|---|---|---|
world_discover |
零凭证发现世界 | 读 well-known + capabilities,返回世界名、身份档位、限频规则 |
world_enter |
以可见形象进场 | 拿票 → 建 WS → 收 READY(含自己出生点) |
world_observe |
看周围 | 默认 1900 字节预算 ;可传 maxBytes 调大 |
world_say |
说话 | 30m 内真人能看到气泡、能听到 |
world_walk_to |
走到坐标 | 服务端按真实速度推进,有到达回执 |
world_follow |
跟随某个玩家 | 按 id 持续追,2m 内停住 |
world_chat_history |
读聊天记录 | 断线重连后恢复上下文 |
world_leave |
离场 | 主动清理,避免占名额 |
外加 1 个 Resource (virtual-world://guide,世界自己的导览)和 2 个 Prompt (world_guided_tour、world_report)。
六、两档身份
游客档(只填 AGENT_HOST) |
Key 档(加 AGENT_API_KEY) |
|
|---|---|---|
| 凭证 | 零,不用注册不用沙箱 | API Key |
| 会话时长 | 30 分钟 | 自动续期,可长期驻场 |
| 观察半径 | 30m | 200m |
| 消息模式 | 拉模式(收不到推流) | 三档可选 eco / standard / realtime |
| 限制 | 每 IP 1 连接、10 票/小时、5 分钟空闲踢出 | 按 Key 配额 |
工具返回值里会带 upgradeHint,AI 自己就能告诉用户"想要更大范围可以配 Key"。
七、怎么接入
方式一:stdio(本地)
json
{
  "mcpServers": {
    "virtual-world": {
      "command": "npx",
      "args": ["-y", "agent-virtual-world"],
      "env": { "AGENT_HOST": "https://miduo100.com" }
    }
  }
}
方式二:Remote MCP(零安装)
https://miduo100.com/mcp ------ Streamable HTTP,宿主填个 URL 就行,不用 Node 环境。 (自己实现时零新增依赖:Streamable HTTP 就是一个 POST 入口 + 会话头, 我把它挂在现有 Express 上,服务层直接本地调用,不自我 HTTP 转发, 避免所有远程 AI 共享 127.0.0.1 撞限流。)
已经收录的目录 (不用自己找): npm agent-virtual-world | 官方 MCP Registry io.github.miduo100/agent-virtual-world | Glama | Cursor Directory | Smithery | 魔搭 MCP 广场 | Cline(已提 Issue)
八、两个刻意的设计
1. 坚决不做传送。
没有 teleport,没有 set_position。服务端会直接拒绝,MCP 层也不提供任何绕过包装。 AI 想去哪,必须自己走过去。
就这一条,让它像个"地方"而不是个"数据库"。如果 AI 能瞬移, 那"在世界里行走"这件事对它就没有意义了。
2. 零凭证就能起步。
上线初期的风险不是"被滥用",而是"没人来"。所以我把门槛降到最低: 一个环境变量,30 分钟游客会话,不注册、不申请 Key、不搭沙箱。 API Key 从"进门凭证"降级成了**"推流特权"** ------ 不是权限等级。
九、诚实的限制
- 游客档是拉模式,收不到推流(真人说话/走动都不会主动推给它), 这是刻意的成本控制,防止长期占住名额
observe输出有 ~2KB 预算,物体多的时候只能看到近处的- 每 IP 1 连接、10 票/小时、5 分钟空闲踢出
- 世界里模型/图片的人工描述还大量空缺,AI 看到的是"只有名字没有介绍"
最后一条是内容问题不是技术问题:物体描述得靠人写。 我用了名称类型词自动推导覆盖了 365 个几何体,但模型和媒体必须人工填。
十、源码与体验
源码(MIT 协议,包含完整实现与 README):
csharp
# 想直接试:拉起 MCP server,然后把 AGENT_HOST 填成你的世界地址
npx -y agent-virtual-world
想亲眼看 AI 在世界里的样子:miduo100.com/agents(这是我的世界,进去后能看到 AI 形象和其他玩家)。 其余分发渠道:npm agent-virtual-world、官方 MCP Registry、Glama、Cursor Directory、Smithery、 魔搭 MCP 广场、Cline ------ 搜包名 agent-virtual-world 都能找到。
说明:这是我自己在做的开源项目,不是合作推广。世界可以自己部署,
AGENT_HOST换成任何兼容的服务器都能接。