第20篇:凸优化与对数障碍法
一、作用:当"约束"遇上"优化"
上一篇我们讲了贝叶斯估计------它告诉我们如何融合先验与数据。但有一个问题没有解决:
如果已知目标必须在地面上呢?如果已知目标在某个多边形区域内呢?
这类问题就是约束优化(Constrained Optimization) 。它的数学形式是:
minxf(x)s.t.gi(x)≤0,hj(x)=0\min_{\mathbf{x}} f(\mathbf{x}) \quad \text{s.t.} \quad g_i(\mathbf{x}) \leq 0, \quad h_j(\mathbf{x}) = 0xminf(x)s.t.gi(x)≤0,hj(x)=0
其中:
- f(x)f(\mathbf{x})f(x):目标函数(如定位误差);
- gi(x)g_i(\mathbf{x})gi(x):不等式约束(如"目标必须在某个区域内");
- hj(x)h_j(\mathbf{x})hj(x):等式约束(如"目标必须在某条线上")。
如果 fff 和 gig_igi 都是凸函数 ,这类问题叫凸优化。凸优化有一个极好的性质:
任何局部最优解都是全局最优解。
这意味着不用担心陷入局部极小------这是非凸优化(如神经网络训练)梦寐以求的性质。
对数障碍法(Logarithmic Barrier Method) 是求解凸优化问题的一类优雅算法。它的核心思想是:
把"硬约束"转化为"软惩罚",把有约束问题变成无约束问题。
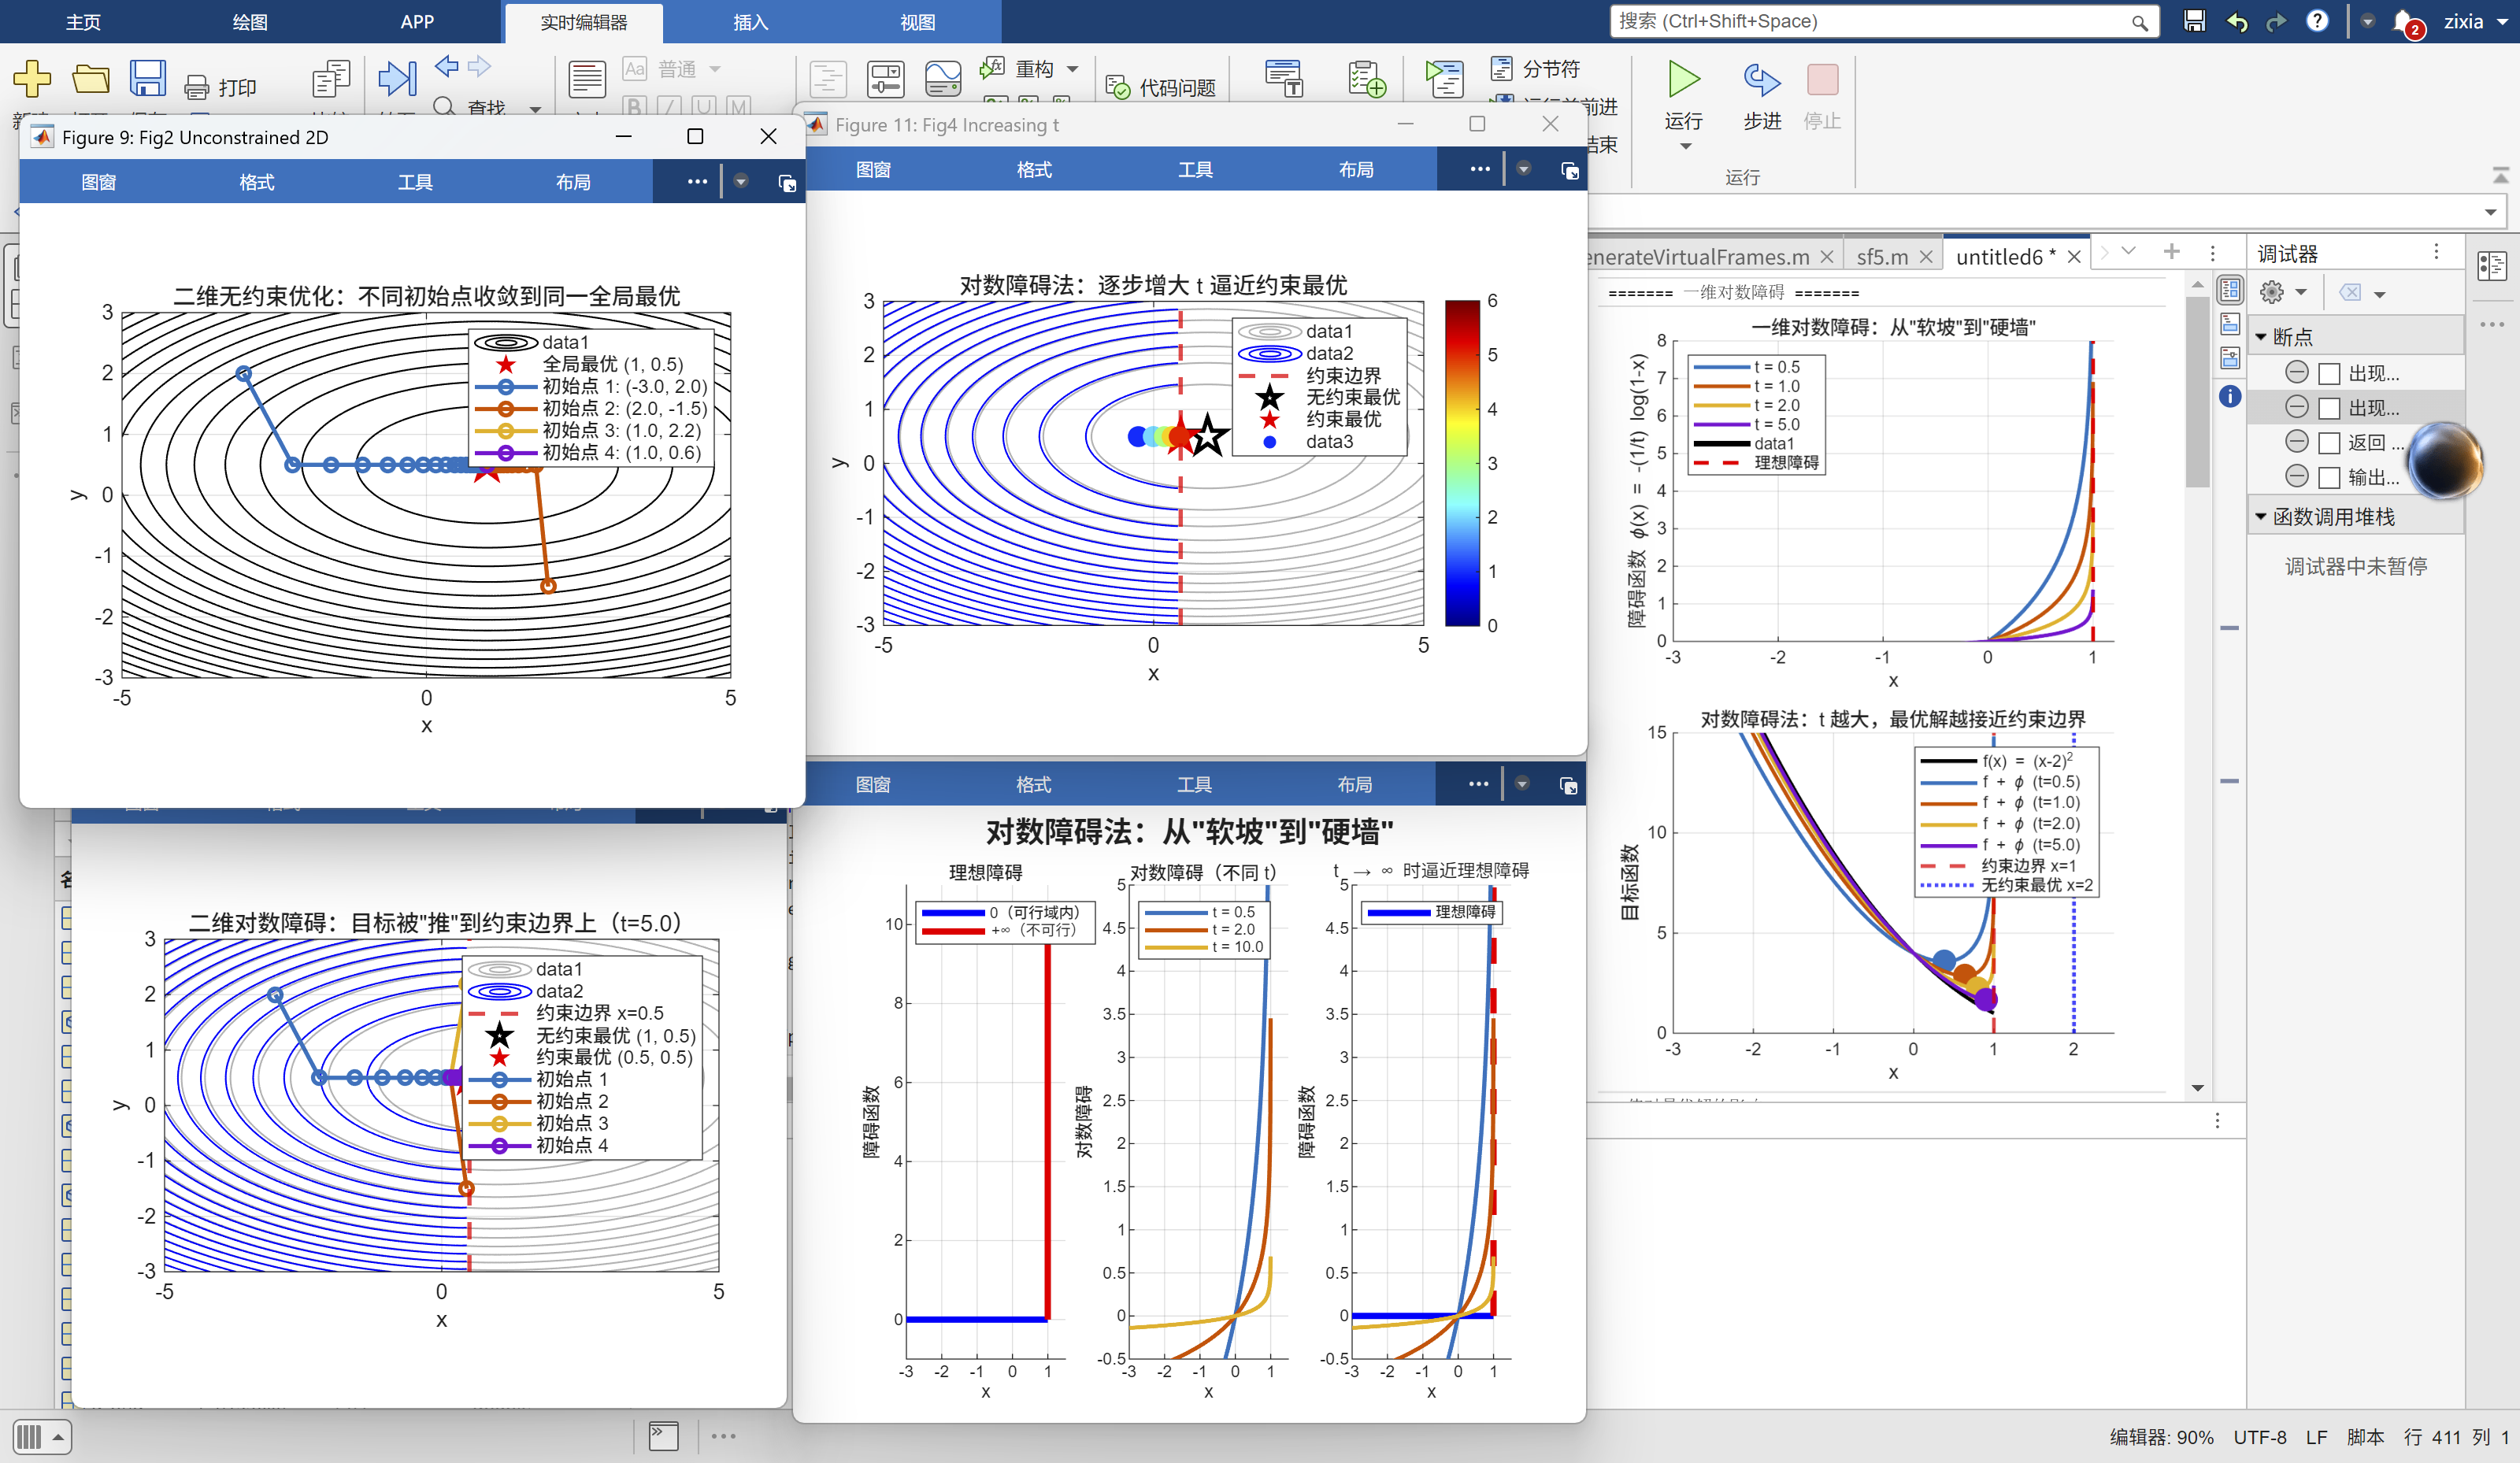
本篇核心作用 :从拉格朗日乘子法出发,推导对数障碍法的数学原理;用 MATLAB 画出一维和二维的对数障碍函数;复现原书图6.2和 book2 图5.14------展示凸优化如何从四个不同初始点收敛到同一全局最优解。
代码出处 :ch6_drawFigures(图6.2)、book2_ch5_drawFigures(图5.14)。
二、原理:数学上发生了什么?
2.1 无约束优化的"梯度下降"
先从最简单的无约束问题开始:
minxf(x)\min_{\mathbf{x}} f(\mathbf{x})xminf(x)
梯度下降迭代:
xk+1=xk−α∇f(xk)\mathbf{x}_{k+1} = \mathbf{x}_k - \alpha \nabla f(\mathbf{x}_k)xk+1=xk−α∇f(xk)
其中 α\alphaα 是步长。当 fff 是凸函数时,梯度下降保证收敛到全局最优。
2.2 等式约束:拉格朗日乘子法
考虑一个等式约束问题:
minxf(x)s.t.h(x)=0\min_{\mathbf{x}} f(\mathbf{x}) \quad \text{s.t.} \quad h(\mathbf{x}) = 0xminf(x)s.t.h(x)=0
拉格朗日函数定义为:
L(x,λ)=f(x)+λ⋅h(x)\mathcal{L}(\mathbf{x}, \lambda) = f(\mathbf{x}) + \lambda \cdot h(\mathbf{x})L(x,λ)=f(x)+λ⋅h(x)
拉格朗日乘子法 :在最优点处,L\mathcal{L}L 对 x\mathbf{x}x 和 λ\lambdaλ 的偏导都为零:
∇xL=0,∇λL=0\nabla_{\mathbf{x}} \mathcal{L} = 0, \quad \nabla_\lambda \mathcal{L} = 0∇xL=0,∇λL=0
几何直觉 :在最优点处,目标函数的梯度与约束函数的梯度平行------沿约束曲面移动不能改善目标。
2.3 不等式约束:KKT 条件
对于不等式约束:
minxf(x)s.t.g(x)≤0\min_{\mathbf{x}} f(\mathbf{x}) \quad \text{s.t.} \quad g(\mathbf{x}) \leq 0xminf(x)s.t.g(x)≤0
拉格朗日函数扩展为:
L(x,μ)=f(x)+μ⋅g(x)\mathcal{L}(\mathbf{x}, \mu) = f(\mathbf{x}) + \mu \cdot g(\mathbf{x})L(x,μ)=f(x)+μ⋅g(x)
KKT(Karush-Kuhn-Tucker)条件是最优解的必要条件:
∇xL=0(平稳性)\nabla_{\mathbf{x}} \mathcal{L} = 0 \quad \text{(平稳性)}∇xL=0(平稳性)
g(x)≤0(可行性)g(\mathbf{x}) \leq 0 \quad \text{(可行性)}g(x)≤0(可行性)
μ≥0(对偶可行性)\mu \geq 0 \quad \text{(对偶可行性)}μ≥0(对偶可行性)
μ⋅g(x)=0(互补松弛)\mu \cdot g(\mathbf{x}) = 0 \quad \text{(互补松弛)}μ⋅g(x)=0(互补松弛)
互补松弛 是最关键的一条:要么 μ=0\mu = 0μ=0(约束不活跃),要么 g(x)=0g(\mathbf{x}) = 0g(x)=0(约束在边界上活跃)。
2.4 对数障碍法:把"墙"变成"坡"
直接求解 KKT 条件在数值上很麻烦(需要处理活跃集)。对数障碍法提供了一种更优雅的方案。
核心思想 :把硬约束 g(x)≤0g(\mathbf{x}) \leq 0g(x)≤0 转化为障碍函数:
ϕ(x)=−1t∑ilog(−gi(x))\phi(\mathbf{x}) = -\frac{1}{t} \sum_{i} \log(-g_i(\mathbf{x}))ϕ(x)=−t1i∑log(−gi(x))
其中 t>0t > 0t>0 是障碍强度参数。
为什么是 log? 因为当 gi(x)→0−g_i(\mathbf{x}) \to 0^-gi(x)→0−(接近约束边界)时:
−log(−gi(x))→+∞-\log(-g_i(\mathbf{x})) \to +\infty−log(−gi(x))→+∞
这就形成了一个"无穷高的墙"------优化器永远不会越过约束边界。
障碍问题:把原问题转化为无约束问题:
minxf(x)+ϕ(x)=minxf(x)−1t∑ilog(−gi(x))\min_{\mathbf{x}} \left f(\\mathbf{x}) + \\phi(\\mathbf{x}) \\right = \min_{\mathbf{x}} \left f(\\mathbf{x}) - \\frac{1}{t} \\sum_i \\log(-g_i(\\mathbf{x})) \\rightxminf(x)+ϕ(x)=xminf(x)−t1i∑log(−gi(x))
关键性质 :当 t→∞t \to \inftyt→∞ 时,障碍问题的解收敛到原约束问题的解 。实践中,我们采用逐步增大 ttt 的策略:
t0<t1<t2<⋯→∞t_0 < t_1 < t_2 < \cdots \to \inftyt0<t1<t2<⋯→∞
每一步都从上一个解出发做牛顿迭代------热启动(Warm Start) ,收敛极快。
2.5 一维示例
考虑一个简单的一维问题:
minxf(x)=(x−2)2s.t.x≤1\min_x f(x) = (x - 2)^2 \quad \text{s.t.} \quad x \leq 1xminf(x)=(x−2)2s.t.x≤1
理想障碍:
I(x)={0x<1+∞x≥1I(x) = \begin{cases} 0 & x < 1 \\ +\infty & x \geq 1 \end{cases}I(x)={0+∞x<1x≥1
对数障碍:
ϕ(x)=−1tlog(1−x)\phi(x) = -\frac{1}{t} \log(1 - x)ϕ(x)=−t1log(1−x)
障碍后的目标函数:
F(x)=(x−2)2−1tlog(1−x)F(x) = (x - 2)^2 - \frac{1}{t} \log(1 - x)F(x)=(x−2)2−t1log(1−x)
当 t=0.5,1,2t = 0.5, 1, 2t=0.5,1,2 时,这个函数的形状会不同------ttt 越大,最优点越接近 x=1x = 1x=1。
三、完整代码(可直接运行)
matlab
%% ========================================================================
% 第20篇:凸优化与对数障碍法
% 参考出处:O'Donoughue, "Emitter Detection and Geolocation for EW",
%           ch6_drawFigures.m, Figure 6.2
%           O'Donoughue, "Practical Geolocation for EW using MATLAB",
%           book2_ch5_drawFigures.m, Figure 5.14
%           https://github.com/nodonoughue/emitter-detection-book
% ========================================================================

clear; close all; clc;
rng(2024);

%% ==================== 图1:一维对数障碍的直观 ====================

fprintf('======= 一维对数障碍 =======\n');

% 目标函数:f(x) = (x-2)^2,无约束最优 x=2
% 约束:x <= 1
% 真实约束最优:x* = 1

x_grid = linspace(-3, 0.999, 1000);

% 理想障碍
I_ideal = zeros(size(x_grid));
I_ideal(x_grid > 0) = Inf;   % 硬约束(用边界截断表示)

% 对数障碍(不同 t)
t_set = [0.5, 1, 2, 5];
n_t = numel(t_set);

figure('Name','Fig1 Barrier 1D','Position',[80 80 900 600]);
hold on;

colors = lines(n_t);
for idx = 1:n_t
    t = t_set(idx);
    phi = -1/t * log(1 - x_grid);
    phi(x_grid >= 1) = NaN;   % 定义域限制
    plot(x_grid, phi, 'Color', colors(idx,:), 'LineWidth', 2, ...
        'DisplayName', sprintf('t = %.1f', t));
end

% 理想障碍(红色虚线)
plot([0.999, 1.001], [0, 0], 'k-', 'LineWidth', 3);
plot([1, 1], [0, 10], 'r--', 'LineWidth', 2, 'DisplayName', '理想障碍');

xlabel('x'); ylabel('障碍函数 \phi(x) = -(1/t) log(1-x)');
title('一维对数障碍:从"软坡"到"硬墙"');
legend('Location', 'northwest');
grid on;
xlim([-3, 1.2]); ylim([0, 8]);

% 障碍后的目标函数
figure('Name','Fig1b Barrier Objective','Position',[100 100 900 600]);
hold on;

% 原始目标
f_orig = (x_grid - 2).^2;
plot(x_grid, f_orig, 'k-', 'LineWidth', 2, 'DisplayName', 'f(x) = (x-2)^2');

% 障碍后的目标(不同 t)
for idx = 1:n_t
    t = t_set(idx);
    phi = -1/t * log(1 - x_grid);
    phi(x_grid >= 1) = NaN;
    F_total = f_orig + phi;

    plot(x_grid, F_total, 'Color', colors(idx,:), 'LineWidth', 2, ...
        'DisplayName', sprintf('f + \\phi (t=%.1f)', t));

    % 找最小点
    [~, idx_min] = min(F_total);
    x_min = x_grid(idx_min);
    plot(x_min, F_total(idx_min), 'o', 'Color', colors(idx,:), ...
        'MarkerSize', 12, 'MarkerFaceColor', colors(idx,:), ...
        'HandleVisibility', 'off');
end

xline(1, 'r--', 'LineWidth', 2, 'DisplayName', '约束边界 x=1');
xline(2, 'b:', 'LineWidth', 2, 'DisplayName', '无约束最优 x=2');

xlabel('x'); ylabel('目标函数');
title('对数障碍法:t 越大,最优解越接近约束边界');
legend('Location', 'northeast');
grid on;
xlim([-3, 2.5]); ylim([0, 15]);

% 数值汇总
fprintf('\nt 值对最优解的影响:\n');
fprintf('%-8s %-15s\n', 't', 'x*');
fprintf('--------------------\n');
for idx = 1:n_t
    t = t_set(idx);
    phi = -1/t * log(1 - x_grid);
    phi(x_grid >= 1) = NaN;
    F_total = (x_grid - 2).^2 + phi;
    [~, idx_min] = min(F_total);
    fprintf('%-8.1f %-15.4f\n', t, x_grid(idx_min));
end

%% ==================== 图2:二维无约束优化(复现原书图6.2) ====================

fprintf('\n======= 二维无约束优化 =======\n');

% 目标函数:f(x,y) = (x-1)^2 + 5*(y-0.5)^2
% 全局最优:(1, 0.5)

f2d = @(x, y) (x - 1).^2 + 5*(y - 0.5).^2;

% 四个不同的初始点
x_init = [-3, 2.0;
           2, -1.5;
           1,  2.2;
           1,  0.6];

n_init = size(x_init, 1);

% 梯度下降
alpha = 0.1;         % 步长
max_iter = 100;
tol = 1e-6;

trajectories = cell(n_init, 1);

for i = 1:n_init
    x_curr = x_init(i, :)';
    traj = x_curr';

    for k = 1:max_iter
        % 梯度
        g = [2*(x_curr(1) - 1); 10*(x_curr(2) - 0.5)];

        % 更新
        x_new = x_curr - alpha * g;
        traj = [traj; x_new'];
        x_curr = x_new;

        if norm(g) < tol
            break;
        end
    end
    trajectories{i} = traj;
end

% 绘图
figure('Name','Fig2 Unconstrained 2D','Position',[120 120 900 700]);

% 等高线
x_range = -5:0.05:5;
y_range = -3:0.05:3;
[XX, YY] = meshgrid(x_range, y_range);
FF = f2d(XX, YY);

contour(XX, YY, FF, 20, 'k-', 'LineWidth', 0.8);
hold on;
colormap(gray);

% 真实最优
plot(1, 0.5, 'rp', 'MarkerSize', 20, 'MarkerFaceColor', 'r', ...
    'DisplayName', '全局最优 (1, 0.5)');

% 四条轨迹
colors_traj = lines(n_init);
for i = 1:n_init
    traj = trajectories{i};
    plot(traj(:,1), traj(:,2), 'o-', 'Color', colors_traj(i,:), ...
        'LineWidth', 2, 'MarkerSize', 6, ...
        'DisplayName', sprintf('初始点 %d: (%.1f, %.1f)', ...
        i, x_init(i,1), x_init(i,2)));
end

xlabel('x'); ylabel('y');
title('二维无约束优化:不同初始点收敛到同一全局最优');
legend('Location', 'northeast');
axis equal; grid on;

fprintf('\n各初始点的最终位置:\n');
for i = 1:n_init
    final = trajectories{i}(end, :);
    fprintf('  初始点 %d: (%.1f, %.1f) -> (%.4f, %.4f),迭代 %d 次\n', ...
        i, x_init(i,1), x_init(i,2), final(1), final(2), ...
        size(trajectories{i}, 1) - 1);
end

%% ==================== 图3:二维对数障碍(约束优化) ====================

fprintf('\n======= 二维对数障碍(约束优化) =======\n');

% 目标函数:与图2相同
% 约束:x <= 0.5(目标必须在左半平面)

% 障碍函数:-1/t * log(0.5 - x)
t_barrier = 5;

% 障碍后的目标
F_barrier = @(x, y) f2d(x, y) - (1/t_barrier) * log(0.5 - x);

% 梯度下降(带障碍)
x_init_2d = [-3, 2.0;
              2, -1.5;
              1,  2.2;
              1,  0.6];

trajectories_b = cell(n_init, 1);

for i = 1:n_init
    x_curr = x_init_2d(i, :)';

    % 如果初始点在约束外,先投影回来
    if x_curr(1) >= 0.5
        x_curr(1) = 0.45;
    end

    traj = x_curr';

    for k = 1:max_iter
        % 梯度(含障碍项)
        g_orig = [2*(x_curr(1) - 1); 10*(x_curr(2) - 0.5)];
        g_barrier = [(1/t_barrier) / (0.5 - x_curr(1)); 0];
        g = g_orig + g_barrier;

        % 更新
        x_new = x_curr - alpha * g;

        % 防止越界
        if x_new(1) >= 0.5
            x_new(1) = 0.4999;
        end

        traj = [traj; x_new'];
        x_curr = x_new;

        if norm(g) < tol
            break;
        end
    end
    trajectories_b{i} = traj;
end

% 约束最优:x*=0.5, y*=0.5
fprintf('约束优化真实最优: (0.5, 0.5)\n');

% 绘图
figure('Name','Fig3 Barrier 2D','Position',[140 140 900 700]);

% 绘制无障碍等高线(灰度)
contour(XX, YY, FF, 20, 'Color', [0.7, 0.7, 0.7], 'LineWidth', 0.8);
hold on;

% 绘制障碍后的等高线(彩色)
F_barrier_grid = F_barrier(XX, YY);
F_barrier_grid(XX >= 0.5) = NaN;
contour(XX, YY, F_barrier_grid, 20, 'b-', 'LineWidth', 0.8);

% 标注约束边界
xline(0.5, 'r--', 'LineWidth', 2, 'DisplayName', '约束边界 x=0.5');

% 真实最优(无约束)
plot(1, 0.5, 'kp', 'MarkerSize', 18, 'LineWidth', 2, ...
    'DisplayName', '无约束最优 (1, 0.5)');

% 约束最优
plot(0.5, 0.5, 'rp', 'MarkerSize', 20, 'MarkerFaceColor', 'r', ...
    'DisplayName', '约束最优 (0.5, 0.5)');

% 四条轨迹
colors_traj = lines(n_init);
for i = 1:n_init
    traj = trajectories_b{i};
    plot(traj(:,1), traj(:,2), 'o-', 'Color', colors_traj(i,:), ...
        'LineWidth', 2, 'MarkerSize', 6, ...
        'DisplayName', sprintf('初始点 %d', i));
end

xlabel('x'); ylabel('y');
title(sprintf('二维对数障碍:目标被"推"到约束边界上(t=%.1f)', t_barrier));
legend('Location', 'northeast');
axis equal; grid on;
xlim([-5, 5]); ylim([-3, 3]);

fprintf('\n各初始点的最终位置(约束优化):\n');
for i = 1:n_init
    final = trajectories_b{i}(end, :);
    fprintf('  初始点 %d: (%.1f, %.1f) -> (%.4f, %.4f)\n', ...
        i, x_init_2d(i,1), x_init_2d(i,2), final(1), final(2));
end

%% ==================== 图4:t 增大的效果(内点法) ====================

fprintf('\n======= 对数障碍法:逐步增大 t =======\n');

t_sequence = [0.5, 1, 2, 5, 20];
x_path = zeros(numel(t_sequence), 2);

x_curr = [-3; 2];   % 初始点

for idx = 1:numel(t_sequence)
    t = t_sequence(idx);

    for k = 1:max_iter
        g_orig = [2*(x_curr(1) - 1); 10*(x_curr(2) - 0.5)];
        g_barrier = [(1/t) / (0.5 - x_curr(1)); 0];
        g = g_orig + g_barrier;

        x_new = x_curr - alpha * g;
        if x_new(1) >= 0.5
            x_new(1) = 0.4999;
        end
        x_curr = x_new;

        if norm(g) < tol
            break;
        end
    end

    x_path(idx, :) = x_curr';
    fprintf('  t = %5.1f -> 解 (%.4f, %.4f)\n', t, x_curr(1), x_curr(2));
end

figure('Name','Fig4 Increasing t','Position',[160 160 900 700]);

contour(XX, YY, FF, 20, 'Color', [0.7, 0.7, 0.7], 'LineWidth', 0.8);
hold on;

F_bg = @(x, y) f2d(x, y) - (1/20) * log(0.5 - x);
F_bg_grid = F_bg(XX, YY);
F_bg_grid(XX >= 0.5) = NaN;
contour(XX, YY, F_bg_grid, 20, 'b-', 'LineWidth', 0.8);

xline(0.5, 'r--', 'LineWidth', 2, 'DisplayName', '约束边界');

plot(1, 0.5, 'kp', 'MarkerSize', 18, 'LineWidth', 2, 'DisplayName', '无约束最优');
plot(0.5, 0.5, 'rp', 'MarkerSize', 20, 'MarkerFaceColor', 'r', ...
    'DisplayName', '约束最优');

% 路径
for idx = 1:numel(t_sequence)
    if idx > 1
        plot([x_path(idx-1,1), x_path(idx,1)], ...
             [x_path(idx-1,2), x_path(idx,2)], 'k-', 'LineWidth', 1.5, ...
             'HandleVisibility', 'off');
    end
end

scatter(x_path(:,1), x_path(:,2), 100, 1:numel(t_sequence), 'filled');
colormap(jet);
colorbar;
clim([0, numel(t_sequence)+1]);

xlabel('x'); ylabel('y');
title('对数障碍法:逐步增大 t 逼近约束最优');
legend('Location', 'northeast');
axis equal; grid on;
xlim([-5, 5]); ylim([-3, 3]);

%% ==================== 图5:对数障碍 vs 理想障碍(一维详细对比) ====================

fprintf('\n======= 对数障碍 vs 理想障碍 =======\n');

x_grid = linspace(-3, 0.999, 500);

figure('Name','Fig5 Barrier Comparison','Position',[180 180 900 700]);

% 子图1:理想障碍
subplot(1,3,1);
hold on;
% 理想障碍
plot([-3, 1], [0, 0], 'b-', 'LineWidth', 3);
plot([1, 1], [0, 10], 'r-', 'LineWidth', 3);
plot(1, 10, 'r^', 'MarkerSize', 15, 'MarkerFaceColor', 'r');
xlabel('x'); ylabel('障碍函数');
title('理想障碍');
grid on; xlim([-3, 1.5]); ylim([-1, 11]);
legend('0(可行域内)', '+\infty(不可行)', 'Location', 'northwest');

% 子图2:不同 t 的对数障碍
subplot(1,3,2);
hold on;
t_set = [0.5, 2, 10];
colors = lines(numel(t_set));
for idx = 1:numel(t_set)
    t = t_set(idx);
    phi = -1/t * log(1 - x_grid);
    phi(x_grid >= 1) = NaN;
    plot(x_grid, phi, 'Color', colors(idx,:), 'LineWidth', 2, ...
        'DisplayName', sprintf('t = %.1f', t));
end
xlabel('x'); ylabel('对数障碍');
title('对数障碍(不同 t)');
grid on; xlim([-3, 1.5]); ylim([-0.5, 5]);
legend('Location', 'northwest');

% 子图3:t → ∞ 的极限
subplot(1,3,3);
hold on;
plot([-3, 1], [0, 0], 'b-', 'LineWidth', 3);
plot([1, 1], [0, 10], 'r--', 'LineWidth', 3);
for idx = 1:numel(t_set)
    t = t_set(idx);
    phi = -1/t * log(1 - x_grid);
    phi(x_grid >= 1) = NaN;
    plot(x_grid, phi, 'Color', colors(idx,:), 'LineWidth', 2, ...
        'HandleVisibility', 'off');
end
xlabel('x'); ylabel('障碍函数');
title('t \rightarrow \infty 时逼近理想障碍');
grid on; xlim([-3, 1.5]); ylim([-0.5, 5]);
legend('理想障碍', 'Location', 'northwest');

sgtitle('对数障碍法:从"软坡"到"硬墙"', ...
    'FontSize', 14, 'FontWeight', 'bold');

fprintf('\n======= 全部完成 =======\n');
四、代码讲解:为什么这么写?
4.1 图1:为什么 ttt 越大,最优解越接近边界?
matlab
phi = -1/t * log(1 - x_grid);物理解释 :ttt 控制"障碍的陡峭程度":
- ttt 小 → 障碍平缓,优化器可以"偷懒"远离边界;
- ttt 大 → 障碍陡峭,优化器被"挤"到边界上。
数学解释 :最优解满足 ∇f+∇ϕ=0\nabla f + \nabla \phi = 0∇f+∇ϕ=0,即:
2(x−2)+1t⋅11−x=02(x - 2) + \frac{1}{t} \cdot \frac{1}{1 - x} = 02(x−2)+t1⋅1−x1=0
当 t→∞t \to \inftyt→∞ 时,第二项 →0\to 0→0,最优解趋近于约束边界 x=1x = 1x=1。
4.2 图2:为什么无约束优化能收敛到全局最优?
matlab
g = [2*(x_curr(1) - 1); 10*(x_curr(2) - 0.5)];
x_new = x_curr - alpha * g;
关键 :f(x,y)=(x−1)2+5(y−0.5)2f(x,y) = (x-1)^2 + 5(y-0.5)^2f(x,y)=(x−1)2+5(y−0.5)2 是凸函数 (二次型,Hessian 正定)。凸函数的梯度下降保证收敛到全局最优------不管初始点在哪里。
四条轨迹的对比 :从 (−3,2)(-3, 2)(−3,2)、(2,−1.5)(2, -1.5)(2,−1.5)、(1,2.2)(1, 2.2)(1,2.2)、(1,0.6)(1, 0.6)(1,0.6) 出发,最终都收敛到 (1,0.5)(1, 0.5)(1,0.5)------这就是凸优化的魅力。
4.3 图3:二维对数障碍的"推挤"效应
matlab
g_barrier = [(1/t_barrier) / (0.5 - x_curr(1)); 0];注意 :障碍项只对 xxx 方向有梯度------因为约束是 x≤0.5x \leq 0.5x≤0.5,与 yyy 无关。
物理图像 :优化器在 xxx 方向被"推"向 x=0.5x = 0.5x=0.5,在 yyy 方向仍然自由地走向 y=0.5y = 0.5y=0.5。最终停在 (0.5,0.5)(0.5, 0.5)(0.5,0.5)------约束边界上的最优解。
4.4 图4:为什么 ttt 要逐步增大?
matlab
t_sequence = [0.5, 1, 2, 5, 20];数值原因 :如果直接从 t=∞t = \inftyt=∞(硬约束)开始,问题会变成"求解 KKT 系统"------这需要活跃集识别,数值上很麻烦。
逐步增大 ttt的策略叫内点法(Interior Point Method) :
- 先用小 ttt 求解,得到一个"还凑合"的解;
- 增大 ttt,用上一个解作为初始点(热启动);
- 重复直到 ttt 足够大,解足够接近约束边界。
优势 :每步都是无约束优化,用牛顿法或梯度下降都能快速收敛。这是现代凸优化求解器(如 CVX、MOSEK)的核心算法。
4.5 图5:对数障碍 vs 理想障碍
理想障碍 在边界处从 0 跳变 到 +∞+\infty+∞------不连续、不可导,无法用梯度方法。
对数障碍 在边界处光滑趋于 +∞+\infty+∞------连续、可导,适合梯度方法。
代价 :对数障碍允许解"稍微越界一点点"------但通过增大 ttt 可以把这点"越界"压到任意小。
五、运行结果解读
运行代码后,你将看到 5 张图:
图1:一维对数障碍
- 左图 :不同 ttt 对应的障碍函数。ttt 越大,曲线越陡------t=5t = 5t=5 时几乎和理想障碍一样陡;
- 右图 :障碍后的目标函数 f+ϕf + \phif+ϕ。可以看到最小值点随 ttt 增大向右移动 ,最终逼近 x=1x = 1x=1。
图2:二维无约束优化
四条彩色轨迹从不同初始点出发,最终都收敛到红色五角星(1, 0.5)------凸优化的全局收敛性。
图3:二维对数障碍
- 灰色等高线:原始目标函数;
- 蓝色等高线:障碍后的目标函数;
- 红色虚线 :约束边界 x=0.5x = 0.5x=0.5;
- 红色五角星 :约束最优 (0.5,0.5)(0.5, 0.5)(0.5,0.5)。
四条轨迹都被"推"到边界上------这是对数障碍法的核心特征。
图4:逐步增大 ttt
彩色圆点从深蓝(t=0.5t=0.5t=0.5)渐变到红色(t=20t=20t=20),显示解沿一条路径逐步逼近约束边界。这就是内点法的"中心路径"。
图5:对数障碍 vs 理想障碍
三张子图并排对比:
- 左:理想障碍(不可导);
- 中 :对数障碍(t=0.5,2,10t=0.5, 2, 10t=0.5,2,10);
- 右 :t→∞t \to \inftyt→∞ 时对数障碍逼近理想障碍。
六、工程实战的四条准则
| 准则 | 数学依据 | 工程做法 |
|---|---|---|
| 1. 凸问题优先 | 局部最优 = 全局最优 | 尽量把问题表述成凸优化 |
| 2. 对数障碍处理不等式 | 光滑化硬约束 | 用 -1/t * log(-g(x)) |
| 3. ttt 逐步增大 | 内点法收敛性 | t *= 2 或 t *= 10 |
| 4. 热启动加速 | 相邻问题的解接近 | 用上一个解作为下一步初值 |
七、延伸思考
7.1 与拉格朗日乘子法的关系
对数障碍法和拉格朗日乘子法是对偶的:
- 拉格朗日法 :引入乘子 μ\muμ,把约束"加入"目标;
- 障碍法:引入障碍函数,把约束"吸收"到目标。
在最优点处,两者等价:μi=1/(t⋅(−gi))\mu_i = 1/(t \cdot (-g_i))μi=1/(t⋅(−gi))。
7.2 约束优化在定位中的应用
场景一:目标必须在地面上
目标高度约束 z≥0z \geq 0z≥0:
min∥z−h(x)∥2s.t.−z≤0\min \|\mathbf{z} - \mathbf{h}(\mathbf{x})\|^2 \quad \text{s.t.} \quad -z \leq 0min∥z−h(x)∥2s.t.−z≤0
场景二:目标必须在某个多边形内
多边形约束 Ax≤bA\mathbf{x} \leq bAx≤b:
min∥z−h(x)∥2s.t.Ax≤b\min \|\mathbf{z} - \mathbf{h}(\mathbf{x})\|^2 \quad \text{s.t.} \quad A\mathbf{x} \leq bmin∥z−h(x)∥2s.t.Ax≤b
场景三:目标速度有限
速度约束 ∥v∥≤vmax\|\mathbf{v}\| \leq v_{max}∥v∥≤vmax:
min∥z−h(x)∥2s.t.∥v∥2−vmax2≤0\min \|\mathbf{z} - \mathbf{h}(\mathbf{x})\|^2 \quad \text{s.t.} \quad \|\mathbf{v}\|^2 - v_{max}^2 \leq 0min∥z−h(x)∥2s.t.∥v∥2−vmax2≤0
7.3 与后续篇章的关系
本篇讲的是静态优化 ------对一个时刻的状态做约束优化。第21篇我们将进入扩展卡尔曼滤波(EKF) ------把贝叶斯估计推广到动态系统。届时你会看到:
- 预测步:用状态方程传播先验;
- 更新步:用观测数据修正后验;
- 约束:在 EKF 中也可以用对数障碍或投影方法处理。
下一篇预告(第21篇):扩展卡尔曼滤波(EKF)与动态跟踪
静止目标的定位只是起点。当目标以 300 m/s 飞行时,你要处理的不是"一个点",而是一条轨迹 。扩展卡尔曼滤波(EKF) 是动态跟踪的标准工具:
- 状态方程 :xk+1=Fxk+wk\mathbf{x}_{k+1} = \mathbf{F}\mathbf{x}_k + \mathbf{w}_kxk+1=Fxk+wk(目标如何运动);
- 观测方程 :zk=h(xk)+vk\mathbf{z}_k = \mathbf{h}(\mathbf{x}_k) + \mathbf{v}_kzk=h(xk)+vk(我们能测到什么);
- 更新:贝叶斯公式的递归实现(先验 → 后验)。
我们将用 MATLAB 完整实现 EKF 跟踪 :从目标的匀速直线运动开始,逐步加入 AOA/TDOA 观测,画出目标轨迹与估计轨迹的对比 ,并分析 EKF 在几何退化下的稳定性。同时解析原书 book2 第7章(图7.1~7.5、7.8a/b)。敬请期待!