上下文窗口是什么
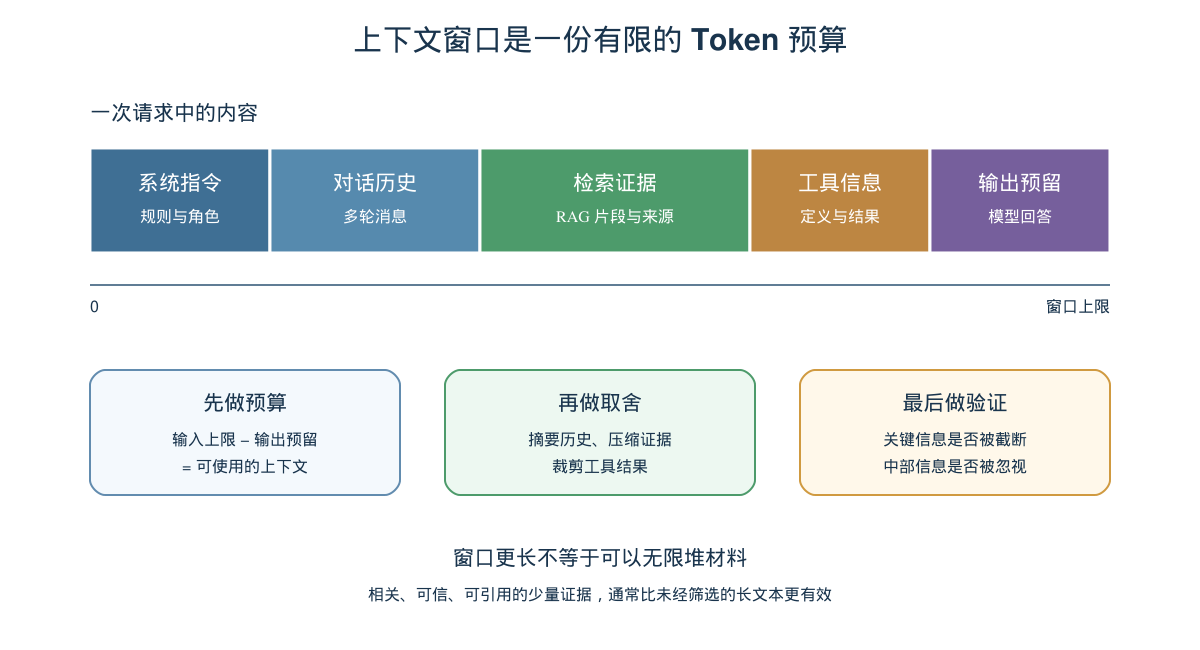
大模型每次生成回答时,只能处理有限数量的 Token。这个范围就是上下文窗口。它通常要同时容纳系统指令、用户问题、对话历史、RAG 证据、工具定义、工具结果以及模型输出。
不同 API 对输入上限、最大输出和内部推理 Token 的计算方式可能不同,使用时应查看对应模型的官方说明,不能只记住一个"总长度"数字。
Token 不是字符。一个英文单词可能由一个或多个 Token 构成,中文字符、标点、代码和空格也会按分词器规则组合。最可靠的做法是使用模型对应的 tokenizer 实际计算。
大模型并不会自动记住上一轮
多数聊天 API 的模型调用是无状态的。界面看起来像连续对话,是因为应用在每次请求时重新发送必要的历史消息:
json
{
  "messages": [
    {"role": "system", "content": "你是一名技术助手"},
    {"role": "user", "content": "我使用的是 Linux"},
    {"role": "assistant", "content": "好的。"},
    {"role": "user", "content": "怎样查看端口占用?"}
  ]
}
历史越长,占用的窗口越多,调用成本和首字延迟也可能上升。应用需要自己决定保留哪些原文、哪些消息可以总结、哪些已经与当前问题无关。
窗口里到底放了什么
一个带工具和 RAG 的智能体,请求预算可能由以下部分组成:
text
系统指令              1,200 tokens
工具定义                900 tokens
近期对话              3,000 tokens
检索证据              6,000 tokens
当前问题                200 tokens
输出预留              2,500 tokens
--------------------------------
合计                 13,800 tokens
这只是预算示例,不代表某个具体模型限制。工程上应先为输出预留空间,再计算输入还能使用多少:
python
usable_input = context_limit - reserved_output - safety_margin

if token_count(prompt_parts) > usable_input:
    prompt_parts = compress_to_budget(prompt_parts, usable_input)
若把窗口全部塞满输入,即使请求没有立刻报错,也可能没有足够空间生成完整回答。
为什么窗口不能无限增大
标准全注意力机制需要让序列中的 Token 相互计算注意力,计算量常被概括为随序列长度呈平方增长。现代模型会使用高效注意力、稀疏结构、缓存和工程优化,实际表现不完全等同于简单公式,但长输入依然需要更多计算与显存。
自回归生成时还会维护 KV Cache。它通常随序列长度、网络层数和注意力头配置增长。上下文越长,缓存越大,单请求占用资源越多,可并发的请求数量也会下降。
因此,模型标称"支持很长窗口"不等于每次都应该填满。无关内容会增加成本,还可能稀释真正重要的证据。
超出窗口会发生什么
行为取决于 API 和应用实现。有些接口直接返回长度错误;有些聊天框架会自动删除较早消息;有些系统会总结历史或截断单条内容。
自动截断如果不可见,会带来隐蔽错误:用户早先给出的关键约束被删掉,模型却继续给出看似连贯的答案。应用应显式记录裁剪策略,并尽量保留系统规则、当前问题和高优先级事实。
即使没有超限,长上下文也不保证模型能同等利用每一部分。研究和实践中常见"Lost in the Middle"现象:关键信息放在很长上下文中部时,模型可能不如处理开头或结尾的信息稳定。解决办法不是简单复制关键内容,而是减少噪声、重排证据并做好评估。
五种上下文管理方法
1. 滑动窗口
只保留最近若干轮对话,适合即时聊天。缺点是早期约束可能被遗忘,因此要把长期有效信息单独保存。
python
recent_messages = messages[-10:]2. 对话摘要
将较早对话压缩为结构化摘要,而不是保留每句话:
json
{
  "environment": "Ubuntu 24.04",
  "goal": "部署 Python Web 服务",
  "constraints": ["不能使用容器", "端口必须为 8080"],
  "resolved": ["已安装 Python 3.12"]
}
摘要也可能遗漏信息,最好保留原始历史的可追溯存储,并在关键决策前重新读取相关消息。
3. 按需检索历史
把长期对话、用户偏好或项目记录放入外部存储,只在与当前问题相关时检索。这与 RAG 的思路相同:不把全部记忆一直带在窗口里。
4. 控制工具定义与结果
智能体若一次暴露几十个工具,其 JSON Schema 就会占用大量 Token。可以先按任务路由,只提供当前需要的工具;工具返回的大表格和日志则先筛选、聚合或分页。
5. 为 RAG 证据设预算
检索不是越多越好。先召回较多候选,再通过重排、去重和压缩,留下能覆盖问题的少量证据:
python
candidates = retrieve(question, top_k=30)
ranked = rerank(question, candidates)
evidence = pack_by_token_budget(ranked, budget=5000)
若问题包含多个子任务,可以按子问题分配预算,避免一个主题占满全部空间。
长上下文会取代 RAG 吗
不会。长上下文和 RAG 解决的不是同一个问题。
长上下文提高了单次请求能阅读的材料量,适合一次性分析一份长报告、代码仓库中的若干文件或完整会议记录。RAG 则从更大的数据集合中筛选当前需要的证据,还能处理更新、权限、引用和多租户隔离。
假设知识库有一万份文档,即使模型能容纳其中几份,也没有必要把一万份全部传入。RAG 先做搜索与过滤,再利用长上下文同时阅读更多高质量候选,两者是互补关系。
text
海量知识库
   ↓ RAG:找出相关且有权限的资料
少量候选文档
   ↓ 长上下文:联合阅读、比较和归纳
最终回答
怎样设计一份可执行的预算
先确定模型限制和预期输出,再按优先级分配输入空间:
python
budget = {
    "system": 1200,
    "tools": 800,
    "history": 2500,
    "evidence": 6000,
    "question": 500,
    "output": 3000,
    "margin": 1000,
}
数字应来自实际 tokenizer 和请求分布。监控中至少记录输入 Token、输出 Token、被裁剪内容、证据数量、延迟和错误率。之后才能判断,应该增加窗口、优化检索,还是精简提示词。
小结
上下文窗口是大模型每次调用的工作区,也是必须主动管理的资源。它容纳的不只有用户文字,还包括系统指令、历史、RAG 证据、工具信息和输出预留。
可靠的做法是先做预算,再按重要性压缩和检索,最后验证关键约束有没有在长输入中丢失。更长的窗口能处理更多材料,但不能替代信息筛选;RAG 负责找到值得阅读的内容,长上下文负责把这些内容一起读好。