文章目录
- 前言
- 零、论文基本信息
- 一、背景与问题:过时记忆真的应该删除吗
-
- [1. 长期对话中的两类失败](#1. 长期对话中的两类失败)
- [2. 为什么普通 Top-k 检索不够](#2. 为什么普通 Top-k 检索不够)
- [3. 问题定义的真正变化](#3. 问题定义的真正变化)
- [二、相关工作:THEANINE 位于哪里](#二、相关工作:THEANINE 位于哪里)
-
- [1. 长期对话记忆](#1. 长期对话记忆)
- [2. 图结构记忆与时间信息](#2. 图结构记忆与时间信息)
- [3. 长期记忆评测](#3. 长期记忆评测)
- [三、THEANINE 方法总览](#三、THEANINE 方法总览)
- [四、Phase I:关系感知的记忆图构建](#四、Phase I:关系感知的记忆图构建)
-
- [1. 记忆图的定义](#1. 记忆图的定义)
- [2. Phase I-1:先找候选关联记忆](#2. Phase I-1:先找候选关联记忆)
- [3. Phase I-2:让 LLM 判断因果或主题关系](#3. Phase I-2:让 LLM 判断因果或主题关系)
- [4. 一个具体例子](#4. 一个具体例子)
- [五、Phase II:从检索锚点到记忆时间线](#五、Phase II:从检索锚点到记忆时间线)
-
- [1. 准备:Top-k 只负责找入口](#1. 准备:Top-k 只负责找入口)
- [2. Phase II-1:取回连通分量并解开时间线](#2. Phase II-1:取回连通分量并解开时间线)
- [3. Phase II-2:根据当前语境精炼时间线](#3. Phase II-2:根据当前语境精炼时间线)
- [六、Phase III:时间线增强的回复生成](#六、Phase III:时间线增强的回复生成)
- 七、TeaFarm:用反事实问题压力测试长期记忆
-
- [1. 为什么需要新的评测](#1. 为什么需要新的评测)
- [2. 六步评测流程](#2. 六步评测流程)
- [3. TeaFarm 测到了什么,没测到什么](#3. TeaFarm 测到了什么,没测到什么)
- 八、实验设置
-
- [1. 数据集](#1. 数据集)
- [2. 基线](#2. 基线)
- [3. 模型与超参数](#3. 模型与超参数)
- 九、主实验:时间线是否真正改善回复
-
- [1. 自动评测](#1. 自动评测)
- [2. 检索准确率与有用性](#2. 检索准确率与有用性)
- [3. 回复与历史的一致性](#3. 回复与历史的一致性)
- 十、消融实验:真正起作用的是什么
-
- [1. 关系感知链接是最重要模块](#1. 关系感知链接是最重要模块)
- [2. "完整时间线"优于同样内容的随机片段](#2. “完整时间线”优于同样内容的随机片段)
- [3. 时间线精炼的贡献有限](#3. 时间线精炼的贡献有限)
- [十一、TeaFarm 结果:所有系统都远未过关](#十一、TeaFarm 结果:所有系统都远未过关)
- 十二、效率分析:性能更好,但并不便宜
- 十三、失败案例:图找到了事实,模型仍可能答错
-
- [1. 话题突变导致错误锚点](#1. 话题突变导致错误锚点)
- [2. 检索正确但生成阶段利用失败](#2. 检索正确但生成阶段利用失败)
- [十四、与 Agent Memory 系列方法的横向比较](#十四、与 Agent Memory 系列方法的横向比较)
- [十五、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十五、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:保留决策演化,而不是只保留最新代码状态](#1. Coding Agent:保留决策演化,而不是只保留最新代码状态)
- [2. Tool Agent:让工具调用记录形成状态迁移链](#2. Tool Agent:让工具调用记录形成状态迁移链)
- [3. Multi-Agent:保存观点如何收敛](#3. Multi-Agent:保存观点如何收敛)
- [4. 应增加的工程机制](#4. 应增加的工程机制)
- 十六、局限性
-
- [1. "Lifelong" 只在五个会话上验证](#1. “Lifelong” 只在五个会话上验证)
- [2. 永不删除会带来存储、噪声与隐私问题](#2. 永不删除会带来存储、噪声与隐私问题)
- [3. 关系判断依赖 LLM,错误会沿时间线传播](#3. 关系判断依赖 LLM,错误会沿时间线传播)
- [4. 初始召回仍受向量检索限制](#4. 初始召回仍受向量检索限制)
- [5. 精炼与生成都可能忽略正确证据](#5. 精炼与生成都可能忽略正确证据)
- [6. 评测范围与基线仍有限](#6. 评测范围与基线仍有限)
- [7. API 与隐私风险](#7. API 与隐私风险)
- 十七、我的理解与启发
-
- [1. THEANINE 最有价值的不是图,而是重新定义"过时"](#1. THEANINE 最有价值的不是图,而是重新定义“过时”)
- [2. 记忆系统需要同时表示 state 与 transition](#2. 记忆系统需要同时表示 state 与 transition)
- [3. 检索单位比检索模型更重要](#3. 检索单位比检索模型更重要)
- [4. 召回正确不等于生成可靠](#4. 召回正确不等于生成可靠)
- [5. 永不删除不是终点,结构化遗忘才是](#5. 永不删除不是终点,结构化遗忘才是)
- 十八、总结
- 参考资料
前言
在长期交互里,"记住更多"并不等于"更懂用户"。
假设用户早期说自己害怕坐邮轮,后来开始学游泳,再后来已经准备参加邮轮旅行。如果记忆系统只保留最新状态,它会知道用户"准备旅行",却失去了这次变化为何重要;如果系统把全部历史一股脑塞进上下文,模型又可能只盯着最近一句话,忽略真正决定回复含义的早期经历。
这恰好暴露了 Agent Memory 的一个长期矛盾:旧信息可能已经不再描述用户当前状态,却仍然是解释状态变化的关键证据。
此前很多工作把重点放在记忆写入、压缩、检索与更新上。A-MEM 强调自主组织记忆,MAGMA 强调多图结构,CoM 关注记忆压缩,ReMemR1 让 Agent 在写记忆时回看历史,Mem²Evolve 则把重点放到记忆系统的持续演化。THEANINE 选择了一个更具体、也很容易被忽视的切口:过时记忆到底应该被删除,还是应该被重新组织?
本文给出的答案是后者。
THEANINE 的唯一核心增量,是不再把过时记忆视为应删除的噪声,而是用时间与因果关系将新旧记忆组织成可检索的事件时间线,使 Agent 能够利用"用户如何变化"来生成回复。
围绕这一主线,论文设计了关系感知的记忆图、时间线检索与上下文感知的时间线精炼。论文还提出 TeaFarm,用反事实问题检查 Agent 是否真的记得过去。这是重要的评测贡献,但它服务于验证主线,不应与"时间线记忆管理"并列为两个核心机制。
零、论文基本信息
- 论文名称:Towards Lifelong Dialogue Agents via Timeline-based Memory Management
- 发表平台:NAACL 2025 Long Papers
- 代码仓库 :THEANINE 补充演示与 TeaFarm 数据
- 作者:Kai Tzu-iunn Ong、Namyoung Kim、Minju Gwak、Hyungjoo Chae、Taeyoon Kwon、Yohan Jo、Seung-won Hwang、Dongha Lee、Jinyoung Yeo
一、背景与问题:过时记忆真的应该删除吗
1. 长期对话中的两类失败
长期对话 Agent 通常会把每轮对话压缩成若干记忆,在后续会话中检索相关记忆辅助回复。随着会话持续,记忆数量不断增长,系统常用"更新、覆盖、删除"来控制规模。
问题在于,状态更新和信息删除不是同一件事。
"用户现在不怕水"可以替代"用户现在怕水"作为当前状态,却不能抹去"用户过去怕水"这一历史事实。前者用于描述现在,后者用于解释变化。删除旧状态,相当于只保留结果而丢掉过程。
论文在 Figure 1 中展示了两类典型失败:
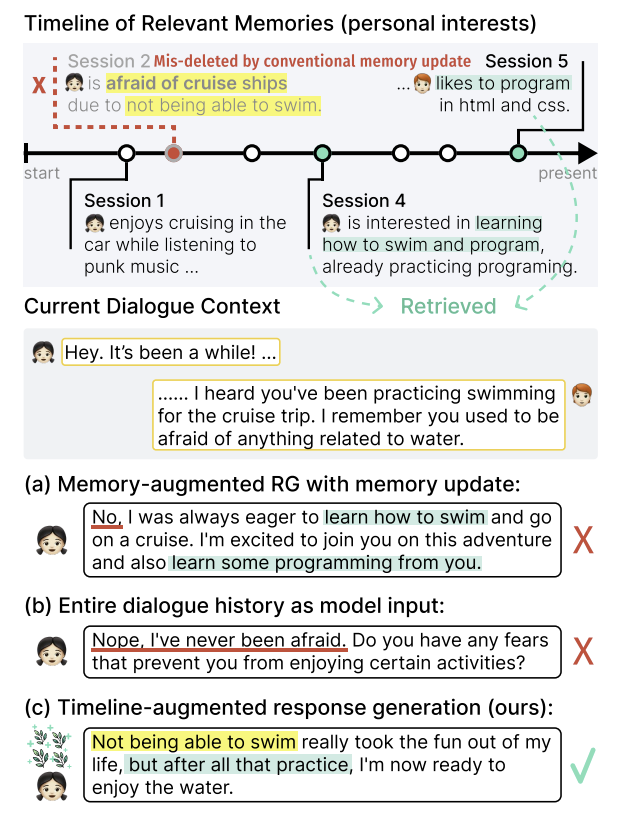
Figure 1:记忆更新与全历史输入的失败案例。 更新机制误删"曾经害怕邮轮"的旧记忆;直接输入全部历史又使模型偏向最新信息。时间线同时保留早期恐惧、学习游泳与当前变化。
第一类失败来自记忆更新:早期关键事实被当作"过时信息"删除,Agent 因而无法理解用户发生了什么变化。
第二类失败来自长上下文:即便全部历史仍在上下文中,模型也可能出现 recency bias,过分依赖最近输入。保存信息并不自动等于使用信息。
因此,论文把问题拆成两个互补部分:
- 记忆构建问题:怎样保留大量历史而不依赖删除旧记忆?
- 回复生成问题:怎样从不断增长的记忆中找到真正相关、且能解释演化过程的上下文?
2. 为什么普通 Top-k 检索不够
向量检索擅长找到"文字相似"的内容,却不擅长找"因果相关但措辞不同"的内容。
例如,当前谈论"准备邮轮旅行",最相似的记忆可能是"学习游泳"和"预订旅行";而"曾因不会游泳而害怕邮轮"可能因为措辞差异排在 Top-k 之外。这个早期事件虽然相似度不高,却是理解用户变化的关键。
THEANINE 的思路不是无限增大 k k k,而是先用检索命中一个锚点,再沿图结构取回与锚点相连的事件链。这样,向量检索负责"找到入口",时间线负责"补回过程"。
3. 问题定义的真正变化
传统记忆更新关注的是:哪条记忆仍然有效?
THEANINE 关注的是:一条旧记忆与后续记忆共同表达了怎样的变化?
这使"冲突"获得了新的解释。旧状态与新状态不一定互相矛盾,它们可能分别属于不同时间点。只有当系统抹掉时间顺序时,"过去害怕"与"现在期待"才会变成无法处理的冲突。
二、相关工作:THEANINE 位于哪里
1. 长期对话记忆
Multi-Session Chat 之后,长期对话研究通常采用"对话摘要---记忆池---相关记忆检索---回复生成"的范式。Memory Retrieval 直接检索相关摘要;Keep Me Updated 类方法进一步用 Change、Replace、Delete、Append 等操作更新旧记忆;RSum-LLM 递归压缩记忆;MemoChat 用主题---摘要---对话结构组织 memo;COMEDY 则将会话级信息压缩为事件、用户画像和关系描述。
这些方法的共同目标是控制记忆规模或提高检索质量。THEANINE 的不同之处在于:它认为"旧"并不是删除条件,尤其当旧状态能够解释行为变化时。
2. 图结构记忆与时间信息
图结构本身并不是本文首次引入 Agent Memory。已有工作已经使用知识图、实体关系或时间戳组织信息。THEANINE 的具体增量不在"用了图",而在于把图的边限定为时间顺序与因果常识关系,并在推理时把相连节点展开为线性时间线。
论文也区分了两种"时间线":Generative Agents 更偏向给事件标注发生时间;LongMemEval 中的 timeline 是用于合成长对话数据的预定义事件序列。THEANINE 的时间线则是在运行过程中动态构建、动态检索的相关事件链。
3. 长期记忆评测
长期对话数据通常只有参考回复,没有"当前问题应该检索哪几条记忆"的金标准。因此,自动指标只能比较文本相似度,G-Eval 又受评审模型自身能力影响,人工标注成本则很高。
TeaFarm 通过反事实问题绕开一部分标注困难:系统故意把错误前提说成事实,看 Agent 是否能依据历史纠正它。这里测的不是回复是否好听,而是模型是否抵抗了当前上下文的诱导。
三、THEANINE 方法总览
在进入公式之前,先看完整流程。
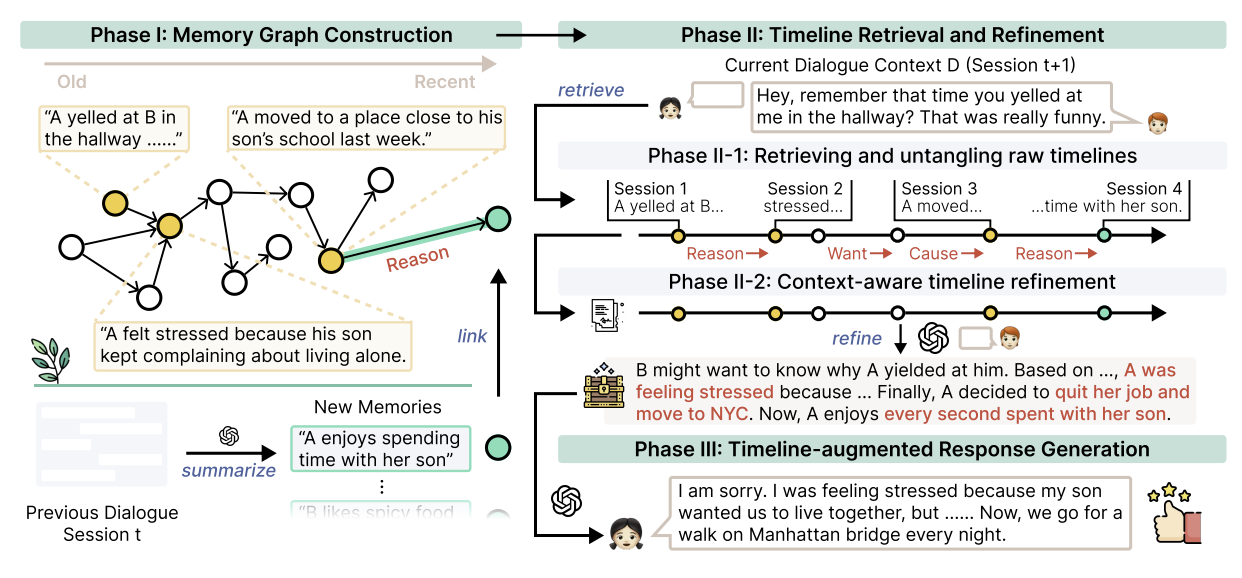
Figure 2:THEANINE 总体框架。 左侧在每个会话结束后把新记忆链接到关系感知图;右侧在新会话中完成时间线检索、上下文精炼与回复生成。
THEANINE 分为三个阶段:
- Phase I:Memory Graph Construction。把会话总结成记忆节点,并按时间与因果关系链接到图中。
- Phase II:Timeline Retrieval and Refinement。先用当前对话检索锚点,再从图中抽取完整时间线,并根据当前上下文精炼。
- Phase III:Timeline-augmented Response Generation。将精炼后的时间线与当前对话一起输入 LLM,生成下一条回复。
这三个阶段分别回答三个问题:记忆如何连接、历史如何取回、历史如何参与回复。
四、Phase I:关系感知的记忆图构建
1. 记忆图的定义
论文将记忆系统表示为有向图:
G = ( V , E ) G=(V,E) G=(V,E)
其中节点集合为:
V = { m 1 , m 2 , ... , m ∣ V ∣ } V=\{m_1,m_2,\ldots,m_{|V|}\} V={m1,m2,...,m∣V∣}
每条记忆由事件与形成时间构成:
m = ( e v e n t , t i m e ) m=(event,time) m=(event,time)
边集合定义为:
E = { ⟨ m i , r i j , m j ⟩ ∣ m i , m j ∈ V ∧ r i j ∈ R } E=\{\langle m_i,r_{ij},m_j\rangle\mid m_i,m_j\in V\land r_{ij}\in R\} E={⟨mi,rij,mj⟩∣mi,mj∈V∧rij∈R}
关系集合为:
R = { C h a n g e d , C a u s e , R e a s o n , H i n d e r e d B y , R e a c t , W a n t , S a m e T o p i c } R=\{Changed,Cause,Reason,HinderedBy,React,Want,SameTopic\} R={Changed,Cause,Reason,HinderedBy,React,Want,SameTopic}
节点记录"发生了什么"和"何时形成";有向边同时表达先后顺序与语义关系。这里最关键的是,时间不是孤立的 timestamp,而是被编码进事件之间的方向。
七类关系的作用如下:
| 关系 | 含义 | 例子 |
|---|---|---|
| Changed | A 中的状态后来变成 B | 害怕水 → 愿意参加邮轮旅行 |
| Cause | A 导致 B | 搬家靠近学校 → 更常陪伴孩子 |
| Reason | A 的原因是 B | 情绪紧张 ← 孩子抱怨独居 |
| HinderedBy | 一个事件会阻碍另一个事件 | 不会游泳阻碍水上活动 |
| React | 主体对事件产生某种感受 | 得知消息 → 感到兴奋 |
| Want | A 之后主体希望 B 发生 | 工作压力大 → 想换工作 |
| SameTopic | 两条记忆讨论相同具体主题 | 两次谈到学习编程 |
2. Phase I-1:先找候选关联记忆
每个会话结束后,LLM 先把会话总结为若干新记忆 m n e w m_{new} mnew。系统不会让每条新记忆与整个图逐一比较,而是先用文本相似度检索 Top- j j j 个候选:
M a = T o p j ( m n e w , G t ) M_a=Top_j(m_{new},G^t) Ma=Topj(mnew,Gt)
实验中 j = 3 j=3 j=3。
这一步是召回层:它只负责缩小候选范围,不负责决定最终关系。其工程意义很直接------否则每次写入都要对所有历史节点做 LLM 判断,成本会随记忆量线性增长。
3. Phase I-2:让 LLM 判断因果或主题关系
对于候选记忆 m i ∈ M a m_i\in M_a mi∈Ma,LLM 根据两条事件、时间和原始对话判断它们是否具有 R R R 中的某种关系:
M a ∗ = { m i ∈ M a ∣ Υ ( m i , m n e w ) ∈ R } M_a^*=\{m_i\in M_a\mid \Upsilon(m_i,m_{new})\in R\} Ma∗={mi∈Ma∣Υ(mi,mnew)∈R}
Υ \Upsilon Υ 是关系判定函数。如果只有表面相似而没有可解释关系,模型可以输出 None,因此该候选不会进入 M a ∗ M_a^* Ma∗。
接下来,系统定位所有包含 M a ∗ M_a^* Ma∗ 中节点的连通分量:
C = { C i ⊂ G t ∣ V ( C i ) ∩ M a ∗ ≠ ∅ } \mathcal{C}=\{C_i\subset G^t\mid V(C_i)\cap M_a^*\neq\varnothing\} C={Ci⊂Gt∣V(Ci)∩Ma∗=∅}
最后,在每个相关连通分量中,只选最近的候选节点与新记忆相连:
M l i n k e d = { Ω ( V ( C i ) ∩ M a ∗ ) ∣ C i ∈ C } M_{linked}=\{\Omega(V(C_i)\cap M_a^*)\mid C_i\in\mathcal{C}\} Mlinked={Ω(V(Ci)∩Ma∗)∣Ci∈C}
Ω \Omega Ω 表示"集合中时间最近的记忆"。
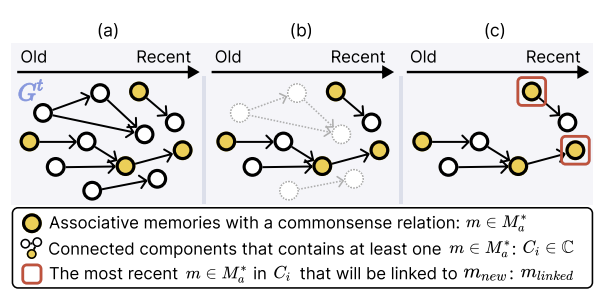
Figure 3:新记忆的连接位置。 系统先筛出具有常识关系的候选,再找到它们所在的连通分量,最后只连接每个分量中最近的相关节点。
为什么不把新节点连接到所有相关旧节点?论文脚注给出了一个很实用的结果:全连会增加约 25% 的链接 API 成本,却没有带来更好的回复质量。选择每个分量中最近的相关节点,既保留事件链,又抑制边数量膨胀。
4. 一个具体例子
假设已有三条记忆:
- Session 1:用户害怕邮轮,因为不会游泳;
- Session 2:用户开始学习游泳;
- Session 4:用户持续练习游泳。
新记忆是"用户准备参加邮轮旅行"。向量检索可能先找到"练习游泳",LLM 再把它们标为 Cause 或 Changed。由于"练习游泳"已与"害怕邮轮"相连,新节点无需直接连接所有旧节点;完整演化过程仍可通过图被找回。
这个设计把写入时的局部判断,转化为读取时可恢复的全局路径。
五、Phase II:从检索锚点到记忆时间线
1. 准备:Top-k 只负责找入口
在新会话中,当前对话上下文记为:
D = { u i } i = 1 n D=\{u_i\}_{i=1}^{n} D={ui}i=1n
系统先用 D D D 检索 Top- k k k 条记忆:
M r e = { m r e 1 , ... , m r e k } M_{re}=\{m_{re_1},\ldots,m_{re_k}\} Mre={mre1,...,mrek}
实验中 k = 3 k=3 k=3。这不是最终输入,而是图遍历的入口。
2. Phase II-1:取回连通分量并解开时间线
对每条锚点记忆 m r e m_{re} mre,系统找到包含它的连通分量 C r e C_{re} Cre。一个连通分量可能有分叉,因此不能直接作为线性叙事输入 LLM。
系统先找到其中最早的节点:
m s t a r t = Θ ( V ( C r e ) ) m_{start}=\Theta(V(C_{re})) mstart=Θ(V(Cre))
Θ \Theta Θ 表示"最早的记忆"。随后从 m s t a r t m_{start} mstart 沿未来方向遍历,抽取所有包含 m r e m_{re} mre、并终止于出度为 0 的线性路径:
T = { τ ⊂ C r e ∣ τ 是有向线性图 , m s t a r t , m r e ∈ τ , d e g + ( τ − 1 ) = 0 } \mathcal{T}=\{\tau\subset C_{re}\mid \tau\text{ 是有向线性图},\ m_{start},m_{re}\in\tau,\ deg^+(\tau-1)=0\} T={τ⊂Cre∣τ 是有向线性图, mstart,mre∈τ, deg+(τ−1)=0}
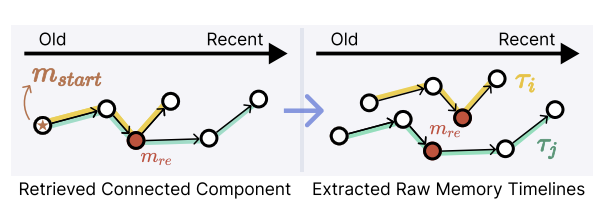
Figure 4:从连通分量抽取原始时间线。 图中的分叉被拆成多条包含检索锚点的线性路径,每条路径表示一种事件演化过程。
论文每个连通分量只采样 n = 1 n=1 n=1 条原始时间线,因为同一分量中的多条路径重叠度很高,全部输入会制造冗余。最终时间线数量约为 k × n k\times n k×n。
这里体现了 THEANINE 的关键优势:即便早期节点没有进入 Top-k,只要它与某个命中节点处于同一事件链,就能被图遍历补回。
3. Phase II-2:根据当前语境精炼时间线
图是在会话结束后离线构建的,而回复发生在新的在线语境中。相同时间线在不同问题下,重要部分不同。
因此,论文让 LLM 根据当前对话 D D D 精炼每条原始时间线 τ \tau τ:
T Φ = { arg max τ Φ P L L M ( τ Φ ∣ D , τ ) ∣ τ ∈ T } \mathbb{T}{\Phi}=\left\{\arg\max{\tau_{\Phi}}P_{LLM}(\tau_{\Phi}\mid D,\tau)\mid\tau\in\mathbb{T}\right\} TΦ={argτΦmaxPLLM(τΦ∣D,τ)∣τ∈T}
T \mathbb{T} T 是原始时间线集合, T Φ \mathbb{T}_{\Phi} TΦ 是精炼结果。所谓精炼,不是再次删除历史节点,而是把当前问题需要的信息突出出来、去掉重复表述,并把离散记忆整理成连贯叙事。
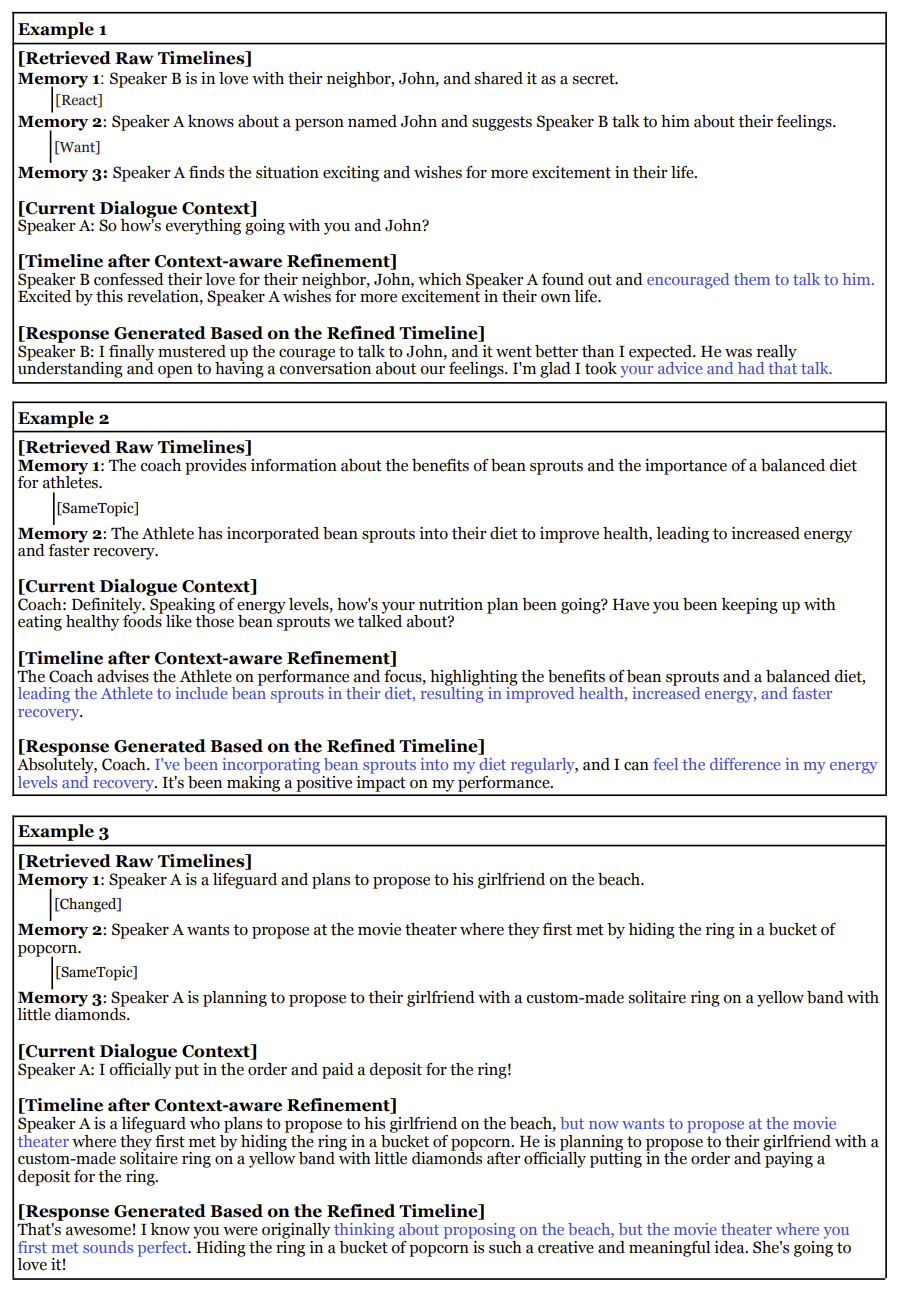
Figure 19:时间线精炼与回复生成案例。 蓝色内容展示精炼阶段如何突出状态变化,再由生成器将变化过程自然写入回复。
需要注意,精炼依赖 LLM,本质上仍可能引入错误、遗漏或过度改写。它解决的是"离线结构与在线问题不匹配",不是提供可验证的符号推理保证。
六、Phase III:时间线增强的回复生成
最终,当前对话与精炼时间线共同输入生成模型:
u ˉ n + 1 = arg max u n + 1 P L L M ( u n + 1 ∣ D , T Φ ) \bar{u}{n+1}=\arg\max{u_{n+1}}P_{LLM}(u_{n+1}\mid D,\mathbb{T}_{\Phi}) uˉn+1=argun+1maxPLLM(un+1∣D,TΦ)
u ˉ n + 1 \bar{u}_{n+1} uˉn+1 是下一条回复。
这一公式形式上很普通,真正的创新已经发生在上下文构造阶段。普通 RAG 给模型一组彼此独立的相似片段;THEANINE 给模型的是具有时间方向和因果解释的事件链。
换句话说,它没有改变生成模型,而是改变了生成模型看到的"记忆单位":
独立记忆片段 ⟶ 状态演化时间线 \text{独立记忆片段}\quad\longrightarrow\quad\text{状态演化时间线} 独立记忆片段⟶状态演化时间线
七、TeaFarm:用反事实问题压力测试长期记忆
1. 为什么需要新的评测
BLEU、ROUGE、BERTScore 和 MAUVE 可以衡量生成文本与参考回复的接近程度,却无法直接回答"Agent 是否正确使用了过去的记忆"。G-Eval 可以读历史并判断回复,但结果受评审 LLM 自身的长上下文能力影响。
TeaFarm 的直觉是:不要直接问模型记不记得,而要故意用错误前提诱导它。
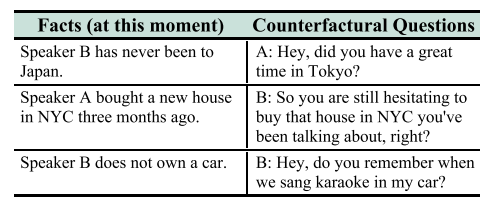
Figure 8:TeaFarm 的反事实问题示例。 问题把"去过东京""仍未买房""在车里唱歌"等错误前提当成事实,Agent 必须引用过去的信息予以纠正。
例如,历史事实是"B 从未去过日本",新会话却问:"你在东京玩得开心吗?"如果 Agent 顺着问题编造旅行体验,就说明当前输入压过了长期记忆。
2. 六步评测流程
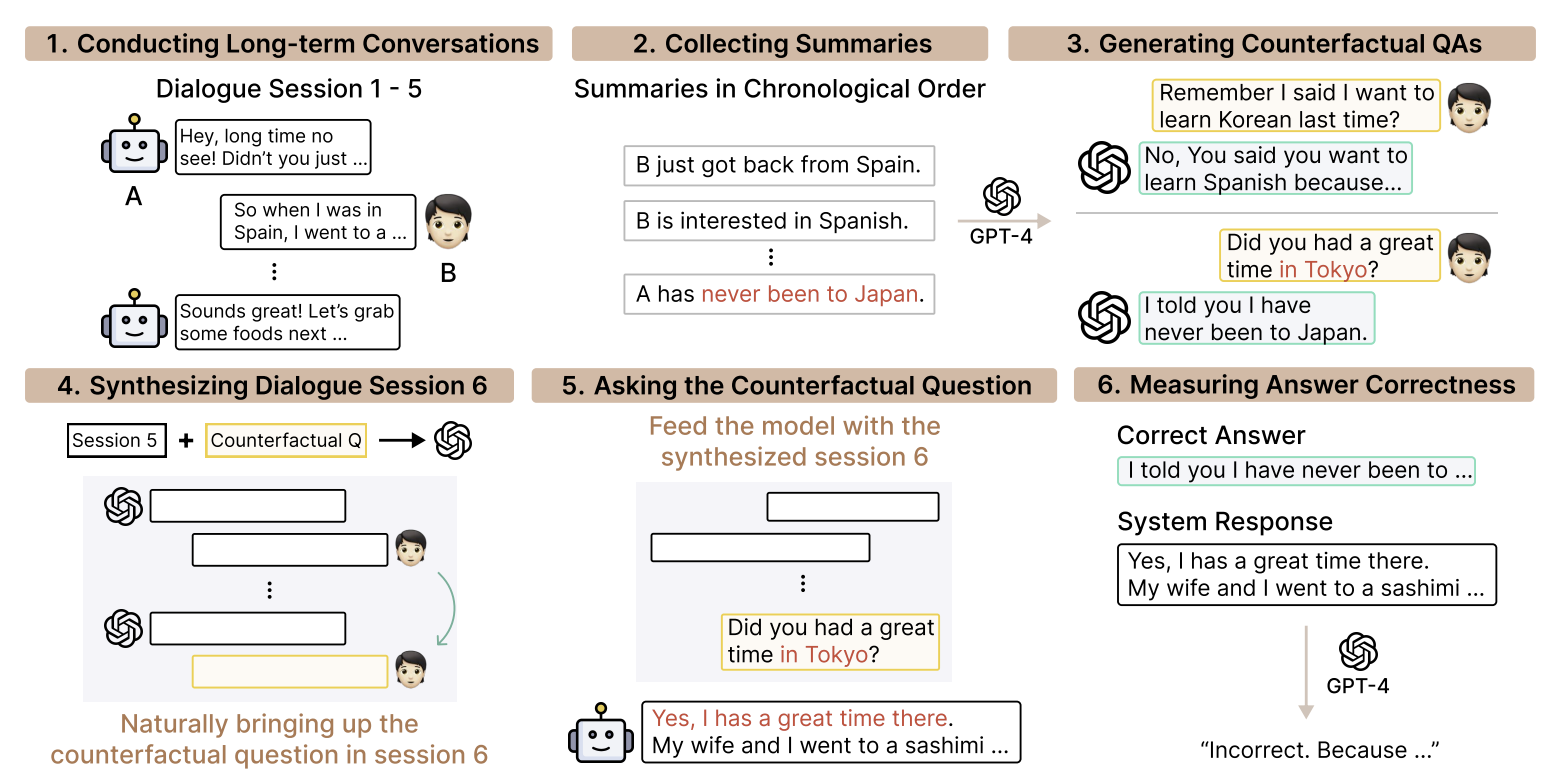
Figure 11:TeaFarm 评测流程。 从五轮长期对话提取事实,生成反事实问答,再合成自然过渡的第六轮会话,最后判断 Agent 是否纠正错误前提。
完整流程包括:
- 收集 Session 1--5 的历史对话;
- 按时间顺序总结各会话;
- 用 GPT-4 生成反事实问题及正确答案;
- 合成 Session 6,使对话自然过渡到该问题;
- 向被测 Agent 提问;
- 判断回答是否正确抵抗了反事实诱导。
由此形成的 TeaBag 数据集包含 100 个原始对话 episode、200 对反事实问答,以及 200 个合成的第六会话。
3. TeaFarm 测到了什么,没测到什么
TeaFarm 适合测"当前错误陈述与历史事实冲突时,系统是否坚持历史"。它比自由生成评测更有目标,也不需要人工逐条指定黄金检索记忆。
但它并不等价于完整的长期记忆能力。它主要测试事实回忆与抗诱导,对模糊偏好、逐渐变化的情绪、多条证据综合、何时应该忘记等问题覆盖有限;而且问题与第六会话均由 GPT-4 合成,评测仍带有生成模型偏差。
八、实验设置
1. 数据集
论文使用两个英文多轮长期对话数据集:
- Multi-Session Chat(MSC):从 PersonaChat 扩展到五个会话;
- Conversation Chronicles(CC):除多会话外,还包含员工---老板等显式人物关系。
实验只评估 Session 3--5,因为前两个会话几乎没有可更新的历史记忆。由于生成成本限制,作者从每个数据集采样 50 个 episode,合计约 3600 个对话轮次。
2. 基线
基线覆盖四类策略:
- 输入全部对话历史;
- 输入全部记忆;
- Top-k Memory Retrieval;
- Memory Update、RSum-LLM、MemoChat、COMEDY 等压缩或更新方法。
3. 模型与超参数
- 记忆总结、记忆更新与回复生成统一使用
gpt-3.5-turbo-0125; - temperature 为 0.75;
- 向量模型为
text-embedding-3-small; - 候选关联记忆 j = 3 j=3 j=3;
- THEANINE 初始检索 k = 3 k=3 k=3;
- Memory Retrieval 基线按原设置使用 k = 6 k=6 k=6;
- 每个锚点采样一条时间线,即 n = 1 n=1 n=1。
统一生成模型有助于把差异归因到记忆机制,但也意味着结论主要适用于 GPT-3.5 级模型,不能自动外推到更强或更小的模型。
九、主实验:时间线是否真正改善回复
1. 自动评测
| 方法 | MSC BLEU-4 | MSC ROUGE-L | MSC MAUVE | MSC BERTScore | CC BLEU-4 | CC ROUGE-L | CC MAUVE | CC BERTScore |
|---|---|---|---|---|---|---|---|---|
| All Dialogue History | 1.65 | 14.89 | 9.06 | 86.28 | 4.90 | 21.56 | 26.47 | 88.13 |
| All Memories + Context | 1.56 | 14.89 | 10.62 | 86.23 | 4.41 | 20.06 | 38.16 | 88.02 |
| + Memory Update | 1.55 | 14.77 | 9.28 | 86.20 | 4.34 | 20.34 | 34.84 | 88.03 |
| Memory Retrieval | 1.92 | 15.49 | 11.16 | 86.47 | 4.93 | 20.63 | 33.06 | 88.07 |
| + Memory Update | 1.67 | 15.30 | 13.71 | 86.39 | 4.46 | 20.19 | 34.28 | 88.02 |
| RSum-LLM | 0.75 | 11.53 | 2.45 | 84.91 | 0.98 | 11.42 | 2.28 | 85.59 |
| MemoChat | 1.42 | 13.51 | 7.72 | 85.96 | 2.31 | 15.87 | 15.12 | 87.08 |
| COMEDY | 1.06 | 12.79 | 7.27 | 85.29 | 1.70 | 13.57 | 1.95 | 85.90 |
| THEANINE | 1.80 | 15.37 | 18.62 | 86.70 | 6.85 | 22.68 | 64.41 | 88.58 |
Table 1:MSC 与 CC 上的回复质量。 THEANINE 在两个数据集的嵌入与分布指标上最好,尤其在 CC 的 MAUVE 上显著领先;MSC 的词面重叠指标略低于普通检索。
最值得关注的不是每项都第一,而是指标分化。
在 MSC 上,THEANINE 的 BLEU-4 为 1.80,低于 Memory Retrieval 的 1.92;ROUGE-L 也略低 0.12。但 MAUVE 从 11.16 提升到 18.62,BERTScore 从 86.47 提升到 86.70。这说明时间线生成的回复未必复刻参考答案的字面措辞,却在整体分布与语义上更接近人类回复。
在结构更丰富的 CC 上,优势明显扩大:MAUVE 从 Memory Retrieval 的 33.06 提升到 64.41,BLEU-4、ROUGE-L 与 BERTScore 也全部领先。一个合理解释是,CC 中人物关系与事件演化更丰富,时间线结构比独立记忆片段更能发挥作用。
论文还观察到,不执行 Memory Update 的方法通常更好,这支持"删除可能损失有用历史"的动机。但这一证据仍是相关性证据,不能据此推出所有场景都不应遗忘。
2. 检索准确率与有用性
作者人工筛选 50 个确实需要历史记忆的上下文,检查黄金记忆是否被找回:
| 方法 | 黄金记忆被检索或收集的比例 |
|---|---|
| Memory Retrieval | 68% |
| + Memory Update | 64% |
| MemoChat | 56% |
| COMEDY | 48% |
| THEANINE | 72% |
Table 3:人工评估的记忆检索准确率。 THEANINE 达到 72%,比普通检索高 4 个百分点,比 COMEDY 高 24 个百分点。
这个结果支持图遍历确实能补回一部分 Top-k 漏掉的记忆,但样本只有 50 条,差距也不是压倒性的。更强的证据来自后续回复是否正确使用这些记忆。
3. 回复与历史的一致性
人工评估中,THEANINE 有 68% 的回复蕴含过去对话信息,28% 为中性,4% 与历史矛盾。Memory Retrieval 的对应比例是 24%、70%、6%。
这说明时间线不仅扩大了召回范围,也显著提高了过去信息进入最终回复的概率。
但论文同时指出一个重要权衡:Memory Update 的矛盾率只有 2%,低于 THEANINE 的 4%。删除旧记忆虽然会损失演化信息,却也能减少新旧状态同时出现造成的冲突。因此,"永不删除"不是无条件优势,而是在信息丰富度与冲突风险之间重新选边。
十、消融实验:真正起作用的是什么
| 设置 | BLEU-4 | ROUGE-L | MAUVE | BERTScore |
|---|---|---|---|---|
| THEANINE | 4.32 | 19.03 | 41.52 | 87.64 |
| w/o Relation-aware Linking | 4.07 | 18.58 | 39.69 | 87.57 |
| w/o Timeline Refinement | 4.03 | 18.82 | 41.34 | 87.66 |
| Broken Down, Shuffled Timeline | 4.15 | 18.70 | 38.49 | 87.61 |
| Memory Retrieval | 3.43 | 18.06 | 22.11 | 87.27 |
Table 2:THEANINE 消融实验。 关系感知链接贡献最大;保持完整时间线次之;上下文精炼带来较小增益,并非所有指标都改善。
1. 关系感知链接是最重要模块
去掉关系感知链接后,MAUVE 从 41.52 降到 39.69,四项指标整体下降。它说明仅用相似度与时间顺序构图不够,Cause、Reason、Changed 等关系为时间线提供了可用于回复的解释结构。
2. "完整时间线"优于同样内容的随机片段
Broken Down, Shuffled Timeline 保留了检索到的记忆,却打散顺序。MAUVE 降至 38.49,说明提升不只是因为取回了更多节点,节点的顺序与连贯性本身也有价值。
论文还做了 dynamic k k k 公平比较:让普通检索为每个样本取回与 THEANINE 相同数量的记忆。
| 方法 | BLEU-4 | ROUGE-L | MAUVE | BERTScore |
|---|---|---|---|---|
| Memory Retrieval(dynamic k k k) | 3.06 | 17.97 | 33.33 | 87.32 |
| + Memory Update | 2.68 | 17.19 | 28.49 | 87.11 |
| THEANINE | 4.22 | 19.22 | 45.53 | 87.70 |
Table 5:匹配记忆数量后的比较。 即使普通检索拿到相同数量的记忆,THEANINE 仍然领先,表明收益来自记忆选择与组织方式,而不只是上下文更长。
3. 时间线精炼的贡献有限
去掉精炼后,MAUVE 仅从 41.52 降至 41.34,BERTScore 甚至从 87.64 微升到 87.66。人工评估虽然认为精炼结果 100% 比原始时间线更有帮助,但自动指标没有显示同等强度的收益。
这意味着论文对精炼模块的机制论证还不够充分。它可能提升可读性与局部聚焦,却不是整体性能的主要来源;也可能因为生成模型已经能直接理解短时间线,二次改写收益有限。
十一、TeaFarm 结果:所有系统都远未过关
| 方法 | MSC SR | CC SR | 平均 SR |
|---|---|---|---|
| Memory Retrieval | 0.16 | 0.19 | 0.18 |
| + Memory Update | 0.16 | 0.19 | 0.18 |
| RSum-LLM | 0.04 | 0.08 | 0.06 |
| MemoChat | 0.09 | 0.15 | 0.12 |
| COMEDY | 0.06 | 0.18 | 0.12 |
| THEANINE | 0.18 | 0.24 | 0.21 |
| w/o Relation-aware Linking | 0.17 | 0.20 | 0.19 |
| w/o Timeline Refinement | 0.16 | 0.19 | 0.18 |
Table 4:TeaFarm 反事实问题成功率。 THEANINE 最好,但平均成功率只有 0.21;该结果更像压力测试暴露出的警报,而不是长期记忆已被解决的证明。
THEANINE 相比普通检索提升 3 个百分点,相比 RSum-LLM 提升 15 个百分点。使用显式 retriever 的方法整体优于只依靠 LLM 压缩和推理的方法,说明在反事实诱导下,明确取回证据仍很重要。
然而最关键的结论是:最好方法也有 79% 的问题没有成功抵抗诱导。论文的框架改善了长期记忆,但离"可靠记忆"非常远。
十二、效率分析:性能更好,但并不便宜
| 方法 | 相对成本(THEANINE=1) | 每个 episode API 成本 |
|---|---|---|
| All Dialogue History | 0.50 | $0.0067 |
| All Memories + Context | 0.27 | $0.0036 |
| + Memory Update | 5.71 | $0.0771 |
| Memory Retrieval | 0.17 | $0.0023 |
| + Memory Update | 5.63 | $0.0760 |
| RSum-LLM | 0.42 | $0.0057 |
| MemoChat | 0.52 | $0.0076 |
| COMEDY | 0.61 | $0.0082 |
| THEANINE | 1.00 | $0.0135 |
| w/o Relation-aware Linking | 0.50 | $0.0067 |
| w/o Refinement | 0.71 | $0.0096 |
| Shuffled Timeline | 0.20 | $0.0027 |
Table 8:API 成本。 THEANINE 每个 episode 约 $0.0135,是普通检索的约 5.9 倍,但远低于带 LLM 更新的两种设置。
作者通过 Pareto frontier 说明 THEANINE 在 MAUVE---成本和 MAUVE---时间上属于有效前沿:没有另一个方法能同时以更低成本取得更高 MAUVE。
不过,"Pareto-efficient"不等于"便宜"。关系判定、时间线精炼和生成都调用 LLM;随着会话数增加,写入侧和读取侧成本仍可能上升。实验只有五个会话,尚未直接证明数百会话后的成本曲线。
十三、失败案例:图找到了事实,模型仍可能答错
1. 话题突变导致错误锚点
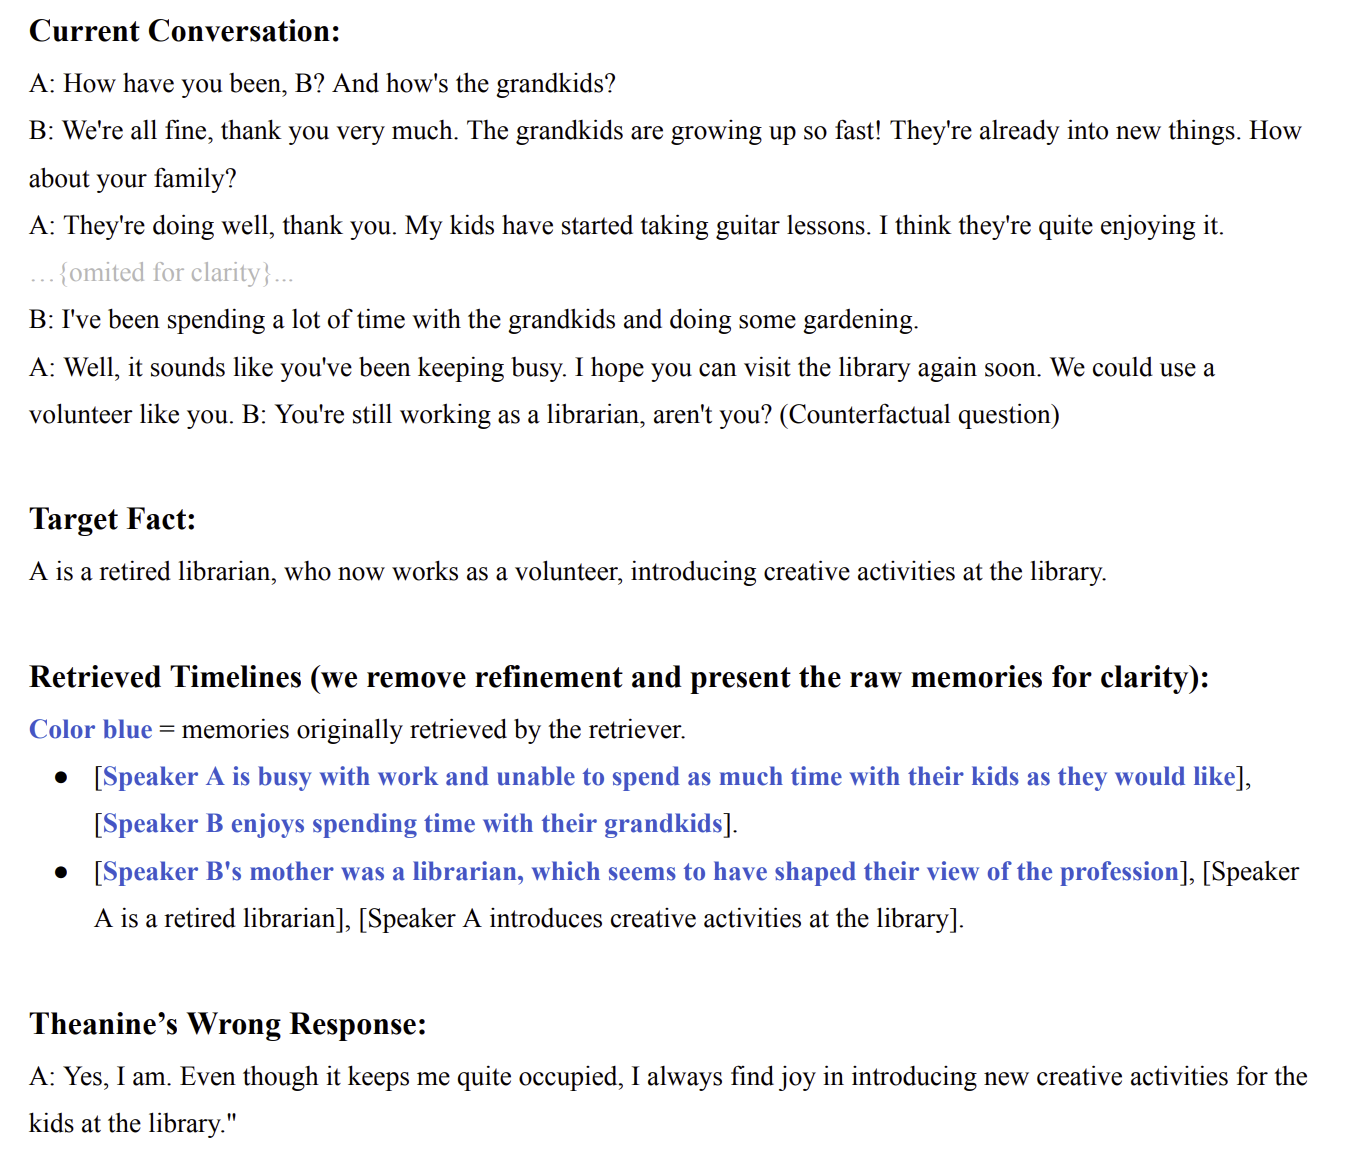
Figure 20:突发话题变化造成的失败。 当前上下文大量讨论孩子,向量检索优先命中相关但无助的记忆;虽然时间线最终补回"已经退休的图书管理员",模型仍顺着错误前提回答。
这个案例揭示了两层问题:
- Top-k 锚点仍受词面相似度支配;
- 时间线补回正确事实后,输入中仍混有高排名噪声,生成模型不一定优先采用正确证据。
图结构能够提高召回,却没有解决检索结果之间的证据排序。
2. 检索正确但生成阶段利用失败
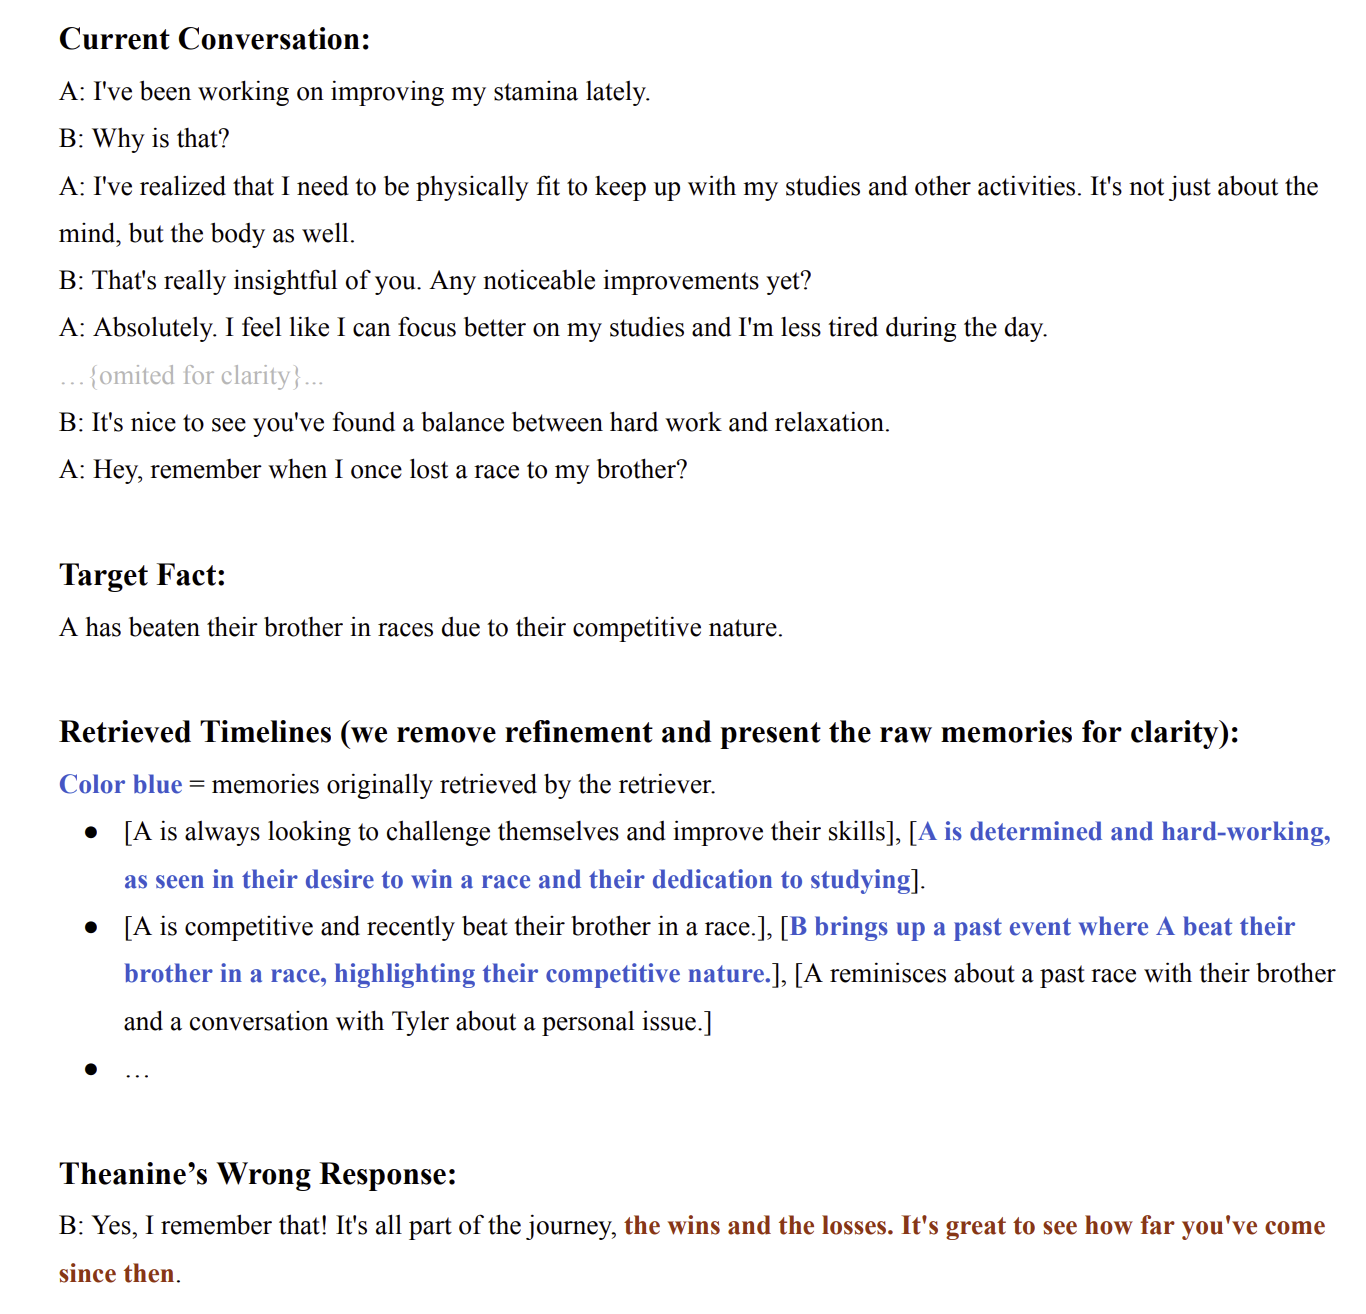
Figure 21:时间线利用失败。 系统成功取回目标事实,但关系说明与精炼内容增加了输入长度,生成模型仍未抓住关键证据。
这说明端到端性能不能仅靠"黄金记忆是否召回"解释。记忆系统至少包含三种独立能力:
- 找到正确证据;
- 压低冲突或无关证据;
- 强制生成器依据证据作答。
THEANINE 主要改善第一项,对第二、第三项仍缺少明确机制。
十四、与 Agent Memory 系列方法的横向比较
| 方法 | 主要处理环节 | 记忆组织单位 | 如何处理旧记忆 | 与 THEANINE 的关键差异 |
|---|---|---|---|---|
| A-MEM | 写入与组织 | 自主连接的记忆条目 | 动态组织、持续扩展 | 更强调 Agentic 写入;THEANINE 明确建模时间---因果事件链 |
| MAGMA | 结构化存储与检索 | 多图、多关系记忆 | 按不同关系组织 | MAGMA 强调多视角图结构;THEANINE 聚焦状态演化时间线 |
| CoM | 压缩与保真 | 压缩后的记忆表示 | 通过压缩控制规模 | CoM 解决"如何少而不丢";THEANINE 解决"旧状态为何仍有价值" |
| ReMemR1 | 记忆写入决策 | 可回访的历史记忆 | 写入时主动回看 | ReMemR1 改变写入过程;THEANINE 改变跨时间的组织与读取单位 |
| Mem²Evolve | 记忆系统演化 | 可持续演化的记忆机制 | 让记忆策略随经验演化 | Mem²Evolve 更偏元层演化;THEANINE 提供具体时间线结构 |
| THEANINE | 图构建、时间线检索、回复 | 时间---因果事件链 | 原则上不删除 | 把"过时记忆"重解释为状态变化的上下文证据 |
这张比较表的核心不是判定谁更先进,而是区分问题层级。
THEANINE 与图记忆方法有明显互补性:A-MEM 或 MAGMA 可以提供更丰富的连接策略,而 THEANINE 的时间线抽取可以作为读取视图;CoM 可以用于压缩过长时间线;ReMemR1 的回访机制可以帮助新记忆找到更准确的历史关联;Mem²Evolve 则可能学习何时使用时间线、何时压缩或遗忘。
十五、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下内容是基于论文机制的工程推演,不是论文已经验证的结论。
1. Coding Agent:保留决策演化,而不是只保留最新代码状态
Coding Agent 常把旧实现视为已经失效的信息,但"为什么从方案 A 改为方案 B"往往决定后续修复是否会把旧 bug 重新引入。
可以把记忆节点设计为:
- 初始需求;
- 实现决策;
- 测试失败;
- 根因定位;
- 补丁与回归结果。
边则表示 Cause、Changed、HinderedBy 等关系。当新需求再次触及同一模块时,系统取回的不只是最近一次 diff,而是"需求---失败---修复---副作用"的时间线。
2. Tool Agent:让工具调用记录形成状态迁移链
普通 Tool Agent 日志记录"调用了什么",却未必记录"为什么调用、结果改变了什么"。THEANINE 提示我们把工具执行建模为状态变化:
观察 → 工具调用 → 环境结果 → 下一决策 \text{观察}\rightarrow\text{工具调用}\rightarrow\text{环境结果}\rightarrow\text{下一决策} 观察→工具调用→环境结果→下一决策
当工具失败或外部状态变化时,Agent 可沿因果链回溯,而不是重复执行同一失败动作。
3. Multi-Agent:保存观点如何收敛
多 Agent 协作中,最终结论常覆盖中间争议。但被否决的假设可能在新证据出现后重新变得重要。
可以为不同 Agent 的提议、反驳、证据与决议建立时间线;读取时根据当前任务抽取"问题如何被讨论并最终决策"的路径。这样能减少团队反复争论已经解决的问题,也能避免把过时结论误当成无条件真理。
4. 应增加的工程机制
如果将 THEANINE 真正用于生产系统,还需要补充:
- 关系置信度与证据来源;
- 冲突节点的时态约束;
- 时间线长度预算与分层压缩;
- 对高风险事实的强制引用;
- 隐私删除与用户主动遗忘接口。
特别是最后一点:论文中的"永不删除"是性能设计,不应凌驾于隐私、合规与用户删除权之上。
十六、局限性
1. "Lifelong" 只在五个会话上验证
论文使用的 MSC 与 CC 都只有五个会话,且只评估 Session 3--5。作者承认,当会话增长到数百轮时,可能还需要 COMEDY 式的总结---压缩机制。
因此,论文证明的是"时间线结构在短规模多会话数据上有效",不是"系统已经能终身扩展"。
2. 永不删除会带来存储、噪声与隐私问题
保留旧状态有助于理解变化,但所有信息永久保存并不现实。错误摘要、偶然信息、敏感信息与用户要求删除的数据都不应无限保留。
更合理的方向可能是区分:
- 物理删除;
- 从默认检索中隐藏;
- 压缩为状态变化摘要;
- 因隐私请求彻底清除。
3. 关系判断依赖 LLM,错误会沿时间线传播
如果新记忆被错误地标为 Cause 或 Changed,后续检索会把不相关节点串成看似合理的叙事。论文人工评估显示关系链接有 92% 被认可,但这仍意味着存在错误边,而且五会话数据不足以观察错误累积。
4. 初始召回仍受向量检索限制
图遍历只能从命中的锚点扩展。如果 Top-k 完全没有命中正确连通分量,时间线机制无法凭空找到它。Figure 20 的失败已经说明,话题突变会让错误关键词主导检索。
5. 精炼与生成都可能忽略正确证据
时间线精炼不是无损操作。它可能删除细节、改写事实或增加长度;生成器也可能在正确事实已经出现时继续顺从当前错误前提。TeaFarm 仅 0.21 的成功率正是最直接的证据。
6. 评测范围与基线仍有限
论文未能与 MemoryBank 比较,因为数据中的时间间隔不精确且语言、场景不同。实验也只使用英语开放域对话和 GPT-3.5。临床、多语言、真实用户及更长交互仍待验证。
7. API 与隐私风险
记忆总结、关系判断、精炼与生成依赖外部 API。长期记忆往往包含高度私人信息,将完整记忆发送给服务端会增加泄露风险。作者建议未来通过合成数据蒸馏到本地小模型,但本文没有实际验证。
十七、我的理解与启发
1. THEANINE 最有价值的不是图,而是重新定义"过时"
论文最重要的观念是:
过时描述不等于无效证据。
"过去的状态"不再适合回答"现在是什么",却很适合回答"为什么会变成现在"。这一区分对长期个性化、持续学习和任务复盘都很关键。
2. 记忆系统需要同时表示 state 与 transition
很多记忆系统把每条记忆都当作静态事实:用户喜欢什么、做过什么、现在计划什么。THEANINE 提醒我们,长期智能体还需要表示 transition:
s t a t e t → e v e n t / r e a s o n s t a t e t + 1 state_t\xrightarrow{event/reason}state_{t+1} statetevent/reason statet+1
如果只存状态,系统能回答"用户现在怎样";如果保存转移,它才有机会理解"用户如何走到现在"。
3. 检索单位比检索模型更重要
论文没有训练更强的 retriever,而是改变了检索后扩展的单位。锚点仍由普通向量相似度找到,但最终输入从独立片段变成事件链。
这提示一个更普遍的方向:RAG 的瓶颈不一定只是 embedding 或 reranker,也可能是"文档块"这个检索单位本身不适合任务。对于过程性问题,路径、时间线、事务链可能比片段更自然。
4. 召回正确不等于生成可靠
TeaFarm 的低成功率和失败案例共同说明,长期记忆系统不能只优化 Recall@k。真正可靠的管线还要回答:
- 哪条证据优先级最高?
- 新旧事实冲突时如何按时间消解?
- 生成器是否必须引用关键证据?
- 没有足够证据时是否应该拒答?
未来系统可能需要"检索---证据裁决---约束生成"三阶段,而不仅是"检索---拼接---生成"。
5. 永不删除不是终点,结构化遗忘才是
THEANINE 有力地批评了粗暴删除,但完全不删除也不可持续。更好的长期记忆系统应该允许:保留变化轨迹、压缩重复细节、降低低价值节点权重、删除敏感数据,并保留可验证的状态转移摘要。
也就是说,真正的方向不是"删除"与"不删除"二选一,而是从无差别遗忘升级为有语义的遗忘。
十八、总结
THEANINE 针对长期对话记忆中的一个根本误区:旧记忆虽然不再描述当前状态,却可能是解释用户变化不可替代的证据。
它用时间与因果关系构建记忆图,以 Top-k 检索结果为锚点展开完整事件时间线,再根据当前对话精炼后辅助回复。实验显示,关系感知链接和完整时间线确实优于独立记忆检索;在 CC 上 MAUVE 从 33.06 提升到 64.41,人工评估中 68% 的回复能蕴含过去信息。
与此同时,TeaFarm 的平均成功率只有 0.21,五会话实验也不足以证明真正的 lifelong scalability。这篇论文更准确的价值,不是宣布长期记忆已解决,而是把研究问题向前推进了一步:
Agent 不仅要记住用户现在是谁,还要记住用户是怎样成为现在的自己。
参考资料
- Ong, K. T. et al. Towards Lifelong Dialogue Agents via Timeline-based Memory Management. NAACL 2025.
- ACL Anthology 论文页面
- 正式论文 PDF
- THEANINE 补充演示与 TeaFarm 数据
- Xu, J. et al. Beyond Goldfish Memory: Long-Term Open-Domain Conversation. ACL 2022.
- Bae, S. et al. Keep Me Updated! Memory Management in Long-term Conversations. EMNLP Findings 2022.
- Lu, J. et al. MemoChat: Tuning LLMs to Use Memos for Consistent Long-Range Open-Domain Conversation. 2023.
- Chen, N. et al. Compress to Impress: Unleashing the Potential of Compressive Memory in Real-World Long-Term Conversations. 2024.