📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 LLM | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前言: 计算机网络篇2把数据从本机网卡一路送到了对端主机 ,报文进了对端,事情却只办了一半------数据是给进程用的 ,主机收下还不算送达。本篇补完最后一段路:进程靠什么在网络里被认出、socket 怎么把两个进程锁成一对、传输层又靠哪张表把数据交到正确的进程手里 ,网络字节序这个跨机器的坑也一并填掉。
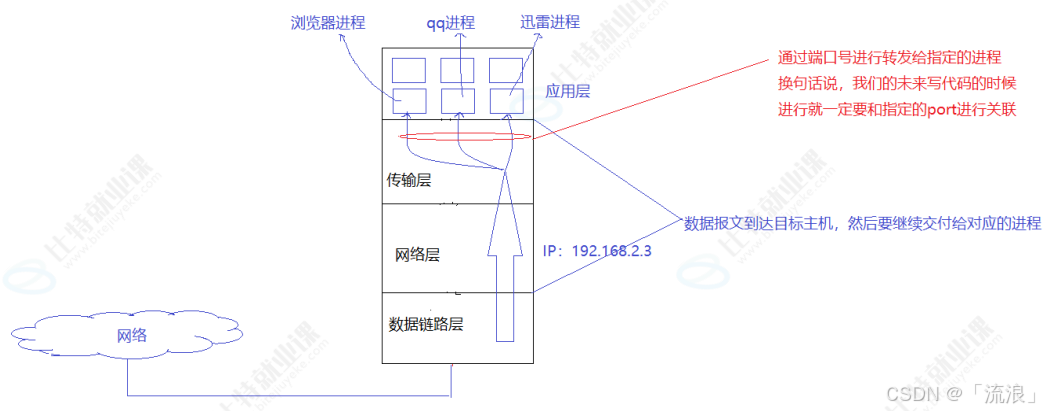
一、数据到主机不是目的,交给进程才是
1.1 进程是人在系统中的代表
1. 数据是给人用的
- 聊天、下载、浏览网页,真正在干活的从来不是人,而是跑起来的 QQ、迅雷、浏览器
- 这些跑起来的软件,在操作系统里都是进程
- 进程是人在系统中的代表,把数据交给进程,人就相当于拿到了数据
2. 主机只是中转站
- 数据传输到主机,只是手段;进入主机交给进程,才是目的
- 报文到了主机,只算「到站」,进了进程手里才算「签收」
1.2 上网的本质是进程和网卡之间的 IO
1. 两种行为
- 获取信息:网络到网卡,网卡再到进程内存
- 发送信息:进程内存到网卡,网卡再到网络
两者是反过来的
2. 冯诺依曼体系定死了网卡只能进行 IO 操作
- 冯诺依曼体系规定了网卡只能进行 IO 操作,数据在进程内存和网卡之间来回搬,就是一次读写
- 这一条也定死了应用层软件的天花板------应用层软件只能做两件事:获取信息和发送信息
数据到主机只是手段,交给进程才是目的。上网的两种行为落到最底,都是进程内存和网卡之间的一次 IO。
二、网络通信的本质是跨主机的进程间通信
2.1 进程间通信的前提是看到同一份资源
1. IPC 的老前提
- Linux系统篇23给过前提:两个进程要通信,先得看到同一份资源,管道、共享内存、消息队列都是在构造这份资源
- 网络通信没跳出这个框架,只是把同一份资源换成了跨主机版------网络本身
2. 落到两个 QQ 进程
- QQ 发消息,本质是你的 QQ 进程把数据写进网络,对方的 QQ 进程从网络里读
- 两个不同主机上的进程借着网络做数据交互,网络通信的本质,也是进程间通信
2.2 数据到了主机,怎么找到目标进程
1. 缺的那一层标识
- IP 已经解决了「定位到哪台主机」,再往下还缺一层------主机内部交给哪个进程
- 目标主机上同时跑着几十上百个进程,报文到了主机,操作系统得知道交给谁
2. 端口号来补这一层
- 要在主机的众多进程里锁定目标,就需要一套在网络背景下成立的进程标识
- 这套标识就是端口号------它属于传输层,干的就是「认进程」这件事
自此,全网内的唯一进程就可以找到了
IP 把数据送到哪台主机,端口号把数据送进哪个进程,两层标识合起来才算送达。
三、端口号:传输层标识进程的 2 字节整数
3.1 端口号是什么
1. 一个 16 位的整数
- 端口号是传输层协议的内容,由操作系统内核维护
- 它是一个 2 字节、16 位的整数,取值范围 0 到 65535
- 用途只有一个:标识主机上的一个网络进程,告诉操作系统这份数据该交给谁处理
2. 范围怎么分
| 范围 | 名称 | 用途 |
|---|---|---|
| 0~1023 | 知名端口号 | HTTP、FTP、SSH 等广为使用的应用层协议,端口号固定不变 |
| 1024~65535 | 动态分配端口号 | 操作系统动态分配,客户端程序的端口号从这里来 |
3.2 PID也是标识进程的,为什么不用 PID 标识网络进程
1. PID 走不出这台主机
PID 是操作系统内部概念,每台主机各自分配,两台机器完全可能撞号- 各操作系统的 PID 规则还不统一,网络要跨平台,就得找一套跟具体系统无关的标识
2. 不是所有进程都要联网
- 本地不碰网络的进程一大把,让网络协议去绑定 PID 这种系统概念,纯属自找麻烦
端口号只给网络进程用,按需分配
3. 为了解耦
- 真拿 PID 做网络标识,系统进程管理和网络协议栈就强耦合了
- 一个进程可以绑定多个端口号,但一个端口号不能让多个进程绑定;绑定关系由内核维护着一张映射表记着
3.3 认端口不认工号:10086 的例子
1. 打的是号码,不是工号
- 打 10086 找移动客服,你只拨 10086 这个号码,不关心里面接电话的是哪个客服、工号多少
- 10086 是服务的固定入口,背后由谁来接听,系统自己调度
2. 端口号就是网络世界的 10086
- 客户端访问服务器的 8080 端口,不需要知道背后进程的 PID
- 进程重启、PID 变了,只要还绑着 8080,服务就照常能被找到
网络认端口,不认PID:对外的是服务的固定入口,背后是谁在接,内部自己安排。
3.4 绑定规则与源目的端口号
1. 两条硬规则
- 一个进程可以绑定多个端口号,一个软件同时开多个网络服务,多个入口各挂各的
- 一个端口号只能被一个进程占用,两个进程抢一个端口,后绑的直接失败,这就是端口冲突
2. 报文里的两个字段
- 传输层协议(TCP 或 UDP)的数据段里带着两个端口字段:源端口号和目的端口号
- 它们描述这份数据是谁发的、要发给谁;再加上 IP 报头里的源 IP 和目的 IP,一份报文的来路和去向就配齐了
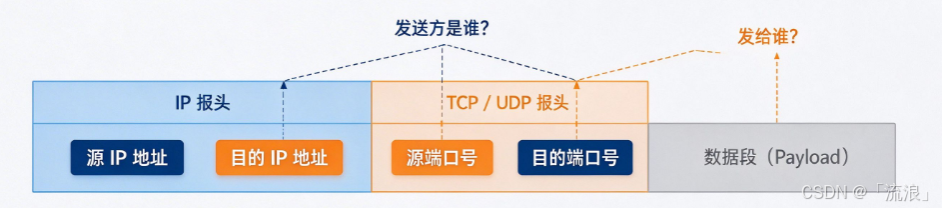
一个进程可以挂多个端口,一个端口只能挂一个进程------前者是服务多入口,后者是收包反查必须唯一。
四、socket 与四元组:全网唯一定位两个进程
4.1 IP 加端口号就是 socket
1. 拼出唯一进程
- IP 地址标识互联网中唯一的一台主机,端口号标识这台主机上唯一的一个网络进程
- 两块一拼,IP 加端口号就能定位互联网中唯一的一个进程
2. 名字的来头
- 这个组合叫套接字 socket,词源是插座、插口
- 插上它,进程就接进了网络
4.2 四元组锁定通信双方
1. 通信要锁住两个进程
- 一次通信牵扯的是两个进程,你一个、我一个,得同时锁住
- {源IP,源端口,目的IP,目的端口} 这样的四元组,正好把双方各锁一次
2. 网络通信的本质
- 两个主机上的两个进程,各自代表各自的主人,靠四元组互相锁定
网络通信的本质,就是跨主机的进程间通信
4.3 TCP 和 UDP 的直观认识
1. 两个典型协议
| TCP | UDP | |
|---|---|---|
| 连接 | 有连接 | 无连接 |
| 可靠性 | 可靠传输 | 不可靠传输 |
| 数据形态 | 面向字节流 | 面向数据报 |
2. 找进程用的是同一套
- TCP 和 UDP 的报头里都带着端口字段
- 不管走哪个协议,找进程用的都是同一套「IP 加端口号」的机制
socket 把 IP 和端口号拼成全网唯一的门牌,四元组把通信双方一起锁住------网络通信回到最底,还是两个进程在通话。
五、传输层怎么用端口号找到进程:一张哈希表
5.1 bind:把进程链入哈希表
1. 先挂钩,再收包
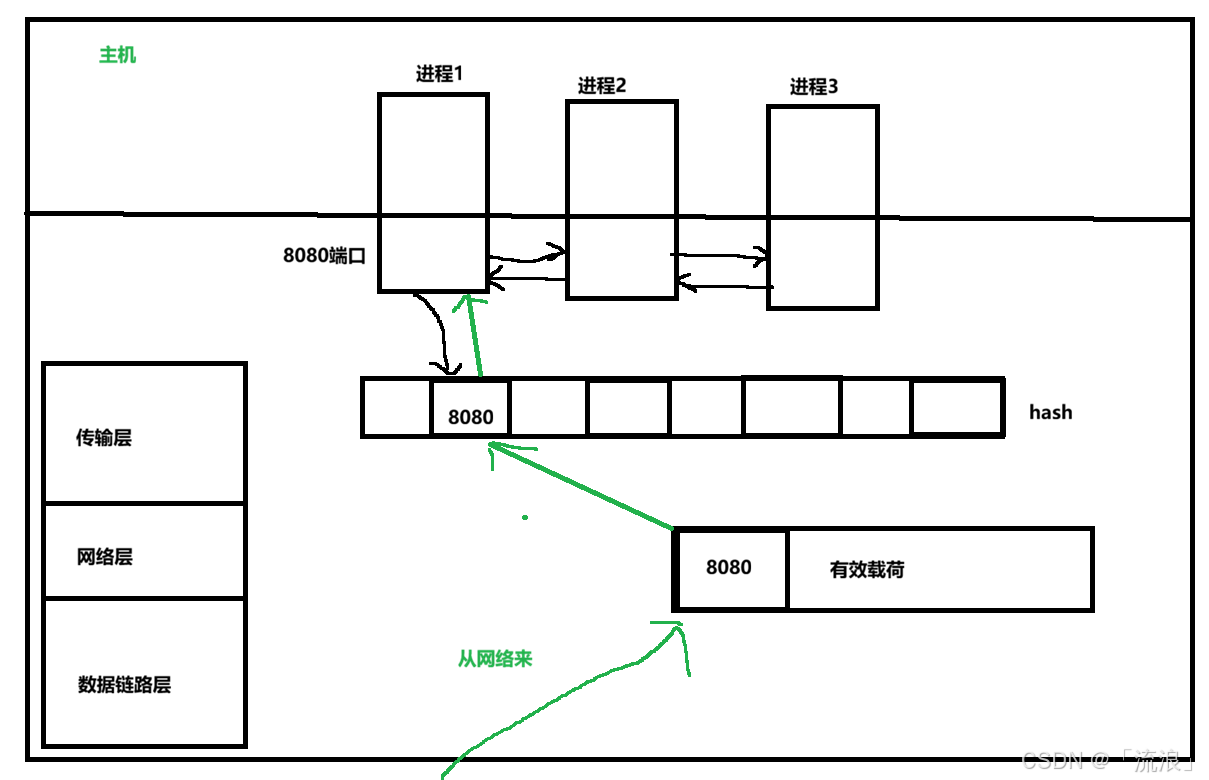
- 操作系统在传输层维护着一张哈希表(hash 表)
- 一个进程想收 8080 端口的数据,得先把自己和 8080 关联起来,这个动作就是绑定 bind
- 具体做的是:拿着 8080 在哈希表里找到对应位置,把进程的 PCB(进程控制块,Linux 里就是 task_struct)链入到这个位置上
2. 挂钩发生在报文之前
- bind 发生在报文到来之前,先把「8080 到进程」的映射挂进表里
- 之后无论数据什么时候到,都查得到
3. 顺带解释端口冲突
- 8080 的位置已经被一个进程占了,第二个进程再拿 8080 来链入,同一格放不下第二条绑定关系
- 绑定失败,报端口被占用------这就是 3.4 那条规则的底层原因
5.2 收包:拿目的端口反查进程
1. 报文到了以后
- 报文等于报头加有效载荷,报头里带着目的端口 8080
- 传输层解包,提取出报文要去的那个目的端口
2. 查表交付
- 拿着目的端口在哈希表里反向一查,找到链在该端口上的进程
- 把后面的有效载荷交付给这个进程
3. 内核就是这么干的
- 计算机网络篇2讲封装分用时说过,数据逐层剥掉报头向上交付
- 交到传输层这层的最后一步「交给哪个进程」,靠的就是这张表的反查;Linux 内核里 TCP 和 UDP 各维护着以端口号为索引的哈希表,比如 UDP 的 udp_table,bind 的本质就是往表里挂 socket
一个端口挂一个进程,加一张哈希表,就是「数据找到进程」的全部机制------定位被做成了查表。
六、网络字节序:发到网络上的数据必须是大端
6.1 大端与小端
1. 两派对多字节数据的不同排法
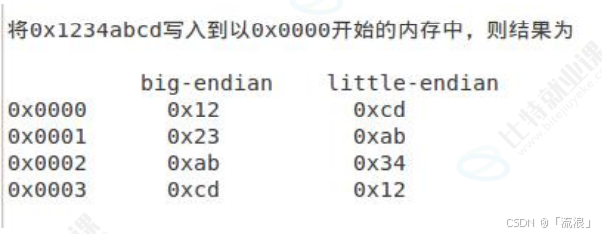
以 4 字节数 0x1234abcd 为例:
| 内存方向(低到高) | 大端(Big-Endian) | 小端(Little-Endian) |
|---|---|---|
| 第 1 字节到第 4 字节 | 12 34 ab cd | cd ab 34 12 |
- 大端把高位字节放在低地址,和人类书写数字的顺序一致
- 小端把低位字节放在低地址,x86 和多数 ARM 都是小端机
2. 怎么看自己的机器是哪派
- 定义一个 int 等于 1,也就是 0x00000001
- 把它的地址强制转成 char 指针再解引用,取到最低地址处那个字节
- 读出来是 1,说明低位字节在低地址,是小端机;是 0,说明高位字节在低地址,是大端机
c
int i = 1;
char *p = (char*)&i;
printf(*p == 1 ? "小端\n" : "大端\n");
6.2 网络数据流的规定
1. 不统一就全乱套
- 两台字节序不同的机器通信,你按小端发 0x1234abcd,对方按大端解读成 0xcdab3412,数字直接对不上
2. TCP/IP 的三条规定
- 发送主机 把发送缓冲区的数据按内存地址从低到高的顺序发出
- 接收主机 把收到的字节也按内存地址从低到高保存,先发出的数据是低地址,后发出的数据是高地址
- 网络数据流必须采用大端字节序,也就是低地址放高字节:所有发送到网络上的数据,都必须是大端
3. 谁转换谁不转换
- 小端主机发送多字节数据前,要先把数据转成大端
- 大端主机不用转,直接发;不管哪台机器,网络上的字节流永远只有一种排法
网络字节序统一规定成大端,不是为了谁更方便,而是为了让「先发的低地址」在全网只有一种解释。
6.3 转换函数 htonl、htons、ntohl、ntohs
1. 名字全是缩写
- h 是 host,主机;n 是 network,网络;l 是 32 位长整数;s 是 16 位短整数
- 记住这四个字母,函数名不用背
2. 四个函数的方向
| 函数 | 方向 | 典型对象 |
|---|---|---|
| htonl | 主机到网络 | 32 位 IP 地址 |
| htons | 主机到网络 | 16 位端口号 |
| ntohl | 网络到主机 | 32 位 IP 地址 |
| ntohs | 网络到主机 | 16 位端口号 |
3. 函数接口
cpp
#include <arpa/inet.h>

uint32_t htonl(uint32_t hostlong);   // 主机序32位整数 → 网络序(多用于IP地址)
uint16_t htons(uint16_t hostshort);  // 主机序16位整数 → 网络序(多用于端口号)
uint32_t ntohl(uint32_t netlong);     // 网络序32位整数 → 主机序(htonl的逆操作)
uint16_t ntohs(uint16_t netshort);   // 网络序16位整数 → 主机序(htons的逆操作)
4. 大端机上什么都不做
- 主机是小端机,函数把参数做大小端转换后返回
- 主机是大端机,函数不做转换,参数原封不动返回------这组函数屏蔽了主机差异,同一份代码跨平台编译行为一致
4. 本篇主角走的是 htons
- 写网络程序时,端口号、IP 地址这些要填进报头的多字节字段,都得先过这组函数
- 本篇主角端口号是 16 位两字节,走的函数就是 htons
七、文末面试题
7.1 推导题
1. 网络通信为什么不用 PID 标识进程,而要专门设一个端口号?
答(推导):PID 是操作系统内部概念,每台主机独立分配、可能撞号,各系统的 PID 规则也不统一,跨平台网络用不了;而且不是所有进程都要联网,让网络协议去绑定 PID,会把系统进程管理和网络协议栈强耦合。端口号归传输层、PID 归进程管理,两套标识各管各的,这是解耦的设计。
2. 一个进程可以绑定多个端口号,一个端口号却不能被多个进程绑定,为什么?
答(推导):绑定的实现是传输层哈希表上挂 PCB,一个进程可以在多个端口位置挂上自己,入口多几个不冲突;但一个端口位置的反查结果必须唯一,挂了两个进程,收包查表就有歧义,载荷不知道交给谁。所以「一个进程多个端口」可以,「一个端口多个进程」不行。
3. 网络字节序为什么必须统一规定,而不能各发各的?
答(推导):协议的本质是约定,大端小端本身没有对错,关键在于全网必须统一。TCP/IP 选定大端后,小端主机发送前用 htonl、htons 转换,大端主机直接发,一组转换函数屏蔽了主机差异,同一份 C 代码在大端机和小端机上编译后行为一致,这就带来了可移植性。
7.2 真题
1. 在客户机/服务器模型中,服务器通常使用什么来标识特定服务?
答(推导 · 已对照解析,转述):选项是 MAC 地址、端口号、线程号、进程号,正确答案是端口号。服务器通过不同端口号向网络公开不同的服务,客户端用目的 IP 加端口号定位并访问特定服务;进程号是操作系统内部的管理标识,对网络客户端不可见。
【真题·转述自 51CTO 软考真题解析】
2. 请写出一段代码判断当前机器是大端还是小端。
答(推导 · 已对照解析,转述):定义一个 int 等于 1,把它的地址强制转成 char 指针再解引用,取最低地址处的字节:是 1 说明低位字节在低地址,是小端机;是 0 说明高位字节在低地址,是大端机。原理在于 1 在小端下内存布局是 01 00 00 00,大端下是 00 00 00 01,看第一个字节落在谁身上就能判出来。
【真题·转述自 CSDN 博客记载的百度面试题】
这一篇把「数据找到进程」的最后一段路修通了:端口号是进程的网络身份牌,socket 把它和 IP 拼成全网唯一的门牌,一张哈希表让数据进门就能找到人。评论区聊聊:端口号和 PID 还有哪些容易混的点?