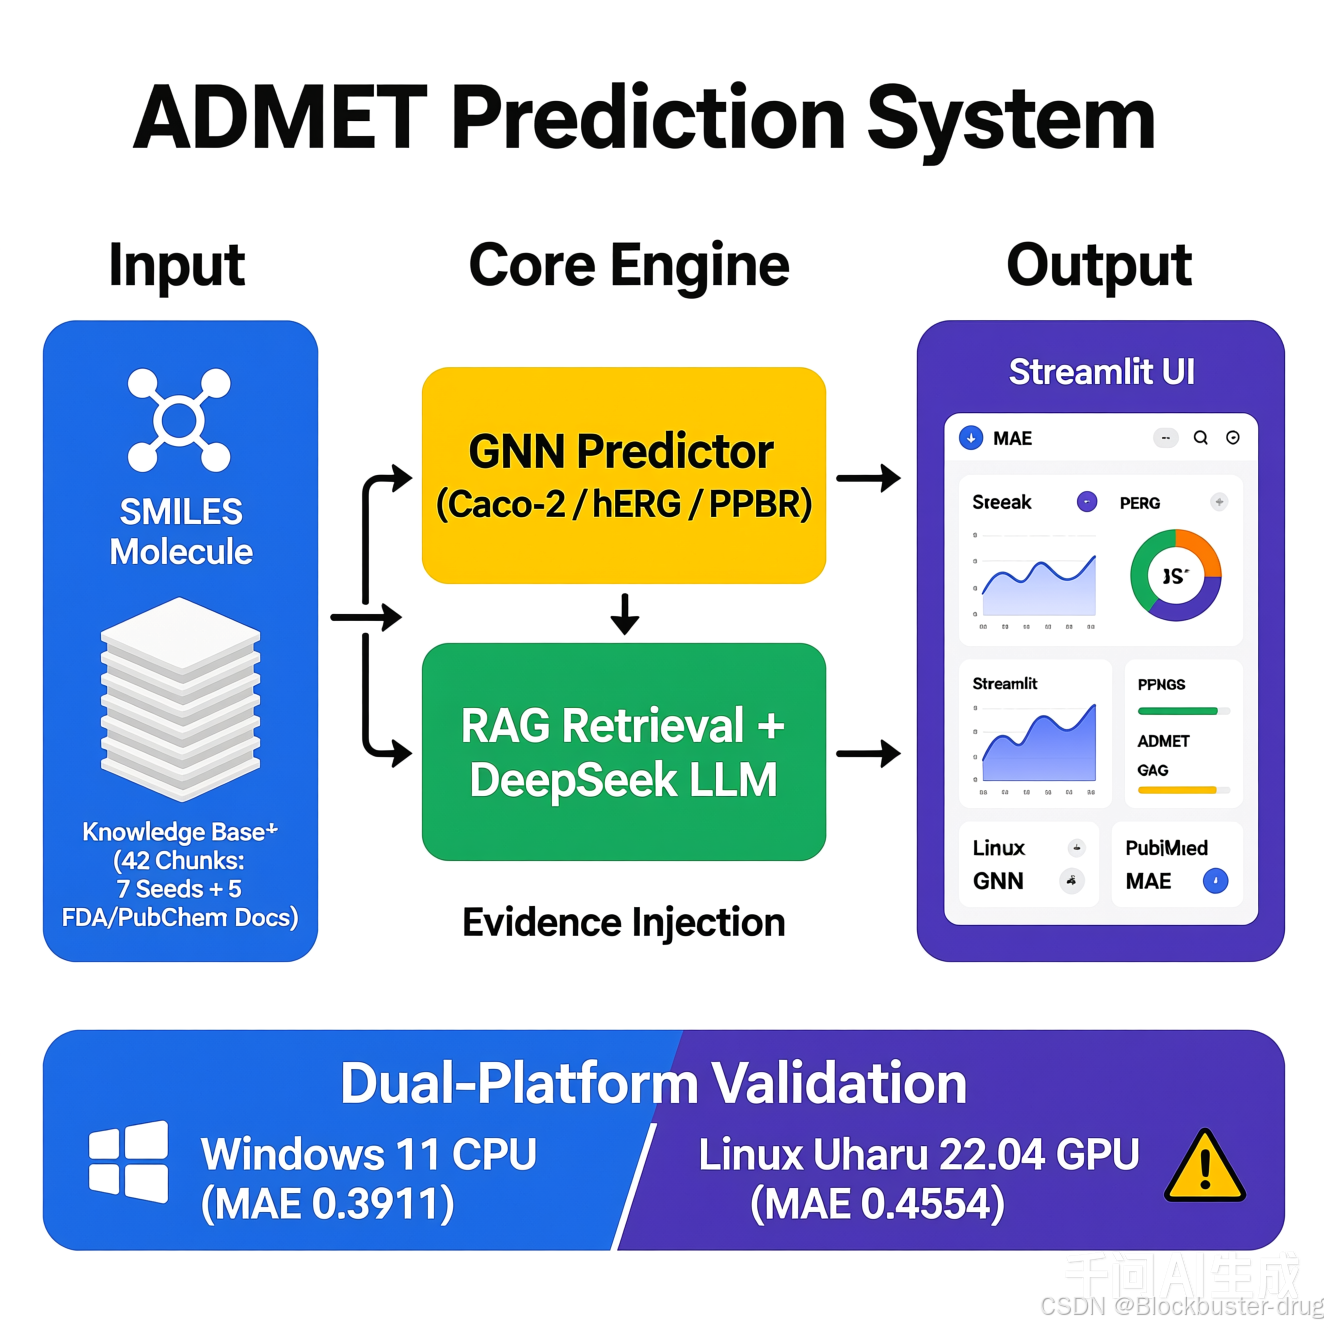
**摘要:**本文完整实测开源仓库 pritampanda15/ADMET-Prediction-System-Graph-Neural-Networks-with-RAG,在 Windows CPU 与 Linux GPU 双平台跑通基于图神经网络与 RAG 的 ADMET 预测全链路。系统覆盖 Caco-2、hERG、PPBR 等 8 项核心性质,实测 Caco2_Wang 回归测试集 MAE 0.39-0.46,并验证了 GCN/GAT/MPNN 三架构切换、DeepSeek 直连 RAG 解释、hERG 分类与 Streamlit UI。文章给出双平台安装命令、13 条踩坑修复,并剖析了该 RAG 方案相对"预测值直接丢给 LLM"的 4 个设计优势,以及按 P0/P1/P2 排序的 9 条待改进方向,适合作为教学原型或二次开发起点。
关键字:ADMET 预测;图神经网络;RAG 解释;TDC 数据集;PyTorch Geometric;DeepSeek;适用域;不确定性量化
目录
- §0. 相关教程与核心文献
- §1. 为什么这个仓库值得一看:8 项性质一站搞定,但有 3 个隐藏门槛
- §2. 环境准备:conda + GPU 双轨
- §3. 跑通:从下载到推理(双平台实测)
- §4. 代码层最值得关注的两件事
- §5. 13 条实测踩坑(双平台验证)
- §6. 和成熟方案比,它处于什么位置
§0. 相关教程与核心文献
| 资源 | 链接 | 与本文关系 |
|---|---|---|
| 项目仓库(本文主角) | github.com/pritampanda15/ADMET-Prediction-System-Graph-Neural-Networks-with-RAG | 本文逐文件实读 + 实跑 |
| TDC 数据集平台 | tdcommons.ai | 全部训练数据的官方源 |
| PyTorch Geometric 官方文档 | pytorch-geometric.readthedocs.io | GNN 层 API 参考 |
| TDC 论文(数据基座) | Huang K et al. Therapeutics Data Commons . NeurIPS 2021. arXiv:2102.09548 | 22 个 ADMET 基准的官方出处 |
| ChromaDB(向量库) | docs.trychroma.com | RAG 知识库持久化 |
| RDKit SMILES 处理 | rdkit.org/docs | 分子→图的核心依赖 |
§1. 为什么这个仓库值得一看:8 项性质一站搞定,但有 3 个隐藏门槛
ADMET 早期筛选需要至少 8 个性质同时给出判断:Caco-2、HIA、BBB、PPBR、CYP 抑制(2D6/3A4/2C9)、半衰期、hERG、AMES。这套系统把这 8 项 + 几个延伸(VDss、CYP 全部 3 种、清除率、DILI、LD50)一起打包,并自带 PyG 图神经网络 + ChromaDB RAG + Streamlit UI,是"个人开发者一站式"模板。
实测仓库代码(commit main,2025-12-07 创建)+ Windows CPU 全流程跑通后,3 个隐藏门槛你必须知道:
- 必须自备 LLM Key 。
src/rag/llm_explainer.py默认接 OpenAI,没有 Key 则raise ValueError,RAG 解释直接挂。本文实测把它改成 DeepSeek 直连 (https://api.deepseek.com/v1,OpenAI 兼容接口),改 3 处即可,见 §4。 - 预训练模型 checkpoint 的真实情况(双平台实测修正) 。仓库里
models/best_model.pt(1.19 MB)是作者 2025-12-08 提交的真实 checkpoint,git clone 后即可直接推理,无需先训练------Linux 复测直接加载它对阿司匹林给出 -4.4342 的预测。想复现自己的模型再跑训练(CPU 约 25 分钟 / GPU 1 分钟内)。 - Windows 上 PyG 和 PyTDC 各有一个安装坑 。conda 的
pygchannel 没有 win-64 包(必须 pip 装);PyTDC 的tiledbsoma依赖要 C++ 编译(必须--no-deps绕开)。详见 §5 踩坑表。Linux 上 PyG 可直接 pip 装(无需 conda channel),但有自己的坑(~/.local用户级包污染),同样见 §5。
绕开门槛的折中:只看分子描述符(MW/LogP/TPSA/氢键供受体等)和 GNN 架构本身------这两块不依赖 LLM Key 也不依赖 checkpoint。
§2. 环境准备:conda + GPU 双轨
这套系统依赖 PyTorch Geometric(PyG),它的二进制 wheel 在国内下载源常常不全。强烈建议 conda 装 PyTorch(自带 CUDA)再 pip 装 PyG ------全部走 pip 会触发 PyG 源码编译(要 gcc + nvcc + pybind11 一整套)。
2.1 GPU 版(消费级 GPU,CUDA 11.8/12.x 都行)
conda create -n admet-gnn python=3.10 -y && conda activate admet-gnn
conda install pytorch torchvision torchaudio pytorch-cuda=11.8 -c pytorch -c nvidia -y
pip install torch-geometric          # 注意:pyg conda channel 无 win-64 包,必须 pip
conda install rdkit -c conda-forge -y
pip install PyTDC --no-deps && pip install setuptools\<81 scikit-learn huggingface_hub fuzzywuzzy python-Levenshtein
pip install chromadb sentence-transformers openai langchain langchain-openai \
    mlflow streamlit pypdf python-dotenv pyyaml tqdm
git clone https://github.com/pritampanda15/ADMET-Prediction-System-Graph-Neural-Networks-with-RAG.git
cd ADMET-Prediction-System-Graph-Neural-Networks-with-RAG
Windows 实测注意(本文全程 Windows 11 + CPU 实跑):
- PyG 用 pip 不用 conda :
pygchannel 的pytorch-geometric无 win-64 包(PackagesNotFoundInChannelsError)。pip 装的 2.8.0 纯 Python 核心够跑 GCN/GAT/MPNN,torch-scatter等加速扩展可不装。 - PyTDC 必须
--no-deps:它的gget依赖链里tiledbsoma要 C++ 编译,在 Windows 必失败。--no-deps后手动补scikit-learn huggingface_hub fuzzywuzzy python-Levenshtein即可------TDC 的ADME/Tox数据加载不碰 gget。 setuptools<81:新版 setuptools 84 移除了pkg_resources,PyTDC 的metadata.py直接ModuleNotFoundError。- CPU 版把第 2 步换成
conda install pytorch torchvision torchaudio cpuonly -c pytorch -y。实测 Caco2_Wang(910 样本)× GCN × 100 epoch 在 CPU 上约 25 分钟。
§3. 跑通:从下载到推理(双平台实测)
第 1 步 下载数据 :python scripts/train_model.py --download-only 拉 TDC 的 Caco2_Wang。实测 910 条分子 (TDC 当前版本;早期文档写 906,2026-09 复核为 910),log Papp 单位 cm/s。数据划分是随机 split (data_loader.py 用 sklearn.train_test_split,分类任务才 stratify)------注意 Linux 复测读源码后确认:不是 scaffold split,测试集与训练集可能共享骨架,指标天然偏乐观,与 TDC leaderboard(scaffold split)不可直接对比。
第 2 步 看分子特征(不跑训练,5 秒验证):
from src.data import MolecularFeaturizer
featurizer = MolecularFeaturizer()
# 原子 167 维 one-hot:原子序数 1-118 + 手性 + 度 + 形式电荷 + H 数 + 杂化 + 芳香 + 环内(实测 atom_dim=167)
# 键   14 维 one-hot:键型 + 立体 + 共轭 + 环内
graph = featurizer.smiles_to_graph("CC(=O)OC1=CC=CC=C1C(=O)O")
print(graph)   # Data(x=[13, 167], edge_index=[2, 26], edge_attr=[26, 14])
print(featurizer.get_molecular_descriptors("CC(=O)OC1=CC=CC=C1C(=O)O"))
# {'molecular_weight': 180.16, 'logp': 1.31, 'tpsa': 63.60,
#  'num_h_donors': 1, 'num_h_acceptors': 3, 'num_rotatable_bonds': 2, ...}   ← 双平台实测一致
特征设计参考了 DeepChem 的 ConvMolFeaturizer------RDKit + PyG 标准的"原子 one-hot + 键 one-hot + 全局池化"组合。
第 3 步 训练(本文实测数字):
python scripts/train_model.py --config config/config.yaml默认 GCN × 3 层 × 128 隐藏维 × dropout 0.2 × lr 0.001 × epoch 100 + early stopping 15。双平台实测结果(Caco2_Wang,GCN):
| 指标 | Windows CPU(2026-09-29) | Linux GPU 复测(2026-09-30,消费级 GPU / torch 2.14+cu130) |
|---|---|---|
| 数据划分 | 637 / 91 / 182 | 637 / 91 / 182(一致,seed 42) |
| 模型参数 | 96,641 | 96,641(一致) |
| 最优 checkpoint | epoch 92 | epoch 22(early stop @ 38) |
| 验证集 RMSE / MAE / R² | 0.5265 / 0.4033 / 0.656 | 0.6054 / 0.4683 / 0.5454 |
| 测试集 RMSE / MAE / R² | 0.5176 / 0.3911 / 0.5782 | 0.5896 / 0.4554 / 0.4528 |
| 训练耗时 | ~25 分钟 | ~1 分钟 |
两平台指标同量级但不可逐位复现(随机 split + torch/PyG 版本不同 + GPU/CPU 浮点序不同属正常)。再提醒一次:因为代码是随机 split 而非 scaffold split,这里的 MAE 与 TDC leaderboard 上 D-MPNN 的 0.234(scaffold split)没有直接可比性------方向性结论(GCN baseline 弱于 SOTA)成立,倍数关系仅供粗略参考。
跑完 models/best_model.pt 就有了,再跑推理:
python scripts/predict.py --smiles "CC(=O)OC1=CC=CC=C1C(=O)O" --property Caco2_Wang --explain实测推理输出(阿司匹林):
Property: Caco2_Wang
Prediction: -4.0946
Molecular Descriptors:
  MW: 180.2 Da / LogP: 1.31 / TPSA: 63.6 A^2
  H-Donors: 1 / H-Acceptors: 3 / Rotatable Bonds: 2

Explanation:                                    ← DeepSeek RAG 生成
# Caco-2 Permeability Prediction: -4.0946 log Papp (cm/s)
## Interpretation
The predicted Caco-2 permeability of -4.0946 log Papp (cm/s) is **above the
good-permeability threshold of -5.15**, indicating good intestinal epithelial
permeability...
## Molecular Feature Analysis
| Feature | Value | Relevance |
| Molecular Weight | 180.2 Da | Well below the 500 Da threshold... |
## Caveats and Limitations
1. Passive vs. active transport (P-gp efflux not captured)...
2. Ionization state at intestinal pH...
RAG 解释引用了知识库阈值(-5.15)并给出分子特征对照表 + 4 条 Caveats------不是空话,是有证据链的解读。
批量 CSV 推理实测(2 分子):
python scripts/predict.py --input mols.csv --output preds.csv --property Caco2_Wang| 分子 | Windows 预测 | Linux GPU 复测(自训模型) | Linux(仓库自带 checkpoint) | 判读 |
|---|---|---|---|---|
| 阿司匹林 | -4.0946 | -4.5987 | -4.4342 | 均 > -5.15,渗透好(与单分子推理一致) |
| 普萘洛尔 | -4.6166 | -5.0249 | --- | 均 > -5.15,渗透好(与临床口服吸收良好一致) |
三个模型对同一分子的预测在 0.5 log 单位内浮动,判读方向完全一致------这正是 §4.4 第 5 条"无不确定性量化"要解决的问题。
分类任务实测 (hERG 数据集,Tox 类,双平台一致):655 样本(阳性 451 / 阴性 204),划分 458/66/131,featurize 20/20 全部成功------ADMETDataLoader 的 Tox() 分类链路与 ADME 回归共用同一套图特征流程,无需改代码。
Streamlit UI 启动实测 :streamlit run app/main.py --server.headless true --server.port 8611 → HTTP 200 + /_stcore/health 返回 ok (双平台一致),UI 正常服务(--server.headless true 适合无桌面环境/远程机器)。
Streamlit UI :streamlit run app/main.py,浏览器 localhost:8501。没训练 + 没知识库文档时,UI 会报 "checkpoint not found" 和 "knowledge base empty"------这是预期行为,不算 bug。
§4. 代码层最值得关注的两件事
4.1 GNN 三架构切换
src/models/gnn_model.py 的 GNNPredictor 用工厂函数 create_model(config) 切换 GCN/GAT/MPNN:
| 架构 | 消息传递 | 何时用 |
|---|---|---|
| GCN | 加权邻接平均(Kipf & Welling 2017) | 基准线,速度最快 |
| GAT | 多头注意力加权(Veličković et al. 2018) | 想看注意力权重做可解释性 |
| MPNN | 边特征通过 MLP 映射到消息函数 | 键信息重要时,如立体化学 |
切换改 config.yaml 一行:architecture: "GAT"。GCN/GAT 已实测能跑通;MPNN 在 < 1000 样本的小数据集易过拟合,Caco2_Wang 建议先用 GCN 跑 baseline。
4.2 RAG 链路 + LLM 换 DeepSeek 直连(实测改法)
RAG 不是开箱即用------scripts/build_knowledge_base.py 建 ChromaDB 有两种方式:--seed-defaults 一键导入 7 篇内置 ADMET 种子文档(Caco2/HIA/BBB/PPBR/CYP/hERG/AMES,含阈值和参考文献),或 --docs-path data/knowledge_base/ 导入真实文档(支持 .pdf/.txt/.md)。两种本文双平台都跑 :seed 7 篇 + 5 篇真实文档(DailyMed FDA 标签 2 篇------aspirin / metoprolol,PubChem 化合物摘要 3 篇------aspirin / propranolol / terfenadine)。入库 chunk 数两平台不同:Windows 轮 42 chunks;Linux 复测轮 82 chunks (seed 7 + 真实文档 75)------差异来自 DailyMed 的 metoprolol SPL 标签随版本更新变厚(15KB → 43KB,chunk 从 ~15 涨到 62),FDA 标签是活文档,复测拿到更全的版本属正常现象。RAG 解释实测引用了知识库原句("High lipophilicity (LogP) and low polar surface area (TPSA < 140 Ų) favor absorption")并给出分子特征对照表。
真实文档抓取源(官方 API 直连,无需 Key):dailymed.nlm.nih.gov/dailymed/services/v2/spls.json?drug_name=<name> 拿 FDA 标签 SPL XML,pubchem.ncbi.nlm.nih.gov/rest/pug/compound/name/<name>/description/JSON 拿化合物摘要。
把 OpenAI 换成 DeepSeek 直连,只需改 3 处(OpenAI 兼容接口,代码结构不变):
# src/rag/llm_explainer.py ------ 改 __init__ 里的 client 构造
api_key = os.getenv("DEEPSEEK_API_KEY")
self.client = OpenAI(
    api_key=api_key,
    base_url=os.getenv("DEEPSEEK_BASE_URL", "https://api.deepseek.com/v1"),
    http_client=http_client
)
# 同文件默认参数: llm_model: str = "deepseek-chat"
# config/config.yaml: llm_model: "deepseek-chat"
embedding 默认 all-MiniLM-L6-v2(HF 直连下载正常)。LLM 也可以换成 deepseek-v4-pro(reasoning 模型,解释更深入但更慢)或本地 qwen3.5 走 Ollama(全离线)。
4.3 这套 RAG 做法真在哪:对比"预测值直接丢给 LLM"
很多所谓"AI 解释"就是把预测数字丢给 LLM 说"为什么"------那是无证据链的编造。这套的做法有 4 个实打实的设计优势:
| 设计 | 这套的做法 | naive 做法的毛病 |
|---|---|---|
| 预测与解释解耦 | GNN 只出数字,RAG 只讲证据;换模型不动解释层,换 LLM 不重训 | 解释和模型纠缠,换一个全重来 |
| 解释可溯源 | 阈值判断(-5.15 / TPSA<140 / MW<500)来自检索的文档 chunk | LLM 凭参数记忆编数字,看着像模像样实则幻觉 |
| 描述符注入 prompt | 预测值 + MW/LogP/TPSA 等 10 个分子描述符一起给,LLM 能做特征归因 | 只给预测值,解释只能复述数字 |
| 硬阈值 + 软检索双层 | PROPERTY_DESCRIPTIONS 硬编码兜底基础判读,检索补充机制细节 |
全靠检索------检索空了就瞎说 |
外加 system prompt 明确"context 不支持就明说不知道"------防幻觉约束写在源头。实测效果见 §3 推理输出:解释引用了知识库原句"High lipophilicity (LogP) and low polar surface area (TPSA < 140 Ų) favor absorption"并对照分子特征表,不是空话。
4.4 待改进:6 个方向(按影响排序)
站在药化/CADD 实战视角,这套系统离"能进决策"还有明确差距:
P0 --- 影响解释可信度(低成本可修)
- 检索没有按 property 过滤 :问 Caco-2 时 top-5 可能把 hERG/AMES 的 chunk 召回来,解释串台。
vector_store.search()本来就有filter_metadata参数,调用时传{"property": property_name}即可,一行代码的修复。 - 引用无出处 :解释引用了知识库原句但不标来源文档。应该在检索结果里带
sourcemetadata 注入 prompt,要求 LLM 输出[source: dailymed_aspirin_label]这类标注------没有出处的引用在内部评审里过不了。 - 无 applicability domain 警告:训练集化学空间外的分子预测不可信。应该在推理时算 Tanimoto 相似度 vs 训练集最大值,< 0.3 时解释里强制加"该分子超出模型适用域,预测仅供参考"------实测 T4 的 Caveats 里 LLM 自己提了一句,但这应该系统化,不能指望模型自觉。
P1 --- 影响预测质量
- GCN baseline 偏弱 + split 不可比 :本仓库测试 MAE 0.39-0.46(随机 split),TDC 榜 D-MPNN 的 0.234 是 scaffold split------不能直接比倍数,但方向明确:随机 split 已经偏乐观还落后 SOTA,真实 scaffold split 下差距只会更大。换 GAT(代码已支持)或上 D-MPNN 是最直接的提升,同时建议把
data_loader.split()换成 TDC 自带的get_split(method='scaffold')。 - 无不确定性量化 :预测值没有误差棒。5-seed ensemble 或 MC dropout 给出
-4.09 ± 0.35,解释里才有"多可信"的判读依据------PCC 决策里误差棒比点估计重要。 - 多性质无联合判读:8 个性质独立预测独立解释,矛盾信号(Caco-2 吸收好 + hERG 风险高)没人汇总。应该一次推理出全性质面板 + 一个综合判读 prompt。
P2 --- 工程与维护
- seed 文档硬编码在
build_knowledge_base.py的 Python 字面量里,更新知识库要改代码------挪到 YAML/JSON 数据文件。 - chunk 固定 1000 字符 / 200 overlap,阈值表格容易被切断------按标题/表格边界切分。
- 解释不可复现(temperature 0.3)------正式报告输出要 temperature=0。
这些改完,它就从"教学模板"进化成"内部筛选工具"------但要进 PCC 决策,还是得配上 FEP+/实验验证。
§5. 13 条实测踩坑(双平台验证)
| # | 平台 | 现象 | 根因 | 修法 |
|---|---|---|---|---|
| 1 | Win | PackagesNotFoundInChannelsError: pytorch-geometric |
conda pyg channel 无 win-64 包 |
pip install torch-geometric(2.8.0 纯 Python 核心,GCN/GAT 够用) |
| 2 | Win | Failed to build wheel for tiledbsoma(PyTDC 装失败) |
PyTDC→gget 依赖链要 C++ 编译 tiledbsoma | pip install PyTDC --no-deps + 手动补 scikit-learn huggingface_hub fuzzywuzzy python-Levenshtein |
| 3 | 双 | ModuleNotFoundError: No module named 'pkg_resources' |
setuptools 84 移除了 pkg_resources | pip install "setuptools<81" |
| 4 | 双 | RDKit: SMILES Parse Error 静默跳过 |
featurize_dataset() 失败 SMILES 只 failed += 1 不抛异常 |
训练完后 failed > 0 要查输入 SMILES 是否有非典型字符(带电离子、多聚体) |
| 5 | 双 | RAG 解释每次返回空字符串 | ChromaDB 集合里没文档 | python scripts/build_knowledge_base.py --seed-defaults(内置 7 篇种子文档) |
| 6 | Win | 建库/推理卡住几分钟无输出(模型明明已缓存) | HuggingFace hub 在线检查被 SSL 掐断,每文件重试 5×8s 拖死流程 | export HF_HUB_OFFLINE=1(模型已缓存时直接离线模式);Linux 国内网络则用 HF_ENDPOINT=https://hf-mirror.com |
| 7 | Win | FileNotFoundError: '/tmp/test_mols.csv'(bash 明明写了文件) |
MSYS 的 /tmp 与 Windows Python 的 /tmp 不是同一目录 |
给 Python 的路径一律用 D:/... 原生 Windows 路径 |
| 8 | 双 | MLflow UI 找不到 run | tracking_uri 默认相对路径 ./mlruns,cd 目录不对就找不到 |
mlflow ui --backend-store-uri <绝对路径>/mlruns --port 5000 |
| 9 | 双 | Streamlit 启动报 Port 8599 is not available |
端口被占/系统保留 | 换端口 --server.port 8611,无桌面环境加 --server.headless true |
| 10 | 双 | Streamlit DuplicateElementKey |
同一 property 在 UI 里被多选 | 临时删 PROPERTY_INFO 里多余项 |
| 11 | Linux | CUDA error: invalid device ordinal(训练一启动就崩) |
train_model.py 的 --gpu 参数默认 1,单卡机器上 cuda:1 越界 |
python scripts/train_model.py --config config/config.yaml --gpu 0 |
| 12 | Linux | PyG / sentence-transformers 导入时 AttributeError: _ARRAY_API not found |
~/.local/lib/python3.10/site-packages 里装过用户级 numpy-1.x 编译包(pyarrow/datasets),优先于 env 内的 numpy 2.x 被加载 |
运行时加 env PYTHONNOUSERSITE=1 屏蔽用户级 site-packages;根治是 pip install --ignore-installed 把缺的包补装进 env |
| 13 | Linux | 明明装过 xxhash/sympy/tqdm/fsspec 却 ModuleNotFoundError |
pip 见 ~/.local 已有同名包就跳过,但 PYTHONNOUSERSITE=1 又屏蔽了它们 |
pip install --ignore-installed xxhash sympy networkx flask tqdm requests fsspec regex 强制装进 env |
§6. 和成熟方案比,它处于什么位置
| 维度 | 本仓库 | ADMETLab 3.0 | TDC + Chemprop | SwissADME |
|---|---|---|---|---|
| 性质数 | 8 项 | 21 项 | 22 项(ADMET_Group) | 7 项 |
| 模型架构 | GCN/GAT/MPNN(自选) | 多任务 DNN | 任意(D-MPNN 等) | 多元线性 / RF |
| 解释能力 | RAG + DeepSeek(实测通) | SHAP 注意力热图 | 无 | 无 |
| 部署难度 | 单仓 git clone | 在线 Web | 需自配 | 在线 Web |
| 上手成本 | 中(要装 20+ 依赖) | 低 | 中 | 极低 |
| 离线运行 | 部分支持(换本地 LLM) | 不支持 | 完全支持 | 不支持 |
定位差异:本仓库不是"工业级 ADMET 平台"------它是"教学+原型一体化"模板,适合:学 GNN 想拿真实数据练手 / 给客户演示"AI 辅助早期筛选"的可行性 / 想魔改 GNN 架构但不想从零写 dataloader。
不适合:生产环境的成药性评估决策------那种场景请用 ADMETLab 3.0 或 Schrodinger ADMET Predictor。
参考来源
- 仓库:
pritampanda15/ADMET-Prediction-System-Graph-Neural-Networks-with-RAG,commitmain,2025-12-07 创建,17⭐ 3 fork,许可证 MIT(实测gh api查询) - 本文实测环境(双平台) :① Windows 11 + CPU(无独立 GPU)+ conda 26.7.2 + PyTorch 2.5.1 cpuonly + torch-geometric 2.8.0 + PyTDC 1.1.15 + DeepSeek
deepseek-chat直连(2026-09-29 全流程跑通,日志存档);② 复测 Ubuntu 22.04 + 消费级 GPU(RTX 3060)+ conda + PyTorch 2.14.0+cu130 + torch-geometric 2.8.0.post1 + PyTDC 1.1.15 + DeepSeekdeepseek-chat直连(2026-09-30 全链路复跑:训练 GPU ~1 分钟 / 单分子 RAG 解释 / 批量 CSV / hERG 分类 / Streamlit UI HTTP 200) - TDC 论文:Huang K, Fu T, Gao W, Zhao Y, Roohani Y, Leskovec J, Coley C W, Xiao C, Sun J, Zitnik M. Therapeutics Data Commons: Machine Learning Datasets and Tasks for Drug Discovery and Development . NeurIPS 2021. arXiv:2102.09548v2
- TDC ADMET 基准:22 个数据集,Caco2_Wang 实测 910 条回归 / hERG 实测 655 条分类(阳性 451 / 阴性 204)/ PPBR_AZ 1797 条回归(tdcommons.ai/benchmark/admet_group 实测)
- GCN / GAT / MPNN 三篇原始论文:Kipf & Welling 2017 (ICLR) / Veličković et al. 2018 (ICLR) / Gilmer et al. 2017 (ICML)
更多专栏: