从 CUDA 到昇腾:一张对照表拆解 DeepSeek 最新开源组件(TileLang / DeepGEMM / DeepEP / TileKernels)
2026 年 9 月 30 日,DeepSeek 公布了一组面向华为昇腾平台的开源组件;相关解读随后于 10 月 4 日在掘金发布,给出了四组明确的对应关系:TileLang Ascend 后端对应 TileLang CUDA 后端、DeepGEMM-Ascend 对应 DeepGEMM CUDA 版本、DeepEP-Ascend 对应 DeepEP CUDA 版本、TileKernels Ascend 后端对应 TileKernels NVIDIA 后端 1。这组发布真正值得注意的地方,不是"又多了一批国产算子",而是它以成对镜像的方式呈现:每一层昇腾侧实现都指名道姓地标注了自己在 CUDA 生态中的对应物。
这种发布方式在工程上信息量很大。它让读者可以绕开"国产化"这类叙事,直接追问一组更硬的问题:CUDA 侧这一层究竟在解什么题?昇腾侧要重新解的是同一道题,还是一道同构但不同的题?两者的边界在哪里?本文以这四组对应关系为骨架,逐层拆解 DSL 与代码生成、低精度 GEMM、MoE 专家并行通信与算子实现层的工程问题,最后讨论"对照镜像式"迁移对推理侧软硬件自主化的实际含义。
需要先说明口径:本文的技术主体事实来自 2026 年 10 月 4 日掘金发布的解读文 1,属于二手技术解读;2026 年 10 月 1 日 AI 行业日报将"国产算力全栈突破"列为当日五大核心主线之一 2,本文引用时统一标注为"日报口径",仅作背景,不作因果论证。凡材料未提供的仓库地址、版本号、API 名称、性能数据与支持范围,本文一律标注为待核实,不做推测性陈述。
一、先看全景:四组对应关系与四层工程问题
1.1 一张对照表:昇腾侧实现与 CUDA 侧对应项
按来源给出的对应关系整理如下 1:
| 昇腾侧实现 | NVIDIA/CUDA 侧对应项 | 所处层次 | 要解决的工程问题 |
|---|---|---|---|
| TileLang Ascend 后端 | TileLang CUDA 后端 | DSL、代码生成与调度层 | 用同一套分块描述生成不同硬件代码,同步对齐调度与同步语义 |
| DeepGEMM-Ascend | DeepGEMM CUDA 版本 | 计算算子层(矩阵乘主力) | BF16、FP8、FP4 等精度下的 GEMM 及相关模型计算 |
| DeepEP-Ascend | DeepEP CUDA 版本 | 通信层 | MoE 场景下 dispatch/combine 等专家并行通信 |
| TileKernels Ascend 后端 | TileKernels NVIDIA 后端 | 算子实现层 | 算子级后端实现;来源摘要在该行"作用"列被截断,具体覆盖范围待核实 |
这张表有一个容易被忽略的结构特征:四行不是四件同类工具,而是横跨了推理软件栈的三个不同层次------如何写和生成 kernel、kernel 本体怎么算、多设备之间怎么搬数据。把它们放在一起,恰好构成一次"从写代码到传数据"的完整覆盖。
1.2 四层拆解框架:从"写 kernel"到"传数据"
可以把一次典型的大模型推理前向拆成四层责任:
- DSL 与调度层(TileLang):决定"同一个计算意图,如何被表达、被编译、被映射到硬件执行模型上";
- 计算算子层(DeepGEMM / TileKernels):决定矩阵乘与高频算子的实际吞吐;
- 通信层(DeepEP):决定多卡多机之间 token 的搬运语义与效率;
- 硬件/驱动与编译器底层:本文不展开,但它是所有上层组件的共同前提,也是"待验证项"最集中的地方。
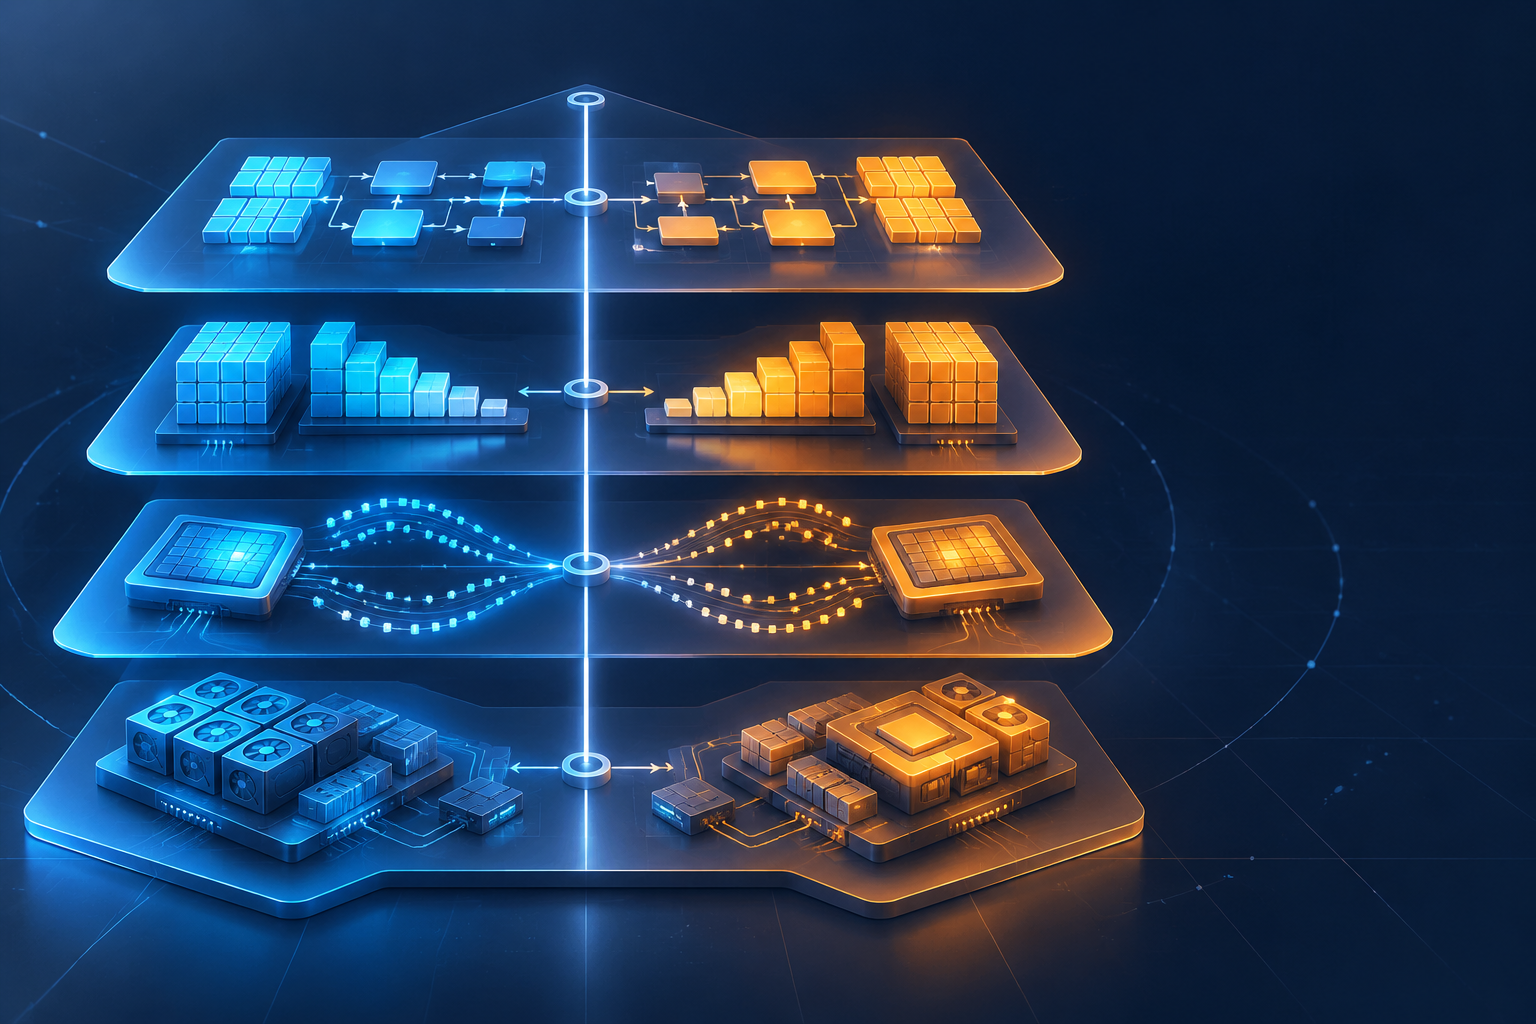
以一次 MoE 模型的推理前向为例,这个框架的用处立刻显现:token 经过路由后被分发到不同专家,这一步的跨设备搬运由 DeepEP 一类通信组件兜底;专家内部的矩阵乘由 DeepGEMM 一类 GEMM 库兜底;attention、归一化、激活等融合或高频算子由 TileKernels 一类实现兜底;而这些 kernel 的写法与生成路径,则由 TileLang 这一层统一描述。任何一层缺位,推理框架在该硬件上的迁移都会卡在"最后一公里"。
这也回答了"为什么恰好是这四个":它们分别对应了异构算力移植中最容易断裂的三类接口------编程模型接口、数值计算接口、集合通信接口。
二、TileLang:DSL、代码生成、调度与同步
2.1 CUDA 侧的 TileLang 在解什么题
在 GPU 上写高性能 kernel,长期存在一对矛盾:CUDA C++ 提供了极致控制力,但代价是把分块、流水、同步、内存层次管理全部交给程序员手写。同一位工程师写的 matmul kernel,可能大部分代码并不在描述"矩阵乘是什么",而在描述"怎么把矩阵乘切成块、塞进共享内存、安排流水线、等待正确的同步点"。
TileLang 一类 DSL 的思路,是把计算意图 与执行调度分离:程序员用 tile(分块)为单位描述计算,编译器负责生成底层代码并落实调度。这样抽象的直接收益是表达密度------一份描述讲清楚计算结构,而不是几百行搬运与同步细节。
下面是一段示意性的伪代码,用来说明这类分块 DSL 的表达方式,它不是任何官方 API 的引用,也不可直接运行:
python
# 伪代码:分块 DSL 的表达方式示意,非官方 API、不可运行
def matmul(A, B, C, M, N, K):
    # 以 tile 为单位描述计算,调度与同步交由编译器落实
    for i in range(0, M, BLOCK_M):
        for j in range(0, N, BLOCK_N):
            acc = zeros(BLOCK_M, BLOCK_N, dtype=fp32)   # 高精度累加
            for k in range(0, K, BLOCK_K):
                a_tile = load(A, i, k, BLOCK_M, BLOCK_K)
                b_tile = load(B, k, j, BLOCK_K, BLOCK_N)
                acc += dot(a_tile, b_tile)              # 分块乘加
            store(C, i, j, acc)
真正的价值不在这几行语法,而在它背后的责任划分:程序员声明的是 tile 的形状与数据流,编译器要负责把它落到具体的内存层次、指令序列与同步点上。
2.2 昇腾后端真正要重新解决的:调度模型与同步语义
同一份 DSL 程序要在两种硬件上生成正确代码,难点不在语法翻译,而在执行模型的对齐。不同加速卡在以下方面通常并不一致:
- 片上存储的层次与容量划分方式;
- 计算单元与数据搬运单元的并行关系;
- 流水线的启动、排空与依赖表达;
- 同步原语的粒度与语义边界。
换句话说,昇腾后端要做的,是把 DSL 中"调度与同步"这组抽象,映射到一套并不相同的底层执行模型上,并保证生成代码在语义上与 CUDA 后端一致。这正是来源表中把 TileLang Ascend 后端的作用写成"DSL、代码生成、调度与同步"的原因 1:它对齐的不只是前端语法,而是编译与执行语义。具体采用了哪些调度原语、同步 API 与编译管线,现有材料未给出,此处不做编造,列入待核实清单。
2.3 对开发者的实际含义
对使用方而言,镜像后端带来的最直接变化是维护结构:kernel 逻辑一份、后端多份。同一套 tile 描述可以分别生成 CUDA 与昇腾代码,而不是由两拨人各自手写、各自维护两份实现。这会显著降低"同一算子在两个平台行为漂移"的风险,也让算子级优化成果有机会跨硬件复用。
需要保留的边界是:DSL 层的一致性不等于生成代码在两种硬件上性能等价。分块尺寸、流水深度、内存占用这些与硬件强相关的参数,仍然需要按目标平台重新调优。抽象降低了移植成本,但没有消除调优成本。
三、DeepGEMM-Ascend:BF16、FP8、FP4 与模型计算的算力底盘
3.1 GEMM 为什么是必争之地
矩阵乘(GEMM)是推理与训练中算力占比最高的一类计算。注意力中的投影、前馈网络中的两层变换、MoE 中每个专家的门控与变换,最终都落到形状各异的矩阵乘上。一个推理框架能否跑满硬件,很大程度上取决于 GEMM 库对目标硬件的利用程度。
因此,"适配一款加速卡"如果只做到框架层算子能跑通、而 GEMM 仍是低效实现,那么上层的任何调度优化都会被这一层吞掉。DeepGEMM-Ascend 对应 DeepGEMM CUDA 版本 1,本质上是在补推理算力的主力底盘。
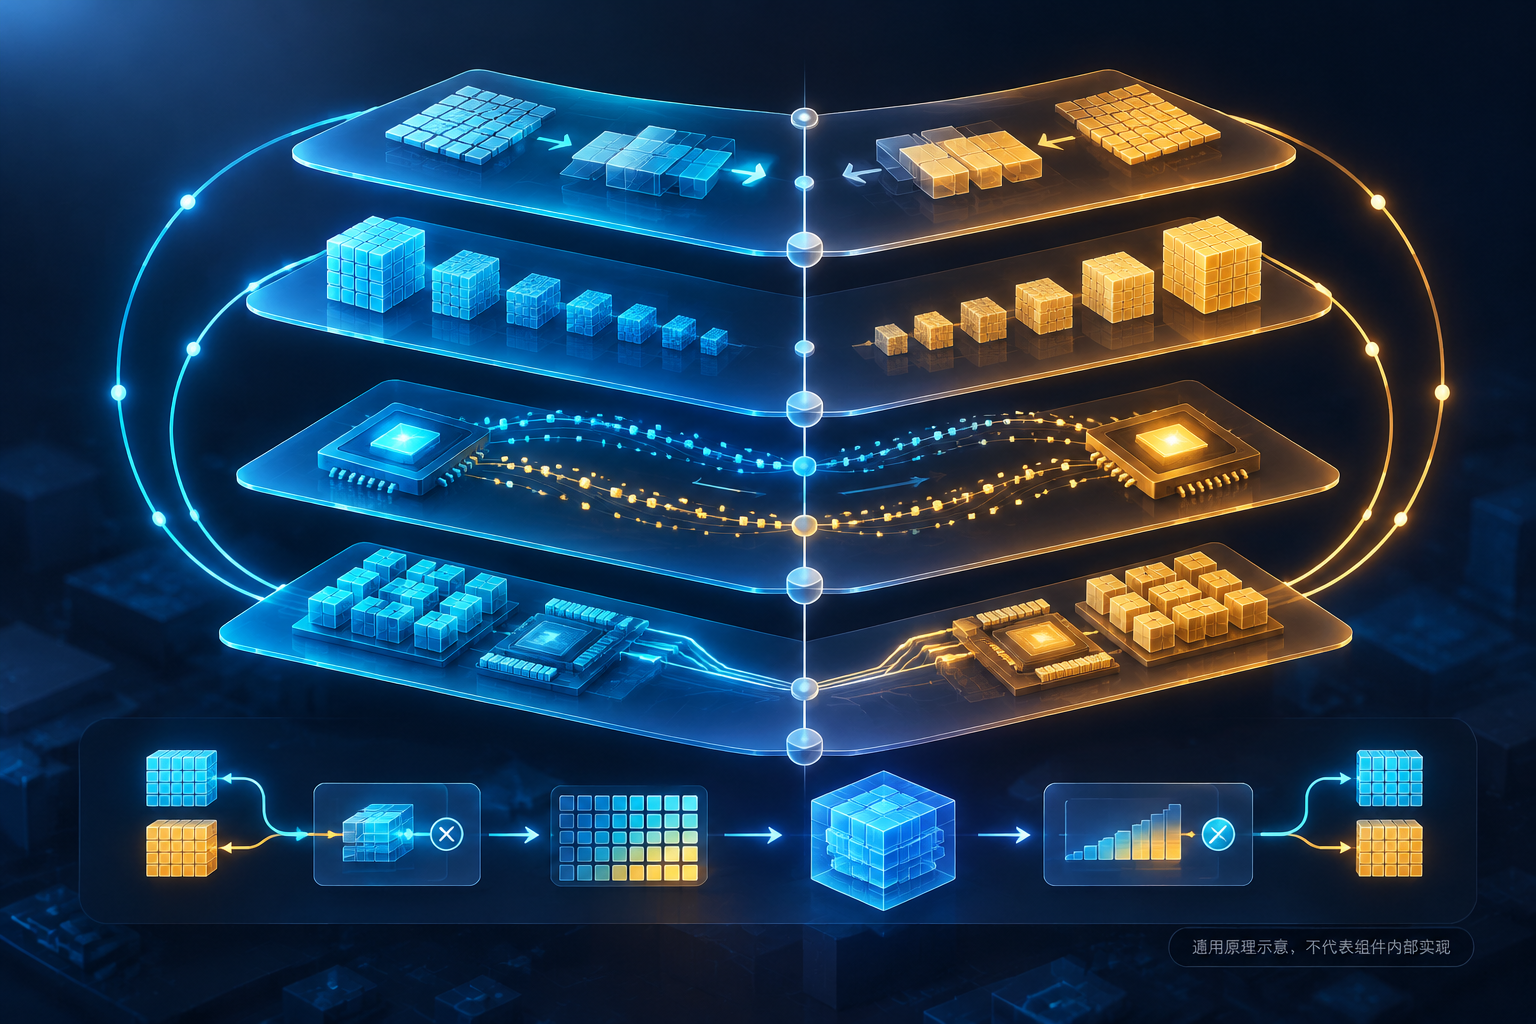
3.2 精度三级阶梯:BF16 → FP8 → FP4
来源把 DeepGEMM-Ascend 的作用表述为"BF16、FP8、FP4 GEMM 及相关模型计算" 1。这里只做定位性描述,不给加速比------现有材料没有任何实测数据。
| 精度 | 在链路中的典型角色 | 落地时要打通的环节 |
|---|---|---|
| BF16 | 训练与推理的通用基线,数值范围宽、生态成熟 | 基础 GEMM 实现与累加策略 |
| FP8 | 权重/激活低精度,用于进一步压低显存占用与搬运量 | 量化---低精度乘加---高精度累加---反量化,以及缩放因子的管理 |
| FP4 | 更激进的低比特方向,通常用于权重量化 | 极低比特表示下的数值稳定性、累加精度与校准流程;实际支持范围待核实 |
低精度 GEMM 的通用数据流可以概括为:低精度输入进入乘法,乘积在更高精度的累加器中累加,输出按需要还原或保持低精度。这个过程中,累加精度、缩放策略与异常值处理往往比"把数压到几比特"更关键。
3.3 "及相关模型计算"意味着什么
来源表述中有一句容易被略过的"及相关模型计算"1。它的含义是:这套实现覆盖的不只是裸 GEMM,还包括依赖 GEMM 的模型计算路径------例如批矩阵乘、带转置或特定布局的变体、以及与 GEMM 相邻的 epilogue 类操作。
这一层的实际覆盖清单(支持哪些形状与精度组合、是否包含分组量化或块状量化、与具体模型结构如何对应)在现有材料中没有展开,属于必须回溯官方文档确认的内容。对性能工程师而言,这也正是评测时最先要问清的问题:支持的形状集合决定了它在真实模型上的命中率,而不是 benchmark 上的峰值。
四、DeepEP-Ascend:MoE 的 dispatch 与 combine
4.1 MoE 前向中的两段通信
混合专家(MoE)模型把前馈层拆成多个专家,每个 token 只被路由到少数专家。当专家分布在不同设备上时,前向过程会插入两段通信:
- dispatch:router 决定每个 token 的专家归属后,把 token 发送到该专家所在的设备;
- 专家计算:各设备上的专家对收到的 token 做矩阵乘等计算;
- combine:把各专家的输出按原始归属聚合回 token 所在的设备,通常还要按路由权重加权合并。
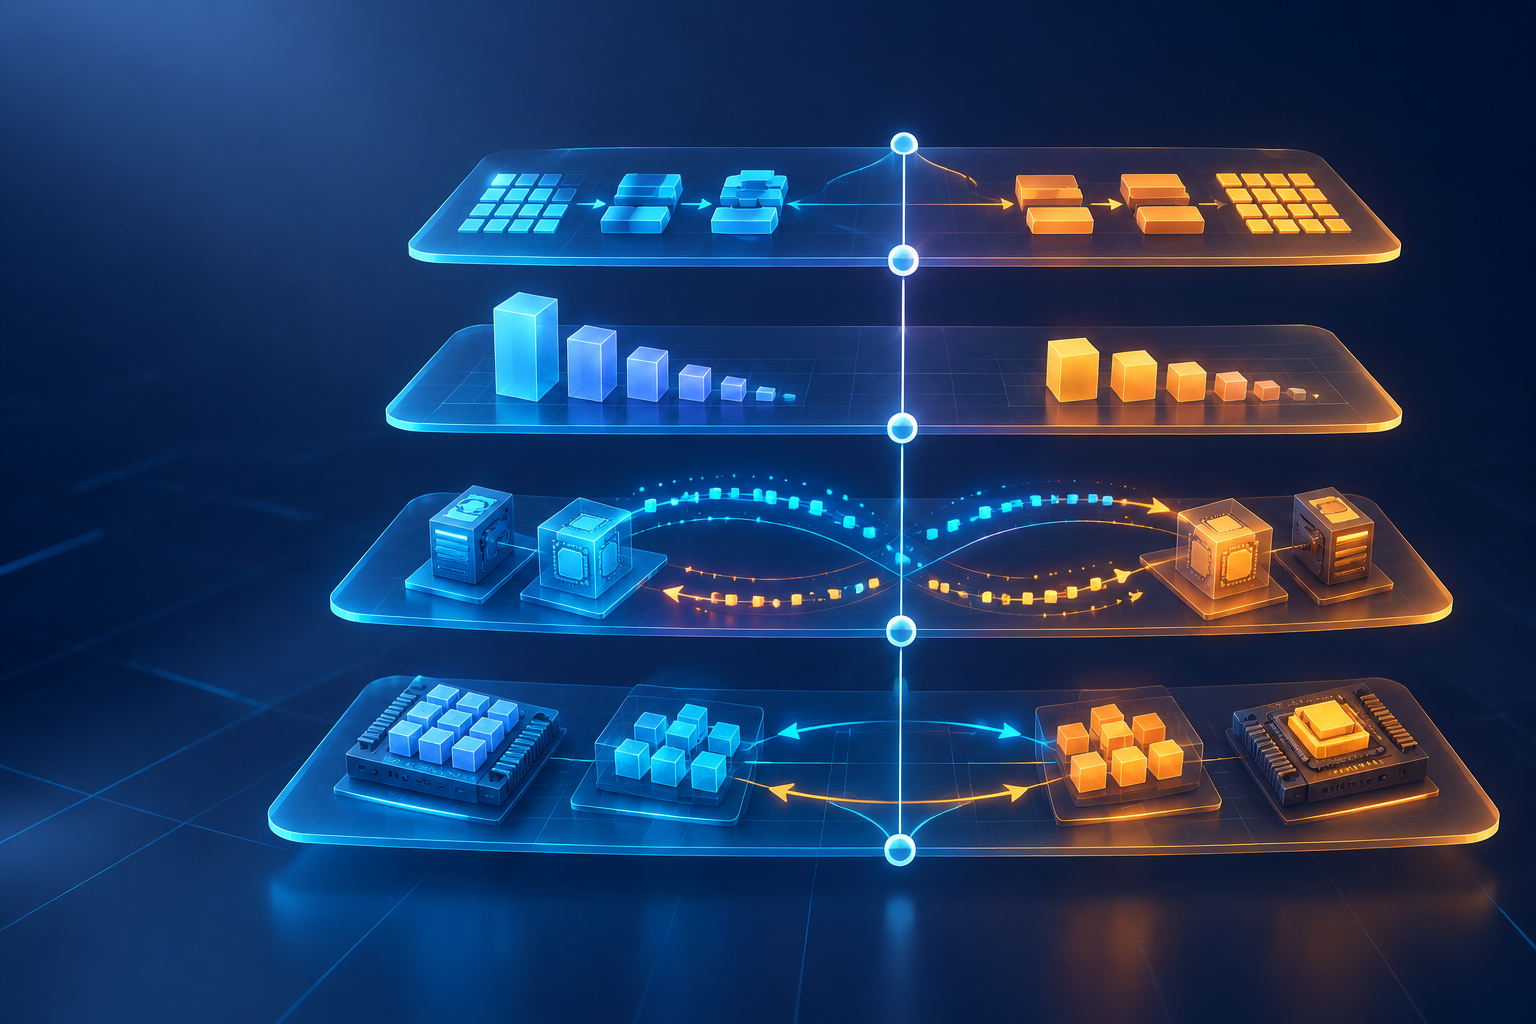
这段流程决定了 MoE 模型在多卡多机上的扩展效率。专家并行(EP)的规模越大,这两段通信在整体时间中的占比通常越敏感。
4.2 为什么它值得单独立一个库
dispatch/combine 的通信模式与传统集合通信并不相同:
- 消息粒度小、数量多:每个 token 只携带少量数据,但 token 数量大;
- 模式不规则:路由结果决定通信量与目的地,负载可能随输入分布变化;
- 延迟敏感:通信与计算需要交错编排,稍有空转就会放大为整体吞吐损失;
- 语义专用:它携带的是"token 到专家"的映射关系,而不仅是连续张量的规约或广播。
通用集合通信库可以表达这类操作,但未必能为这种不规则、动态的模式做针对性优化。把 dispatch/combine 作为独立通信库的原语来实现,可以让上层框架直接调用专家并行语义,而不是自己拼装低层通信原语。
4.3 昇腾侧对应项的工程意义
DeepEP-Ascend 对应 DeepEP CUDA 版本 1,意味着这套专家并行通信语义在昇腾平台上有了对应实现。对推理侧的直接影响是:MoE 结构的模型(其前向路径高度依赖 EP 并行)在国产硬件上具备了可用的通信组件,而不必由每个推理框架自行从零实现 dispatch/combine。
这里必须克制表述:有对应实现不等于性能对标完成。现有材料没有给出 DeepEP-Ascend 的通信后端(是否基于昇腾自有集合通信库)、支持的拓扑与并行规模、是否包含推理专用模式等信息,这些都属于待核实项。本文不写"与 CUDA 版持平"之类的结论。
五、TileKernels:算子实现层的最后一块
第五组对应关系是 TileKernels Ascend 后端与 TileKernels NVIDIA 后端 1。需要如实说明:来源摘要中该行的"作用"列被截断,因此本文无法确认其准确覆盖范围,只能做层次定位与分工推断。
从命名与对应结构看,它的位置在算子实现层:与 DeepGEMM 专注矩阵乘主力不同,它更接近一组针对特定高频计算的高性能 kernel 集合,且同样以多后端方式组织。至于它是否聚焦 MoE 相关融合算子、覆盖哪些算子清单,必须回溯原文或官方仓库确认,本文不做断言。
三者的分工可以这样理解:
| 组件 | 管什么 | 待确认点 |
|---|---|---|
| TileLang | kernel 怎么描述、怎么生成、怎么调度与同步 | 昇腾后端的调度与同步 API 细节 |
| DeepGEMM | 矩阵乘主力,覆盖 BF16/FP8/FP4 等精度路径 | 精度组合、量化粒度、形状覆盖 |
| TileKernels | 算子级实现集合,与 NVIDIA 后端构成镜像 | 准确职责与算子清单(来源摘要截断) |
这个分工表的价值在于,它暴露了一个现实:异构算力迁移的难点并不平均分布。GEMM 有成熟的性能模型与评测方法,通信有明确的语义接口,而杂项算子层往往是工程量最大、最琐碎、也最容易被低估的部分。TileKernels 以独立项目形式出现在清单里,说明这批迁移没有停留在"跑通几个明星算子"的层面。
六、"对照镜像式"迁移意味着什么
6.1 不是适配几个算子,而是三层同步迁移
如果这批组件是零散发布的,读者很难判断它们拼出的是一条完整路径还是若干孤岛。而按 CUDA 侧对应项成对发布,至少在结构上证明了一件事:DSL/调度层(TileLang)、计算算子层(DeepGEMM、TileKernels)、通信层(DeepEP)同时建立了对应实现。这三层恰好是推理软件栈的关键路径。
对工程团队而言,这种镜像结构还有一个次要但实际的好处:它天然提供了对照基准。同一个 kernel 的 CUDA 实现与昇腾实现可以做行为对照、数值对照与结构对照,定位移植引入的偏差时有明确参照物,而不是在黑盒里猜。
6.2 对推理侧自主化的具体价值
对推理侧来说,模型结构演进已经把两个能力推到了关键位置:一是低精度计算链路 (从 BF16 到 FP8、FP4 的降比特),二是专家并行通信(MoE 模型的 dispatch/combine)。这两项恰好被 DeepGEMM 与 DeepEP 覆盖。
因此,这批组件的实际价值可以概括为:让现代模型结构(低精度 GEMM + EP 并行)在国产硬件上具备了对应的开源实现,从而降低推理框架迁移的"最后一公里"成本。开源本身也带来可审计、可二次开发、可由生态共建维护的属性,这与封闭二进制适配的路径有本质区别。
从时间线看,2026 年 10 月 1 日的 AI 行业日报将"国产算力全栈突破"列为当日五大核心主线之一(日报口径)2,而本组组件的公布时间是 9 月 30 日 1,两者相邻。需要强调的是,这只能作为叙事背景:日报条目是行业观察口径,不能用来证明本组组件的性能或成熟度,二者之间也不构成因果关系。
6.3 必须保留的边界
在没有实测数据与官方文档支撑的情况下,以下结论目前都不成立:
- 开源对应项 ≠ 性能对标完成。是否有任何官方性能或正确性测试数据可引用,现有材料未显示;在拿到数据前,本文不做任何性能结论。
- 软件栈组件齐备 ≠ 全栈可用。驱动、编译器、运行时、调试与性能分析工具链是共同前提。来源标题提及这批组件与 Ascend C 的关系 1,但摘要未包含相关论述,其定位关系需回溯原文确认。
- 可用 ≠ 可长期依赖。版本节奏、兼容承诺、社区维护机制,是生产选型时必须单独评估的问题。
这些边界不是泼冷水,而是这类技术评估的基本纪律:把"实现了对应关系"与"达到了等效效果"严格区分。
七、给不同读者的上手路径
在仓库地址、安装命令与示例均未核实之前,本节只给方向,不给命令。宁可留白,也不提供无法验证的操作步骤。
| 读者角色 | 优先关注 | 建议动作 |
|---|---|---|
| 推理性能工程师 | DeepGEMM-Ascend、TileKernels | 先确认精度与形状覆盖,再设计以真实模型形状为主的 GEMM 与算子评测 |
| 系统/通信工程师 | DeepEP-Ascend | 重点核对 dispatch/combine 的通信语义、支持拓扑与规模边界 |
| 内核与 DSL 使用者 | TileLang 双后端 | 尝试让同一份 tile 描述在两个后端上生成代码,对照生成结果与行为一致性 |
| 技术管理者 | 四层整体 | 按"是否有官方仓库与许可证、是否有测试与评测、是否有维护机制"三问做准入判断 |
八、待核实清单
以下事项在现有材料中不足以下结论,撰写与引用时需回溯 DeepSeek 官方发布渠道或项目仓库确认:
- 四组组件的官方仓库地址、许可证、版本或 commit;
- "2026 年 9 月 30 日公布"的确切口径(是发布、开源还是文档更新);
- DeepGEMM-Ascend 的精度支持范围,FP4 是已实现还是规划项,以及量化粒度;
- TileKernels 的准确职责与算子清单(来源摘要在该行截断);
- DeepEP-Ascend 的通信后端、支持拓扑与并行规模,是否含推理专用模式;
- TileLang 与 Ascend C 的关系表述(来源标题提及,摘要未展开);
- 是否存在可引用的官方性能或正确性测试数据。
结语
把这四组组件放在一起看,DeepSeek 这次做的事情可以用一句话概括:不是"让模型在昇腾上跑起来",而是把 CUDA 侧那套已被验证的软件栈结构,在昇腾侧按同样的层次逐层重建。TileLang 管表达与生成,DeepGEMM 与 TileKernels 管计算,DeepEP 管专家并行通信,三者合起来覆盖了推理迁移最容易断裂的位置。
对关注国产算力的工程团队,这是值得认真跟踪的结构信号;但它的成色,仍要由官方文档、可运行示例、正确性测试与性能数据来兑现。在这些材料补齐之前,最恰当的判断是:对应关系已经建立,对标结果仍待验证。
参考资料
1 《DeepSeek 重磅开源面向华为昇腾平台的组件:从 CUDA 到昇腾------拆解 DeepSeek 新开源组件与 TileLang、Ascend C 的关系》,掘金,2026-10-04,https://juejin.cn/post/7692485970525241378
2 《2026 年 10 月 1 日 AI 行业日报|Gemini 4 Argon 正式发布、全球 AI 监管收紧、国产算力全栈突破》,CSDN,2026-10-01,https://blog.csdn.net/Smoothly_Lu/article/details/166937993