一年前,"Harness(智能体运行框架)才是真正的产品"还只是一个观点。到了 8 月 13 日,DeepSeek 把这个观点直接做成了产品战略:它开源了一套采用 MIT 许可证的 Agent Harness。模型、工具、沙箱,甚至智能体最核心的运行循环,都可以像插件一样随时替换。项目上线短短两天,GitHub Star 就突破了 9 万,到目前为止(9月28号,24万star,版本rc.2)。
那么,DeepSeek Harness 到底是什么?它和我们过去熟悉的 Agent 框架有什么不同?热度之外,又有哪些容易被忽略的细节?
有时候,行业的发展会突然把你过去提出的判断,原封不动地送回到你面前。 2026 年 8 月 13 日,DeepSeek 在发布 V4-Pro 模型的同时,还推出了一个开发者预览项目------DeepSeek Harness,在命令行中简称 dsh。
它不是一个新模型,也不是一个聊天机器人。它是一套 Harness。 如果觉得这个词比较抽象,可以把它理解成"让大模型真正变成 Agent 的运行框架"。大模型本身只负责思考和生成内容,而 Harness 负责把整个 Agent 系统组织起来:什么时候让模型继续推理,什么时候调用工具,可以拥有哪些权限,如何保存会话记录,怎样操作文件,以及如何在沙箱中安全执行代码等等。 换句话说,模型更像"发动机",Harness 则是装着发动机、真正能够上路行驶的"汽车"。
DeepSeek Harness 发布后大约两天,GitHub Star 就超过了 9 万。通常来说,这种热度更容易出现在一个重磅大模型身上。但这一次吸引开发者的并不是模型本身,而是一套非常明确的设计理念。 README 用五个英文单词概括了它:"everything is a plugin"------一切皆插件。 在这个系列开篇时,我曾提出过一个比喻:模型是发动机,Harness 是汽车,而这辆车应该由开发者自己来造。 DeepSeek 又往前走了一步:不仅汽车可以自己造,而且整辆车应该变成一套可以自由拆装的"模块化套件"。 模型可以换,工具可以换,Skills 可以换,会话系统可以换,沙箱和文件系统可以换,UI 可以换。 更关键的是,连 Agent 最核心的运行循环(Agent Loop)都可以替换。 这也是最让不少工程师关注的一点。 而且,这些组件都采用 MIT 许可证开源。
《南华早报》把这次发布视为 DeepSeek 的一次战略转向:AI 行业的竞争重点,正在从单纯比拼"谁的模型更聪明",转向"谁能让 AI Agent 更顺畅地连接并操作现实世界的软件"。 VentureBeat 的说法更加直接:随着大模型能力逐渐接近,模型本身会越来越容易替换;真正难以替代的,反而可能是 Harness------因为它决定了 Agent 如何推理、如何调用工具、如何修改软件,以及如何在一项持续数小时甚至数天的任务中保持状态并继续工作。 过去大家竞争的是"谁有更强的大脑";现在越来越多人开始竞争"如何让这个大脑真正把事情做完"。
这也意味着,"Harness 才是产品"不再只是一个关于 Agent 架构的讨论。如今,DeepSeek 已经以一家头部 AI 实验室的身份,正式把这个思路押注成了一条产品路线。 因此,本文主要想回答三个问题。
- 第一,DeepSeek Harness 到底是怎么工作的。因为目前围绕它的报道很多都在讨论理念和战略,但真正讲内部机制的并不多。
- 第二,它和我们过去二十多篇文章讨论的传统 Harness 架构究竟有什么不同。这并不是简单的"又一个 Agent 框架",两者在一些关键设计上存在非常具体的差异。
- 第三,也是很容易被热度掩盖的一点:看看它的"说明书小字"。
毕竟,这是一个刚发布两天就拿到 24 万 GitHub Star 的开发者预览版。这样的项目当然值得认真关注,但同样值得保持审慎。首批开发者的实际体验,也已经暴露出了一些值得讨论的问题。 最后需要提前说明:本文是一篇紧跟新品发布的分析文章,讨论对象仍然是一个 Developer Preview(开发者预览版)。下面涉及的具体功能和版本信息,以 2026 年 9 月中旬的状态为准。随着项目快速迭代,一些细节很可能很快发生变化。
第一部分:基础概览
1. DeepSeek 这一次到底发布了什么?
这次发布并非单一更新,而是**"三合一"组合拳**: 模型升级: **** DeepSeek-V4-Pro-0813
官方表示,该版本重点大幅强化了 Agent(智能体)的相关能力。
计费规则调整
自 9 月 28 日起,原有的统一计费改为"闲忙时动态定价"。据路透社测算,根据 Token 类型和时间段的不同,价格涨幅在 50% 到 1100% 以上不等。
Agent 运行框架: dsh (DeepSeek Harness)
这是一个基于 Node.js 的开源 Agent 运行时(采用 MIT 开源许可证)。开发者只需在终端输入 npx @deepseek-ai/dsh web,就能在本地启动 Web 界面。它还同步提供了 Python SDK,GitHub 仓库一经发布,Star 趋势图直接呈"垂直拉升"之势。
这三个动作的组合非常关键:模型提供大脑,Harness 提供身体,而计费调整则表明,DeepSeek 认为两者结合带来的价值,远大于各自单独相加。
这与 Anthropic 推出的 Claude Code 以及 OpenAI 推出的 Codex 逻辑如出一辙。但有一个根本区别:
- Claude Code 和 Codex 是买来即用的"产品";
- DeepSeek Harness 则是完全开源、你可以据为己有的"代码库"。
2. 传统 Agent 框架的长相
为了搞清楚 DeepSeek 到底改变了什么,我们不妨先回顾一下传统的 Agent 框架是如何设计的。
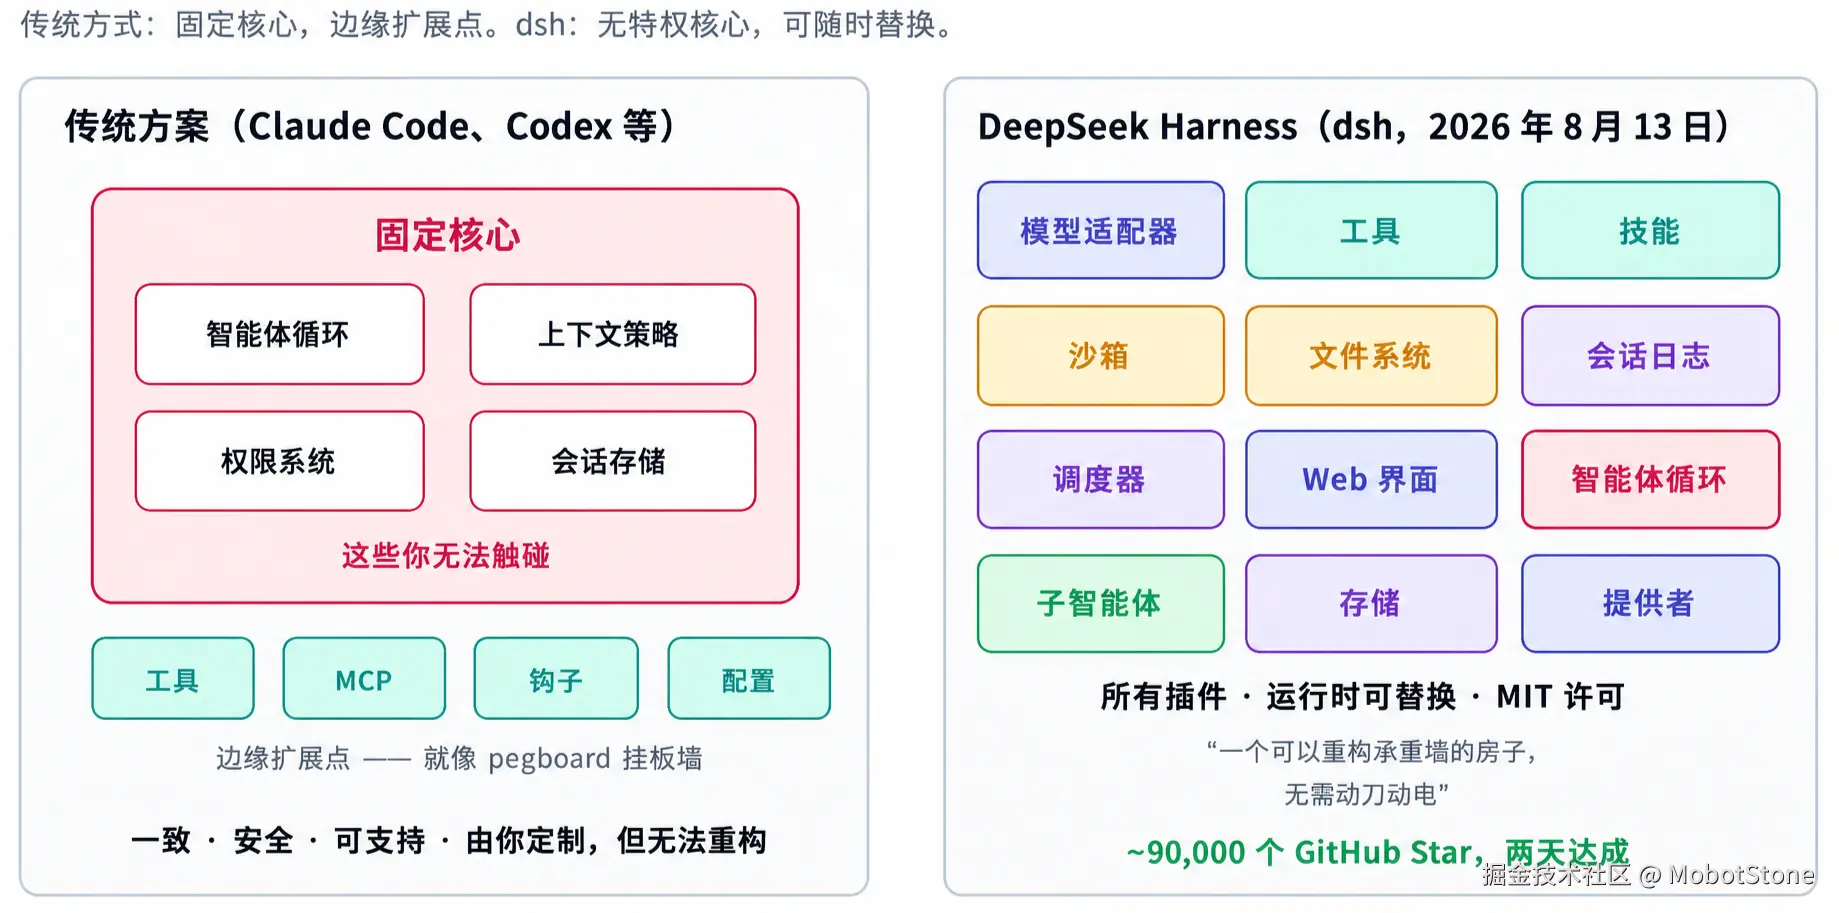
过去绝大多数工业级 Harness 的架构,都是**"固定的坚硬核心 + 外围的扩展点"**:
- 核心 Loop(运行循环): 由平台写死,开发者无法轻易修改。
- 外围工具: 开发者可以注册新 Tool、接入 MCP(Model Context Protocol)客户端、设置在特定节点触发的 Hook(钩子)、配置权限规则以及上下文压缩策略。
无论是 Claude Code 还是 Codex,基本都遵循这个逻辑;即便像 LangGraph 这种允许开发者自由绘制图结构(Graph)的工具,其底层的执行 runtime 依然是固定的。
这种架构就像开发商交给你的"精装房":你可以买家具、挂洞洞板、甚至搭个小隔断,但房子里的承重墙,必须严格呆在开发商打好的位置上。
这种设计并非缺陷,而是一种理性的选择。固定的核心是保证系统一致性、安全性和可维护性的基础。 比如防止智能体陷入死循环(Doom-loop)、自动压缩上下文、以及严格的权限校验,都需要一个开发者不能随意篡改的"安全核心"来统一把控。
3. DeepSeek 的"逆向颠覆"
而 DeepSeek Harness(dsh)做的事情,是把这种传统结构颠覆了过来。
在 dsh 中,根本不存在所谓的"特权核心" 。
- Agent Loop 变成插件了: 驱动 Agent 思考和行动的核心循环代码(位于
packages/core/agent-loop),只是一组普通插件。如果你想换一套调度逻辑,只需修改 YAML 配置文件即可。 - 模型适配器是插件: 支持无缝路由到 DeepSeek、OpenAI、Anthropic、AWS Bedrock、Google Vertex、Azure,甚至任何兼容 OpenAI 接口的本地模型。
- 沙箱环境是插件: 本地可以选择 Linux Landlock、macOS Seatbelt 或 Windows 受限 Token;远程沙箱同样可以无缝插拔。
- 会话存储、文件系统抽象、任务调度器、Web UI: 统统都是插件。
- 连竞争对手的框架也能当插件:
dsh内置了"子 Agent 提供者"(Sub-agent provider)。你可以直接把任务委派给 Claude Code 或 Codex CLI 执行(使用你自己的账号认证),把竞争对手的产品当作自己生态里的一个工具来用。
有一位开发者给出了一个非常贴切的比喻:
"Codex 是交给你一套装修好的精装房,附赠一面可以挂工具的洞洞板; 而
dsh是直接把整栋房子连同建筑图纸交给你,允许你在不拉闸、不断水的前提下,随意拆改任意一面承重墙 。" 那么,接下来的核心问题就变成了:在实际的开发和业务场景中,我们真的需要频繁去拆改承重墙吗?
第二部分:核心机制------Cordis 引擎、事件流与"日志即真相"
1. Cordis 组合层:如何做到"不停机换零件"?
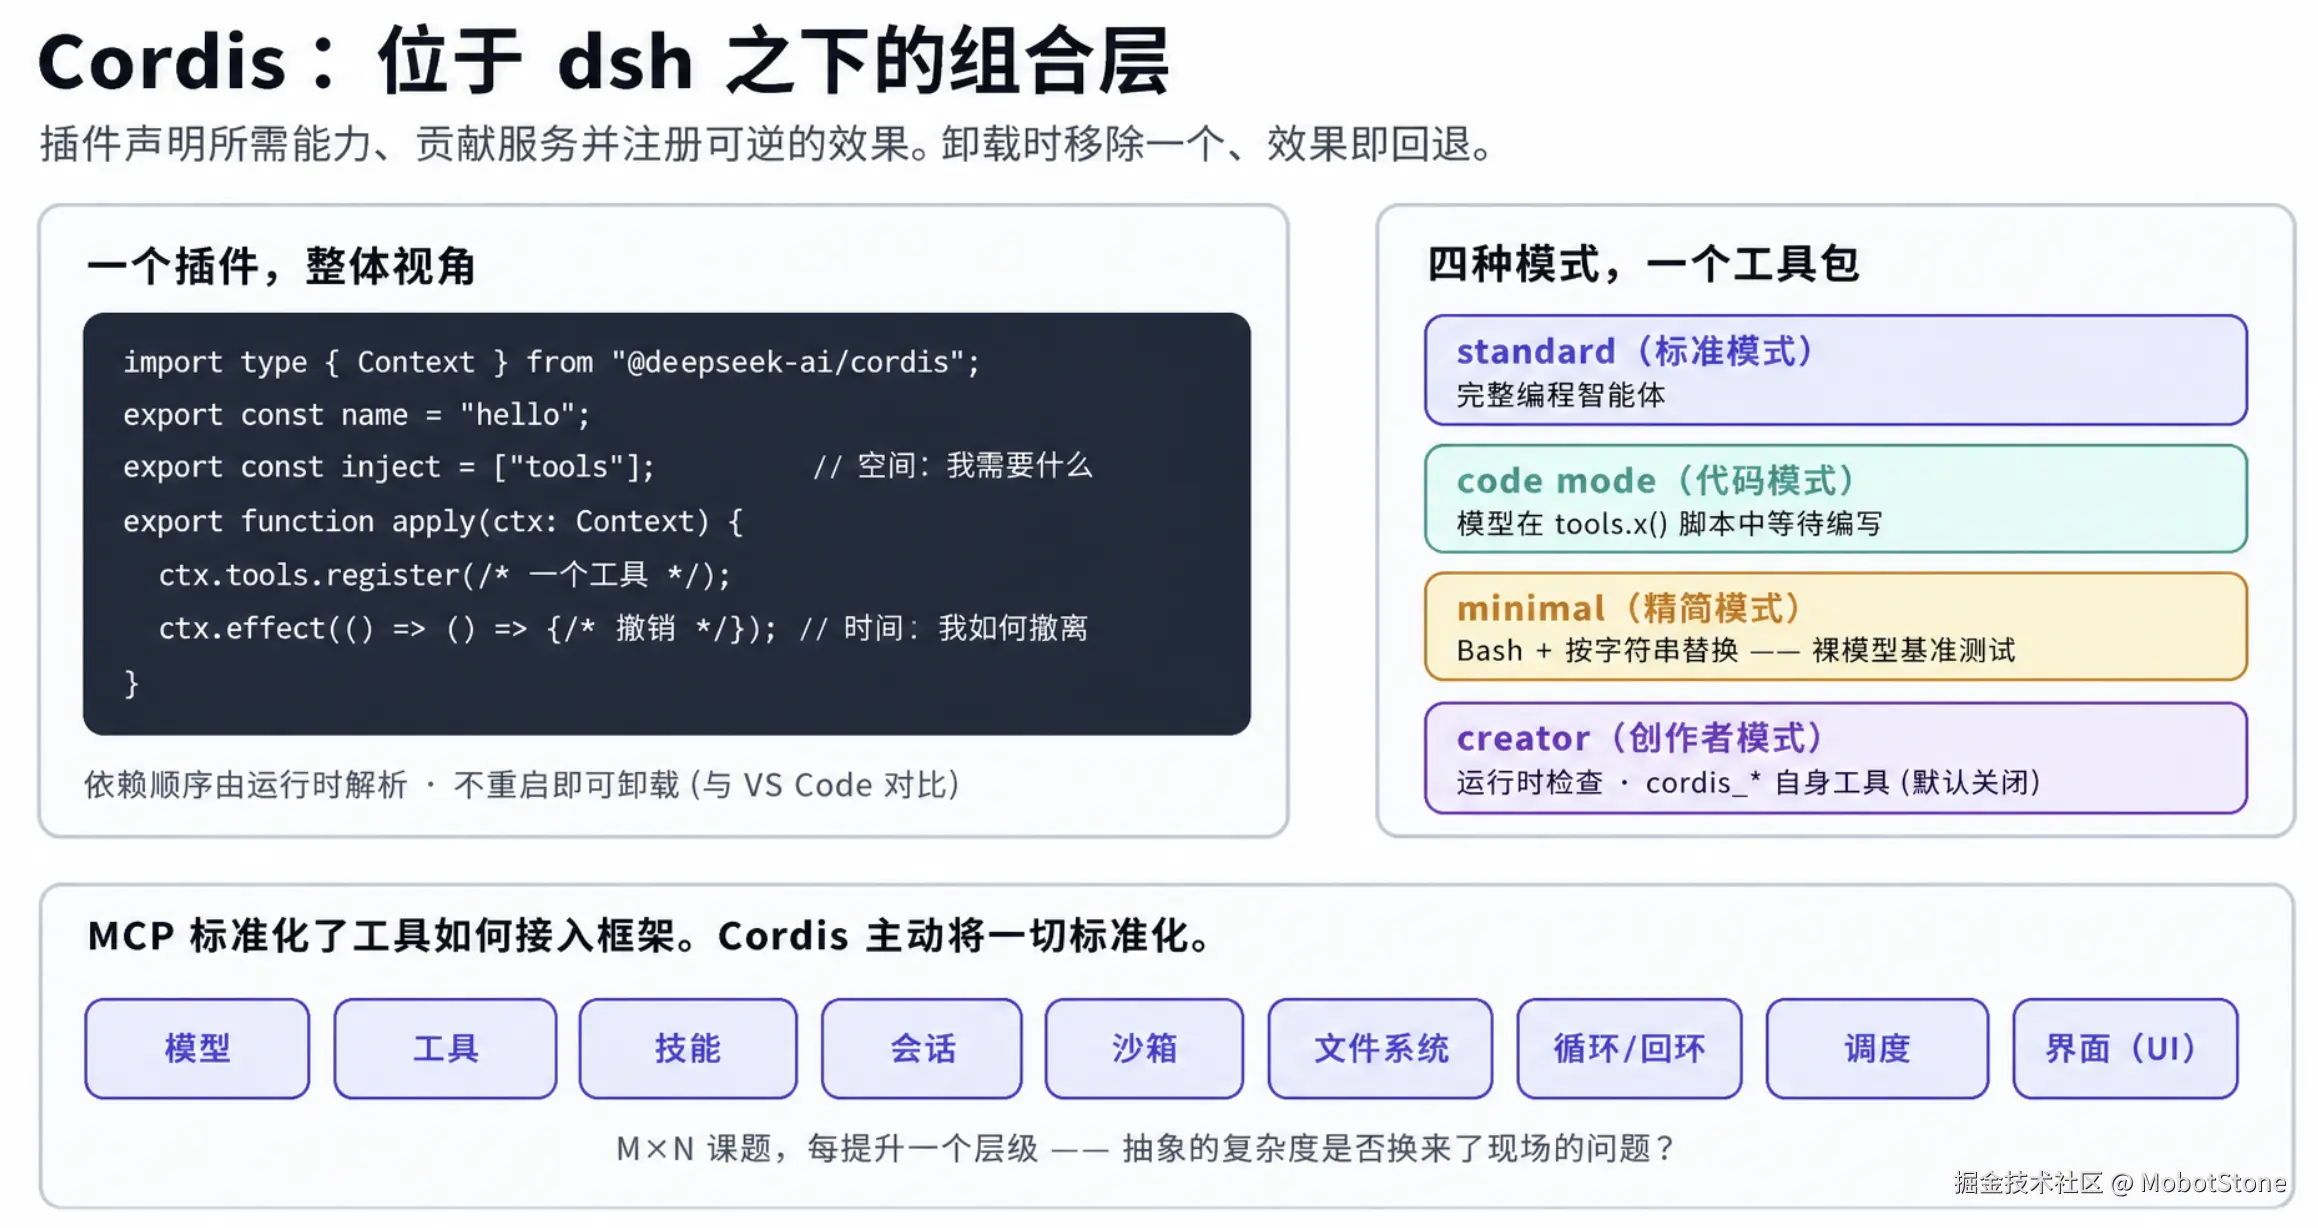
在 dsh 的底层,运行着一个名为 Cordis 的元框架(Meta-framework)。这是 DeepSeek 与北京大学研究团队联合打造的核心技术,主打概念是**"时空可组合性"**(Spatiotemporal Composability)。
撇开这些高深的学术词汇,它在工程上其实就保证了两件事:
- 空间维度(Spatial) :插件只需声明自己需要什么服务(比如
inject = ["tools"]),并把自己的服务和事件监听器注入到共享上下文(Context)中,运行时就会自动解析并搞定依赖顺序。 - 时间维度(Temporal) :插件创建的每一个副作用(Effect),都会注册一个清理回调函数(Disposer,即
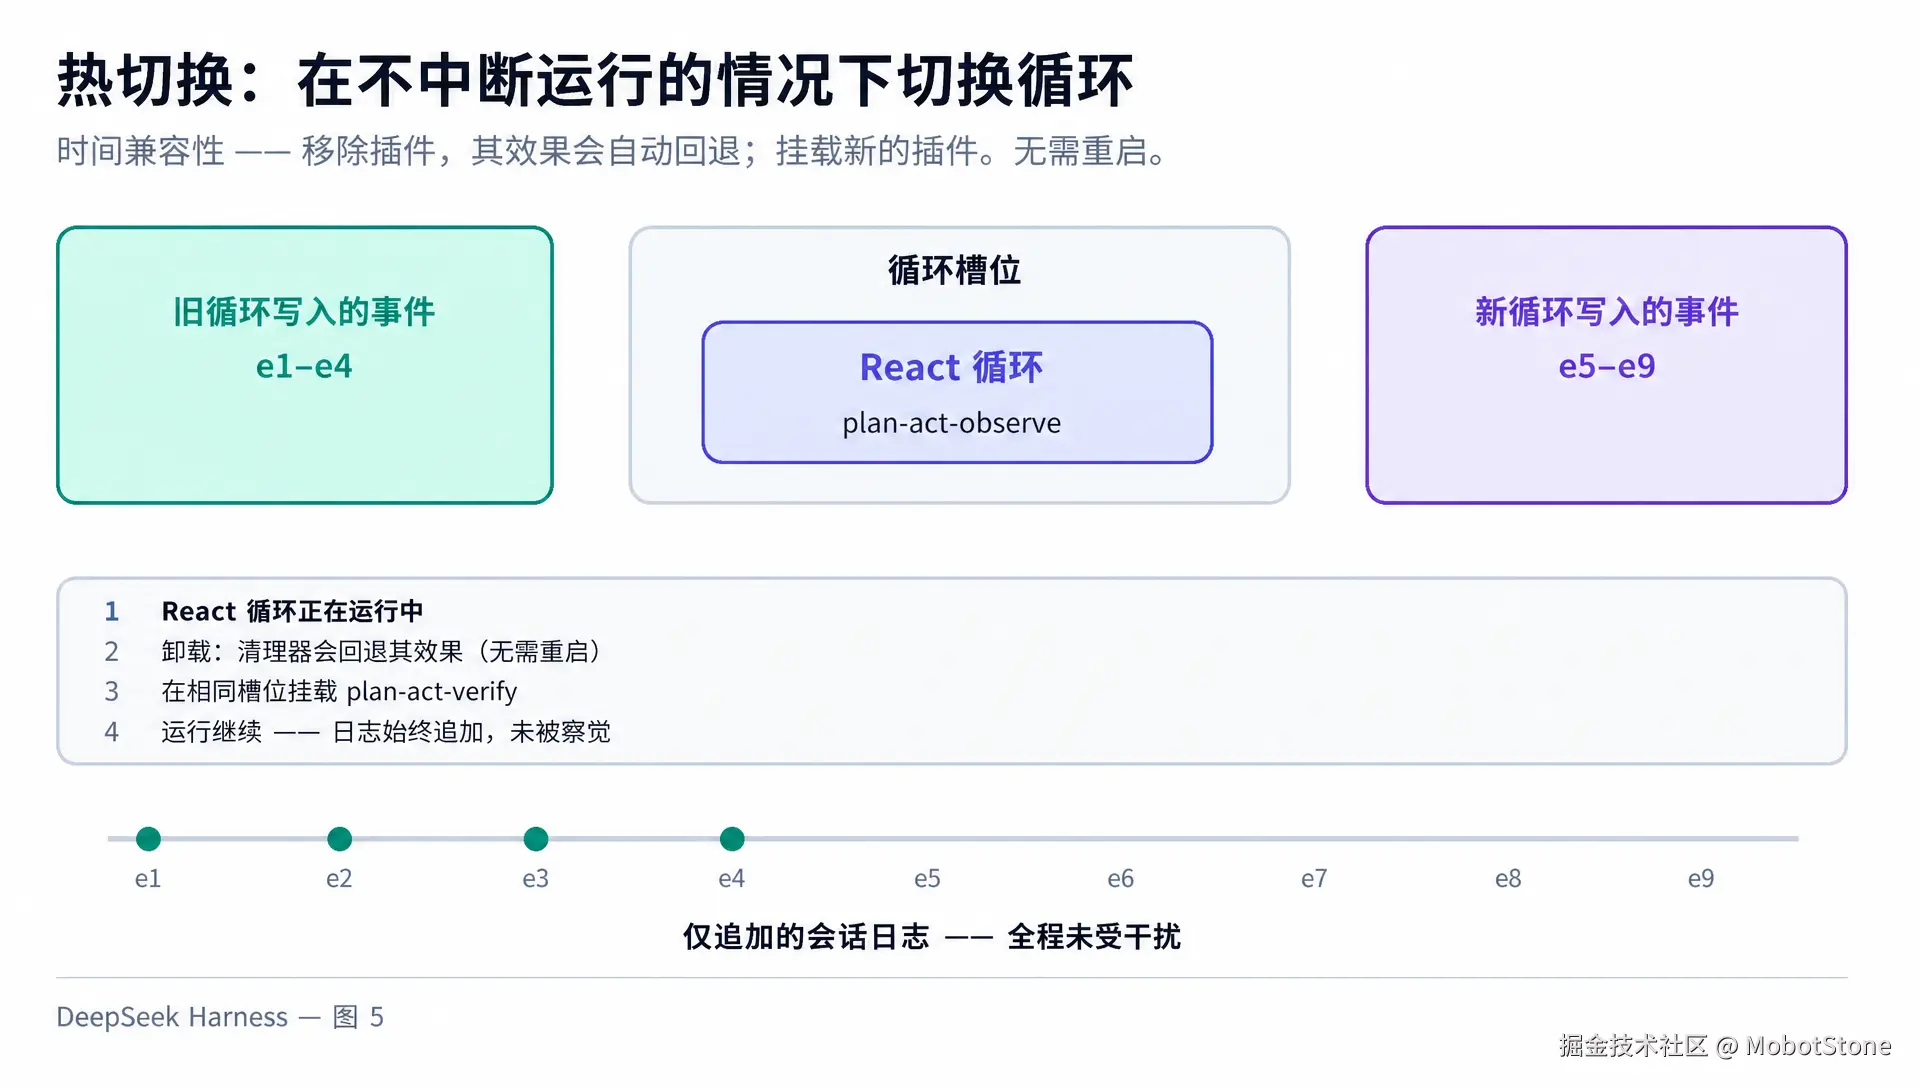
ctx.effect()返回的 undo 操作)。这意味着,你可以在程序运行过程中动态卸载插件 ,系统会自动撤销该插件造成的所有影响,完全不需要重启。
文档中拿它与 VS Code 作对比:在 VS Code 中彻底移除一个扩展,通常需要重启编辑器;而在 dsh 中,你甚至可以在会话执行到一半时,直接卸载当前的沙箱服务,并动态挂载一个新的沙箱。
编写一个最基础的 Cordis 插件,只需要区区 8 行代码:
javascript
import type { Context } from "@deepseek-ai/cordis";
export const name = "hello";
export const inject = ["tools"];
export function apply(ctx: Context) {
  ctx.tools.register(/* 注册一个工具定义 */);
  ctx.effect(() => () => {/* 当插件被卸载时执行的清理逻辑 */});
}如果了解过智能体工具设计的演进,就会发现这是在更高的维度解决扩展性问题:MCP 规范了"工具(Tools)如何接入框架",而 Cordis 则是试图规范"除了工具之外的一切(框架本身)如何插拔"。
至于这种高度抽象的架构是否会带来过度的复杂度,我们后面会看实际数据。
2. 会话日志即真相:Agent 的"飞行记录仪"
在 dsh 的所有设计中,我认为最能经受住时间考验的,是它的事件流机制。
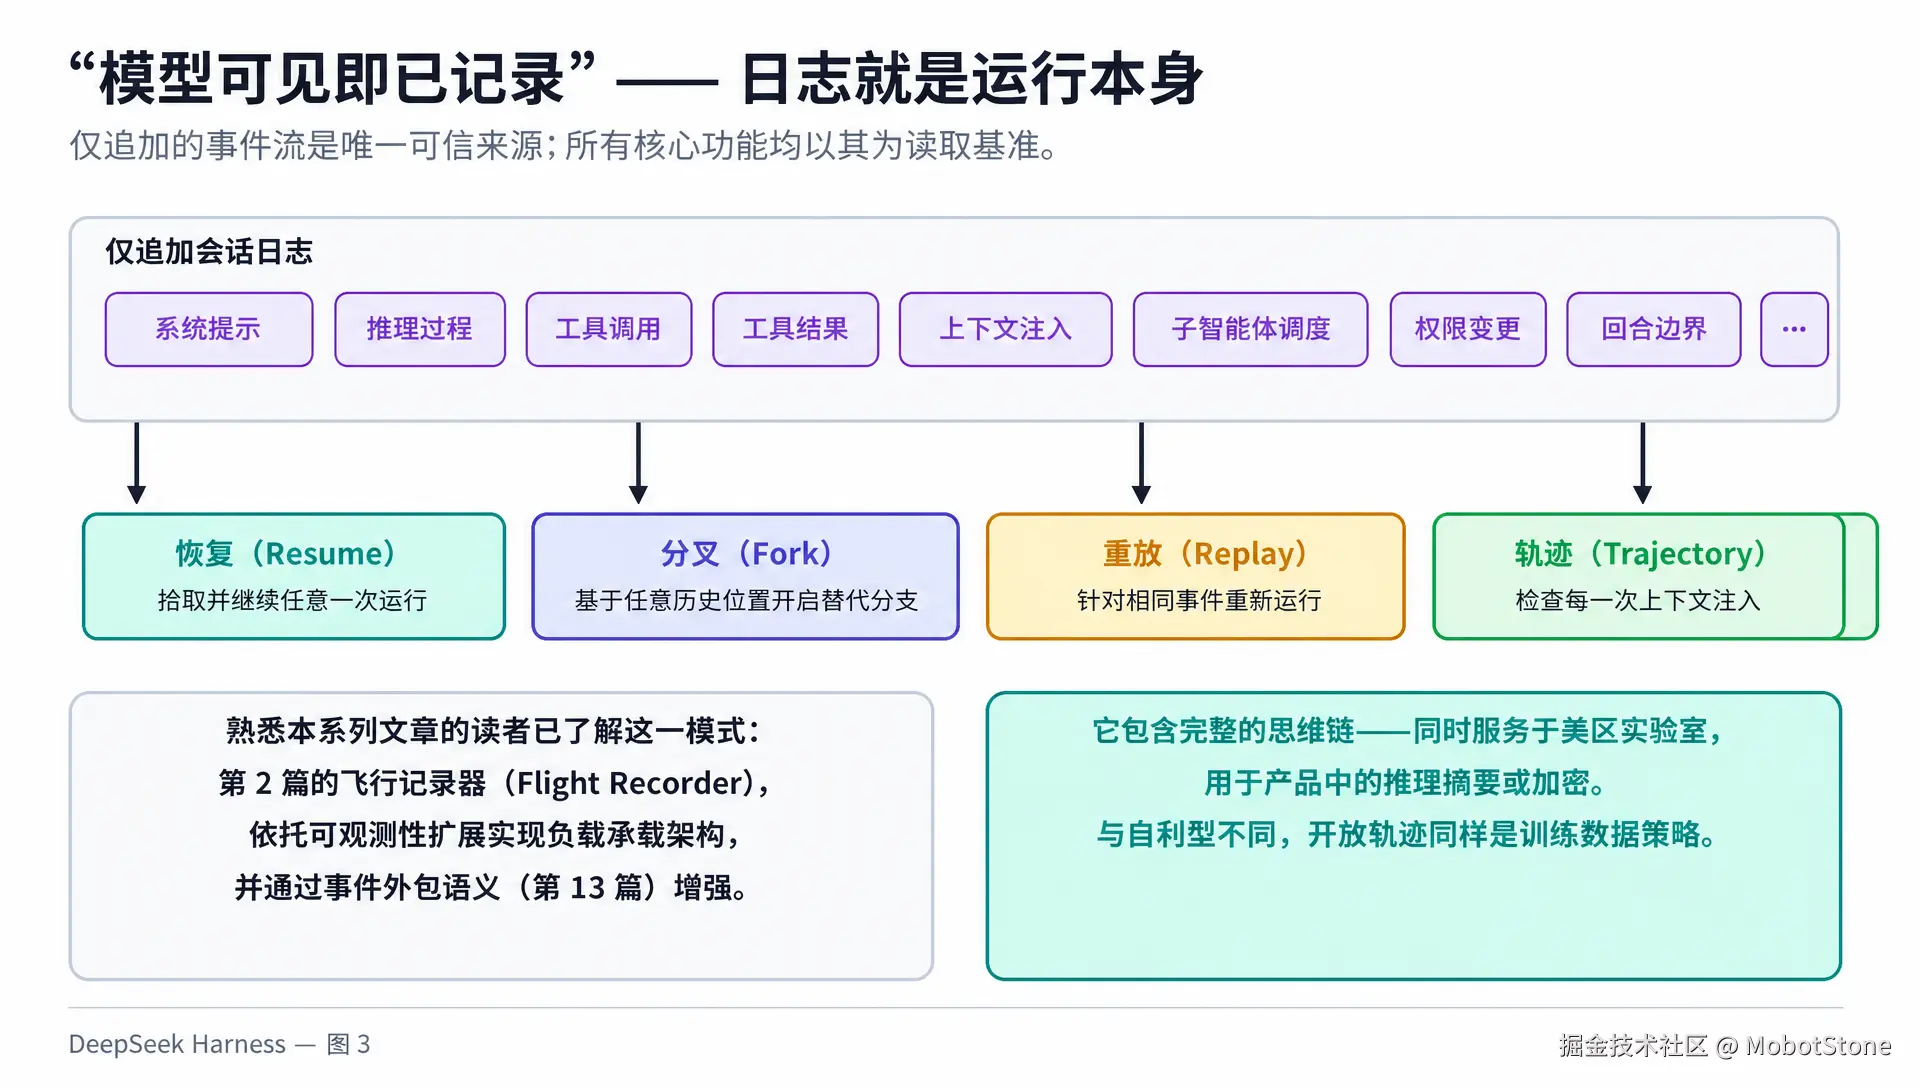
dsh 在运行时强制执行了一条硬性规则: "模型可见,即被记录"(Model-visible means logged) 。
任何进入大模型上下文的内容------无论是系统提示词(System Prompt)、思维链(Reasoning)、工具调用与返回结果、子 Agent 的调度指令,还是每一次上下文注入------都会被严格写入一个"只能追加、不能修改"的会话日志中。
更关键的是:这个日志不是任务运行后产生的副产品,日志本身就是任务运行的"实体"。
断点续传(Resume)、分支派生(Fork)、过程重放(Replay)、历史搜索以及轨迹可视化查看(Trajectory view),全都直接衍生自这个统一的事件流。
这种设计有两个非常关键的亮点:
- 默认开启且全量覆盖:它不是事后补救式的"埋点日志",而是在底层架构里强制开启的。
- 完全保留思维链(Chain of Thought) :眼下不少西方头部实验室为了防止模型被"蒸馏"(Distillation),开始在产品中加密或简化思考过程。而
dsh选择将推理轨迹完全透明化。这既是技术上的差异化亮点,也是开源生态下极其明智的策略。
3. 工具执行管道:把"审批"与"隔离"彻底划清界限
在 dsh 中,工具的执行会经过一条严格的防线:预执行校验(策略检查) → 权限处理 → 执行工具 → 后处理(敏感信息掩码与结果验证) → 结果持久化落盘。每个阶段都可以插入插件钩子(Hooks)。
在其权限模型中,dsh 明确区分了两个经常被混为一谈的概念:
- 审批(Approval) 回答的是:"这个操作需要人类点击确认吗?"
- 沙箱(Sandboxing) 回答的是:"这个操作在物理上最高能触及哪些系统资源?"
正如 dsh 文档所言: "弹窗确认并不等于文件系统的安全边界。"
dsh 的权限预设涵盖了从 read-only(只读)、workspace-write(工作区写入),一直到自带警告属性的 danger-full-access(危险的高危全通模式)。
为了适应不同的使用场景,dsh 包装出了四种默认工作模式:
- Standard(标准模式) :功能完整的编程 Agent。
- Code Mode(代码模式) :将所有工具封装成 TypeScript SDK,大模型不再一次次调用单个工具,而是直接写一段脚本(比如用
await tools.x()),批量执行十几个操作------实现了"将代码作为通用工具"的理念。 - Minimal(极简模式) :仅保留最基础的 Bash 命令和字符串替换,专门用于评估裸模型的原始能力。
- Creator(创造者模式) :探针与实验模式。在该模式下,Agent 甚至可以使用默认禁用的
cordis_*工具,来进行自我检查,甚至自己编写插件来扩展自己。
第三部分:传统 Harness vs. dsh------对 Agent 开发者来说,究竟改变了什么?
如果你已经按照传统方式开发过 Agent,那么真正值得关注的并不是 dsh 多了多少功能,而是它改变了哪些底层规则。
可以把一个 Agent 拆成几个核心"器官",逐一对比。
1. Agent Loop:从"写死的核心"变成"可以更换的插件"
传统架构下,Agent 最核心的运行循环通常只有两种选择:要么自己写,要么接受平台提供的那一套。
这个 Loop 决定了 Agent 如何工作。例如:
模型先思考 → 调用工具 → 获取结果 → 再次思考 → 再调用工具......直到任务完成。
而在 dsh 中,连这个最核心的循环都被做成了一个可挂载、可替换的组件。
dsh 又把执行过程区分成两个层级:
- Step(步骤) :一次模型请求,以及由这次请求触发的工具调用;
- Turn(轮次) :由 0 个或多个 Step 组成的一轮完整处理过程。
在这些边界上,系统都会暴露事件接口。
这意味着,你可以直接把整个 Loop 换掉。比如采用"规划 → 执行 → 验证"(Plan-Act-Verify),或者多 Agent 辩论,也可以换成自己设计的一套 Graph 工作流,而不需要 Fork 整个运行时重新改底层代码。
这是 dsh 与传统 Harness 相比最实质性的变化之一。
过去我们所谓的各种"Harness 设计模式",到了 dsh 这里,都可以被封装成一个独立的 Loop 插件,然后直接发布给其他开发者使用。
2. Tools:不只是"接入工具",还可以控制工具如何执行
传统 Agent 接工具,通常有两种方式:直接注册函数,或者通过 MCP 接入。 dsh 两种都支持,但又往前走了一步。 除了工具本身,你还可以通过 Pipeline Hook 干预工具执行的各个阶段,比如执行前检查、权限判断、执行后验证和结果处理。 再加上前面提到的 Code Mode ,模型甚至可以不再连续发起十几次零散的工具调用,而是生成一段 TypeScript 代码,把多个工具组合起来一次执行。 值得注意的是,dsh 还专门做了兼容迁移。 例如,它提供了对其他产品现有 hooks.json 配置的兼容桥接。这个设计的目标非常明确:降低包括 Claude Code 用户在内的现有开发者迁移到 dsh 的成本。
3. Context:上下文如何组装,也不再由框架说了算
在传统 Harness 中,上下文管理通常属于框架核心能力。 什么时候压缩历史对话?哪些内容应该保留?哪些工具结果应该进入上下文?上下文快满时应该丢掉什么? 开发者通常可以调整一些参数,但大的规则还是由框架决定。 到了 dsh,连 Context Assembly(上下文组装机制)本身都是可插拔的。 而且,每一次向上下文中注入内容,都会变成一条日志事件。 你可以直接通过 Trajectory(运行轨迹)界面查看:模型在某一步到底看到了什么信息,以及这些信息是怎么进入上下文的。 以前我们分析"一个真实的大模型 Context Window 里面到底装了什么",往往需要自己抓日志、做调试。 在 dsh 中,这件事直接变成了 UI 里的一个标准功能。
4. 权限与沙箱:理念并不新,但架构更彻底
传统框架通常会提供一套固定的权限等级,开发者负责配置。 dsh 并没有发明全新的安全理念,但它把这套机制做得更加模块化:权限系统和沙箱都可以通过 Provider 替换。 同时,它在系统 Schema 层面明确区分了两件事情:Approval(审批)解决"人要不要确认",Sandbox(沙箱)解决"程序实际上能访问什么"。 也就是说,用户点了"允许",并不意味着程序就能突破沙箱去读取任意文件。 在安全思想上,这和成熟 Agent 架构一直强调的原则基本一致;但从工程实现来看,dsh 把这种边界直接落实到了底层架构中,划分得更加清楚。
5. 可观测性:从"给 Agent 加日志"变成"Agent 本身就是日志"
传统方式下,为了观察 Agent 到底做了什么,我们通常需要额外埋点、采集 Trace,再把数据发送到 LangSmith、Langfuse 等可观测平台。 dsh 的逻辑正好反过来:事件日志首先存在,Agent 的运行过程本身就是从这条事件流中产生的。 因此,可观测系统不再负责"创造"运行轨迹,而只是读取、分析已经存在的事件流。 这是一个看似细微、实际上很重要的架构变化。
6. Sub-Agent:甚至可以把竞争对手变成自己的"员工"
传统多 Agent 系统中,一般是一个 Orchestrator(协调器)启动多个 Worker,而这些 Worker 通常运行在同一套框架中。 dsh 则把 Sub-Agent 也抽象成了 Provider。 更有意思的是:这个 Provider 完全可以是另一家公司的 Agent Harness。 比如,同一个任务中: dsh 负责总调度 → 一部分任务交给 Claude Code → 另一部分任务交给 Codex → 最后再统一汇总结果。 理论上,构建这样一个同时调度 Claude Code 和 Codex 的 Orchestration Layer(编排层),核心甚至可以只是修改一份配置文件。 这样一来,多 Agent 的玩法就变得更加复杂,也更加有想象空间:未来所谓的"多 Agent",不一定是同一个框架里复制出多个智能体,也可能是多个不同厂商的 Agent 产品互相协作。
7. Models:模型也只是一个可替换部件
在传统厂商提供的 Agent 产品里,你通常主要使用这家厂商自己的模型。 而 dsh 从一开始就把模型视为 Provider。 因此,不同 Session 可以使用不同模型,并且可以针对不同模型分别调整 Reasoning Effort(推理强度)。 今天可以使用 DeepSeek,换一个任务可以接 OpenAI 或 Anthropic,也可以接企业自己的私有模型,甚至本地部署的兼容模型。 在这套体系里,模型不再天然处于整个架构的中心,它只是 Harness 中一个可以替换的智能模块。
把这些变化放在一起,就能看懂 dsh 真正想做什么。
过去开发 Agent 时,我们会花大量时间争论:
"Loop 应该怎么写?"
"上下文应该怎么压缩?"
"权限应该怎么设计?"
"Sub-Agent 应该怎么调度?"
"沙箱应该采用什么方案?"
讨论结束之后,我们通常会选定一种方案,然后把它写死在系统里。
而 dsh 提出的思路是:不要急着把这些设计决策写死,而是先把它们定义成标准接口,再允许不同的人提供不同实现。
这才是所谓"Harness 化"的真正含义。
dsh 并没有替开发者解决所有架构问题,也没有替你决定哪种 Agent Loop、上下文策略或安全机制最好。
它做的是另一件事:为这些原本需要写死在底层的设计决策,提供一个统一的"插座"。
以后想换方案,不必再拆掉整栋房子。
把旧模块拔下来,再把新的插上去即可。
第四部分:热度背后的"小字条款"------上线前两周,真实体验到底如何?
接下来才是新品发布的热潮中最容易被忽略的部分。
综合首批开发者的实测报告来看,dsh 的架构确实很有吸引力,但代价和问题同样明显。对于一个刚刚发布的 Developer Preview(开发者预览版),这些信息甚至比 GitHub Star 数量更值得关注。
1. Token 开销很高,而且不是"小高一点"
目前最突出的一个问题,是 dsh 的 Token 消耗。
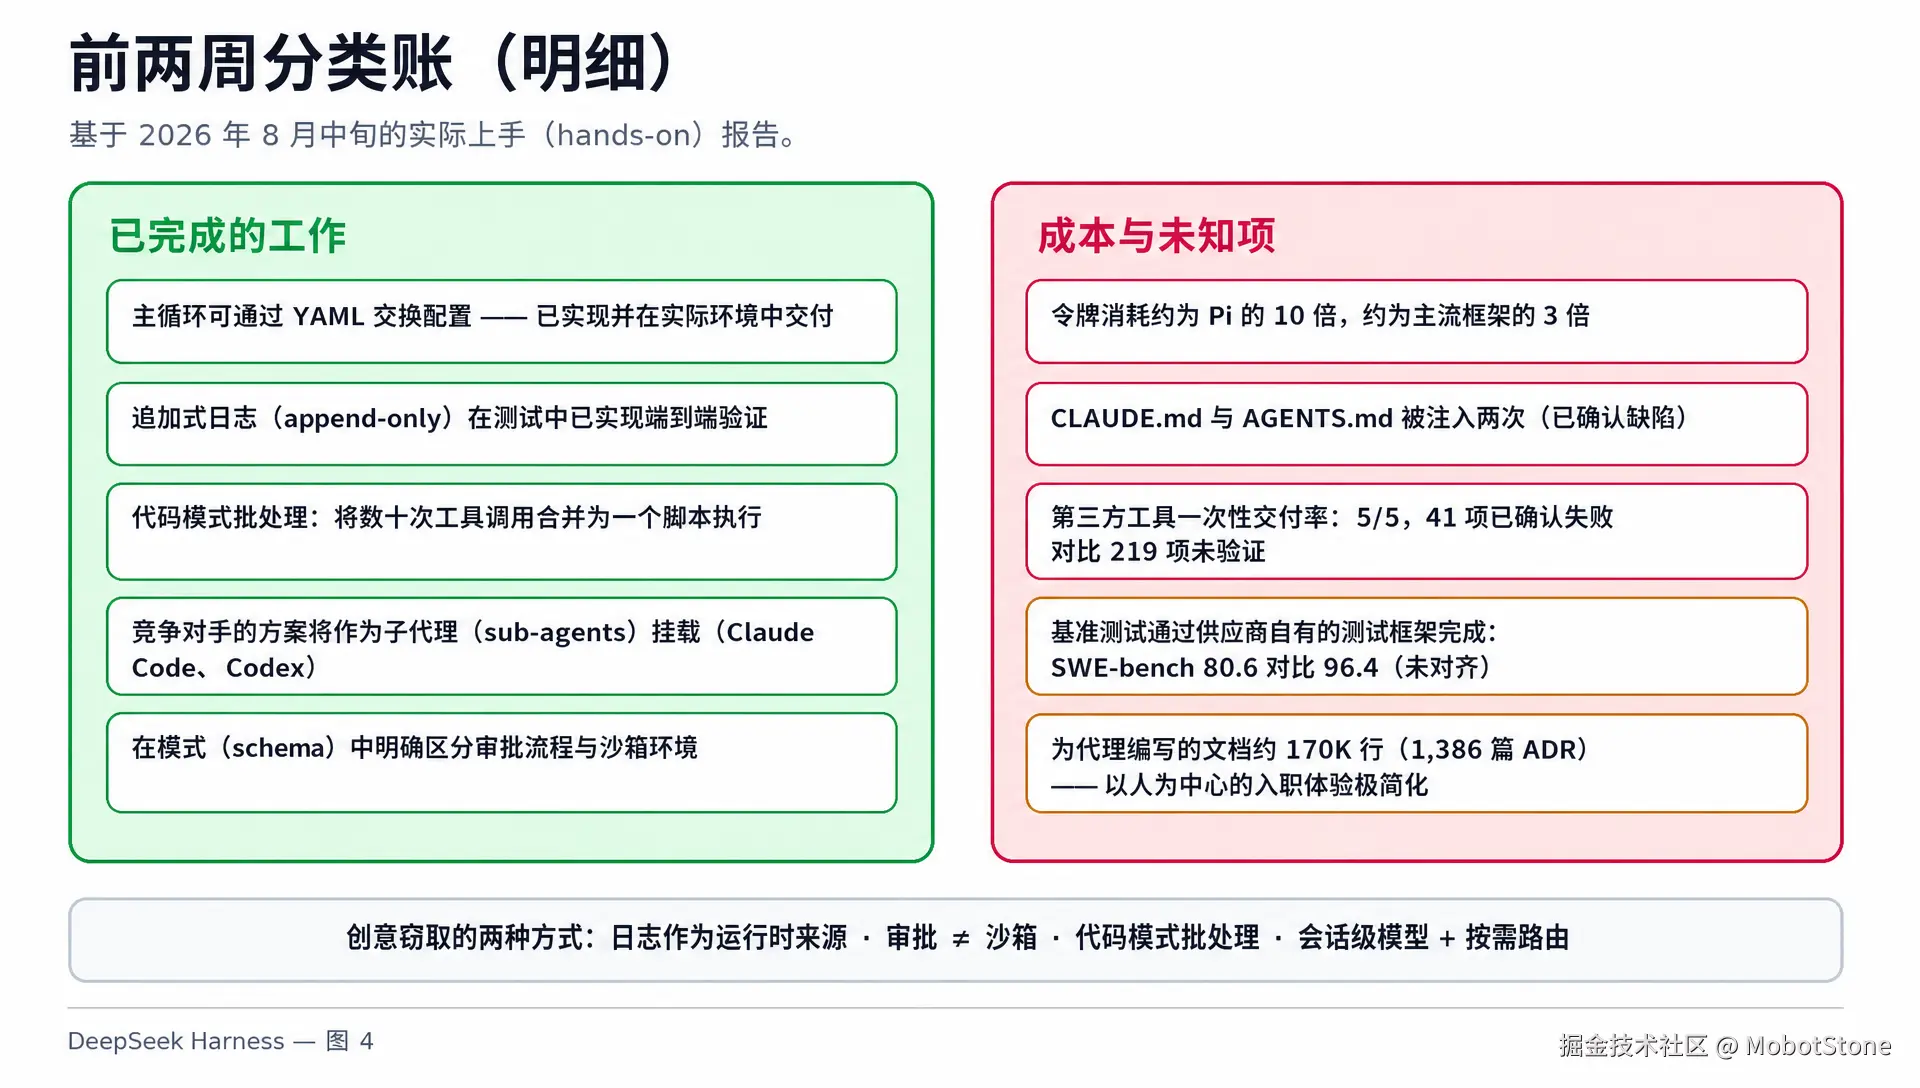
社区早期测试显示,在相近任务中,dsh 的 Token 用量大约是 Pi 的 10 倍。Pi 是一个刻意追求极简的 Harness,默认只有 4 个工具,System Prompt 还不到 1000 Token。
即使与其他主流 Agent 框架相比,dsh 的 Token 消耗也大约达到了 3 倍。
当然,其中一部分属于预览版的 Bug。例如已经确认的一个问题是:系统会把内容相同的 CLAUDE.md 和 AGENTS.md 重复注入两遍,导致这一部分 System Prompt 直接翻倍。
一个很极端的案例来自 ISS Tracker(国际空间站追踪器)项目。
测试者只进行了两轮较长的交互,运行约 35 分钟,累计 Token 消耗就接近 2000 万。
之所以最终账单还没有夸张到完全不可接受,很大程度上是因为缓存命中率达到了 95%~100% ,大量重复上下文走了缓存。
这也暴露出了一个很现实的问题:架构灵活性不是免费的。
如果一套高度模块化的 Harness 要消耗其他方案 3~10 倍的 Token,那么它就必须带来足以抵消这 3~10 倍成本的收益。
某些复杂项目中,这笔账可能划算;但在大量普通任务中,答案未必如此。
2. 第三方插件生态:理想很丰满,现阶段兼容性还没跟上
dsh 最大的卖点之一是"一切皆插件"。
但从第一批测试来看, "理论上什么都能插"与"实际上插上就能用",目前还是两回事。
有媒体在实测中尝试了 5 个第三方工具,结果 5 个全部接入失败。
项目刚发布时的兼容性列表中,只有 41 个集成被确认可以正常工作 ,另外 219 个仍处于"需要进一步验证"状态。
与此同时,社区插件仓库在两天内收到了超过 2000 个提交。
这个数字看起来非常惊人,但它和 9 万 GitHub Star 本质上反映的是同一种现象:社区热情已经先冲上去了,质量验证还远远没有跟上。
也就是:先有数量,再谈质量。
还有一个颇有意思的细节。
一位 Beta 测试者发现,有时候连 DeepSeek 自己的模型都搞不明白某个插件应该怎么使用。最后模型索性放弃插件接口,直接修改代码来完成任务。
测试者的评价大意是:"这样反而更快,效果也差不多。"
这其实点出了 Agent 工具设计中的一个经典问题:人类工程师觉得很优雅的抽象层,模型未必觉得好用。
你设计了一套漂亮的插件机制,模型看了一眼,然后说:算了,我还是直接改代码吧。
3. Benchmark 很亮眼,但评测方法还不够透明
V4-Pro 公布的 Agent Benchmark 成绩相当漂亮。
例如 Terminal Bench 2.1 达到了 87.9,另外还有 DeepSeek 自己内部的 DSBench 系列成绩。
但这里有一个非常重要的细节:这些成绩并不是单纯测试 V4-Pro 模型,而是模型配合 dsh 的 Minimal Mode 一起跑出来的。
也就是说,这实际上测的是:模型 + Harness 的综合能力。
这恰恰验证了一个越来越重要的事实:同一个模型,换一套 Harness,Benchmark 成绩可能出现明显变化。
以前大家习惯把排行榜上的数字理解成"模型有多强";但进入 Agent 时代后,这个数字越来越可能代表"模型和执行框架组合起来有多强"。
另一个争议来自 SWE-bench Verified。
目前 V4-Pro 出现了两个差距很大的成绩:DeepSeek 官方:80.6%
第三方评测:96.4%
两者足足相差约 16 个百分点,目前还没有一个权威解释把这两个数字统一起来。
需要强调的是,这并不意味着某一个数字被证明是假的。
真正的问题在于:评测方法、运行条件和 Harness 配置还不够透明。
因此,面对这类成绩,一个原则依然成立:公开 Benchmark 不等于你的业务评测;厂商公布的 Benchmark,也不应该直接替你做技术选型。
最终还是要拿自己的真实任务、真实成本和真实生产环境去跑。
4. 一个很特别的变化:文档开始不是写给人看的了
dsh 还有一个容易被忽略、但可能预示未来趋势的地方:它的大量内部文档,本身就是写给 Agent 看的
内部架构文档规模大约达到 17 万行,并通过 CI 检查,避免文档随着代码迭代而逐渐失真。
项目的 .agents/ 目录中,还有 1386 条架构决策记录(ADR) 。
这些资料明确把 Agent 当成主要读者之一。
有意思的是,与之形成对比的是:目前面向人类开发者的入门资料反而比较薄弱。
这可能只是 Developer Preview 阶段来不及补文档。
但也可能透露出一个更深层的变化:未来软件文档的第一读者,未必还是人类程序员。
当 Agent 开始承担越来越多的代码阅读、维护和开发工作,我们也许会越来越多地看到一种"AI First Documentation"------代码仓库首先确保 Agent 能理解整个项目,人类开发者反而成为第二读者。
现阶段,这两种解释大概都成立。
5. 开源是真的,但方向盘目前仍然握在 DeepSeek 手里
还有一些背景信息需要放在一起看。
这次 Harness 发布的同时,DeepSeek 还进行了涨价;部分早期用户认为 Pro 版本写代码的效果甚至不如 Flash,而从初步测试来看,Flash 的"成本 / 产出比"反而更加有吸引力。
与此同时,目前项目对外部 Pull Request 的贡献机制仍有一定限制。
仓库对自己的定位也很耐人寻味,大意是: "这是一个想法、一份官方示范和一个灵感来源,但不是要求所有人必须遵循的标准。"
这句话可以有两种理解。
比较积极的理解是:DeepSeek 很清楚这只是一个早期预览项目,所以没有把自己的方案包装成 Agent 架构的"标准答案"。
另一种更谨慎的理解则是:开源可以帮助项目快速传播和建立生态,但真正决定项目方向的权力,目前仍主要留在官方手中。
这两种判断并不冲突,现阶段都值得保留。
6. 真正用起来是什么感觉?
综合第一批上手报告,一个相当一致的评价逐渐浮现出来:它确实非常透明,但也确实很"重"。
GeekPark 的测试验证了 dsh 宣传中的透明性并非停留在 PPT 上。System Prompt、模型推理过程、工具调用等信息,确实能够从头到尾查看。
前面提到的 ISS Tracker 测试中,开发者通过两轮较长的 Agent 执行成功做出了一个可以工作的应用。
但测试结束后,他更推荐 Flash 而不是 Pro,原因很简单:从实际效果和成本综合来看,Flash 的性价比更高。
而几份早期体验报告中反复出现的感受,可以浓缩成两句话:底层机制看得非常清楚。 默认配置也确实非常重。
某种程度上,这恰好符合一个"Agent 操作系统开发者预览版"应有的样子。
它的目标不是成为最轻、最便宜、开箱即用的 Agent 工具,而是尽可能把模型、工具、上下文、权限、沙箱、日志乃至 Agent Loop 全部拆开,让开发者能够看到它们、理解它们,并替换它们。
因此,真正需要回答的问题并不是: "dsh 强不强?"
而是: "你的项目,真的需要这样一套可以拆到如此彻底的 Agent 基础设施吗?"
如果需要,那么它付出的复杂度和 Token 成本可能是值得的。
如果不需要,那么"一切皆插件"带来的自由,也可能只是你最终根本用不到的自由。
第五部分:DeepSeek Harness 意味着什么?三种不同的解读
如果跳出具体功能,从产业和战略层面来看,dsh 的意义可能比"一套新的 Agent 开源框架"更大。
目前至少可以从三个角度理解 DeepSeek 为什么要做这件事。
1. 第一种解读:让模型进一步"商品化"
DeepSeek 模型的一大优势一直是价格。
但它面临的现实问题也很明显:尤其在中国以外的市场,DeepSeek 在开发者覆盖、生态分发以及企业信任度方面,并不一定占优势。
因此,一套采用 MIT 许可证、而且能够运行任何厂商模型的 Harness,就可能成为一个非常有效的切入口。
开发者一开始甚至不需要使用 DeepSeek 模型。
你完全可以先用 dsh,然后在里面接入 OpenAI、Anthropic、Gemini 或本地模型。等整个 Agent 系统都建立在这套基础设施之上后,一个新的选择逻辑就出现了:既然 Harness 已经统一了模型接口,那么谁能以更低的价格提供"足够好"的能力,谁就更容易被默认选中。
而这恰恰是 DeepSeek 擅长的战场。
从这个角度看,dsh 原生支持把 Claude Code 和 Codex 当作 Sub-Agent,也就变得很好理解。
DeepSeek 未必需要正面打败 Claude Code 或 Codex。
它甚至可以直接把它们装进自己的框架里。
让 dsh 成为更上一层的调度平台:需要 Claude Code 时调用 Claude Code,需要 Codex 时调用 Codex,需要便宜的大规模执行时再切到 DeepSeek。
这与美国头部 AI 厂商正在采取的路线,恰好形成了某种镜像。
Anthropic 和 OpenAI 正在越来越多地把"模型 + Harness"打包成完整产品,比如 Claude Code 的订阅方案、Codex 与现有产品体系的深度捆绑。
原因很简单:对于这些公司来说,Harness 本身正在成为护城河的一部分。
而 DeepSeek 的打法可能恰恰相反:别人用 Harness 修护城河,DeepSeek 则试图用开源 Harness 撬开护城河。
2. 第二种解读:这不仅是产品,也是一个 Agent 研究平台
如果仔细观察 dsh 的架构,会发现很多设计并不只是为了方便普通开发者。
它们同样非常适合研究、训练和改进 Agent。
比如:
只追加、不篡改的完整事件日志,可以重放的任务执行过程,可以随时替换的 Agent Loop,能够检查自身运行状态的 cordis_* 工具,以及大量直接写给 Agent 阅读的 ADR(架构决策记录)。
这些东西组合到一起,本质上构成了一套非常完整的Agent 实验基础设施。
尤其值得注意的是完整的 Trajectory(执行轨迹)。
如果要通过强化学习(RL)训练 Agent 完成长链条任务,那么最有价值的数据之一,就是:
Agent 看到了什么 → 做出了什么判断 → 调用了什么工具 → 工具返回了什么 → 接下来又如何行动 → 最终任务成功还是失败。
而 dsh 的事件日志天然就在生产这种数据。
同样,如果未来要研究"能够自己修改、扩展甚至进化的 Agent",那么可重放的运行过程、可替换的 Loop,以及允许 Agent 检查和生成插件的能力,也都是非常理想的实验条件。
从这个角度来看,dsh 强调"透明"就不仅仅是一种开源精神。
它同时还可能是一种训练数据战略。
这一点放到整个中国大模型生态中看,会更加有意思。Qwen Code、Trae、Kimi CLI、ZCode 等项目都在不同程度上拥抱开放或开源的 Agent 工具链。
背后的逻辑可能是:开放 Harness → 获得更多真实 Agent 使用场景 → 产生更多完整执行轨迹 → 反过来帮助训练下一代 Agent 模型。
因此,"透明"不仅是一项产品特性,也可能成为 Agent 时代的数据供应链。
3. 第三种解读:Agent 正在出现两条截然不同的路线
这可能是最值得长期关注的一层。
有人用一个非常形象的比喻概括了当前 Agent 架构的两种哲学:Pi 认为 Agent 应该是一把小而锋利的刀。
它追求简单、轻量、低 Token 消耗:几个核心工具,加一个短小的 System Prompt,让强大的模型自己解决问题。
而 dsh 押注的是另一种未来:Agent 会越来越复杂,最终复杂到需要一套属于自己的"操作系统"。
当 Agent 开始拥有多个模型、几十种工具、多层权限、不同沙箱、Sub-Agent、任务调度、长期会话、上下文管理、持久化状态以及完整的可观测系统时,它就已经不太像"一段 Prompt 加几个 Tool"了。
它更接近一个真正的软件系统。
如果未来 Agent 真的发展到这个阶段,那么 Cordis、可插拔 Loop、Event Sourcing、Sandbox Provider 这些今天看起来略显"重"的设计,就可能变得非常合理。
但这并不意味着 Pi 的路线是错的。
两条路线完全可能同时成立。
简单任务、小团队和个人开发者,可能更适合"一把锋利的小刀";大型企业、复杂 Coding Agent、长期运行的自动化系统,则可能逐渐需要"Agent OS"。
真正的区别只是:不同用户会在不同时间点达到那个复杂度拐点。
而 DeepSeek Harness 最重要的意义,或许正在这里。
过去,大模型是所有人关注的主角,Harness 只是藏在模型背后的"脚手架",很少有人认真讨论它。
现在,一家头部 AI 实验室已经公开把筹码押在这一层。
这意味着一个趋势已经越来越难以忽视:Agent 时代真正的架构之争,正在从"模型有多聪明",逐渐延伸到"如何把聪明的模型组织成一个真正能持续完成任务的系统"。
曾经最不起眼的"脚手架",正在变成新的主战场。
第六部分:到底要不要用 DeepSeek Harness?给开发者的选择建议
综合目前已经公开的资料和首批实测,如果你正在考虑是否把 dsh 用到自己的项目里,可以按照一个很简单的原则来判断:你现在需要的是一个成熟好用的 Agent 产品,还是一套可以深度改造的 Agent 基础设施?
1. 这些情况,可以现在就尝试 dsh
如果你本身就在开发 Agent 基础设施 ,比如多 Agent 编排层、自定义 Agent Loop、评测系统,那么 dsh 很值得研究。
原因不只是"一切皆插件",而是它提供了一套相对完整、容易观察,而且采用 MIT 许可证的参考实现。尤其是它真正把 Event Sourcing(事件溯源)做进了底层架构,而不是把日志作为后期外挂的监控能力。
如果你的企业特别强调审计和可追溯性,它也值得关注。
例如,你需要回答:
"Agent 当时到底看到了什么?"
"为什么调用了这个工具?"
"某一步具体执行了什么?"
"能不能把当时的运行过程完整重放?"
那么 dsh 的"日志即运行"设计具有明显价值。当然,目前还是开发者预览阶段,你也要愿意承担相应的"预览版税":更高的 Token 消耗、更粗糙的体验,以及可能频繁变化的接口。
对于研究 Agent 架构的人来说,它同样是一份很有价值的研究材料。尤其是 .agents/ 目录里的大量架构决策记录,本身就像是一套关于"如何设计 Agent Harness"的课程。
2. 这些情况,现阶段更适合等等
如果你只是想找一个现在就能稳定干活的 Coding Agent ,那目前没有太强的理由为了架构上的优雅而立即切换到 dsh。
Claude Code、Codex 等成熟产品在完成度上依然更高,而且 Token 效率明显更好。
如果你的业务高度依赖第三方插件和外部集成,也建议谨慎。目前"41 个确认可用、219 个尚待验证"的比例,还不足以成为生产系统可以放心押注的生态基础。
成本也是一个不能忽略的问题。
如果目前相同任务需要付出主流方案 3~10 倍的 Token 开销,而你的业务本身又对推理成本非常敏感,那么最好等待框架进一步优化。
架构再漂亮,最终也得算账。
3. 即使不用 dsh,也值得"抄走"这四个设计
实际上,你完全可以不采用 DeepSeek Harness,却把其中最好的设计理念带回自己的 Agent 系统。
最值得借鉴的是四点:
- 日志就是运行本身:凡是模型看到的内容,都必须进入日志。这样才能真正实现审计、重放和调试。
- 审批与沙箱必须分开:审批解决"用户是否同意",沙箱解决"程序实际上能访问什么"。二者绝不是同一个安全机制。
- 用 Code Mode 批量执行工具:与其让模型连续发起十几次零散 Tool Call,不如生成一段受控脚本,一次组合多个工具完成任务。
- 按 Session 动态选择模型和推理强度:不是所有任务都值得使用最贵、推理最深的模型。模型路由与 Reasoning Effort 应该成为运行时策略的一部分。
这些思想都不依赖 Cordis,也不要求你迁移到 dsh。
这恰恰是开放 Harness 最有价值、也最容易被低估的一点:即使最后没人采用你的整套软件,其中优秀的架构思想依然可以传播出去。
4. 最重要的一条:不要拿厂商 Benchmark 替代自己的评测
无论最终用不用 dsh,还有一个原则值得反复强调:
所有 Agent Benchmark,都应该放到你自己的环境里重新跑一遍。
包括本文前面提到的那些漂亮数字。
因为 DeepSeek 测试 V4-Pro 时,用的是 DeepSeek 自己的 Harness。这个成绩反映的是特定条件下"模型 + Harness"的综合表现,而不一定代表模型放进你的系统后还能得到同样结果。
进入 Agent 时代以后,我们甚至需要逐渐改变一个习惯:不要只问"这个模型跑分多少",而应该问"这个模型在我的 Harness、我的工具、我的权限规则和我的真实任务里,表现怎么样"。
厂商用自己的 Harness 测模型。
你也应该用自己的 Harness 测它。
最后用一份简化的 dsh 配置,就能很直观地理解它的整个设计哲学:
yaml
# 一份 dsh 配置,本质上就是 Agent 的"零件清单"

# 大脑:可以换 DeepSeek、Anthropic、OpenAI、本地模型......
model:
  provider: deepseek
  name: v4-flash
  effort: medium

# 思考与行动方式:注意,连 Loop 都只是插件
loop: plan-act-verify

# Agent 能使用哪些工具
tools: [files, shell, search]

# Agent 实际能触碰哪些系统资源
sandbox:
  provider: landlock
  policy: workspace-write

# 敏感操作是否需要人工确认
approval: ask

# 子 Agent:甚至可以把竞争对手的 Harness 当作 Worker
subagents:
  - provider: claude-code

# Session 如何保存
# append-only:只允许追加,因为"日志就是运行本身"
session:
  store: sqlite
  log: append-only
这几十行配置,其实已经浓缩了 DeepSeek Harness 最核心的想法:模型、Loop、工具、沙箱、审批、Sub-Agent、Session,都不是不可触碰的系统核心,而是一组可以自由组合和替换的零件。
所以,对于大多数开发者来说,现在未必需要立刻把现有系统迁移到 dsh。
但对于所有正在构建 Agent 的人来说,它值得研究。
因为真正值得关注的,可能并不是 DeepSeek Harness 最终会不会成为行业标准,而是它把一个问题明确摆到了整个行业面前:当模型越来越容易替换之后,你真正应该掌握在自己手里的,究竟是模型,还是那套让模型能够持续做事的系统?
第七部分:常见踩坑方式------团队最可能在哪些地方用错 dsh?
越是自由、可扩展的架构,越容易让人产生一种错觉:既然什么都能换,那就应该把什么都做成可替换的。
但从 dsh 目前的状态来看,真正的风险可能不是"它能力不够",而是团队过早、过度地使用这些能力。
1. 把一个架构理念,当成成熟产品直接上生产
dsh 最吸引人的地方,是它背后的设计哲学。但不要因此忽略一个基本事实:
它目前仍然只是 Developer Preview(开发者预览版)。
官方已经明确表示,后续可能出现 Breaking Changes(破坏性变更)。今天能运行的配置、插件和接口,未来版本升级后不一定还能原样工作。
因此,现阶段更合理的做法是:先在基础设施实验、内部工具和非核心项目中试用,而不是直接搬到承担核心收入的生产业务上。
可以研究它,可以验证它,但没必要把最重要的业务拿去陪一个预览版一起迭代。
2. 只看到模型便宜,却忽略 Harness 多吃了多少 Token
这可能是最容易被低估的成本陷阱。
DeepSeek 模型价格可能很有竞争力,但如果 dsh 在实际任务中产生了 3~10 倍的额外 Token 开销,那么模型单价上的优势很可能被 Harness 悄悄吃掉。
所以不要只比较:"每百万 Token 谁更便宜?"
真正应该比较的是: "完成同一个真实任务,最终总共花了多少钱?"
解决办法也很简单:上线前把 Token、缓存命中率、模型调用次数、执行时间和最终成本全部量化。用现有系统跑一次,再用 dsh 跑一次。
最后让数据决定,而不是让架构理念决定。
3. 把"模型 + Harness"的成绩,当成模型本身的能力
前面提到的 Terminal Bench 87.9,就是一个典型例子。
这个数字并不只是 V4-Pro 的成绩,而是:V4-Pro + 特定 Harness 配置的综合成绩。
进入 Agent 时代之后,这种情况会越来越普遍。同一个模型搭配不同 System Prompt、工具集合、Context 策略、Loop 和重试机制,最后的 Benchmark 完全可能差很多。
因此,不要简单理解成:"V4-Pro 的能力就是 87.9。"
更准确的说法应该是:"这套模型与 Harness 的组合,在这套评测环境中跑出了 87.9。"
dsh 提供 Minimal Mode,本身就可以帮助减少 Harness 带来的干扰。但即便如此,最终仍然应该使用自己的任务集重新评测。
4. 把"热插拔"当成万能锤子
dsh 很酷的一项能力,是运行过程中直接换组件。
甚至 Agent Loop 都能动态替换。
技术上这当然很漂亮,但问题是:你的业务真的需要吗?
绝大多数团队可能根本不需要在一个 Session 执行到一半时,突然把 Plan-Act-Verify Loop 换成另一套 Loop。
很多时候,重启进程可能只需要 3 秒。
如果为了避免这 3 秒重启,却引入一整套动态依赖、生命周期管理、副作用回滚和插件卸载机制,那么很可能是在用复杂度解决一个并不存在的问题。
因此,更值得学习的是 dsh 的接口设计思想,而不是照搬所有"仪式感"。
先问两个问题:我到底需要动态更换什么?又会在什么时候更换?
如果答不出来,就暂时不要为了 Hot Swap 而 Hot Swap。
5. 不要因为有 2000 个插件,就默认这 2000 个插件可信
两天产生 2000 个社区插件,说明生态热度非常高。
但从安全角度来看,这句话也可以换一种表达:短短两天,出现了 2000 份你没有审计过的第三方代码。
Agent 插件往往可以接触文件、Shell、网络、凭据,甚至其他内部系统,因此它们带来的供应链风险比普通 UI 插件更值得警惕。
正确的处理方式不是"装上试试看",而应该像管理生产依赖一样:锁定版本、检查源码、限制权限,并默认把社区插件视为不可信代码。
因为从安全模型来看,它们本来就应该被视为不可信代码。
6. "开源"不等于"社区共同治理"
dsh 使用 MIT 许可证,这意味着你拥有非常大的代码使用、修改和 Fork 自由。
但这并不意味着项目路线由社区共同决定。
目前外部 PR 仍受到限制,项目 Roadmap 的最终方向依然主要掌握在 DeepSeek 手中。
因此,不要把:Open Source(代码开放)
自动理解为:Community Governed(社区治理)。
MIT 真正给你的安全感不是"官方以后一定会听你的",而是:如果有一天官方路线与你的需求完全不同,你有权 Fork,然后自己继续维护。
所以企业采用时,最好按照一个更稳妥的假设做规划: 上游项目不欠你任何东西。
你需要确认的是,一旦官方改变方向、接口停止维护,团队有没有能力自己接手。
7. 不要轻易允许 Agent 自己修改插件
dsh 的 Creator Mode 很有想象力。
通过 cordis_* 工具,Agent 可以检查自己的插件系统,甚至生成、修改插件,从某种意义上实现"自己扩展自己"。
这也是所谓 Self-evolving Agent(自进化智能体)最诱人的方向之一。
但这些能力默认关闭是有原因的。
一个拥有工具执行权限的 Agent 已经需要严格控制;如果再允许它修改"决定自己拥有什么工具、权限和行为方式"的代码,相当于让系统在运行时修改自己的能力边界。
这非常适合做研究,但距离成熟的生产模式还有很远。
因此,在任何接近生产环境的系统中,现阶段都更适合保持 cordis_* 自修改能力关闭。
"Agent 能不能修改自己"是一个值得研究的问题,不应该被当成默认的工程实践。
归根结底,dsh 最大的优势------高度开放、模块化和可替换------同时也是最容易制造复杂度和风险的地方。
正确的使用方式并不是"既然都能换,那就全部动态化",而是:借鉴它的接口,保留你真正需要的自由,把暂时用不到的复杂度留在门外。
第八部分:如何快速体验 dsh?一个周末就够了
如果你只是想弄明白 dsh 到底特别在哪里,没必要花一整周研究源码。
用 4 个小时做几个针对性实验,基本就能理解它最重要的设计思想。
第 1 小时:先跑起来,重点看 Agent 到底"看到了什么"
首先启动本地 Web UI:
bash
npx @deepseek-ai/dsh web打开浏览器里的本地界面,找一个无关紧要的测试代码仓库,然后用 Standard Mode(标准模式) 给 Agent 一个简单任务。
比如修一个小 Bug、补一个测试,或者实现一个简单功能。
这里不要只盯着最终生成的代码。
真正值得看的,是 Trajectory(运行轨迹) 。
一边让 Agent 工作,一边观察整个事件流:系统给模型注入了哪些 Prompt?模型每一步拿到了什么上下文?调用了哪些工具?工具返回的结果又是如何进入下一轮上下文的?
如果你过去只是通过聊天界面使用 Coding Agent,这个过程会非常直观地告诉你一件事:所谓 Agent,并不只是"一个更聪明的大模型",而是 Harness 在不断决定模型这一刻能看到什么、能做什么,以及下一步应该得到什么信息。
单是把 Trajectory 完整看一遍,就已经是一堂不错的 Agent Harness 入门课。
第 2 小时:保持任务不变,只换 Harness 配置和模型
接下来,用同一个任务再跑一次。
这次切换到 Minimal Mode(极简模式) 。
然后保持 Harness 尽可能不变,再把底层模型换成另一家模型,重新执行。
这样只需要切换几个选项,就能亲手验证一个非常重要的结论:同一个模型,换一套 Harness,可能变成完全不同的 Agent;同一套 Harness,换一个模型,表现同样会发生明显变化。
因此,Agent 的最终能力从来不只是 Model 决定的。
更接近:Agent 能力 = Model × Harness × Tools × Context × Execution Strategy
这比单纯比较模型 Benchmark 更接近真实世界。
第 3 小时:体验一次"时间旅行"
找一个已经执行完成的 Session。
不要重新开始,而是从历史执行过程中的某个节点创建一个 Fork(分支) 。
然后修改前面的一项决策,让 Agent 从那里重新运行。
比如原来 Agent 选择方案 A,你可以让新分支尝试方案 B,再比较两条执行轨迹最终有什么不同。
这就是事件溯源和可重放架构最直观的价值。
传统 Agent 调试经常是:"刚才跑错了,再从头跑一遍。"
而有了完整事件日志之后,就可以变成: "回到第 12 步,从这里重新选择一次。"
你不需要先搭建复杂的分布式工作流系统,就可以直接在自己的电脑上体验类似 Checkpoint(检查点)、Replay(重放)、Fork(分支)和"时间旅行"的能力。
第 4 小时:亲手写一个最小插件
最后,自己写一个 Hello World 插件。
基础版本只有大约 8 行代码。然后注册一个简单 Tool,观察它如何进入 dsh 的工具执行 Pipeline:注册 → 模型发现工具 → 发起调用 → 权限检查 → 执行 → 返回结果 → 写入事件日志。
做到这里,你基本就理解了"一切皆插件"并不只是一句宣传语,而是一套具体的工程机制。
接着去 .agents/ 目录里随便挑 3 条架构决策记录读一遍。
重点不是记住里面的实现细节,而是观察 dsh 的开发者如何解释:为什么要这样设计?他们考虑过哪些替代方案?为什么最终选择现在的架构?
这往往比直接啃几万行源码更容易理解整个项目。
四个小时之后,就可以停了
没必要因为项目有 9 万 Star,就顺手给自己安排一个"通读 dsh 源码"的长期任务。
做完上面四个实验后,问自己一个更有价值的问题: "这里面哪两个设计,值得搬进我自己的 Agent 技术栈?"
可能是"日志即运行",可能是 Approval 与 Sandbox 分离,也可能是可替换 Loop、Code Mode 或 Session Fork。
把这两个答案写下来。
对于大多数开发者而言,这可能才是花四个小时研究 dsh 能得到的最高回报。
结语:一个观点,终于变成了一个开源项目
对于 DeepSeek Harness,目前大致有两种看法。
一种认为它有些"过度设计":为了多数人用不到的热插拔能力,可能付出 3~10 倍的 Token 开销;Benchmark 基于自家 Harness 测试;大量社区插件也尚未经过充分验证。从这个角度看,最好的选择是再等几个月,继续使用更成熟、轻量的工具。
另一种则认为,预览版的问题只是暂时的,真正重要的是它背后的架构:Agent Loop 可以替换,日志就是运行本身,审批与沙箱彻底分离,甚至 Claude Code、Codex 都能成为它的子 Agent。
更重要的是,DeepSeek 用一个 MIT 开源项目正式表达了一个判断:Harness 值得像模型一样,被当作核心产品来设计。
过去两年,"Harness 才是产品"更多是 Agent 开发者之间的共识;现在,一家头部 AI 实验室真正把筹码押在了这件事上。
因此,dsh 最终能不能成为主流,反而没那么重要。它真正代表的变化是:Agent 的竞争,正在从"谁的模型更强",扩展到"谁能更好地让模型完成真实任务"。
模型这个"发动机"会继续按照厂商的路线升级,但 Harness 这辆"车",依然可以掌握在开发者自己手里。
而现在,DeepSeek 又提供了一种新选择:不必从零造车,可以拿一套开源零件自己组装,甚至修改它的"承重结构"。
如果只打算花一个小时体验 dsh,最值得看的就是 Trajectory(运行轨迹):逐条观察 Harness 到底给模型提供了什么信息,以及模型如何一步步完成任务。
因为看完之后,你会更清楚一件事: Agent 的能力,从来不只来自模型本身。