Retrieval直接翻译过来即"检索",本章Retrieval模块包括与检索步骤相关的所有内容,例如数据的获
取、切分、向量化、向量存储、向量检索等模块。
官方文档地址:https://docs.langchain.com/oss/python/langchain/retrieval
一、Retrieval模块的设计意义
1.1 大模型的局限
1)知识滞后
LLM 训练数据有截止日期,无法及时反映最新的信息或动态变化。比如:难以应对诸如"请推荐当前
热门影片"等时间敏感性问题。
2)知识缺失
大型语言模型(LLM)的训练依赖于网络上海量公开的静态数据,而某些特定领域(如企业内部资
料、专有技术文档等)或你的私有数据是缺乏的,导致模型回复时生成不准确甚至虚构的回复。
3)幻觉
LLM 在生成回答时,可能会"胡言乱语" ,这种现象称之为 LLM 的"幻觉"。"幻觉"可以体现为错误陈述、
编造事实、错误的复杂推理或者复杂语境下理解能力不足等。
幻觉问题的严重性:
大模型生成内容的不可控,尤其是在金融和医疗领域等领域,一次金额评估的错误,一次医疗诊断
的失误,哪怕只出现一次都是致命的。但,对于非专业人士来说可能难以辨识。目前还没有能够百分之
百解决这种情况的方案。
幻觉产生的原因:
-
训练知识存在偏差,这些错误信息被 LLM 学习后在输出中复现
-
LLM 训练时过度泛化,将普通的模式应用在特定场合导致不准确输出
-
LLM 本身没有真正学习到训练数据中深层次的含义,导致在一些需要深入理解或复杂推理的任
务中出错
-
LLM 缺乏某些领域的相关知识,在面临这些领域的相关问题时编造不存在的信息
当前大家普遍达成共识的一个方案:
首先,为大模型提供一定的上下文信息,让其输出会变得更稳定。
其次,利用本章的RAG,将检索出来的文档和提示词输送给大模型,生成更可靠的答案。
1.2 什么是RAG
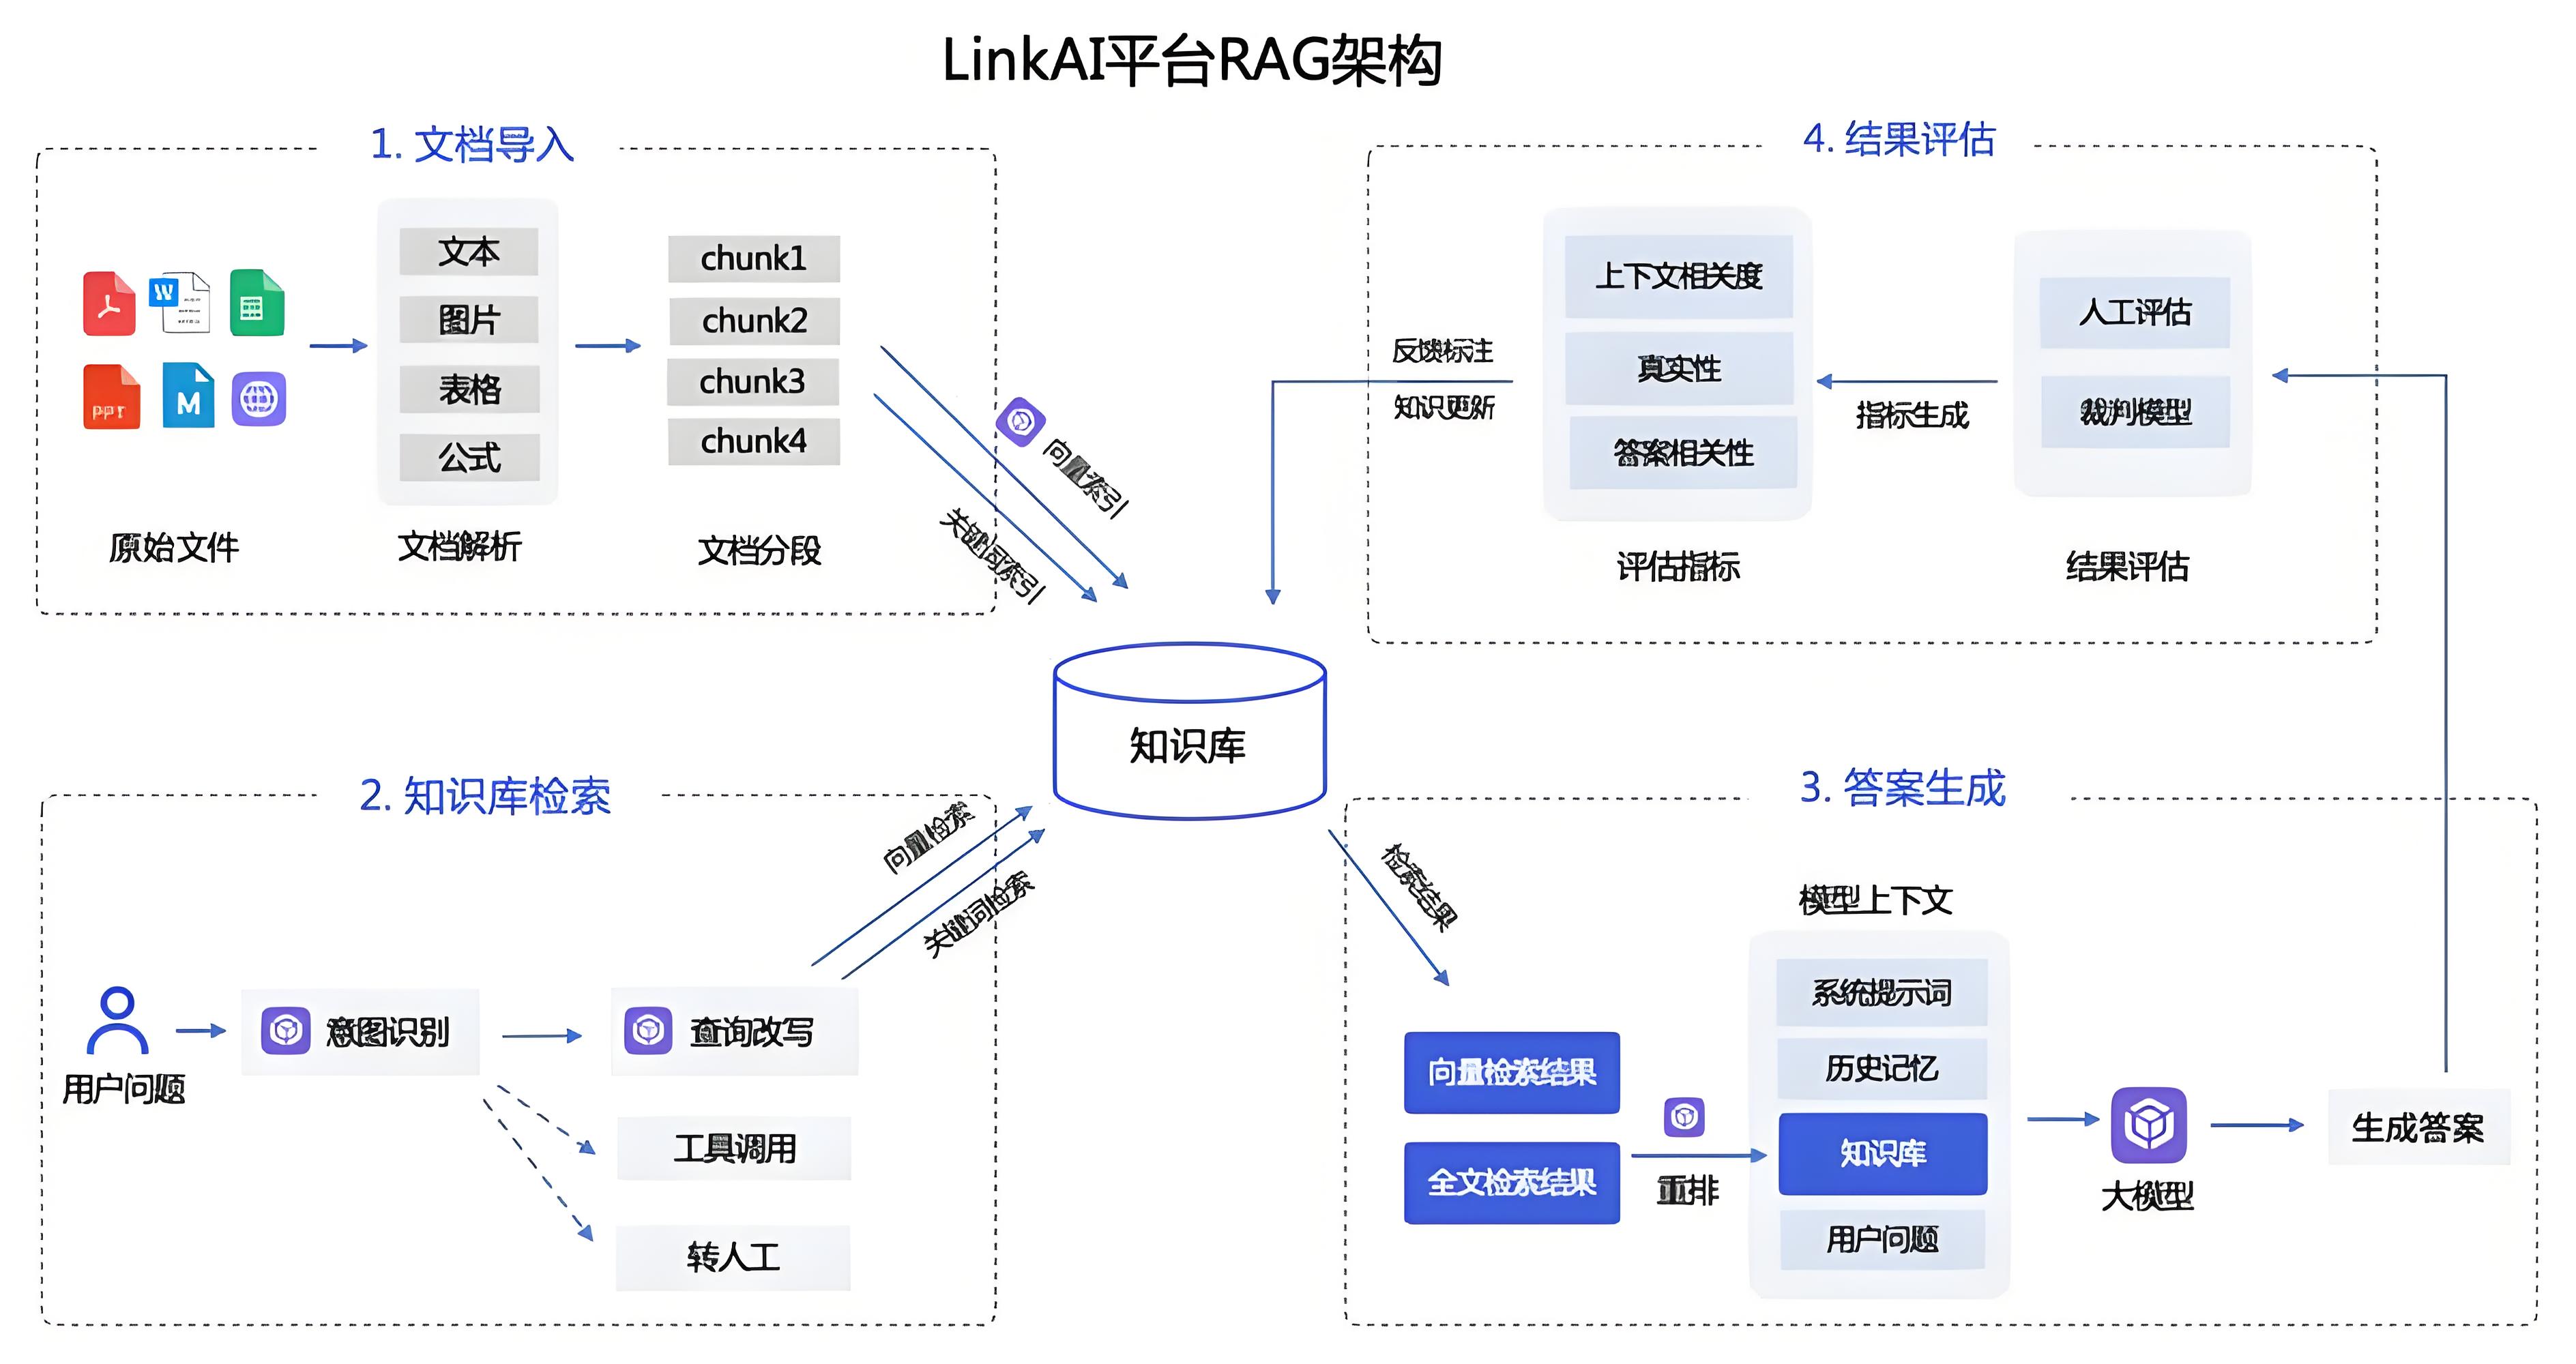
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合信息检索(Retrieval)与文本
生成(Generation)的技术,旨在提升大语言模型在回答专业问题时的准确性和可靠性。
典型的检索流程如下:(官方)
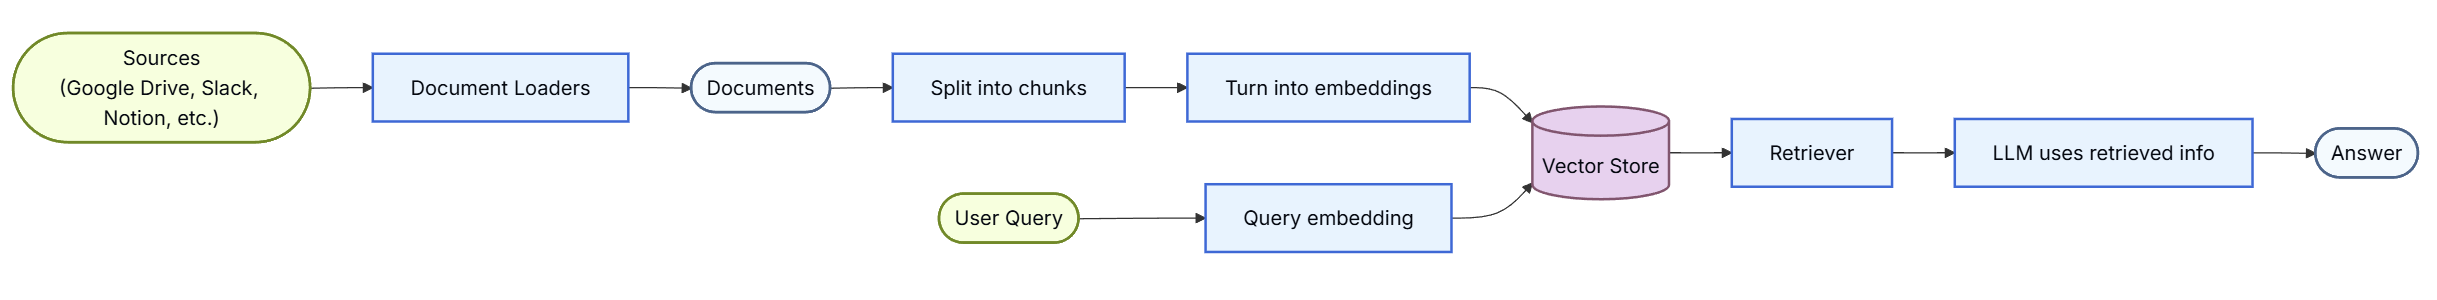
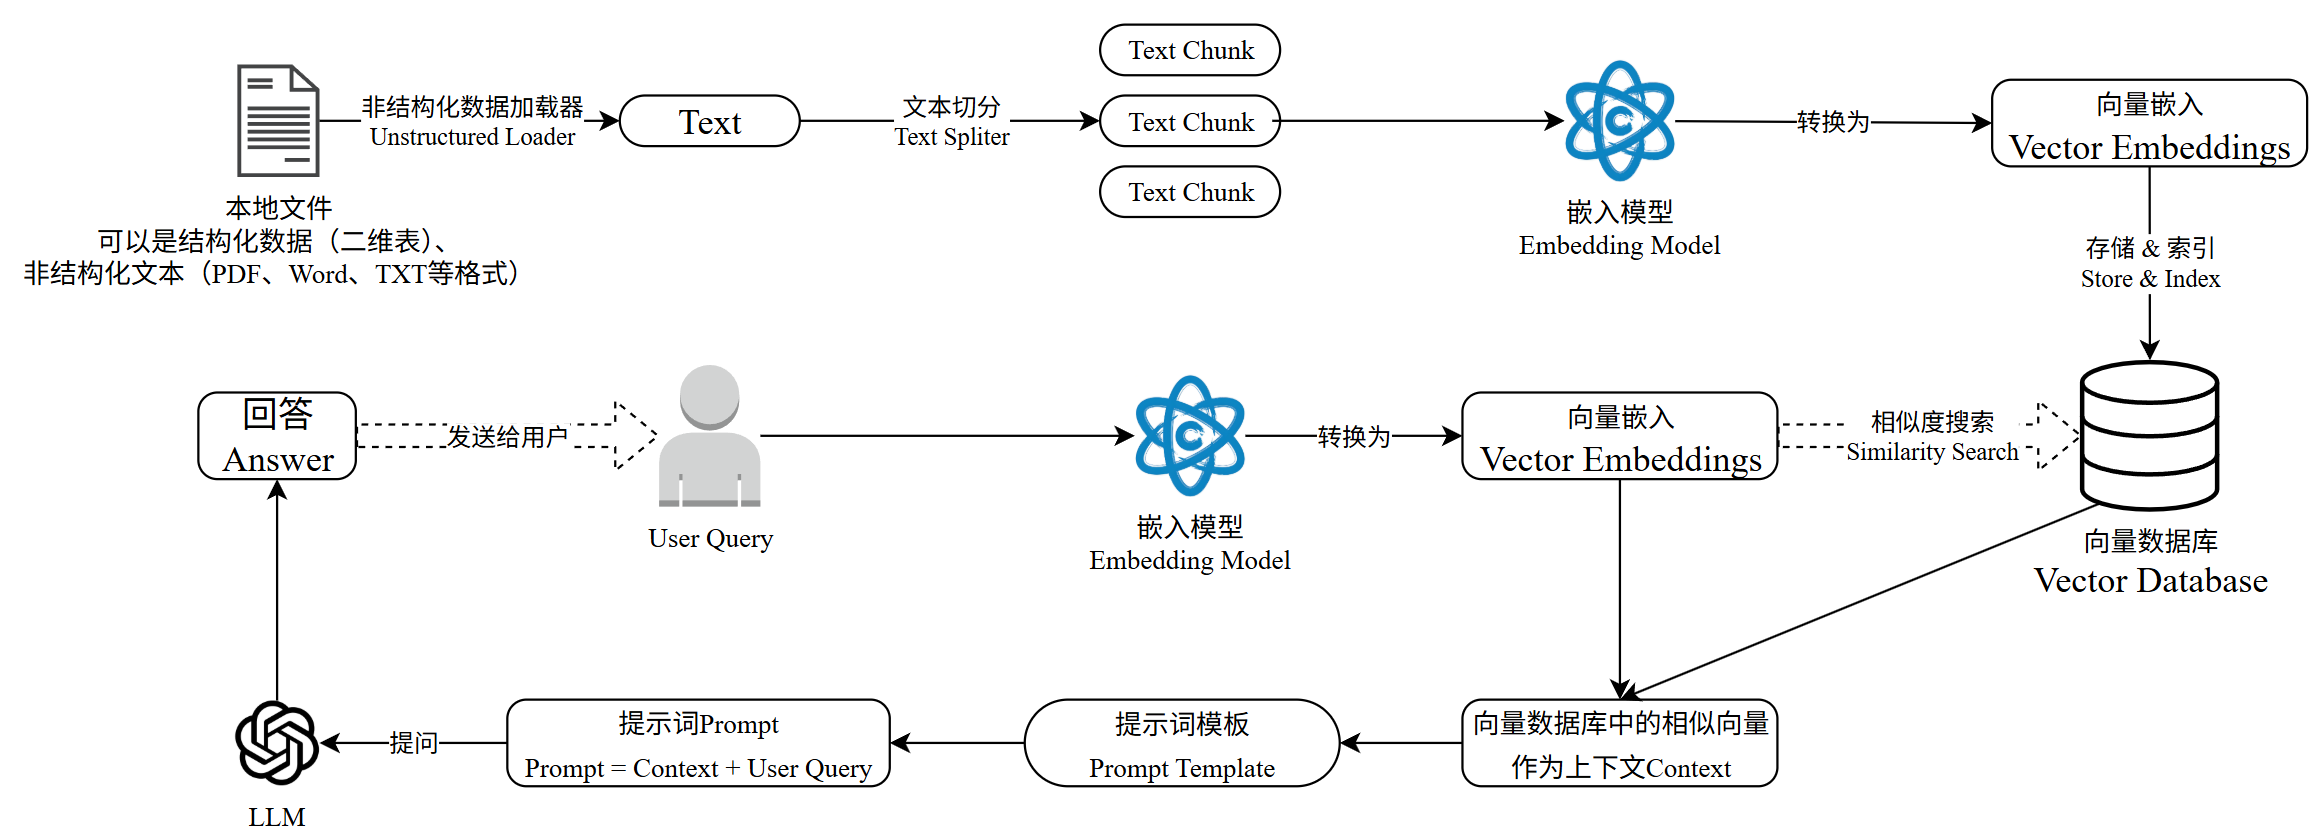
即:
简单举例:
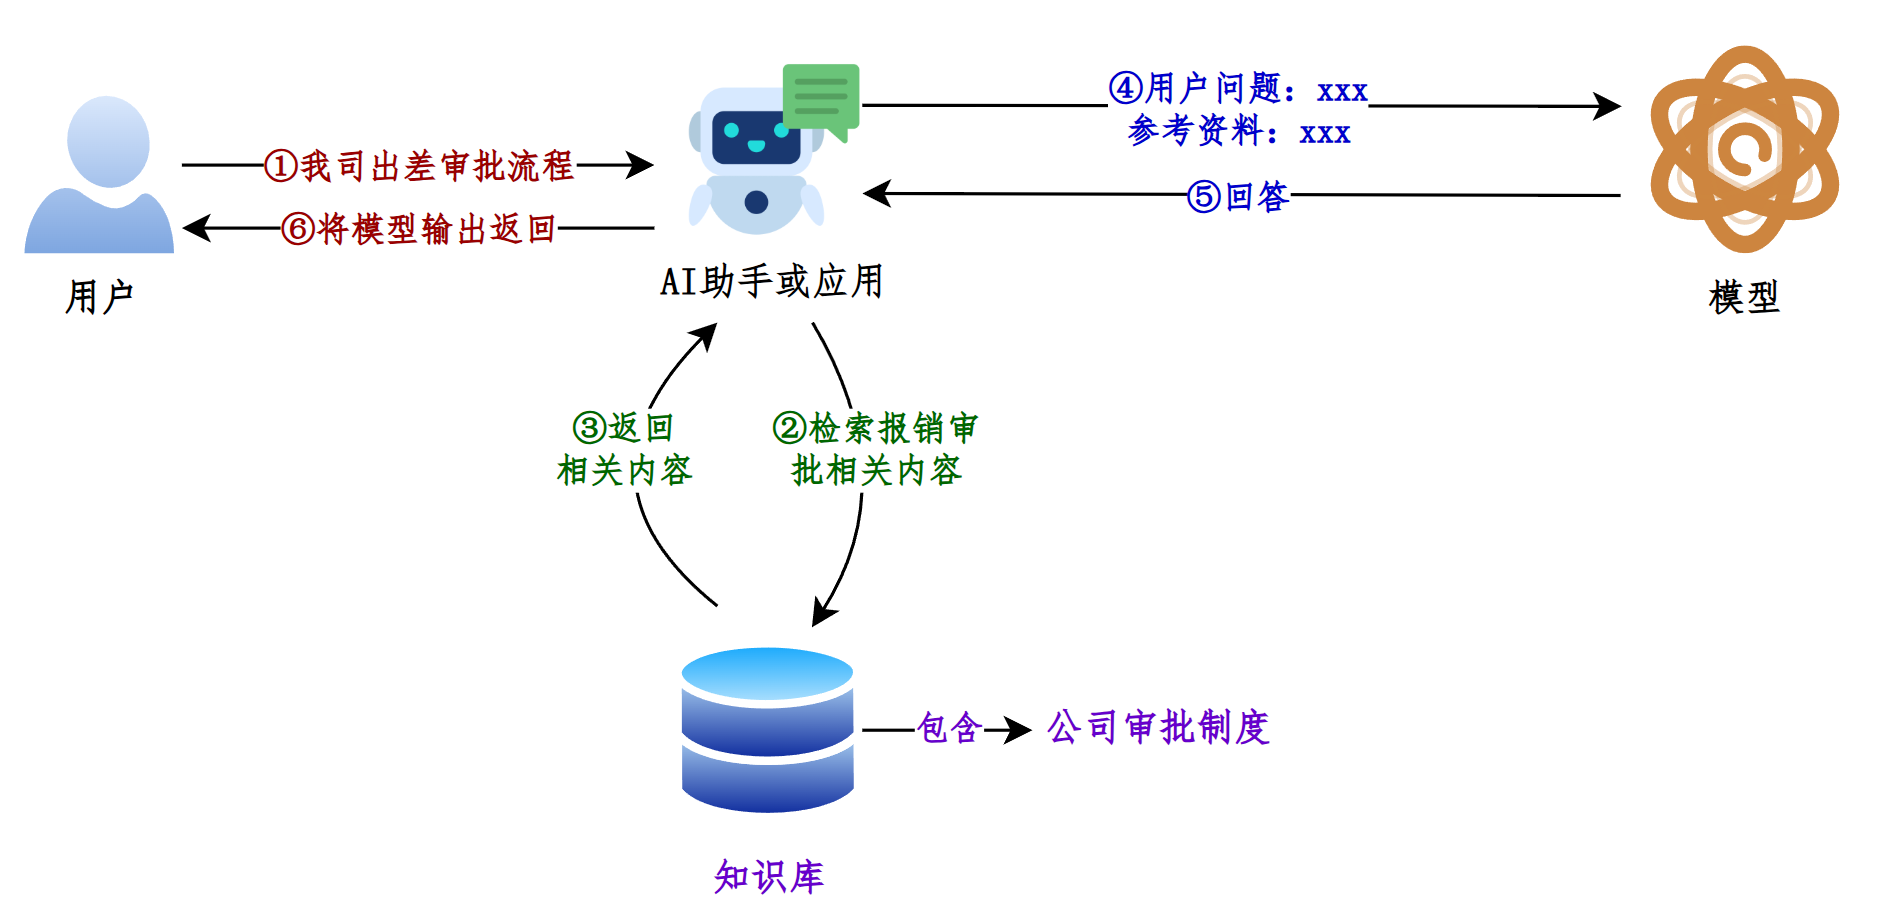
如果说LangChain相当于给LLM这个"大脑"安装了"四肢和躯干",RAG则是为LLM提供了接入"人类
知识图书馆"的能力。
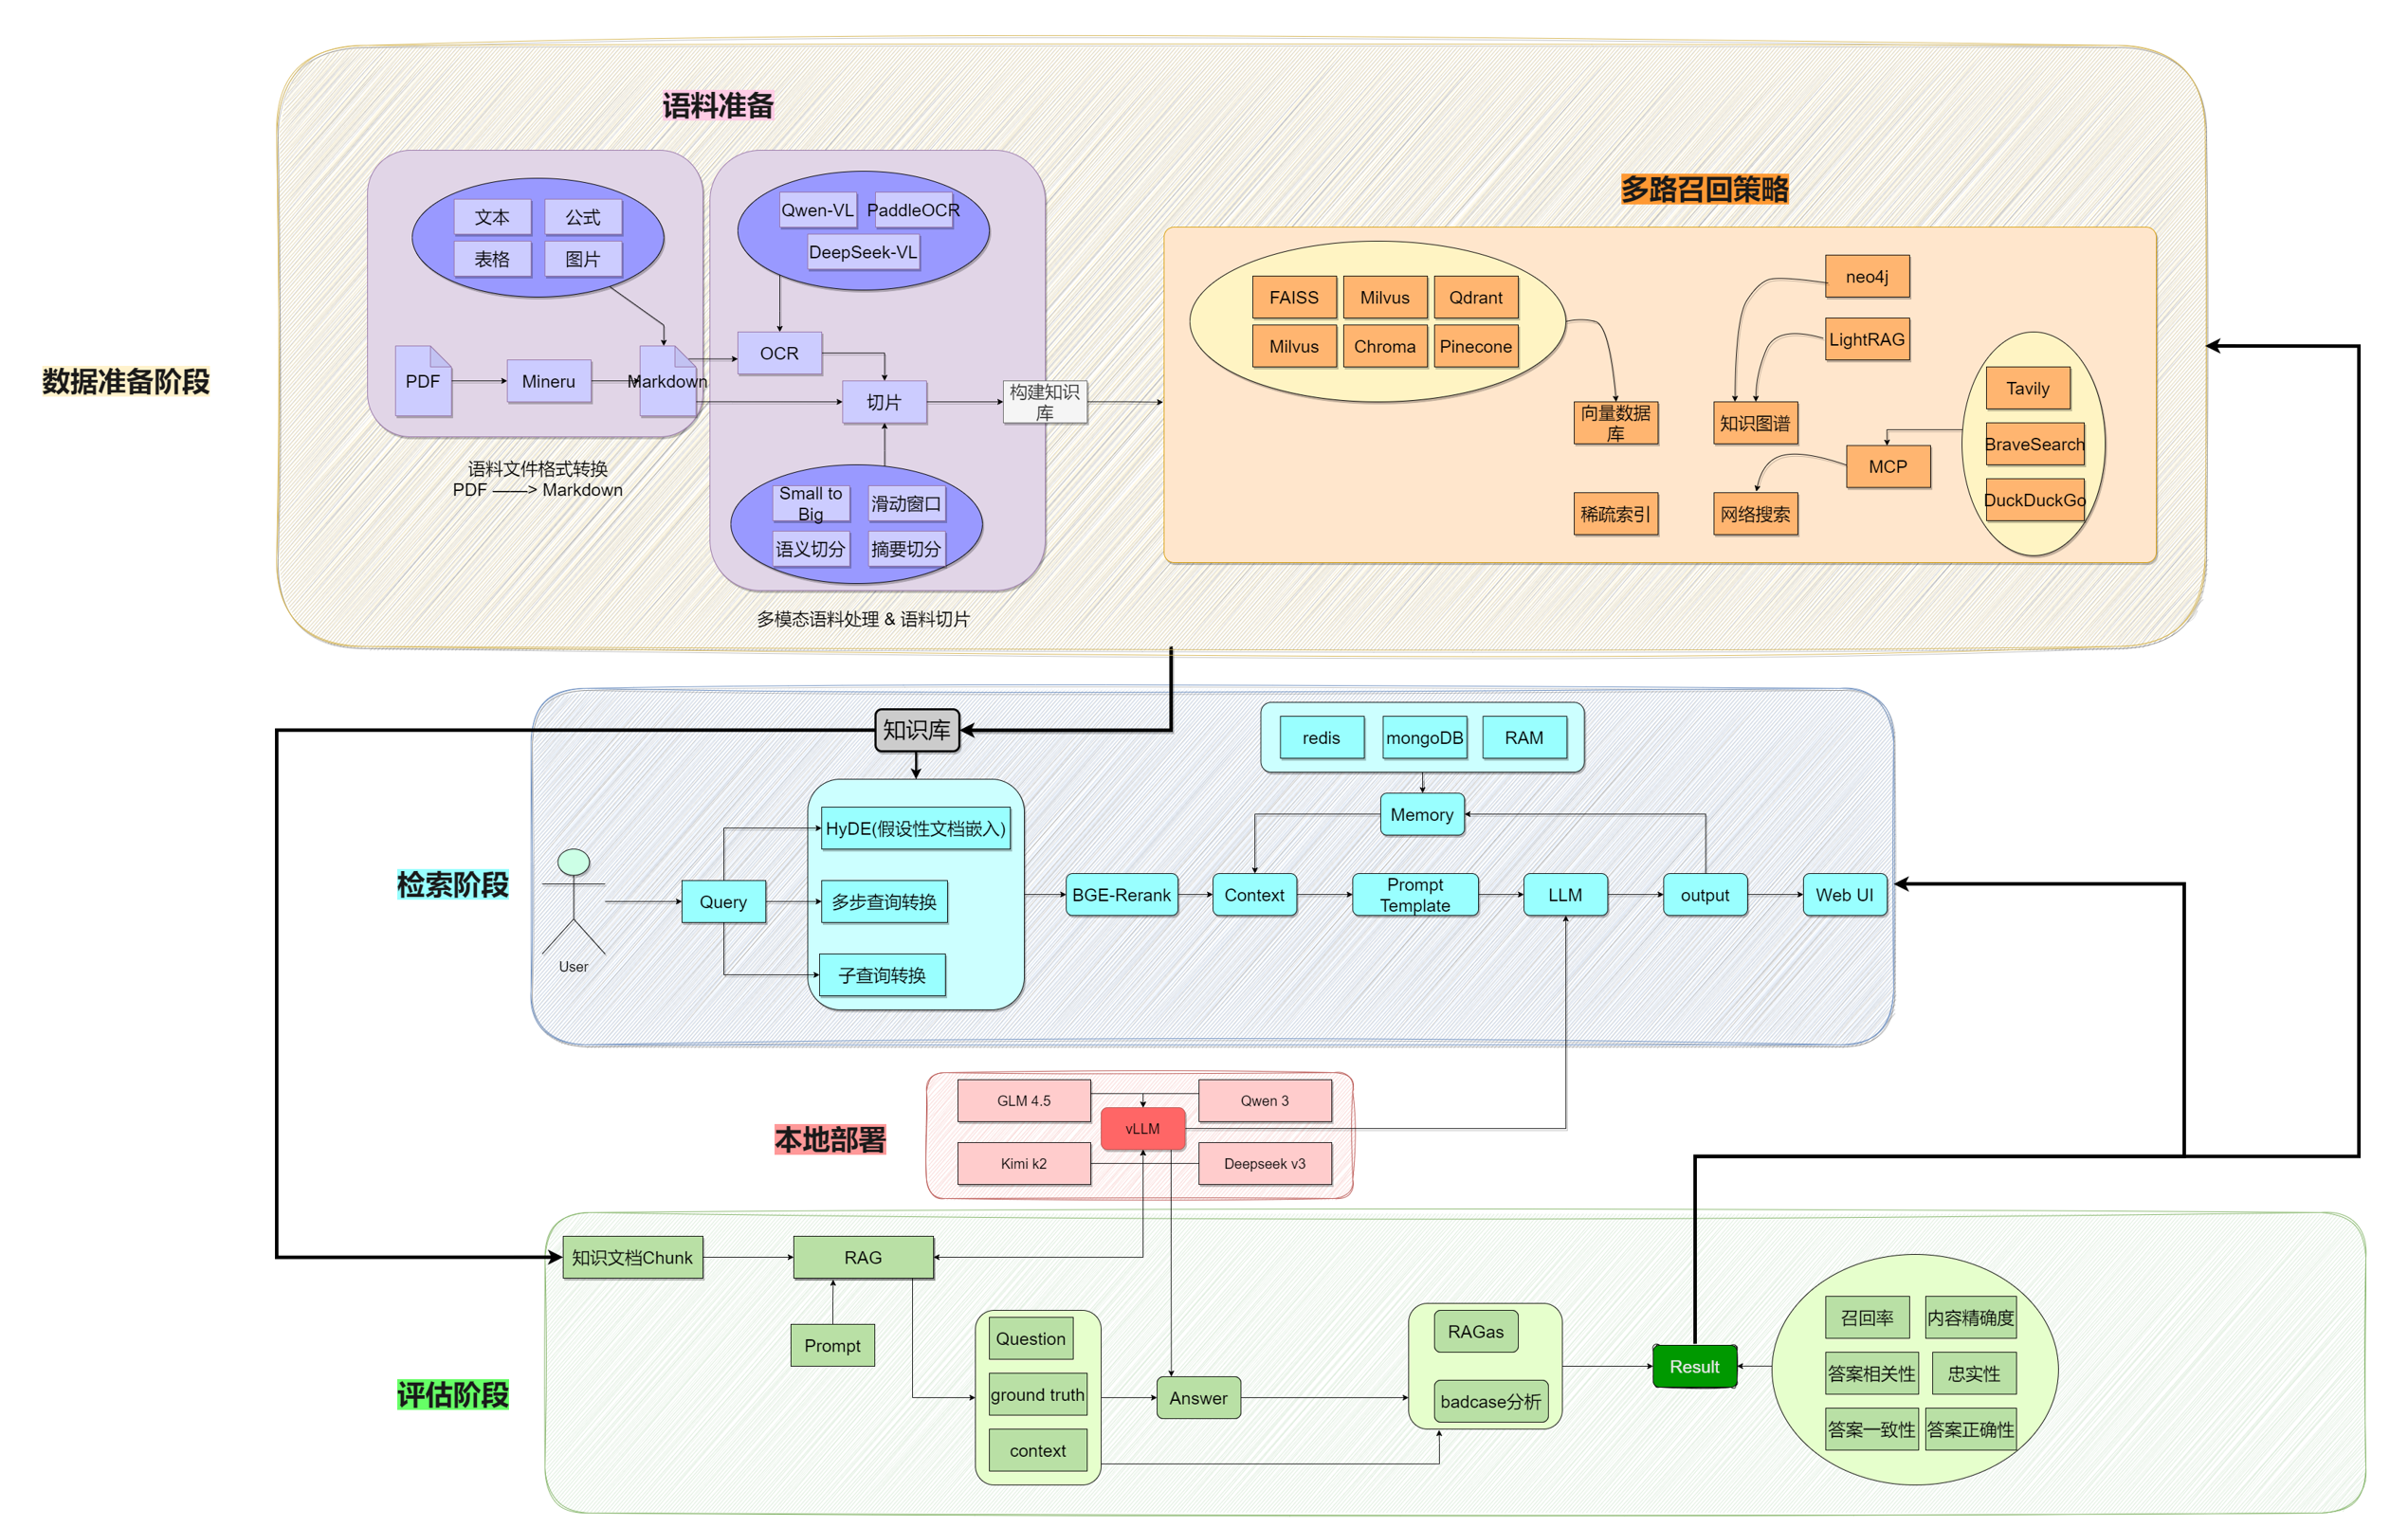
RAG的项目举例:
目前,已经出现了非常多的产品几乎完全建立在 RAG 之上,包括客服系统、基于大模型的数据分
析,以及成千上万的数据驱动聊天应用,应用场景五花八门。
1.3 RAG优缺点
RAG的优点
1)相比提示词工程,RAG有更丰富的上下文和数据样本,可以不需要用户提供过多的背景描述,就能
生成比较符合用户预期的答案。
2)相比于模型微调,RAG可以提升问答内容的时效性和可靠性
3)在一定程度上保护了业务数据的隐私性。
RAG的缺点
1)由于每次问答都涉及外部系统数据检索,因此RAG的响应时延相对较高。
2)引用的外部知识数据会消耗大量的模型Token 资源。
1.4 RAG工作流程
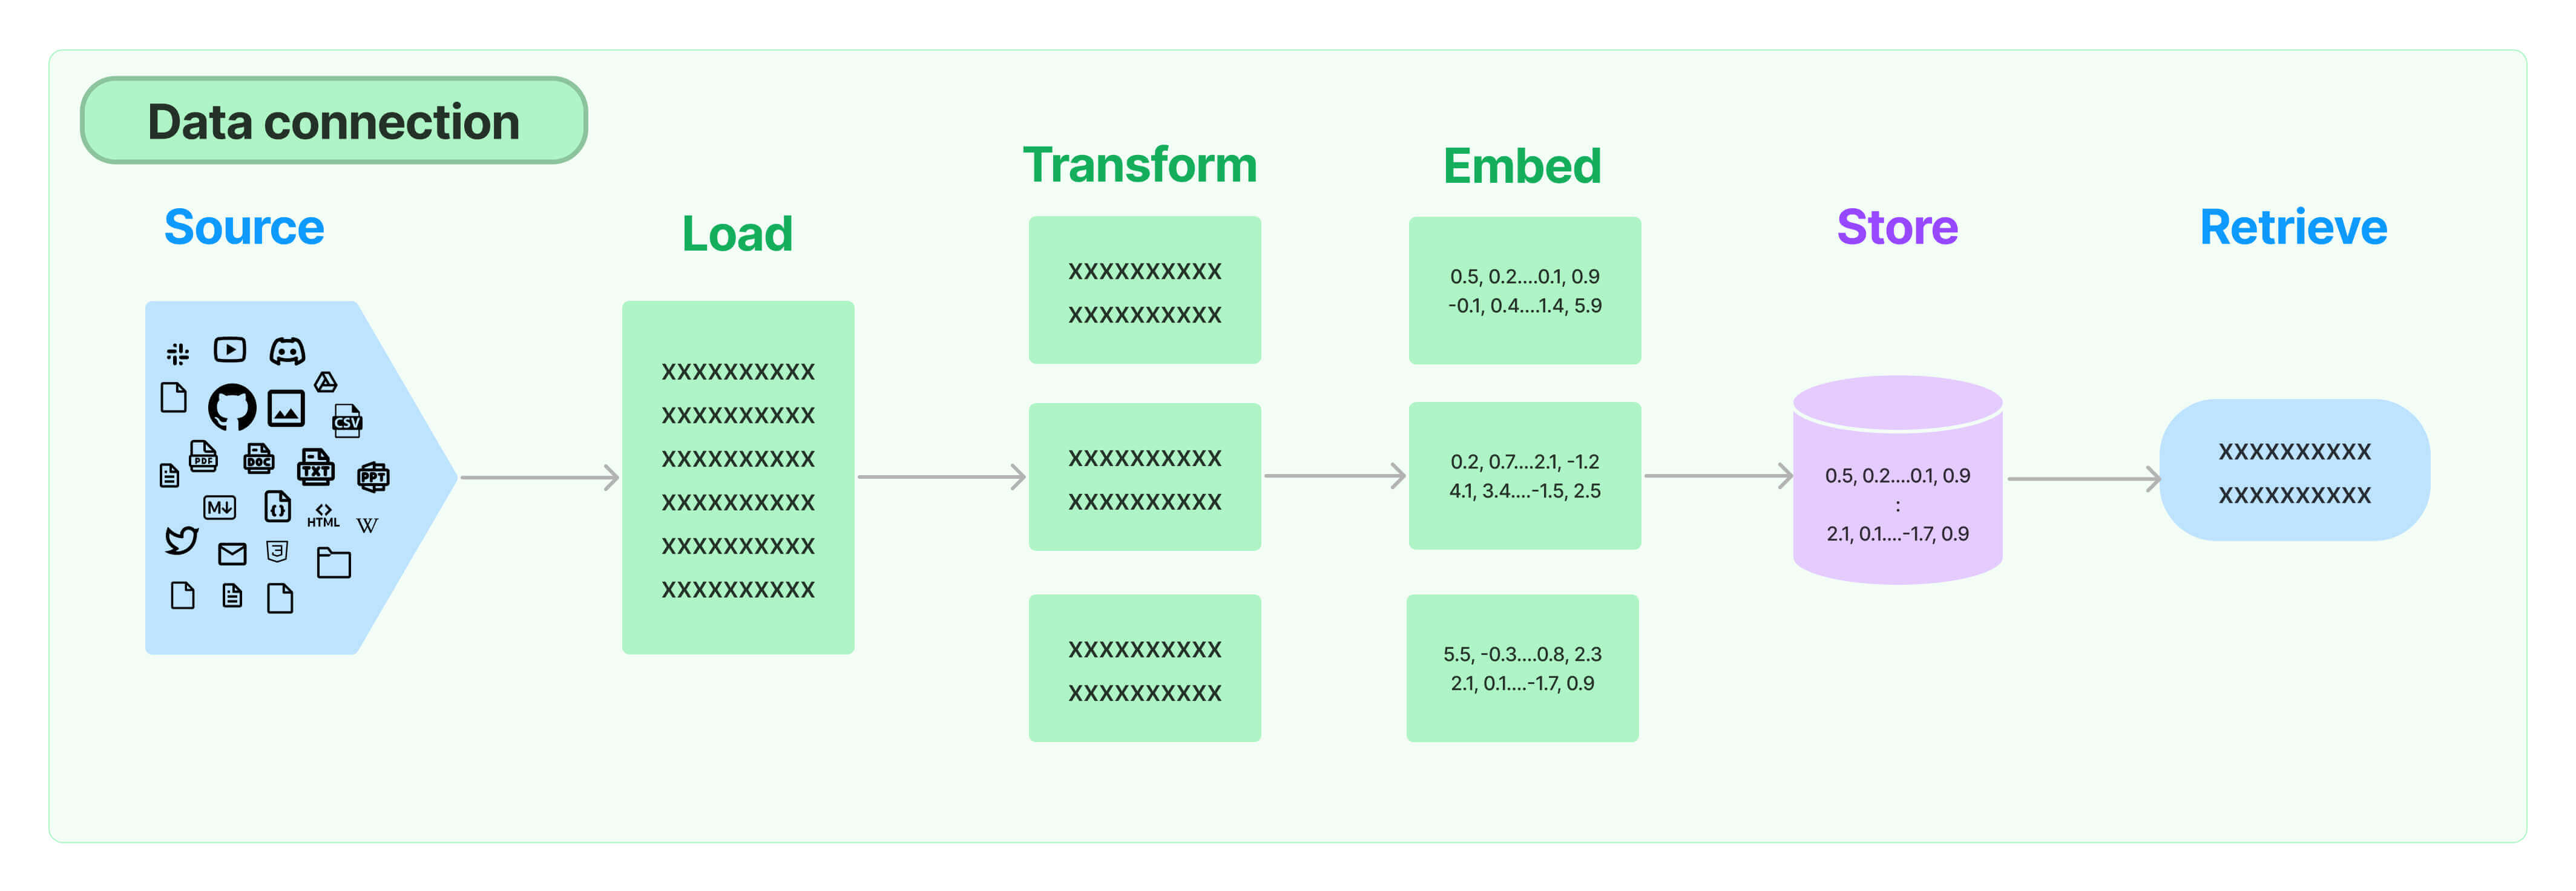
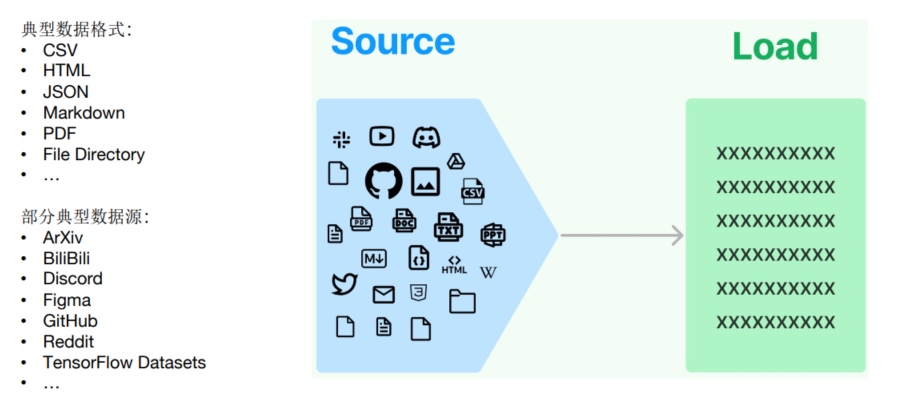
环节1:Source(数据源)
指的是RAG架构中所外挂的知识库。这里有三点说明:
1、原始数据源类型多样:如:视频、图片、文本、代码、文档等
2、形式的多样性:
-
可以是上百个.csv文件,可以是上千个.json文件,也可以是上万个.pdf文件
-
可以是某一个业务流程外放的API,可以是某个网站的实时数据等
环节2:Load(加载)
文档加载器(Document Loaders)负责将来自不同数据源的非结构化文本,加载到内存,成为文档
(Document)对象。
文档对象包含文档内容和相关元数据信息,例如TXT、CSV、HTML、JSON、Markdown、PDF,甚
至 YouTube 视频转录等。
文档加载器还支持" 延迟加载"模式,以缓解处理大文件时的内存压力。
LangChain封装好的loader地址:https://docs.langchain.com/oss/python/integrations/document_lo
文档加载器的编程接口使用起来非常简单,以下给出加载TXT格式文档的例子。
text
from langchain.document_loadersimport TextLoader

loader = TextLoader("./test.txt")
print(loader.load())
环节3:Transform(转换)
文档转换器(Document Transformers) 负责对加载的文档进行转换和处理,以便更好地适应下游任务
的需求。
文档转换器提供了一致的接口(工具)来操作文档,主要包括以下几类:
-
文本拆分器(Text Splitters) :将长文本拆分成语义上相关的小块,以适应语言模型的上下文窗口
限制。
-
冗余过滤器(Redundancy Filters) :识别并过滤重复的文档。
-
元数据提取器(Metadata Extractors) :从文档中提取标题、语调等结构化元数据。
-
多语言转换器(Multi-lingual Transformers) :实现文档的机器翻译。
-
对话转换器(Conversational Transformers) :将非结构化对话转换为问答格式的文档。
总的来说,文档转换器是 LangChain 处理管道中非常重要的一个组件,它丰富了框架对文档的表示和操
作能力。
在这些功能中,文档拆分器是必须的操作。下面单独说明。
环节3.1:Text Splitting(文档拆分)
-
拆分/分块的必要性:前一个环节加载后的文档对象可以直接传入文档拆分器进行拆分,而文档切
块后才能向量化并存入数据库中。
-
文档拆分器的多样性:LangChain提供了丰富的文档拆分器,不仅能够切分普通文本,还能切分
Markdown、JSON、HTML、代码等特殊格式的文本。
-
拆分/分块的挑战性:实际拆分操作中需要处理许多细节问题,不同类型的文本、不同的使用场
景都需要采用不同的分块策略。(具体策略见2.3.2)
在构建RAG应用程序的整个流程中,拆分/分块是最具挑战性的环节之一,它显著影响检索效果。目前还
没有通用的方法可以明确指出哪一种分块策略最为有效。不同的使用场景和数据类型都会影响分块策略
的选择。
环节4:Embed(嵌入)
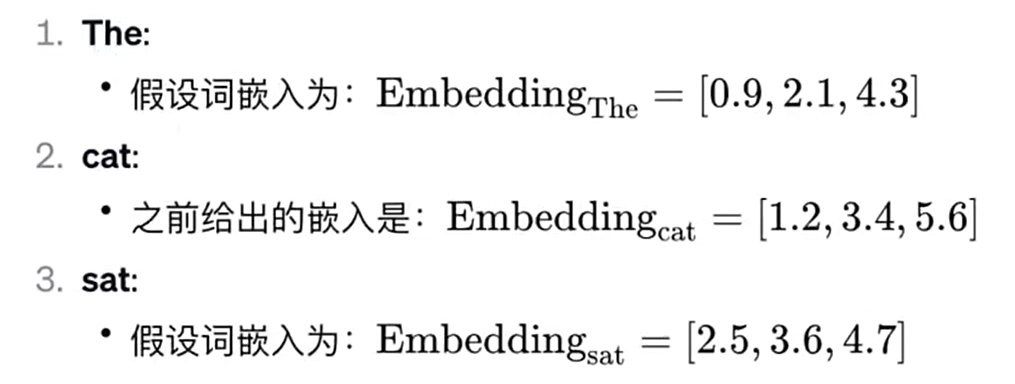
文档嵌入模型(Text Embedding Models)负责将文本转换为向量表示,即模型赋予了文本计算机
可理解的数值表示,使文本可用于向量空间中的各种运算,大大拓展了文本分析的可能性,是自然语言
处理领域非常重要的技术。
-
实现原理:通过特定算法(如Word2Vec)将语义信息编码为固定维度的向量,具体算法细节需
后续深入。
-
关键特性:相似的词在向量空间中距离相近,例如"猫"和"犬"的向量夹角小于"猫"和"汽车"。
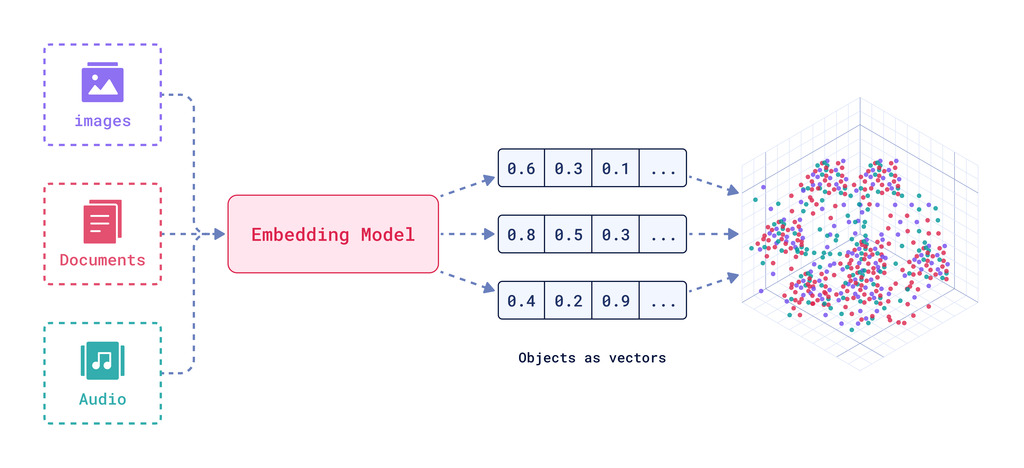
文本嵌入为 LangChain 中的问答、检索、推荐等功能提供了重要支持。具体为:
-
语义匹配:通过计算两个文本的向量余弦相似度,判断它们在语义上的相似程度,实现语义匹
配。
-
文本检索:通过计算不同文本之间的向量相似度,可以实现语义搜索,找到向量空间中最相似的
文本。
-
信息推荐:根据用户的历史记录或兴趣嵌入生成用户向量,计算不同信息的向量与用户向量的相
似度,推荐相似的信息。
-
知识挖掘:可以通过聚类、降维等手段分析文本向量的分布,发现文本之间的潜在关联,挖掘知
识。
-
自然语言处理:将词语、句子等表示为稠密向量,为神经网络等下游任务提供输入。
环节5:Store(存储)
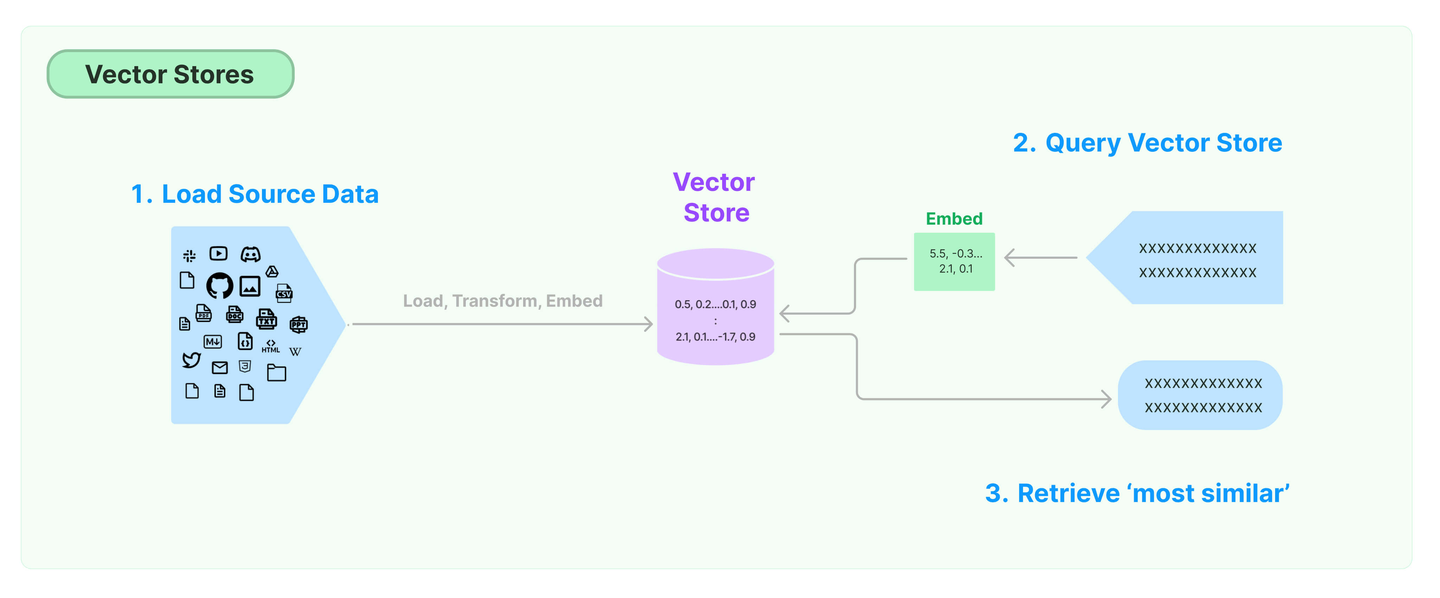
LangChain 还支持把文本嵌入存储到向量存储或临时缓存,以避免需要重新计算它们。这里就出现了数
据库,支持这些嵌入的高效存储和搜索的需求。
环节6:Retrieve(检索)
检索器(Retrievers)是一种用于响应非结构化查询的接口,它可以返回符合查询要求的文档。
LangChain 提供了一些常用的检索器,如向量检索器、文档检索器、网站研究检索器等。
通过配置不同的检索器,LangChain 可以灵活地平衡检索的精度、召回率与效率。检索结果将为后续的
问答生成提供信息支持,以产生更加准确和完整的回答。
二、详细使用流程
2.1 环境准备
2.1.1 安装依赖
我们在《第02章-模型调用》章节已经通过requirements.txt 文件安装过课程的依赖。当时考虑到本章
RAG模块涉及的依赖较多且大,所以不在之前的依赖文件中。所以,这里大家需要补充安装RAG涉及到
的依赖。完整版文件见《02-资料\requirements_full.txt》
text
pip install -r requirements_full.txt检查冲突
text
pip check如果环境安装正确,则日志如下
text
(langchain1.2) PS C:\Users\shkstart\OneDrive\文档\AI\langchain> pip check
No broken requirements found.
(langchain1.2) PS C:\Users\shkstart\OneDrive\文档\AI\langchain>
2.1.2 准备数据
将 knowledge.txt 置于项目根目录下
将 asset文件夹 解压后置于项目根目录下
2.2 文档加载器 Document Loaders
文档加载器(内置或自行实现)需实现 BaseLoader 接口。
Class Document 是 LangChain 内文档的统一载体,所有文档加载器最终返回此类的实例。核心记录:
page_content:文档内容
metadata:文档元数据(字典)
一个基础的Document类实例,基于如下代码创建:
text
from langchain_core.documents import Document

document = Document(
    page_content="Hello, world!",
    metadata={"source": "https://example.com"}
)两个统一方法:
-
load():一次性加载全部文档
-
lazy_load():延迟流式传输文档,对大型数据集很有用,避免内存溢出
官方文档加载器列表:Document loader integrations - Docs by LangChain
重点加载器:CSVLoader、JSONLoader、PDFLoader(PyPDFLoader)、TextLoader。
数据源可能包含多种格式的文件,如文本文档、Markdown,PDF 等。LangChain 实现和集成了众多文
档加载器(https://docs.langchain.com/oss/python/integrations/document_loaders ),方便从不同
格式的文件中加载数据。
常用 Loaders:
-
TextLoader - 文本文件
-
CSVLoader - CSV 文件
-
PyPDFLoader - PDF 文件
-
WebBaseLoader - 网页
LangChain的设计:对于Source 中多种不同的数据源,我们可以用一种统一的形式读取、调用。上述
每一个文档加载器,都要继承自 BaseLoader 基类,此类提供了通用的 load (一次加载所有文档)
与 lazy_load (以延迟方式加载文档) 方法,用于从数据源加载数据并处理为Document 对象。
2.2.1 加载txt
text
# 1.导入相关依赖
from langchain_community.document_loaders import TextLoader

# 2.定义TextLoader对象,file_path=".txt的位置"
text_loader = TextLoader(file_path="../asset/load/01-langchain-utf-8.txt", encoding="utf-8")

# 3.加载
docs = text_loader.load()  #返回List列表(Document对象)

# 4.打印
print(docs)
text
[Document(metadata={'source': '../asset/load/01-langchain-utf-8.txt'}, page_content='LangChain 是一个用于构建基于大语言模型(LLM)应用的开发框架,旨在帮助开发者更高效地集成、管理和增强大语言模型的能力,构建端到端的应用程序。它提供了一套模块化工具和接口,支持从简单的文本生成到复杂的多步骤推理任务')]Documment对象中有两个重要的属性:
-
page_content:真正的文档内容,字符串类型。
-
metadata:文档内容的原数据,字典类型。
text
print(type(docs[0])) #langchain_core.documents.base.Document
text
print(docs[0].page_content)
'''
LangChain 是一个用于开发由大型语言模型 (LLMs) 驱动的应用程序的框架。LangChain简化了LLM应用程序生命周期的每个阶段。\nLangChain 已经成为了我们每一个大模型开发工程师的标配。
'''
text
print(docs[0].metadata) # {'source': './data/langchain.txt'}2.2.2 加载CSV
举例:加载csv所有列
text
from langchain_community.document_loaders.csv_loader import CSVLoader

loader = CSVLoader(file_path="asset/load/04-load.csv")
data = loader.load()
print(data)

print(type(data))  # <class 'list'>
print(type(data[0]))  # <class 'langchain_core.documents.base.Document'>
print(len(data))  # 4
print(data[0].page_content)  # id: 1  title: Introduction to Python ...
text
[Document(metadata={'source': 'asset/load/04-load.csv', 'row': 0}, page_content='id: 1\ntitle: Introduction to Python\ncontent: Python is a popular programming language.\nauthor: John Doe'), Document(metadata={'source': 'asset/load/04-load.csv', 'row': 1}, page_content='id: 2\ntitle: Data Science Basics\ncontent: Data science involves statistics and machine learning.\nauthor: Jane Smith'), Document(metadata={'source': 'asset/load/04-load.csv', 'row': 2}, page_content='id: 3\ntitle: Web Development\ncontent: HTML, CSS and JavaScript are core web technologies.\nauthor: Mike Johnson'), Document(metadata={'source': 'asset/load/04-load.csv', 'row': 3}, page_content='id: 4\ntitle: Artificial Intelligence\ncontent: AI is transforming many industries.\nauthor: Sarah Williams')]
<class 'list'>
<class 'langchain_core.documents.base.Document'>
4
id: 1
title: Introduction to Python
content: Python is a popular programming language.
author: John Doe
2.2.3 加载JSON
LangChain提供的JSON格式的文档加载器是JSONLoader 。在实际应用场景中,JSON格式的数据占有
很大比例,而且JSON的形式也是多样的。我们需要特别关注。
JSONLoader 使用指定的 jq结构来解析 JSON 文件。jq是一个轻量级的命令行 JSON 处理器 ,可以对
JSON 格式的数据进行各种复杂的处理,包括数据过滤、映射、减少和转换,是处理 JSON 数据的首选
工具之一。
text
# 在requirements_full.txt中已经安装
pip install jq
常见 jq schema 参考:
text
JSON        -> ["...", "...", "..."]
jq_schema   -> ".[]"

JSON        -> [{"text": ...}, {"text": ...}, {"text": ...}]
jq_schema   -> ".[].text"

JSON        -> {"key": [{"text": ...}, {"text": ...}, {"text": ...}]}
jq_schema   -> ".key[].text"
详细用法可参考 https://jqlang.org/manual/#basic-filters。
举例1:使用JSONLoader文档加载器加载
text
# 1.导入依赖
from  langchain_community.document_loaders import JSONLoader
from rich import print as rprint

# 2.定义JSONLoader对象
# 情况1
json_loader=JSONLoader(
    file_path="../asset/load/03-load.json",
    jq_schema=".", ## 提取所有字段
    text_content=False #保持原始 JSON 结构,将提取的数据转换为JSON字符串存入page_content字段中
)

# 情况2
# .messages[].content:遍历.messages[]中所有元素 从每一个元素中提取.content字段
# json_loader=JSONLoader(
#     file_path="../asset/load/03-load.json",
#     jq_schema=".messages[].content"
# )

# 3.加载
docs = json_loader.load()
rprint(docs)
text
[
 Document(
     metadata={
         'source': 'D:\\code\\workspace_pycharm_test\\langchain1.2_beike\\asset\\load\\03-load.json',
         'seq_num': 1
     },
     page_content='{"messages": [{"sender": "Alice", "content": "Hello, how are you today?", "timestamp":
"2023-05-15T10:00:00"}, {"sender": "Bob", "content": "I\'m doing well, thanks for asking!", "timestamp":
"2023-05-15T10:02:00"}, {"sender": "Alice", "content": "Would you like to meet for lunch?", "timestamp":
"2023-05-15T10:05:00"}, {"sender": "Bob", "content": "Sure, that sounds great!", "timestamp":
"2023-05-15T10:07:00"}], "conversation_id": "conv_12345", "participants": ["Alice", "Bob"]}'
 )
]
举例2:提取03-response.json文件中指定的文本
text
# 1.导入相关依赖
from langchain_community.document_loaders import JSONLoader
from rich import print as rprint

# 2.定义json文件的路径
file_path = '../asset/load/03-response.json'

# 3.定义JSONLoader对象
# 需求1:提取data.items中的数据
# loader = JSONLoader(
#     file_path=file_path,  # 文件路径
#     jq_schema=".data.items[]",
#     text_content=False,  # 提取内容是否为字符串格式
# )


# 需求2:提取data.items[].content中的数据
# loader = JSONLoader(
#     file_path=file_path,  # 文件路径
#     jq_schema=".data.items[].content",
# )


# 需求3:提取data.items中指定字段的数据
loader = JSONLoader(
    file_path=file_path,  # 文件路径
    jq_schema="""
        .data.items[] | {
            author,
            created_at,
            content: (.title + "\n" + .content)
        }
    """,
    text_content=False,  # 提取内容是否为字符串格式
)


# 4.加载
data = loader.load()
rprint(data)
text
[
 Document(
     metadata={
         'source': 'D:\\code\\workspace_pycharm_test\\langchain1.2_beike\\asset\\load\\03-response.json',
         'seq_num': 1
     },
     page_content='{"author": {"id": "user_1", "name": "Alice"}, "created_at": "2023-10-05T08:12:33Z",
"content": "Understanding JSONLoader\\nThis article explains how to parse API responses..."}'
 ),
 Document(
     metadata={
         'source': 'D:\\code\\workspace_pycharm_test\\langchain1.2_beike\\asset\\load\\03-response.json',
         'seq_num': 2
     },
     page_content='{"author": {"id": "user_2", "name": "Bob"}, "created_at": "2023-10-05T09:15:21Z", "content":
"Advanced jq Schema Patterns\\nLearn to handle nested structures with..."}'
 ),
 Document(
     metadata={
         'source': 'D:\\code\\workspace_pycharm_test\\langchain1.2_beike\\asset\\load\\03-response.json',
         'seq_num': 3
     },
     page_content='{"author": {"id": "user_3", "name": "Charlie"}, "created_at": "2023-10-05T10:03:47Z",
"content": "LangChain Metadata Handling\\nBest practices for preserving metadata..."}'
 )
]
2.2.4 加载pdf
PDF 存在多种来源格式,包括扫描版(图片 PDF)、电子文本版、混合版。并且布局格式也多种多样,
包括单列布局、双列布局甚至竖排文本布局。并且包含段落、标题、页眉页脚、表格、数学公式、化学
式、特殊符号、图片等各种元素。
因此,PDF 解析存在很多挑战。对于复杂 PDF,需要进行文本提取、布局检测、表格解析、公式识别等
处理。
2.2.4.1 方式1:PyPDFLoader
LangChain加载PDF文件使用的是pypdf,先安装
text
# 在requirements_full.txt中已经安装
pip install pypdf
text
from langchain_community.document_loaders import PyPDFLoader

loader = PyPDFLoader(
    # 文件路径,支持本地文件和在线文件链接
    # file_path="../asset/load/04-sample.pdf",
    file_path="https://arxiv.org/pdf/alg-geom/9202012",
    # 提取模式:控制如何从 PDF 文件中解析和提取文本结构。
    #   plain 提取文本,默认值
    #   layout 布局感知提取模式,通常会通过插入大量的空格、换行符,来模拟原文档中的多栏、缩进和间距(适用场景:学术论文(如 arXiv 论文)、多栏报刊杂志、带有左右分栏的合同)
    extraction_mode="plain",
)

docs = loader.load()

print(docs)
print(len(docs))
输出:略
2.2.4.2 方式2:MinerU (实际开发推荐使用)
MinerU 提供了 PDF、Word、PPT、图片等文件的解析,支持图像提取、OCR、公式、表格解析等功
能。
调用在线服务:https://mineru.net/apiManage/docs。可以从本地批量上传文件进行解析,并接收解
析结果。
text
import os
import time
import requests
from dotenv import load_dotenv

load_dotenv(override=True)


def upload_files(file_paths: list[str]) -> str:
    """批量上传文件"""
    url = "https://mineru.net/api/v4/file-urls/batch"
    api_token = os.getenv("MINERU_API_TOKEN")
    header = {
        "Content-Type": "application/json",
        "Authorization": f"Bearer {api_token}",
    }

    files_info = [
        {
            "name": os.path.basename(file_path),
            "is_ocr": True,
            "data_id": f"file_{i}",
        }
        for i, file_path in enumerate(file_paths)
    ]

    data = {
        "enable_formula": True,
        "enable_table": True,
        "language": "ch",
        "files": files_info,
    }

    try:
        response = requests.post(url, headers=header, json=data)
        if response.status_code == 200:
            result = response.json()
            print("response success. result:{}".format(result))

            if result["code"] == 0:
                batch_id = result["data"]["batch_id"]
                urls = result["data"]["file_urls"]
                print("batch_id:{}\nurls:{}".format(batch_id, urls))

                for i in range(0, len(urls)):
                    with open(file_paths[i], "rb") as f:
                        res_upload = requests.put(urls[i], data=f)
                        if res_upload.status_code == 200:
                            print(f"{urls[i]} upload success")
                        else:
                            print(f"{urls[i]} upload failed")
                            return None

                return batch_id
            else:
                print("apply upload url failed, reason:{}".format(result.get("msg")))
                return None
        else:
            print(
                "response not success. status:{} ,result:{}".format(
                    response.status_code, response.text
                )
            )
            return None

    except Exception as err:
        print(err)
        return None


def download_files(batch_id):
    """批量获取任务结果"""
    if not batch_id:
        print("batch_id为空,跳过下载")
        return

    os.makedirs("parsed_files", exist_ok=True)

    url = f"https://mineru.net/api/v4/extract-results/batch/{batch_id}"
    api_token = os.getenv("MINERU_API_TOKEN")
    header = {
        "Content-Type": "application/json",
        "Authorization": f"Bearer {api_token}",
    }

    failed_files = set()
    done_files = set()

    while True:
        res = requests.get(url, headers=header)
        result_json = res.json()

        if res.status_code != 200 or result_json.get("code") != 0:
            print("get result failed:", result_json)
            break

        extract_results = result_json["data"]["extract_result"]

        for result in extract_results:
            data_id = result["data_id"]

            if result["state"] == "failed":
                failed_files.add(data_id)

            elif result["state"] == "done" and data_id not in done_files:
                done_files.add(data_id)

                full_zip_url = result["full_zip_url"]
                res_download = requests.get(full_zip_url, stream=True)

                with open(
                    f"parsed_files/{result['file_name']}_{result['data_id']}.zip", "wb"
                ) as f:
                    for chunk in res_download.iter_content(chunk_size=1024):
                        if chunk:
                            f.write(chunk)

        if len(failed_files) + len(done_files) == len(extract_results):
            break

        time.sleep(5)

    for i in failed_files:
        print("failed:", i)

    for i in done_files:
        print("done:", i)


file_paths = ["../asset/load/04-sample.pdf"]
batch_id = upload_files(file_paths)

if batch_id:
    download_files(batch_id)
说明:需要在.env文件中提供:
text
#MinerU的API_TOKEN
MINERU_API_TOKEN=<你的API TOKEN>
2.2.5 加载word
可使用 UnstructuredWordDocumentLoader加载 Word 文件,需要 unstructured 包。(已在
requirements_full.txt文件中安装)
举例:
text
from langchain_community.document_loaders import UnstructuredWordDocumentLoader

loader = UnstructuredWordDocumentLoader(
    # 文件路径
    file_path="../asset/load/05-sgg_chat.docx",
    # 加载模式:
    #   single 返回单个Document对象
    #   elements 按标题等元素切分文档
    mode="single",
)

docs = loader.load()

print(len(docs))
print(docs)
输出:略
2.2.6 加载Markdown
可使用 UnstructuredMarkdownLoader 加载 Markdown 文件,需要 unstructured 包。(已在
requirements_full.txt文件中安装)
举例1:使用UnstructuredMarkdownLoader加载md文件
text
# 1.导入相关的依赖
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from pprint import pprint

# 2.定义UnstructuredMarkdownLoader对象
loader = UnstructuredMarkdownLoader(
    file_path="../asset/load/06-load.md",
    # 加载模式:
    #   single 返回单个Document对象
    #   elements 按标题等元素切分文档
    mode= "single",
    # 解析策略:
    #   "fast"(快速模式),它会以最快的速度提取文本,不进行复杂的版面分析
    #   "hi_res" 高分辨率模式
    strategy="fast"
)

# 3.加载
docs = loader.load()

# 4.打印
print(len(docs))
pprint(doc)
text
1
Document(metadata={'source': '../asset/load/06-load.md'}, page_content='自然语言处理技术文档\n\n本文档用于测试UnstructuredMarkdownLoader的中文处理能力。\n\n第一章:简介\n\n自然语言处理(NLP)是人工智能的重要分支,主要技术包括:\n\n文本分类\n\n命名实体识别\n\n机器翻译\n\n情感分析\n\n问答系统\n\n第二章:关键技术\n\n2.1 预训练模型\n\nBERT:双向Transformer编码器\n\nGPT:自回归语言模型\n\nT5:文本到文本转换框架\n\n2.2 代码示例\n\n```python from transformers import pipeline\n\n创建文本分类管道\n\nclassifier = pipeline("text-classification", model="bert-base-chinese")\n\nresult = classifier("这家餐厅的服务很棒!") print(result)')
举例2:精细分割文档,保留结构信息
将Markdown文档按语义元素(标题、段落、列表、表格等)拆分成多个独立的小文档(Element 对
象),而不是返回单个大文档。通过指定mode="elements" 轻松保持这种分离。
text
# 1.导入相关的依赖
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from pprint import pprint

# 2.定义UnstructuredMarkdownLoader对象
md_loader = UnstructuredMarkdownLoader(
    file_path="../asset/load/06-load.md",
    # 加载模式:
    #   single 返回单个Document对象
    #   elements 按标题等元素切分文档
    mode= "elements",
    strategy="fast"
)

# 3.加载
docs = md_loader.load()

print(len(docs))
# 4.打印
for doc in docs:
    # pprint(doc)
    pprint(doc.page_content)
text
19
'自然语言处理技术文档'
'本文档用于测试UnstructuredMarkdownLoader的中文处理能力。'
'第一章:简介'
'自然语言处理(NLP)是人工智能的重要分支,主要技术包括:'
'文本分类'
'命名实体识别'
'机器翻译'
'情感分析'
'问答系统'
'第二章:关键技术'
'2.1 预训练模型'
'BERT:双向Transformer编码器'
'GPT:自回归语言模型'
'T5:文本到文本转换框架'
'2.2 代码示例'
'```python from transformers import pipeline'
'创建文本分类管道'
'classifier = pipeline("text-classification", model="bert-base-chinese")'
'result = classifier("这家餐厅的服务很棒!") print(result)'
2.2.7 加载HTML(了解)
举例:
text
# 1.导入相关的依赖
from langchain_community.document_loaders import UnstructuredHTMLLoader

# 2.定义UnstructuredHTMLLoader对象
# strategy:
#   "fast" 解析加载html文件速度是比较快(但可能丢失部分结构或元数据)
#   "hi_res": (高分辨率解析) 解析精准(速度慢一些)
#   "ocr_only"  强制使用ocr提取文本,仅仅适用于图像(对HTML无效)

# mode :one of `{'paged', 'elements', 'single'}
#    "elements"  按语义元素(标题、段落、列表、表格等)拆分成多个独立的小文档

loader = UnstructuredHTMLLoader(
    file_path="../asset/load/07-load.html",
    mode="elements",
    strategy="fast"
)

# 3.加载
docs = loader.load()

print(len(docs))  # 16

# 4.打印
for doc in docs:
    pprint(doc)
输出:略
2.2.8 加载File Directory(了解)
除了上述的单个文件加载,我们也可以批量加载一个文件夹内的所有文件。
举例:
text
# 1.导入相关的依赖
from langchain_community.document_loaders import DirectoryLoader
from langchain_community.document_loaders import PythonLoader
from pprint import pprint

# 2.定义DirectoryLoader对象,指定要加载的文件夹路径、要加载的文件类型和是否使用多线程
directory_loader = DirectoryLoader(
    path="../asset/load",
    glob="*.py", # 文件匹配模式(过滤器)。使用标准的 Unix 路径通配符。
    use_multithreading=True, # 是否启用多线程。填 True 意味着 LangChain 会同时并发读取多个文件。
    show_progress=True, # 是否显示进度条。填 True 时,控制台在加载文件时会弹出一个进度条
    loader_cls=PythonLoader # 指定底层核心加载器
)

# 3.加载
docs = directory_loader.load()

# 4.打印
print(len(docs))
for doc in docs:
    pprint(doc)
text
100%|██████████| 4/4 [00:00<00:00, 498.83it/s]
4
Document(metadata={'source': 'asset\\load\\07-fun.py'}, page_content='"""\n一 函数入门\n"""\n# 1.不使用函数\n# 打印欢迎信息1\nprint("********************************")\nprint("*                              *")\nprint("*     欢迎来到Python世界       *")\nprint("*                              *")\nprint("********************************")\n\n# 打印欢迎信息2\nprint("********************************")\nprint("*                              *")\nprint("*     欢迎来到Python世界       *")\nprint("*                              *")\nprint("********************************")\n\n# 打印欢迎信息3\nprint("********************************")\nprint("*                              *")\nprint("*     欢迎来到Python世界       *")\nprint("*                              *")\nprint("********************************")\n\n# 2.使用函数\ndef print_welcome():\n    """打印欢迎信息"""\n    print("********************************")\n    print("*                              *")\n    print("*     欢迎来到Python世界       *")\n    print("*                              *")\n    print("********************************")\n\n# 多次调用函数打印欢迎信息\nprint_welcome()\nprint_welcome()\nprint_welcome()')
Document(metadata={'source': 'asset\\load\\07-fun_param.py'}, page_content='"""\n二 函数参数\n"""\n\n\n# 1. 无参数版本 - 只能计算固定的购物车\ndef calculate_total_no_params():\n    """计算固定购物车总价"""\n    prices = [100, 50, 30]  # 商品价格固定写死在函数内\n    total = 0\n    for price in prices:\n        total += price\n    return total\n\n# 只能计算一个固定的购物车\nprint(f"购物车总价:{calculate_total_no_params()}")\n\n# 2.有参数版本 - 可以计算任意购物车\ndef calculate_total(prices):\n    """计算任意购物车总价"""\n    total = 0\n    for price in prices:\n        total += price\n    return total\n\n# 可以计算任意购物车\ncart1 = [100, 50, 30]\ncart2 = [200, 80, 45, 60]\ncart3 = [75, 90, 120]\n\nprint("第一个购物车总价:{calculate_total(cart1)}:")\nprint("第二个购物车总价:{calculate_total(cart2)}")\nprint(f"第三个购物车总价:{calculate_total(cart3)}")\n\n\n# 3.参数传递\n# 3.1 不可变类型 函数传递不可变对象\n\ndef changeInt(a) :\n    print("函数体中未改变前a的内存地址",id(a))\n    a = 10   #底层会创建一个新对象 然后给新对象一个新值\n    print("函数体中改变后a的内存地址",id(a))\n\na = 2 # 创建一个对象 然后给这个对象一个值\nchangeInt(a)\nprint(a)\nprint("函数外b的内存地址",id(a))\n\n\n\n# 输出结果\n# 函数体中未改变前a的内存地址 140729722661336\n# 函数体中改变后a的内存地址 140729722661592\n# 2\n# 函数外b的内存地址 140729722661336\n\n\n# 3.2 可变类型 函数传递不可变对象\n\ndef changeList(myList) :\n    myList[1] = 50\n    print("函数内的值",myList) # [1,50,3]\n    print("函数内列表的内存",id(myList)) # 0111111\n\nmlist = [1,2,3]  # 底层创建一个对象 地址0111111\nchangeList(mlist)\nprint("函数外的值",mlist) # # [1,50,3]\nprint("函数外列表的内存",id(mlist))\n\n# 输出结果\n# 函数内的值 [1, 50, 3]\n# 函数内列表的内存 1380193079680\n# 函数外的值 [1, 50, 3]\n# 函数外列表的内存 1380193079680\n\n')
Document(metadata={'source': 'asset\\load\\07-fun_retun.py'}, page_content='"""\n四 函数的返回值\n"""\n# 1.返回表达式\n# 2.不带表达式的 return 语句,返回 None。\n# 3.函数中如果没有 return 语句,在函数运行结束后也会返回 None。\n# 4.用变量接收返回结果\n# 5.return 语句可以返回多个值,多个值会放在一个元组中。\n\ndef f(a, b, c):\n    return a, b, c, [a, b, c]\nprint(f(1, 2, 3))  # (1, 2, 3, [1, 2, 3])\n')
Document(metadata={'source': 'asset\\load\\07-param_form.py'}, page_content='"""\n三 函数参数形式\n"""\n# 1.位置参数\n# 2.关键字参数\n# 3.默认参数\n# 4.不定长参数\n# 4.1 带一个*\ndef printInfo(num,*vartuple):\n    print(num)\n    print(vartuple)\n\nprintInfo(70,60,50)\n\nprint("-" * 20)\n# 如果不定长的参数后面还有参数,必须通过关键字参数传参\ndef printInfo1(num1,*vartuple,num) :\n    print(num)\n    print(num1)\n    print(vartuple)\n\nprintInfo1(10,20,num = 40)\n\nprint("-" * 20)\n# 如果没有给不定长的参数传参,那么得到的是空元组\nprintInfo1(70,num = 60)\n# 4.2 带二个*\ndef printInfo(num,**vardict):\n    print(num)\n    print(vardict)\n    # return\n\nprintInfo(10,key1 = 20,key2 = 30)')
2.2.9 了解:BaseLoader、Document类
一方面:LangChain在设计时,要保证Source中多种不同的数据源,在接下来的流程中可以用一种统一
的形式读取、调用。
另一方面:为什么PDFloader 和TextLoader 等Document Loader 都使用load() 去加载,且都使
用.page_content 和.metadata 读取数据。
【解答】每一个在LangChain中集成的文档加载器,都要继承自BaseLoader(文档加载器) ,
BaseLoader提供了一个名为"load"的公开方法,用于从配置的不同数据源加载数据,全部作为
Document 对象。实现逻辑如下所示:
BaseLoader类分析
BaseLoader类定义了如何从不同的数据源加载文档,每个基于不同数据源实现的loader,都需要继承
BaseLoader 。Baseloader要求不多,对于任何具体实现的loader,最少都要实现 load方法。
text
class BaseLoader(ABC):
    """文档加载器接口。

    实现应当使用生成器实现延迟加载方法,以避免一次性将所有文档加载进内存。

    `load` 方法仅供用户方便使用,不应被重写。
    """

    # 子类不应直接实现此方法。而应实现延迟加载方法。
    def load(self) -> List[Document]:
        """将数据加载为 Document 对象。"""
        return list(self.lazy_load())

    async def aload(self) -> list[Document]:
        """将数据加载为 Document 对象。load的异步版本"""
        return [document async for document in self.alazy_load()]

    def load_and_split(
        self, text_splitter: Optional[TextSplitter] = None
    ) -> List[Document]:
        """加载文档并将其分割成块。块以 Document 形式返回。
        不要重写此方法。它应被视为已弃用!
        参数:
            text_splitter: 用于分割文档的 TextSplitter 实例。默认为 RecursiveCharacterTextSplitter。
        返回:
            文档列表。
        """
                .....
                .....
            _text_splitter: TextSplitter = RecursiveCharacterTextSplitter()
        else:
            _text_splitter = text_splitter
        docs = self.load()
        return _text_splitter.split_documents(docs)
BaseLoader 把数据加载成Documents object ,存到 Documents 类中的page_content 中。
Document类分析
Document 允许用户与文档的内容进行交互,可以查看文档内容。
其继承体系如下
text
Serializable
   ↑
BaseMedia
   ├── id
   ├── metadata
   ↑
Document
   ├── page_content
   ├── type = "Document"
Document源码:
text
class Document(BaseMedia):
    """用于存储一段文本及其关联元数据的类。

    !!! note

        `Document` 用于 **检索工作流**,而不是聊天输入输出。
        如果要在对话中向 LLM 发送文本,请使用 `langchain.messages`
        中的消息类型。

    Example:
        ```python
        from langchain_core.documents import Document

        document = Document(
            page_content="Hello, world!", metadata={"source": "https://example.com"}
        )
        """

    page_content: str
    """字符串文本。"""

    type: Literal["Document"] = "Document"

    def __init__(self, page_content: str, **kwargs: Any) -> None:
        """将 page_content 作为位置参数或命名参数传入。"""
        # mypy 会报怨说 page_content 没有在基类中定义。
        # 这里我们依赖 pydantic 基类来处理字段校验。
        super().__init__(page_content=page_content, **kwargs)  # type: ignore[call-arg,unused-ignore]

    @classmethod
    def is_lc_serializable(cls) -> bool:
        """返回 `True`,表示该类是可序列化的。"""
        return True

    @classmethod
    def get_lc_namespace(cls) -> list[str]:
        """获取 LangChain 对象的命名空间。

        Returns:
            `["langchain", "schema", "document"]`
        """
        return ["langchain", "schema", "document"]

    def __str__(self) -> str:
        """重写 `__str__`,使其只展示 page_content 和 metadata。

        Returns:
            `Document` 的字符串表示形式。
        """
        # 该格式与 pydantic 的 __str__ 格式保持一致。
        #
        # 这样做的目的是:确保用户代码中那些直接把 Document 对象
        # 放入 prompt 的写法,不会因为新增 id 字段
        # 或未来新增其他字段而发生变化。
        #
        # 这个重写方法未来很可能会被移除,
        # 转而采用一种更通用的方案:
        # 在 prompt 内部直接格式化内容。
        if self.metadata:
            return f"page_content='{self.page_content}' metadata={self.metadata}"
        return f"page_content='{self.page_content}'"
BaseMedia源码:
text
class BaseMedia(Serializable):
    """用于检索和数据处理工作流中内容对象的基类。

    为那些需要被存储、索引或搜索的内容提供公共字段。

    !!! note

        对于 **聊天消息** 中的多模态内容
        例如发送给 LLM 或由 LLM 返回的图片、音频等,
        请使用 `langchain.messages` 中的内容块 content blocks。
    """

    # id 字段目前是可选的。
    # 在未来的某个主版本中,当足够多的 VectorStore 实现
    # 都采用它之后,它很可能会变成必填字段。
    id: str | None = Field(default=None, coerce_numbers_to_str=True)
    """文档的可选标识符。

    理想情况下,它应该在整个文档集合中保持唯一,
    并且格式最好是 UUID,但这一点不会被强制要求。
    """

    metadata: dict = Field(default_factory=dict)
    """与内容关联的任意元数据。"""