深入浅出LangGraph【一】_基础篇
文章目录
- 深入浅出LangGraph【一】_基础篇
-
- Agent概述
-
- [1. Agent基本原理回顾](#1. Agent基本原理回顾)
- [2. Agent开发的模型支持和工具支持](#2. Agent开发的模型支持和工具支持)
- [3. Agent开发框架选型](#3. Agent开发框架选型)
- [4. 学习Agent开发框架的8大要点](#4. 学习Agent开发框架的8大要点)
- LangGraph底层原理介绍
- LangGraph底层源码解析
-
- [1. Graph基类](#1. Graph基类)
- [2. GraphState](#2. GraphState)
- [3. Nodes](#3. Nodes)
- [4. Edges](#4. Edges)
- [5. Graph 的调用方法](#5. Graph 的调用方法)
- 使用LangGraph构建大模型的问答流程
Agent概述
1. Agent基本原理回顾
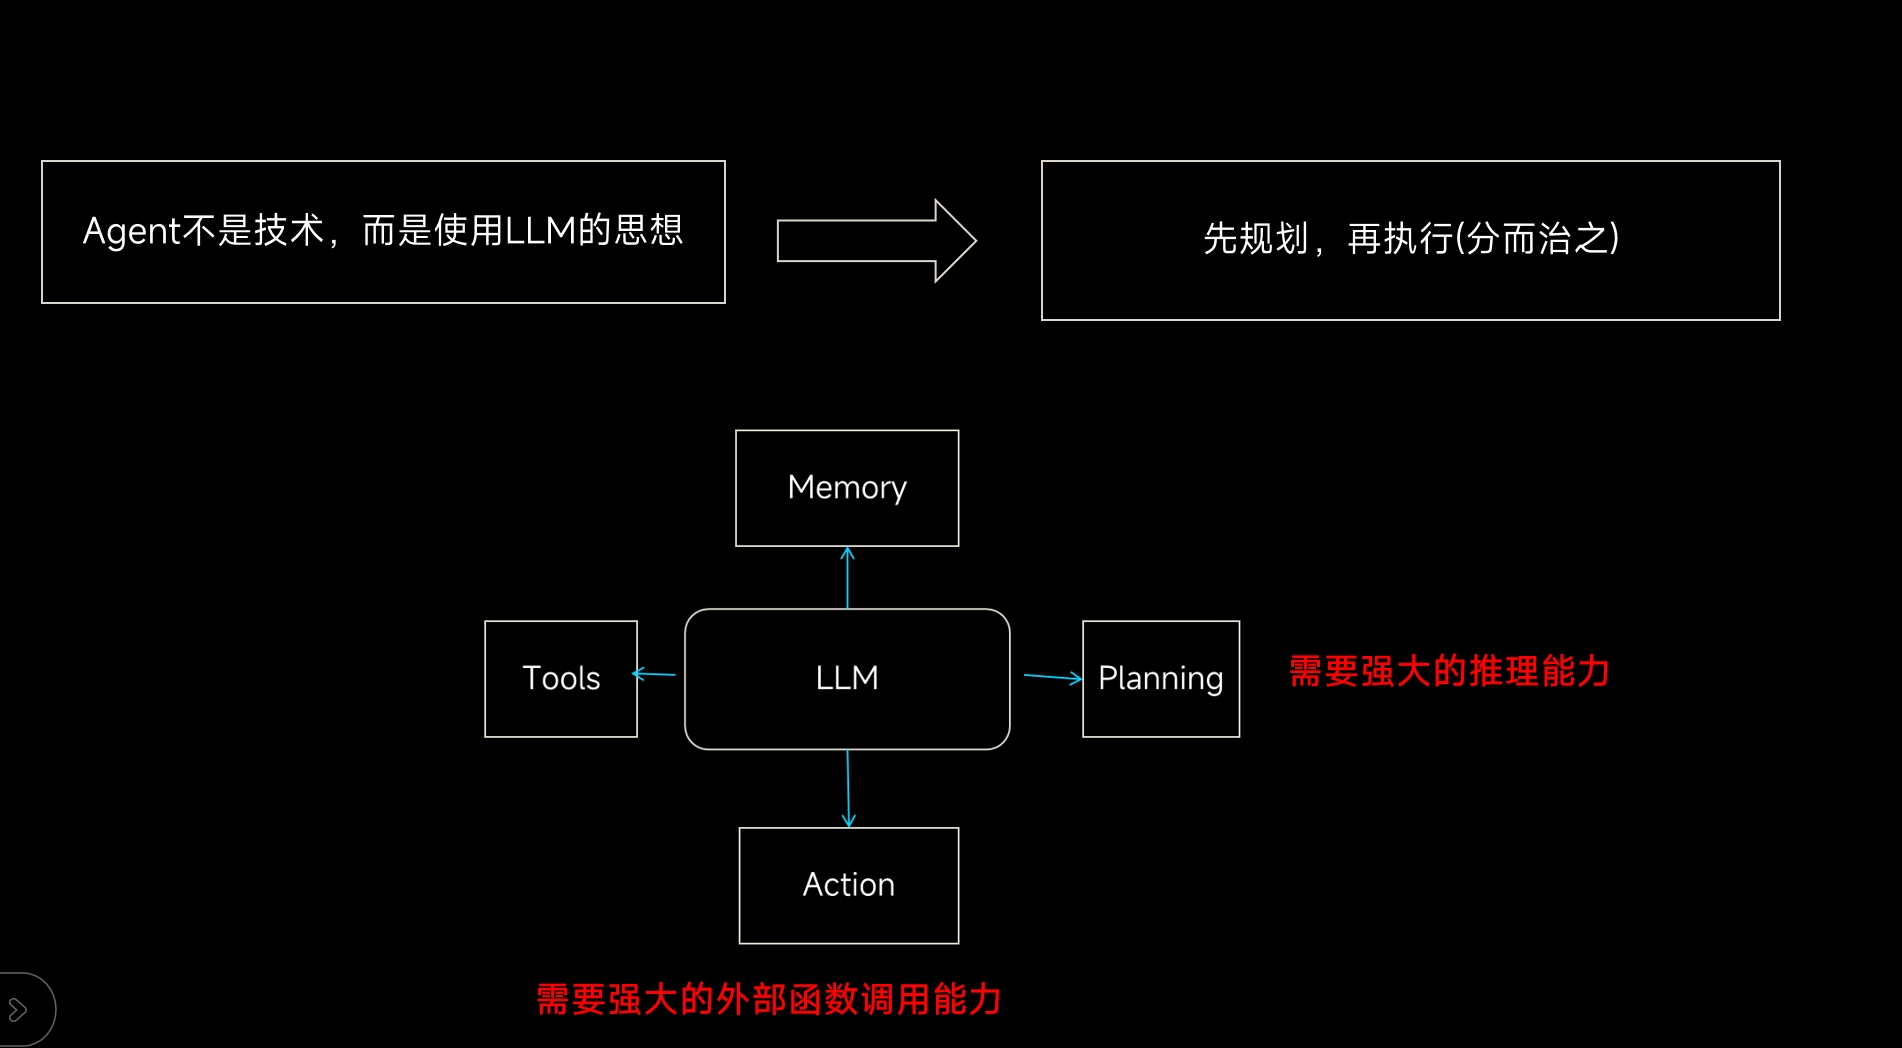
2. Agent开发的模型支持和工具支持
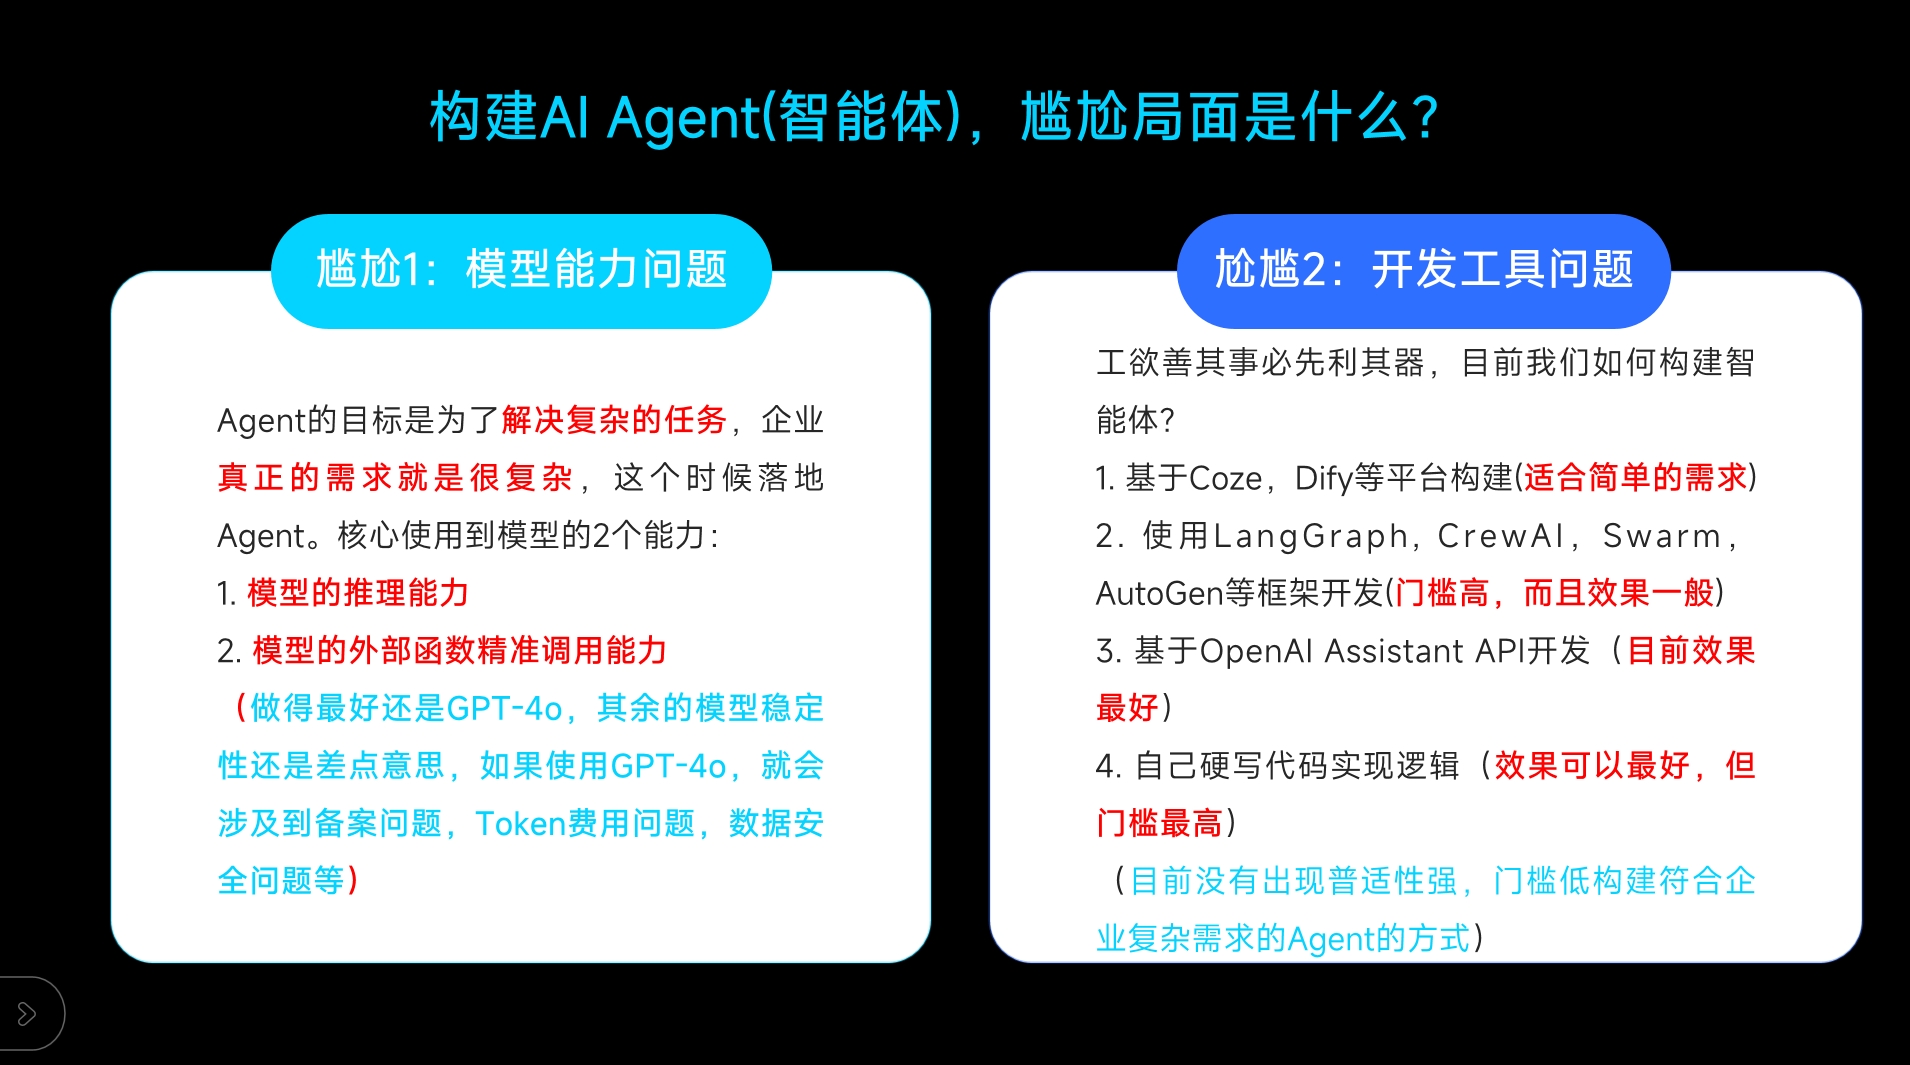
3. Agent开发框架选型
| 框架名称 | 核心优点 | 核心缺点 |
|---|---|---|
| LangGraph | 1. 生产级成熟度最高,原生支持状态持久化、断点恢复与人工介入 2. 复杂分支 / 循环 / 并行逻辑完全可控,灵活性拉满 3. 与 LangSmith 深度集成,可观测性、调试能力行业顶尖 4. 社区生态最完善,插件与工具库丰富 | 1. 学习曲线陡峭,需掌握状态图心智模型 2. 代码相对冗长,简单场景下冗余度高 3. 多语言支持不完善,Python 生态远优于 JS / 其他语言 |
| CrewAI | 1. 角色化抽象极简易用,声明式 API 上手门槛极低,5 分钟可跑通流程 2. 内置顺序、层级两种主流协作模式,适配多数业务场景 3. 兼容绝大多数主流 LLM,无强厂商绑定 4. 社区活跃,迭代速度快,开源 MIT 协议无商业限制 | 1. 状态管理能力弱,无内置断点恢复,流程中断需全量重试 2. 复杂流程灵活性不足,细粒度控制能力弱于 LangGraph3. 仅支持 Python,多语言团队适配成本高 4. 企业级功能仍在迭代,成熟度有待提升 |
| AutoGen | 1. 多智能体协作范式成熟,原生支持对话式、角色化、群体协作等多种模式,适配复杂交互场景 2. 跨模型兼容性强,支持所有主流 LLM,无强制厂商绑定,可灵活切换模型 3. 开源生态活跃,社区贡献的工具、扩展案例丰富,落地门槛低 4. 轻量化设计,部署简单,支持 Python/.NET 双语言,适配多技术栈 | 1. 状态管理与持久化能力弱,无内置断点恢复,长流程容错性差 2. 企业级生产能力不足,缺少原生可观测性、权限管控、高可用组件 3. 微软官方迭代优先级降低,核心功能更新放缓,逐步被新框架替代 4. 复杂流程编排能力弱,无原生分支 / 循环 / 并行管控,需手动实现逻辑 |
| OpenAI Agents SDK | 1. OpenAI 官方原生适配,与 GPT 系列模型、OpenAI 工具链无缝集成 2. 内置完整的可观测性追踪、日志与调试能力,生产运维友好 3. 原生支持沙箱执行环境,代码 / 文件操作安全可控 4. 轻量灵活,多智能体交接逻辑简洁,低代码成本 | 1. 强依赖 OpenAI 生态,多模型提供商支持能力弱 2. 无可视化低代码编排,全流程需代码开发 3. 生产级高可用、权限管控等能力需自行补充 4. 新功能优先 Python 发布,多语言支持滞后 |
| Spring AI Alibaba | 1. 无缝集成 Spring 生态,Java 企业级开发体验原生适配,贴合国内政企技术栈 2. 内置 Graph 多智能体编排,支持 Supervisor、并行、顺序等多种协作模式 3. 与阿里云百炼、通义千问深度适配,中文场景优化效果好,国内合规性完善 4. 内置全链路可观测性、MCP 服务发现,企业级运维能力完善 | 1. 仅支持 Java/Spring 技术栈,Python 等主流 AI 开发生态完全空白 2. 高级编排、运维能力强依赖阿里云服务,私有化部署功能严重阉割 3. 2026 年才正式 GA,迭代周期短,跨行业通用生产案例积累不足 4. 强绑定阿里生态,非阿里云 / 通义模型适配性差,全球通用性极低 |
LangGraph虽然学习曲线高,但是也是对底层的Agent开发框架,学好这个框架,有利于大家学习其余的任何Agent开发框架,就像《倚天屠龙记》里面张无忌练了九阳神功以后,他在学习其它武功都很快!
4. 学习Agent开发框架的8大要点
- 如何实现外部调用?
- 如何实现多轮对话?
- 如何实现流式输出?
- 如何实现短期记忆和长期记忆?
- 如何实现人机交互?
- 如何实现规划逻辑?
- 如何实现多 Agent?
- Debug 和监控如何做?
LangGraph底层原理介绍
LangGraph 是一个功能强大且通用性广泛的 AI Agent 开发框架。在大语言模型的支持方面 ,LangGraph 不仅兼容 GPT 系列模型,还支持包括 glm、llama 和 Qwen 在内的多种热门在线和开源模型,几乎涵盖了当前主流的大模型选项,为开发者提供了丰富的选择。关于大模型的接入方式 ,开发者可以采用传统的集成方式,例如通过 openai API 将大模型接入到 LangGraph 的 AI Agent 开发流程中,也可以借助 ollma 和 vllm 等大模型推理加速库,以实现更高效、便捷的集成。除此之外,在 AI Agent 的构建范式方面,LangGraph 不仅内置了支持 ReAct 框架的预配置代理机制,还允许灵活扩展更多自定义策略,例如 Planning 策略,以满足不同场景的需求。
综合这三方面来看,LangGraph 的高度自主性和开放性 确实使其在功能和灵活性上相比 其它Agent开发框架 更具优势。然而,这种自主性和可扩展性也带来了更高的复杂性和开发成本。选择使用 LangGraph 意味着 开发者需要承担更多的自主开发任务。
那么LangGraph到底是什么呢?
从名称来看,LangGraph 与 LangChain 有着密切的关联,而这在实际上也确实如此。LangGraph 是一个基于 LangChain 表达式语言构建的框架,专用于开发 AI Agent。 因此,LangGraph 在大模型支持、接入以及 AI Agent 构建方面的优势,可以直接从 LangChain 的功能中自然继承。
LangChain发展至现在,仍然是构建大语言模型应用程序的前沿框架之一。特别是在最新发布的v0.3版本中,已经基本完成了由传统类到表达式语言(LCEL)的重要过渡,给开发者带来的直接利好就是定义和执行分步操作序列(也称为链)会更加简单 。用更专业的术语来说,使用LangChain 构建的是 DAG(有向无环图) 。而之所以会出现LangGraph框架,根本原因是在于随着AI应用(特别是AI Agent)的发展,对于大语言模型的使用不仅仅是作为执行工具,而更多作为推理引擎的需求在日益增长 。这种转变带来的是更多的重复(循环)和复杂条件的交互需求,这就导致**基于LCEL的线性序列构建方式在构建更复杂、更智能的系统时显示出了明显的局限性。**如下所示的代码就是在LangChain中通过LECL表达式语言构建Chain的一种最简单的方式:
python
 ! pip install langchain==0.3.3
 ! pip install langchain-openai
LangChain ChatOpenAI:https://python.langchain.com/docs/integrations/chat/openai/
python
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate

# 加载 .env 文件,必须放在 os.getenv 前面!
load_dotenv()

## 这是你的key
key=os.getenv("DEEPSEEK_API_KEY")
base_url="https://api.deepseek.com"
python
llm = ChatOpenAI(model="deepseek-v4-pro", api_key=key, base_url=base_url)

prompt = ChatPromptTemplate.from_messages(
    [
        ("system","You are a helpful assistant that translates {input_language} to {output_language}."),
        ("human", "{input}"),
    ]
)

chain = prompt | llm

chain.invoke(
    {
        "input_language": "English",
        "output_language": "Chinese",
        "input": "I love programming.",
    }
)反观LangGraph,顾名思义,LangGraph 在图这个概念上有很大的侧重,它的出现就是要解决线性序列的局限性问题,而解决的方法就是循环图。在LangGraph框架中,用图来管理代理的生命周期并在其状态内将暂存器作为消息进行跟踪,增加了以循环方式跨各种计算步骤协调多个链或参与者的功能。这就与 LangChain 将代理视为可以附加工具和插入某些提示的对象不同,对于图来说,意味着我们可以从任何可运行的功能或代理或链作为一个程序的起点。
LangGraph通过组合Nodes和Edges去创建复杂的循环工作流程,通过消息传递的方式串联所有的节点形成一个通路。那么维持消息能够及时的更新并向该去的地方传递,则依赖langGraph构建的State概念。 在LangGraph构建的流程中,每次执行都会启动一个状态,图中的节点在处理时会传递和修改该状态。这个状态不仅仅是一组静态数据,而是由每个节点的输出动态更新,然后影响循环内的后续操作。如下所示:👇
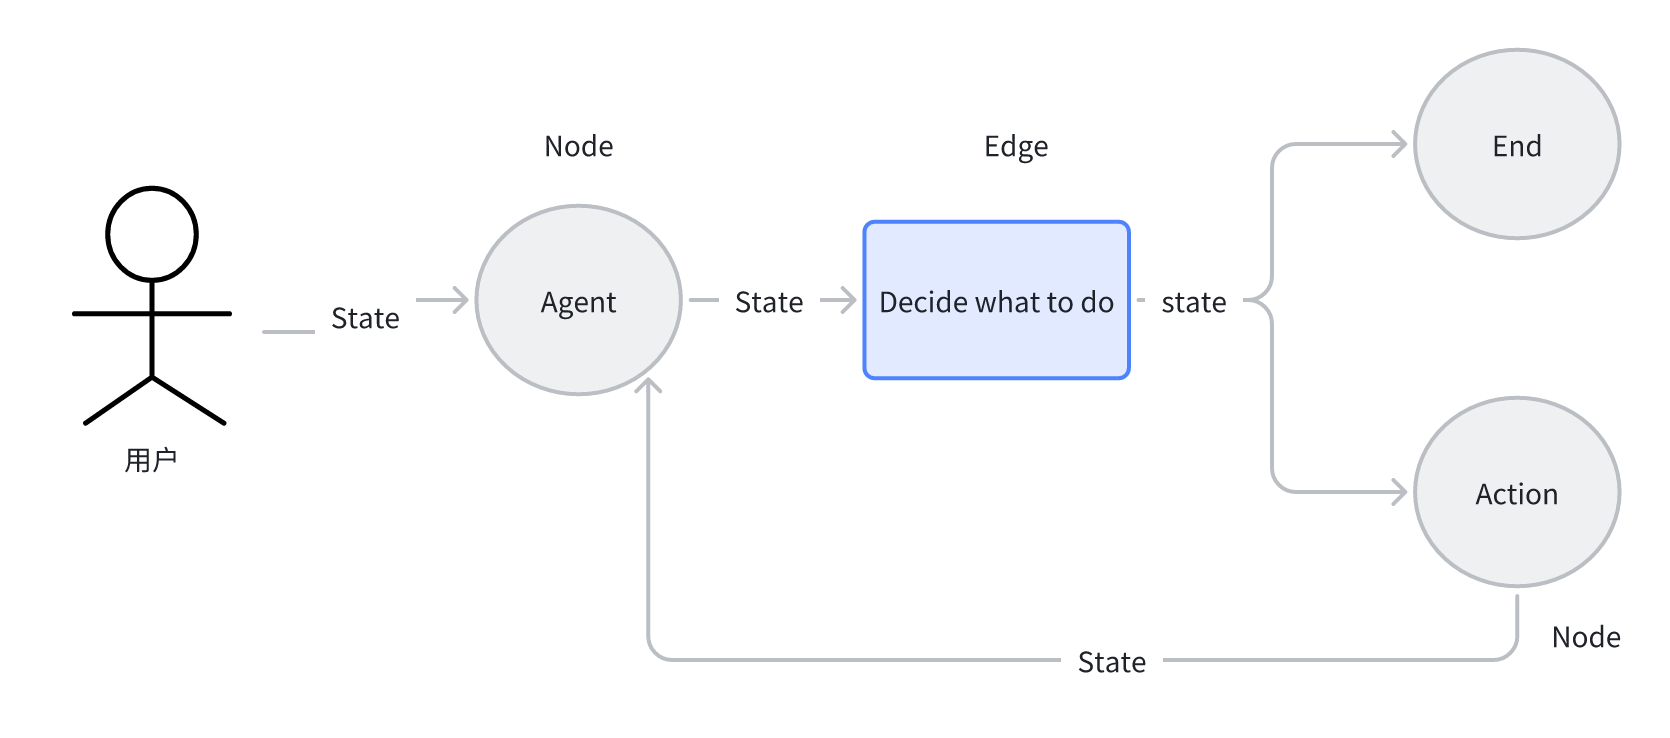
**此谓共享状态。共享状态是指在执行期间在图内的节点之间传递的数据或信息 。 LangGraph允许节点在图上执行时时通过共享和更新此公共状态来进行交互。**这种共享状态使节点能够根据它们共同维护的数据进行通信、交换信息并影响彼此的行为。通过利用共享状态, LangGraph才能够促进节点间操作的协调和同步,允许动态交互和创建复杂的工作流程,其中节点可以协作并根据可用的共享信息做出决策。
从LangGraph官方的定义看,该框架是一个用于使用大模型构建有状态、多参与者应用程序的库,可以创建代理和多代理工作流程 。而其官方自己总结的LangGraph的优势则是:
- 循环和分支:在应用程序中实现循环和条件。
- 持久性:在图中的每个步骤之后自动保存状态。随时暂停和恢复图形执行,以支持错误恢复、人机交互工作流程等。
- 人机交互:中断图形执行以批准或编辑代理计划的下一个操作。
- 流支持:流输出由每个节点生成(包括令牌流)。
- 与 LangChain 集成:LangGraph 与LangChain和LangSmith无缝集成(但不需要它们)。
LangGraph Github:https://github.com/langchain-ai/langgraph
LangGraph Docs:https://langchain-ai.github.io/langgraph/
至此,当我们了解了上述的原理后,再来看
LangGraph官方的介绍,就能够比较清楚的理解其独特优势究竟体现在何处。
LangGraph底层源码解析
在上一小节的原理介绍部分,我们在图中提到了节点、边、状态和路由四个概念,那在LangGraph框架中,各个组件是怎么实现,以及如何定义图结构呢? 我们将在这一小节展开详细的介绍和代码实践。首先我们来看图。
1. Graph基类
对于任意一个简单或者复杂的图来说,都是基于Graph类来构建和管理图结构的。在Graph类中允许添加节点、边,并定义节点间的动态流转逻辑。如下是Graph类的主要组成部分和功能:
Class Graph :https://langchain-ai.github.io/langgraph/reference/graphs/#langgraph.graph.graph.Graph
python
from collections import defaultdict
from typing import Any, Callable, Dict, Optional, Set, Tuple, Union, Awaitable, Hashable

class Graph:
    def __init__(self) -> None:
        self.nodes: Dict[str, Any] = {}  # 一个字典,用于存储图中的所有节点。每个节点可以是一个字符串标识或者是一个可调用对象
        self.edges: Set[Tuple[str, str]] = set()  # 一个集合,用来存储图中所有的边,边由一对节点名称组成,表示从一个节点到另一个节点的直接连接。
        self.branches: defaultdict = defaultdict(dict)  # 一个默认字典,用于存储条件分支,允许从一个节点根据特定条件转移到多个不同的节点。
        self.support_multiple_edges = False  # 一个布尔值,指示图是否支持同一对节点间的多条边。
        self.compiled = False    #  一个布尔值,表示图是否已经被编译。编译是指图的结构已经设置完毕,准备进行执行。

    @property
    def _all_edges(self) -> Set[Tuple[str, str]]:
        """
        获取所有的边的信息。
        """
        return self.edges

    def add_node(self, node: Union[str, Callable], action: Optional[Callable] = None, *, metadata: Optional[Dict[str, Any]] = None) -> 'Graph':
        """
        添加一个新节点到图中。节点可以有附加的元数据,这些元数据存储在节点的字典中。
        """
        pass

    def add_edge(self, start_key: str, end_key: str) -> 'Graph':
        """
        在图中添加一条边,连接两个指定的节点。
        """
        pass

    def add_conditional_edges(self, source: str, path: Callable, path_map: Optional[Dict[Hashable, str]] = None, then: Optional[str] = None) -> 'Graph':
        """
        添加一个条件边,允许在执行时根据某个条件从一个节点动态地转移到一个或多个节点。
        """
        pass

    def set_entry_point(self, key: str) -> 'Graph':
        """
        设置图的入口点,即定义图执行的起始节点。
        """
        pass

    def set_conditional_entry_point(self, path: Callable, path_map: Optional[Dict[Hashable, str]] = None, then: Optional[str] = None) -> 'Graph':
        """
        设置一个条件入口点,允许根据条件动态决定图的起始执行点。
        """
        pass

    def set_finish_point(self, key: str) -> 'Graph':
        """
        设置结束点,定义图执行到此节点时将停止。
        """
        pass

    def validate(self, interrupt: Optional[Set[str]] = None) -> 'Graph':
        """
        验证图的结构是否正确,确保所有节点和边的定义都符合逻辑和图的规则。
        """
        pass

    def compile(self, checkpointer=None, interrupt_before: Optional[Set[str]] = None, interrupt_after: Optional[Set[str]] = None, debug: bool = False) -> 'Graph':
        """
        编译图,确认图的结构合法且可执行后,准备图以供执行。
        """
pass从源码中可以看出,Graph该类提供了丰富的方法来控制图的编译和执行,使其适用于需要复杂逻辑和流程控制的应用场景。
2. GraphState
定义图时要做的第一件事是定义图的State。状态表示会随着图计算的进行而维护和更新的上下文或记忆。它用来确保图中的每个步骤都可以访问先前步骤的相关信息,从而可以根据整个过程中积累的数据进行动态决策。这个过程通过状态图StateGraph类实现,它继承自 Graph 类,这意味着 StateGraph 会使用或扩展基类的属性和方法。
Class StateGraph:https://langchain-ai.github.io/langgraph/reference/graphs/#langgraph.graph.state.StateGraph
python
from collections import defaultdict
from typing import Any, Callable, Dict, Optional, Set, Tuple, Type, Union

class StateGraph(Graph):

    """StateGraph 是一个管理状态并通过定义的输入和输出架构支持状态转换的图。"""
    def __init__(self, state_schema: Optional[Type[Any]] = None, config_schema: Optional[Type[Any]] = None) -> None:
        super().__init__()
        self.state_schema = state_schema      # 一个可选的类型参数,定义图状态的结构。这是用于定义和验证图中节点处理的状态数据的模式。
        self.config_schema = config_schema    # 一个可选的类型参数,用于定义配置的结构。这可以用于定义和验证图的配置参数。
        input: Optional[Type[Any]] = None,   # 消息输入
        output: Optional[Type[Any]] = None, # 消息输出

    def add_node(self, node: Union[str, Callable], action: Optional[Callable] = None, *, metadata: Optional[Dict[str, Any]] = None) -> 'StateGraph':
        """向图中添加一个新节点。节点可以是一个具名字符串或一个可调用对象(如函数), 如果node是字符串,则action应为与节点关联的可调用动作。"""
        pass

    def add_edge(self, start_key: str, end_key: str) -> 'StateGraph':
        """在图中添加一条边,连接两个节点。"""
        pass

    def compile(self) -> 'CompiledStateGraph':
        """编译图,将其转换成可运行的形式。包括验证图的完整性、预处理数据等。"""
        pass
什么是图的模式
- 默认情况下,
StateGraph使用单模式运行,这意味着在图中的任意阶段都会读取和写入相同的状态通道,所有节点都使用该状态通道进行通信。除此之外,在某些情况下如果希望对图的状态有更多的控制,比如:- 内部节点可以传递图的输入/输出中不需要的信息。
- 对图使用不同的输入/输出模式。例如,输出可能仅包含单个相关输出键。
LangGraph的底层实现上提供了多种不同图模式的支持,这可以通过state_schema来进行灵活的指定。不过关于自定义的图模式,因为涉及到更多的基础概念,我们将在课程的后半部分在展开详细的介绍。
首先来看图的单模式。任何模式都包含输入和输出,输入模式需要确保提供的输入与预期结构匹配,而输出模式根据定义的输出模式过滤内部数据以仅返回相关信息。而这个预期结构的校验,由TypedDict工具来限定。
TypeDict
TypedDict 是 Python 类型注解系统中的一个工具,它允许为字典中的键指定期望的具体类型 。在 Python 的 typing 模块中定义,通常用于增强代码的可读性和安全性,特别是在字典对象结构固定且明确时。示例代码如下:
python
from typing import TypedDict

class Contact(TypedDict):
    name: str
    email: str
    phone: str

def send_email(contact: Contact) -> None:
    print(f"Sending email to {contact['name']} at {contact['email']}")

# 使用定义好的 TypedDict 创建字典
contact_info: Contact = {
    'name': 'Lilei',
    'email': 'Lilei@qq.com',
    'phone': '15814023435'
}

send_email(contact_info)
输出结果:Sending email to Lilei at Lilei@qq.com
在这个示例中,Contact 类型定义了三个必须的字段:name,email,和 phone,每个字段都是字符串(Str)形式。当创建 contact_info 字典时,必须提供所有这些字段。函数 send_email 则利用这个类型安全的字典进行操作。这样的 TypedDict 使用场景非常适合那些需要确保字典中具有特定字段和类型的应用场景,如处理从外部API返回的数据或者在内部各个模块间传递复杂的数据结构,因为在LangGraph图中,每个节点传递到下一个节点的数据,将直接影响到下一个节点能否顺利执行。
接下来我们实践在LangGraph中通过Typedict定义单输入输出模式。首先,需要安装所需的依赖包,代码如下:
python
! pip install langgraph==0.2.60
python
from langgraph.graph import StateGraph
from typing_extensions import TypedDict

# 定义输入的模式
class InputState(TypedDict):
    question: str

# 定义输出的模式
class OutputState(TypedDict):
    answer: str

# 将 InputState 和 OutputState 这两个 TypedDict 类型合并成一个字典类型。
class OverallState(InputState, OutputState):
    pass
接下来,创建一个 StateGraph 对象,使用 OverallState 作为其状态定义,同时指定了输入和输出类型分别为 InputState 和 OutputState,代码如下:
python
# 明确指定它的输入和输出数据的结构或模式
builder = StateGraph(OverallState, input=InputState, output=OutputState)
创建 builder 对象后,相当于构建了一个图结构的框架。接下来的步骤是向这个图中添加节点和边,完善和丰富图的内部执行逻辑。
3. Nodes
在 LangGraph 中,节点是一个 python 函数(sync 或async ),接收当前State作为输入,执行自定义的计算,并返回更新的State。所以其中第一个位置参数是state 。
python
def agent_node(state:InputState):
    print("我是一个AI Agent。")
    return
python
def action_node(state:InputState):
    print("我现在是一个执行者。")
return {"answer":"我现在执行成功了"}定义好了节点以后,我们需要使用add_node方法将这些节点添加到图中。在将节点添加到图中的时候,可以自定义节点的名称。而如果不指定名称,则会为自动指定一个与函数名称等效的默认名称。代码如下:
python
builder.add_node("agent_node", agent_node)
builder.add_node("action_node", action_node)现在有了图结构,并且图结构中也存在两个孤立的节点agent_node和action_node,接下来我们要做的事就是需要将图中的节点按照我们所期望的方式进行连接,这需要用到的就是Edges - 边。
4. Edges
Edges(边)用来定义逻辑如何路由以及图何时开始与停止。这是代理工作以及不同节点如何相互通信的重要组成部分。有几种关键的边类型:
- 普通边:直接从一个节点到下一个节点。
- 条件边:调用函数来确定下一个要转到的节点。
- 入口点:当用户输入到达时首先调用哪个节点。
- 条件入口点:调用函数来确定当用户输入到达时首先调用哪个节点。
同样,我们先看普通边。如果直接想从节点A到节点B,可以直接使用add_edge方法。注意:LangGraph有两个特殊的节点:START和END。START表示将用户输入发送到图的节点。使用该节点的主要目的是确定应该首先调用哪些节点。END节点是代表终端节点的特殊节点。当想要指示哪些边完成后没有任何操作时,将使用该节点。因此,一个完整的图就可以使用如下代码进行定义:
python
from langgraph.graph import START, END

builder.add_edge(START, "agent_node")
builder.add_edge("agent_node", "action_node")
builder.add_edge("action_node", END)最后,通过compile编译图。在编译过程中,会对图结构执行一些基本检查(如有没有孤立节点等)。代码如下:
python
graph = builder.compile()至此,我们已经成功构建了一个完整的图结构,并准备好接收用户的请求。
5. Graph 的调用方法
要调用图中的方法,可以使用 invoke 方法。示例代码如下:
python
graph.invoke({"question":"hello,你好"})输出结果:
我是一个AI Agent。
我现在是一个执行者。
{'answer': '我现在执行成功了'}
python
graph.invoke({"question":"今天的天气怎么样?"})输出结果:
我是一个AI Agent。
我现在是一个执行者。
{'answer': '我现在执行成功了'}
在这个过程中,我们将state: InputState作为输入模式传递给agent_node,在传递到action_node,最后由action_node传递到END节点。节点之间通过边是已经构建了完整的通路,那么如果我们想要传递每个节点的状态信息,则可以稍加修改即可实现。对于图模式,我们的定义方法如下:
python
from langgraph.graph import StateGraph
from typing_extensions import TypedDict
from langgraph.graph import START, END

# 定义输入的模式
class InputState(TypedDict):
    question: str

# 定义输出的模式
class OutputState(TypedDict):
    answer: str

# 将 InputState 和 OutputState 这两个 TypedDict 类型合并成一个更全面的字典类型。
class OverallState(InputState, OutputState):
    pass
python
def agent_node(state: InputState):
    print("我是一个AI Agent。")
    return {"question": state["question"]}
python
def action_node(state: InputState):
    print("我现在是一个执行者。")
    step = state["question"]
    return {"answer": f"我接收到的问题是:{step},读取成功了!"}
python
# 明确指定它的输入和输出数据的结构或模式
builder = StateGraph(OverallState, input=InputState, output=OutputState)

# 添加节点
builder.add_node("agent_node", agent_node)
builder.add_node("action_node", action_node)

# 添加边
builder.add_edge(START, "agent_node")
builder.add_edge("agent_node", "action_node")
builder.add_edge("action_node", END)

# 编译图
graph = builder.compile()
执行调用:
python
graph.invoke({"question":"今天的天气怎么样?"})输出结果:
我是一个AI Agent。
我现在是一个执行者。
{'answer': '我接收到的问题是:今天的天气怎么样?,读取成功了!'}
python
graph.invoke({"question":"你好,我用来测试"})输出结果:
我是一个AI Agent。
我现在是一个执行者。
{'answer': '我接收到的问题是:你好,我用来测试,读取成功了!'}
不同节点间能够传递信息的原因是因为节点可以写入图状态中的任何状态通道。图状态是初始化时定义的状态通道的并集,而我们定义的状态通道包含了OverallState以及过滤器InputState和OutputState 。
使用LangGraph构建大模型的问答流程
在上面的示例中,我们通过使用打印函数来初步了解LangGraph构建图的基本方法和机制。接下来,我们将探索如何将大模型集成至LangGraph框架中,从而构建一个更具实际应用价值的用于问答流程的图模式。
首先,LangGraph对目前主流的在线或者开源模型均支持接入,所以大家可以在该框架下非常便捷的应用到自己偏爱的大模型来进行问答流程的构建。这下面的示例中,我们选择比较方便且高效的LangChain框架,同时使用OpenAI的GPT模型来进行案例实现。而关于LangChain支持接入的模型列表及方式,大家可以在LangChain Docs中查阅:https://python.langchain.com/docs/integrations/chat/ 或者 https://python.langchain.com/docs/integrations/llms/ 。
这里仍然需要首先定义图模式,代码如下:
python
from langgraph.graph import StateGraph
from typing_extensions import TypedDict
from langgraph.graph import START, END

# 定义输入的模式
class InputState(TypedDict):
    question: str

# 定义输出的模式
class OutputState(TypedDict):
    answer: str

# 将 InputState 和 OutputState 这两个 TypedDict 类型合并成一个更全面的字典类型。
class OverallState(InputState, OutputState):
pass使用OpenAI的GPT模型需要使用到ChatOpenAI方法,我们需要将其定义到Agent节点中,用来接收用户输入的问题,调用GPT模型来根据用户的问题生成自然语言的回复响应。代码如下:
python
from langchain_openai import ChatOpenAI
from dotenv import load_dotenv

import os

# 加载 .env 文件,必须放在 os.getenv 前面!
load_dotenv()

## 这是你的key
key=os.getenv("DEEPSEEK_API_KEY")
base_url="https://api.deepseek.com"

def llm_node(state: InputState):
    messages = [
        ("system","你是一位乐于助人的智能小助理",),
        ("human", state["question"])
    ]


    llm = ChatOpenAI(model="deepseek-v4-pro", api_key=key,base_url=base_url,temperature=0,)

    response = llm.invoke(messages)

    return {"answer": response.content}
构建图,添加节点和边,并进行图结构的编译。完整代码如下所示:
python
# 明确指定它的输入和输出数据的结构或模式
builder = StateGraph(OverallState, input=InputState, output=OutputState)

# 添加节点
builder.add_node("llm_node", llm_node)

# 添加边
builder.add_edge(START, "llm_node")
builder.add_edge("llm_node", END)

# 编译图
graph = builder.compile()
python
graph.invoke({"question":"你好,我用来测试"})
python
final_answer = graph.invoke({"question":"你好,我用来测试"})

print(final_answer["answer"])
python
final_answer = graph.invoke({"question":"你好,请你详细的介绍一下你自己"})

print(final_answer["answer"])更进一步地,如果想在原有的图结构中构建更复杂的功能,则只需要新定义一个Python函数,并按照自己的预期流程用边来建立连接,如下代码所示:
python
from langgraph.graph import StateGraph
from typing_extensions import TypedDict, Optional
from langgraph.graph import START, END

# 定义输入的模式
class InputState(TypedDict):
    question: str
    llm_answer: Optional[str]  # 表示 answer 可以是 str 类型,也可以是 None


# 定义输出的模式
class OutputState(TypedDict):
    answer: str

# 将 InputState 和 OutputState 这两个 TypedDict 类型合并成一个更全面的字典类型。
class OverallState(InputState, OutputState):
    pass
python
def llm_node(state: InputState):
    messages = [
        ("system","你是一位乐于助人的智能小助理",),
        ("human", state["question"])
    ]

    llm = ChatOpenAI(model="deepseek-v4-pro", api_key=key,base_url=base_url,temperature=0,)
    response = llm.invoke(messages)

    return {"llm_answer": response.content}

def action_node(state: InputState):
    messages = [
        ("system","无论你接收到什么语言的文本,请翻译成英语",),
        ("human", state["llm_answer"])
    ]

    llm = ChatOpenAI(model="deepseek-v4-pro", api_key=key,base_url=base_url,temperature=0,)

    response = llm.invoke(messages)

    return {"answer": response.content}
python
# 明确指定它的输入和输出数据的结构或模式
builder = StateGraph(OverallState, input=InputState, output=OutputState)

# 添加节点
builder.add_node("llm_node", llm_node)
builder.add_node("action_node", action_node)


# 添加便
builder.add_edge(START, "llm_node")
builder.add_edge("llm_node", "action_node")
builder.add_edge("action_node", END)

# 编译图
graph = builder.compile()
python
final_answer = graph.invoke({"question":"你好,请你详细的介绍一下你自己"})

print(final_answer["answer"])
python
final_answer = graph.invoke({"question": "请问什么是人工智能?"})

print(final_answer["answer"])
深入理解 LangGraph 的底层原理及其基于图结构的构建逻辑后,可以明显感受到,相较于 LangChain 的 AI Agent 架构,LangGraph 展现出了更高的灵活性和可扩展性。在 LangGraph 中,我们能够通过各个 Python 函数定义节点的核心逻辑,并通过边来确定输入和输出的关系。此外,节点函数在定义时还可以自主生成和管理中间状态的信息。虽然在本示例中,我们通过 LangChain 实现大模型的接入,但从节点函数的定义逻辑来看,完全可以不依赖 LangChain,而采用原生方法完成接入。
由此可见,正如课程开始时所强调的,**尽管 LangGraph 基于 LangChain 表达式语言构建,但它完全具备独立运行的能力。**整体而言,今天的示例虽然并不复杂,但涉及的知识点和细节较为丰富。建议大家亲自实践,通过动手操作巩固基础,为后续复杂循环图的学习打下坚实的基础。