前面我们介绍了muduo库,接下来我们进行sqlite以及gtest的使用
一.SQLite3
1.什么是 SQLite
SQLite 是一个进程内的轻量级数据库,它实现了自给自足的、无服务器的、零配置的、事务性的 SQL 数据库引擎。它是一个零配置的数据库,这意味着与其他数据库不一样,我们不需要在系统中配置。不像其他数据库,SQLite 引擎不是一个独立的进程,可以按应用程序需求进行静态或动态连接,SQLite 直接访问其存储文件。
2.为什么要用 SQLite
- 不需要一个单独的服务器进程或操作的系统(无服务器 );
- SQLite 不需要配置;
- 一个完整的 SQLite 数据库是存储在一个单一的跨平台磁盘文件里;
- SQLite 非常小、轻量级,完全配置时小于 400 KiB,省略可选功能配置时小于 250 KiB;
- SQLite 是自给自足的,这意味着不需要任何外部依赖;
- SQLite 事务完全兼容 ACID,允许从多个进程或线程安全访问;
- SQLite 支持 SQL92(SQL2)标准的大多数查询语言功能;
- SQLite 使用 ANSI-C 编写,并提供了简单、易于使用的 API;
- SQLite 可在 UNIX(Linux、Mac OS-X、Android、iOS)和 Windows(Win32、WinCE、WinRT)中运行。
3.SQLite3 C/C++ API 介绍
C/C++ API 是 SQLite3 数据库的一个客户端,提供一种用 C/C++ 操作数据库的方法。
官方文档: List Of SQLite Functions
1.查看当前数据库在编译阶段是否启动了线程安全
cpp
int sqlite3_threadsafe(); // 0-未启用;1-启用需要注意的是,SQLite 有三种安全等级:
- 非线程安全模式;
- 线程安全模式 (不同的连接在不同的线程/进程间是安全的,即一个句柄不能用于多线程间);
- 串行化模式 (可以在不同的线程/进程间使用同一个句柄)。
2. 创建/打开数据库文件,并返回操作句柄
cpp
int sqlite3_open(const char *filename, sqlite3 **ppDb);
// 成功返回 SQLITE_OK
若在编译阶段启动了线程安全,则在程序运行阶段可以通过参数选择线程安全等级:
cpp
int sqlite3_open_v2(const char *filename, sqlite3 **ppDb,
                    int flags, const char *zVfs);
// 返回 SQLITE_OK 表示成功
flags 取值:
| 取值 | 含义 |
|---|---|
SQLITE_OPEN_READWRITE |
以可读可写方式打开数据库文件 |
SQLITE_OPEN_CREATE |
不存在数据库文件则创建 |
SQLITE_OPEN_NOMUTEX |
多线程模式,只要不同的线程使用不同的连接即可保证线程安全 |
SQLITE_OPEN_FULLMUTEX |
串行化模式 |
3. 执行语句
cpp
int sqlite3_exec(sqlite3 *db, const char *sql,
                 int (*callback)(void*, int, char**, char**),
                 void *arg, char **errmsg);
// 返回 SQLITE_OK 表示成功
回调函数 int (callback)(void, int, char, char**) 的四个参数:**
| 参数 | 含义 |
|---|---|
void* |
在回调时传入的 arg 参数 |
int |
一行中数据的列数 |
char** |
存储一行数据的字符指针数组 |
char** |
每一列的字段名称 |
这个回调函数有个 int 返回值:成功处理的情况下必须返回 0,返回非 0 会触发 ABORT 退出程序 。
4. 销毁句柄
int sqlite3_close(sqlite3 *db);      // 成功返回 SQLITE_OK
int sqlite3_close_v2(sqlite3 *db);   // 推荐使用------无论如何都会返回 SQLITE_OK
获取错误信息
cpp
const char *sqlite3_errmsg(sqlite3 *db);4.SQLite3 C/C++ API的使用
来看代码,我们直接进行封装,方便我们的使用
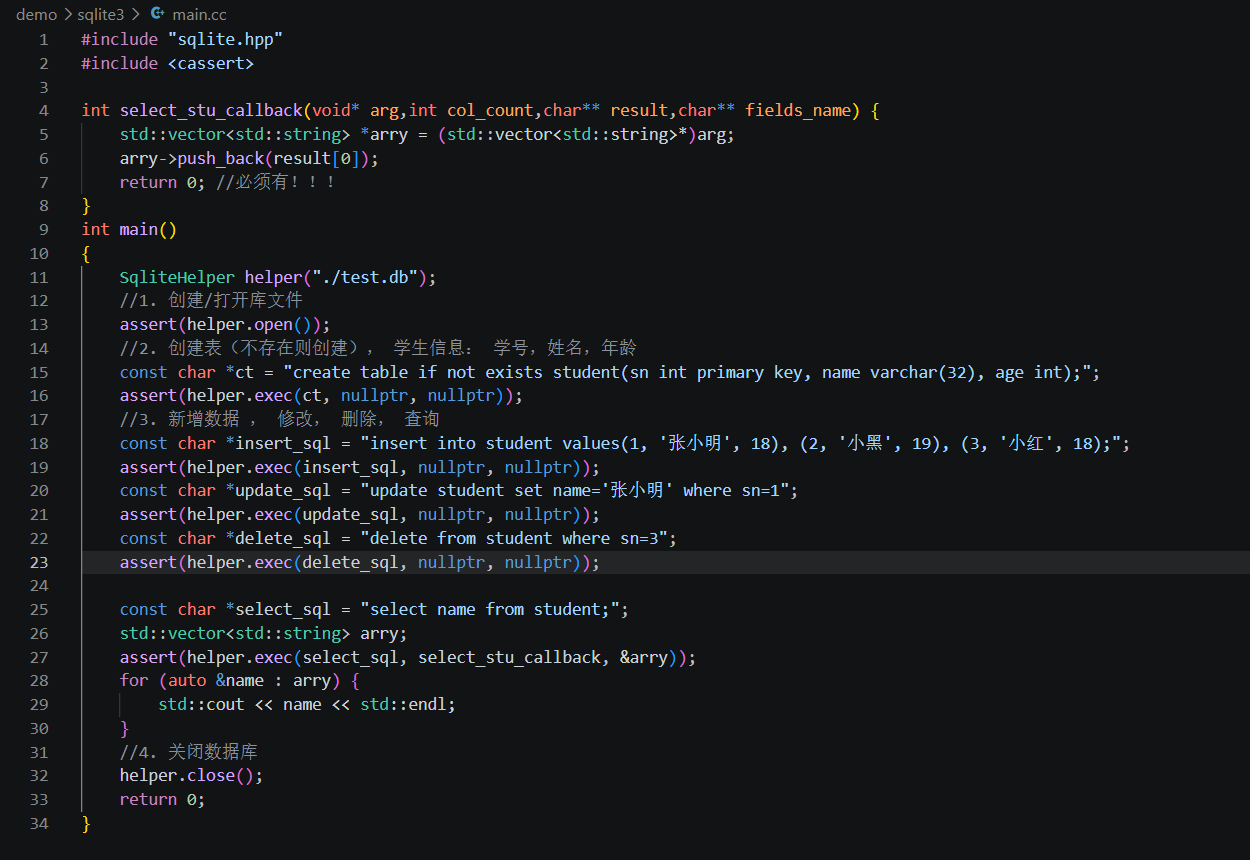
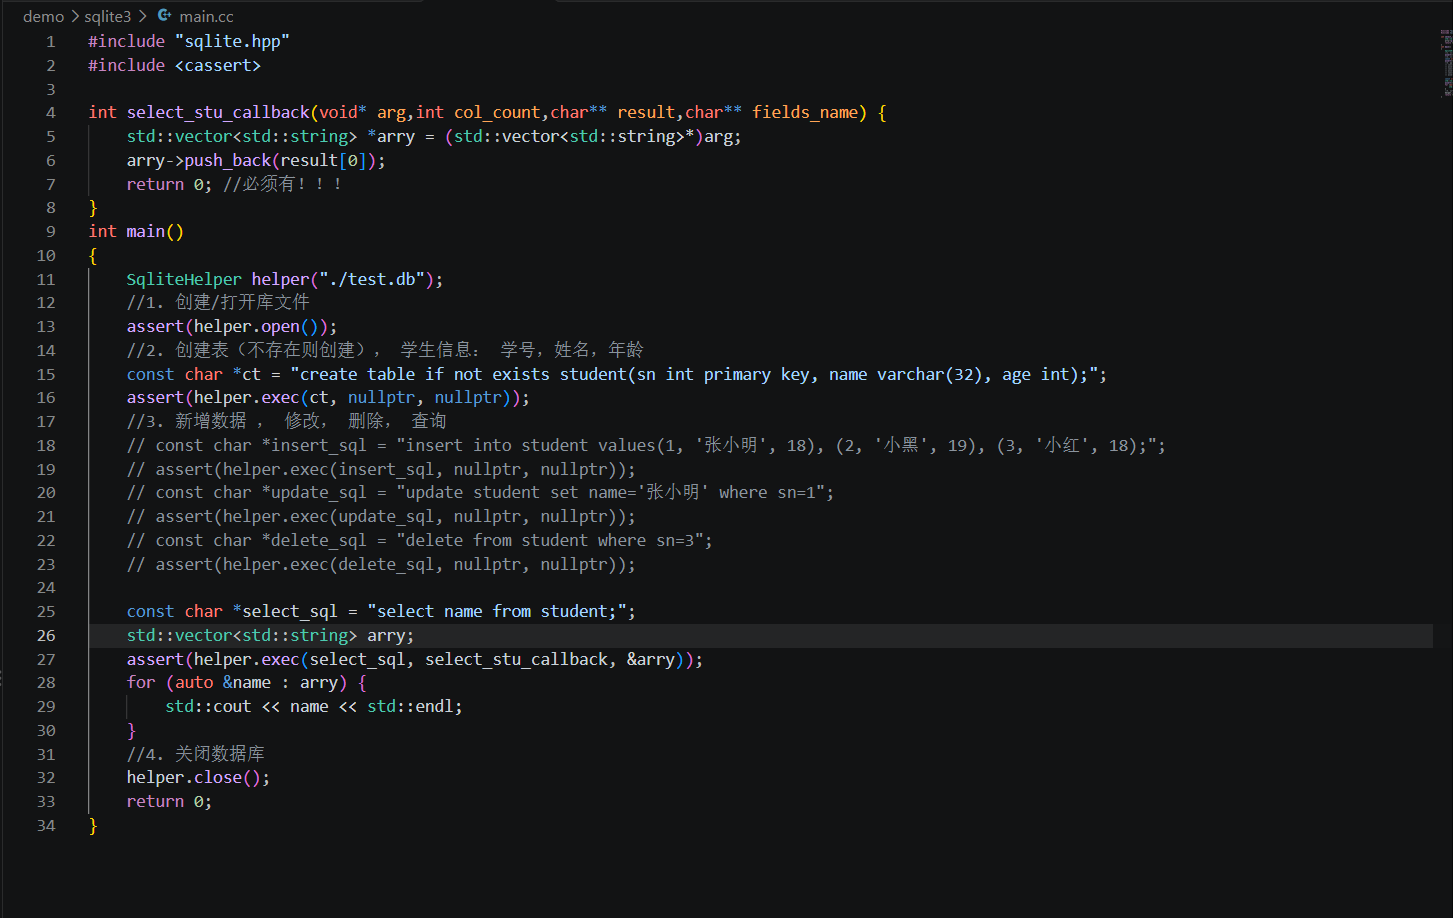
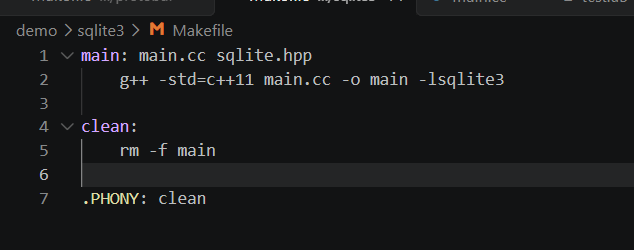
代码框架
bash
SqliteHelper
├── 成员
│     ├── _dbfile    : std::string    数据库文件路径
│     └── _handler   : sqlite3*       数据库操作句柄(核心资源)
│
├── open()   → sqlite3_open_v2()      创建/打开,拿到句柄
├── exec()   → sqlite3_exec()         执行任意 SQL
└── close()  → sqlite3_close_v2()     释放句柄
程序运行检测:
我们先开放插入代码运行结果:


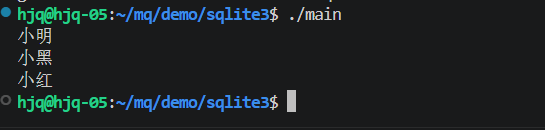
接着开放删除语句,进行执行

接着往下运行会发现报错了,原因如下:
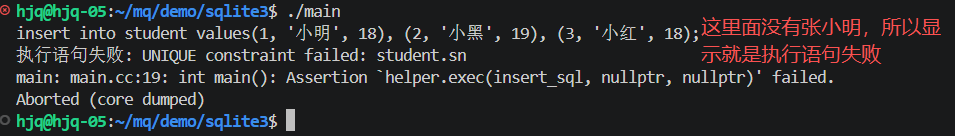
所以接下来进行修改:
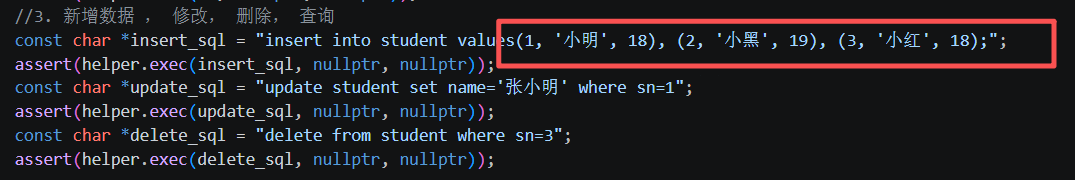
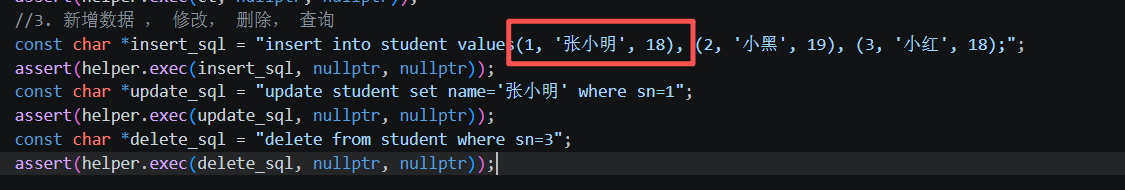
接着再次运行,看结果:
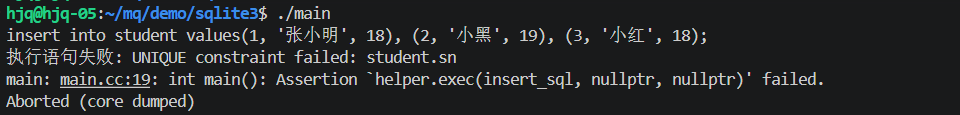
第二次运行就主键冲突
原因 :test.db 是持久化文件,第一次运行插入的数据还在磁盘上。而 sn 是主键:
bash
create table if not exists student(sn int primary key, name varchar(32), age int);同样的主键 1、2、3 再插一次,必然冲突。
这恰恰是 SQLite 的特性 :它的价值就在于"数据不随程序退出而消失 "------一个文件就是一个完整数据库。所以调试时需要主动清库。
三种解法
| 方案 | 做法 | 适用 |
|---|---|---|
| 删库重来 | rm -f test.db && ./main |
调试阶段最省事 |
| 有则替换 | SQL 改成 insert or replace into student values(...) |
幂等写入 |
| 先清空表 | 插入前执行 delete from student; |
数据量小 |
注意哈 :SQLite 里
int primary key不会自增 ,必须写integer primary key(是integer而不是int)才会成为 rowid 的别名并自动递增。用int的话,主键值要自己保证不重复。
assert 在这里暴露了它的问题 
assert 检查失败时做了什么?
直接 abort 进程 + core dump。
而更麻烦的是它在 Release 构建下的行为:
| 构建方式 | 断言失败时 |
|---|---|
| Debug(默认,当前) | abort + core dump,用户看到的是崩溃 |
Release(-DNDEBUG) |
断言被整个编译掉 → 插入失败了程序照常往下跑,后续查询拿到的是旧数据,你完全不知道出过错 |
两种情况都不是想要的结果。 因为 assert 的正确定位是:
检查"不可能发生的内部逻辑错误"(比如"这个指针按设计绝不可能是空")。
而"打开数据库""执行 SQL"都是可能失败的外部操作------文件可能不存在、磁盘可能满、SQL 可能写错。这类检查应该用 if:
cpp
if (!helper.exec(insert_sql, nullptr, nullptr)) {
    std::cerr << "插入失败" << std::endl;
    return -1;                          // 优雅退出,不 core dump
}
简单来说就是:能被编译掉的检查,就不是检查。
验证结果
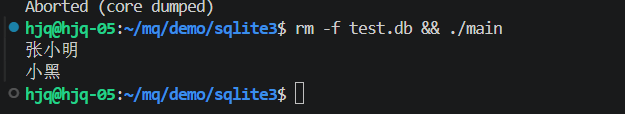
只打印两行是正确的 ------因为同时delete from student where sn=3也放开了:
bash
插入 3 行:张小明(1) / 小黑(2) / 小红(3) --->delete sn=3:(小红被删除) --->select:(只剩张小明、小黑)二.Gtest
1.GTest 是什么
GTest 是一个跨平台的 C++单元测试框架,由 google 公司发布。gtest 是为了在不同平台上为编写 C++单元测试而生成的。它提供了丰富的断言、致命和非致命判断、参数化等等
2.GTest 使用
a.两个核心宏
cpp
TEST(test_case_name, test_name)
TEST_F(test_fixture, test_name)| 宏 | 用途 |
|---|---|
TEST |
创建一个简单测试。函数体内可以写任意 C++ 代码,并用框架提供的断言检查 |
TEST_F |
用于多样测试 。多个测试场景需要相同的数据配置时使用------即"相同的数据,测不同的行为" |
简单区分:
TEST每次都是干净的空白开始;TEST_F基于一个 Fixture 类,可以在每个测试用例执行前自动准备同一份数据。
b.断言:两类,差别很大
| 系列 | 失败时的行为 |
|---|---|
ASSERT_* |
退出当前函数(后面的代码不再执行) |
EXPECT_* |
继续往下执行(失败也把整个函数跑完) |
c.常用断言速查
cpp
// bool 值检查
ASSERT_TRUE(参数);      // 期待结果是 true
ASSERT_FALSE(参数);     // 期待结果是 false

// 数值型数据检查
ASSERT_EQ(val1, val2);  // equal,相等才通过
ASSERT_NE(val1, val2);  // not equal,不等才通过
ASSERT_LT(val1, val2);  // less than,小于才通过
ASSERT_GT(val1, val2);  // greater than,大于才通过
ASSERT_LE(val1, val2);  // less equal,小于等于才通过
ASSERT_GE(val1, val2);  // greater equal,大于等于才通过
把上面所有 ASSERT_ 换成 EXPECT_,就是对应的"非致命"版本。
自定义失败信息 :如果对自动输出的错误信息不满意,可以用
operator<<在失败时打印自己的日志:
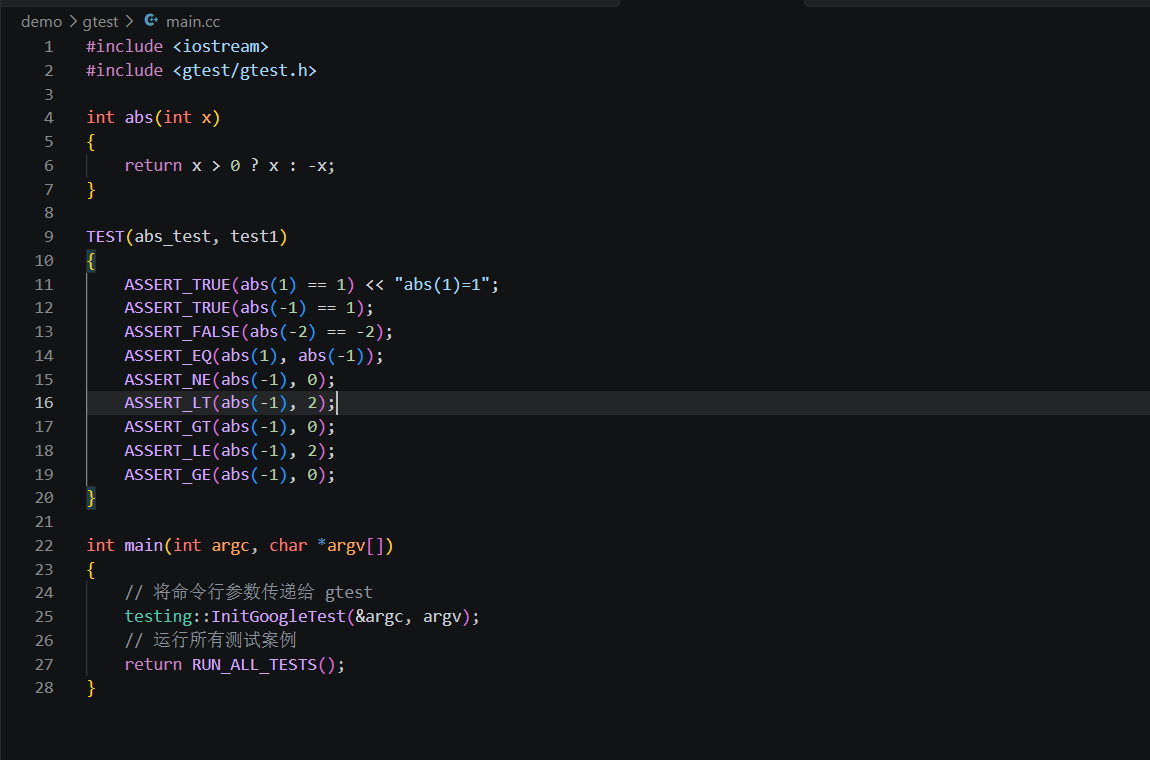
cppASSERT_TRUE(abs(1) == 1) << "abs(1)=1";
实战:测试一个求绝对值的函数
运行结果如下:
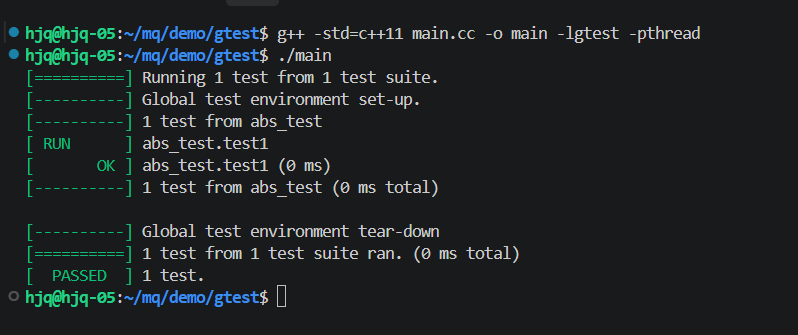
参数逐个说明
| 参数 | 作用 | 能不能省 |
|---|---|---|
-std=c++11 |
GTest 需要 C++11 起 | 不能 |
main.cc |
源文件 | --- |
-o main |
输出可执行文件名 | 可以(默认 a.out) |
-lgtest |
链接 GTest 库 | 不能 |
-pthread |
GTest 内部用到线程 | 不能 |
接下来我们呢将第一条语句改成 ASSERT_FALSE 进行错误测试
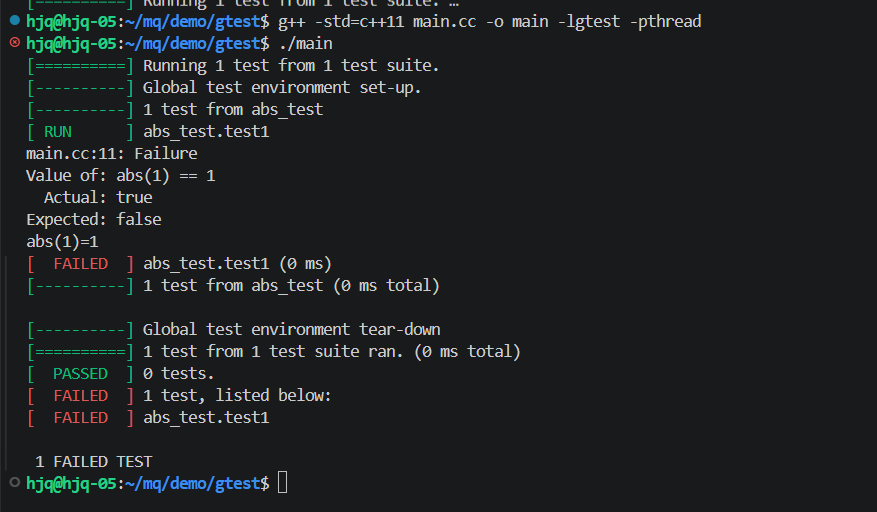
【重点】为什么只报了一条错?
上面的失败输出里,只出现了第 11 行那一条失败,后面 8 条断言一条信息都没有。
不是它们都通过了,而是根本没执行。
cpp
TEST(abs_test, test1)
{
    ASSERT_FALSE(abs(1) == 1);   // <-- 这里失败,函数【直接返回】
    ASSERT_TRUE(abs(-1) == 1);   // <-- 以下 8 条全部被跳过,从未运行
    ASSERT_FALSE(abs(-2) == -2);
    ...
}
这就是 ASSERT_ 和 EXPECT_ 的本质区别:
| 用哪个 | 结果 |
|---|---|
ASSERT_FALSE |
第一条失败 --> 函数返回 --> 只看到 1 条失败信息 |
EXPECT_FALSE |
第一条失败 --> 继续跑完 --> 看到 1 条失败 + 8 条通过 |
d.事件机制
GTest 中的事件机制是指在测试前和测试后提供给用户自行添加操作的机制,而且该
机制也可以让同一测试套件下的测试用例共享数据。GTest 框架中事件的结构层次:
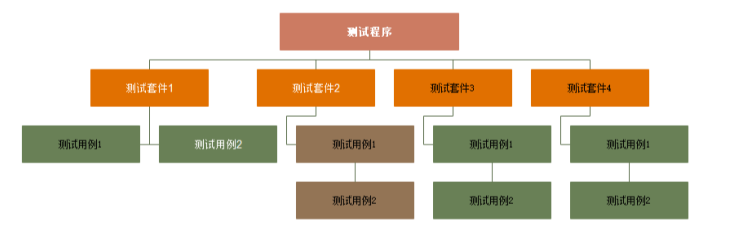
- 测试程序:一个测试程序只有一个 main 函数,也可以说是一个可执行程序是一个测试程序。该级别的事件机制是在程序的开始和结束执行
- 测试套件:代表一个测试用例的集合体,该级别的事件机制是在整体的测试案例开始和结束执行
- 测试用例:该级别的事件机制是在每个测试用例开始和结束都执行
事件机制的最大好处就是能够为我们各个测试用例提前准备好测试环境,并在测试完
毕后用于销毁环境,这样有个好处就是如果我们有一端代码需要进行多种不同方法的
测试,则可以通过测试机制在每个测试用例进行之前初始化测试环境和数据,并在测
试完毕后清理测试造成的影响。
- GTest 提供了三种常见的的事件:
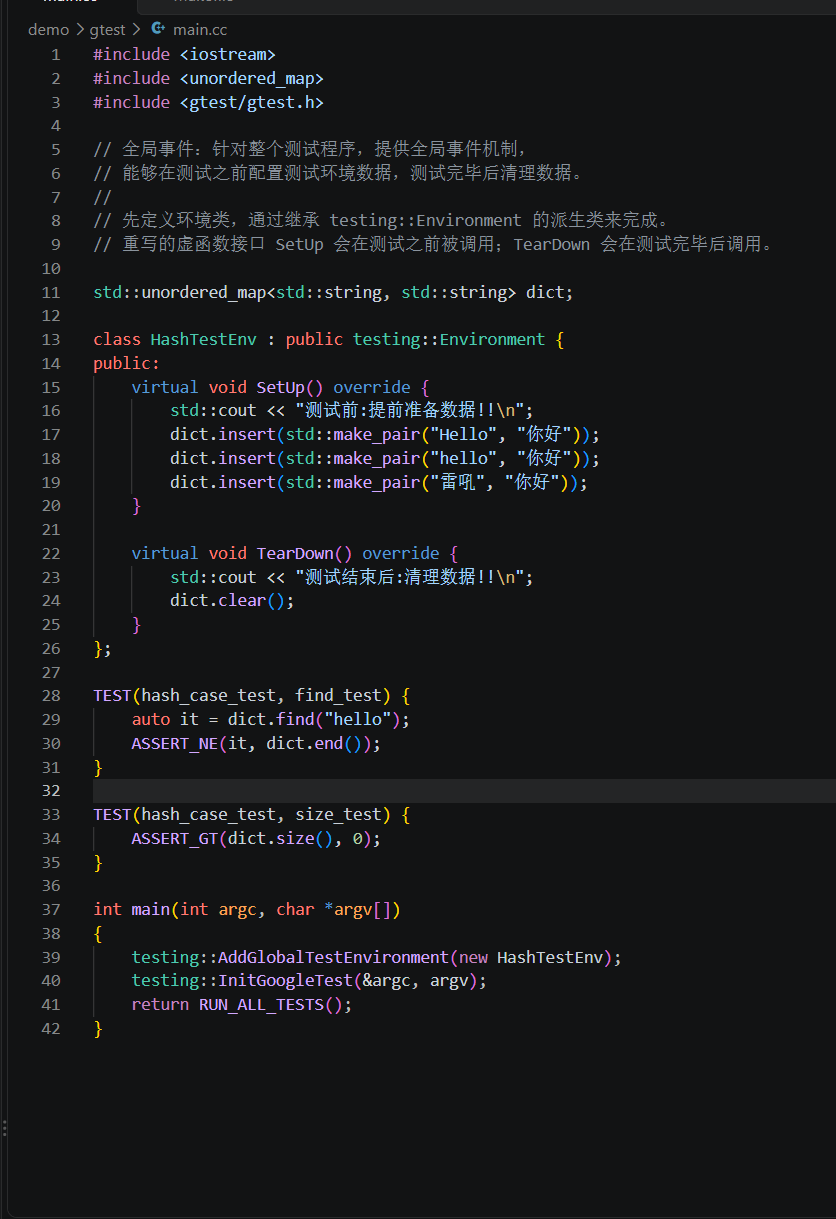
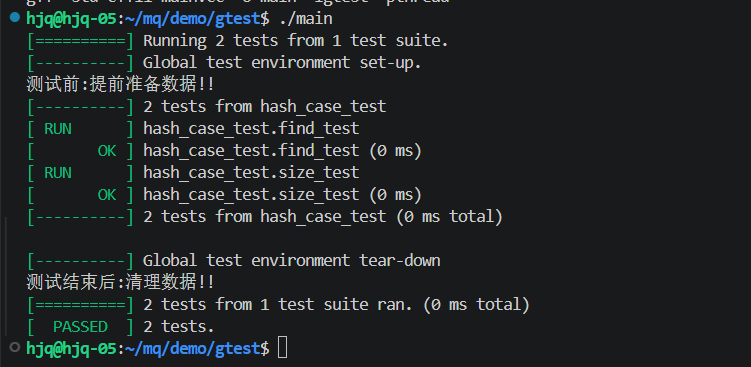
**全局事件:**针对整个测试程序。实现全局的事件机制,需要创建一个自己的类,然后继承 testing::Environment 类,然后分别实现成员函数 SetUp 和 TearDown,同时在 main 函数内进行调用 testing::AddGlobalTestEnvironment(newMyEnvironment);函数添加全局的事件机制
TestSuite 事件:针对一个个测试套件。测试套件的事件机制我们同样需要去创建一个类,继承自 testing::Test,实现两个静态函数 SetUpTestCase 和TearDownTestCase,测试套件的事件机制不需要像全局事件机制一样在 main 注册,而是需要将我们平时使用的 TEST 宏改为 TEST_F 宏。
○ SetUpTestCase() 函数是在测试套件第一个测试用例开始前执行
○ TearDownTestCase() 函数是在测试套件最后一个测试用例结束后执行
○ 需要注意 TEST_F 的第一个参数是我们创建的类名,也就是当前测试套件的
名称,这样在 TEST_F 宏的测试套件中就可以访问类中的成员了。
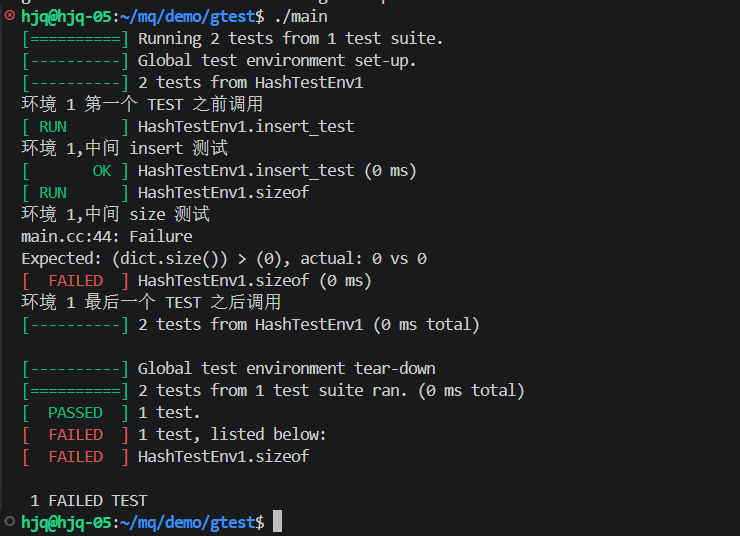
能够看到在上例中,有一个好处,就是将数据与测试结合到同一个测试环境类中了,
这样与外界的耦合度更低,代码也更清晰。
但是同样的,我们发现在两个测试用例中第二个测试用例失败了,这是为什么呢?这
就涉及到了 TestCase 事件的机制。
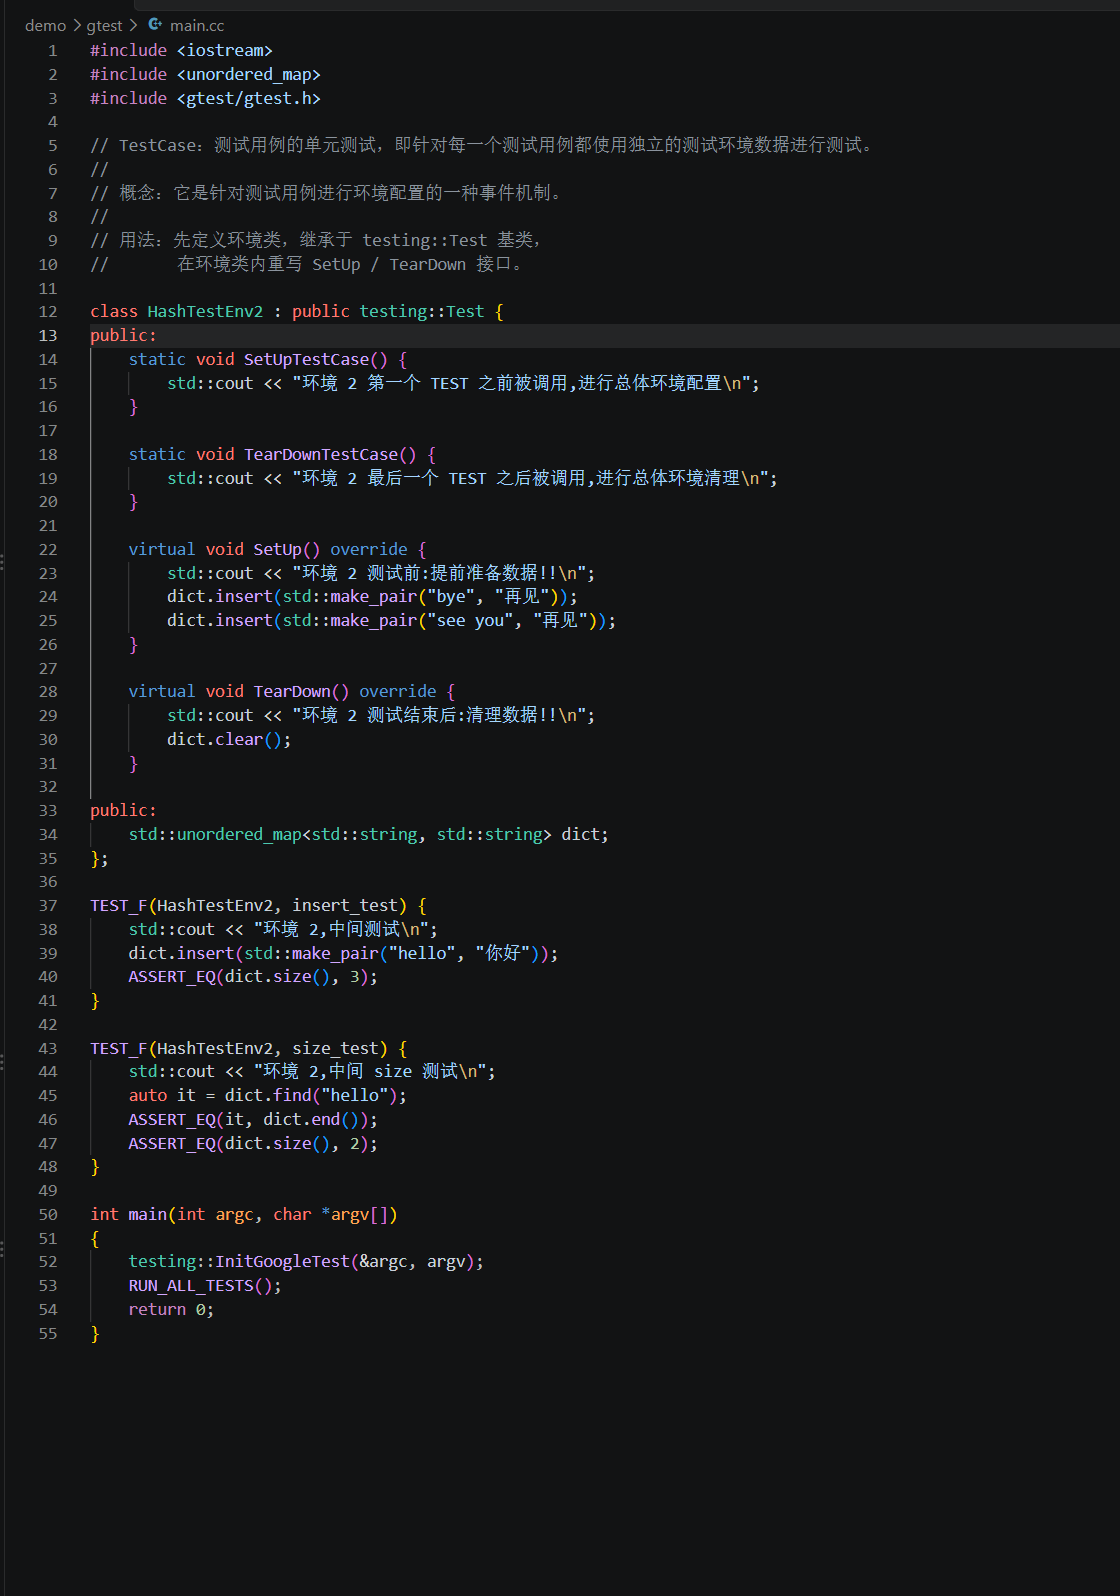
TestCase 事件: 针对一个个测试用例。测试用例的事件机制的创建和测试套件的基本一样,不同地方在于测试用例实现的两个函数分别是 SetUp 和 TearDown, 这两个函数也不是静态函数
○ SetUp()函数是在一个测试用例的开始前执行
○ TearDown()函数是在一个测试用例的结束后执行
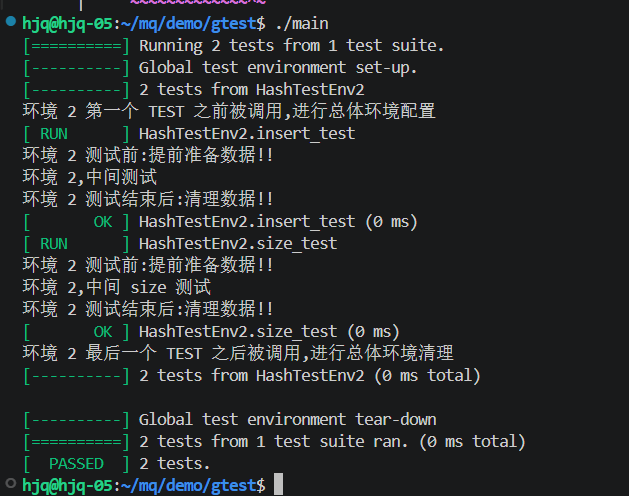
也就是说,在 TestSuite/TestCase 事件中,每个测试用例,虽然它们同用同一个事件
环境类,可以访问其中的资源,但是本质上每个测试用例的环境都是独立的,这样我
们就不用担心不同的测试用例之间会有数据上的影响了,保证所有的测试用例都使用
相同的测试环境进行测试。
3.GTest 三层事件
1.先搞懂"三层"是什么
GTest 的事件机制,就是在测试前自动准备、测试后自动收拾。它分三层,区别只有一件事:这个"准备和收拾"多久做一次?
用上课打个比方:
| 层次 | 比方 | 做几次 |
|---|---|---|
| 全局事件 | 学校大门早上开、晚上关 | 全校 1 次 |
| TestSuite 事件 | 一个班上课前,老师进教室开灯、擦黑板 | 一个班 1 次 |
| Test 事件 | 每个学生各拿一张全新的草稿纸 | 每个学生 1 次 |
一句话就是:全局和 TestSuite 是"一群人共用一次 ",Test 是"每个人各来一次"。
2.三个例子分别在干什么
| 例子一 | 例子二 | 例子三 | |
|---|---|---|---|
| 做什么 | 全校开一次门 | 一个班擦一次黑板 | 擦黑板 + 每人发新纸 |
| 继承谁 | testing::Environment |
testing::Test |
testing::Test |
| 写哪些函数 | SetUp / TearDown |
SetUpTestCase / TearDownTestCase |
四个都写 |
| 用哪个宏 | TEST |
TEST_F |
TEST_F |
| main 里要注册吗 | 要 | 不用 | 不用 |
| 结果 | 2 个全过 | 挂了一个 | 2 个全过 |
3.例子二为什么挂了一个?
GTest 有个规矩:每跑一个测试用例,就发一张全新的草稿纸。
cpp
跑 insert_test 这个测试
    ↓ GTest 发了【草稿纸 A】
    在纸 A 上写了 3 条数据(Hello / hello / 雷吼)
    查 hello --> 查到了通过
    ↓ 测试结束,【草稿纸 A 被收走,连同上面的数据一起扔掉】

跑 sizeof 这个测试
    ↓ GTest 发了【草稿纸 B】------ 一张全新的空纸!
    查 dict.size() --> 是 0
    ASSERT_GT(0, 0) --> 不成立 -->  失败
为什么数据会跟着纸走?
因为 dict 是类的非静态成员------它就相当于"写在草稿纸上的内容"。
| 定义方式 | 相当于 | 结果 |
|---|---|---|
std::unordered_map<...> dict;(非静态) |
写在草稿纸上 | 换张纸就没了 → 不共享 |
static std::unordered_map<...> dict;(静态) |
写在黑板上 | 全班都看得到 → 共享 |
注意 :这个"失败"不是 GTest 的 bug,反而是故意的设计------保证每个测试都从干净的环境开始,不会因为"谁先跑谁后跑"而结果不同。
4.例子三怎么把这个坑填上
例子三只比例子二多做了一件事 :加了 SetUp / TearDown。
SetUp 的作用,相当于"每次发新草稿纸时,老师先替你把基础数据抄上去"。
cpp
跑 insert_test
    ↓ 先自动执行 SetUp:往新纸上写 2 条(bye / see you)
    ↓ 测试体再自己加 1 条(hello)
    总共 3 条 --> ASSERT_EQ(dict.size(), 3) --> 通过
    ↓ 自动执行 TearDown:把纸清空
    ↓ 草稿纸被收走

跑 size_test
    ↓ 先自动执行 SetUp:又往新纸上写同样的 2 条
    查 hello --> 查不到(因为新纸上只有 bye / see you)
    总共 2 条 --> ASSERT_EQ(dict.size(), 2) --> 通过
结果就是每个测试拿到的初始数据都一模一样,两个都过了。
5.三个例子的运行次数对照
看日志出现了几次,就能看出作用范围------这是最直观的证据:
| 日志 | 例子一 | 例子二 | 例子三 |
|---|---|---|---|
全局 SetUp / TearDown |
1 / 1 | --- | --- |
套件 SetUpTestCase / TearDownTestCase |
--- | 1 / 1 | 1 / 1 |
用例 SetUp / TearDown |
--- | --- | 2 / 2 |
6.例子二 --> 例子三:只改了一处
| 改了什么 | 效果 |
|---|---|
加了 SetUp / TearDown(每个用例前重填数据) |
FAILED → PASSED |
其他全一样:同样 testing::Test、同样 TEST_F、同样非静态 dict |
--- |
7.实际写代码时怎么选
| 你要做的事 | 用哪一层 | 为什么 |
|---|---|---|
| 连接数据库、加载全局配置 | 全局事件 | 整个程序只需要做一次 |
| 建表、加载一批只读的基础数据 | TestSuite 事件 | 一组测试共用一份 |
| 每个测试都要一份干净、一致的数据 | Test 事件(最常用) | 避免测试之间互相干扰 |
为什么推荐优先用 Test 事件?
因为它能避免最让人头疼的一类问题:"单个测试跑能过,一起跑就挂"。 这类问题排查起来极其耗时,而根源往往就是不同测试共享了可变数据。
总结 :SetUpTestCase管"整组一次 ",SetUp管"每个测试各一次 "。 例子二的失败不是写错了,而是暴露了"测试之间数据不共享 "这个事实;例子三用SetUp把它补上,就对了。