MySQL
mysql基础
什么是主键
唯⼀标识⼀条记录,不允许重复,不允许为空
主键、外键、索引的区别
主键:唯⼀标识⼀条记录,不允许重复,不允许为空,⽤于唯⼀标识表中每⼀⾏的字段
外键:外键是⼀个表中的字段,其值是另⼀个表的主键,⽤于建⽴两个表之间的关系。
索引:没有重复值,但可以有⼀个空值 ,⽤于快速查询到数据。
MySQL表连接
连接: 将各个表中的记录都取出来进⾏依次匹配,将匹配后的结果发给客户端
笛卡尔积: 连接查询的结果中包含⼀个表的每⼀条记录与另⼀个表中每⼀条记录的组合
连接过程: 从驱动表中取每一条符合搜索条件的记录,到被驱动表中查找匹配的记录。只需要访问驱动表⼀次,可能会多次访问被驱动表。
内连接: 驱动表中的记录在被驱动表中找不到匹配的记录,那么驱动表的这条记录不会加⼊到最后的结果中。
外连接: 驱动表中的记录在被驱动表中找不到匹配的记录,也仍需要加⼊到最后结果中
左外连接:语句左侧的表为驱动表,右外连接:语句右侧的表为驱动表
过滤条件
where:
不论内外连接,只要是不符合 where ⼦句的记录都不会加⼊到最后的结果中
on:
在内连接中与 where 等价;
在外连接中,如果驱动表中的记录在被驱动表中没有记录可以匹配,该驱动表记录仍会加⼊到结果中,对应的被驱
动表字段以 null 填充
嵌套循环连接
如果有3个表进⾏连接,那么表1和表2完成连接后的结果作为驱动表,将表3作为被驱动表进⾏连接查询
执行一条SQL请求的执行过程
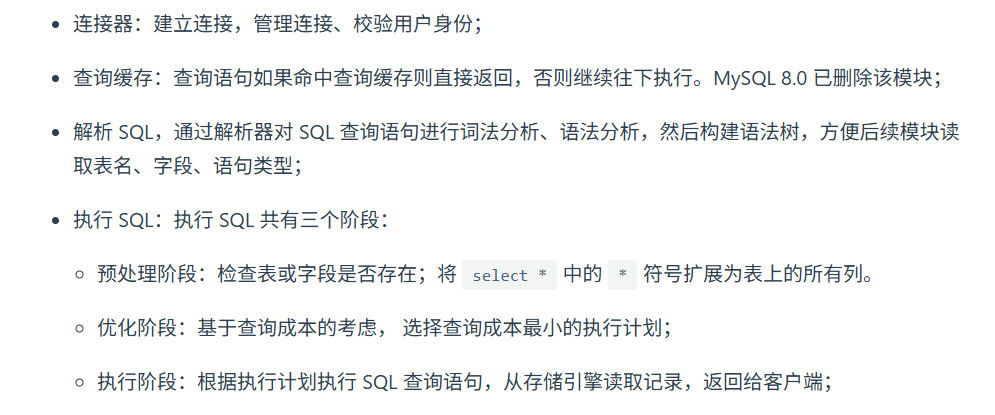
用户账号
查用户表:select user from user
新增用户:CREATE USER [user_name] IDENTIFIED BY [user_pwd]
修改用户:RENAME USER [user_name] TO [new_user_name]
修改用户密码:SET PASSWORD FOR [user_name] = Password('[new_pwd]')
删除用户账号:DROP USER [user_name]
查看用户权限:SHOW GRANTS FOR [user_name]
给用户授权:GRANT [权限名] ON [数据库名].[表名] TO [⽤户名]
撤销授权:REVOKE [权限名] ON [数据库名].[表名] FROM [⽤户名]
索引
什么是索引
索引类似与书的目录,为了提⾼数据查询的效率。
索引操作
创建索引:create index 索引名 on 表名(列名);
删除索引:drop index 索引名 on 表名;
怎么查看⼀个SQL语句是否使⽤了索引进⾏检索
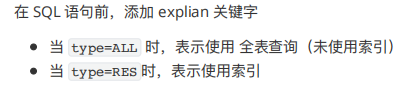
索引有哪些类别
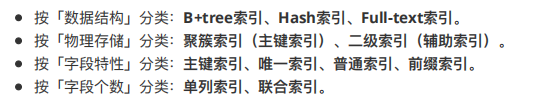
按数据结构分类:
-
哈希表:使用key-value对,存储数据,可能存在哈希冲突,多个value对应同一个key
优点:key无序,插入数据无需维护顺序,效率高
缺点:区间查询速度慢
适用场景:适用于等值查询
-
有序数组:
优点:有序数组适合查询
缺点:有序数组不适合增删
适用场景:适用于静态存储引擎,适合等值查询和区间查询。
-
二叉搜索树:有序数组的查询速度 + 链表的增删速度;但数据库索引要落磁盘,二叉树节点太稀、树太高,磁盘 I/O 扛不住,所以换成一节点存多 key 的 B+ 树。
-
N叉树:二叉树节点太稀、树太高,N 叉树一个节点装满一整个磁盘页,把树压矮、把磁盘 I/O 从几十次降到 3~4 次
按存储分类
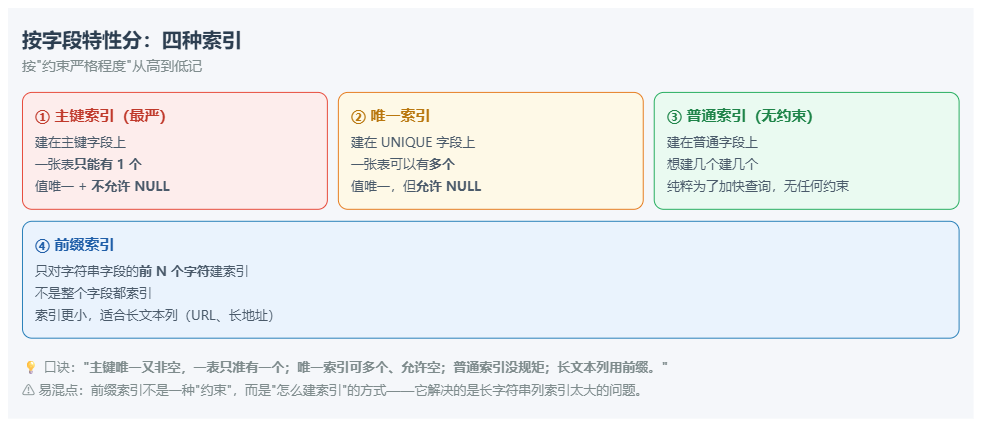
按照字段特性分类
按字段个数分类
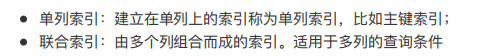
什么是最左匹配原则
最左匹配原则要求查询条件中的列应该从索引的最左边的列开始,并且不能跳过中间的列。
如果查询条件不按照索引的顺序进⾏匹配,那么索引可能会失效。
范围查询的字段可以⽤到联合索引,但是范围查询字段的后⾯的字段⽆法⽤到联合索引。
索引下推优化
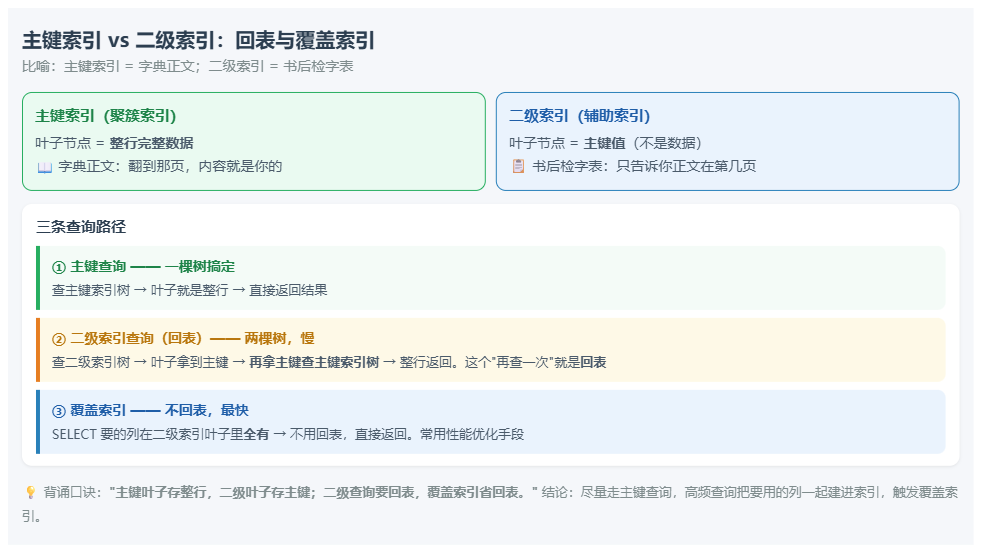
可以在联合索引遍历过程中,对联合索引中包含的字段先做判断,直接过滤掉不满⾜条件的记录,减少回表次数。
索引区分度
索引区分度表示某个字段不同值的个数占整个表的⽐例,建⽴联合索引时,要把区分度⼤的字段排在前⾯。
建立索引的注意事项
不需要建立索引的情况:
- 数据量小的表
- 不经常使用的列
- 频繁更新的列
- 字段中存在大量重复数据
索引的优缺点
优点:
1、大大加快数据的检索速度
2、唯一性索引可以保证数据库表中每一行数据的唯一性
缺点:
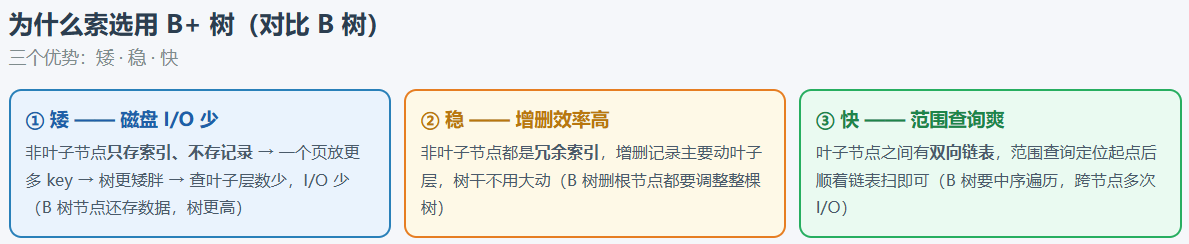
1、一个索引对应一颗B+树,每个节点是一个16kb大小的页,占用空间较大
2、如果数据有索引,频繁增删改会降低sql执行效率
什么时候需要创建索引
- 频繁查询的列
- 大表
- 唯一性要求
- 连接表的外键列
- 频繁使用排序和分组的列
索引优化的方法
1、前缀索引优化:使用某个字段中的字符串的前几个字符建立索引
2、覆盖索引优化:从⼆级索引中可以查询得到记录,避免回表
3、主键索引最好是⾃增的;这样每次插⼊⼀条新记录,都是追加操作,不需要重新移动数据
4、避免过多的索引
索引什么时候会失效
- 使⽤左或者左右模糊匹配
- 在索引列上使⽤函数或表达式
- 在 WHERE ⼦句中,如果在 OR 前的条件列是索引列,⽽在 OR 后的条件列不是索引列,那么索引会失效。
- 违背最左匹配原则
- 数据分布不均匀
- 查询中的条件涉及到隐式类型转换
为什么使用B+树索引
事务
事务的四⼤特性 ACID
- 原⼦性
事务是⼀个不可分割的⼯作单元,要么完全执⾏,要么完全不执⾏。通过undo log(回滚日志)保证。 - ⼀致性
确保事务将数据库从⼀个⼀致的状态转变为另⼀个⼀致的状态。
通过持久性+原⼦性+隔离性来保证的。 - 隔离性
多个事务并发执⾏时,每个事务都不能看到其他事务的中间状态。
通过 MVCC(多版本并发控制) 或锁机制来保证的。 - 持久性
⼀旦事务被提交,其结果将永久保存在数据库中,即使系统发⽣故障。
通过 redo log (重做⽇志)来保证的。
并⾏事务会出现什么问题
- 脏读:读到其他事务未提交的数据
- 不可重复读:前后读取的数据不⼀致
- 幻读:前后读取的记录数量不⼀致
严重性排序:脏读>不可重复读>幻读
隔离级别
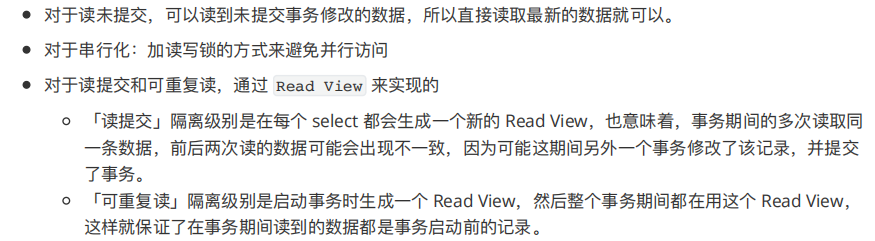
- 读未提交:
⼀个事务可以读取到另⼀个事务未提交的数据。这可能导致脏读(Dirty Reads)和不可重复读、幻读等问题。 - 读提交:
⼀个事务只能读取到已经提交的其他事务的数据。这解决了脏读的问题,但仍可能遇到不可重复读的问题。 - 可重复读
⼀个事务在其⽣命周期内多次执⾏相同的查询,将始终看到相同的数据,但是,仍可能发⽣幻读。也是MySQL InnoDB 引擎的默认隔离级别; - 可串⾏化
会对记录加上读写锁。事务的执⾏效果就好像它们是按顺序执⾏的,事务之间没有并发。这可以防⽌脏读、不可重复读和幻读,但也可能导致性能下降,因为并发性降低。
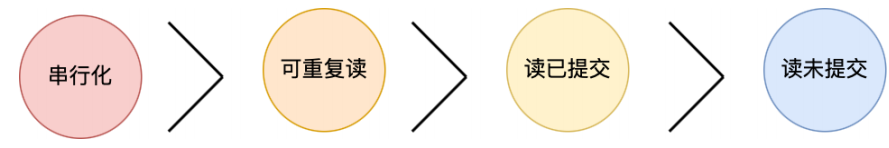
幻读是如何解决的
针对快照读(普通 select 语句),是通过 MVCC ⽅式解决了幻读
针对当前读:(select ... for update 等语句),是通过 next-key lock(记录锁+间隙锁)⽅式解决了幻读。
事务隔离的实现
Read View在MVCC中是如何⼯作的
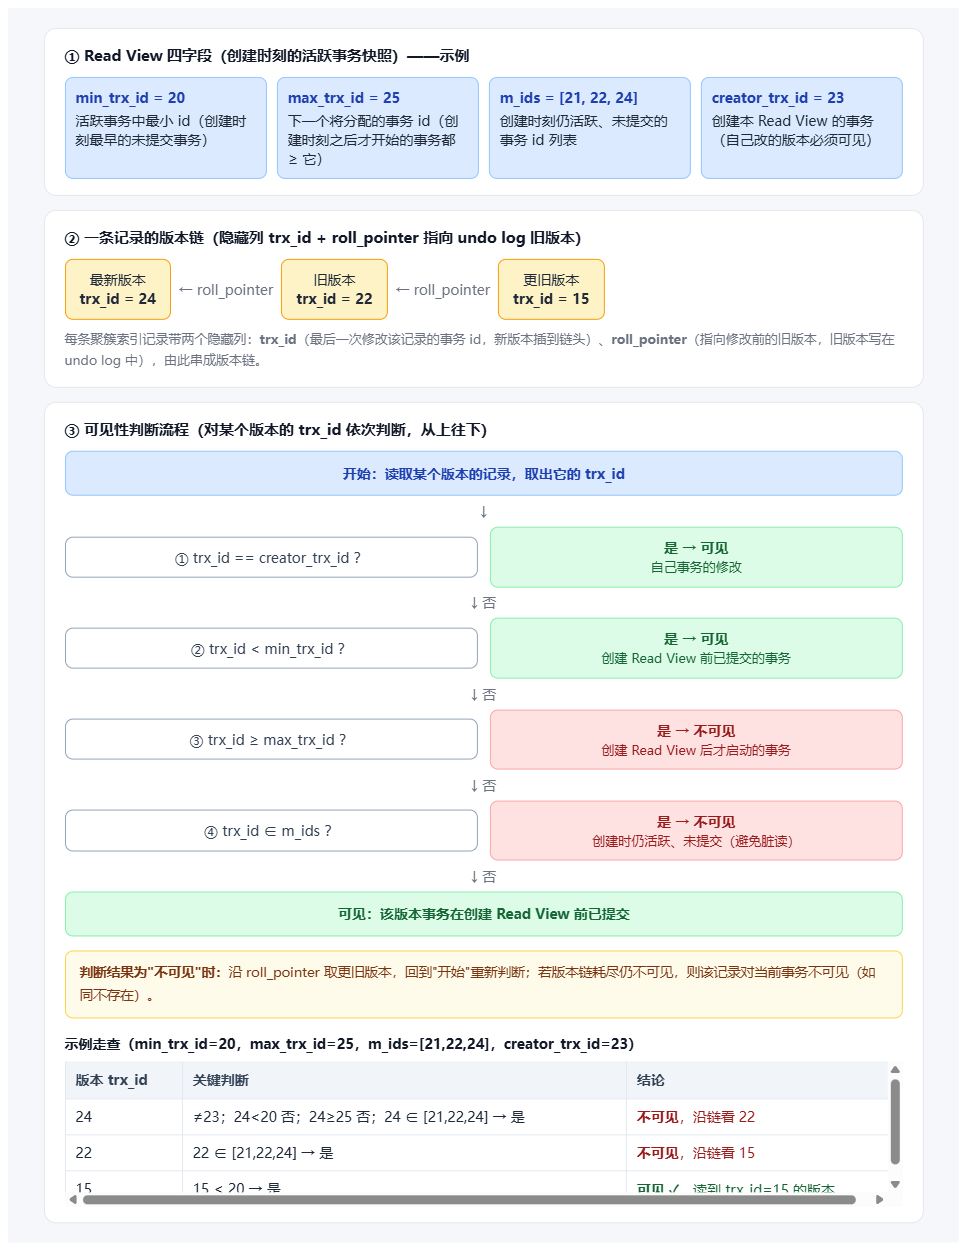
读已提交是怎么实现的
使⽤ MVCC(多版本并法控制) 实现的
读操作:在MVCC中,读已提交只能看到已提交事务的版本。
写操作: 写操作创建⼀个新的数据版本,⽽不是直接修改原始数据。这确保了正在进⾏的事务不会看到未提交事务的更改。