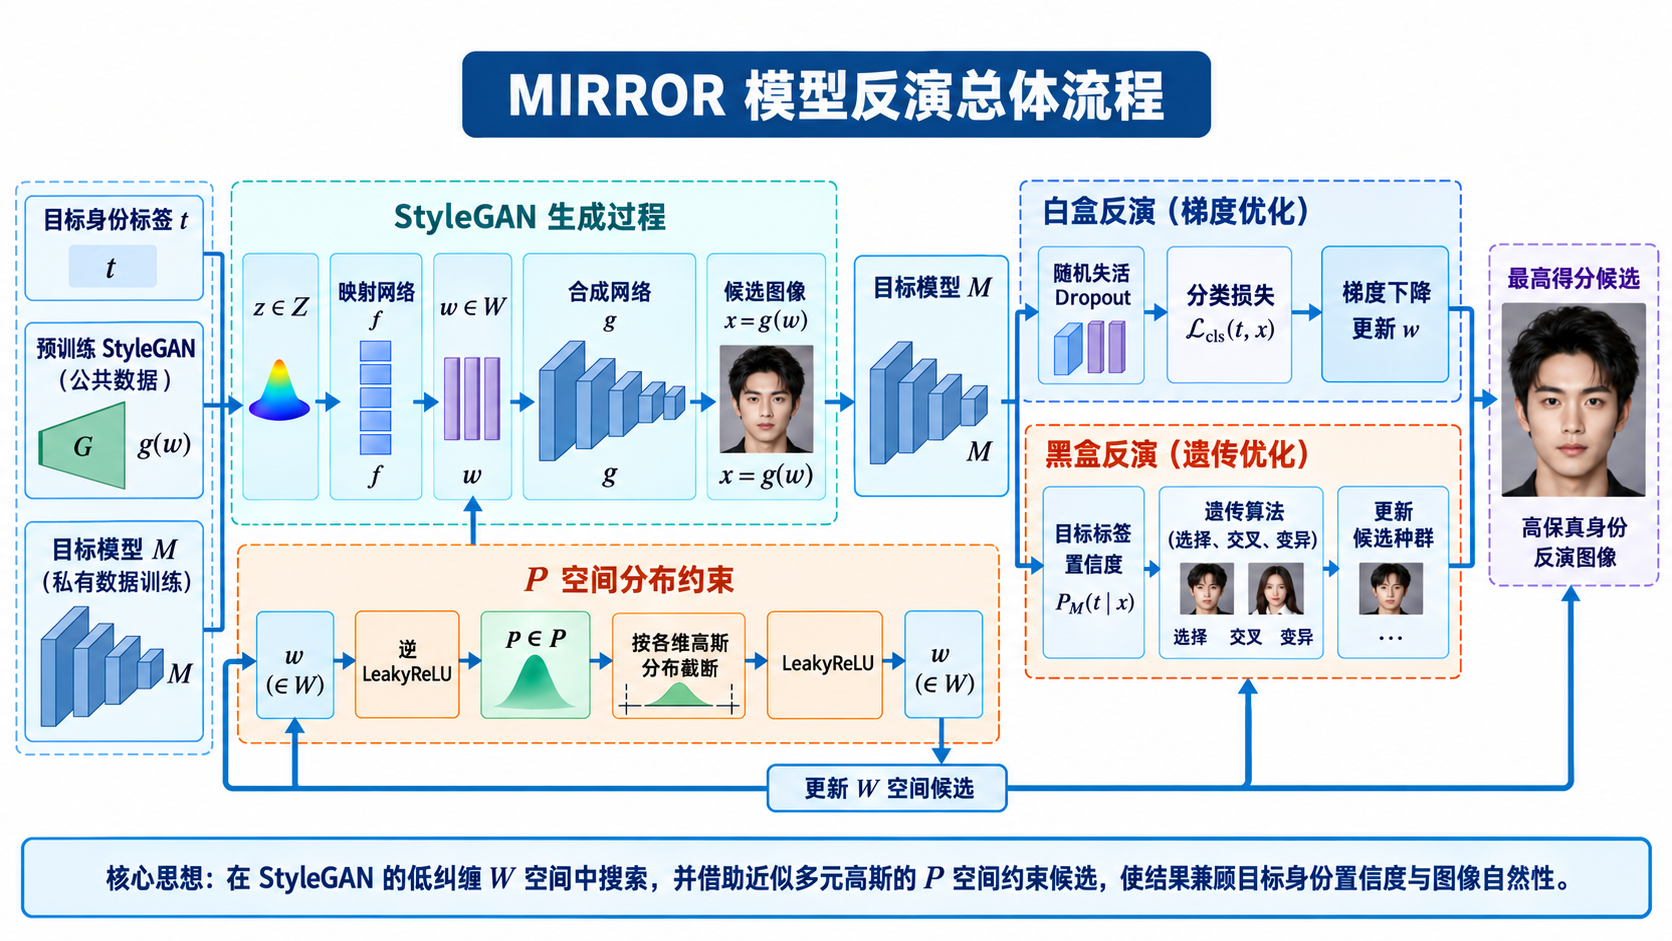
摘要 模型反演对给定模型的输入样本进行逆向工程,因此对信息机密性构成严重威胁。我们提出了一种基于 StyleGAN 的新颖反演技术,其生成器具有特殊的架构,可以强制将输入分解为各种粒度的样式,以便模型可以在训练中单独学习它们。在样本生成期间,生成器将潜变量值转换为控制这些样式的参数以组成样本。在我们的反演中,给定一些要反演的目标模型的目标标签(例如,基于私人人脸的身份识别模型),我们的技术利用在同一领域的公共数据(例如,公共人脸数据集)上训练的 StyleGAN,使用梯度下降或遗传搜索算法,以及基于分布的裁剪,来找到样式的正确参数化,以便生成的样本正确分类到目标标签(通过目标模型)并被人类识别。结果表明,我们的反演样本具有高保真度,比现有最先进技术的样本要好得多。
一 简介
给定深度学习 (DL) 模型,模型反演旨在为感兴趣的标签生成样本。它通常假设了解目标模型的应用领域,例如人脸识别,但没有单个标签的信息或没有训练样本的可用性。白盒模型反演假设模型内部结构(例如梯度)是可访问的,而黑盒反演则认为目标模型是黑盒,例如当它作为服务在线托管时。模型反演可能会泄露目标模型和标签的关键信息,造成严重的隐私泄露。例如,如果攻击者成功反演访问控制中使用的人脸识别模型,他就可以将自己伪装成反演的人,从而造成毁灭性的安全漏洞。
虽然通用机器学习模型的模型反演有着悠久的历史23、22、61、28、73、69,但由于这些模型在安全关键任务中的应用迅速增长,深度学习模型反演显得尤为重要。早期的模型反演工作(例如22)直接利用梯度反向传播来变异随机输入,以便目标模型将变异输入分类为
2022 年网络与分布式系统安全 (NDSS) 研讨会 2022 年 4 月 24-28 日,美国加利福尼亚州圣地亚哥 ISBN 1-891562-74-6 https://dx.doi.org/10.14722/ndss.2022.24335 www.ndss-symposium.org
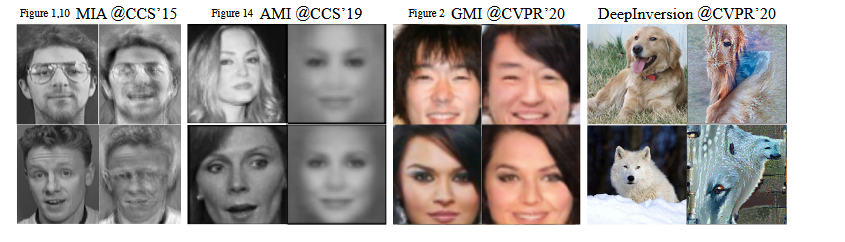
图 1:来自原始论文或官方 GitHub 存储库的现有方法的反演结果。在每一组中,左边的图像是目标人物,右边的图像是反演图像。
目标标签。图 1 中最左边的一组显示了原始论文 22 中没有隐藏层的神经网络的两个样本反演结果。从那时起,人们提出了许多不同的方法。两种最先进的白盒方法是 DeepInversion 69 和 GMI 73。前者基于这样的观察:许多模型都具有批量归一化 (BN) 层,用于记录内部特征图(对于训练数据集)的均值和方差,这些层用于归一化激活值,以获得更好的训练/分类性能。 DeepInversion 强制变异输入遵循所有 BN 层中记录的分布。这在反演期间提供了强有力的调节。图 1 中最右边的一组显示了来自其官方 GitHub 存储库的两个反演样本,用于在 ImageNet 上训练的 ResNet50v1.5 模型 46。观察到样本具有许多目标标签的高保真细节。相比之下,GMI 利用 GAN 来反演模型。它不是改变输入,而是改变输入到 GAN 生成器以生成样本的潜变量值。梯度从目标模型反向传播到生成的输入(通过 GAN),并进一步传播到潜变量值。由于 GAN 可以确保生成样本的自然性,因此 GMI 可以产生高质量的反演结果,如图 1 中的第三组所示,该图显示了原始论文中的反演样本。 AMI 65 是最先进的黑盒方法。它利用辅助数据集来学习生成器,该生成器可以根据目标模型的预测分数生成样本。图 1 中的第二组显示了原始论文中的两个示例。观察到,由于其黑盒性质,反演质量略有下降。相关工作的更多讨论可以在第六节中找到。
尽管现有技术已经取得了长足的进步,但仍有很大的改进空间。具体来说,从图 1 中的示例中,我们可以观察到,虽然 DeepInversion 可以具有高保真度特征,但这些特征的位置往往不正确。
这是因为虽然 BN 层记录了各个特征图的统计数据,但它们没有提供足够的跨特征约束,例如它们的相对位置。另外,有些细节可能不太现实,因为它不像GAN那样,经过训练可以捕捉各方面特征的自然分布。 GMI显示出巨大的潜力。但它仅支持低分辨率反演。根据我们的经验,当分辨率变高时,潜在空间过于稀疏,导致空间中的直接优化变得缺乏约束。此外,已知常规 GAN 的潜在空间具有大量纠缠34,这意味着特征不具有局部性。因此,优化很难找到一个好的最优解。在第三节中,我们将详细讨论最先进解决方案的局限性。
我们提出了一种新的基于 GAN 的反演技术。我们观察到使用 GAN 进行模型反演存在许多突出的挑战。我们发现潜在空间中的纠缠使其不是优化的理想空间,特别是当空间稀疏时。使用 GAN 的判别器来确保反演结果的自然性的合理想法是有问题的,因为判别器与相应的生成器紧密耦合,不能作为自然度的通用分类器。因此,我们建议使用 StyleGAN 生成器,它根据潜变量值生成真实样本,控制一组分解良好的特征/样式的参数化重组。通过 StyleGAN 的结构在训练中强制执行分解(以实现生成中的重新组合)。在反演过程中,给定目标模型(例如,基于私有人脸的身份识别系统)和在目标模型领域的公共数据(例如,公开人脸数据集)上预训练的 StyleGAN,可以使用梯度反向传播或遗传算法来搜索 StyleGAN 生成器的最佳参数化,从而生成样本,从而使目标模型和人类都将其识别为目标标签。为了提高图像质量,我们进一步建议在 StyleGAN 中遵循多元高斯(MVG)分布的辅助空间中调节优化/搜索。为了提高保真度(即反演图像应该类似于目标标签),我们利用随机丢弃(dropout)来减轻目标模型中常见的特征过度拟合。
我们的贡献总结如下。
• 我们研究基于GAN 的模型反演的挑战。
• 我们建议使用StyleGAN 进行模型反演。我们的反演方法在辅助空间中进行了额外的调节,并支持白盒和黑盒设置。在黑盒设置中,我们不使用梯度,而是使用遗传算法来搜索最优解。
• 我们开发了一种新颖的随机丢弃(dropout)方法,以减轻目标模型中可能降低反演保真度的特征过拟合。
• 我们探索了基于 GAN 和基于 StyleGAN 的反演的大设计空间,并报告了我们的发现。
• 我们在PyTorch 中构建了一个原型MIRROR(深度学习网络模型反演)。我们的评价
在 6 个模型和 3 个广泛使用的人脸数据集上的结果表明,我们的方法可以高保真度地反演模型,生成与目标标签非常相似的样本。我们的用户研究表明,平均 88.4% 的用户更喜欢我们的反演结果,而不是现有技术的反演结果。当将一个人的反演图像与一组与该人非常相似的图像混合时,89.29%的用户可以从其他图像中正确选择反演图像。我们的定量分析表明,与现有最先进的方法相比,反演样本的泛化性平均提高了 15 倍,这意味着与目标模型不同的其他模型的分类精度(目标标签)提高了 15 倍。我们还在两项商业服务上测试了我们的黑盒方法:Azure 人脸识别服务 1 和 Clarifai 2。我们的方法实现了 100% 的有效性(即,反演样本被目标模型 100% 分类到目标标签)和 50%+ 的泛化性(另一个模型为 50%+),而最先进的黑盒方法的有效性和泛化性接近于 0。此外,MIRROR 在许多图像质量指标上都优于现有方法。除了人脸识别模型之外,我们还证明 MIRROR 可以在其他数据集(例如汽车和猫)和模型上产生高质量的反演结果。我们的方法可以成功地攻击使用多种现有防御方法训练的模型,包括针对对抗性样本的对抗性训练、针对模型反演的信息正则化以及针对成员推理的差分隐私。 MIRROR 将在我们的项目页面 7 上发布后开源。
威胁模型。我们的威胁模型与现有工作73、65、69中的一致。我们假设攻击者知道目标模型的应用领域,并且该领域有可用的公共数据。请注意,公共数据可能与用于训练目标模型的私有数据完全不重叠。这个假设是合理的,因为深度学习模型的实际应用很可能植根于物理世界的数据。因此,攻击者可以从物理世界中进行采样来支持他们的 StyleGAN 训练。在白盒设置中,我们假设攻击者可以访问模型内部。但他们没有其他信息,例如标签特定信息或特定训练数据。在黑盒设置中,他们无权访问模型。目标模型通常在没有特定强化的情况下进行训练(例如,为了防止反演)。尽管我们证明 MIRROR 对现有的防御方法具有一定抵抗能力,但如何更好地防御模型反演将是我们未来的工作。
二 背景 STYLEGANS
StyleGAN最初在34中提出,后来在35中进行了改进。传统 GAN 中的生成器直接将潜变量向量映射到样本,而 StyleGAN 中的生成器首先将初始潜变量向量映射到中间潜变量向量,该中间潜变量向量进一步(通过简单函数)转换为不同粒度的样式。这些样式将由卷积层的恒定输入(例如,平均脸部)表示的平均样本塑造为特定样本(例如,具有个性化特征的人脸)。
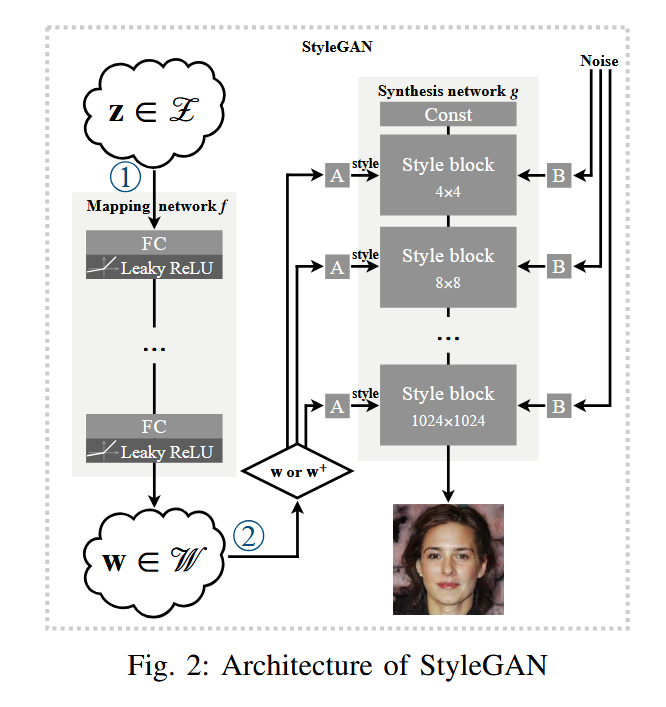
图2:StyleGAN的架构
图 3:(a) 中的真实世界特征空间和 (b)-(d) 中的不同 GAN/StyleGAN 空间。它们具有不同程度的纠缠和不同的分布。
个性化功能)。众所周知,中间潜在空间的纠缠程度较低34,35。
图 2 显示了 StyleGAN 生成器的架构。它的两个主要组成部分是映射网络 f(左侧)和合成网络 g(右侧)。网络 f 由多个具有泄漏 ReLU 激活函数的全连接层组成; g 由具有不同分辨率比例(例如,4 × 4 到 1024 × 1024)的多个样式块组成。每个样式块都有两个卷积层,就像典型的 CNN 中的那样。不同之处在于,每个块中特征图的样式是受控制的(由方格 A 的输入控制),并且值受到随机噪声的扰动(来自方格 B 的输入)。在文献中,特征图的均值和方差被认为可以对风格进行编码30。因此,样式应用是通过改变特征图的均值和方差来实现的。
具体来说,在步骤 1 中,从 Z 空间(例如高斯分布)采样潜变量向量 z 并将其提供给映射网络 f。函数 f(z) 产生一个中间潜变量向量 w(所有 w 形成 W 空间)。在步骤2中,w被复制并发送到g中的每个样式块以合成样本。每个样式块处的正方形 A 表示将 w 转换为样式的线性层,而正方形 B 则调整随机噪声的强度。形式上,基于样式的生成器返回图像 x = g(f(z))。在训练期间,f、g、A 和 B 中的参数会更新。
x = g(f(z))
图 3 (a)-(c) 通过显示共享相似特征(例如,面部)的样本分布,说明了传统 GAN 和 StyleGAN 之间的概念差异
共享相似的鼻子形状)在不同的设计中。每种颜色代表一种特征。具有特定颜色的像素表示具有特定特征的样本。在(a)中,具有相似特征的自然样本彼此接近。然而,在(b)中,即经典 GAN 中的 Z 空间,它们分布在许多小的局部区域中。换句话说,特征是纠缠在一起的。在 StyleGAN 中,经过 f 变换后,特征在中间 W 空间中很大程度上解开,如 (c) 所示。这种解开是通过 StyleGAN 的特殊架构在训练过程中实现的。特别是,A 块是线性函数,其输出直接控制特征图的均值和方差。不同分辨率的样式块的分离在结构上将样本分解为样式,其本质上是不同复杂程度的特征。如果网络在训练中收敛,则 w 值必须以其线性投影(通过 A 块)控制各种特征的参数化的方式解开。更多详细信息请参阅原始论文34、35。
三 动机
本节展示并分析了现有最先进反演方法的局限性,从而激发了我们的工作。我们将利用图 4 中的示例结果来提供不同方法的直观比较,并证明我们的方法优于现有方法。图中的每一行都展示了一个人通过不同方法反演的结果。每个反演图像都标注有模型对目标人物的分类置信度。提供每个目标人的两张真实图像作为用于比较的基本事实。为了简洁起见,我们使用 M 和 t 分别表示模型和要反演的目标标签。给定 M 和 t,模型反演的目标是生成图像 x,以便人类或机器将 x 视为 t 的图像。
A 现有的白盒反演方法
目前最先进的两种白盒方法是 DeepInversion 69 和 GMI 73。
DeepInversion。DeepInversion 利用损失来约束批量归一化 (BN) 层中的内部特征。在训练过程中,前面层的参数不断更新,因此后续层的输入分布不断变化。 BN 层被提出来解决这种所谓的"内部协变量偏移",以加速训练 31。 BN 层维护在训练数据批次上观察到的运行均值和方差。它将前一层的输出分布进行归一化,得到均值为0、方差为1的内部分布,从而使后一层的输入分布更加稳定。如果我们向网络提供一批真实的输入数据,内部特征的统计数据应该与存储在 BN 层中的统计数据类似。这些均值和方差用于正则化反演输入的特征分布,使其接近真实输入的分布。具体来说,除了强制将反演图像正确分类为目标标签的交叉熵 (CE) 损失之外,内部约束还最小化了由一批要优化的输入计算出的方差(分别为均值)和运行方差(分别为均值)之间的 2 距离。
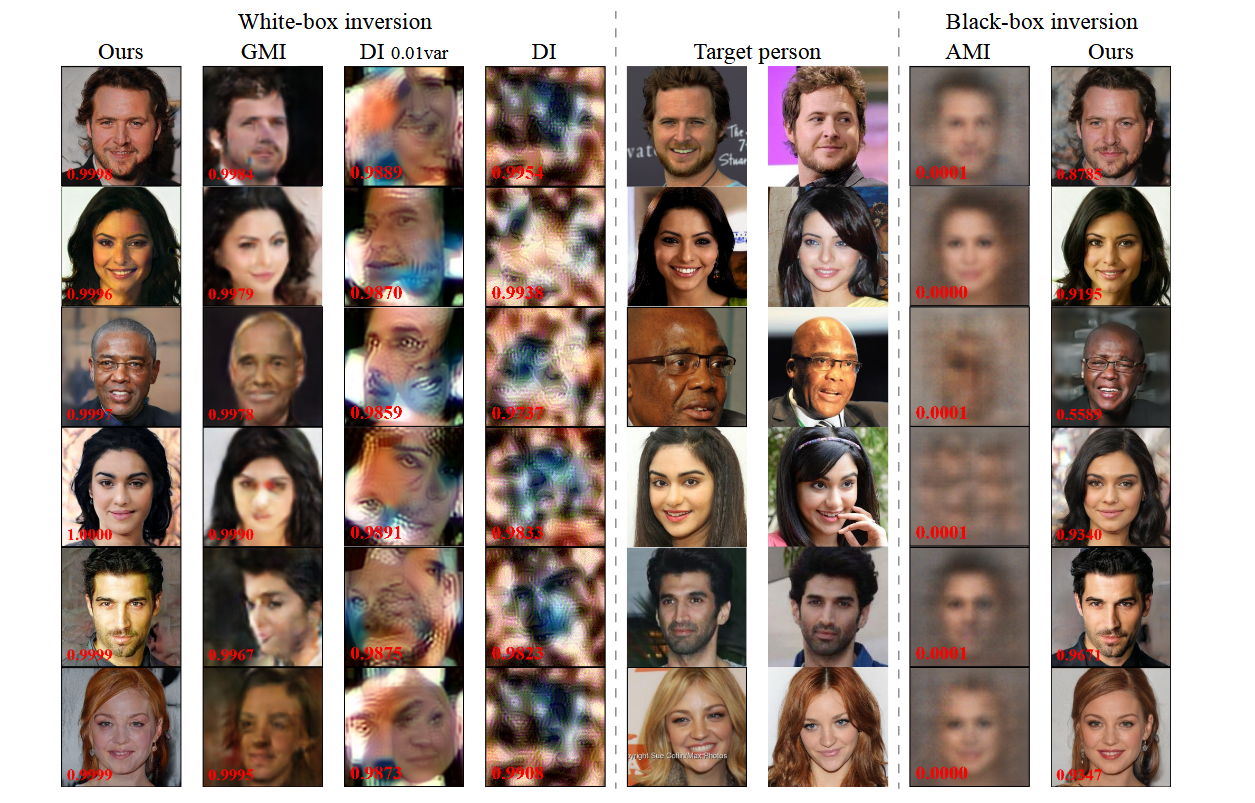
图 4:在白盒和黑盒设置下与现有最先进方法的比较。每一行对应一个人。第一行和第二行的目标人存在于反演方法的训练数据中,而其他人则不存在。第一到第四列显示了我们的方法、现有 GMI 和 DeepInversion 的白盒反演结果。第五列和第六列显示每个目标人的两张真实图像。第七和第八列显示了现有 AMI 和我们的方法的黑盒反演结果。每个反演图像中的数字表示分类置信度。
运行均值)存储在每个 BN 层中。DeepInversion 的优化目标如下。
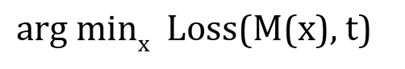
DeepInversion 不能直接应用于没有 BN 层的模型(例如 VGG16 和 SphereFace)。反演图像通常不如 GMI 和 MIRROR 等基于生成器的方法那么自然,如图 4 所示。第四列显示 DeepInversion 使用默认参数反演的图像。它们看起来像随机噪音。调整参数后,我们可以通过将 将方差和均值的 L₂ 距离项权重设为 0.01来获得最佳结果,相应的结果显示在第三列中。虽然有些五官可以反演,但也有多个重叠的脸和错位的眼睛。这样的结果与 DeepInversion 最初为 ImageNet 上预训练的 ResNet50v1.5 生成的结果一致,如图 1 所示。这种现象并不超出预期。模型通常被训练来学习特征和输出之间的相关性,并且可能不会学习特征之间的相对约束(例如,它们的相对位置)。因此,归一化统计的使用允许反演各个自然特征,但不足以限制它们的组成。这足以满足 DeepInversion 的最初目标,即数据增强,但不足以反演人类可识别的面孔。我们已经探索了许多增强 DeepInversion 的方法,通过添加更多约束来强制反演人脸的各种属性,例如在面部的正确位置恰好有两只眼睛和一个鼻子。然而,这些结果(在我们的在线附录 XI 7 中)仍然无法与基于生成器的结果进行比较。
GMI。 GAN 能够生成分布输入。例如,在人脸数据集上训练的 GAN 能够生成自然的人脸。因此,除了目标模型之外,一个想法是使用预训练的 GAN 来调节反演结果。 GAN包含一对生成网络G和判别网络D。G和D以替代和竞争的方式进行训练。 D 的目标是将 G 生成的假图像与真实图像区分开来。 G 的目标是从预先定义的潜在空间生成图像来欺骗 D。收敛后,G 通常能够生成分布随机输入(例如,随机人脸)。与直接优化输入图像的 DeepInversion 不同,GMI 优化潜变量向量 z 来生成图像 G(z),以便 M 将 G(z) 分类为标签 t,D 将其视为真实图像。也就是说,GMI 的优化目标如下。潜在空间的维度比图像空间少(例如,100 vs. 3 × 64 × 64)。从图 4 中观察,GMI 反演的人脸比 DeepInversion 反演的人脸更容易被人类识别,并且其中一些人脸确实具有目标人的特征。然而,传统的 GAN 架构也导致 GMI 存在两个局限性:1)反演图像的分辨率较低(64 × 64),因此面部特征过于模糊,无法泄露所需的信息(对于攻击者); 2)潜在空间是纠缠的34,这意味着特征在空间中不具有局部性,使得对空间的探索很可能陷入许多局部最优,导致生成与目标人物不相似的低质量图像,如图 4 和图 13 所示。
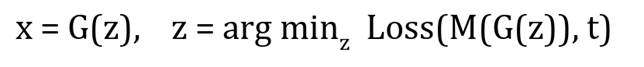
解决第一个问题的一种思路是采用更强大的 GAN,例如 PGGAN(输出分辨率为 3 × 1024 × 1024)32。然而,如图13和图26(在线附录7中)所示,在不解决第二个问题的情况下,高分辨率反演图像仍然不自然,与目标人物不同。
B 现有的黑盒反演方法
现有最先进的黑盒反演方法是 AMI 65,它基于生成网络。为了反演标签 t,AMI 将一个 one-hot 向量(即第 t 个元素除 1 之外全为 0 的向量)提供给生成模型。与 GMI 中学习从潜变量值到图像的映射的生成模型不同,这里它学习从预测分数到辅助数据集的训练图像的映射。通过使用训练图像查询目标模型来获取预测分数。训练目标是最小化生成图像与辅助数据集中的训练图像之间的均方误差(MSE)。图 4 中 AMI 反演图像揭示了其局限性:1)反演图像是模糊的平均人脸,并且透露的目标标签信息很少; 2)低分类置信度意味着目标模型没有将反演图像识别为目标人物; 3)很多目标标签无法反演。第一个限制是由于其生成模型的能力较低(3 × 64 × 64)和MSE损失的使用,MSE损失的重点是平滑生成图像的细节区域以实现更多像素级的正确性42。由于该技术的目的是使用从辅助数据集中学习的映射来反演未见过的数据集中的标签,因此模型学习可分解和泛化的人脸特征至关重要。然而,辅助数据集上的简单 MSE 损失似乎并没有强制执行这一点。
C 我们的解决方案
为了克服弱生成网络和纠缠潜在空间的问题,我们建议使用 StyleGAN (3 × 1024 × 1024) 34, 35。 StyleGAN 具有特殊的架构,可以大大减轻纠缠并将特征分解为可以单独控制以生成不同输出的样式。要利用 StyleGAN 进行反演,一个简单的想法是在(解纠缠的)W 空间中进行优化,以生成分类到目标标签的自然输入,并避免在纠缠的 Z 空间中进行优化。然而,尽管 W 空间纠缠度较低,但其分布很难建模,如图 3 (c) 中空间的不规则形状所示。因此,很难防止优化超出分布范围,从而导致不良的反演结果。因此,我们建议在非常接近 W 但具有多元高斯分布的内部空间进行调节。因此,一方面,我们可以受益于W空间控制特征/风格的能力;另一方面,我们可以轻松确保此类控制在分布范围内。在黑盒设置中,我们应用搜索算法(例如遗传算法)来探索具有类似正则化的 W 空间。直接使用 StyleGAN 有时会生成与目标标签不相似的反演样本(例如,错误的性别),即使目标模型以高置信度将样本分类到目标标签。这通常是由于目标模型的原始训练集中的低层特征偏差导致模型
不期望地学习目标标签 t 和一些低层特征之间的强联系。因此,在反演过程中,StyleGAN 可能会生成一张拥有这些特征但与人眼中的 t 不同的脸部。为了解决这个问题,我们在反演过程中随机丢弃目标模型中的神经元。因此,随着时间的推移,类似于 t 的反演样本会脱颖而出(参见第 IV-B 和 V-C6 节)。
从图 4 可以看出,我们的方法反演的图像具有更细粒度的面部特征,并且与目标人更加相似。考虑第一排的人。观察他的独特特征包括眼睛(和眉毛)、鼻子和发型。他的笑容也很特别。我们在两种设置下的反演结果都忠实地捕获了它们。相比之下,GMI 结果抓住了眼睛形状和胡须。但其余部分则模糊且无法区分。 DeepInversion 结果抓住了鼻子,但脸部非常混乱。第二行和第四行中的女性彼此相似(通过查看真实样本)。区别在于前者的鼻子比较尖,后者的鼻子比较圆,后者有非常明显的双眼皮,而前者则没有。他们的笑纹也不同。我们的反演结果清楚地捕捉到了这些差异。相比之下,其他技术都无法披露此类细节。我们对第三排黑人男性的结果忠实地揭示了他的肤色、鼻子形状、嘴唇形状、脸颊线条、眼镜和秃发。相比之下,其他方法(即 GMI 的方法)的最佳结果缺乏很多细节。另一个观察结果是,尽管存在明显的质量差异,但大多数白盒方法的结果的目标模型产生了接近 1.0 的分类置信度。这表明交叉熵损失并不是质量的决定因素。
正如我们将在第 V-D 节中展示的,我们的技术可以高保真度地对各种数据(除了人脸之外)进行模型反演。这些结果表明,如果深度学习模型对敏感数据进行操作,隐私泄露确实是一个严重且实际的问题。 7 为感兴趣的读者提供了大量反演样本。
四 设计
图 5 展示了 MIRROR 的概述。顶部虚线框说明了 StyleGAN,它将初始潜在空间 Z(在 1 处)转换为中间空间 W(在 2 处),用于参数化样式并合成图像(在 3 处)。顶部和中间的虚线框一起说明了白盒反演。从初始 w(在 2 处)开始,StyleGAN 生成一个样本(在 3 处),该样本被馈送到目标模型以获得输出(在 4 处)。 MIRROR 在分类过程中随机丢弃目标模型中的神经元(由白色方块表示),以减轻低层特征过度拟合。然后计算分类损失并使用梯度下降方法来优化 w 以最小化损失(5)。为了确保反演图像的质量,它在步骤 6 中对 w 进行正则化,即从 W 空间绕道到 P 空间(将在第 IV-B 节中定义),然后返回到 W。
2 3 4 5 6 当反演成功或达到最大历元时终止。请注意,Z 空间和映射网络 f (at 1 ) 被排除在该过程中。
图 5 的顶部和底部框架表示黑盒反演流程。在步骤 4 处,攻击者只能访问目标标签的得分,不能访问完整输出层的值或梯度。步骤 5 使用遗传算法寻找能够提高该得分的 w。
毕业。基于优化。
图 5:我们方法的架构
A 使用 GAN 进行模型反演的观察
我们的反演方法基于 GAN。虽然使用 GAN 反演类标签的想法并不新鲜,例如 GMI 73,但我们发现如果做得不当,会产生质量较差的结果。我们探索了各种设计选择,一些结果显示在在线附录七和八中7。在本小节中,我们将讨论我们在探索中所做的一些观察。它们导致了我们的最终设计。
1 Z空间中的优化无效
GAN的一个基本假设是自然域中的样本遵循高斯分布,因此生成器本质上是从具有高斯分布的z值到自然域的映射。因此,给定一个类标签,现有基于 GAN 的反演方法遵循的一个简单想法是优化 z 向量以产生最小损失。因此,反演图像是 GAN 生成器根据 z 向量生成的图像。为了增强生成图像的自然度,它们根据 Z 空间的(高斯)分布来裁剪 z 向量。然而,我们发现 Z 空间的性质使其很难获得良好的结果。
图 6 说明了搜索 StyleGAN 34 Z 空间的示例反演过程。目标是反演在 VGGFace2 上预训练的 ResNet50 模型的标签 38。目标人物的两张图像显示在右下角。我们首先按照高斯分布随机采样 2000 个 z 向量。它们对应于 GAN 生成的一组自然图像。它们是密集区域 (B.1) 中的绿色数据点。然后,我们选择目标模型对标签 38 置信度最高的 6 张图像作为优化的起始图像。它们由独特的符号表示,如 (B) 右上角的图例所示。
对于每个起始图像,我们运行两种优化:1)将 z 裁剪为 0±1; 2)无剪辑。优化迭代中生成的每个数据点都根据策略进行着色(红色表示有剪切,灰色表示没有剪切),并具有其起源的符号。随着迭代次数的增加,颜色逐渐变浅。这样,同一符号的数据点就形成了一条优化路径。我们还显示了一组数据点的相应(面部)图像。每个图像都标有一个数字,表示第 100 步(优化中)及其符号。例如,(B.2) 处的图像表示从 (B.0) 中具有相同星号符号的初始人脸开始,经过 70000 次优化迭代后生成的人脸。由于密集区域过于拥挤,我们在左侧提供了三个放大视图。例如,(A.1) 视图显示了 5700、5800 和 20000 步后经过裁剪的反演结果。
从图 6 中,我们得到了一些观察结果。 1)通过比较(不同符号的)灰色数据点(表示没有裁剪的优化结果并且远离密集区域(B.1))与(A.1)和(A.2)中经过裁剪的红色对应数据点,我们可以看到裁剪有助于将向量限制在密集区域。具体来说,观察灰色星形符号的优化路径,即包含(B.2)的路径。当优化超出高概率密度区域时(例如,在步骤4900),图像变得混乱。 2)甚至与(A.1)和(A.2)中微红数据点相对应的受限图像也可能变得无法识别。观察 (A.3) 中的 4 个图像。它们完全落在密集区域内,但其中三个人类无法识别。换句话说,并非分布中的所有数据点都表示自然面孔。就像接近某个标签的输入的对抗性样本可以被分类为其他标签一样,GAN 的潜在空间也不是鲁棒的,即表示自然人脸的潜变量值的接近值可能不代表自然人脸。因此,Z 空间裁剪对于生成人类可识别的面部来说是一个弱约束。 GMI 使用少量优化步骤的策略来尝试缓解该问题。然而,3)少量的优化步骤不足以搜索空间,使得结果图像不会与起始图像偏离太多并且与目标人不相似。 4)表示目标标签特征的区域分散在整个Z空间中。请注意,所有优化结果(具有不同的符号)虽然分布在整个空间中,但都是针对同一个人的反演。
文献指出Z空间是高度纠缠的34。在我们的模型反演背景下,这意味着相似的特征没有局部性,并且分布在空间中众多且独立的区域中。因此,优化很难找到全局最优解。图 3 提供了概念图。 (a) 中的圆圈表示高斯分布的自然域。每种颜色代表一种特征。观察它们有局部性。颜色之间的过渡是平滑的,表示样本具有多种特征的组合。换句话说,自然相似的样本彼此接近。相比之下,图 (b) 表示标准 GAN 的 Z 空间。请注意,颜色不存在局部性。相反,它们分散在许多小区域。虽然这种纠缠空间不会影响生成,但它确实使反演变得极具挑战性。
(A) 密集区域的放大视图 (B.1)。
和剪裁。
(A.3) 四次裁剪优化结束时第 20000 次迭代的数据点(和相应的面)。
(B) PCA 的二维数据点。
(B.0) 与初始数据点相对应的面。
(B.1) 密集区域(多元高斯分布的密集区域中的值)。
(B.2) 没有裁剪的数据点。
图 6:Z 空间中的模型反演。我们使用 2 种不同的策略(即有剪裁和没有剪裁)来反演目标人物的图像(如右下角所示),从表示 6 个随机面孔的 6 个随机 z 值开始。优化在每次迭代时得出一个 z 值。我们将这些值简化为二维数据点后将其呈现在 B 中。如右上角的阴影图例所示,来自不同起点的数据点用六个唯一的符号表示。两种优化策略生成的数据点分别具有红色和灰色,不同的色标表示优化迭代。因此,所有从相同初始值开始的数据点在空间中形成一条具有相同颜色逐渐变浅的符号的优化路径。我们还显示选定数据点子集的相应面。每个图像都标有表示第 100 次迭代的数字(例如,70 表示第 7000 次迭代)和表示初始数据点的符号。密集区域 B.1 放大到左侧的 A.1、A.2 和 A.3,以获得更好的可视性。
2 预训练的判别器无法保证自然性
在 GAN 的训练过程中,判别网络 D 与生成网络 G 竞争。优化目标是找到两方极小极大博弈的固定点:
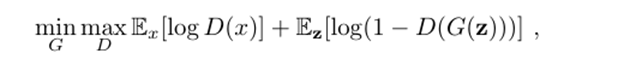
其中 x 是从真实图像中采样的,z 是从潜在空间(例如高斯分布)中采样的。
训练完一对 G 和 D 后,确保生成高质量人脸的一个合理想法是使用 D,就像许多基于 GAN 的反演方法(例如 GMI)一样。特别是,反演图像和一组随机自然图像被馈送到 D 以计算判别器损失 log(1−D(G(z))),该损失用于衡量两组样本之间的差异。然而,根据我们的研究,它并不有效。图 4 中的 GMI 结果质量不是特别好。另外,去掉GMI中的判别器损失或者增大其权重对结果影响不大(网上附录八7)。这些表明预训练的判别器尽管在概念上可行,但很难确保反演过程中的质量。
我们进行了一个实验来进一步研究其根本原因。图 7 显示了一组具有不同质量级别(在人眼中)的图像,按分辨率升序排列。
图 7:各种质量图像的判别损失。通常认为较低的判别器损失与更自然的图像有关。然而,事实并非如此。
基于预训练 StyleGAN 中判别器的判别器损失。每张图像中的数字显示其判别器损失,文本表示其来源。 CelebA 表示 StyleGAN 的训练数据。 VGGFACE 表示 VGGFACE 数据集。用 GMI/AMI/Ours 注释的图像由 GMI/AMI/Ours 反演。人们通常认为判别器损失较低的图像更真实。然而,情况并非如图所示。例如,AMI 和 GMI 反演的模糊图像比 CelebA 数据的判别损失要小得多。我们推测,虽然概念上D是区分分布内(自然)和分布外(非自然)样本,但它实际上是在区分两组样本。
图 8:W 空间中的模型反演。 w 向量通过主成分分析 (PCA) 简化为二维,并在图中表示为数据点。反演从由 8 个不同符号表示的 8 个初始值开始,如 A.2 所示。绿色数据点表示通过在 Z 空间中采样获得的 2,000 w 个潜变量向量。我们使用红色表示没有裁剪的优化,使用蓝色表示简单裁剪,根据 w 的范围分布来裁剪 w 的尺寸(参见 A.3)。显示与最后 20000 次迭代时的潜变量向量相对应的图像。每个图像中的数字和符号分别表示(优化)的第一百步及其起源。优化目标和起点与图6相同,但这里我们使用W空间。具有不同比例的蓝色/红色的路径表示优化路径。
其中一组来自生成器,另一组来自自然数据域。接近训练结束时,G 已经学会生成高度真实的样本,使得 D 倾向于学习 G 的输出和自然样本之间的低层特征差异。也就是说,它正在细化细节。因此,如果样本是自然的,则 D 不能很好地做出高层决策。我们还尝试使用来自半途训练的 GAN 的 D。结果并没有更好。我们推测标准 GAN 训练的设计只会产生可以改进相应 G 的 D。一般来说,这些 D 并不是自然性的分类器。
这两个观察结果表明 GAN 在模型反演中的简单应用无效,并激发了我们的设计。
B MIRROR 中的白盒反演
W 空间已解耦但不服从正态分布。由于 W 空间已解耦,所以一个直接的方法是直接优化w来反演标签。然而,我们发现如此简单的设计几乎行不通。图8展示了W空间以及空间中目标人物的反演过程。绿色样本的 V 形(即,由 Z 空间中 2,000 个高斯样本映射得到的 w 值)表明这些样本不遵循 W 中的高斯分布。因此,虽然优化能够探索局部区域(由于解耦),但生成的样本(在 20000 个步骤之后)的质量大幅下降,因为它们偏离数据分布。由于同样的原因,基于范围的剪裁也不起作用,因为当基础分布不是各向同性高斯分布时,此类剪裁可能会引入很大的偏差16。更多结果可以在在线附录 X 7 的图 31 中找到。
多元高斯 P 空间中的裁剪正则化。 W 不服从高斯分布。 w 向量的各个维度也不是。图 5 左上数第三个分布显示了典型的分布
图 9:直方图和 Q-Q 图。
w 维度。不规则的分布是由于 ReLU 操作的泄漏造成的63。相反,leaky ReLU 之前的各个维度的值遵循高斯分布。它称为 P 空间,具有多元高斯分布。图 9 显示了 StyleGAN 映射网络最后两个 LeakyReLU 层之前/之后空间的随机维度的直方图和分位数-分位数 (Q-Q) 图 45。 Q-Q 图通过绘制分位数来比较两个分布。如果绘制的点大致沿着 45 度参考线落下,则两个分布相似。在这里,我们将所选维度的分布与高斯分布及其计算的平均值和标准差进行比较。我们可以看到 LeakyReLU 之前的空间是高斯分布的(直方图呈钟形,点与参考线对齐良好),而 Leaky ReLU 之后的空间则不是。我们使用 P 表示最后一个 LeakyReLU 之前的空间。我们对 P 中的潜变量向量 w 进行正则化,因为它最接近 W 空间,并且是满足高斯分布的最深空间。 StyleGAN 论文声称更深的映射网络表现更好并且具有更解耦的空间 34。请注意,虽然 P 空间之前的 LeakyReLU 的输出不是高斯分布,但它和 P 空间之间有一个全连接层
算法 1 白盒反演
| 行 | 伪代码 |
|---|---|
| 1 | 函数 INVERSION(model M, target t, epoch e, learning rate η) |
| 2 | w₁ = INITWSPACE(M, t) |
| 3 | w_best, ℓ_best = w₁, ∞ |
| 4 | for i ∈ {1, ..., e} do |
| 5 | imgᵢ = SYNTHESIZE(wᵢ) ▷ 即 g(wᵢ) |
| 6 | ℓᵢ = LOSS(M(imgᵢ), t) ▷ 例如交叉熵损失 |
| 7 | if ℓᵢ < ℓ_best then |
| 8 | w_best, ℓ_best = wᵢ, ℓᵢ |
| 9 | end if |
| 10 | wᵢ₊₁ = wᵢ − η∇wℓᵢ |
| 11 | pᵢ₊₁ = TOPSPACE(wᵢ₊₁) |
| 12 | pᵢ₊₁ = CLIPPSPACE(pᵢ₊₁) |
| 13 | wᵢ₊₁ = TOWSPACE(pᵢ₊₁) |
| 14 | end for |
| 15 | return SYNTHESIZE(w_best) |
| 16 | 结束函数 |
1: 函数 IVERSION(model M, target t, epoch e, lr ⌘) 2: w1 = INITWSPACE(M, t) 3: wbest, `best = w1, 1 4: for i 2 {1, .。。 , e} 执行 5: imgi = SYNTHESIZE(wi)。即 g(wi) 6: `i = LOSS(M(imgi), t)。例如,CE 损失 7: if `i < `best then 8: wbest, `best = wi, `i 9: end if 10: wi+1 = wi −⌘rw`i 11: pi+1 = TOPSPACE(wi+1) 12: pi+1 = CLIPPSPACE(pi+1) 13: wi+1 = TOWSPACE(pi+1) 14: 结束15:返回 SYNTHESIZE(wbest)。即 g(wi) 16:结束函数
全连接层的输出可以被视为每个输入维度的加权平均值。根据中心极限定理14,它趋于正态分布。在文献中,由于中心极限定理,在 ResNet152 64 中观察到 ReLU 层之前输出的类似高斯分布,而其他人也观察到网络权重的高斯分布 21、57。
因此,我们确保分布内优化如下。我们从 Z 空间获取大量高斯样本,并将它们输入到映射网络 f 中,并在 P 空间中收集它们的激活值。根据这些激活值,我们建立了各个 p 维度的高斯分布。下面的等式表示将 p 转换为相应的 w 及其反函数的泄漏 ReLU 操作。
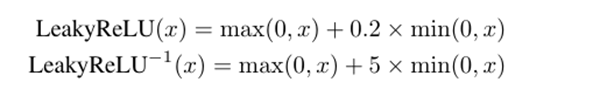
直观上,如果它是正数,它会保留该值,否则将其乘以一个小的权重 0.2。在反方向上,如果该值是正数,则保留该值,否则将其乘以权重值 5,即 1/0.2。给定通过优化更新的 w,我们通过首先将其投影到 P 空间(使用逆泄漏 ReLU 函数),根据分析的 P 空间分布剪裁其各个维度,然后将其投影回 W 空间(使用泄漏 ReLU)来对其进行正则化。形式上,令 wi 和 pi 表示 w 和 p 的第 i 维,后者的分布为 N(μ, σ)。
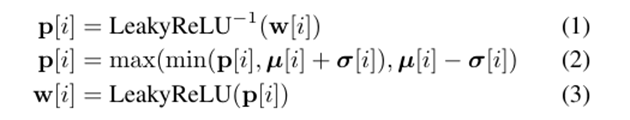
算法。整个反演过程是本节开头描述的过程。它由算法 1 正式描述。第 2 行首先通过调用函数 INITWSPACE() 从预先生成的样本中选择具有最高目标置信度的样本来初始化 w1,以计算 P 空间统计数据。为了简单起见,省略了该函数的定义。第 4-14 行执行了 e 次反演循环。在每次迭代 i 中,第 5 行调用 SYNTHESIZE(),使用 wi 的 g 函数生成候选图像 imgi
图 10:dropout 和一致选择策略的影响。第一列显示每个目标人的两张图像。奇数/偶数行显示没有/有随机丢弃策略的反演结果。通过我们一致的选择策略选择的最终图像以绿色方块突出显示。数字表示目标置信度。
生成器(图 5 中的步骤 2)。第 6 行将图像输入目标模型并根据目标标签计算损失(步骤 3 4 )。第7行记录损失最小的结果。第 10 行由梯度下降引导更新 w(步骤
第 11-13 行分别用等式 (1)、(2)、(3) 中定义的 TOPSPACE、CLIPPSPACE、TOWSPACE 正则化 w(步骤 6)。第 15 行生成具有最佳 w 的图像。
随机丢弃以减轻特征过度拟合。我们发现使用上述反演算法有时可能会生成与目标标签有很大不同的样本(例如,错误的性别)。这些样本看起来很自然,并由目标模型分类到目标标签。我们推测目标模型在某些低层特征上过度拟合,从而导致优化陷入某些局部最优。我们建议在反演过程中使用随机丢弃(dropout)来减轻过度拟合的影响。这个想法是,如果表示那些不期望的强神经元(对于目标标签)的神经元被丢弃,即它们的激活设置为 0,则优化可以逃离局部最优。具体来说,在每次迭代中,MIRROR 随机选择 M 层,并为每个层附加一个 dropout 层,该层随机将层中的神经元子集设置为 0。图 10 显示了随机丢弃(dropout) 之前和之后的一些样本。奇数行是没有 dropout 的目标人的反演样本,而偶数行则显示有 dropout 的目标人。例如,如果没有 dropout,第一人称的反演样本的性别都是错误的,并且与目标人不相似。通过 dropout,MIRROR 可以生成更准确的反演结果。
虽然 dropout 可以生成更准确的反演结果,但它不能排除错误的结果。例如,图10的第二行中仍然有一些女性反演图像。由于MIRROR没有任何目标标签的先验知识,因此它需要确定哪个图像更有可能是目标人。我们观察到,与正确的图像相比,与局部最优相对应的图像(即错误的反演图像)具有更多样化的前 5 个标签。请注意,正确和错误的结果通常具有相同的(高)top-1 置信度。因此,我们建议通过识别具有一致的前 5 个标签的最大子集来选择结果图像。
算法 2 黑盒遗传反演
| 行 | 伪代码 |
|---|---|
| 1 | 函数 GENINV(model M, target t, size n, epoch e, confidence c) |
| 2 | generation₁ = INITGENERATION(n) |
| 3 | for i ∈ {1, ..., e} do |
| 4 | scoresᵢ = COMPUTESCORE(M, generationᵢ) |
| 5 | eliteᵢ = FINDELITE(generationᵢ, scoresᵢ) |
| 6 | if scoresᵢeliteᵢ ≥ c then |
| 7 | return eliteᵢ |
| 8 | end if |
| 9 | generationᵢ₊₁ = {eliteᵢ} |
| 10 | for j ∈ {1, ..., n − 1} do |
| 11 | parent₁ = SAMPLE(generationᵢ, scoresᵢ) |
| 12 | parent₂ = SAMPLE(generationᵢ, scoresᵢ) |
| 13 | childⱼ = CROSSOVER(parent₁, parent₂) |
| 14 | childⱼ = MUTATE(childⱼ) |
| 15 | pⱼ = TOPSPACE(childⱼ) |
| 16 | pⱼ = CLIPPSPACE(pⱼ) |
| 17 | childⱼ = TOWSPACE(pⱼ) |
| 18 | generationᵢ₊₁ = generationᵢ₊₁ ∪ {childⱼ} |
| 19 | end for |
| 20 | end for |
| 21 | return FINDELITE(generationₑ, scoresₑ) |
| 22 | 结束函数 |
1: 函数 GENINV(model M, target t, size n, epoch e, conf c) 2: Generation1 = INITGENERATION(n) 3: for i 2 {1, .。。 , e} do 4: Scoresi = COMPUTESCORE(M, Generationi) 5: Elitei = FINDELITE(Generationi, Scoresi) 6: 如果 Scoresielitei > c 那么 7: 返回 Elitei 8: 结束 if 9: Generationi+1 = {elitei} 10: 对于 j 2 {1, .。。 , n −1} do 11: Parent1 = SAMPLE( Generationi, Scoresi) 12: Parent2 = SAMPLE(Generationi, Scoresi) 13: Childj = CROSSOVER(parent1, Parent2) 14: Childj = MUTATE(childj) 15: pj = TOPSPACE(childj) 16: pj = CLIPPSPACE(pj) 17: childj = TOWSPACE(pj) 18: Generationi+1 = Generationi+1 [ {childi} 19: 结束 20: 结束 21: return FINDELITE( Generatione, Scorese) 22: 结束函数
特别是,给定模型 M 的目标标签的一批 n 个反演图像,我们使用 M 来预测每个反演图像的前 5 个标签。给定预定义参数 k <= 5,我们确定 n 个反演图像的最大子集,这些图像在前 5 个标签中至少共享 k 个公共标签。然后,我们返回子集中置信度最高的图像。我们在本文中使用 k = 2。图 10 中通过我们一致的选择策略选择的最终图像以粗体方块突出显示。观察它返回正确的图像(与 dropout 一起使用时)。
其他设计选择。除了我们描述的 Z、W 和 P 空间之外,还有其他空间可以用于反演。讨论和结果可以在在线附录 I 7 中找到。
C 黑盒反演
在黑盒设置中,无法获得梯度。然而,借助已解耦的 W 空间和 P 空间中的正则化,可以使用离散搜索算法来寻找相同损失函数的最优解。在这里,我们采用遗传算法15。该算法从初始种群(即W中的一组初始样本)开始,通过交叉和变异导出下一代。前者是通过交换两个任意样本的部分。后者是通过随机扰动总体样本的个体维度来实现的。新样本经过调节(在 P 中),然后馈送到目标模型以确定其适应度,这就是预测分数。选择一组高适应度样本来形成下一代。
算法 2 正式描述了该过程。第 2 行是提供大小为 n 的第一代的初始化。我们对 Z 进行采样以获得 W 中的一组潜变量向量以及相应的合成图像。我们查询目标模型以查找具有 n 个最高预测分数的图像,并使用相应的 w 向量作为初始生成。第 4 行描述了适应度函数,即预测分数(表示目标标签置信度的单个值)。在第 9 行,它采用了精英主义策略 15 并添加了精英样本
当前一代的最高适应度分数(通过第 5 行的函数 FINDELITE())到下一代。第 10-19 行产生高适应度后代。为了产生更好的下一代,算法相互独立地随机从当前一代中选择父代,其概率与其适应度分数成正比(通过第 11-12 行的函数 SAMPLE())。第 13 行表示 CROSSOVER 操作。子代的维度由基于概率 (p, 1−p) 的父代 1 或父代 2 的维度组成,其中 p 定义如下,以便更好的子代有更高的机会被继承。
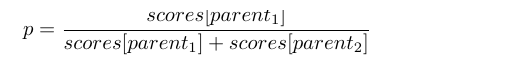
第 14 行表示 MUTATE 操作。为了使下一代多样化并更好地探索搜索空间,子代的每个维度都会以选定的概率发生突变。在 (−c·σp, c·σp) 范围内均匀采样的随机扰动被执行,其中 c 是调整突变强度的系数,σp 是 P 这个维度的标准差。大多数函数都有不言自明的名称,并且省略了它们的详细定义。
五 评价
我们评估 MIRROR 并与各种数据集和模型上最先进的方法进行比较。我们还在 Microsoft Azure 和 Clarifai 提供的两项商业人脸识别服务上对其进行了评估。进行消融研究是为了证明我们方法的参数的合理性。我们进一步证明 MIRROR 对几种现有的防御方法具有一定抵抗能力。我们在 PyTorch 中实现 MIRROR 51。大多数实验是在配备 256 GB RAM、两个 Intel Xeon Silver 4214 2.20GHz 12 核 CPU 和八个 NVIDIA Quadro RTX 6000 GPU 的服务器上进行的。我们在 GitHub 7 上有完整的反演结果集,我们将在发布后发布我们的系统。
A 实验设置
1 数据集和模型
表一显示了我们使用的5个数据集和8个模型的基本信息。我们使用 3 个流行的人脸识别数据集。在每个数据集上,我们选择 2 个具有不同架构的预训练模型。输入图像尺寸为3 × 224 × 224(通道 × 高度 × 宽度)、3 × 160 × 160和3 × 112 × 96。它们比以前的方法可以处理的要大得多:GMI 和 AMI 为 3 × 64 × 64。此外,我们遵循与 AMI 65 类似的设置来评估我们在两个商业面部识别服务上的黑盒方法 1、2。这些服务允许用户上传不同人的图像,然后允许用户调用 API 对给定样本进行分类。我们从 VGGFace2 数据集中随机选择 8 个人进行上传,然后使用 API 来评估黑盒方法。此外,我们还展示了使用在斯坦福汽车数据集 36 上训练的 ResNet34 进行汽车品牌和模型分类的反演结果,以及使用在 Oxford-IIIT Pet 数据集 50 中的猫以及东北虎 37 和白虎图像上训练的 ResNet18 进行猫/老虎品种分类的反演结果。虽然汽车模型和猫品种一般不构成敏感信息,但我们的目标是表明反演结果具有高保真度,使得处理私人信息的深度学习模型存在严重的隐私泄露问题。
表一:评估我们的方法的数据集和模型。每个数据集后面括号中的两个数字表示该数据集中不同身份的数量和图像的数量。数据集下方的模型意味着它们是在数据集上预先训练的(最后两列除外)。例如,"VGGFace2"下的"ResNet50"和"InceptionV1"是在"VGGFace2"数据集上进行预训练的,稍后将其中一个作为目标模型,另一个作为参考模型。
数据集 VGGFace (2,622/2.6M) 49 VGGFace2 (9,131/3.3M) 17 CASIA (10,575/0.5M) 67 Cat+tiger (14/2.8K) 50, 37 汽车 (196/16.2K) 36
模型 VGG16 6 VGG16BN 6 ResNet50 6 InceptionV1 3 InceptionV1 3 SphereFace 4 ResNet18 26 ResNet34 26
精度 97.22 96.29 99.88 99.65 99.05 99.22 93.05 90.30 参数 145M 110M 41M 28M 29M 28M 11M 21M 图像尺寸 3 × 224 × 224 3 × 224 × 224 3 × 224 × 224 3 × 160 × 160 3 × 160 × 160 3 × 112 × 96 3 × 224 × 224 3 × 400 × 400
2 StyleGAN
我们主要使用第三方训练的StyleGAN作为我们的生成器。我们使用来自55的预训练StyleGAN,该StyleGAN基于从CelebA数据集38中选择的103,706张图像来进行人脸识别任务,在我们的消融研究中使用在FFHQ数据集34上预训练的StyleGAN和StyleGAN2,以及在肖像艺术11上预训练的StyleGAN以获得额外结果。此外,我们使用33中在LSUN汽车数据集71上预训练的StyleGAN进行汽车模型分类,并使用33中在LSUN Cat数据集71上预训练的模型进行猫品种分类。
3 无训练集重叠的反演
除非另有说明,我们仅反演 StyleGAN 训练数据集中不存在的标签。也就是说,我们的方法使用 StyleGAN 来反演看不见的身份。在本节中,默认情况下通过反演每个目标模型的前 100 个不重叠标签来聚合结果。
4 基线
我们将我们的方法与白盒设置中最先进的反演方法 GMI 73 和 DeepInversion 69 以及黑盒设置中的 AMI 65 进行比较。对于 DeepInversion,我们使用三种不同的初始化设置:随机噪声/卡通人脸/平均人脸,用 DIR/DIC/DIA 表示。最后两个是我们为了增强 DeepInversion 的有效性而提出的。为了进行公平比较,我们使用与 StyleGAN 相同的数据集来训练所有生成器。我们还提出了另外三个基线:a)优化传统但高分辨率的 PGGAN 中的潜变量向量32; b)简单地选择GAN训练数据中目标置信度最高的图像; c)对StyleGAN的z进行采样并选择具有最高目标置信度的生成图像。我们强调最后两条基线是必要的,但被许多现有的工作所忽视。
B 评估指标
除了通过展示不同方法反演的图像进行定性评估外,我们还采用以下定量指标以及用户研究。
反演有效性(准确性)。我们报告了目标模型在反演图像上的分类精度。
反演的泛化性(迁移准确率)。如果反演图像确实揭示了目标人的特征而不是过度拟合目标模型,则它们应该被在同一数据集上预训练的具有不同架构的其他模型识别为目标标签。因此,我们也报告了其他模型的准确性。除了 (top-1) 可转移分类准确率之外,我们还收集了 top-5 准确率。如果目标标签出现在按预测置信度排序的前 5 个标签中,我们认为它是正确的。
特征距离。我们计算反演图像与目标类质心之间的L₂ 特征距离。特点
是从模型的倒数第二层提取的,除了 SphereFace,我们使用角度距离,因为它经过训练以增加不同特征之间的角度裕度。我们还报告了另一个具有不同架构的模型的特征距离,该模型在与目标模型相同的数据集上进行了预训练。该指标越低越好。
自然图像质量评估器 (NIQE)。 NIQE 被提议作为感知质量评估的非参考指标43。它从自然场景统计模型构建"质量感知"特征,并拟合多元高斯(MVG)模型。给定一个测试图像,它适合另一个 MVG 模型,质量由两个 MVG 模型之间的距离来描述。分数越小意味着感知质量越好。
人类研究。由于如果人类无法将自然图像视为目标标签,自然图像可能不会构成安全威胁,因此对于人脸数据集,我们进行了人类研究以进一步量化反演身份的正确性。我们遵循文献 72 中的用户研究设计。在该设置中,用户会获得目标身份的真实图像,然后被要求从两个反演图像中选择一个更类似于真实图像的图像。两张反演图像包括一张来自我们的方法,另一张来自对比方法。顺序是随机的。这三个图像将在屏幕上闪烁五秒钟。对于我们的方法和基线方法之间的每个比较设置,我们随机选择 50 个身份进行评估,总共评估了 10900 对身份。有 218 个唯一用户参与了我们的研究,在删除大于 1 个标准差的数据点后,218 个用户中的 170 个被认为是有效的。实验前,用户需要进行五次热身练习。典型的用户研究样本可以在附录 III-A 的图 22 中找到 7。除了上述比较人类研究之外,我们还进行了另外三项人类研究,通过将目标人的反演图像与 1)其他随机选择的人的训练图像,2)与原始数据集中最相似的目标人的其他人的图像,以及 3)来自被目标模型分类为目标的 CelebA 的图像混合来直接评估我们的结果。详细信息和示例参见附录 III-B 7。
C 反演人脸识别模型
1 白盒反演结果
图11a显示了不同方法的反演准确率。除了 GMI 之外,所有方法都具有相似的反演准确率,因为白盒反演方法明确考虑了目标模型上的分类损失。图 11b 显示了迁移准确率。我们的方法在所有情况下都远远优于最先进的方法 GMI。除了一个模型之外,我们的模型比采用随机初始化的 DeepInversion 优越得多。
(b) 参考模型上的 Top-1/top-5(深色/浅色)准确度。图 11:白盒反演的有效性和泛化性。越高越好。 DeepInversion 无法应用于没有 BatchNorm 层的模型。
(a) 目标模型的准确性。
表二:白盒方法反演图像的特征距离(越低越好)。为每个设置报告的两个数字分别表示目标模型上的 L₂ 特征距离,以及在同一数据集上预训练的另一个模型上的特征距离。例如,"MIRROR"行和"ResNet50"列的单元格中的"149.96"和"147.97"显示了目标"ResNet50"和参考模型"InceptionV1"计算的距离。 DeepInversion 无法应用于没有 BatchNorm 层的模型。
方向 -- 102.67 132.41 161.15 201.16 127.76 174.21 172.06 11.51 -- DIC -- 93.05 131.64 149.10 185.35 129.40 171.26 172.27 11.41 --直径 -- 85.26 117.01 150.91 192.95 130.10 172.69 172.50 11.47 -- GMI 110.20 103.41 98.87 104.49 155.25 198.51 143.47 188.23 153.34 12.09 12.20 187.73 PGGAN 139.57 82.35 85.71 96.41 164.10 150.22 130.64 170.47 181.18 10.13 9.06 159.83 MIRROR 97.73 55.41 72.06 80.65 149.96 147.97 119.82 163.84 154.41 9.81 8.96 156.19
通过更好的初始化方法,DIC/DIA 的性能更好,但在除一种模型之外的所有模型上仍然比我们的模型差。我们提出的 PGGAN 基线已经比现有的最先进方法更强,并且具有与我们相当的迁移准确率。根据图 13,我们怀疑 PGGAN 具有可比较的迁移准确率,因为它生成目标的尖锐且扭曲的特征。然而,正如 NIQE 结果(表 III)和所有 6 个模型的用户研究(图 12)所示,生成的面部与目标(从人类的角度)不太相似。
对于表 II 中所示的(目标/可转移)特征距离,我们的方法生成的图像在目标模型和参考模型上都具有最小的 L₂ 特征距离,除了其距离略大于在 CASIA 上训练的目标 InceptionV1 模型的 GMI 和在 VGGFace2 上训练的目标 ResNet50 模型的 DIC 的距离。但请注意,两个相应参考模型上的距离要小得多。
对于感知质量评估,表三中我们反演的图像的 NIQE 分数要好得多。我们还在图 13 中显示了通过不同方法反演的图像。我们可以观察到:1)我们的图像具有更好的质量
并且与目标人群更加相似; 2)我们的方法生成了在面部特征和性别方面更加一致的图像。
图 12 显示了用户研究结果。 x 轴显示不同的数据集。 y 轴显示我们样本的偏好率。这是用户比其他样本更喜欢我们的反演样本的次数(以百分比表示)。因此,50% 表示我们的方法与对比方法没有显著偏好差异。每个点的中心表示平均偏好,其直径表示标准误差。我们的反演图像在用户研究中更受用户青睐。请注意,设计用户研究来直接测量给定样本与目标人的相似程度确实很困难。因此我们设计了
表III:白盒方法反演图像的NIQE(越低越好)。 DeepInversion 无法应用于没有 BatchNorm 层的模型。
DIR -- 25.67 16.84 18.88 18.87 -- DIC -- 6.28 6.38 5.22 5.06 -- DIA -- 6.49 5.68 5.21 5.06 -- GMI 6.82 6.78 6.94 6.57 6.76 6.59 PGGAN 5.32 5.17 4.95 5.00 4.74 5.43 MIRROR 3.56 3.59 3.46 3.58 3.56 3.70
图 12:人类对我们的图像相对于其他图像的偏好(越高越好)。 DeepInversion 无法应用于没有 BatchNorm 层的模型。
比较研究表明我们比其他人更好。当我们将目标人的反演图像与其他随机选择的人的训练图像混合时,95.71%的用户可以根据反演图像正确选择目标人。当反演图像与原始数据集中与目标人物最相似的其他人的图像混合时,百分比下降(如预期)至 89.29%,但仍然很高。当反演图像与 CelebA 中被错误分类为目标人物的图像混合时,百分比进一步下降(如预期)至 78.75%。更多详细信息请参见附录 III-B 7。有兴趣的读者可以参考在线附录和我们的在线存储库 7 中的图 13 和 28(使用艺术风格-GAN 反演)中的示例进行进一步检查。
图 13:通过我们的方法 MIRROR、GMI、我们提出的 PGGAN 基线和使用平均人脸 (DIA) 初始化的 DeepInversion 在白盒设置中反演的图像。我们的图像不仅更具有人类可识别性并且与目标人群相似,而且在面部特征和性别方面也更加一致。
表IV:黑盒方法反演图像的特征距离(越低越好)。单元格中的两个数字对应于目标模型和在同一数据集上预训练的另一个模型上的L₂ 特征距离(目标特征距离不可计算的两个商业服务除外)。例如,"MIRROR"行和"ResNet50"列的单元格中的"150.27"和"172.03"显示了目标"ResNet50"和参考模型"InceptionV1"计算的距离。对于 MS Azure,我们基于 InceptionResnetV1 计算特征距离。对于 Clarifai,我们基于 24 类 VGG16 计算特征距离。
AMI 103.10 124.15 125.82 104.73 197.11 234.40 234.95 202.51 188.05 10.89 11.37 198.98 198.51 24.53 MIRROR 90.83 69.05 62.19 85.17 150.25 172.03 130.77 167.86 139.39 10.12 10.09 173.34 176.67 16.66
表V:通过黑盒方法反演图像的NIQE(越低越好)。
2 黑盒反演结果
如图14所示,我们的黑盒反演方法在数量上比AMI好得多,AMI的反演有效性和泛化性非常低,正如我们在第三节中所解释的。通过我们的方法反演的图像在所有情况下都具有较小的特征距离,如表 IV 所示。很明显,我们的方法可以生成比 AMI 的模糊图像质量更高的图像,如表 V 中的 NIQE 分数和图 15 中的可视化结果所示。
3 与选择具有最高目标置信度的样本进行比较
我们将我们的方法与两个简单的基线进行比较,这两个基线被许多现有的工作所忽略,实际上在大多数情况下优于现有的最先进的方法。 "Celeba"方法只是简单地选择 GAN 训练数据中目标置信度最高的图像。类似地,"Sample"方法通过对 StyleGAN 的潜变量向量进行采样,从一组预先生成的图像中选择图像。如图 16-17 和表 VI 所示,我们的方法优于两个基线。我们还对 120 位唯一用户进行了一项用户研究,共提出了 6000 个问题,以将"Celeba"/"Sample"与我们的进行比较。平均大约 69.07%/68.47% 的用户更喜欢我们的方法而不是"Celeba"/"Sample"。
4 商业服务反演结果
为了进一步证明我们的方法确实威胁到现实世界的人脸识别服务,我们评估了我们的黑盒反演方法
(b) 参考模型上的 Top-1/top-5(深色/浅色)准确度。图 14:黑盒反演的有效性和泛化性。越高越好。
(a) 目标模型的准确性。
图 15:由 AMI 和我们的反演图像。每一列对应一个人。第一行和第二行显示真实图像。第三行显示 AMI 反演的图像,而我们的反演图像位于第四行。
图 16:采样/选择基线和我们的反演有效性。越高越好。
图 17:采样/选择基线和我们的的反演泛化性。 Top-1/top-5(深色/浅色)准确度。越高越好。
商业 Microsoft Azure 认知服务 1。它提供API供用户将人脸识别嵌入到自己的应用程序中,而不需要任何深度学习专业知识,因此得到广泛应用。例如,Uber 利用它来确保用户的自拍照被识别为存档人员,从而保护用户免受欺诈 5。我们所有的反演图像都被预测为目标人物,top-1/top-5 迁移准确率为 37.50%/50.00%。一些图像如图 18 所示。MIRROR 也在模型上进行了评估
在Clarifai 商业平台上进行了培训2。反演精度和top-1/top-5迁移准确率分别为100%和37.5%/87.5%。
5 消融研究
为了展示不同因素如何影响我们的方法,我们在各种设置下对我们的方法进行了对照实验。我们考虑的因素包括:1)GAN的训练数据集; 2)优化的潜在空间; 3)裁剪策略; 4)GAN的架构; 5)除了 Z 和 W 空间之外,我们还考虑 Z+ 和 W+ 空间,其中单独的 z 向量(以及相应的 w 向量)被馈送到不同样式的块。在线附录 I 7 中解释了不同因素的详细信息。从表VII中的NIQE分数,我们可以看到它们都优于现有的最先进的方法,并且在W中进行优化并在P中进行裁剪的方法,即w&clip,合成了最佳感知质量的图像。定性比较可参见附录 I 中的图 20 7。我们进行了一项用户研究,将默认设置(即在 Celaba 上训练的 StyleGAN 结构的 w&clip)与其他单独设置进行比较,以了解其影响。结果见表VII。对于训练数据,用户更喜欢在 FFHQ 上训练的 StyleGAN 生成的图像,而不是在 Celeba 上训练的 StyleGAN 生成的图像。 FFHQ 具有更好质量和更多多样性的图像,因此生成的人脸可能具有更自然的肤色和更好的光照条件,如附录 I 7 中的图 21 所示。然而,我们在主要实验中选择不使用在 FFHQ 上预训练的 StyleGAN,因为 FFHQ 只有未标记的图像,这意味着我们无法确认哪些身份未出现在训练数据中,因此难以可靠评估对未见身份的反演。其余结果表明,默认设置具有更好的用户偏好率。
表六:通过我们的方法和采样/选择基线方法反演的图像的特征距离(越低越好)。设置的两个数字对应于目标模型和在同一数据集上预训练的另一个模型的 L₂ 特征距离。
CelebA 105.37 81.27 83.34 106.37 160.71 178.24 159.44 171.90 153.64 14.92 27.33 174.19 样本 96.27 77.08 77.16 100.05 170.59 200.83 173.82 183.34 153.49 18.89 26.85 174.58 镜子(黑盒) 90.83 69.05 62.19 85.17 150.25 172.03 130.77 167.86 139.39 10.12 10.09 173.34 MIRROR(白盒) 97.73 55.41 72.06 80.65 149.96 147.97 119.82 163.84 154.41 9.81 8.96 156.19
图 18:商业 Microsoft Azure 认知服务的反演结果。第一行显示我们的反演图像,第二行显示 AMI 反演的图像,最后两行显示真实图像。 AMI 反演的图像很模糊,更像普通人脸,因此无法被人类识别。我们的结果提供了更好的图像并且与目标人群更相似。
表 VII:消融研究。我们在各种设置下使用我们的方法反演 ResNet50 的 100 个随机选择的标签,并计算平均 NIQE(越低越好)。我们研究了默认设置(即 Celeba 上使用 StyleGAN 的 w&clip)和其他个人设置之间的用户偏好率。例如,第二行意味着 42% 的人更喜欢默认设置的结果,而不是使用 FFHQ 的结果。在线附录 I 7 中解释了不同因素的详细信息。
z 3.77 54.8 ±1.0% z&夹子 3.87 54.8 ±2.8% w 3.80 73.3 ±5.3% w&夹子 3.46 -- z+ 3.65 55.5 ±1.3% z+&夹子 3.75 66.0 ±9.6% w+ 3.99 86.0 ±6.7% w+&夹子 3.57 78.4 ±7.9%
6 基于Dropout和一致性的结果选择的影响
我们随机选择在VGGFace上预训练的VGG16的50个标签,进行有和没有dropout和基于一致性的结果选择的模型反演。准确度和 NIQE 相似。目标模型和参考模型的特征距离在增强后为 98.12/55.90,在没有增强时为 107.12/65.08。
D 其他数据域的结果
为了演示 MIRROR 的功能,我们使用在艺术风格面部肖像 11 上训练的 StyleGAN 来反演 ResNet50 模型。结果可以在在线附录7的图28中找到。他们表明,使用来自相似(但不同)域的数据可以产生良好的反演结果。我们还表明 MIRROR 可以对使用其他领域(例如汽车和猫)的数据训练的模型执行高质量的反演。由于篇幅有限,结果呈现在在线附录九7中。
E 各种防御方法的结果
除了原始的 ResNet50 (Rorg) 之外,我们还攻击由 60 对抗性训练的鲁棒 ResNet50 (Radv) 和由 MID 59 训练的防御性 ResNet50 (Rmid)。 MID 试图规范输入图像和网络预测之间的依赖关系,以防御反演攻击。对于 Rorg、Radv 和 Rmid 中的每一个,我们对其进行攻击并使用其他两个作为参考模型。准确率和可传递准确率均为100%。当使用InceptionV1作为参考模型时,攻击Rorg/Radv/Rmid的迁移准确率为74%/76%/73%。对抗性训练不能像预期那样使模型反演变得更加困难,因为它有助于模型学习针对对抗性扰动的鲁棒特征。 MID 能够很好地防御 GMI(反演精度从 31% 下降到 18% 59),但不能很好地防御 MIRROR(在有防御和无防御的情况下具有相同的 100% 反演精度),可能是因为 MIRROR 是一种更强的攻击。一些反演结果
如图 19 所示。我们还针对由差分私有随机梯度下降 (DP-SGD) 8、70 训练的 VGG16 模型评估我们的方法,该模型在训练期间向梯度添加噪声以防御成员推理攻击。反演精度为 100%,正常训练的 VGG16 和 ResNet18 上的 top-1/top-5 可转移反演精度为 70%/100% 和 100%/100%。虽然DP-SGD可以确保训练样本的一定隐私性,但它无法防御模型反演攻击。因为与攻击者检查样本是否用于训练模型的成员推理攻击不同,模型反演的目标是为目标标签生成代表性图像。
六 相关工作
机器学习隐私。研究人员研究了机器学习中的各种隐私问题48。肖克里等人。 56提出了成员推理攻击,旨在推断给定的数据点是否属于训练集。此类攻击随后出现了几项工作39、66、54、18。宋等人。 58建立了一个替代模型,其性能与原始模型一样准确,同时记住有关训练集的信息。继13之后,Ganju 等人。 24提出了属性推断攻击,提取训练数据的数据属性(例如少数群体的比例)。塞勒姆等人。 53考虑了在线学习场景,并提出推断用于更新训练模型的数据。最近还有研究协作学习中信息泄漏问题的工作27、29、41、68,其中训练或推理任务被分配给多个参与者。例如,GradInversion 68是一种基于DeepInversion的方法,用于恢复客户端使用的私有训练数据。它需要训练过程中模型权重的一组私有训练图像的梯度,这在模型反演中是不可用的。此外,它仅适用于白盒设置中具有 BatchNorm 层的模型。 Vec2Face 20 专注于从特征嵌入中恢复图像。当模型反演仅提供标签信息时不适用。与上述不同的是,我们的重点是
图 19:使用不同策略训练的模型上的反演图像。
模型反演攻击,旨在重建目标身份的代表性数据点。
模型反演攻击。 Fredrikson 在等人中首先引入了这种攻击。 23,22,其目标包括从线性回归模型推断私人用户属性,从浅层神经网络恢复人脸图像等。后来,Mahendran和Vedaldi 40特别关注反演图像并提出添加自然图像先验,Wu等人。 61进一步提供了模型反演攻击的形式化。总的来说,这些早期的工作主要针对浅层模型,反演图像的保真度不高。最近,提出了几种最先进的模型反演方法65、69、73。例如,通过使用辅助数据集查询目标模型,AMI 65 训练额外的生成模型以将截断的预测映射到灰度图像。 DeepInversion 69 通过合并额外的正则化项来限制批量归一化层上的特征相似性,从而扩展了 DeepDream 44 中的优化框架。 GMI73提出使用GAN进行反演。它优化了潜在空间,可以生成更自然的图像。继73之后,Chen 等人。 19进一步提出将目标模型纳入GAN中。它继承了 GMI 的局限性。我们对这些技术进行了彻底的比较,MIRROR 的性能优于这些技术。
GAN 和图像反演。自第一个 GAN 25 以来,人们提出了许多 GAN 52、12、47。最近,设计了一系列改进的 GAN 32、34、35 来生成高保真自然图像,包括 StyleGAN 34、35。 StyleGAN 广泛应用于图像超分辨率42、图像编辑9、10、62、63。这些图像应用中使用的常见技术称为图像反演。与模型反演不同,图像反演的目的是找到可以精确重建给定图像的潜变量向量。与模型反演相比,它具有更强的约束,并且现有的图像反演方法仅在白盒设置中起作用。相比之下,MIRROR 接受一个标签并为该标签生成图像,并且适用于白盒和黑盒。
例如,63是一种基于StyleGAN的图像反演方法。它将协方差矩阵和高斯分布的均值作为能量项相加,这实际上是潜变量向量和均值之间的马哈拉诺比斯距离,而 MIRROR 截断了潜变量向量。虽然其优化方法可以适用于模式反演,但我们的实验表明,我们的优化在模型反演的情况下比63的优化方法高出25.5%。详细信息请参见在线附录五7。
七 结论
我们研究基于 GAN 的模型反演的挑战。我们基于 StyleGAN 开发了一种新的反演技术 MIRROR。它利用了 StyleGAN 解耦潜在空间的能力。它支持白盒和黑盒反演,并用多元高斯分布调节 StyleGAN 辅助空间中的图像质量。我们的结果表明,与最先进的方法相比,通过 MIRROR 反演的样本具有更好的质量和保真度。
致谢
我们感谢匿名审稿人的建设性意见。这项研究部分得到 NSF 1901242 和 1910300、ONR N000141712045、N000141410468 和 N000141712947、IARPA TrojAI W911NF-19-S-0012、DARPA VSPELLS(根据与 BAE 的分包合同 1119482)的支持系统)和国家自然科学基金62172199。姚远和徐经伟得到软件新技术与产业化协同创新中心的部分支持。我们感谢 Clarifai(尤其是 Ian Kelk 和 J´er´emy Faret)提供免费帐户来运行实验。本文中的任何观点、发现和结论仅代表作者的观点,并不一定反映我们赞助商的观点。
参考文献
1 "Azure cognitive services," https://azure.microsoft.com/en-us/services/ cognitive-services/. 2 "Clarifai," https://www.clarifai.com/. 3 "Inception resnet (v1) models in pytorch," https://github.com/timesler/ facenet-pytorch. 4 "Sphereface model in pytorch," https://github.com/clcarwin/sphereface pytorch. 5 "Uber with azure cognitive services," https://customers.microsoft.com/ en-us/story/731196-uber. 6 "Vggface/vggface2 models in pytorch," https://www.robots.ox.ac.uk/ ⇠albanie/pytorch-models.html. 7 "Our system MIRROR," https://model-inversion.github.io/mirror/, 2021. 8 M. Abadi, A. Chu, I. Goodfellow, H. B. McMahan, I. Mironov, K. Talwar, and L. Zhang, "Deep learning with differential privacy," in Proceedings of the 2016 ACM SIGSAC Conference on Computer and Communications Security (CCS), ser. CCS '16. New York, NY, USA: Association for Computing Machinery, 2016, p. 308--318. 9 R. Abdal, Y. Qin, and P. Wonka, "Image2stylegan: How to embed images into the stylegan latent space?" in Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), 2019, pp. 4432-- 4441. 10 R. Abdal, Y. Qin, and P. Wonka, "Image2stylegan++: How to edit the embedded images?" in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020, pp. 8296-- 8305.
11 ak9250, "Stylegan art," https://github.com/ak9250/stylegan-art, 2019.
12 M. Arjovsky, S. Chintala, and L. Bottou, "Wasserstein gan," 2017.
13 G. Ateniese, L. V. Mancini, A. Spognardi, A. Villani, D. Vitali, and G. Felici, "Hacking smart machines with smarter ones: How to extract meaningful data from machine learning classifiers," International Journal of Security and Networks, vol. 10, no. 3, pp. 137--150, 2015.
14 I. B´ar´any and V. Vu, "Central limit theorems for gaussian polytopes," The Annals of Probability, vol. 35, no. 4, pp. 1593--1621, 2007.
15 D. Bhandari, C. Murthy, and S. K. Pal, "Genetic algorithm with elitist model and its convergence," International journal of pattern recognition and artificial intelligence, vol. 10, no. 06, pp. 731--747, 1996.
16 C. M. Bishop, Pattern recognition and machine learning. springer, 2006.
17 Q. Cao, L. Shen, W. Xie, O. M. Parkhi, and A. Zisserman, "Vggface2: A dataset for recognising faces across pose and age," in 2018 13th IEEE international conference on automatic face & gesture recognition (FG). IEEE, 2018, pp. 67--74.
18 D. Chen, N. Yu, Y. Zhang, and M. Fritz, "Gan-leaks: A taxonomy of membership inference attacks against generative models," in Proceedings of the ACM SIGSAC Conference on Computer and Communications Security (CCS), 2020, pp. 343--362.
19 S. Chen, R. Jia, and G.-J. Qi, "Improved techniques for model inversion attack," arXiv preprint arXiv:2010.04092, 2020.
20 C. N. Duong, T.-D. Truong, K. Luu, K. G. Quach, H. Bui, and K. Roy, "Vec2face: Unveil human faces from their blackbox features in face recognition," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020, pp. 6132--6141.
21 G. Franchi, A. Bursuc, E. Aldea, S. Dubuisson, and I. Bloch, "Tradi: Tracking deep neural network weight distributions," in Proceedings of the European Conference on Computer Vision (ECCV). Springer, 2020, pp. 105--121.
22 M. Fredrikson, S. Jha, and T. Ristenpart, "Model inversion attacks that exploit confidence information and basic countermeasures," in Proceedings of the 22nd ACM SIGSAC Conference on Computer and Communications Security (CCS), 2015, pp. 1322--1333.
23 M. Fredrikson, E. Lantz, S. Jha, S. Lin, D. Page, and T. Ristenpart, "Privacy in pharmacogenetics: An end-to-end case study of personalized warfarin dosing," in 23rd {USENIX} Security Symposium ({USENIX} Security), 2014, pp. 17--32.
24 K. Ganju, Q. Wang, W. Yang, C. A. Gunter, and N. Borisov, "Property inference attacks on fully connected neural networks using permutation invariant representations," in Proceedings of the 2018 ACM SIGSAC Conference on Computer and Communications Security (CCS), 2018, pp. 619--633.
25 I. Goodfellow, J. Pouget-Abadie, M. Mirza, B. Xu, D. Warde-Farley, S. Ozair, A. C. Courville, and Y. Bengio, "Generative adversarial nets," in Advances in Neural Information Processing Systems (NeurIPS), 2014.
26 K. He, X. Zhang, S. Ren, and J. Sun, "Deep residual learning for image recognition," in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016, pp. 770--778.
27 Z. He, T. Zhang, and R. B. Lee, "Model inversion attacks against collaborative inference," in Proceedings of the 35th Annual Computer Security Applications Conference (ACSAC), 2019, pp. 148--162.
28 S. Hidano, T. Murakami, S. Katsumata, S. Kiyomoto, and G. Hanaoka, "Model inversion attacks for prediction systems: Without knowledge of non-sensitive attributes," in 2017 15th Annual Conference on Privacy, Security and Trust (PST). IEEE, 2017, pp. 115--124.
29 B. Hitaj, G. Ateniese, and F. Perez-Cruz, "Deep models under the gan: information leakage from collaborative deep learning," in Proceedings of the 2017 ACM SIGSAC Conference on Computer and Communications Security (CCS), 2017, pp. 603--618.
30 X. Huang and S. Belongie, "Arbitrary style transfer in real-time with adaptive instance normalization," in Proceedings of the IEEE International Conference on Computer Vision (ICCV), 2017, pp. 1501--1510.
31 S. Ioffe and C. Szegedy, "Batch normalization: Accelerating deep network training by reducing internal covariate shift," in International Conference on Machine Learning (ICML). PMLR, 2015, pp. 448--456.
32 T. Karras, T. Aila, S. Laine, and J. Lehtinen, "Progressive growing
参考文献(保留原文著录格式)
of gans for improved quality, stability, and variation," in International Conference on Learning Representations (ICLR), 2018.
33 T. Karras, S. Laine, and T. Aila, "Nvidia stylegan," https://github.com/ NVlabs/stylegan, 2019.
34 T. Karras, S. Laine, and T. Aila, "A style-based generator architecture for generative adversarial networks," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019, pp. 4401--4410.
35 T. Karras, S. Laine, M. Aittala, J. Hellsten, J. Lehtinen, and T. Aila, "Analyzing and improving the image quality of stylegan," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020, pp. 8110--8119.
36 J. Krause, M. Stark, J. Deng, and L. Fei-Fei, "3d object representations for fine-grained categorization," in 4th International IEEE Workshop on 3D Representation and Recognition (3dRR-13), Sydney, Australia, 2013.
37 S. Li, J. Li, H. Tang, R. Qian, and W. Lin, "Atrw: A benchmark for amur tiger re-identification in the wild," in Proceedings of the 28th ACM International Conference on Multimedia (MM), 2020, pp. 2590--2598.
38 Z. Liu, P. Luo, X. Wang, and X. Tang, "Deep learning face attributes in the wild," in Proceedings of International Conference on Computer Vision (ICCV), December 2015.
39 Y. Long, V. Bindschaedler, L. Wang, D. Bu, X. Wang, H. Tang, C. A. Gunter, and K. Chen, "Understanding membership inferences on wellgeneralized learning models," arXiv preprint arXiv:1802.04889, 2018.
40 A. Mahendran and A. Vedaldi, "Understanding deep image representations by inverting them," in Proceedings of the IEEE conference on computer vision and pattern recognition (CVPR), 2015, pp. 5188--5196.
41 L. Melis, C. Song, E. De Cristofaro, and V. Shmatikov, "Exploiting unintended feature leakage in collaborative learning," in 2019 IEEE Symposium on Security and Privacy (SP). IEEE, 2019, pp. 691--706.
42 S. Menon, A. Damian, S. Hu, N. Ravi, and C. Rudin, "Pulse: Selfsupervised photo upsampling via latent space exploration of generative models," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020, pp. 2437--2445.
43 A. Mittal, R. Soundararajan, and A. C. Bovik, "Making a "completely blind" image quality analyzer," IEEE Signal Processing Letters, vol. 20, no. 3, pp. 209--212, 2012.
44 A. Mordvintsev, C. Olah, and M. Tyka, "Inceptionism: Going deeper into neural networks," 2015.
45 NIST/SEMATECH, "e-handbook of statistical methods," https://www. itl.nist.gov/div898/handbook/eda/section3/qqplot.htm, 2012.
46 NVIDIA, "Resnet50 v1.5 for pytorch," https://github.com/NVIDIA/ DeepLearningExamples/tree/master/PyTorch/Classification/ConvNets/ resnet50v1.5.
47 A. Odena, C. Olah, and J. Shlens, "Conditional image synthesis with auxiliary classifier gans," in International Conference on Machine Learning (ICML). PMLR, 2017, pp. 2642--2651.
48 N. Papernot, P. McDaniel, A. Sinha, and M. P. Wellman, "Sok: Security and privacy in machine learning," in 2018 IEEE European Symposium on Security and Privacy (EuroS&P). IEEE, 2018, pp. 399--414.
49 O. M. Parkhi, A. Vedaldi, and A. Zisserman, "Deep face recognition," 2015.
50 O. M. Parkhi, A. Vedaldi, A. Zisserman, and C. V. Jawahar, "Cats and dogs," in IEEE Conference on Computer Vision and Pattern Recognition, 2012.
51 A. Paszke, S. Gross, F. Massa, A. Lerer, J. Bradbury, G. Chanan, T. Killeen, Z. Lin, N. Gimelshein, L. Antiga, A. Desmaison, A. Kopf, E. Yang, Z. DeVito, M. Raison, A. Tejani, S. Chilamkurthy, B. Steiner, L. Fang, J. Bai, and S. Chintala, "Pytorch: An imperative style, highperformance deep learning library," in Advances in Neural Information Processing Systems 32 (NeurIPS). Curran Associates, Inc., 2019, pp. 8024--8035.
52 A. Radford, L. Metz, and S. Chintala, "Unsupervised representation learning with deep convolutional generative adversarial networks," 2015.
53 A. Salem, A. Bhattacharya, M. Backes, M. Fritz, and Y. Zhang, "Updates-leak: Data set inference and reconstruction attacks in online
learning," in 29th {USENIX} Security Symposium ({USENIX} Security), 2020, pp. 1291--1308. 54 A. Salem, Y. Zhang, M. Humbert, M. Fritz, and M. Backes, "Ml-leaks: Model and data independent membership inference attacks and defenses on machine learning models," in Network and Distributed Systems Security Symposium (NDSS). Internet Society, 2019. 55 Y. Shen, Y. Xu, C. Yang, J. Zhu, and B. Zhou, "Genforce," https:// github.com/genforce/genforce, 2020. 56 R. Shokri, M. Stronati, C. Song, and V. Shmatikov, "Membership inference attacks against machine learning models," in 2017 IEEE Symposium on Security and Privacy (SP). IEEE, 2017, pp. 3--18. 57 J. Sirignano and K. Spiliopoulos, "Mean field analysis of neural networks: A central limit theorem," Stochastic Processes and their Applications, vol. 130, no. 3, pp. 1820--1852, 2020. 58 C. Song, T. Ristenpart, and V. Shmatikov, "Machine learning models that remember too much," in Proceedings of the 2017 ACM SIGSAC Conference on Computer and Communications Security (CCS), 2017, pp. 587--601. 59 T. Wang, Y. Zhang, and R. Jia, "Improving robustness to model inversion attacks via mutual information regularization," in Proceedings of the AAAI Conference on Artificial Intelligence (AAAI), vol. 35, no. 13, 2021, pp. 11 666--11 673. 60 E. Wong, L. Rice, and J. Z. Kolter, "Fast is better than free: Revisiting adversarial training," in International Conference on Learning Representations (ICLR), 2020. 61 X. Wu, M. Fredrikson, S. Jha, and J. F. Naughton, "A methodology for formalizing model-inversion attacks," in IEEE 29th Computer Security Foundations Symposium (CSF). IEEE, 2016, pp. 355--370. 62 Z. Wu, D. Lischinski, and E. Shechtman, "Stylespace analysis: Disentangled controls for stylegan image generation," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2021, pp. 12 863--12 872. 63 J. Wulff and A. Torralba, "Improving inversion and generation diversity in stylegan using a gaussianized latent space," arXiv preprint arXiv:2009.06529, 2020. 64 Q. Xu, G. Tao, and X. Zhang, "D-square-b: Deep distribution bound for natural-looking adversarial attack," 2020. 65 Z. Yang, J. Zhang, E.-C. Chang, and Z. Liang, "Neural network inversion in adversarial setting via background knowledge alignment," in Proceedings of the 2019 ACM SIGSAC Conference on Computer and Communications Security (CCS), 2019, pp. 225--240. 66 S. Yeom, I. Giacomelli, M. Fredrikson, and S. Jha, "Privacy risk in machine learning: Analyzing the connection to overfitting," in 2018 IEEE 31st Computer Security Foundations Symposium (CSF). IEEE, 2018, pp. 268--282. 67 D. Yi, Z. Lei, S. Liao, and S. Z. Li, "Learning face representation from scratch," arXiv preprint arXiv:1411.7923, 2014. 68 H. Yin, A. Mallya, A. Vahdat, J. M. Alvarez, J. Kautz, and P. Molchanov, "See through gradients: Image batch recovery via gradinversion," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2021, pp. 16 337--16 346. 69 H. Yin, P. Molchanov, J. M. Alvarez, Z. Li, A. Mallya, D. Hoiem, N. K. Jha, and J. Kautz, "Dreaming to distill: Data-free knowledge transfer via deepinversion," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020, pp. 8715-- 8724. 70 A. Yousefpour, I. Shilov, A. Sablayrolles, D. Testuggine, K. Prasad, M. Malek, J. Nguyen, S. Ghosh, A. Bharadwaj, J. Zhao, G. Cormode, and I. Mironov, "Opacus: User-friendly differential privacy library in pytorch," arXiv preprint arXiv:2109.12298, 2021. 71 F. Yu, Y. Zhang, S. Song, A. Seff, and J. Xiao, "Lsun: Construction of a large-scale image dataset using deep learning with humans in the loop," arXiv preprint arXiv:1506.03365, 2015. 72 R. Zhang, P. Isola, and A. A. Efros, "Colorful image colorization," in European Conference on Computer Vision. Springer, 2016, pp. 649-- 666. 73 Y. Zhang, R. Jia, H. Pei, W. Wang, B. Li, and D. Song, "The secret revealer: Generative model-inversion attacks against deep neural networks," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020, pp. 253--261.