模型太大又不能减面,多数人第一反应是「换个格式试试」。这个方向一开始就错了:格式转化不改几何,转完体积不掉、甚至变大,属于正确行为,不是 bug。
为什么转格式不省体积
格式转化只换打包容器。GLB → PLY、OBJ → FBX,顶点数据和索引原样搬过去,三角面一个不少。往文本类格式转还会变大------紧凑的二进制编码换成明文数字,同样一份几何更占空间。
Zipoly 支持 GLB / glTF / OBJ / FBX / STL / DAE / PLY 七种互转(Zipoly 官网 / 公开信息),解决的是下游兼容性,不是体积问题。这两件事得分开想。
三条能不动面数就省的路
| 手段 | 动了什么 | 代价 | 什么时候用 |
|---|---|---|---|
| 坐标量化 | 顶点坐标 / 法线 / UV 的存储位宽,32 位浮点 → 更少位 | 精度损失:UV 过低贴图错位,法线过低光照变糙 | 面数不能动时先动它 |
| 结构重组 | 移除冗余索引与空数据,优化 BufferView | 无,不损失可见精度 | 任何时候都开着 |
| 纹理压缩 | 贴图转 JPEG / WebP / KTX2,质量默认 75,最大边长 2048 | 贴图画质,WebP 体积小约 30% | 模型大头是贴图时优先 |
量化可调范围是位置 / 法线 / UV 各 4-16 bit,自动档推导出来是位置 10 bit、法线 8 bit、UV 8 bit。压缩强度滑杆 1-7,默认 7(HIGH)------这个值往下调,量化位宽会自动跟着放宽,这就是取舍的入口。
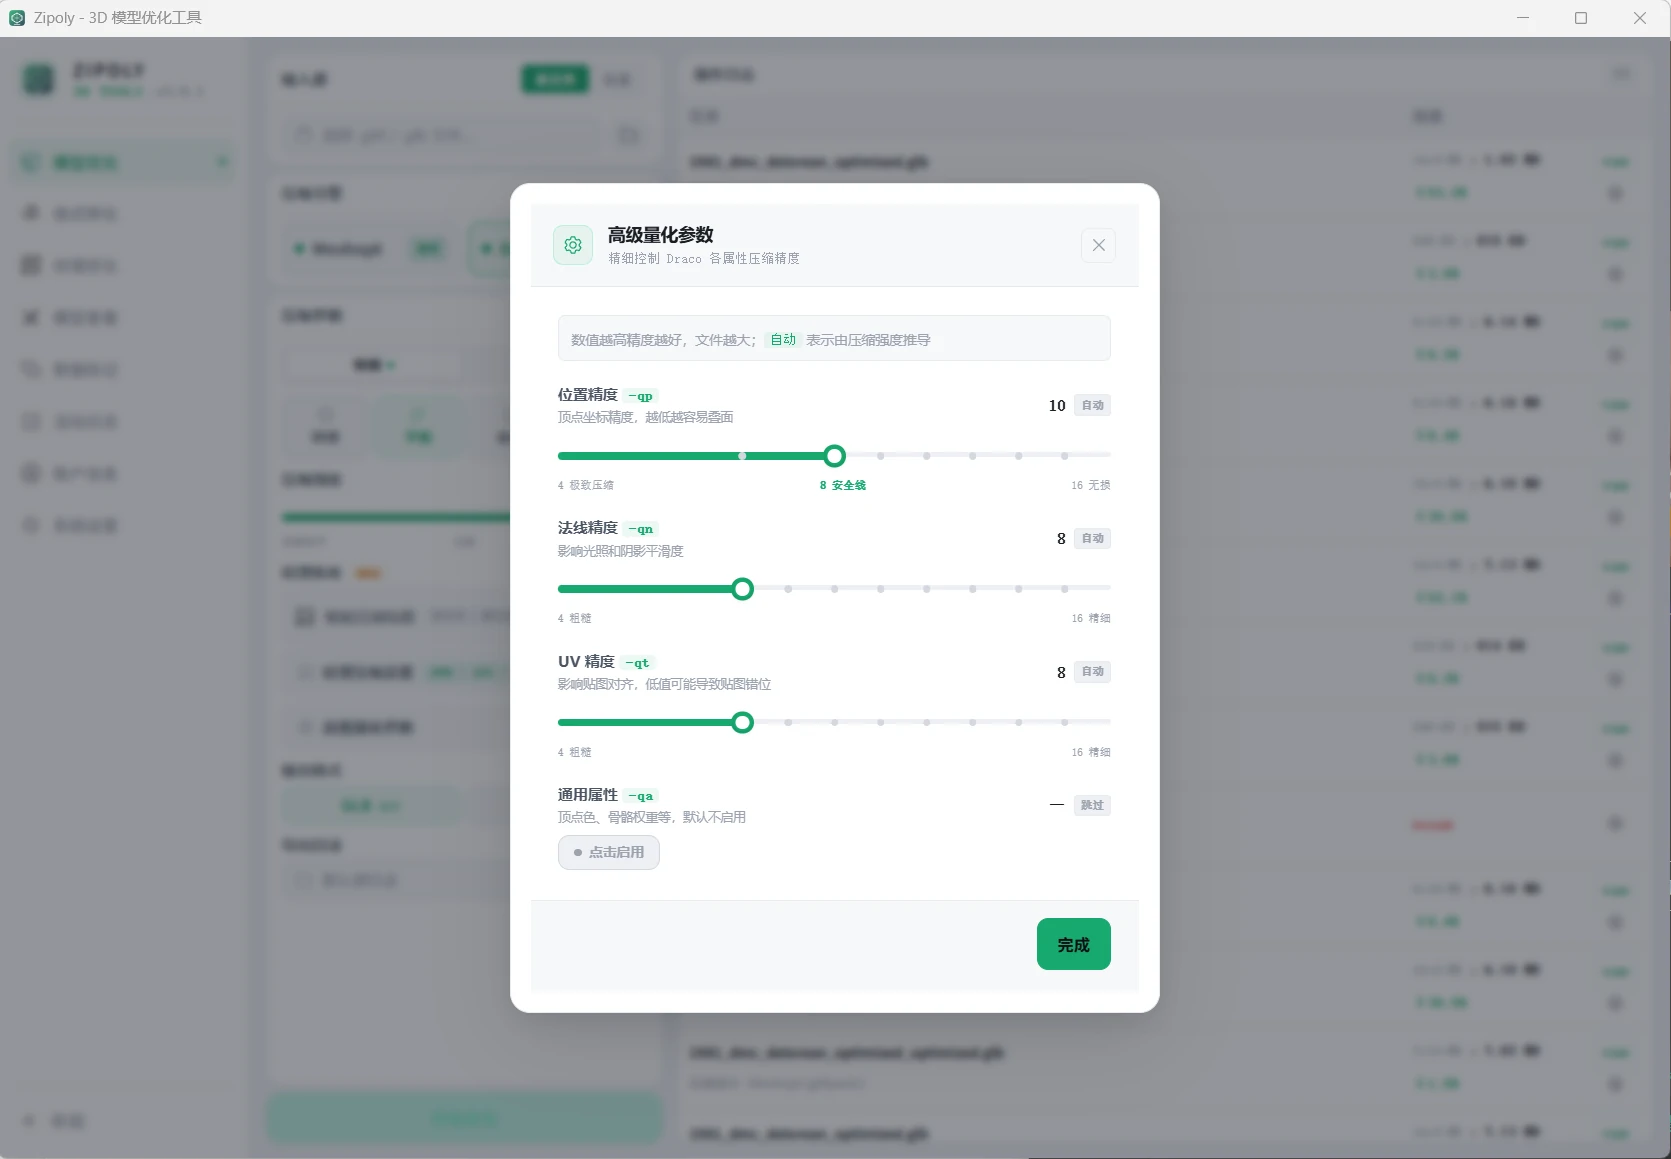
图注:Zipoly 高级量化参数:位置 / 法线 / UV 精度各 4-16 bit 可调,精度越高文件越大
看一个真实量级
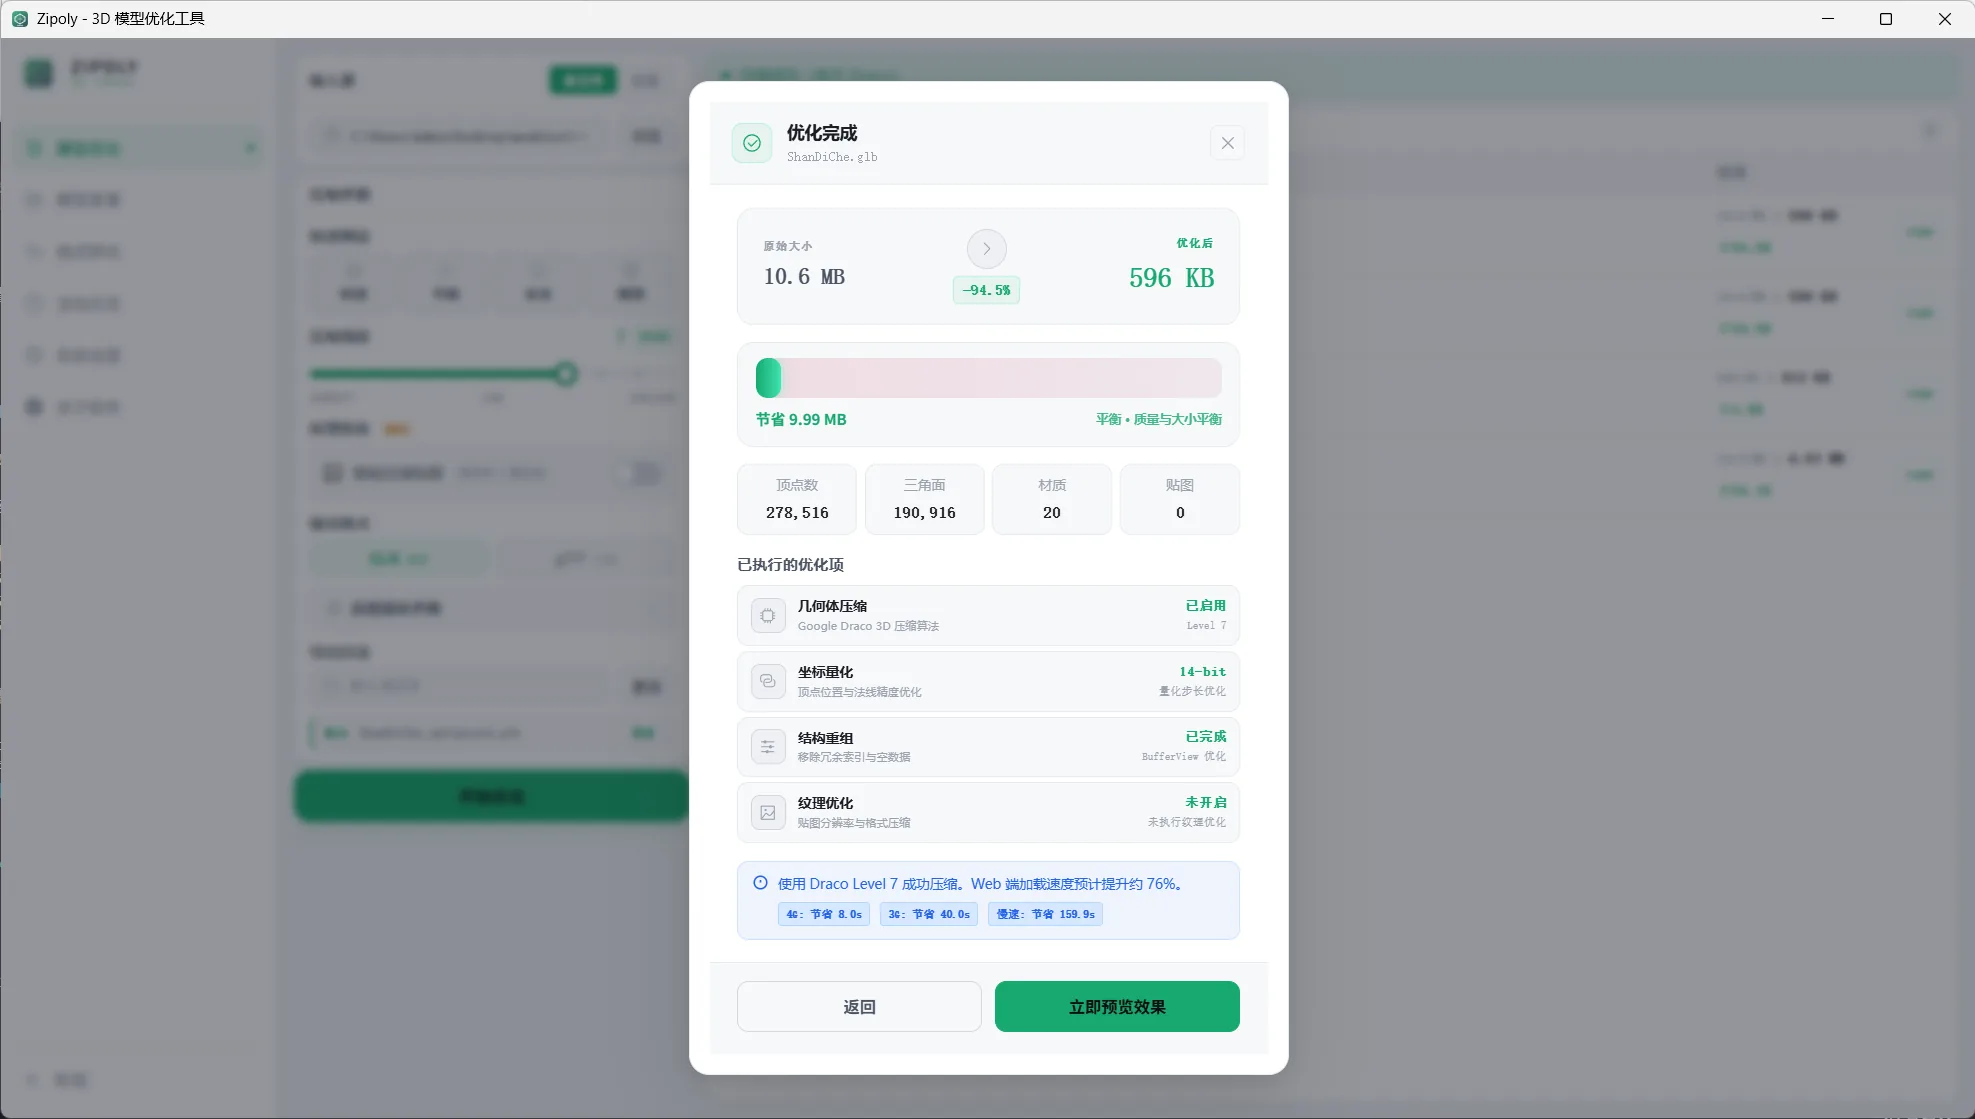
图注:Zipoly v2.1.0 实测:ShanDiChe.glb 用 Draco Level 7 压到 596 KB(-94.5%),提示 Web 端提速约 76%
ShanDiChe.glb:10.6 MB,27.8 万顶点 / 19 万三角面 / 20 材质,压到 596 KB,省 94.5%。弹窗里列的三行要看清楚------Draco Level 7 几何压缩、14-bit 坐标量化、结构重组,纹理优化那行是关的。也就是说,这 94.5% 是三件事叠加出来的。
动手前先看大头在哪
「太大」有两种:面数堆出来的、贴图堆出来的。判断方法很轻------查看器打开看统计,顶点、三角面、材质数、总大小都在一屏里。面数只有几万却上十 MB,那体积基本花在贴图上,该动的是纹理那一档而不是几何(Zipoly 官网 / 公开信息)。
顺带一提,压过的纹理会被自动跳过,日志里「省了 0%」那条不是失败,是告诉你这张已经到头了。
别在这几种情况下折腾
- 面数本身上百万:不减面基本没戏,量化省的字节不够看。
- 已经压过的模型:846 KB → 815 KB,只省 3.6%。再转格式也救不回来,找源文件重跑。
- 单文件超过 50 MB:免费版会直接拦住,60 MB 的模型报 FAILED 并提示升级授权,别跑一半才发现。
先查清楚贴图占比,再决定动哪个旋钮,比上来就把压缩强度拉满靠谱得多。