模型下载全攻略:HuggingFace、hf-mirror、ModelScope 国内实操
本篇解决本地部署第一道坎:模型文件从哪下、怎么下、下了怎么保证没下坏? 国内直连 huggingface.co 时快时慢、动不动连接重置,是新手劝退第一因素。这篇把 HuggingFace 生态结构讲清楚,给 hf-mirror、ModelScope、直链三种可复制命令的国内方案,外加下载验证、断点续传和目录规划。读完你能把几十 GB 的模型稳稳下进非 C 盘的 SSD 里。
一、为什么需要它
本地部署大模型,第一步永远是下载模型 ,而它恰恰是最容易翻车的一步:huggingface.co 在国内访问不稳定,"模型下载慢""HuggingFace 连不上""ModelScope 怎么用" 是搜索量长期居前的词。我见过太多人花一整天卡在一个 4GB 的分片上------其实问题不在耐心,在于没选对源、没配好断点续传 。更典型的翻车姿势是:对着 huggingface.co 的网页直接点下载按钮,浏览器进度条走到 70% 就断,重来一次又是 60% 断,最后气得转投 ModelScope 才发现人家一条命令就下完了。正确的姿势是:用带断点续传的命令行工具 + 选对源,这两件事本篇分别放在第三节和第六节。
更麻烦的是,模型文件动辄十几 GB、拆成十几个分片,下了一半断了、或者下完缺了分片,加载时才报错,此时重新下载代价很大。所以本篇除了给命令,还要给一套"下载后先验证、再加载"的纪律。配合《AI-05 显存计算与模型选择》先选对量化版本(7B 级 fp16 权重约 14-15 GB,Q4 量化约 4-5 GB),下载前心里就有底了。
二、环境要求
| 项目 | 要求 | 检查方式 |
|---|---|---|
| Python | 3.10 / 3.11 / 3.12(建议 3.11) | python --version |
| 网络 | 能访问 hf-mirror.com 或 modelscope.cn 即可 | 浏览器能打开 |
| 磁盘 | SSD 优先;放非 C 盘,预留模型体积 1.5 倍空间 | 磁盘管理 |
| pip 镜像 | 国内建议配清华源,装依赖不折腾 | 见下方命令 |
| 工具 | huggingface-cli 或 modelscope 二选一(本文都讲) | pip show huggingface_hub |
装工具(国内 pip 用清华源):
arduino
pip install -U "huggingface_hub[cli]" -i https://pypi.tuna.tsinghua.edu.cn/simple
pip install modelscope -i https://pypi.tuna.tsinghua.edu.cn/simple预期:两个包都安装成功,huggingface-cli version 能出版本号。如果 pip 本身装得慢,先检查是不是直连了国外 PyPI------换清华源后速度通常是数量级提升。两个工具不冲突,可以都装:huggingface-cli 走 hf-mirror,ModelScope 走阿里源,哪个顺用哪个。
三、下载实操:四种路径
3.1 先懂 HuggingFace 的 repo 结构
一个 HF 模型仓库(repo)通常包含:
- 权重文件 :大模型拆成多个分片(如
model-00001-of-00008.safetensors...model-00008-of-00008.safetensors),外加一个model.safetensors.index.json记录分片索引; - tokenizer 文件 :
tokenizer.json/tokenizer_config.json(词表与分词规则); - 配置文件 :
config.json(模型结构超参数); - 量化版 :很多社区量化权重以
.gguf单文件发布(llama.cpp 家族,Ollama 底层就是它)。
记住一点:权重和 tokenizer 必须来自同一个 repo ,混搭会输出乱码。这也是后面"下载验证"要核对的事。另外注意一个常见误区:HuggingFace 网页上的"Files"标签页显示的是**当前分支(通常是 main)**的全部文件,一个 repo 里可能同时挂着 fp16、int8、多种 GGUF 量化版本,体积加起来远超单个模型。下载前先在文件列表里确认你要的那个文件真实存在、大小符合预期,再用 --include 精确过滤,比"整库拉下来再挑"省心得多。量化后缀(q4_k_m、q5_k_m 等)和参数量要和你《AI-05 显存计算与模型选择》里算好的显存预算对得上。
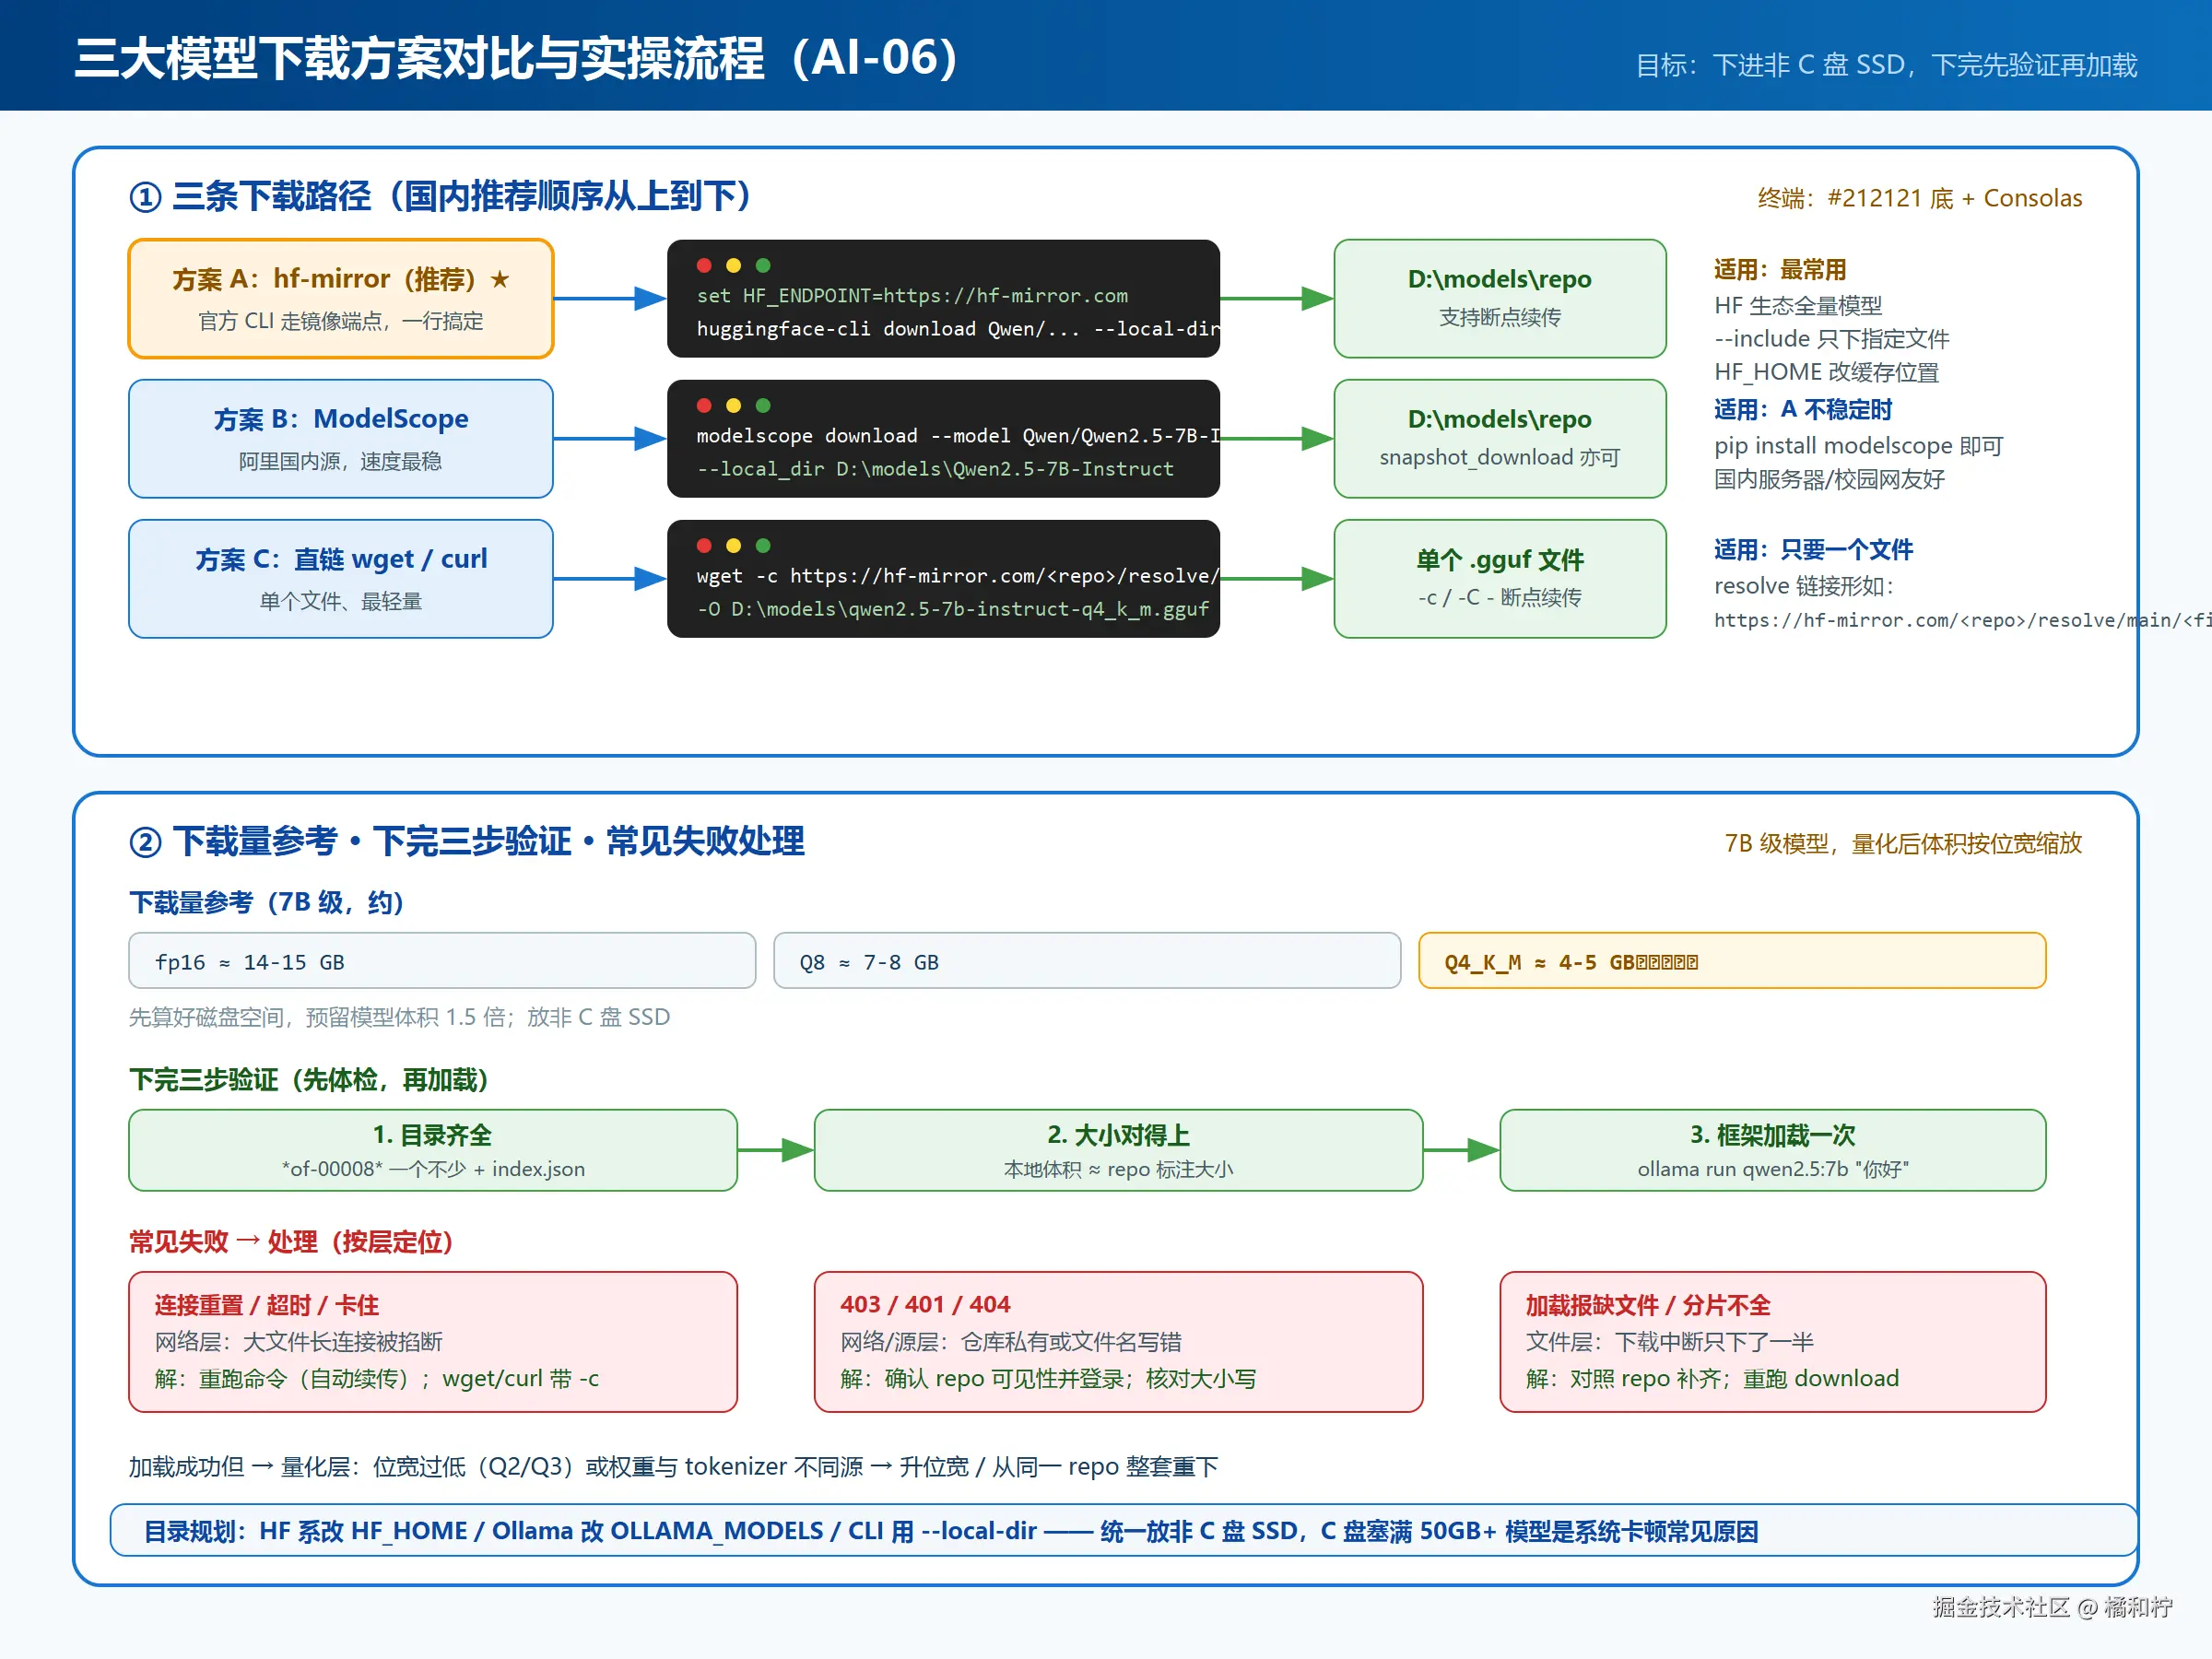
3.2 方案 A:huggingface-cli + hf-mirror(推荐,一行搞定)
huggingface-cli download 是官方下载器,支持 --include(只下指定文件)和 --local-dir(指定落盘目录);缓存目录由环境变量 HF_HOME 控制(Windows 默认 %USERPROFILE%\.cache\huggingface,Linux 默认 ~/.cache/huggingface)。
国内的关键只有一行:把下载端点指向 hf-mirror:
arduino
:: Windows(当前终端生效)
set HF_ENDPOINT=https://hf-mirror.com

:: Linux / WSL
export HF_ENDPOINT=https://hf-mirror.com
然后下模型(以 Qwen2.5-7B-Instruct 为例,落到非 C 盘的 D:\models):
css
huggingface-cli download Qwen/Qwen2.5-7B-Instruct --local-dir D:\models\Qwen2.5-7B-Instruct只要量化文件时用 --include 过滤,省掉 14-15 GB 的 fp16 权重(Q4 文件通常只有 4-5 GB):
css
huggingface-cli download Qwen/Qwen2.5-7B-Instruct-GGUF --include "*.gguf" --local-dir D:\models\Qwen2.5-7B-Instruct-GGUF预期:逐文件显示进度,结束后 D:\models\... 下出现完整文件。重跑同一条命令会自动跳过已完成的文件 ,这是它内置的断点续传。几个高频参数再展开说一遍:--include 支持通配符,"*.gguf" 表示只要 GGUF 量化文件,能帮你省掉十几 GB 的 safetensors;--local-dir 指定的目录会被直接当模型目录用(不是缓存目录),Ollama/llama.cpp 可以直接指向它。如果你不想落盘到自定义目录,也可以不传 --local-dir,让它进 HF_HOME 缓存(Windows 默认 %USERPROFILE%\.cache\huggingface),后续 Python 代码里用 from_pretrained 时会自动命中缓存,但记得定期清缓存防止 C 盘膨胀。
3.3 方案 B:ModelScope(阿里系,国内源)
国内网络下 ModelScope 的速度通常最稳。两种用法:
arduino
pip install modelscope -i https://pypi.tuna.tsinghua.edu.cn/simple命令行:
css
modelscope download --model Qwen/Qwen2.5-7B-Instruct --local_dir D:\models\Qwen2.5-7B-InstructPython API:
java
from modelscope import snapshot_download
snapshot_download('Qwen/Qwen2.5-7B-Instruct', local_dir='./models')
预期:输出分片下载进度,目录结构完整落盘。ModelScope 的 repo 命名与 HuggingFace 不完全一致(组织名可能不同,比如同一模型在两边前缀不同),不确定时直接在 modelscope.cn 上搜模型名,把页面右上角的下载命令复制下来改个 --local_dir 即可。它同样支持中断后重跑续传,行为与 huggingface-cli 一致。
3.4 方案 C:直链 wget / curl(最轻量)
知道 resolve 直链规则后,任意文件都能单独拉。hf-mirror 的 resolve 链接形如 https://hf-mirror.com/<repo>/resolve/main/<file>:
makefile
:: 示例:只拉一个 Q4_K_M GGUF 单文件
wget -c "https://hf-mirror.com/Qwen/Qwen2.5-7B-Instruct-GGUF/resolve/main/qwen2.5-7b-instruct-q4_k_m.gguf" -O D:\models\qwen2.5-7b-instruct-q4_k_m.gguf

:: 或 curl(-L 跟随重定向,-C - 断点续传)
curl -L -C - "https://hf-mirror.com/Qwen/Qwen2.5-7B-Instruct-GGUF/resolve/main/qwen2.5-7b-instruct-q4_k_m.gguf" -o D:\models\qwen2.5-7b-instruct-q4_k_m.gguf
-c / -C - 就是断点续传参数,中断后原命令重跑即可接着下。
3.5 常用模型下载量参考(先算好空间)
| 模型规格 | 下载量(约) |
|---|---|
| 7B fp16 | 14-15 GB |
| 7B Q8 量化 | 7-8 GB |
| 7B Q4 量化(如 Q4_K_M) | 4-5 GB |
更大规格按同一比例放大即可(参数量翻倍,体积约翻倍,再按位宽折半或再翻倍);具体以各 repo 页面标注的文件大小为准。下载前养成一个习惯:先打开 repo 页面看文件列表,把总大小心算一遍,再决定下到哪个盘、选哪个量化。这一步能避免"下到一半发现 D 盘只剩 8G"的尴尬。
四、验证:下完先体检再加载
- 看目录 :分片是否齐全(
*of-00008*一个不能少,且index.json在);.gguf场景则确认只有一个完整的.gguf文件; - 对大小:把本地文件体积和 repo 文件列表页标的大小对一遍,明显偏小就是中断残留;
- 走框架加载一次(真正试金石):
arduino
ollama list
ollama run qwen2.5:7b "你好,用一句话自我介绍"
预期:模型正常加载并输出通顺中文。若加载报 connection reset by peer,说明下载没完成,回到断点续传重跑即可;若加载成功但输出乱码/重复,多半是权重与 tokenizer 不同源,见第六节第 4 条。
验证通过的标准很简单:能加载、输出通顺、速度符合预期(GPU 上 7B Q4 一般远快于每 token 一秒,慢到个位数 tokens/s 就要怀疑 offload 占比太高或框架没吃到 GPU)。三项都满足,这个模型才算"入库",可以安心接到 OpenWebUI、Dify 这类前端工具后面用。
五、进阶技巧
- 目录规划 :模型统一放非 C 盘的 SSD(如
D:\models);Ollama 用户可用环境变量OLLAMA_MODELS把模型库搬走(Windows 默认在%USERPROFILE%\.ollama\models);HF 系改HF_HOME。C 盘塞满 50GB+ 模型是系统卡顿的常见原因。 - 长连接保护 :大文件下载开着路由器别断电;公司/校园网若限速,换家庭网络或错峰(凌晨)下载。多文件 repo 建议顺序下载而不是开多个窗口并行------单条连接跑满带宽通常比多条互相抢带宽更稳,也更容易断点续传。
- 只下需要的文件 :跑 GGUF 就不要整个 repo 全拉(
--include "*.gguf");只想要 tokenizer 也同理。省下的带宽和空间都很可观。 - 下载完成后立刻验证,别等要用的那天才发现缺分片------那时你大概率忘了用的是哪个量化版本。验证通过后再把模型接入 Ollama(详见《AI-07 Ollama本地部署大模型》)或 llama.cpp(详见《AI-12 llama.cpp与GGUF格式》),流程就顺了。
六、故障排查(按层定位)
| # | 症状(报错原文) | 层 | 原因 | 解决 |
|---|---|---|---|---|
| 1 | HuggingFace 下载卡住 / ConnectionError / 超时 |
网络 | 国内直连 huggingface.co 受限 | set HF_ENDPOINT=https://hf-mirror.com(Windows)或 export HF_ENDPOINT=https://hf-mirror.com(Linux);或改走 ModelScope |
| 2 | 大文件下载中途断(连接重置/超时) | 网络 | 大文件长连接被掐断 | 重跑原命令:huggingface-cli download 自动跳过已完成分片;wget/curl 带 -c / -C - 续传;Ollama 场景重新 ollama pull 即可续传 |
| 3 | 下载报 403 / 401 或文件被 404 | 网络/源 | 仓库私有或需要登录,或文件名写错 | 私有 repo 先在 HF 网页确认可见性并登录;核对文件名大小写(resolve 链接区分大小写) |
| 4 | 模型加载成功但输出乱码、重复 | 文件 | 权重与 tokenizer 不匹配(混源) | 删除后从同一个 repo 重新下载整套文件 |
| 5 | 加载时报缺文件 / 分片缺失 | 文件 | 下载中断只下了部分分片 | 对照 repo 文件列表补齐缺失分片;重跑 download 命令 |
| 6 | pip install modelscope / huggingface_hub 失败 |
依赖 | 直连 PyPI 慢 | 加清华源 -i https://pypi.tuna.tsinghua.edu.cn/simple 重装 |
| 7 | 磁盘空间不足(C 盘爆满) | 磁盘 | 模型默认落盘 C 盘缓存目录 | HF_HOME / --local-dir / OLLAMA_MODELS 指向非 C 盘 SSD |
七、本篇自检清单
- 能说出 HF repo 的结构:权重分片 + tokenizer + config,且必须同 repo
- 会配
HF_ENDPOINT=https://hf-mirror.com并用huggingface-cli download --local-dir下载到指定目录 - 会用 ModelScope(CLI 与 Python API 两种)作为国内备选源
- 会拼 hf-mirror resolve 直链,wget/curl 带断点续传参数
- 知道 7B fp16 约 14-15 GB、Q4 约 4-5 GB,下载前会先核对磁盘空间
- 下载后做过三步验证:目录齐全、大小对得上、框架能加载
- 模型目录已放到非 C 盘 SSD
参考
- Hugging Face Hub 文档(huggingface-cli / HF_HOME):huggingface.co/docs/hub
- hf-mirror 镜像站:hf-mirror.com
- ModelScope 模型库与文档:modelscope.cn
- 清华 PyPI 镜像:pypi.tuna.tsinghua.edu.cn