✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍(约300字)
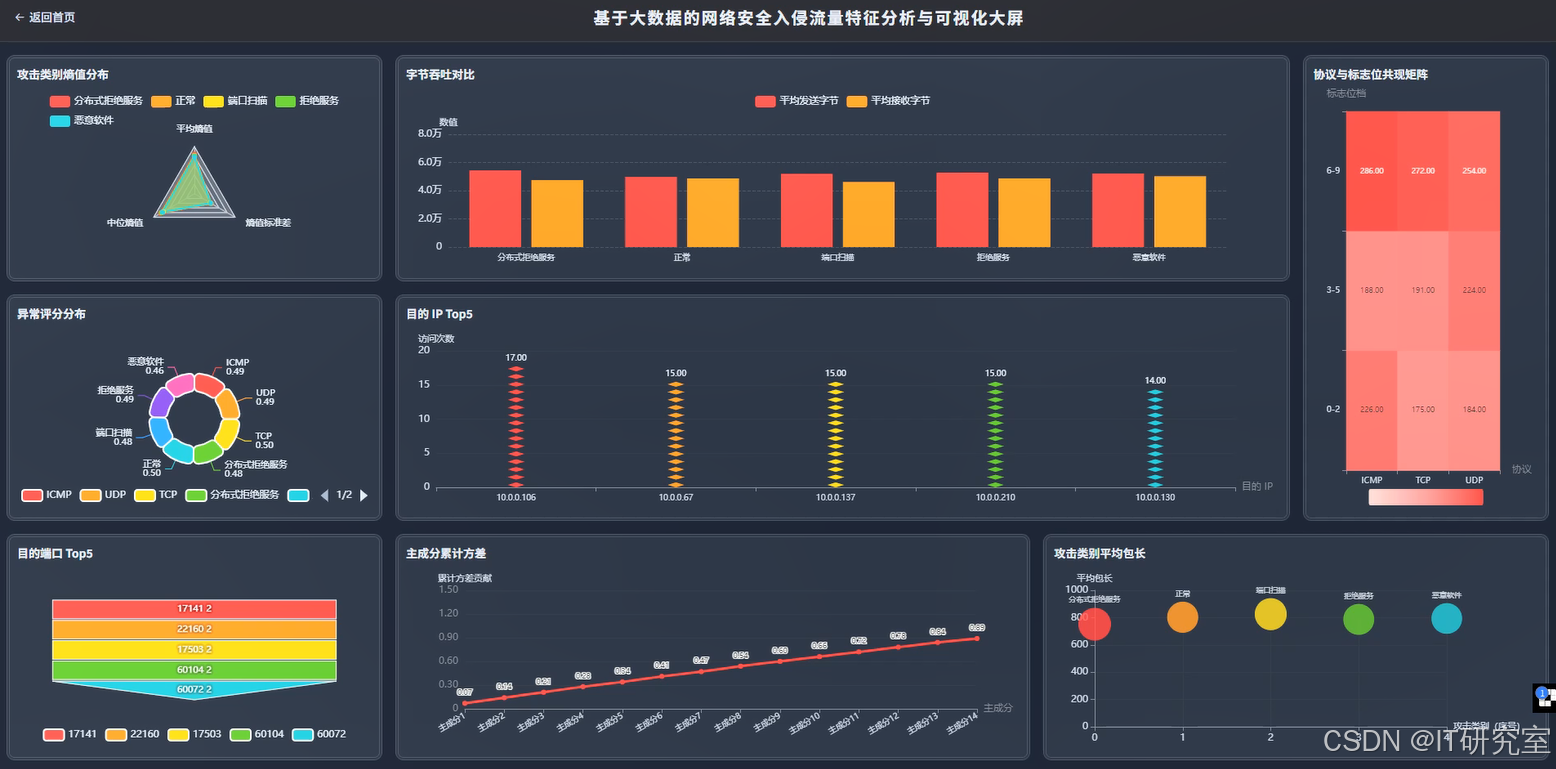
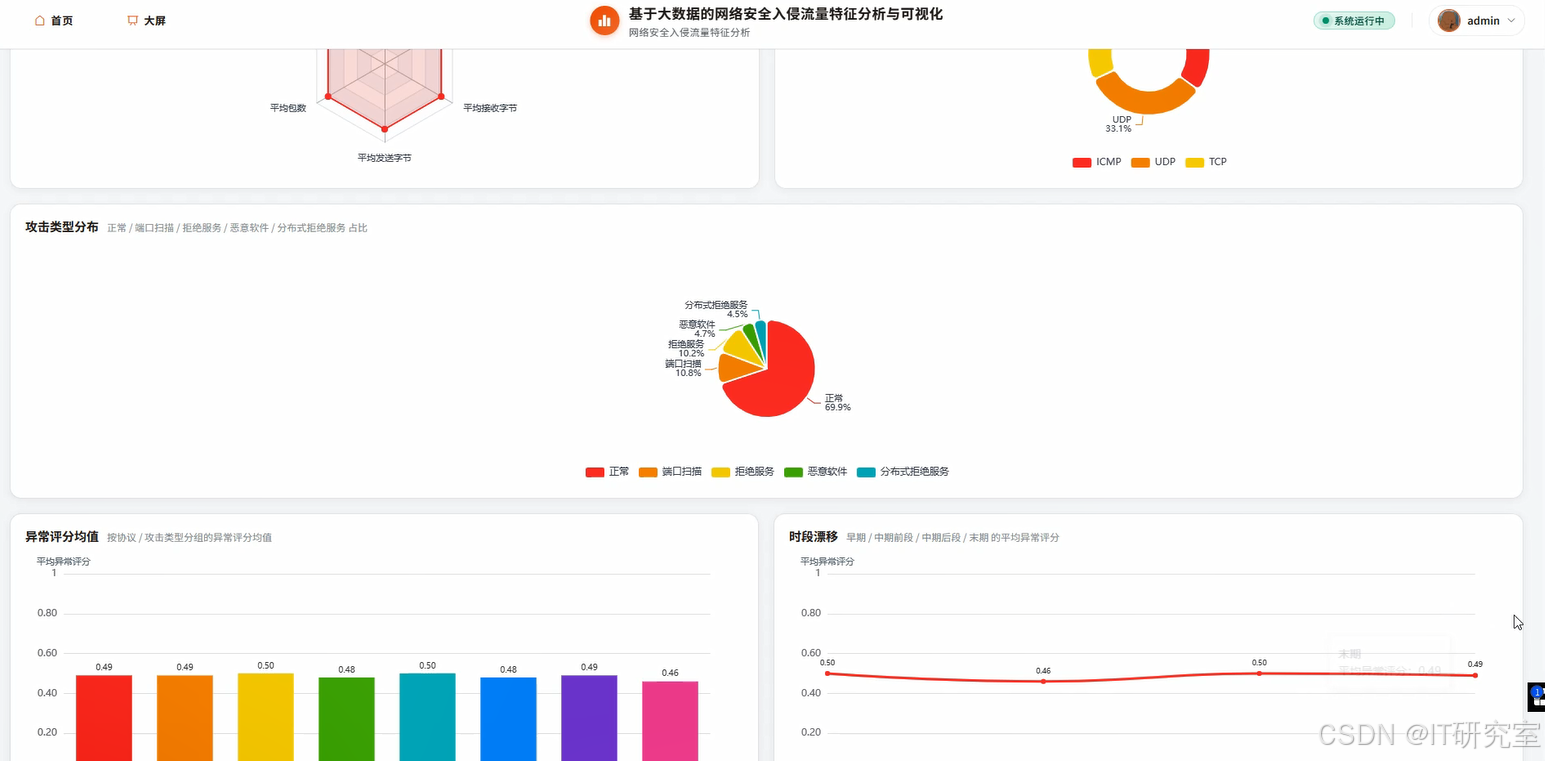
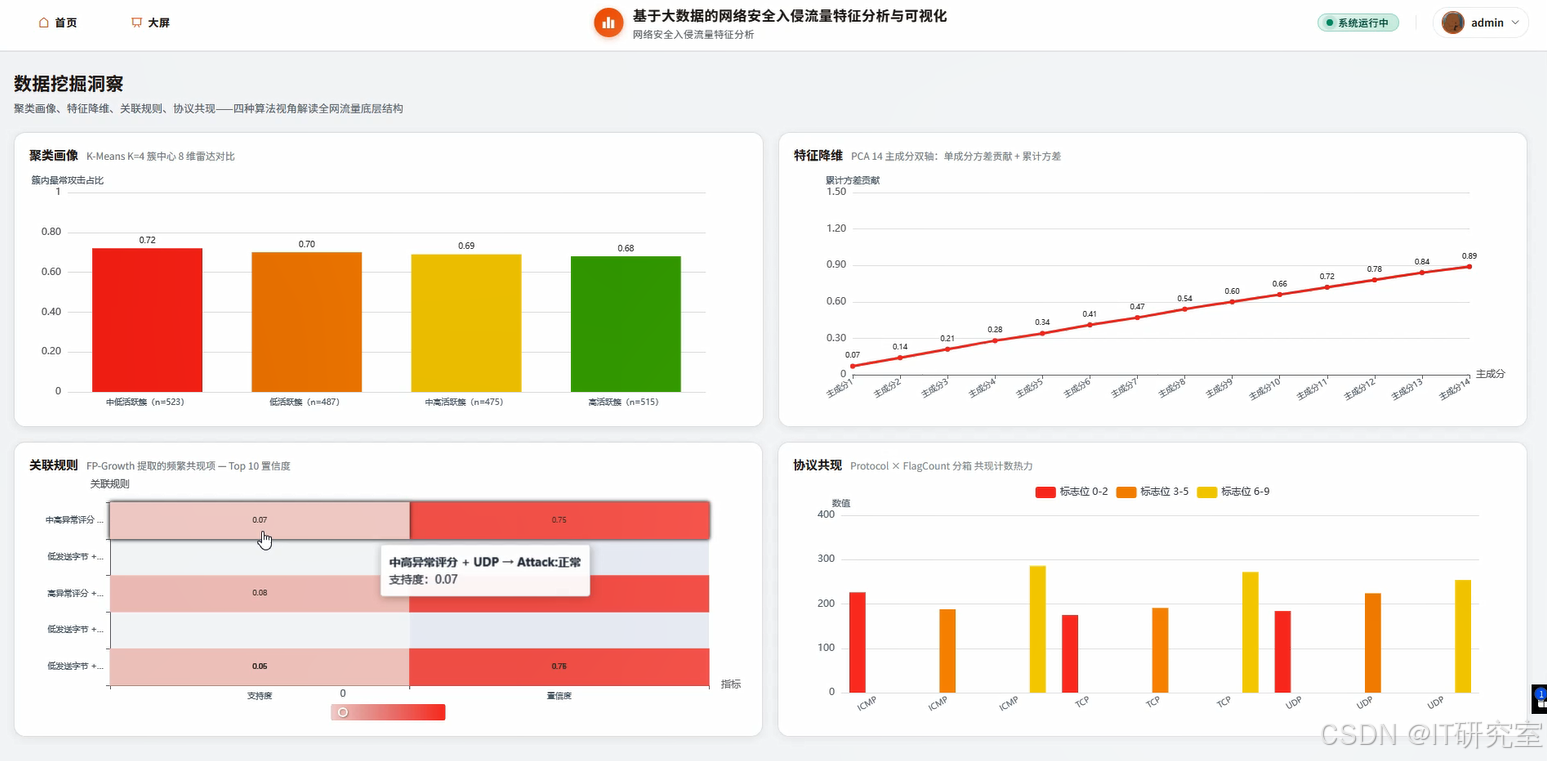
《基于大数据的网络安全入侵流量特征分析与可视化》系统是一套面向毕设场景的大数据处理应用,核心围绕Hadoop分布式存储与Spark内存计算引擎构建,支持Python(Django)与Java(Spring Boot)双版本后端切换,前端采用Vue框架配合ECharts图表库实现交互式大屏展示。系统聚焦于网络流量数据的采集、清洗、特征提取与威胁建模,底层以HDFS承载原始PCAP或日志格式的流量数据,借助Spark SQL和Pandas进行会话聚合、协议分布统计及异常特征指标计算,并将结果持久化至MySQL数据库。功能模块涵盖网络流量总览、威胁画像、数据挖掘洞察、可视化大屏及数据管理五大板块,其中威胁画像基于多维度特征(源IP、目的端口、包长度、时间窗口内请求频次)生成行为标签,数据挖掘部分采用Spark MLlib中的聚类或分类算法辅助发现潜在攻击模式。可视化大屏聚合了实时流量趋势、威胁等级分布、地理来源热力等图表,最终形成一个从数据导入、特征工程到风险识别与结果展示的相对完整的技术闭环,可用于验证大数据技术在网络安全场景下的可行性。
选题背景(约250字)
当前校园网、企业办公网乃至云环境中的网络攻击手段持续翻新,入侵行为往往隐藏在大量正常流量之中,传统基于规则库的防火墙或IDS系统难以有效识别低频慢速攻击或变形变种威胁。与此同时,大数据处理技术日趋成熟,Hadoop、Spark等框架为海量日志的离线批处理和迭代计算提供了低成本、高扩展性的解决方案。网络安全领域逐步意识到,单点检测已无法应对复杂对抗场景,需要结合流量时序特征、行为统计特征和上下文关联信息进行综合判定。毕业设计阶段,许多计算机专业学生虽然掌握了编程基础和数据库知识,却缺乏将大数据工具与具体安全分析需求结合起来的实践训练,不知道如何设计特征工程、如何搭建可视化分析链路,也难以在有限硬件资源下处理真实流量数据。由此催生一个现实问题:如何构建一个既贴近实际入侵检测逻辑,又能在单机或小集群上流畅运行的大数据分析原型系统,本课题正是基于上述背景展开探索。
选题意义(约250字)
从实际应用角度看,本系统为校园小型网络或实验环境提供了一套可落地的流量分析工具,管理员能够通过威胁画像模块快速锁定可疑IP段,减少人工翻阅日志的盲目性。可视化大屏将抽象的数字指标转化为直观图表,降低了非专业人员理解安全态势的门槛,有助于日常巡检或应急响应。从教学训练角度出发,系统代码完整覆盖了数据导入、分布式计算、特征提取、结果存储和前端展示的全链路,后续学生可将其作为参考范本,学习如何用Spark替代单机脚本处理较大规模数据,也能在此基础上修改分类模型或增加新的特征维度。对于毕设本身,该系统强调工程实现与业务逻辑的紧密结合,每个功能模块都对应明确的输入输出,没有设置过度复杂的算法,保证了在有限开发周期内的可完成性,同时预留了替换数据源和调整阈值的灵活接口,方便指导教师根据实际需求进行课题扩展。整体而言,本系统的意义更多体现在辅助理解和降低重复劳动层面,远谈不上替代专业安全产品。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
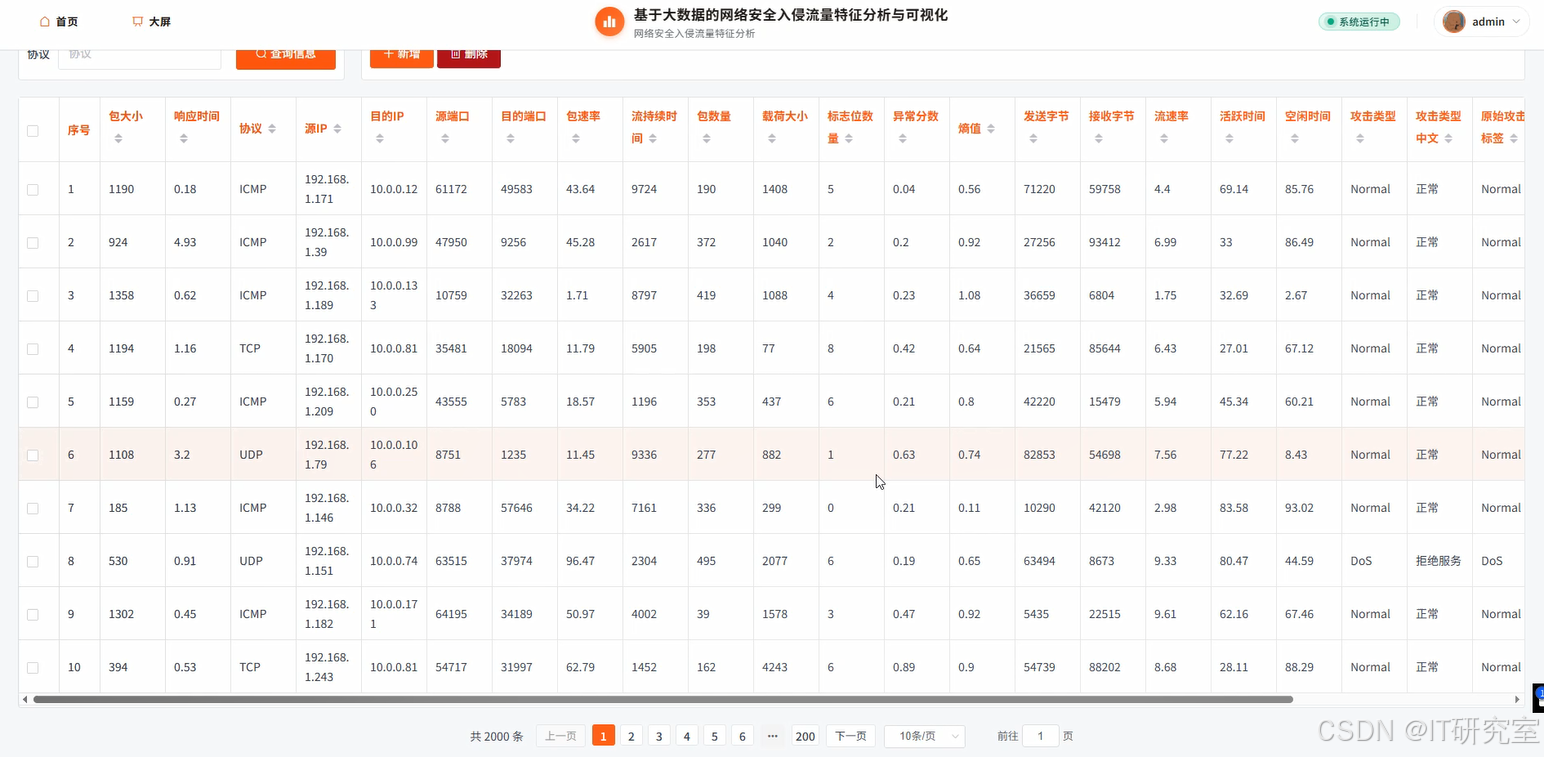
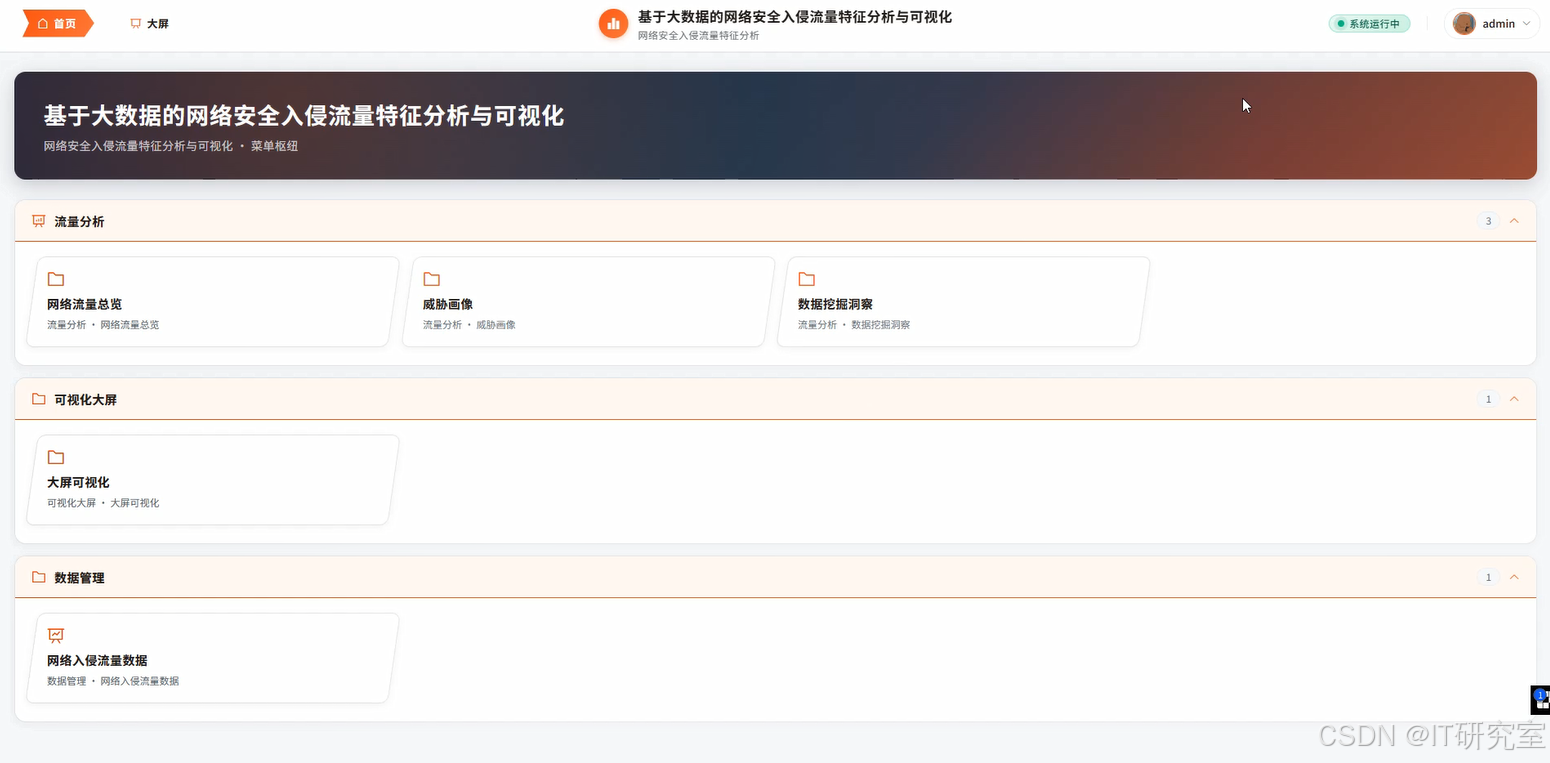
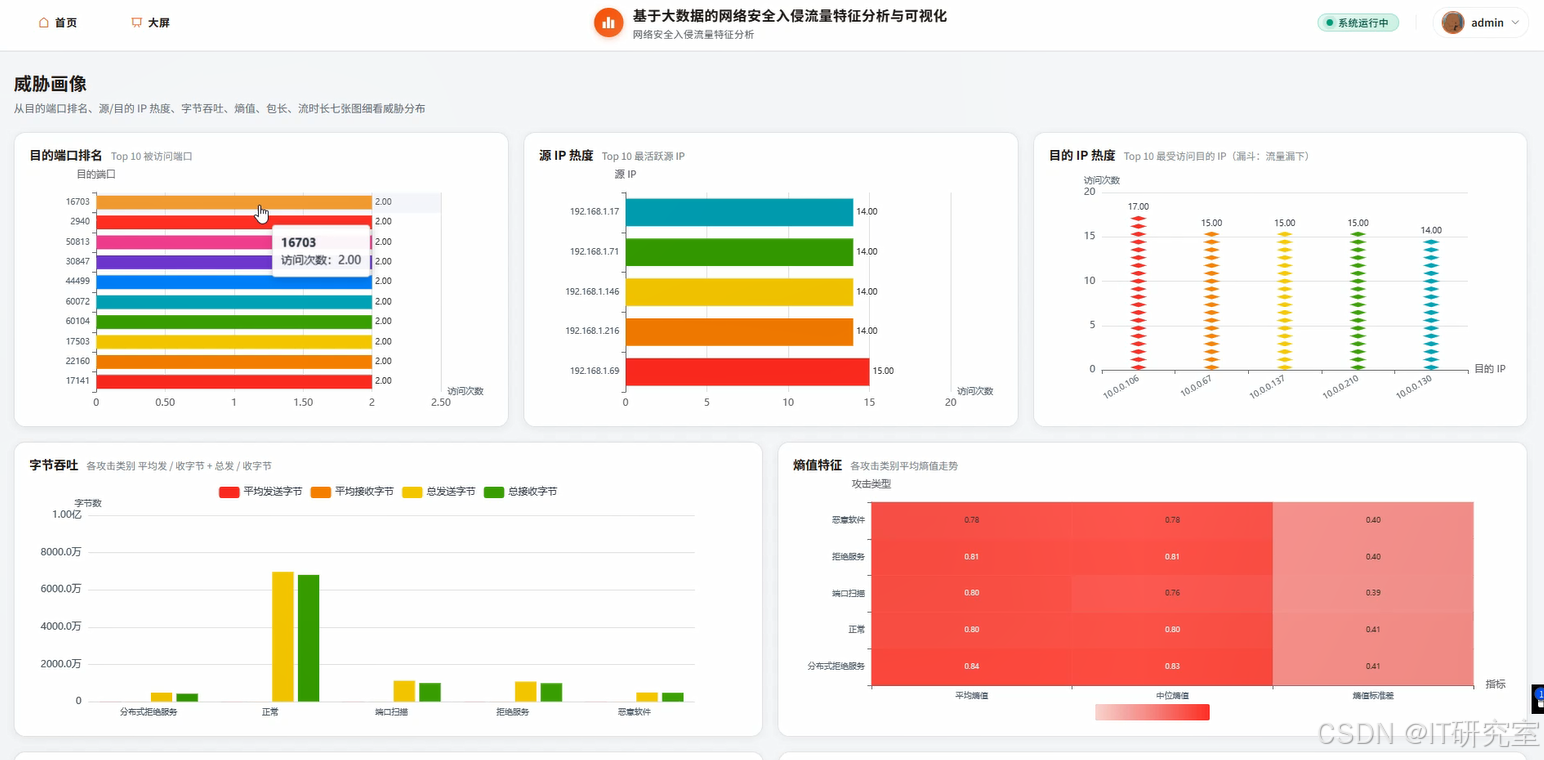
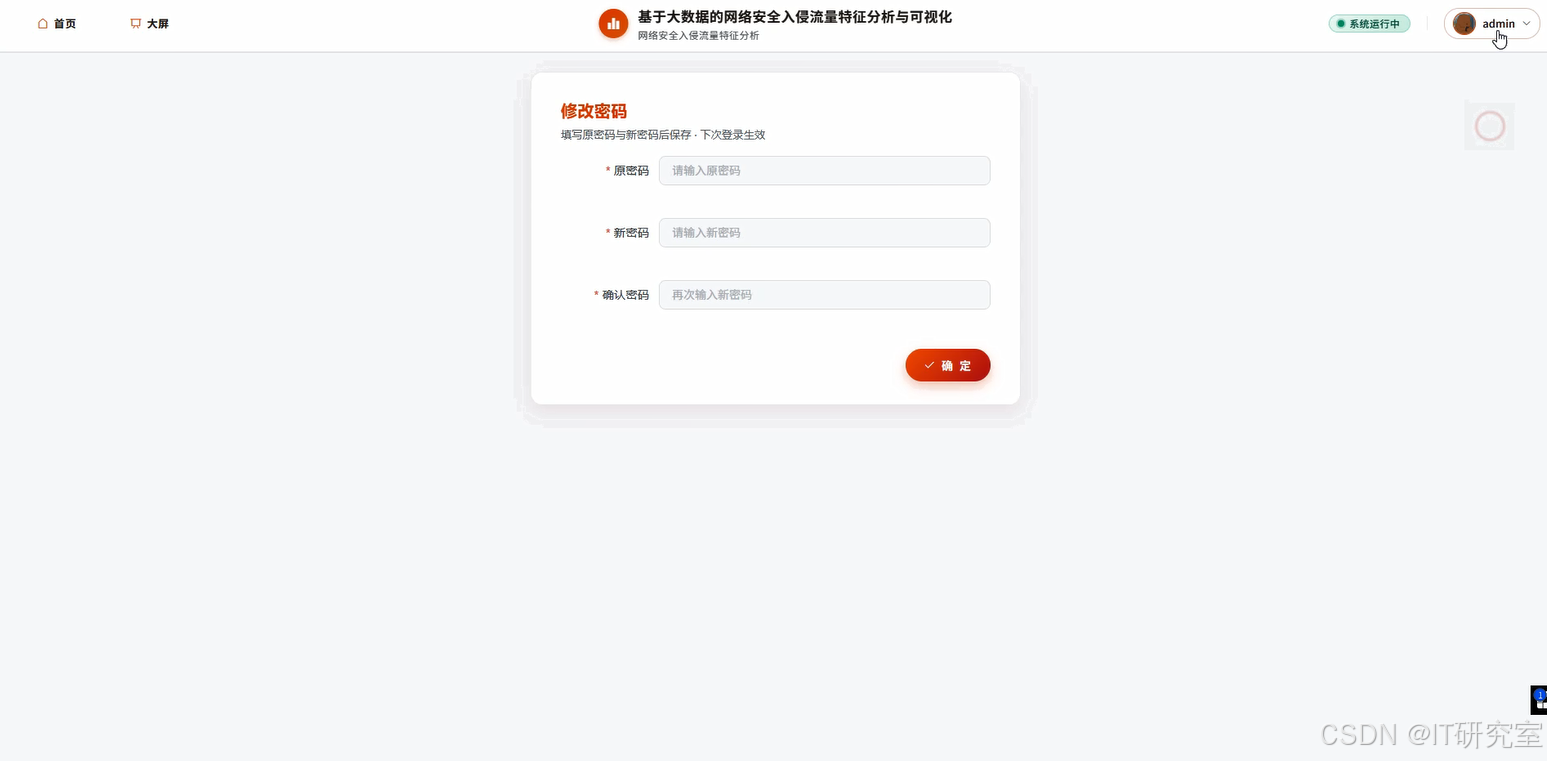
-基于大数据的网络安全入侵流量特征分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, sum as spark_sum, avg, when, to_timestamp, hour, window, approx_count_distinct
spark = SparkSession.builder.appName("TrafficFeatureAnalysis").config("spark.sql.shuffle.partitions", "4").master("local[*]").getOrCreate()
# 功能1:网络流量总览------按协议统计会话数、字节总量及平均包长
def get_traffic_overview():
    df = spark.read.parquet("hdfs://localhost:9000/traffic/parquet")
    df_clean = df.filter(col("bytes") > 0).filter(col("protocol").isNotNull())
    df_with_time = df_clean.withColumn("time_hour", hour(to_timestamp(col("timestamp"), "yyyy-MM-dd HH:mm:ss")))
    overview = df_with_time.groupBy("protocol").agg(
        count("session_id").alias("session_count"),
        spark_sum("bytes").alias("total_bytes"),
        avg("packet_len").alias("avg_packet_len"),
        approx_count_distinct("src_ip").alias("unique_src")
    )
    overview_pd = overview.toPandas()
    return {"data": overview_pd.to_dict(orient="records"), "total_sessions": overview_pd["session_count"].sum()}
# 功能2:威胁画像------基于高频请求、小字节和长周期生成威胁标签
def generate_threat_profile():
    raw = spark.read.parquet("hdfs://localhost:9000/traffic/parquet")
    raw_filter = raw.filter(col("src_ip").isNotNull()).filter(col("dst_port") > 0)
    windowed = raw_filter.groupBy("src_ip", window(to_timestamp(col("timestamp"), "yyyy-MM-dd HH:mm:ss"), "5 minutes")).agg(
        count("*").alias("req_count"),
        avg("packet_len").alias("avg_len"),
        approx_count_distinct("dst_ip").alias("unique_dst")
    )
    threat = windowed.withColumn(
        "threat_level",
        when((col("req_count") > 200) & (col("avg_len") < 80), "high")
        .when((col("req_count") > 100) & (col("unique_dst") > 10), "medium")
        .otherwise("low")
    )
    threat_filter = threat.filter(col("threat_level") != "low")
    threat_filter.cache()
    result = threat_filter.groupBy("threat_level").agg(count("src_ip").alias("ip_count")).toPandas().to_dict(orient="records")
    top_ip = threat_filter.orderBy(col("req_count").desc()).select("src_ip", "req_count", "avg_len").limit(10).toPandas().to_dict(orient="records")
    return {"threat_stats": result, "suspicious_top": top_ip}
# 功能3:数据挖掘洞察------用聚类探查异常流量簇(简化版距离计算)
def get_mining_insights():
    source = spark.read.parquet("hdfs://localhost:9000/traffic/parquet")
    sample = source.select("src_ip", "bytes", "packet_len", "duration").filter(col("duration") > 0).filter(col("bytes") > 0).limit(5000)
    sample_agg = sample.groupBy("src_ip").agg(
        avg("bytes").alias("avg_bytes"),
        avg("packet_len").alias("avg_pkt"),
        avg("duration").alias("avg_dur"),
        count("*").alias("freq")
    ).filter(col("freq") > 5)
    from pyspark.ml.feature import VectorAssembler, StandardScaler
    assembler = VectorAssembler(inputCols=["avg_bytes", "avg_pkt", "avg_dur", "freq"], outputCol="raw_features")
    vector_df = assembler.transform(sample_agg)
    scaler = StandardScaler(inputCol="raw_features", outputCol="scaled_features", withStd=True, withMean=True)
    scaler_model = scaler.fit(vector_df)
    scaled_df = scaler_model.transform(vector_df)
    from pyspark.ml.clustering import KMeans
    kmeans = KMeans(featuresCol="scaled_features", k=3, seed=42, maxIter=10)
    model = kmeans.fit(scaled_df)
    clustered = model.transform(scaled_df)
    cluster_summary = clustered.groupBy("prediction").agg(avg("avg_bytes").alias("cluster_avg_bytes"), avg("avg_pkt").alias("cluster_avg_pkt"), count("*").alias("size"))
    output = cluster_summary.toPandas().to_dict(orient="records")
    return {"clusters": output, "k": 3}
五、系统视频
基于大数据的网络安全入侵流量特征分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的网络安全入侵流量特征分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇