1. 前言
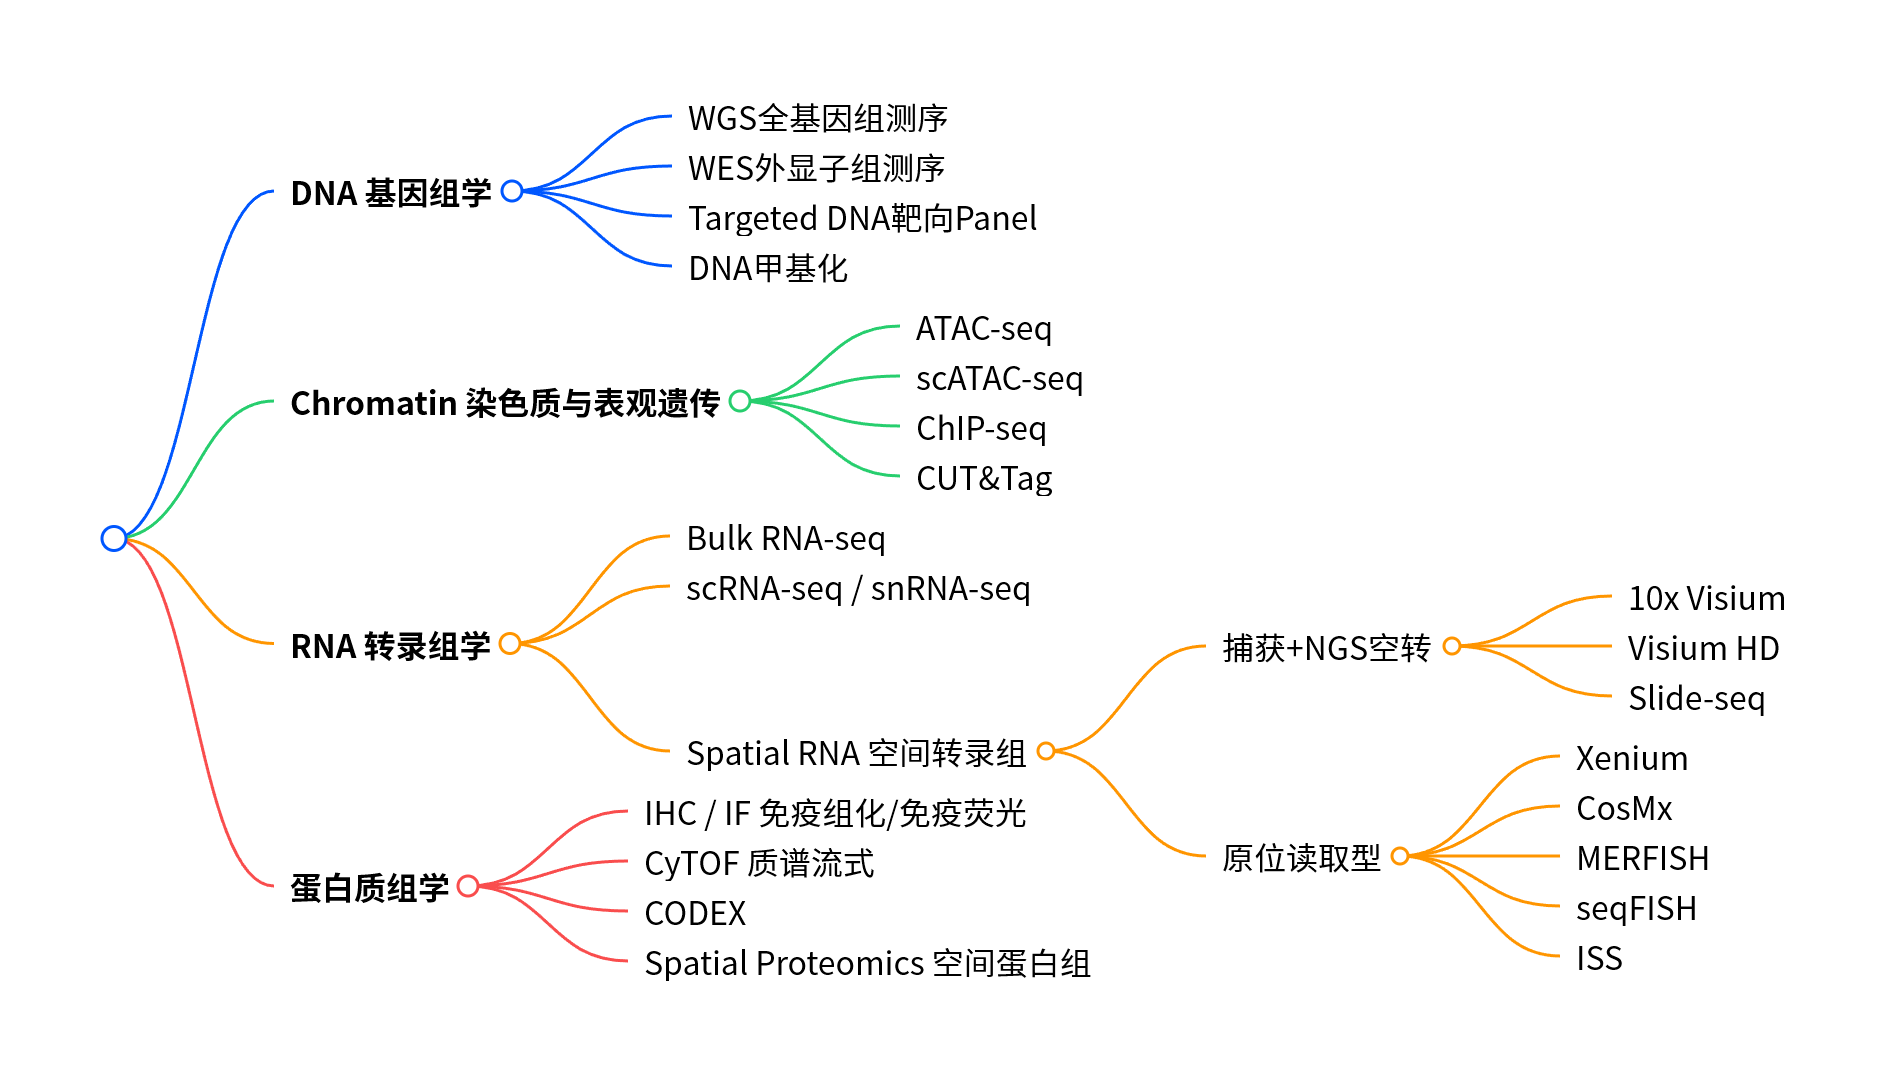
组学(Omics)技术------从 DNA、RNA、蛋白质乃至表观遗传等多个层面,全面揭示生命活动的分子机制。
内容:系统梳理 DNA 基因组学、Chromatin、RNA 转录组学、蛋白质组学以及 Multi-omics 五大方向的核心概念、技术手段与应用场景。
7类RNA技术比较
| 技术 | 测什么 | 空间位置 | 分辨率 | 基因范围 | 典型输出 |
|---|---|---|---|---|---|
| Bulk RNA-seq | RNA | ❌ | 整块组织 | 全转录组 | gene × sample |
| scRNA-seq | RNA | ❌ | 单细胞 | 全转录组 | gene × cell |
| snRNA-seq | 核RNA | ❌ | 单核 | 全转录组 | gene × nucleus |
| Visium类 ST | RNA | ✅ | spot/近细胞级 | 全转录组 | gene × spatial spot |
| Visium HD等 | RNA | ✅ | μm级bin | 全转录组 | gene × spatial bin |
| Xenium/MERFISH | RNA | ✅ | 单分子/单细胞 | 通常靶向panel | transcript坐标 |
| scATAC-seq | 开放染色质 | ❌ | 单细胞核 | 全基因组 | peak × cell |
Notes:"空间分辨率高"≠"检测基因多"≠"检测灵敏度高"。
-
例如 Xenium 可以知道:
某一个 RNA 分子
↓
是什么基因
↓
位于哪个 x,y 坐标
↓
属于哪个细胞
但它通常不是传统意义上无偏的全转录组检测。
而 Visium 可以做更广泛的转录组检测,但传统 Visium 一个 spot 可能覆盖多个细胞 。
10x 官方目前也明确把 Chromium、Visium 和 Xenium分别定位为 single-cell、whole-transcriptome spatial 和 targeted in-situ spatial;Xenium目前可针对最高约数千基因进行检测。
2. DNA 基因组学
DNA 基因组学(Genomics)是研究生物体全部遗传信息(即基因组)的结构、功能与进化的学科。其核心目标是获取并解析物种的完整 DNA 序列,进而定位基因、注释功能、发现变异。
主要技术手段:
- 全基因组测序(WGS):对个体全部 DNA 进行测序,用于变异检测与遗传病研究。
- 全外显子组测序(WES):聚焦蛋白编码区,成本更低,适合大规模人群筛查。
- 单核苷酸多态性(SNP)芯片:用于群体遗传学与关联分析。
应用场景涵盖肿瘤基因组学、罕见病诊断、农业育种以及微生物组研究等。
3. Chromatin组学
Chromatin(染色质)是 DNA 与组蛋白等蛋白质结合形成的复合结构,是表观遗传调控的核心载体。Chromatin 研究关注 DNA 的包装状态、可及性以及组蛋白修饰如何影响基因表达。
关键技术包括:
- ATAC-seq:检测染色质开放区域,定位调控元件。
- ChIP-seq:鉴定特定转录因子或组蛋白修饰在全基因组上的结合位点。
- Hi-C:解析染色质三维空间结构,揭示远距离调控关系。
这些技术帮助研究者理解细胞分化、发育以及疾病发生过程中的基因调控网络。
4. RNA 转录组学
RNA 转录组学(Transcriptomics)研究细胞或组织在特定状态下全部 RNA 的种类、结构与表达水平,是连接基因组与蛋白质组的桥梁。
常用方法:
- RNA-seq:基于高通量测序定量基因表达,发现差异表达基因与可变剪接事件。
- 单细胞 RNA-seq(scRNA-seq):在单细胞分辨率下解析转录异质性,绘制细胞图谱。
- 空间转录组学 :将基因表达信息映射到组织空间位置,揭示细胞微环境。
转录组学广泛应用于疾病标志物筛选、药物响应预测以及发育生物学研究。
4.1. Bulk RNA-seq/ scRNA-seq/snRNA-seq
单细胞 RNA 测序(scRNA-seq)是一种研究样本中每个独立细胞全转录组基因表达谱的方法。如果将批量读取比作眺望整片森林,那么单细胞读取就如同看清每一棵树。
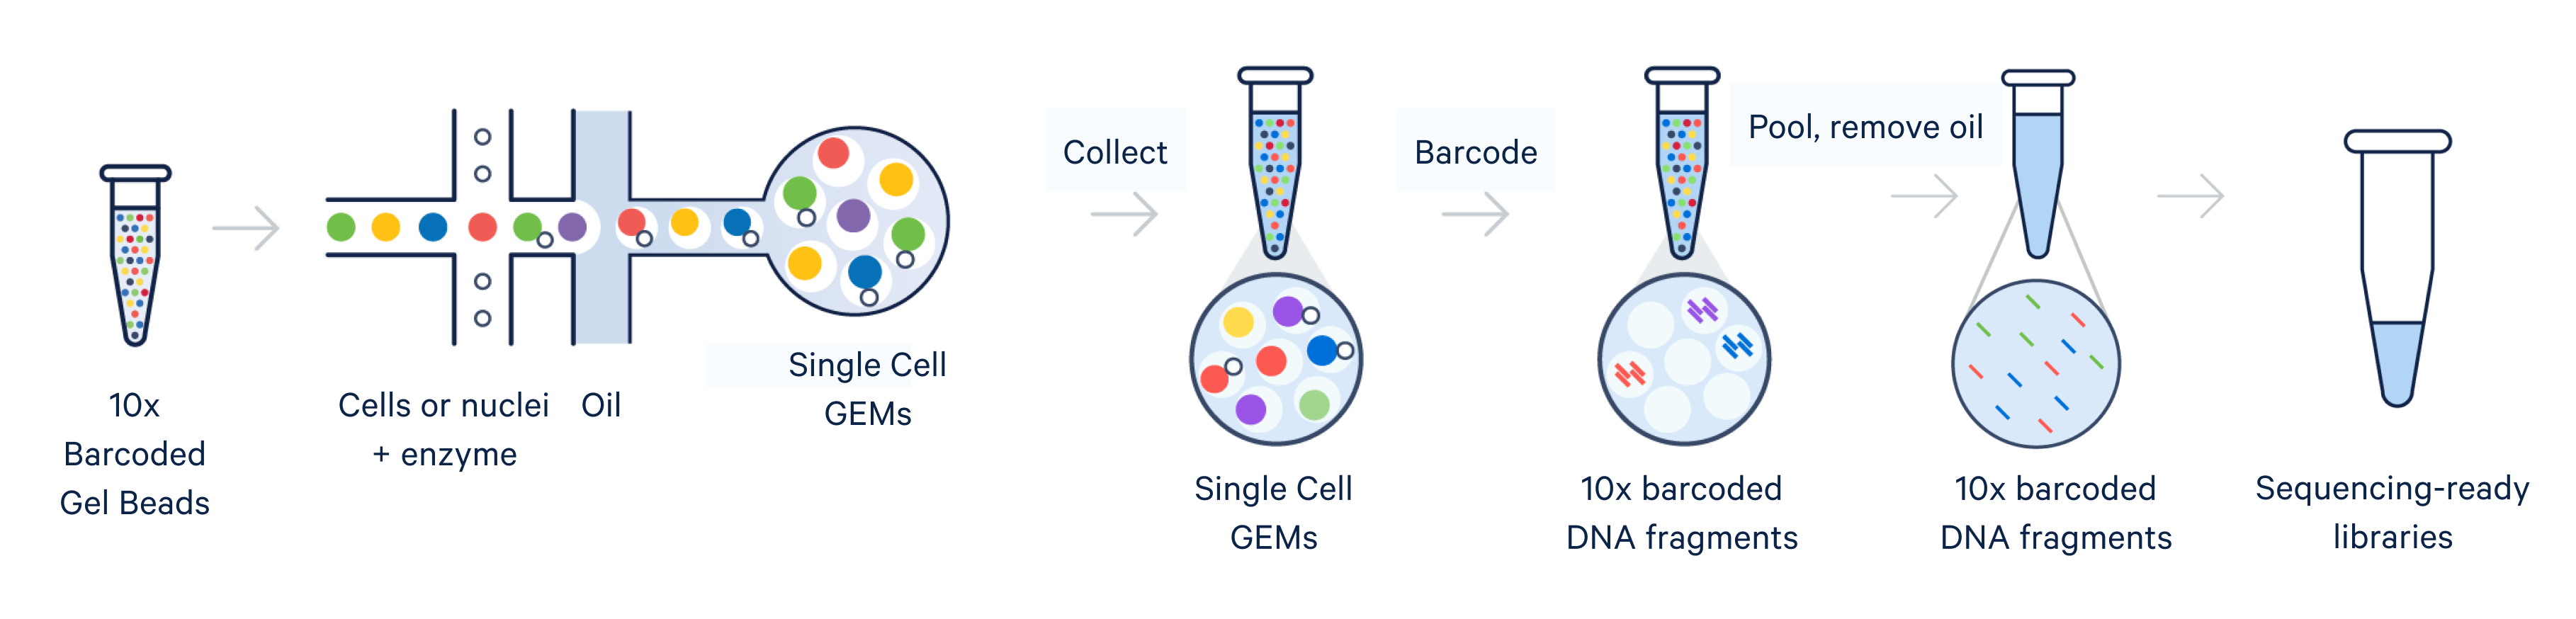
细胞或细胞核通过微流控通道并在 Chromium X 系列仪器中生成 GEM 的示意图,这是单细胞实验工作流程的一部分,用于生成可供测序的基因表达文库。
4.1.1. 批量RNA测序/bulk
- 作用:
- 差异基因表达分析
- 识别和表征新转录本:批量数据可用于注释异构体、非编码 RNA、可变剪接事件和基因融合。
- 发现用于疾病诊断、预后或分层的 RNA 生物标志物和分子特征
- 研究基因集(通路和网络)在各种生物条件下如何整体变化
- 差异基因表达分析
- 优缺点:
- 成本更低的全转录组分析选择,侧重于群体水平的洞察。较低的测序深度要求进一步降低了成本。此外,更简单的样本制备要求以及更低的数据复杂度和分辨率使其成为更易上手的工作流程,分析也更加直接。
- 由于 bulk RNA-seq 提供的是样本中所有细胞基因表达的平均读数,它无法区分基因表达读数的细胞来源。如果某一基因或独特转录本主要由一种或少数几种细胞类型产生,这一点就会被掩盖。
- 无法揭示样本的细胞异质性,因此对于高度异质性的组织而言不太理想。相比之下,单细胞测序可以揭示这种异质性,甚至能够发现可能驱动独特基因表达谱的稀有、低丰度细胞类型。
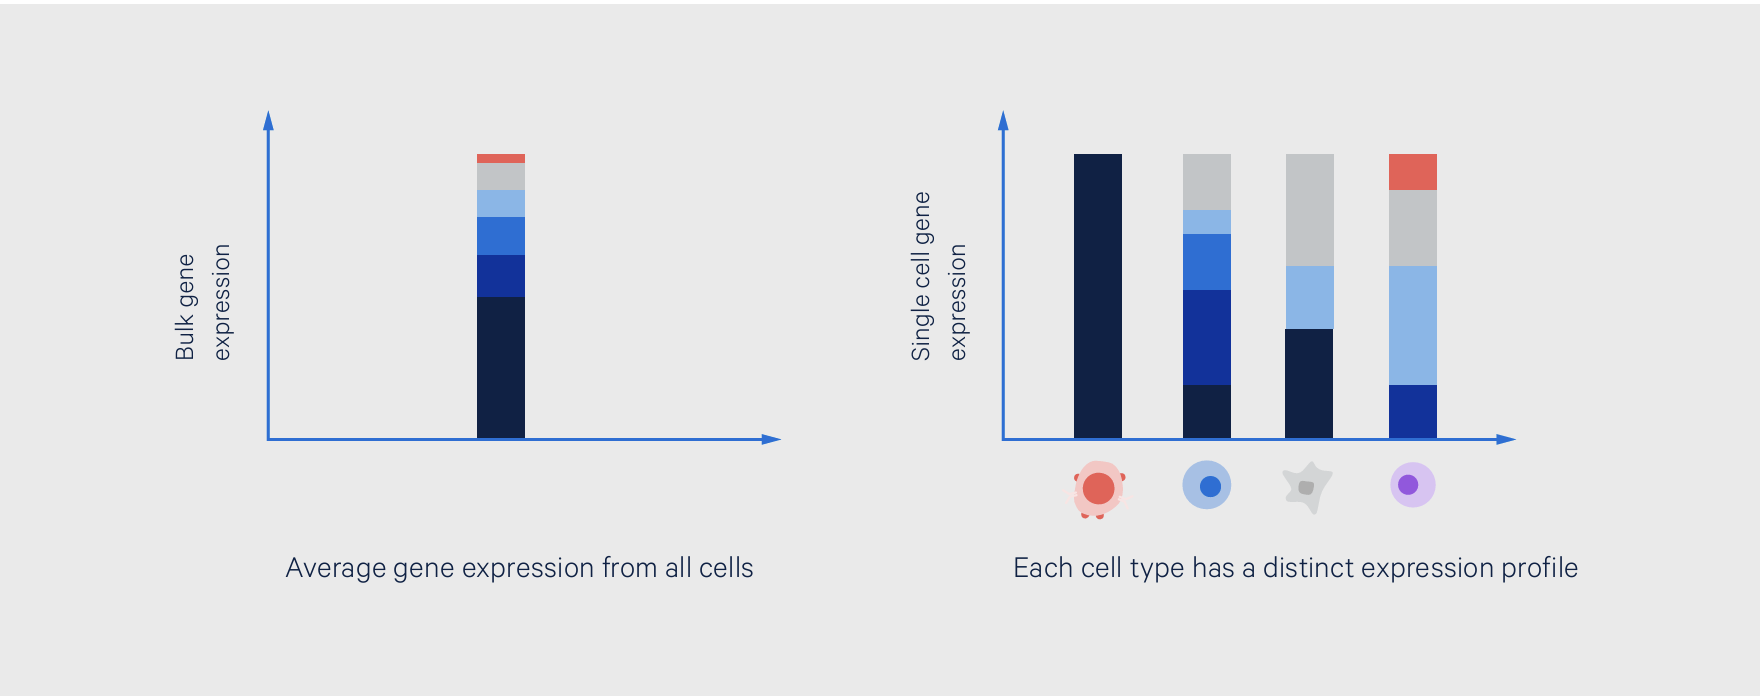
比较 bulk RNA-seq 和单细胞 RNA-seq 基因表达读取的分辨率。左侧图表展示了样本转录景观的 bulk 视图,显示了 6 个基因的平均表达水平。右侧图表代表单细胞基因表达数据,揭示了样本真实的细胞异质性,以及从平均视图所见的表达模式的细胞来源。
4.1.2. 单细胞 RNA 测序 / scRNA-seq
原理
单细胞 RNA 测序(single-cell RNA sequencing, scRNA-seq)通过微流控技术将单个细胞与带有条形码的凝胶珠(Gel Bead-in-Emulsion, GEM)包裹,实现单细胞水平的 mRNA 捕获、反转录和文库构建。每个细胞的转录本被赋予独特细胞条形码(cell barcode),测序后按 barcode 拆分,获得 gene × cell 的表达矩阵。
核心流程(以 10x Genomics Chromium 为例)
单细胞悬液制备 → 微流控生成 GEM → 细胞裂解、mRNA 捕获 → 反转录(带 barcode)→
文库构建 → Illumina 测序 → 数据拆分与定量
与 bulk RNA-seq 的关键差异
| 维度 | bulk RNA-seq | scRNA-seq |
|---|---|---|
| 分辨率 | 组织/群体平均 | 单细胞 |
| 异质性 | 完全丢失 | 完整保留 |
| 数据稀疏性 | 低(基因覆盖完整) | 高(dropout 事件多) |
| 成本 | 低 | 高(每个细胞需独立建库) |
| 分析复杂度 | 简单(DESeq2/edgeR) | 复杂(降维、聚类、轨迹推断) |
主要优势
- 发现稀有细胞类型:如肿瘤微环境中的耗竭 T 细胞、癌症干细胞
- 刻画细胞状态连续谱:如分化轨迹、应激响应梯度
- 解析细胞间通讯:通过配体-受体基因共表达预测细胞互作
主要局限
| 问题 | 原因 | 应对策略 |
|---|---|---|
| 解离偏好 | 酶消化导致某些细胞类型易死亡或丢失 | 优化酶方案;改用 snRNA-seq |
| 应激基因诱导 | 解离过程激活即刻早期基因(如 Fos , Jun) | 快速操作;使用冷冻样本做 snRNA-seq |
| 双细胞(doublets) | 两个细胞被同一个 GEM 捕获 | 计算预测(Scrublet/DoubletFinder);降低上样浓度 |
| mRNA 捕获效率 | ~10-30%,低表达基因易漏检 | 增加测序深度;使用高灵敏度平台 |
典型应用场景
- 肿瘤免疫微环境:区分恶性细胞、T/B 细胞、髓系细胞、成纤维细胞亚群
- 发育生物学:构建胚胎发育的细胞分化图谱(如小鼠 gastrulation)
- 药物筛选:追踪药物处理后不同细胞群体的特异性响应
4.1.3. 单细胞核 RNA 测序 / snRNA-seq
原理
snRNA-seq(single-nucleus RNA sequencing)直接对分离的细胞核进行 RNA 捕获和测序。细胞核膜完整,内含 pre-mRNA、lncRNA 及少量成熟 mRNA。通过机械研磨或细胞裂解液破坏细胞膜,释放完整细胞核,后续流程与 scRNA-seq 类似。
与 scRNA-seq 的核心对比
| 对比项 | scRNA-seq | snRNA-seq |
|---|---|---|
| 起始材料 | 活细胞悬液 | 细胞核(新鲜或冷冻组织) |
| 捕获 RNA 类型 | 主要是成熟细胞质 mRNA | 核内 pre-mRNA + 成熟 mRNA(含 intron) |
| 解离步骤 | 需要(酶消化/机械) | 不需要(直接裂解细胞膜) |
| 样本类型 | 新鲜组织为主 | 兼容冷冻样本、FFPE、难消化组织 |
| 应激基因 | 高(解离诱导) | 低 |
| 细胞质基因丢失 | 无 | 部分(如线粒体基因高比例丢失) |
| 检测灵敏度 | 较高(mRNA 丰富) | 略低(核 RNA 总量少) |
| 核/质比例基因偏差 | 无 | 有(需校正 intron/exon 比例) |
关键优势:解决 scRNA-seq 的"硬骨头"
难消化组织                    珍贵冷冻样本
    ↓                           ↓
  脂肪组织、心肌、              临床样本库(biobank)
  神经组织(神经元大             手术剩余组织、穿刺样本
  且易损)、骨组织               ↓
    ↓                      【snRNA-seq 直接可用】
【scRNA-seq 解离困难或
  细胞死亡率高】
    ↓
【snRNA-seq 绕过解离,
  直接提核】
数据分析的特殊考量
| 注意点 | 说明 | 处理方法 |
|---|---|---|
| intron 富集 | 核 RNA 含大量未剪接 pre-mRNA | 定量时纳入 intronic reads;或使用 velocyto/scVelo 做 RNA 速率分析 |
| 线粒体基因比例低 | 线粒体位于细胞质 | 不能直接用 %MT 作为质控指标;改用核内基因数、双细胞率 |
| 核包被完整性 | 核膜破裂导致 RNA 流失 | 流式或显微镜质检;PI 染色排除破损核 |
何时选择 snRNA-seq 而非 scRNA-seq
| 场景 | 理由 |
|---|---|
| 样本已冷冻,无法新鲜制备 | 无需活细胞 |
| 组织解离后特定细胞类型大量丢失 | 避免解离偏好 |
| 研究目标基因主要在核内调控(如转录因子、lncRNA) | 核 RNA 信息更丰富 |
| 需要同时做 scATAC-seq 或 Multiome | 共用细胞核样本,实现 RNA + 染色质可及性 联合 |
| 大样本队列研究 | 冷冻样本便于批量处理和标准化 |
10x Genomics Multiome:snRNA-seq + scATAC-seq 联合
同一细胞核 → 同时捕获
    ├── 转录组(gene expression, snRNA-seq)
    └── 染色质可及性(chromatin accessibility, scATAC-seq)

→ 直接关联:某基因的启动子开放程度 ↔ 该基因表达水平
→ 揭示调控机制:enhancer → 靶基因 → 细胞状态
scRNA-seq vs snRNA-seq
新鲜样本 + 活细胞易得 + 追求最高灵敏度
    ↓
【scRNA-seq】

冷冻样本 / 难消化组织 / 需联合 ATAC / 避免解离应激
    ↓
【snRNA-seq】两者在分析层面(降维聚类、注释、轨迹)高度互通,主要差异在于实验前置条件 和质控指标,可根据样本实际情况灵活选择。
4.2. Spatial RNA
4.2.1. 捕获+ NGS空转(10x Visium / Visuim HD / Slide-seq)
4.2.2. 原位读取型(Xenium / CosMx / MERFISH
/ seqFISH / ISS)
- 传统空间转录组:组织中的RNA → 捕获→ 拿出来→ 建库→Illumina测序
- 原位方法:RNA还在组织里→直接在组织里识别
即:in situ
4.2.2.1. Xenium(⭐亚细胞级分辨率+目标 RNA 转录本检测+空间定位)
-
数据格式:每个 transcript 是一个空间点 。
-
→ 细胞分割 → 转录本transcript → 分配到细胞(gene x cell)的格式
Gene X Y
NPHS1 124.2 815.3
NPHS1 125.1 817.4
COL1A1 500.3 231.4
PECAM1 319.4 624.1
...
-
-
示例图片背景:三阳性(HER2+/ER+/PR+)乳腺癌的预后趋势("中等偏好"预后)
- 在乳腺癌各亚型中的预后排序(从好到差):
- Luminal A (ER+/PR+/HER2-) 最好
- Luminal B (ER+/PR+/HER2-,Ki67高)
- Luminal B 型(ER+/PR+/HER2-,Ki67 高) 较好
- 三阳性 (ER+/PR+/HER2+) 中等偏好 ← 这个位置
- HER2过表达型 (ER-/PR-/HER2+) 中等偏差
- 三阴性 (ER-/PR-/HER2-) 最差
- 三阳性 vs 其他亚型的具体数据
- 在乳腺癌各亚型中的预后排序(从好到差):
-
怎么解读:查看Xenium 空间图中 ESR1、ERBB2 和 PGR 的表达情况后发现,所分析的组织切片中大部分同时表达 ERBB2 和 ESR1 转录本(HER2/ER 双阳性)或仅表达 ERBB2 转录本(HER2 阳性)。
-
特点:
- "亚细胞级":看清RNA在细胞内部的精确位置(<50nm ;传统Visium分辨率大约55μm的单位------包含多个细胞,但是是全转录组)
- "目标RNA转录本检测":看【已知的】重要基因
-
适合什么情况:组织区域比较
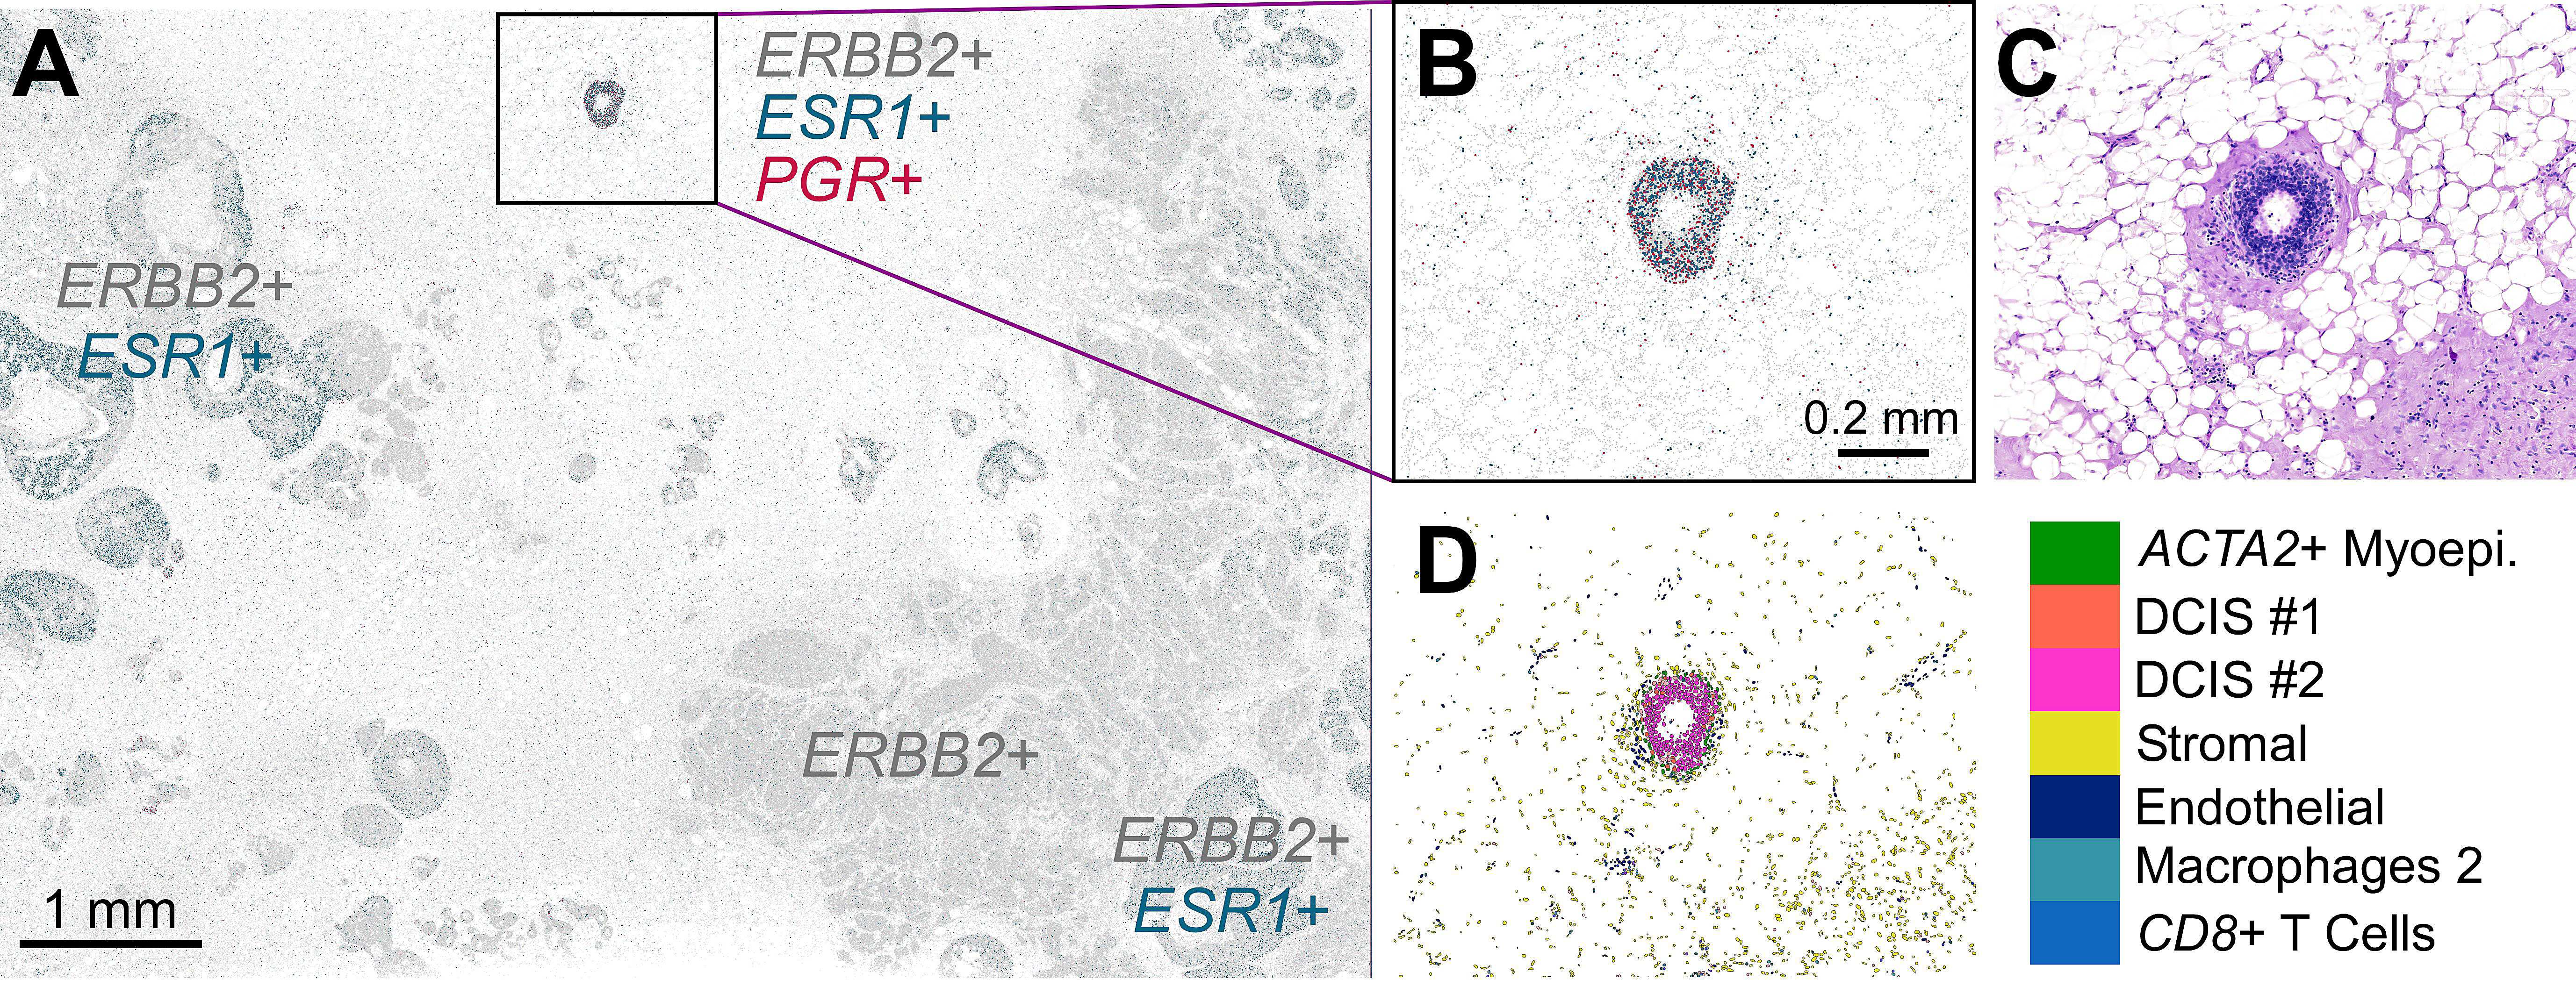
三阳性本身不是"坏趋势"------相比纯HER2阳性或三阴性,它的预后反而更好;但它也不是"好趋势"------不如Luminal A型。原文的核心价值在于发现"同一肿瘤内部藏着不同分子特征的区域",这种空间异质性才是理解肿瘤进展的关键。
- 和HE标注结果的关键区别
| 检测层面 | 结果 | 覆盖范围 | |
|---|---|---|---|
| H&E 传统病理 | 基于蛋白质的免疫组化(IHC) | HER2+/ER+/PR- | 整个组织切片的整体评估 |
| Xenium | 基于RNA的原位检测 | 大部分区域 HER2+/ER+/PR-,但小区域 HER2+/ER+/PR+ | 单细胞/亚细胞分辨率的空间图谱 |
H&E 看到的(整体平均):
┌─────────────────────────────┐
│     整个样本 = HER2+/ER+/PR-  │
└─────────────────────────────┘

Xenium 看到的(空间分辨):
┌─────────────────────────────┐
│  ████████████████████████   │  ← 90% 区域:HER2+/ER+/PR-(与H&E一致)
│  ████████████████████████   │
│        ▓▓▓                  │  ← 10% 小区域:HER2+/ER+/PR+(新发现)
│        ▓▓▓                  │     ~0.1 mm² / 总面积 42 mm²
└─────────────────────────────┘- 为什么需要考虑:H&E 能看出大概,只是不够精细。Xenium 在相同组织上发现了 H&E 无法捕捉的微小异质性区域。
- 为什么 H&E 没发现 PR+ 区域?
| 原因 | 解释 |
|---|---|
| 区域太小 | 仅 ~0.1 mm²,占总面积 0.2% |
| H&E 是整体判读 | 病理医生对整张切片做综合评估,微小区域被"平均"掉了 |
| RNA vs 蛋白检测差异 | Xenium 检测 RNA 转录本,灵敏度更高;IHC 检测蛋白,PR 蛋白表达可能低于检测阈值 |
| 空间信息丢失 | 传统方法没有"这个基因在哪个位置表达"的信息 |
4.2.2.2.CosMx
CosMx Spatial Molecular Imager 是 Bruker Spatial Biology(原 NanoString) 的成像型、原位空间组学平台.
- 可以回答:这个细胞是什么细胞、表达什么基因,而且它原来就在组织的什么位置。
| 对比项 | CosMx SMI(Bruker/NanoString) | Xenium(10x Genomics) | MERFISH(Vizgen等实现) |
|---|---|---|---|
| 公司/体系 | Bruker/NanoString | 10x Genomics | Vizgen等实现 |
| 类型 | 原位成像 | 原位成像 | 原位成像 |
| 是否 Illumina NGS | 否 | 否 | 否 |
| 基本单位 | transcript(转录本) | transcript(转录本) | transcript(转录本) |
| 空间尺度 | 单细胞/亚细胞 | 单细胞/亚细胞 | 单细胞/亚细胞 |
| RNA panel | 高plex targeted(高通量靶向) | 高plex targeted(高通量靶向) | 高plex targeted(高通量靶向) |
| 输出 | RNA坐标+cell | RNA坐标+cell | RNA坐标+cell |
| 组织形态 | 保留 | 保留 | 保留 |
| 最大基因panel | 最多 6000 基因 | 最多 5000 基因 | 依方案(最高可上万) |
| FFPE | 支持 | 支持相应工作流 | 依方案(冷冻样本最优,FFPE难度更高) |
| 主要优势 | RNA+蛋白/组织环境能力强 | 10x生态成熟,RNA灵敏度高 | 原位编码体系经典,基因通量上限高 |
-
三者都属于原位成像读取型空间转录组,不依赖 Illumina NGS,直接检测单条转录本、保留组织形态,输出带空间坐标的单细胞基因表达;
- CosMx:同切片 RNA + 蛋白联合检测能力突出,适配病理 FFPE、TMA;
- Xenium:10x 多组学生态配套完善,低丰度 RNA 检测灵敏度好;
- MERFISH:经典纠错编码方案,冷冻组织可实现超高基因 panel。
-
这三类和 Visium/Slide-seq(捕获 + NGS 型)本质区分:后者需要提取 RNA 上机 NGS 测序;这三者不做 NGS,直接在组织切片原位成像解码。
4.2.2.3.MERFISH
MERFISH(Multiplexed Error-Robust Fluorescence In Situ Hybridization,多重纠错荧光原位杂交)由哈佛大学庄小威团队开发,是基于组合式纠错编码的原位成像技术。
核心原理
每个 RNA 分子 → 分配唯一二进制条形码(如 16-bit)
              ↓
多轮杂交成像:每轮用两种颜色(ON=1, OFF=0)读取 1 个 bit
              ↓
16 轮成像 → 16-bit 二进制码 → 解码基因身份
              ↓
纠错设计:Hamming 距离 ≥ 4,可纠正单 bit 错误、检测双 bit 错误
技术特点
| 维度 | 详情 |
|---|---|
| 分辨率 | 单分子 / 单细胞 / 亚细胞(~20 nm 定位精度) |
| 基因通量 | 经典方案 140 基因;扩展方案可达 10,000+ 基因 |
| 检测方式 | 多轮循环杂交 + 成像,非酶促扩增 |
| 样本类型 | 冷冻切片最优;FFPE 需优化 |
| 读出平台 | 宽场荧光显微镜 + 高灵敏相机 |
与 Xenium/CosMx 的关键差异
| 对比项 | MERFISH | Xenium | CosMx |
|---|---|---|---|
| 编码体系 | 组合式二进制纠错编码 | 挂锁探针 + 酶促滚环扩增(RCA) | 光切割条形码 + 原位测序 |
| 信号放大 | 无(单分子直接成像) | RCA 扩增 | RCA 扩增 |
| 多轮循环机制 | 杂交-成像-剥离,重复 | 探针连续杂交,酶切步进 | 连续成像,光切割释放 |
| 基因上限 | 最高(理论无上限,已验证 10,000+) | ~5,000(官方 panel) | ~6,000(官方 panel) |
| RNA 灵敏度 | 中等(无扩增,低丰度 RNA 可能漏检) | 高(RCA 放大信号) | 高 |
| 成像速度 | 较慢(多轮完整剥离) | 较快(连续步进) | 中等 |
| 生态配套 | 需自建分析流程;Vizgen 提供商业化方案 | 10x 生态完整(Cell Ranger, Loupe) | Bruker/NanoString 配套 |
独特优势
- 超高基因通量 :唯一实现 >10,000 基因 panel 的原位技术,适合全转录组级空间图谱
- 无扩增偏差:单分子直接计数,定量更线性
- 经典编码理论:Hamming 纠错编码降低误检率,即使某轮成像失败仍可正确解码
主要局限
| 问题 | 解释 |
|---|---|
| 低丰度 RNA 检测受限 | 无信号放大,单拷贝基因可能低于信噪比阈值 |
| 多轮循环耗时长 | 16-20 轮杂交 × 每轮数十分钟 → 总耗时数小时至一天 |
| 组织穿透深度 | 厚样本(>10 μm)探针渗透不均,通常限于薄切片 |
| FFPE 兼容性差 | 交联严重干扰探针结合,需特殊修复方案 |
- 典型应用
- 全转录组空间图谱:如小鼠皮层 10,000 基因 MERFISH 图谱,揭示细胞类型空间排布规律
- 复杂组织三维重建:连续切片 + 配准,构建 mm 级三维空间表达模型
- 验证性研究:用高 panel 验证 scRNA-seq 发现的 marker 基因空间分布
4.2.2.4. seqFISH
seqFISH(sequential FISH,序贯荧光原位杂交)由加州理工学院蔡龙团队开发,与 MERFISH 并列为早期经典原位编码技术,但采用不同的条形码设计和成像策略。
核心原理
超参数条形码:每个基因分配一组初级探针(20 条),每条带独特"读出序列"
              ↓
多轮杂交:每轮用荧光标记的"读出探针"识别特定读出序列
              ↓
伪彩色编码:通过不同轮次、不同颜色的组合区分基因
              ↓
示例:基因 A = 轮1-绿色 + 轮3-红色 + 轮5-黄色
      基因 B = 轮1-红色 + 轮2-绿色 + 轮4-蓝色
技术演进
| 版本 | 特点 | 通量 |
|---|---|---|
| seqFISH | 原始版本,伪彩色编码 | ~30-100 基因 |
| seqFISH+ | 引入纠错编码 + 信号放大 | ~10,000 基因 |
| seqFISH+ v2 | 优化探针设计,提升 FFPE 兼容性 | ~10,000 基因 |
与 MERFISH 的核心对比
| 对比项 | seqFISH/seqFISH+ | MERFISH |
|---|---|---|
| 编码逻辑 | 超参数空间编码(多探针 × 多轮颜色组合) | 组合式二进制纠错编码 |
| 探针设计 | 每个基因 20 条初级探针,各带独立读出序列 | 每个基因 1 套二进制编码探针组 |
| 信号放大 | 原始无;seqFISH+ 引入 branched DNA 放大 | 始终无扩增 |
| 纠错能力 | seqFISH+ 引入有限纠错 | 强纠错(Hamming 距离设计) |
| 基因通量 | seqFISH+ 可达 10,000 | 10,000+ |
| 商业化 | 学术方案为主;部分公司授权提供试剂 | Vizgen 商业化成熟 |
- 独特技术特征
- 内参校正 :seqFISH+ 在每个细胞中同时检测 housekeeping 基因作为内参,校正样本间、批次间信号差异
- 亚细胞定位精度高 :利用多点定位(20 条探针分散结合)可实现 <10 nm 的精确定位,用于研究 RNA 在细胞器层面的分布
- 兼容活细胞成像:部分方案可在活细胞中进行有限轮次成像,追踪 RNA 动态
局限
| 问题 | 说明 |
|---|---|
| 探针设计复杂度高 | 20 条初级探针/基因 × 验证特异性,设计工作量大 |
| 原始 seqFISH 无纠错 | 早期版本误检率较高,依赖 seqFISH+ 改进 |
| 商业化程度低 | 主要依赖学术实验室自建,标准化流程较少 |
4.2.2.5. ISS
ISS(In Situ Sequencing,原位测序)由瑞典皇家理工学院 Mats Nilsson 团队开发,是**唯一真正实现"在组织内直接进行酶促测序"**的原位技术,与其他成像编码技术有本质区别。
核心原理:滚环扩增 + 测序-by-合成
目标 RNA → 反转录为 cDNA → 挂锁探针(padlock probe)环化 cDNA
              ↓
滚环扩增(RCA):Φ29 聚合酶以环化 cDNA 为模板,生成长单链 DNA 纳米球
              ↓
测序-by-合成(Sequencing-by-Synthesis, SBS):
    逐轮加入:
    ├── 荧光标记的寡核苷酸探针(与 RCA 产物互补杂交 → 成像 → 剥离)
    └── 或:连接测序(SOLiD 风格,荧光标记探针连接)
              ↓
多轮循环 → 逐个碱基读取序列 → 识别基因身份
技术分支
| 方案 | 测序化学 | 读长 | 特点 |
|---|---|---|---|
| ISS(原始) | 连接测序(ligation-based) | 4-5 bp | 短读长,高准确率 |
| ISS-PLA | 邻近连接扩增 | - | 检测蛋白-RNA 互作 |
| ExSeq / STARmap | 杂交测序(hybridization-based) | 较长 | 提升通量,简化流程 |
| ISS 结合 Illumina | SBS 化学 | 可达 30+ bp | 读长增加,解码能力增强 |
与其他原位技术的本质区别
| 维度 | ISS | MERFISH/seqFISH/Xenium/CosMx |
|---|---|---|
| 信息读取方式 | 真正测序(读取实际核苷酸序列) | 编码杂交(预设探针-颜色对应表) |
| 发现能力 | 可检测未知突变、融合、SNV | 仅检测预设 panel 中的基因 |
| 序列验证 | 有(实际读取序列) | 无(依赖探针特异性) |
| 读长限制 | 短(通常 <30 bp) | 无(探针结合即检测) |
| 酶促步骤 | 多(RCA、聚合酶/连接酶反应) | 少或无 |
| 组织损伤风险 | 较高(多轮酶反应) | 较低 |
关键优势
- 序列验证级特异性:实际读取 RNA 序列,非预设探针杂交,可区分高度同源基因、剪接变体
- 发现未知变异 :短读长范围内可检测点突变、融合断点(如 BCR-ABL)
- 灵活靶向:无需预先合成大量编码探针,通过通用测序引物即可靶向任意基因
主要局限
| 问题 | 解释 |
|---|---|
| 读长短 | 4-30 bp 难以覆盖全转录本,复杂区域(重复序列)解码困难 |
| 酶促损伤 | 多轮 RCA + 测序反应导致组织形态破坏、RNA 降解 |
| 通量低 | 每轮成像区域小,大视野拼接耗时;基因 panel 通常 <100 |
| 技术复杂度高 | 需优化 RCA 效率、测序反应均匀性,重复性挑战大 |
| 商业化困难 | 流程难以标准化,目前以学术研究为主 |
典型应用
场景 1:验证基因融合
    → 设计靶向融合断点的挂锁探针
    → ISS 读取断点两侧序列
    → 单细胞水平确认 *EML4-ALK* 等融合事件的空间分布

场景 2:区分高度同源基因家族
    → 如 Hox 基因簇,序列相似度 >90%
    → 短读长测序可识别 SNP 差异位点
    → 杂交编码技术难以设计特异性探针

场景 3:神经科学(与 ExSeq 结合)
    → 膨胀显微镜(Expansion Microscopy)预先将组织物理放大
    → ISS 在膨胀后的水凝胶中测序
    → 实现超分辨率(<20 nm)空间转录组
三种技术快速对比总结
| 对比项 | MERFISH | seqFISH | ISS |
|---|---|---|---|
| 核心创新 | 纠错编码理论 | 超参数探针设计 | 原位酶促测序 |
| 本质 | 成像编码 | 成像编码 | 真正测序 |
| 基因通量 | 10,000+ | 10,000+(seqFISH+) | <100(通常) |
| RNA 灵敏度 | 中 | 中(seqFISH+ 有放大) | 中(依赖 RCA 效率) |
| 序列验证 | 无 | 无 | 有 |
| 发现未知变异 | 否 | 否 | 可检测短读长范围内突变/融合 |
| 组织完整性 | 较好 | 较好 | 较差(多轮酶反应) |
| 商业化程度 | Vizgen 成熟 | 低 | 低 |
| 最佳场景 | 超高通量空间图谱 | 亚细胞精确定位、活细胞 | 融合/突变验证、同源基因区分 |
5. 蛋白质组学
蛋白质组学(Proteomics)是对生物体或细胞中全部蛋白质进行大规模鉴定与定量分析的学科。蛋白质是功能的直接执行者,因此蛋白质组学能更真实地反映生物学状态。
核心技术:
- 质谱分析(Mass Spectrometry):蛋白质组学的基石,用于蛋白鉴定与定量。
- 双向电泳(2D-PAGE):经典分离方法,按等电点与分子量分离蛋白。
- 蛋白质互作网络分析:结合亲和纯化与质谱,绘制蛋白-蛋白相互作用图谱。
蛋白质组学在生物标志物发现、药物靶点验证以及精准医学中发挥关键作用。
6. Multi-omics
Multi-omics(多组学)是指在同一生物学样本上整合基因组、表观基因组、转录组、蛋白质组乃至代谢组等多层次数据,进行系统性关联分析的研究范式。
核心价值:
- 互补验证:不同组学数据相互印证,降低单一组学的假阳性。
- 机制解析:从 DNA 变异 → 转录变化 → 蛋白表达 → 代谢表型的完整链条,揭示因果机制。
- 精准分层:在肿瘤、复杂疾病中实现更精细的分子分型与个体化治疗。
常用整合策略:多组学关联分析、网络建模以及基于机器学习的多模态融合。