目录
[一、vector 的成员变量](#一、vector 的成员变量)
[1.1 vector 是什么](#1.1 vector 是什么)
[1.2 _start、_finish、_endofstorage 三个指针成员](#1.2 _start、_finish、_endofstorage 三个指针成员)
[1.3 与 string 的成员设计对比](#1.3 与 string 的成员设计对比)
[二、vector 的默认成员函数](#二、vector 的默认成员函数)
[2.1 默认构造函数](#2.1 默认构造函数)
[2.2 迭代器区间构造](#2.2 迭代器区间构造)
[2.3 构造函数重载(n 个 val)](#2.3 构造函数重载(n 个 val))
[2.3.1 vector v(10, 1) 的重载陷阱](#2.3.1 vector v(10, 1) 的重载陷阱)
[2.4 拷贝构造函数](#2.4 拷贝构造函数)
[2.5 析构函数](#2.5 析构函数)
[4.1 size、capacity 和 operator\[\]](#4.1 size、capacity 和 operator[])
[4.2 reserve 和 resize](#4.2 reserve 和 resize)
[4.2.1 reserve 更新 _finish 的坑](#4.2.1 reserve 更新 _finish 的坑)
[4.2.2 迭代器失效 ------ 扩容引发的野指针](#4.2.2 迭代器失效 —— 扩容引发的野指针)
[4.3 迭代器 begin/end](#4.3 迭代器 begin/end)
[5.1 vector 的崩溃分析](#5.1 vector 的崩溃分析)
[5.2 正确做法:赋值重载逐个拷贝](#5.2 正确做法:赋值重载逐个拷贝)
[5.3 动态二维数组 vector](#5.3 动态二维数组 vector)
[6.1 push_back 和 pop_back](#6.1 push_back 和 pop_back)
[6.2 insert](#6.2 insert)
[6.2.1 迭代器失效------ insert 偏向野指针](#6.2.1 迭代器失效—— insert 偏向野指针)
[6.3 erase](#6.3 erase)
[6.3.1 迭代器失效------ erase 偏向意义改变](#6.3.1 迭代器失效—— erase 偏向意义改变)
[6.3.2 vs 与 g++ 的检测差异](#6.3.2 vs 与 g++ 的检测差异)
前言
上一篇博客:【C++编程】STL容器(一)--- string简单模拟实现(常用接口实现 | 深浅拷贝讲解)-CSDN博客
上一篇我们完成了 string 类的模拟实现,从三个成员变量出发,把构造、深浅拷贝、赋值、容量管理、增删查改这一整套核心接口都自己动手撸了一遍。那今天这篇文章,我们就正式进入 STL 的重头戏------vector 的模拟实现。
vector 可以说是我们平时写 C++ 用得最多、也最能代表 STL 设计思想的一个容器。我们常说,学习 STL 有三个境界------能用、明理、能扩展。上一篇讲 string 接口用法的时候,我们其实一直停留在"能用"和"明理"之间;而到了模拟实现这一步,就是实打实地往"明理"和"能扩展"去迈进。vector 的学习我们同样按照这个思路来:先搞清楚它是什么,再把它的底层掰开揉碎讲明白。
不过要提前给大家打个预防针:这一篇会比上一篇 string 难上不少,难度主要来自三个地方------第一, vector 是一个模板类,它要适配任意类型 T,而不像 string 只管 char,很多问题会因为"T 到底是什么类型"而变得复杂;第二, vector 有一个新手很头疼的问题------迭代器失效,我们会讲到具体接口时结合场景展开;**第三,**vector 的扩容拷贝里藏着一个 memcpy 的经典深坑,我们专开了一节来讲。
至于那些和 string 基本一样的部分(比如命名空间隔离、赋值运算符的现代写法、operator\[\] 的越界检查),我们就简单带过,把火力集中在真正有差别的地方。
同样地,为了不和标准库的 vector 冲突,我们依然把自己造的 vector 放进 Marks 命名空间里。
一、vector 的成员变量
1.1 vector 是什么
在动手写代码之前,我们先要搞清楚一个问题:vector 到底是什么东西?
说白了,它就是一个可变大小的数组。我们把它拆开来看,就是三层意思:
- 它底层是一块连续的存储空间,所以可以像数组一样用下标 vi 随机访问,访问效率和数组一样高;
- 它的大小是动态可变的,而且这个"变大"不需要我们操心,容器会自动处理;
- 代价是:当空间不够装新元素时,vector 要经历"重新配置一块更大的空间 -> 把旧元素全部搬过去 -> 释放原来的空间"这一整套流程,这是一个相对昂贵的操作。
也正因为扩容昂贵,vector 不会每插入一个元素就扩一次容,而是"提前多备一些":每次都分配一些额外的空间以适应可能的增长,并且这个增长是按倍数进行的。这样把扩容的代价平摊下来,就能保证末尾插入元素接近常数时间的体验。
我们用一句话总结:vector 就是一个会自动扩容的数组。随机访问快、尾插快,但扩容那一瞬间是"搬家"级别的开销------记住这个特点,它决定了后面所有的实现细节。
1.2 _start、_finish、_endofstorage 三个指针成员
既然 vector 底层是一块连续的动态数组,那我们要管理这块数组,本质上就是要回答三个问题:数据从哪开始?有效数据到哪结束?整个空间到哪为止?
对应地,vector 用三个指针来回答这三个问题:
cpp
namespace Marks
{
	template<class T>
	class vector
	{
	public:
		// vector 的迭代器就是原生指针
		typedef T* iterator;
		typedef const T* const_iterator;

	private:
		iterator _start = nullptr;         // 指向数组的起始位置
		iterator _finish = nullptr;        // 指向最后一个有效元素的下一个位置
		iterator _endofstorage = nullptr;  // 指向整个已分配空间的末尾
	};
}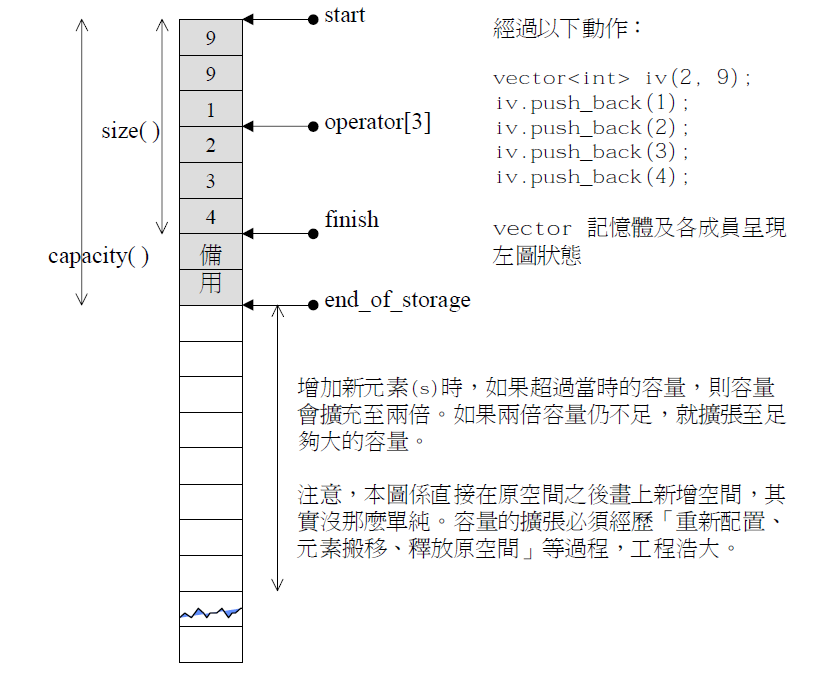
根据上面的这张图,三个指针的分工就一目了然了:
- _start:指向这块连续内存的首地址,所有数据都从这里开始放;
- _finish :指向最后一个有效元素的下一个位置,_start 到 _finish之间就是"真正存了数据"的区域;
- _endofstorage :指向整个已分配空间的末尾 ,_finish 到 _endofstorage之间是"已经开好但还没有用上"的备用空间。
它们之间天然满足 _start <= _finish <= _endofstorage的关系。有了这个关系,两个最常用的接口就变得极其简单:
cpp
size_t size() const     { return _finish - _start; }        // 有效元素个数
size_t capacity() const { return _endofstorage - _start; }  // 已分配的容量
看到没,size 和 capacity 这两个天天用的接口,底层就是两个指针相减。这也是 vector 的精妙之处------它把"有效数据长度"和"总容量"都藏在了指针的差值里,不需要再单独维护两个整数变量。
1.3 与 string 的成员设计对比
成员变量有了,那我们现在再思考一个问题:上一篇 string 我们用的是 _str、_size、_capacity------"一个指针 + 两个整数"的结构,为什么 vector 不照着抄,反而要搞出三个指针呢?
这里就是我们这篇要讲的第一个关键差别点了。我们把两者的成员摆在一起看:
cpp
// string:一个指针 + 两个整数
char* _str;        // 数据载体
size_t _size;      // 有效字符个数
size_t _capacity;  // 总容量

// vector:三个指针
T* _start;         // 数据起始
T* _finish;        // 有效数据末尾
T* _endofstorage;  // 空间末尾
两者在功能上其实是等价的,都能回答"数据在哪、有效数据多长、总空间多大"这三个问题。那 vector 为什么要选择三指针?原因有两点:
第一,vector 的迭代器就是原生指针。上一篇我们说过 string 的迭代器本质也是 char* ,但到了 vector 这里,这个特性被发挥了极致------begin() 直接返回 _start,end() 直接返回 _finish,一行代码都不用多写:
cpp
iterator begin() { return _start; }   // 第一个元素的地址
iterator end()   { return _finish; }  // 最后一个元素的下一个地址
如果沿用 string 那套 _str +_size 的设计,end() 就得写成 return _str + _size,虽然也能跑,但不如直接维护一个 _finish 指针来得直观。
第二,指针相减天然就是"元素个数" 。在C++里,两个同类型指针相减,得到的是它们之间相隔的元素个数(而不是字节数)。所以 _finish - _start 直接就是 size(),连 sizeof(T) 都不用除,代码会非常清爽。
1
小结一下:vector 和 string 都是在管"堆上的动态数组",思想一脉相承;但 vector 因为是模板类、迭代器又是原生指针,所以改用"三指针"来记账------这是它和 string 的第一个关键差别。记住 _start / _finish / _endofstorage 这套结构,后面讲扩容、迭代器失效,全都围绕它展开。
二、vector 的默认成员函数
在上一篇 string 里我们详细聊过"6个默认成员函数"这回事------构造、析构、拷贝构造、赋值重载、取地址重载、const 取地址重载。到了 vector 这里,我们重点处理其中和资源管理直接相关的几个:**构造函数(含各种重载)、拷贝构造函数、析构函数;**赋值运算符重载因为有个"偷梁换柱"的写法值得单独讲,我们放到下一节;至于取地址重载和 const 取地址重载,编译器默认生成的那份已经够用了,这里直接略过不提。
2.1 默认构造函数
成员变量有了,第一个问题就是:一个 vector 对象刚创建出来的时候,它的三个指针应该是什么状态?
答案很简单------都指向空。我们在声明成员的时候,就直接用默认成员初始化器给它们赋上 nullptr:
cpp
private:
    iterator _start = nullptr;         // 声明时就初始化为空
    iterator _finish = nullptr;
    iterator _endofstorage = nullptr;
这样一来,默认构造函数体里其实什么都不用写:
cpp
vector()
{}
这里大家不妨回想一下上一篇 string 的默认构造------string 那边我们可是要 new char1 专门开一个放 '\0' 的空间的。为什么 vector 就不用呢?因为 string 要兼容 C 风格的字符串,必须保证任何时候 _str 都指向一个合法的、以 '\0' 结尾的空间;而 vector 是个纯数组,空就是空,三个指针都是 nullptr 就是最合理、最安全的"空"状态,不需要也不应该去额外 new 一块空内存。
这个"空指针"的初始化还有一层意义:后面析构函数里我们判断 if(_start) 才去 delete\[\],就是建立在这个"要么是合法空间、要么说 nullptr"的约定之上的。所以成员初始化成 nullptr 这件事,一定要做。
2.2 迭代器区间构造
光会造一个空的 vector 还不够。实际开发里最常见的需求其实是------从一段已有的数据初始化出一个 vector。比如我手里有一个数组,或者有另一个容器的某一段区间,我想把它直接变成一个新的 vector。这个时候,就要用到 vector 的迭代器区间构造了:
cpp
// [first, last) 左闭右开区间
template<class InputIterator>
vector(InputIterator first, InputIterator last)
{
    while (first != last)
    {
        push_back(*first);   // push_back 尾插
        ++first;
    }
}
它的作用就是:给我一个 [first, last) 的区间,我逐个把区间里的元素拷进来。注意这里的 InputIterator 是一个模板参数,而不是写死的某种具体类型。
为什么要用模板?因为"迭代器"的身份五花八门:它可能是另一个 vector 的迭代器,可能是 string 的迭代器,甚至可能就是一个原生指针(数组名)。这些类型各不相同,我们没法用一个固定类型写死,所以干脆用模板泛化,让编译器根据实参自动推导。
我们看几个实际的用法就明白了。假设已经有了一个 vector<int> v1 和一个 string str ,那么可以这样:
cpp
vector<int> v3(v1.begin(), v1.end());       // 用另一个 vector 的迭代器区间构造
vector<char> v4(str.begin(), str.end());    // 用 string 的迭代器区间构造

int a[] = { 16, 2, 77, 29 };
vector<int> v5(a, a + 4);                   // 用原生指针(数组首尾)当迭代器
v3 用的是 vector 的迭代器,v4 用的是 string 的迭代器, v5 用的干脆就是两个原生指针 a 和 a + 4------它们都能被 InputIterator 这个模板参数接住,这就是模板的强大之处。
顺便和 string 对比一句:上一篇模拟 string 的时候,我们并没有写这个迭代器区间构造,是因为 string 的场景几乎都是直接传 C 字符串,用不上这种"从别的容器拷贝区间"的需求。但 vector 作为最通用的容器,经常要从数组、list、甚至另一个 vector 里初始化,所以这个模板构造就成了标配,也是它和 string 的一个重要差别。
2.3 构造函数重载(n 个 val)
从区间造会了,还有一种更直白的场景:我想一口气造出 n 个一模一样的元素,比如 10 个 1、或者 10个空字符串。
这个构造也很直接,根据前面的经验,直接复用我们后面讲的 resize 就行了:
cpp
// 构造 n 个 val
vector(size_t n, const T& val = T())
{
    resize(n, val);
}
这里有两个点值得留意:
- 参数用const T& val------ 传引用,避免 T 是自定义类型时发生不必要的拷贝。
- 默认参数 val = T() ------ 这里的 T() 是一个匿名对象,当 T 是 int 这种内置类型时 int() 就是 0 ,当 T 是 string 时 string() 就是空串。这个匿名对象的细节我们放到第四节讲 resize 的时候再展开,这里先记住"默认参数给一个 T()"就够了。
2.3.1 vector v(10, 1) 的重载陷阱
上面我们写的是 vector<size_t n, const T& val> 这个版本,本以为 vector<int> v(10, 1)会顺理成章地走进去、造出 10 个 1。但真实情况是------它会直接编译报错:
cpp
vector<int> v(10, 1); // 本意:10 个 1这是为什么呢?关键在于C++的重载决议规则。当我们调用 v(10, 1)时,编译器手里有两个候选:
cpp
vector(size_t n, const T& val);    // 候选一:需要 int → size_t 的隐式转换

// 候选二:2.2 里的模板构造,InputIterator 直接推导成 int,两个参数都精确匹配
候选一虽然名字听着像"构造 n 个val",但它要求第一个参数 size_t(无符号整数),而我们传的 10 是int(有符号),要走一步隐式类型转换;候选二是函数模板,InputIterator 直接被推导成 int ,两个参数 10 和 1 都是int,精确匹配,精确匹配,一步转换都不用。
那编译器会选谁?在重载决议里,"精确匹配"永远优先于"需要隐式转换的匹配" 。于是 vector<int> v(10, 1)就稀里糊涂地被推给了迭代器区间构造------两个 int 被当成了"一对迭代器",进去之后对 *first 解引用,也就是对一个 int 解引用,直接编译报错。
那怎么解决?很简单,再补一个 int 版本的重载,专门"抢回"这种两个 int 的调用:
cpp
// 额外补一个 int 版本,专门接住 vector<int> v(10, 1) 这种调用
vector(int n, const T& val = T())
{
    resize(n, val);
}
有了这个 int 版本,vector<int> v(10, 1)就能精确匹配到它(两个参数都是 int),不会再被模板抢走,问题就解决了。这也是为什么你在一些成熟的 vector 实现里,会同时看到 size_t 和 int 两个几乎一模一样的构造函数------就是为了堵住这个重载的坑。
2.4 拷贝构造函数
cpp
vector(const vector<T>& v)
{
    _start = new T[v.capacity()];
    // 注意:这里不能用 memcpy 一把梭拷贝,原因留到第五节专门讲
    for (size_t i = 0; i < v.size(); ++i)
    {
        _start[i] = v._start[i];
    }

    _finish = _start + v.size();
    _endofstorage = _start + v.capacity();
}逻辑分三步:先在堆上开一块容量和 v 一样大的新空间 -> 把 v 里的有效元素逐个拷进来 -> 更新三个指针。
这里有个非常关键的细节,也是 vector 和 string 拷贝最大的不同:拷贝元素用的是 for 循环逐个赋值,而不是 memcpy。上一篇 string 的拷贝构造我们可是直接用 memcpy 一把唆的------因为 string 的元素是 char,memcpy 按字节原样拷贝完全没问题。但 vector 的元素类型是模板参数 T ,它可能是 int,也可能是 string 这种自己管理资源的类型,memcpy 一梭子下去就变成浅拷贝,会直接崩溃。
这个问题比较重要,我专门用第五节一整节来讲,这里先记住即可。
不过拷贝构造其实还有第二种写法------先 reserve(v.capacity()) 预留好空间,再push_back 逐个插进去。两种写法效果一样,一个先开空间再直接赋值,一个边扩容边插,看个人习惯。这里我们用第一种(先开空间)的思路,跟后面 reserve 的逻辑也更统一。
2.5 析构函数
就是负责把堆上的空间还回去:
cpp
~vector()
{
    if (_start)
    {
        delete[] _start;
        _start = _finish = _endofstorage = nullptr;
    }
}
这里和 string 的析构基本一个套路,就两点需要留意:
- 用 delete\[\] 要对应前面的 new\[\]。
- 删之前先 if(_start) 判断一下------因为默认构造出来的空 vector,它的 _start 是 nullptr,养成"先判空再删"的习惯总没坏处,而且删完把三个指针统一置空,也能防止后续误用。
到这里,vector 就能安全地创建、拷贝、销毁了。但注意,我们还没写赋值运算符------没有它, v1 = v2 这种操作会走编译器默认生成的浅拷贝,又会出现当时在模拟 string 时出现的"double free"的问题,下一节我们就来解决这个问题。
三、赋值运算符重载
拷贝构造处理的是"用一个 vector 去初始化另一个 vector"的场景,但更常见的其实是这种情况------两个 vector 都已经存在了,我要把 = 把一个赋给另一个:
cpp
vector<int> v1(10, 1);
vector<int> v2(5, 2);
v1 = v2;   // 赋完值,v1 应该变成 5 个 2
那这个 = 该谁来干活?如果我们的类里不写 operator= ,编译器会默认生成一个------而默认生成的是浅拷贝,直接把 v2 的三个指针值原样拷给 v1。后果会和上一篇 string 一模一样:
- v1 原来指向的那块堆空间,没人管了 -> 内存泄漏。
- 赋完之后 v1 和 v2 的 _start 指向同一块空间 -> 两个对象析构时对同一块内存 delete\[\] 两次 ->程序崩溃。
所以我们必须自己写一个 operator= 。这里我们直接沿用上一篇 string 里重点讲过的"现代写法"------传值 + swap,偷梁换柱:
cpp
// 先写一个 swap 成员函数:交换两个 vector 的三个指针
void swap(vector<T>& v)
{
    std::swap(_start, v._start);
    std::swap(_finish, v._finish);
    std::swap(_endofstorage, v._endofstorage);
}

// 现代写法:按值传参,编译器自动调拷贝构造,再 swap 偷梁换柱
vector<T>& operator=(vector<T> v)
{
    swap(v);   // v(临时副本)拿到旧资源,离开作用域时析构自动释放
    return *this;
}
我们再来拆解一下这其中的过程,当执行 v1 = v2 时:
第一步,按值传参。operator= 的参数是 vector<T> v(按值,不是引用),所以把 v2 传进去的时候,编译器会先调用我们 2.4 写的拷贝构造,用 v2 造出一个临时副本 v。这个副本是深拷贝,有自己独立的一块空间,数据跟 v2 一样。
第二步,swap。把 v1 的三个指针和副本 v 的三个指针互换。换完之后,v1 拿到了副本那块装着正确数据的新空间,而副本 v 拿到的,是 v1 原来那块旧空间。
第三步,副本析构。函数返回,副本 v 离开作用域,自动调用析构函数,把它手里那块 v1 的旧空间释放掉。
这个写法的好处,上一篇已经详细分析过,这里简单回顾:不用写自赋值判断(传值自动生成副本,即使 v1 = v1 也安全)、不用手动 delete(旧资源跟着副本走,自动析构)、异常安全(拷贝在传参时完成,如果拷贝崩了根本进不到 swap,原对象完好无损)。
到这里,默认成员函数这一块就齐了:能创建、能拷贝、能赋值、能销毁。但光能"存在"还不够,接下来我们要让 vector 能"用"起来------知道它多大、能访问某个元素、能在空间不够时自动扩容。
四、容量与元素访问
4.1 size、capacity 和 operator\[\]
size 和 capacity 第一节已经见过,就是两个指针相减:
cpp
size_t size() const     { return _finish - _start; }        // 有效元素个数
size_t capacity() const { return _endofstorage - _start; }  // 总容量
operator\[\] 按下标访问,两个版本(可读写 / 只读):
cpp
T& operator[](size_t pos)
{
    assert(pos < size());   // 标准库为性能不做检查,模拟实现加个 assert 方便排错
    return _start[pos];
}

const T& operator[](size_t pos) const
{
    assert(pos < size());
    return _start[pos];
}
返回引用是为了能直接改,比如 v0 = 10。跟 string 是一样的。
4.2 reserve 和 resize
这两个是经常会弄混的。一句话:reserve 只改容量,resize 改元素个数。
先看 reserve,它只把底层空间变大,不碰元素:
cpp
void reserve(size_t n)
{
    if (n > capacity())
    {
        size_t sz = size();      // 先把旧元素个数记下来
        T* tmp = new T[n];       // 开一块更大的新空间
        if (_start)
        {
            for (size_t i = 0; i < sz; ++i)   // 逐个搬过去(为什么不用 memcpy,第五节讲)
            {
                tmp[i] = _start[i];
            }
            delete[] _start;     // 释放旧空间
        }
        _start = tmp;
        _finish = _start + sz;
        _endofstorage = _start + n;
    }
}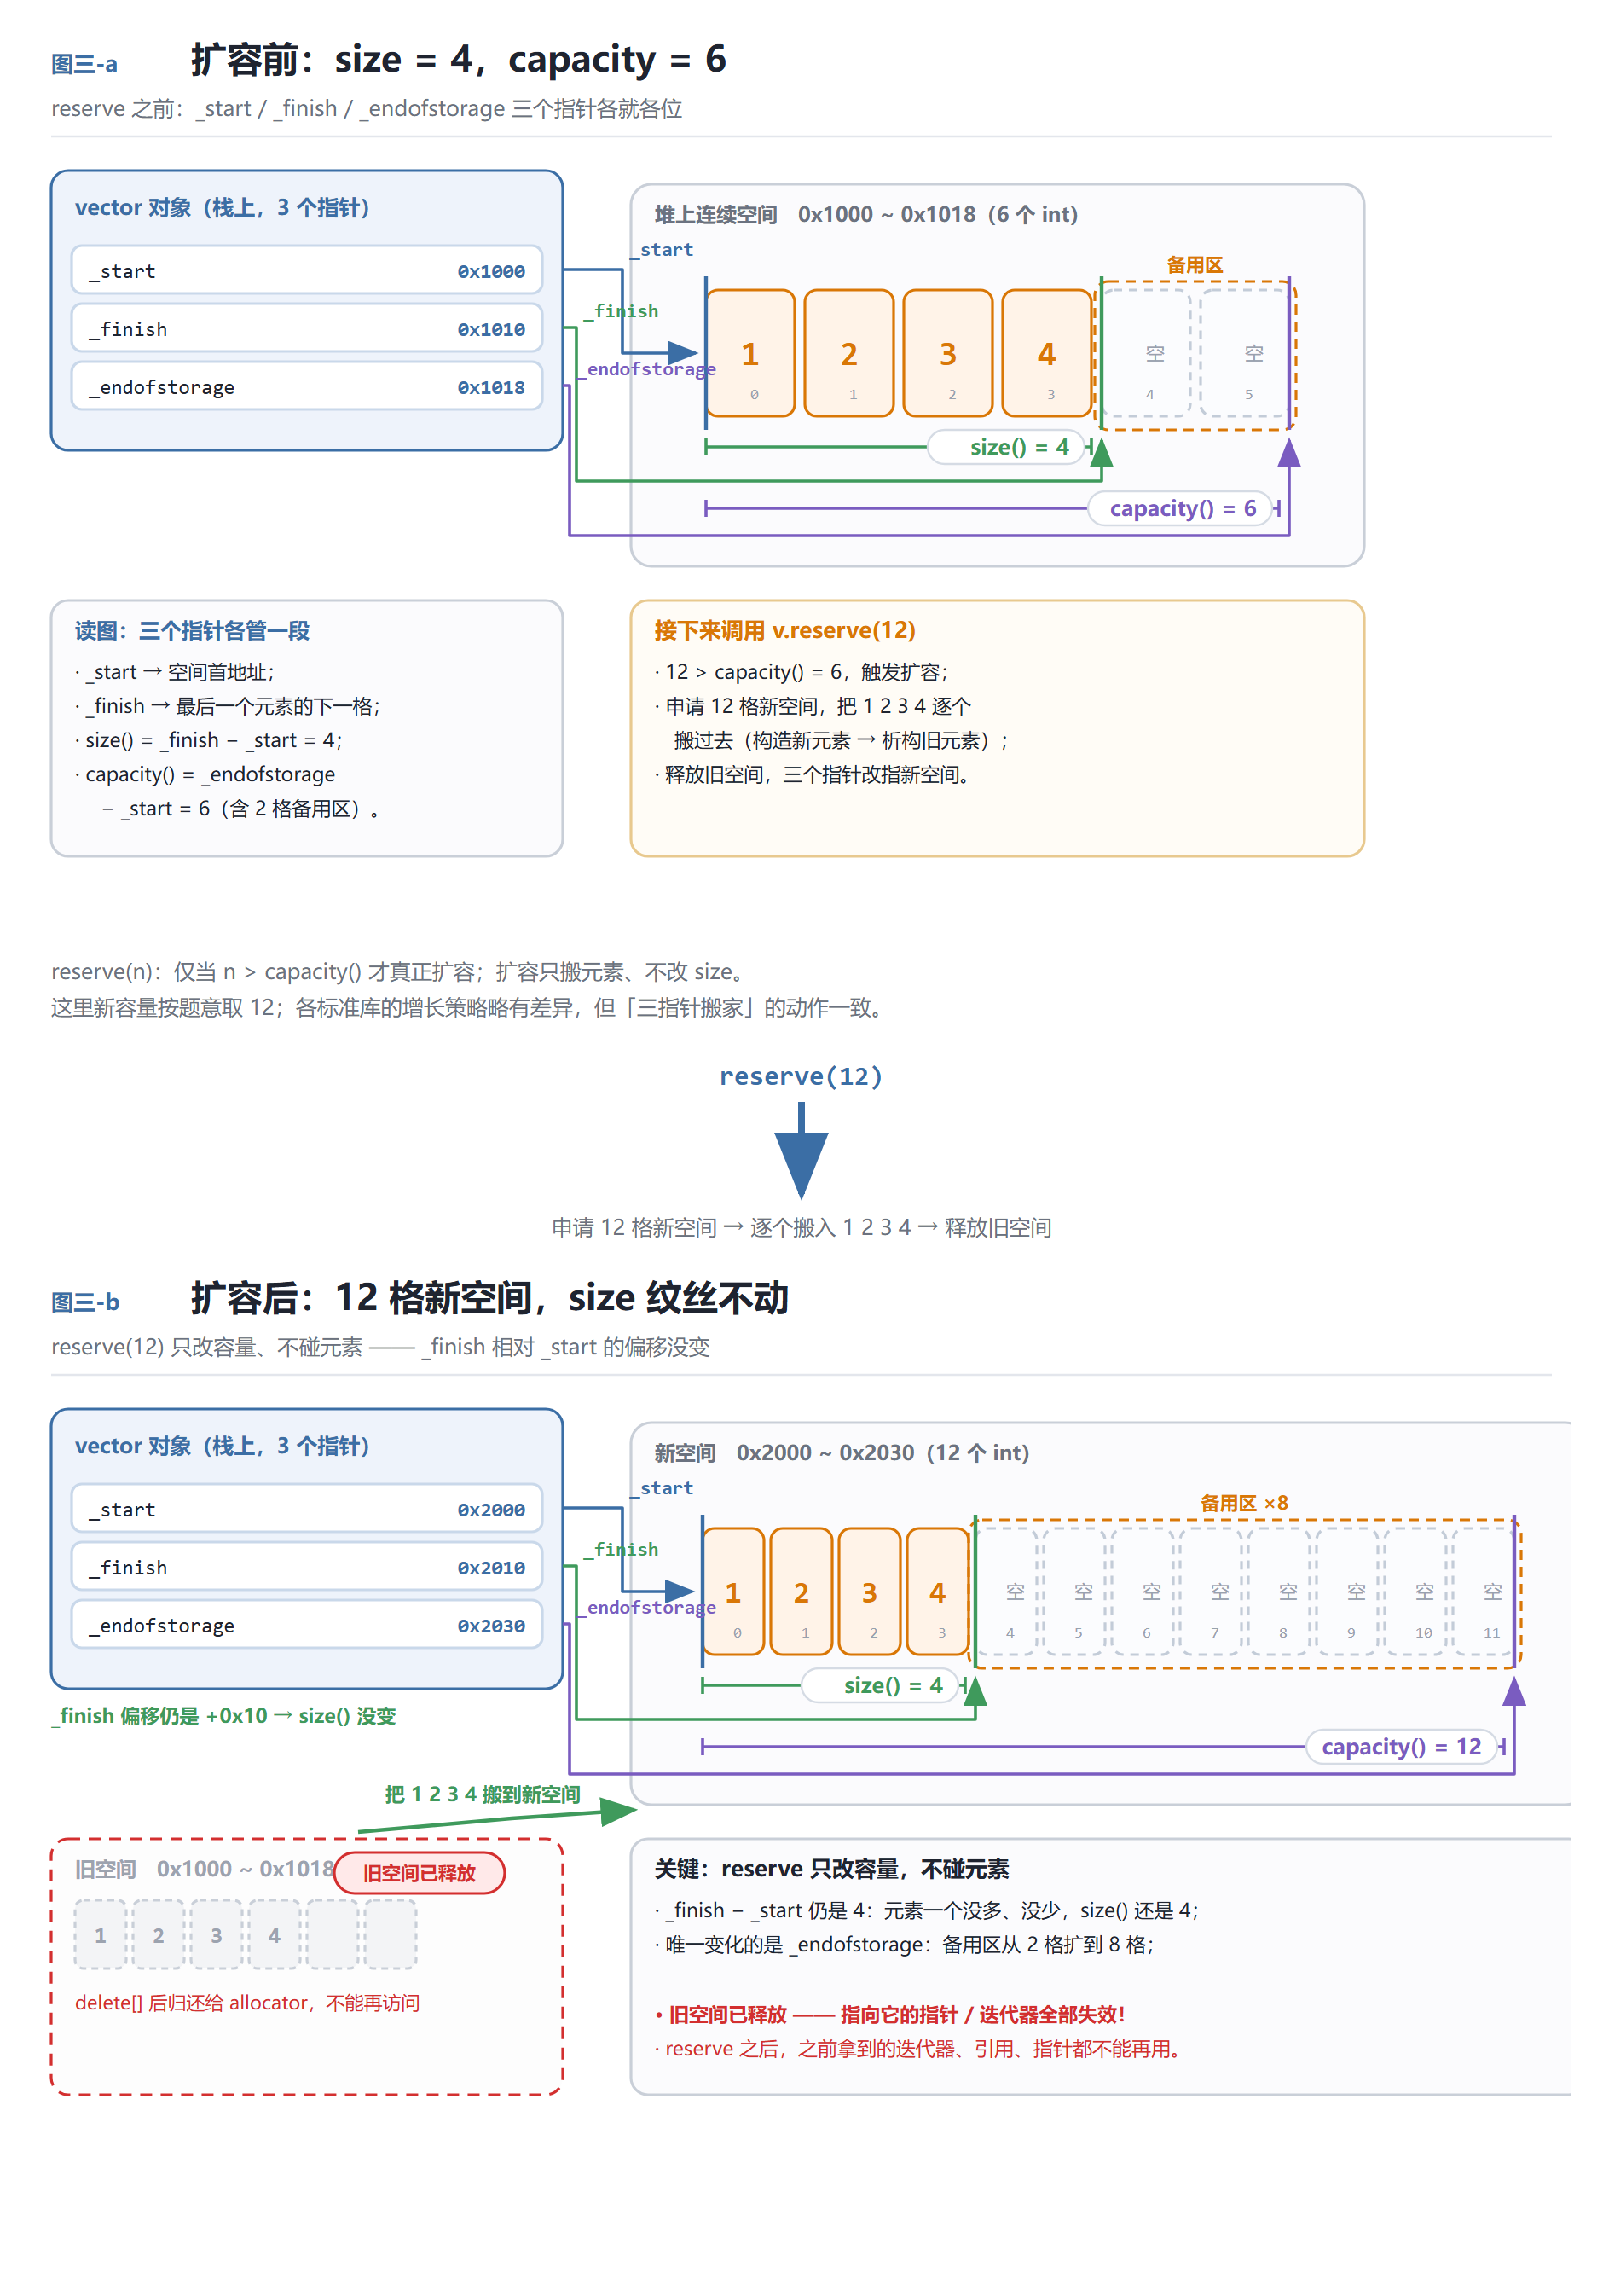
空间不够才扩:开新空间、搬旧数据、放旧空间、更新三个指针,就这四步。
4.2.1 reserve 更新 _finish 的坑
第一行 **size_t sz = size();**藏着一个坑。
可能有人会想:最后不是要 **_finish = _start + size()**吗,直接写不就行了,干嘛提前存个 sz?
因为执行到最后一行时,_start 已经改成指向新空间了,这时候 size() 算的是 _finish - _start,而 _finish 还存在旧空间,_start 已经是新空间,一减就是乱七八糟的数。拿它去更新 _finish,vector 直接废掉。
所以必须趁 _start 还没动,先把 size() 存进 sz,最后用 _start + sz 恢复 _finish。
4.2.2 迭代器失效 ------ 扩容引发的野指针
reserve 还有个副作用:扩容时旧空间被 delete\[\] 释放了。谁要是之前拿过迭代器(指向旧空间的指针),现在就是野指针,再访问就是未定义行为。
cpp
vector<int> v;
v.push_back(1);
auto it = v.begin();   // 指向旧空间
v.reserve(100);        // 扩容,旧空间释放
// *it  ------ 已失效,未定义行为
这就是迭代器失效的第一种来源:扩容产生野指针。VS 下这种访问直接崩,g++ 检查得松,可能还能读到,但结果是错的。insert/erase 引发的失效第六节会系统讲,这里先记住一句:任何可能扩容的操作,都可能让之前的迭代器失效。
再看 resize,它连空间带元素一起管:
cpp
void resize(size_t n, const T& val = T())
{
    if (n < size())
    {
        _finish = _start + n;          // 缩小,砍掉尾巴
    }
    else
    {
        reserve(n);                    // 先保证空间够
        while (_finish != _start + n)  // 多出来的位置逐个填 val
        {
            *_finish = val;
            ++_finish;
        }
    }
}
n 比当前元素少,就把 _finish 缩回去;n 比当前元素多,先 reserve,再把多出来的位置填上 val。
这里重点讲解一下默认参数 val = T() 。T() 是个匿名对象,会调 T 的默认构造:T 是 int ,int() 就是 0;T 是 string,string() 就是空串。内置类型本来没有构造函数,但为了让模板能统一写 T(),C++给内置类型也补上了默认构造,int() 合法且值为 0。所以 resize 的默认构造才能直接写成 T()。
4.3 迭代器 begin/end
vector 的迭代器就是原生指针,begin/end 直接返回两个指针,四个版本(可读写 + 只读):
cpp
iterator begin() { return _start; }
iterator end()   { return _finish; }

const_iterator begin() const { return _start; }
const_iterator end() const   { return _finish; }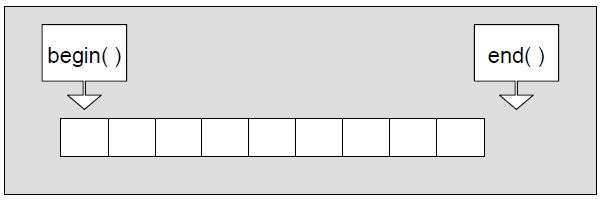
五、深浅拷贝问题
前面 2.4 拷贝构造、4.2 reserve 里,我们一直留着一句话没说透:拷贝元素为什么不用 memcpy,非要 for 循环一个个赋值?接下来我们就开始讨论这个问题:
5.1 vector 的崩溃分析
先看一段会崩的代码。假设我们偷懒,reserve 里用 memcpy 拷贝:
cpp
// 错误示范:reserve 里用 memcpy
void reserve(size_t n)
{
    if (n > capacity())
    {
        size_t sz = size();
        T* tmp = new T[n];
        if (_start)
        {
            std::memcpy(tmp, _start, sizeof(T) * sz);   // 错就错在这一行
            delete[] _start;
        }
        _start = tmp;
        _finish = _start + sz;
        _endofstorage = _start + n;
    }
}
再用 vector 测一下:
cpp
vector<string> v;
v.push_back("1111111111111111");
v.push_back("2222222222222222");
v.push_back("3333333333333333");
v.push_back("4444444444444444");
v.push_back("5555555555555555");   // 第 5 个元素触发扩容,memcpy 浅拷贝后崩溃
为什么崩?问题全出在 memcpy 上。
memcpy 是把一段内存按字节原样搬到另一段,它才不管里面装的是什么。而 vector 的空间里装的,是一个个 string 对象------每个 string对象内部还有自己的 _str 指针,指向堆上真正的字符串。
所以 memcpy 一搬,把 string 对象的 _str 指针值原样复制过去了。搬完之后,新空间的 string 对象和旧空间的 string 对象,_str 指向同一块字符串内存。这就是浅拷贝。
接着 delete\[\] _start 释放旧空间。delete\[\] 会依次调用旧空间里每个 string 的析构,析构又把自己 _str 指向的字符串释放掉。这一下,新空间里那些 string 的 _str 就成了野指针------指向一块已经被释放的内存。再访问一个被释放的内存就会崩溃。
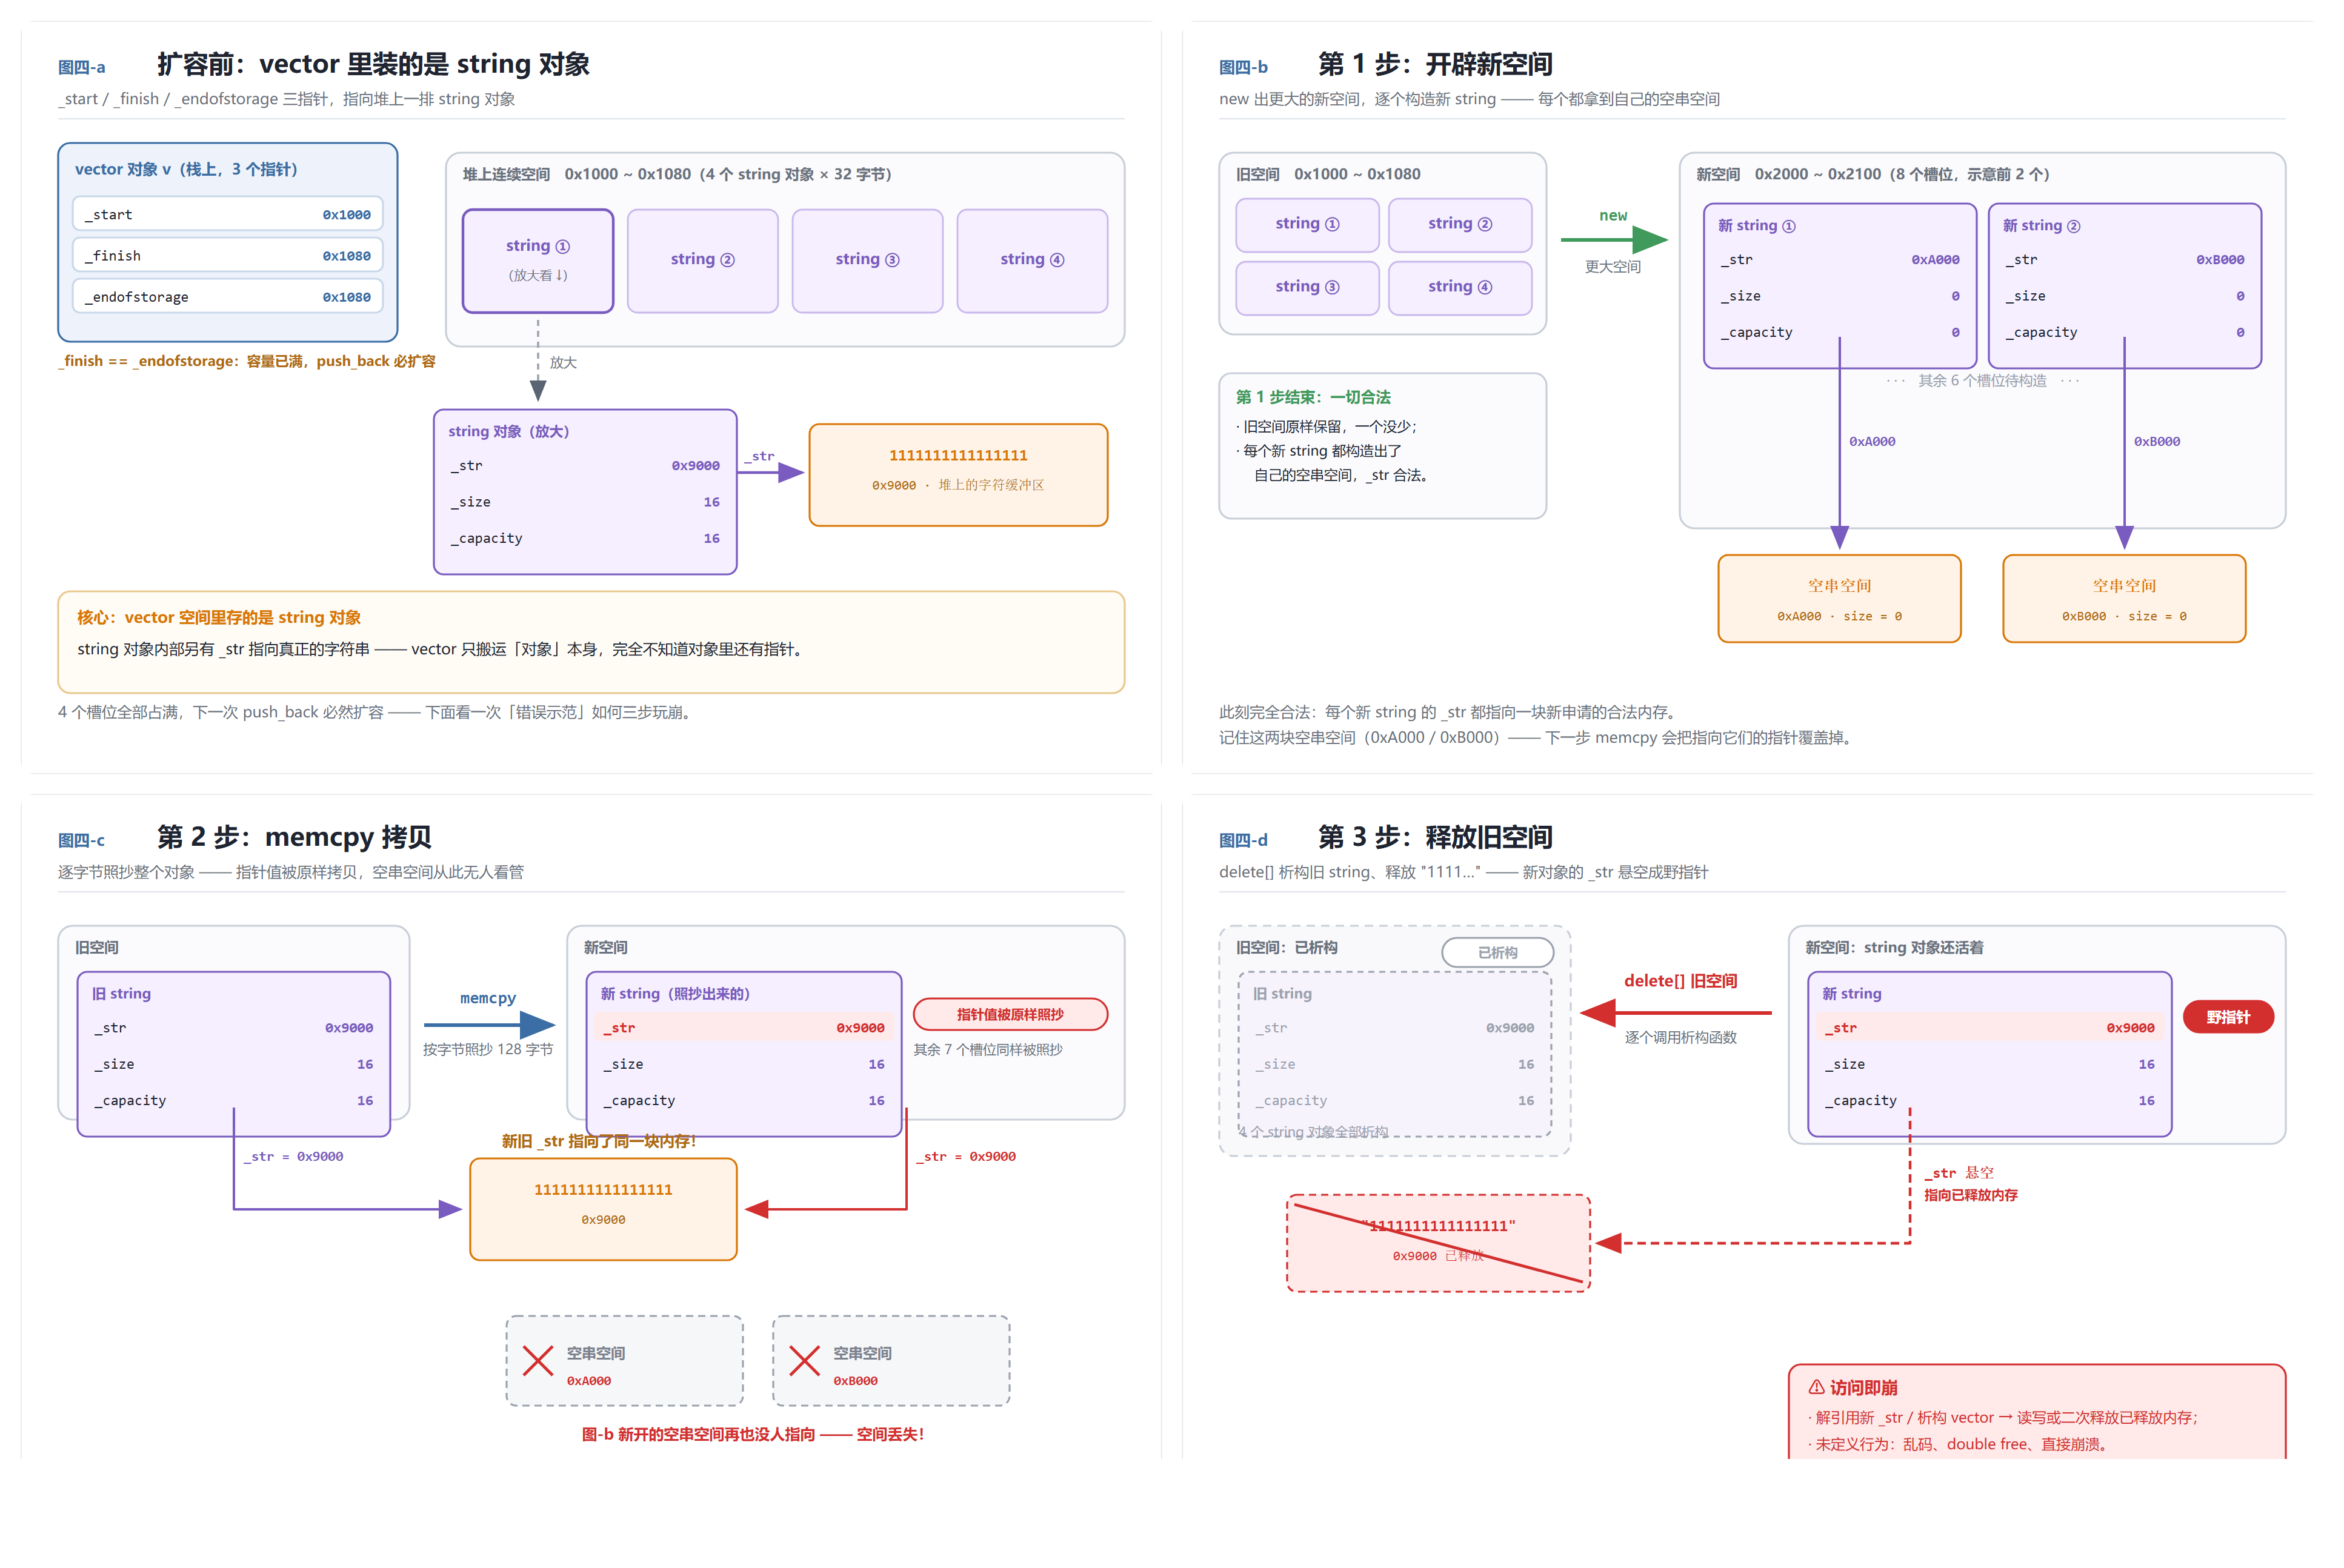
一句话总结:vector 本身是深拷贝,但 memcpy 把元素(string 对象)给浅拷贝了,结果就是野指针 + 崩溃。
5.2 正确做法:赋值重载逐个拷贝
正确写法就是我们一直在用的 for 循环:
cpp
for (size_t i = 0; i < sz; ++i)
{
    tmp[i] = _start[i];
}区别在哪?tmpi = _starti 这一行,调用的是 string 的赋值运算符重载,走的是 string 自己的深拷贝:每个 string 对象会重新开一块堆空间,把字符串内容拷贝过去。所以搬完之后,新空间的每个 string 都有独立的一份字符串,谁也不影响谁。
对比一下就清楚了:
- memcpy:按字节硬拷指针值 -> 元素浅拷贝 -> 两个 string 共享一块字符串 -> 释放旧空间后新空间变野指针 -> 程序崩溃。
- 循环赋值:调元素的 operator= -> 元素深拷贝 -> 每个 string 独立 -> 安全。
结论:元素是自定义类型(尤其带资源管理的)时,拷贝一律用赋值/拷贝构造,绝不用memcpy。
5.3 动态二维数组 vector<vector>
最后看一个挺直观的例子,能帮我们把"vector 空间里存的是 T 的对象数组"这句话彻底想明白------vector 的元素本身也可以是 vector。
比如杨辉三角这种二维结构:
填充前:
cpp
vector<vector<int>> vv(n);              // 外层 n 行,每行是一个 vector<int>
for (size_t i = 0; i < n; ++i)
    vv[i].resize(i + 1, 1);             // 每行先 resize 成 i+1 个元素,都填 1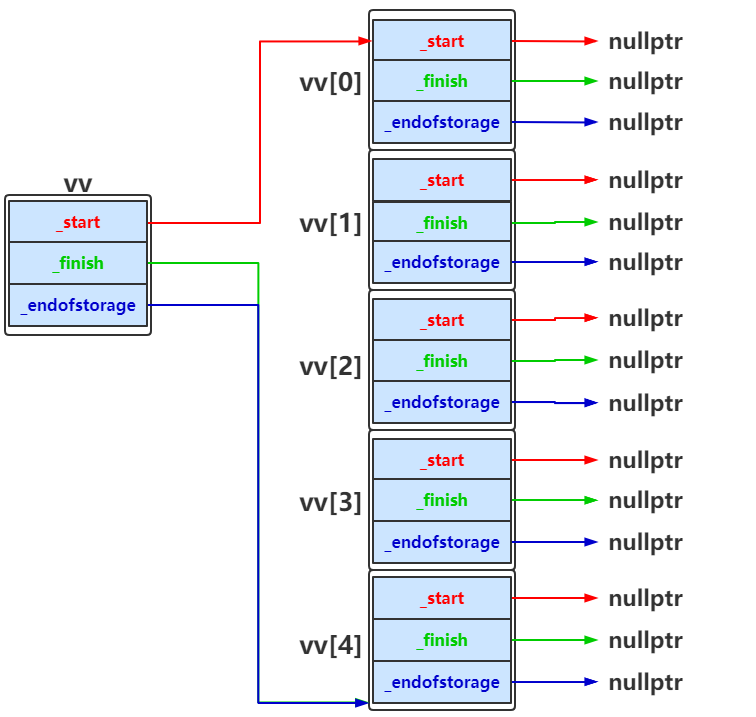
填充后:
cpp
for (size_t i = 2; i < n; ++i)          // 前两行已经是 1,从第 2 行起填中间值
    for (size_t j = 1; j < i; ++j)      // 中间元素 = 左上方 + 右上方
        vv[i][j] = vv[i - 1][j] + vv[i - 1][j - 1];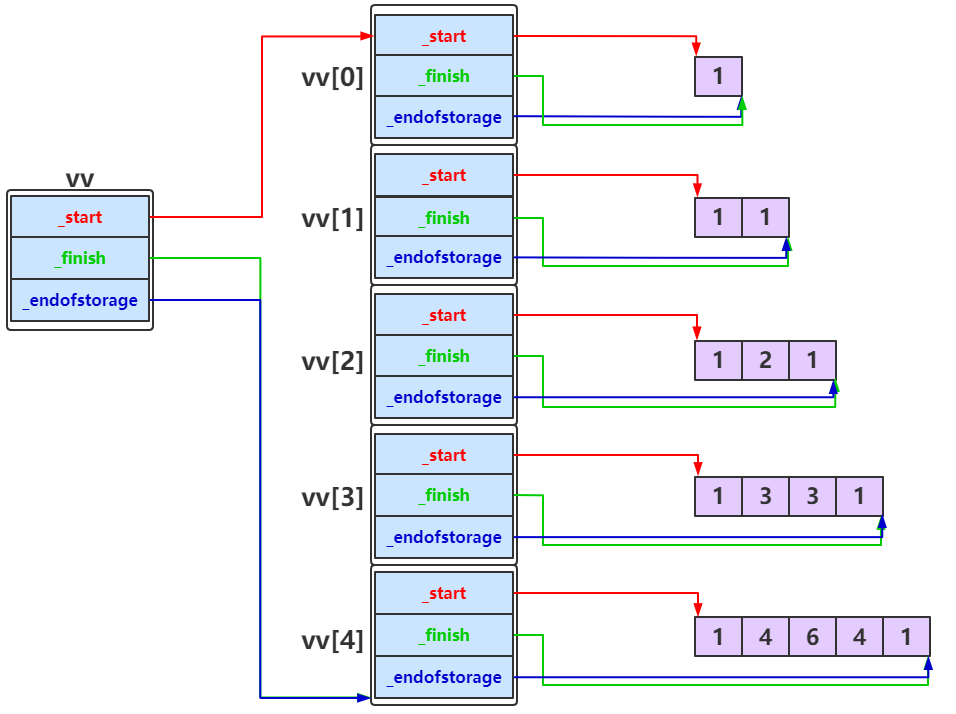
vv 是外层 vector,它的元素类型 T 是 vector<int>。所以外层空间里,一个挨一个存的是 n 个 vector 对象,每个对象都有自己的一套三指针。刚构造完时(vv(n) 调的是 2.2 的 n 个 val 构造),这些内层对象的三指针都还是空指针;vvi.resize(i+1, 1) 才给每一行各自开数据空间。
这个例子反过来也印证了 5.1:正因为 vector 空间里存的是"对象",拷贝 vector<vector> 时更不能 memcpy------否则内层 vector 的三指针被浅拷贝,几个 vector 共享同一段数据,又会变成野指针。
六、修改操作
6.1 push_back 和 pop_back
逻辑很简单,我们这里直接复用后续要讲解的 insert 和 erase:
cpp
void push_back(const T& x)
{
    insert(end(), x);   // 在末尾插入
}

void pop_back()
{
    erase(end() - 1);     // 删掉最后一个元素
}
push_back 的参数是 const T& x,用引用是为了避免 T 是 string 这种类型时,传参还要多一次拷贝。这俩本质就是"在 end() 处插入"和"删 end() 前一个"。
6.2 insert
insert 在任意位置 pos 插入元素,是 vector 里最"重"的操作之一:
cpp
iterator insert(iterator pos, const T& x)
{
    assert(pos >= _start && pos <= _finish);

    if (_finish == _endofstorage)                 // 满了,先扩容
    {
        size_t len = pos - _start;                // 先记下 pos 相对 _start 的偏移
        size_t newcapacity = capacity() == 0 ? 4 : capacity() * 2;
        reserve(newcapacity);                     // 扩容会释放旧空间,pos 失效
        pos = _start + len;                       // 用偏移量恢复 pos
    }

    iterator end = _finish - 1;
    while (end >= pos)                            // 把 pos 及其后的元素整体后移一位
    {
        *(end + 1) = *end;
        --end;
    }

    *pos = x;                                     // 空出来的位置放 x
    ++_finish;

    return pos;
}
流程分两块:先看满没满,满了就扩容;再把 pos 及其后面的元素整体往后挪一位,空出 pos 放 x。
挪数据这里和 string 的 insert 有个区别,值得说一下。上一篇 string 的 insert 里,挪数据要小心 size_t 下溢------pos 是 0 时,循环变量减到 -1 会变成无符号最大值,死循环。vector 没有这个麻烦,因为 pos 是迭代器(原生指针),end >= pos 这个条件天然保证不会减到 _start 前面去。这就是"insert 对比 string,挪动数据更简单,因为 pos 不会小于 0"。
6.2.1 迭代器失效------ insert 偏向野指针
上面 insert 里有一段挺突兀的代码:扩容前先 size_t len = pos - _start 记偏移,扩容后再 pos = _start + len 恢复。这是在干嘛呢?
因为 reserve 扩容会把旧空间 delete\[\] 释放掉,pos 指向的还是旧空间,就成了野指针。所以 insert 内部先记下 pos 离 _start 有多远(偏移量),扩容后用新 _start 加上偏移量,把 pos 找回来。
但注意,insert 只能"救"它自己的 pos 形参。你要是从外面传一个迭代器进来,insert 之后还用原来的那个,就踩雷了:
cpp
vector<int> v;
v.push_back(1);
v.push_back(2);
v.push_back(3);
v.push_back(4);     // 现在 size == capacity == 4,满了

vector<int>::iterator p = v.begin() + 3;   // 指向 4
v.insert(p, 300);   // 满了,插入必扩容,p 失效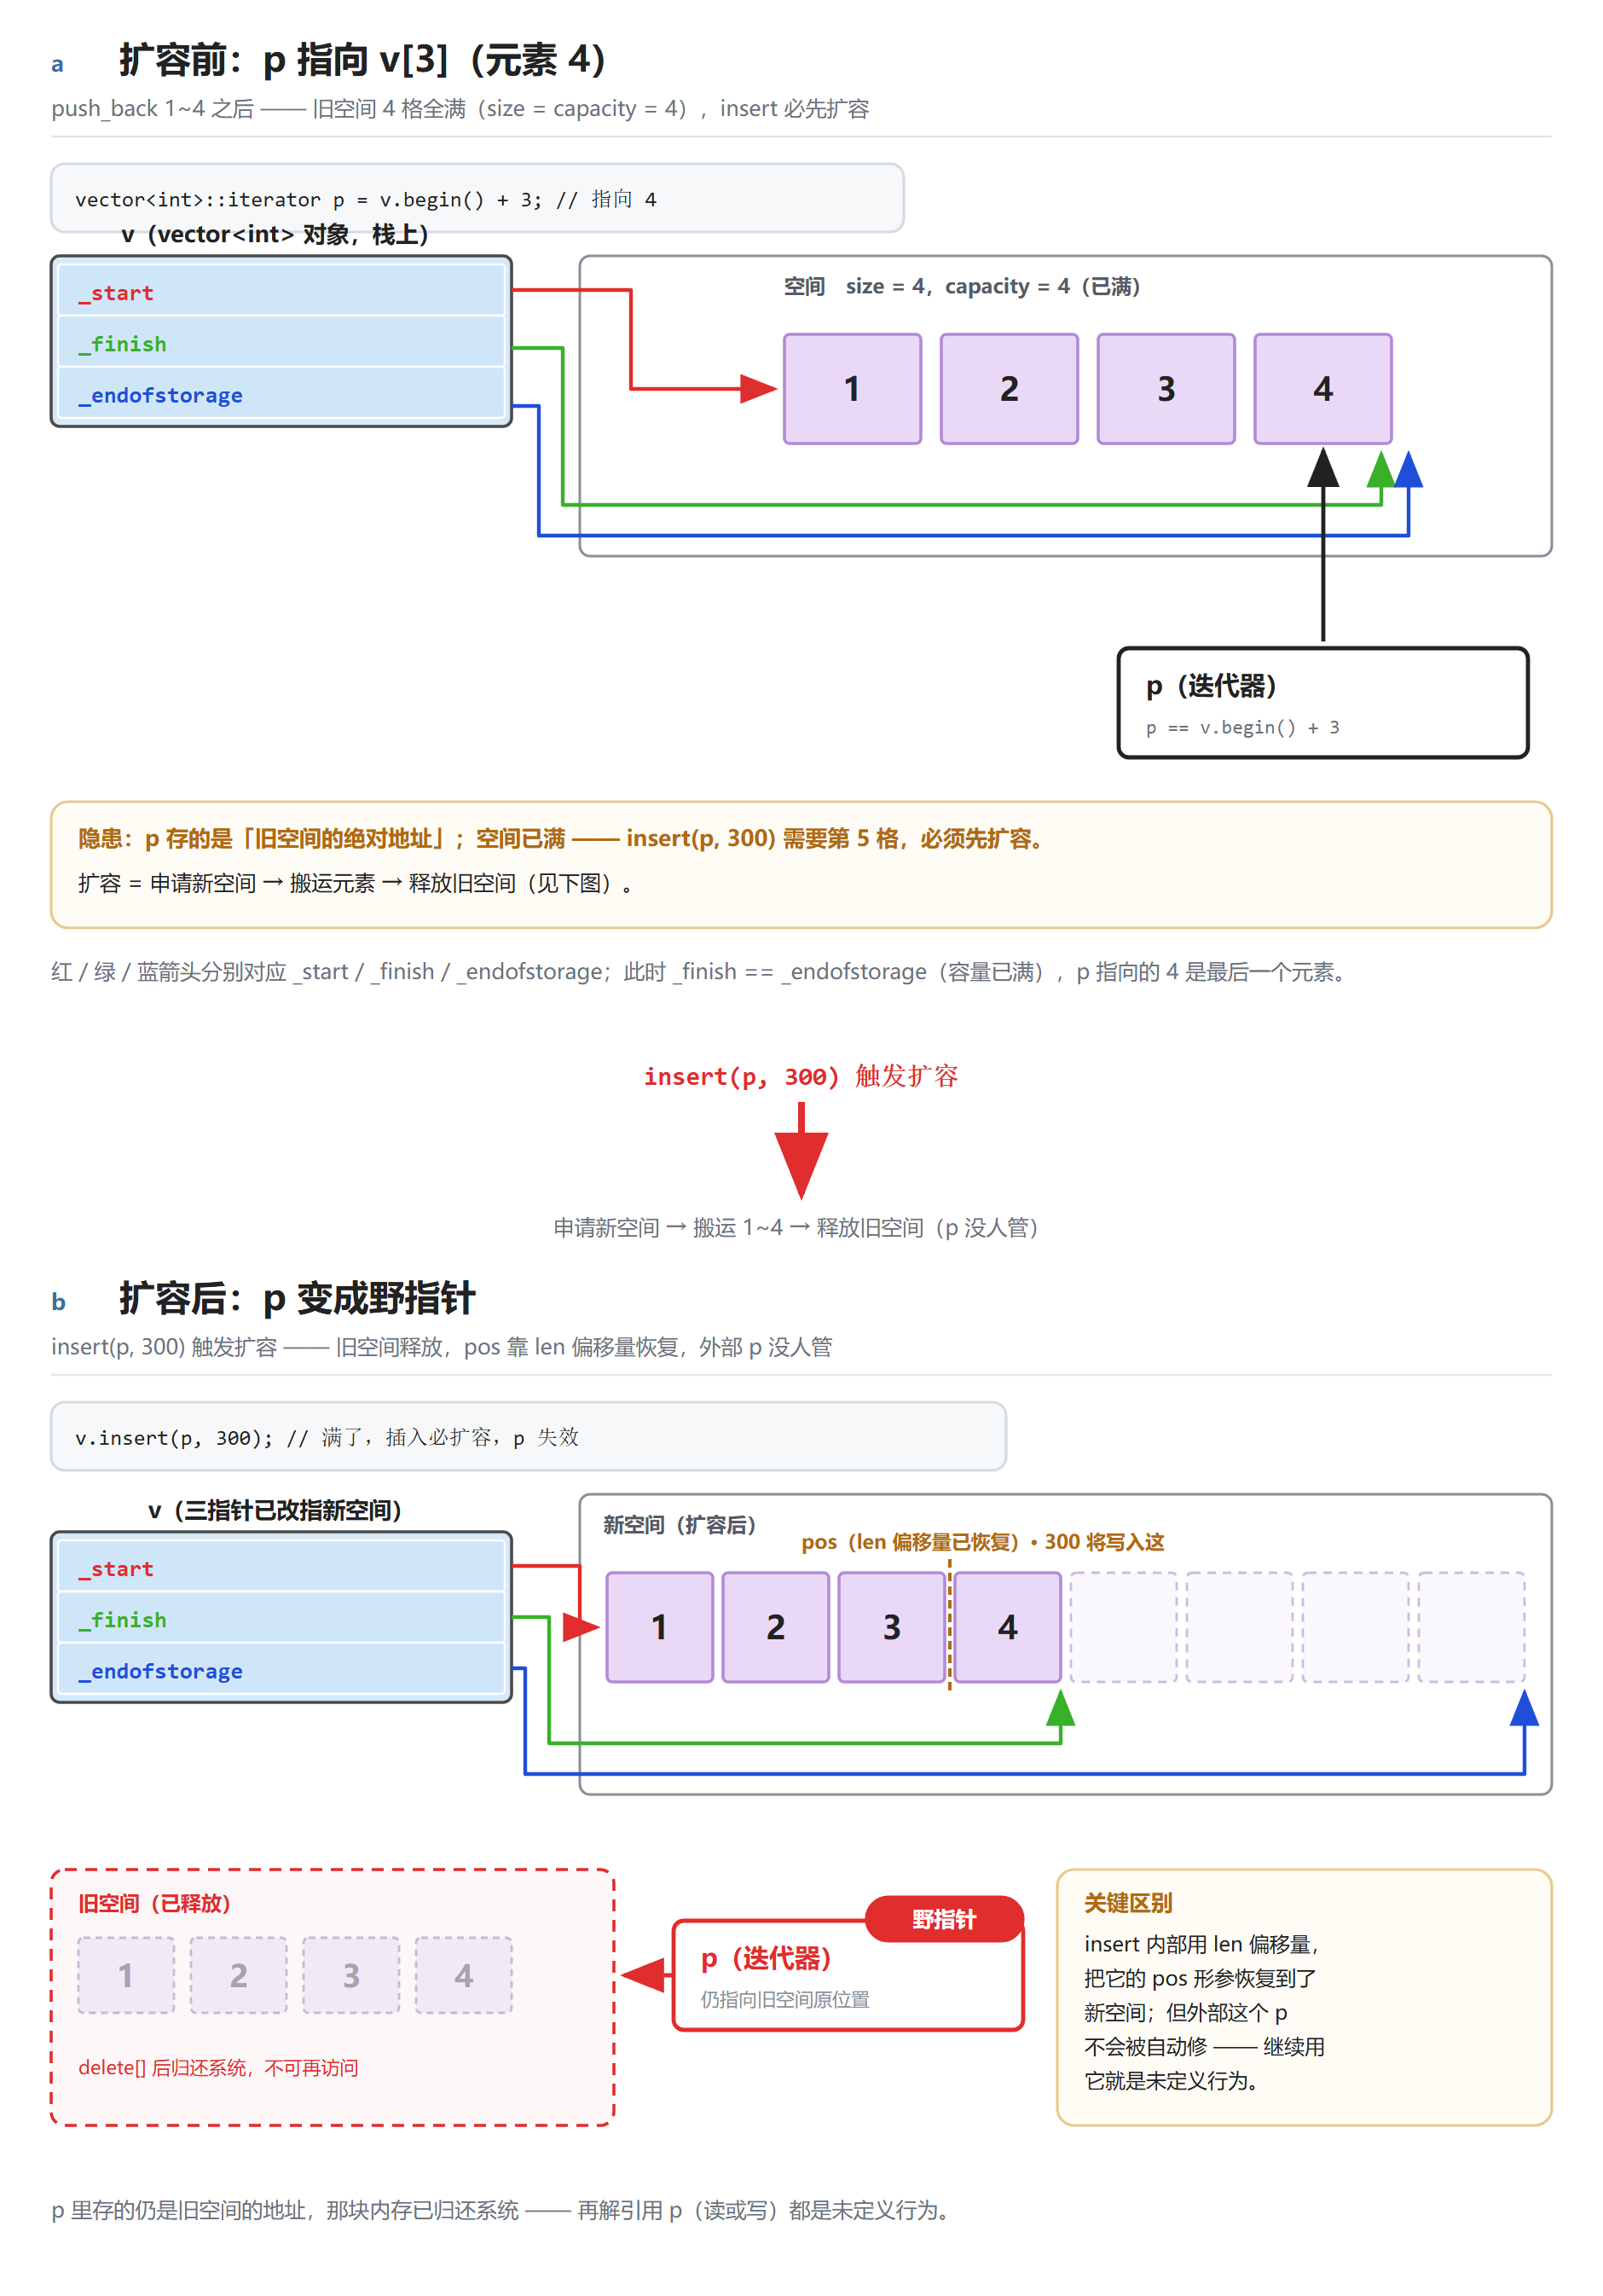
所以结论:**insert 之后,原来拿到的迭代器就当作失效,别再用了。**insert 返回的那个才是有效的新迭代器。
6.3 erase
cpp
iterator erase(iterator pos)
{
    assert(pos >= _start && pos < _finish);

    iterator it = pos + 1;
    while (it != _finish)                         // 把 [pos+1, _finish) 整体前移一位
    {
        *(it - 1) = *it;
        ++it;
    }

    --_finish;

    return pos;
}
逻辑是:把 pos 后面的元素整体往前挪一位,把 pos 盖掉,然后 _finish 减一。返回 pos,也就是删除位置现在的那个元素(原来 pos + 1 的那个)。
6.3.1 迭代器失效------ erase 偏向意义改变
erase 也涉及迭代器失效,但性质和 insert 不一样:erase 不扩容、不释放空间,所以迭代器不会变野指针。问题在于,元素前移之后,pos 这个位置"指向的东西"变了。
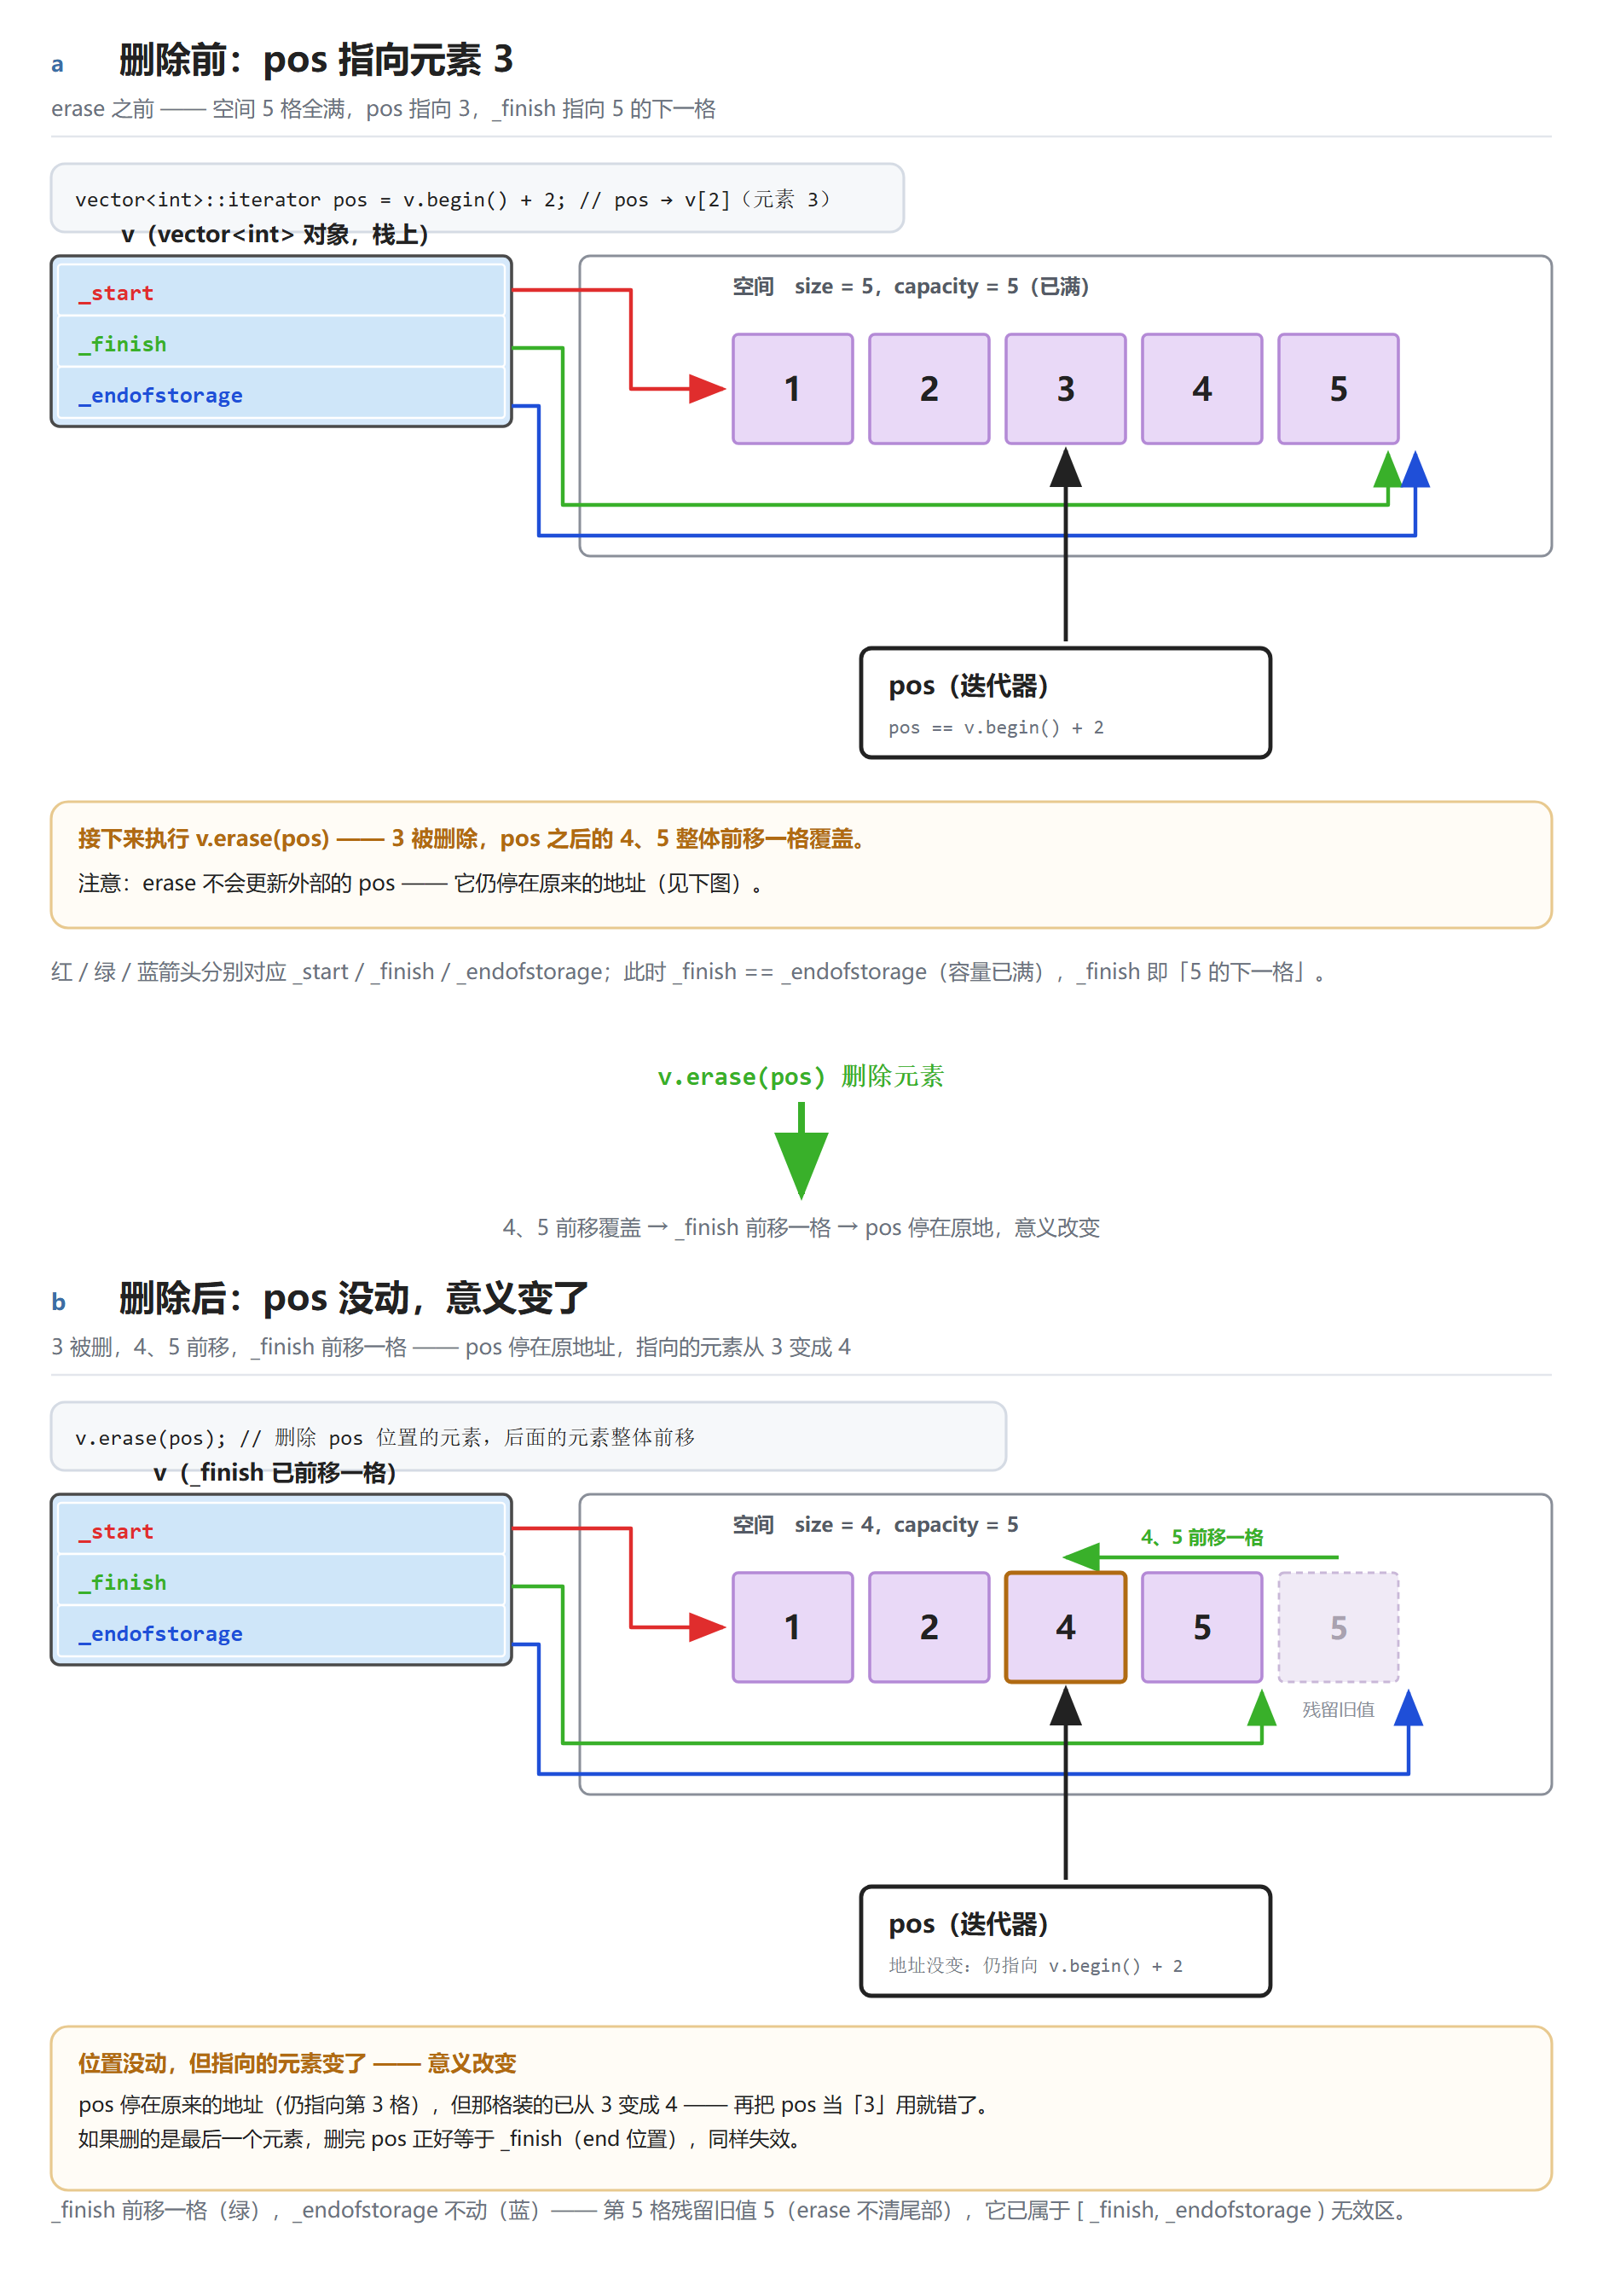
所以 erase 的失效,是"这个迭代器的意义变了",不是"变野指针了"。这也是 erase 要返回一个迭代器的原因------用 it = erase(it) 接住删除位置的新迭代器,继续遍历才不会出错。
看个实际场景,删除 vector 里所有偶数,错误和正确写法对比:
cpp
// 错误:erase 后 it 已失效,++it 是未定义行为
auto it = v.begin();
while (it != v.end())
{
    if (*it % 2 == 0)
        v.erase(it);
    ++it;
}

// 正确:用 erase 的返回值接住新迭代器
auto it = v.begin();
while (it != v.end())
{
    if (*it % 2 == 0)
        it = v.erase(it);   // 删完,it 指向下一个有效元素
    else
        ++it;
}
6.3.2 vs 与 g++ 的检测差异
最后说一下,同样是访问失效的迭代器,不同编译器反应不一样。
VS 的 STL 检查很严格,失效迭代器一访问,直接断言崩溃。Linux 下的 g++ 检查得松,很多失效的迭代器照样能读能写,但读出来的是垃圾、写进去是往野内存里写,反而更危险------程序不崩,结果悄悄错了,这种 bug 最难查。
所以别指望编译器帮你兜底,规矩就一条:insert、erase(以及一切可能扩容的操作)之后,之前拿到的迭代器一律当作失效,别再用。需要继续用,就用接口返回的那个新的。
顺带说一句 list:它和 vector 不一样,list 的迭代器不是原生指针,是包了一层的自定义类型,所以它的 insert/erase 不会让迭代器失效。这个等后面讲到 list 再展开。
到这里,vector 的核心接口就全部实现了。
结语
至此,一个相对完整的 vector 模拟实现就完成了。我们从三个指针成员出发,一路实现了构造函数(含各种重载和迭代器区间构造)、拷贝构造、赋值、容量管理、增删改,以及贯穿始终的两个核心难点------迭代器失效和 memcpy 浅拷贝。
当然,真实的标准库 vector 远比这复杂,比如它用空间配置器(allocator)来管理内存、扩容策略各平台不同(VS 约 1.5 倍、g++ 2 倍)、insert 内部用 uninitialized_copy 处理未构造内存等等。我们这里追求的是把核心思想吃透,而不是复刻工程细节,剩下的优化留给大家有兴趣再深入。
下一篇我们会讲 list。list 和 vector 最大的不同在于:它的迭代器不是原生指针,而是包了一层的自定义类型------这也正好接上了本篇结尾留下的"迭代器失效"这个话题,因为 list 的 insert/erase 不会让迭代器失效。
写文不易,希望各位给个三连~
言已至此,感谢各位读者花费时间阅读,本人浅学才疏,如有文笔拙劣之处还望见谅~