一、问题描述:
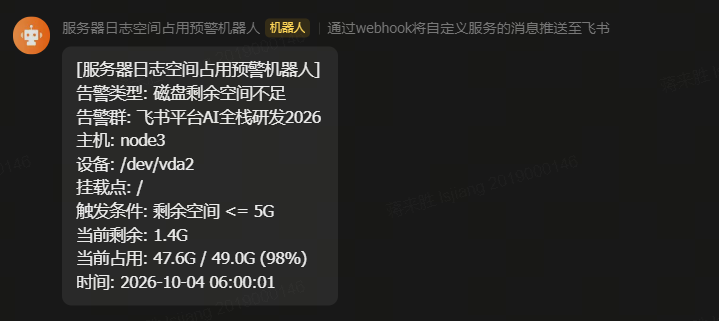
国庆假期期间,群里有开发联调环境服务器监控告警,具体信息如下
登录到服务器之后,发现prometheus目目录下面有很多WAL文件
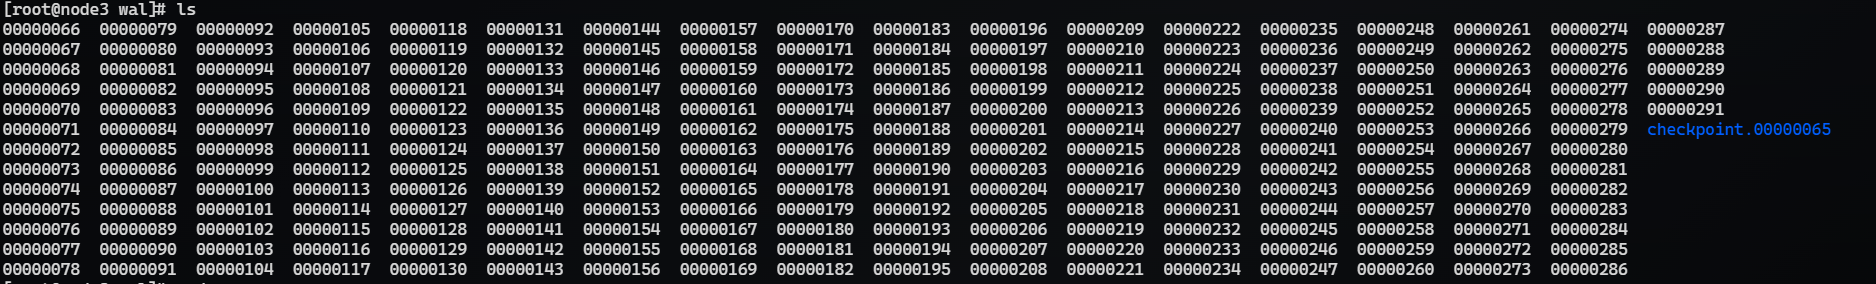
总文件大小,占用了接近20G,所以触发了上图的空间占用告警

二、原因分析:
理论上prometheus应该配置了WAL日志的压缩和保留策略,可以看到Prometheus的pod里面配置文件,配置了15天的保留策略,理论上不会出现磁盘占用问题
--config.file=/etc/prometheus/prometheus.yml
--storage.tsdb.path=/prometheus
--storage.tsdb.retention.time=15d
--web.listen-address=:9090
当时查看Prometheus日志,发现一些关键信息
  compaction failed
  corruption in segment /prometheus/wal/00000066
  unexpected full record
同时还能看到:
  write block
  Head GC completed
  Creating checkpoint
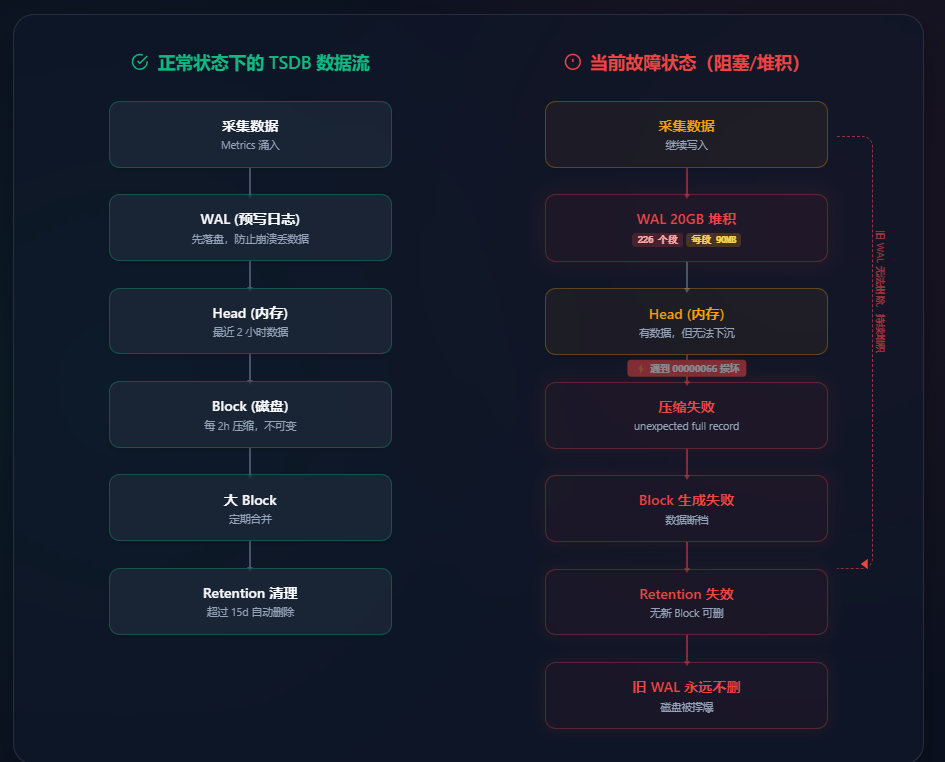
这些关键日志表明
-
Prometheus 仍在持续接收监控样本;
-
Head 数据仍可能正常生成新的 block;
-
但在创建 checkpoint、读取 WAL 段 00000066 时遇到损坏或不完整记录;
-
checkpoint 失败后,旧 WAL 无法正常截断;
-
新 WAL 持续生成,最终导致 /data/prometheus/dev-test/wal 占满磁盘。
三、解决方案:
1. 停止 Prometheus
kubectl -n monitoring scale deployment/prometheus --replicas=0
kubectl -n monitoring get pod -l app.kubernetes.io/name=prometheus
必须确认 Prometheus Pod 已终止,并确认节点上没有仍在运行的 Prometheus 进程:
pgrep -af '/bin/prometheus|prometheus --config.file' || true2. 保留旧 TSDB 并创建新目录
STAMP=$(date +%Y%m%d%H%M%S)
BACKUP=/data/prometheus/dev-test.corrupt.${STAMP}
mv /data/prometheus/dev-test "$BACKUP"
mkdir -p /data/prometheus/dev-test
chown --reference="$BACKUP" /data/prometheus/dev-test
chmod --reference="$BACKUP" /data/prometheus/dev-test
ls -ld /data/prometheus/dev-test "$BACKUP"
df -hT /3. 恢复 Prometheus
kubectl -n monitoring scale deployment/prometheus --replicas=1
kubectl -n monitoring rollout status deployment/prometheus --timeout=180s
验证:
kubectl -n monitoring get pod -l app.kubernetes.io/name=prometheus -o wide
kubectl -n monitoring logs -l app.kubernetes.io/name=prometheus --since=10m
四、后续优化
1. 存储优化
-
不要把 Prometheus TSDB 放在节点根分区;
-
使用独立数据盘或 Kubernetes PVC;
-
为 Prometheus 配置明确的存储容量和扩容方案;
-
这次开发联调环境,应该避免生产环境使用无容量边界的
HostPath; -
对 TSDB 目录设置独立的磁盘使用率监控。
2. 数据保留和远端存储
-
时间保留和容量保留同时配置;
-
通过
--storage.tsdb.retention.time与--storage.tsdb.retention.size双重约束; -
重要监控数据使用
remote_write写入长期存储; -
明确本地数据丢失后的恢复目标和可接受时间。
示例:
--storage.tsdb.retention.time=15d
--storage.tsdb.retention.size=80GB
实际容量应根据磁盘大小、样本量、压缩比例和增长趋势测算,不应机械套用示例值。
3. 版本和升级
-
评估从
2.22.1升级到当前组织批准的稳定版本; -
升级前备份配置、规则、告警和数据目录;
-
先在测试环境验证 WAL replay、compaction、remote_write 和规则兼容性;
4. 告警建议
至少配置以下告警:
-
文件系统使用率超过 80%、90%、95%;
-
Prometheus TSDB WAL 目录持续增长;
-
Prometheus compaction 失败;
-
Prometheus WAL 损坏或 checkpoint 失败;
-
Prometheus readiness 失败;
-
抓取目标大量丢失;
-
Prometheus 重启次数异常;
-
远端写入失败或积压。
5. 运维巡检
如果是生产环境,建议每日或每小时执行只读巡检:
df -hT /
du -sxh /data/prometheus/dev-test
du -sxh /data/prometheus/dev-test/wal
find /data/prometheus/dev-test/wal -maxdepth 1 -type f | wc -l
kubectl -n monitoring get pod -l app.kubernetes.io/name=prometheus
kubectl -n monitoring logs -l app.kubernetes.io/name=prometheus --since=1h \
  | grep -Ei 'corruption|compaction failed|checkpoint|out of space|error'