本文收录于专栏 agent智能体系列 ------ 专栏系统覆盖 AI Agent 的记忆、工具、插件与实战,点击订阅可跟踪后续更新。
本课定位 :第 1 课给了判定框架,但要动手还得先补一块地基:Agent 眼中的 LLM 到底长什么样。本课从 Agent 视角重讲四个底层机制------消息结构、chat template、function calling 协议、上下文窗口与 token 账单。Agent 的每一层机制最终都落在对 LLM API 的理解上。本课不讲 transformer 结构,只讲写 Agent 时必须内化的四件事。它们是后面每一课代码的"物理定律",第 6 课的最小 Agent 会逐条用到。
阶段 1|概念与基础 | 来源:【补】(吸收微软课程微· 00 环境准备与微·04 Tool Use 设计模式的思想)
关键字: 大模型基础、消息结构、Chat Template、Function Calling、上下文窗口、token计费、OpenAI兼容API、Agent底层机制
本节目录
- [2.1 消息结构:Agent 的一切状态都在 messages 数组里](#2.1 消息结构:Agent 的一切状态都在 messages 数组里)
- [2.2 Chat Template 与 special tokens:同一模型,千种格式](#2.2 Chat Template 与 special tokens:同一模型,千种格式)
- [2.3 Function Calling / Tool Call:模型输出的是"意图",不是执行](#2.3 Function Calling / Tool Call:模型输出的是"意图",不是执行)
- [2.4 上下文窗口与 token 计费:Agent 的资源约束](#2.4 上下文窗口与 token 计费:Agent 的资源约束)
概念讲解
2.1 消息结构:Agent 的一切状态都在 messages 数组里
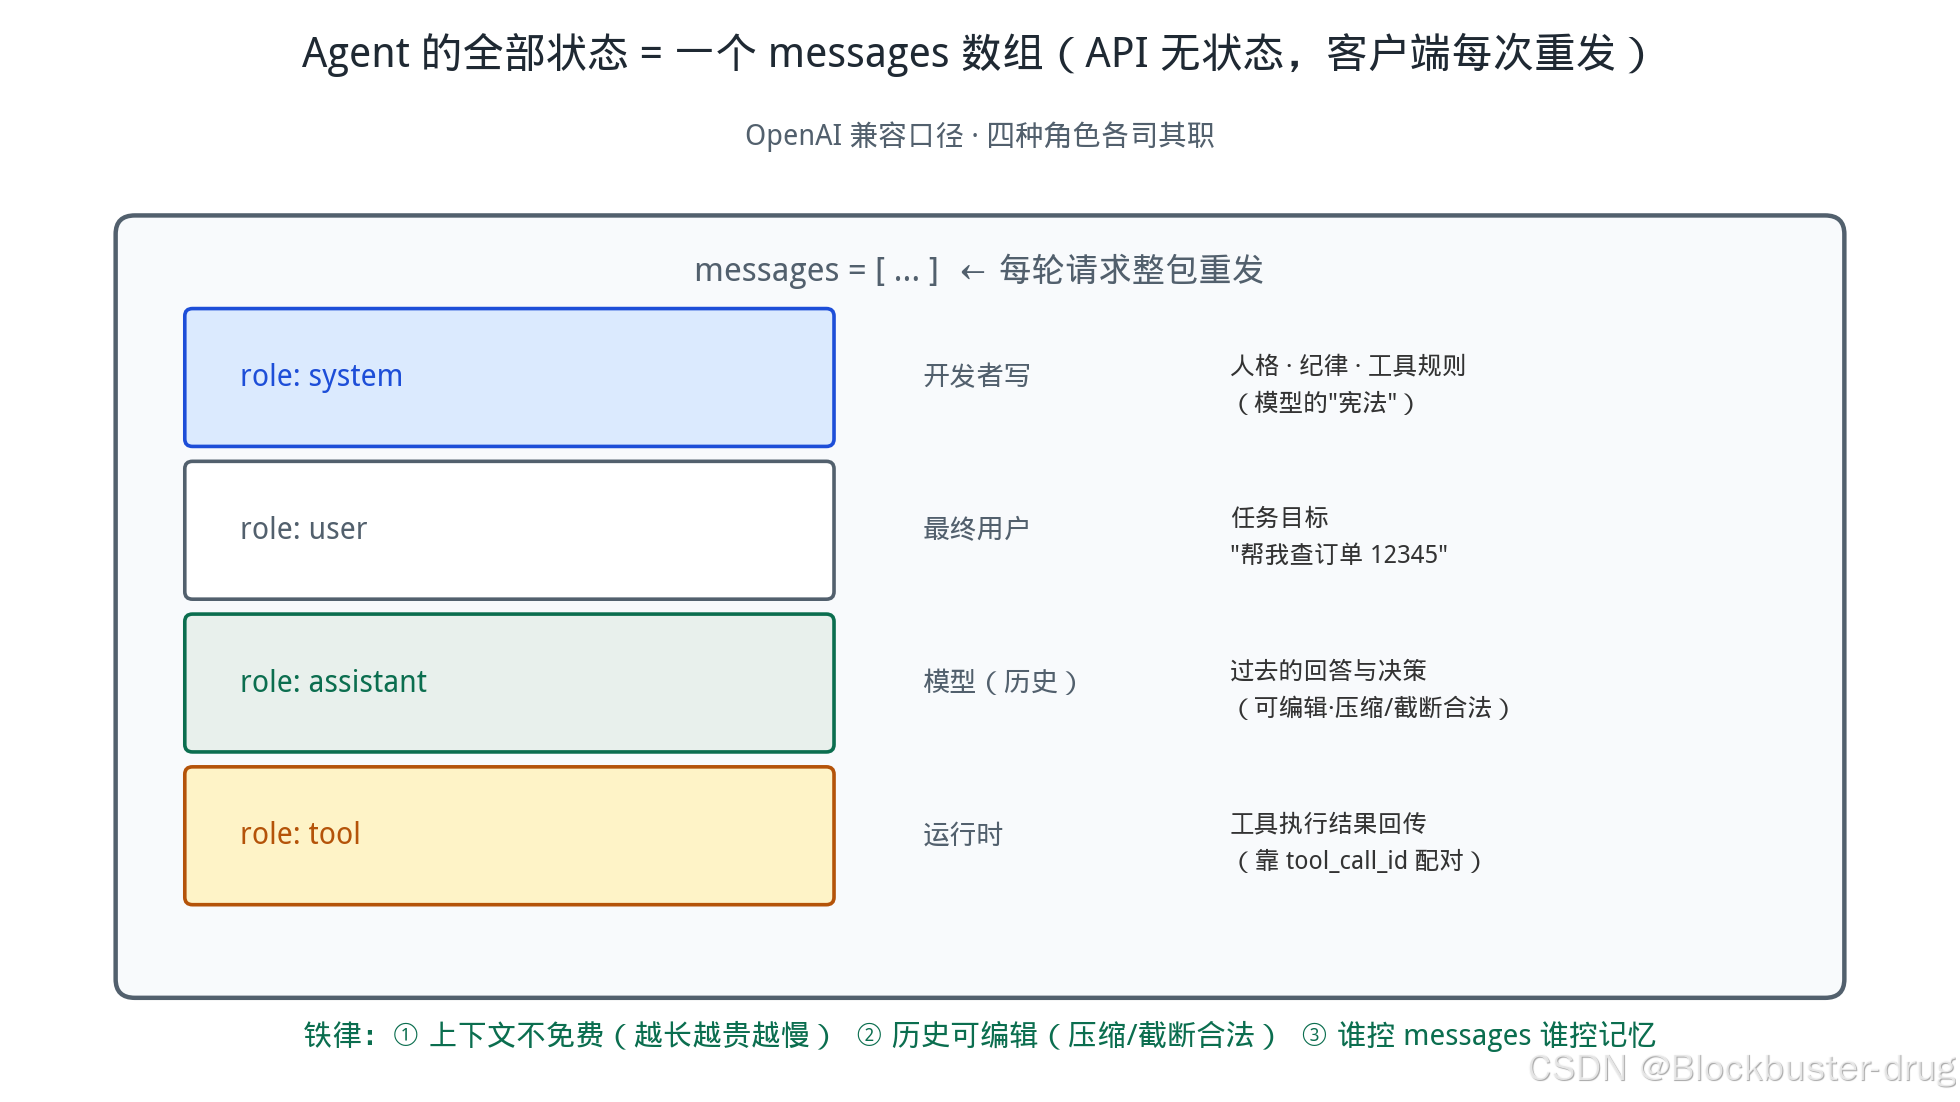
OpenAI 兼容 API(如今是事实行业标准,国内外模型几乎全部兼容)的最小请求是:
python
{"model": "...", "messages": [
    {"role": "system",    "content": "你是一个助手"},
    {"role": "user",      "content": "你好"},
    {"role": "assistant", "content": "你好!"},
    {"role": "user",      "content": "介绍一下你自己"},
]}
四个角色各司其职:
| 角色 | 谁写的 | Agent 中的用途 |
|---|---|---|
system |
开发者 | 人格、纪律、工具使用规则------模型"宪法" |
user |
最终用户 | 任务目标 |
assistant |
模型(历史) | 模型过去的回答与工具调用决策 |
tool |
运行时 | 工具执行结果回传(对应 tool_call_id) |
关键认知:API 是无状态的 。你以为的"模型记得上下文",实际是你(客户端)把完整历史 messages 数组每次重发一遍。这个事实推出 Agent 工程的三条铁律:
- 上下文不是免费的------数组越长,费用和延迟越高(见 2.4 节)。
- 历史是可编辑的------压缩、截断、重写历史都是合法操作,这是第 13 课"上下文工程"的全部基础。
- 谁控制 messages 数组,谁控制 Agent 的记忆------框架做的事无出其右。
2.2 Chat Template 与 special tokens:同一模型,千种格式
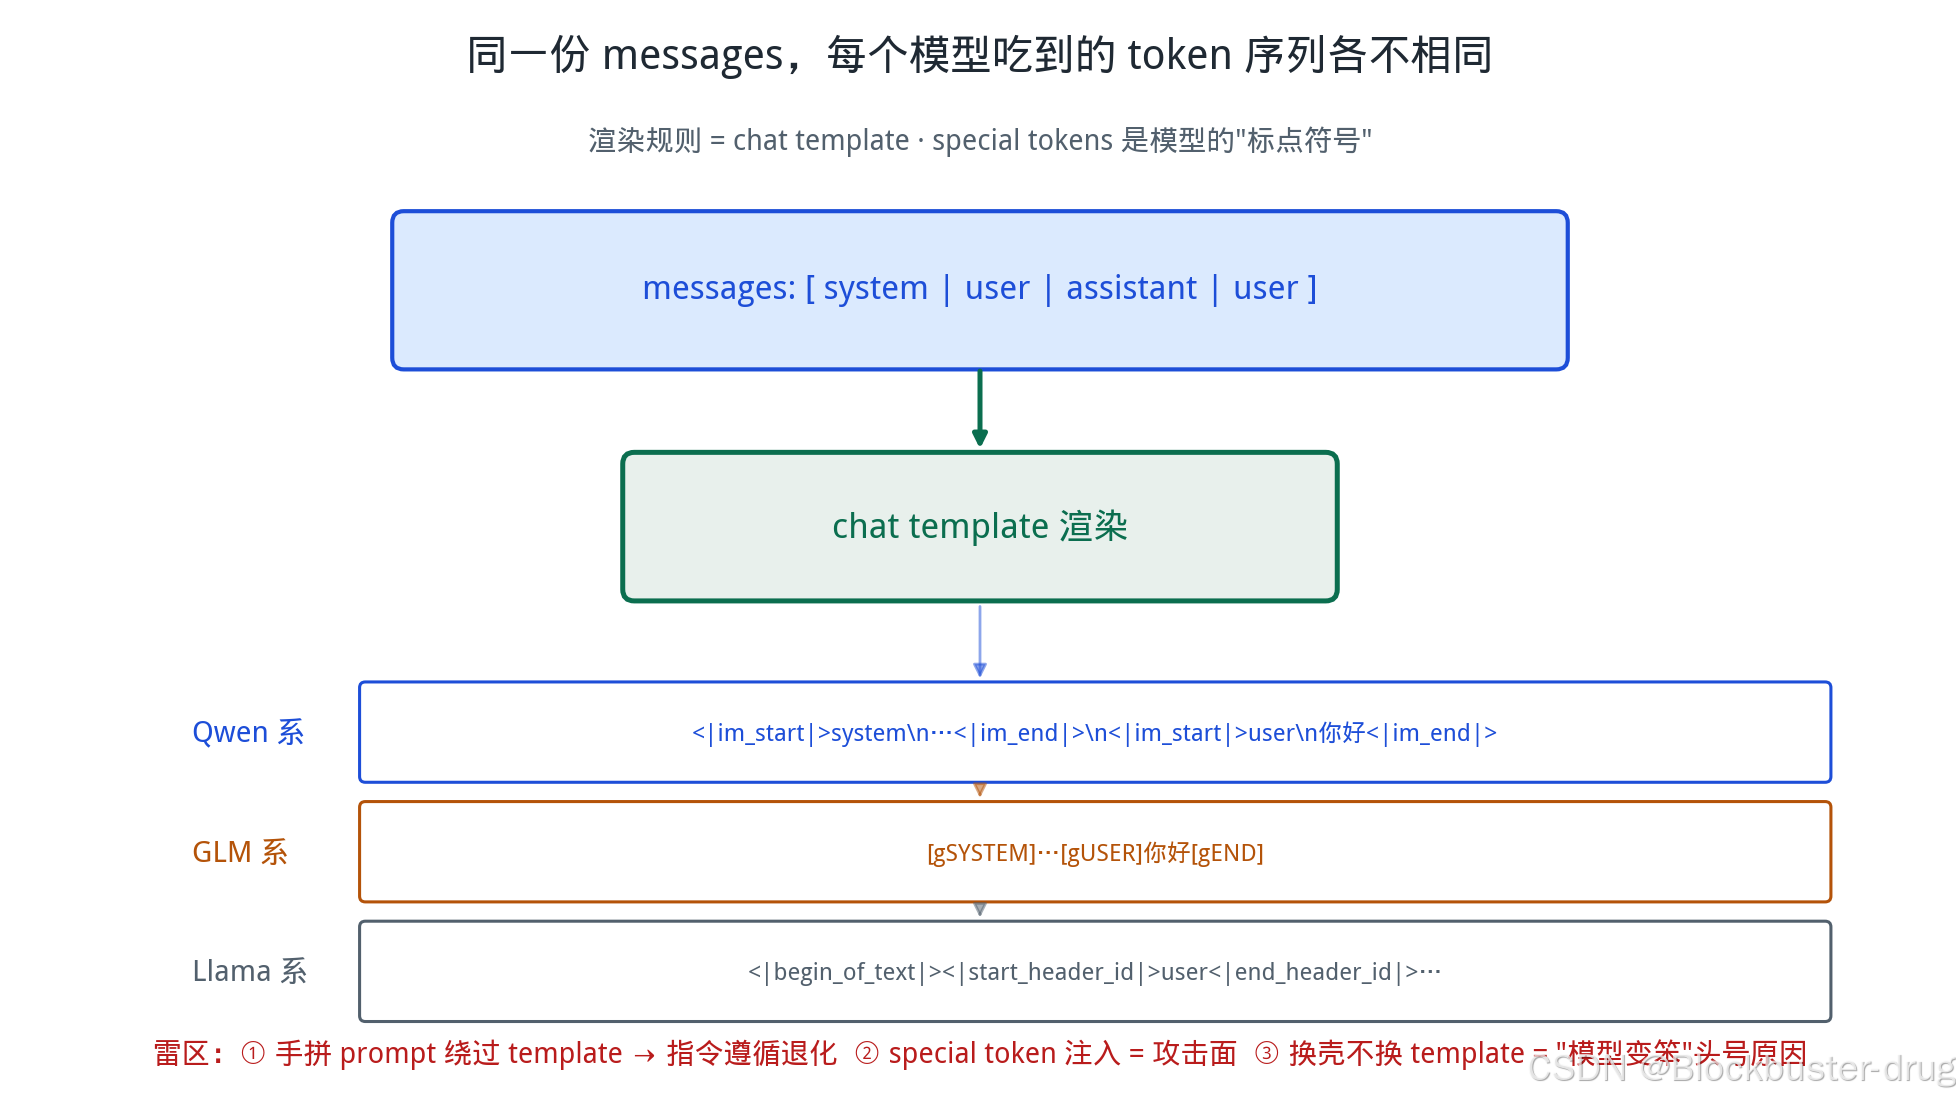
API 背后,服务端会把 messages 数组渲染成模型实际吃到的单个 token 序列 ,渲染规则就是 chat template(对话模板)。例如某模型的模板可能是:
<|system|>你是一个助手<|user|>你好<|assistant|>你好!...其中 <|system|>、<|user|> 这类就是 special tokens(特殊标记)------加入词表、被分词器强制切分、对模型有特殊语义的 token。三条工程含义:
- 不要手拼 prompt 绕过 template。直接把"System: xxx"写进 user 消息是常见错误------模型的对齐训练是在 template 格式上做的,格式不对,指令遵循显著退化。
- special token 注入是攻击面 。用户输入里若含有
<|im_end|>之类标记,可能截断/伪造对话结构。生产系统要对输入做转义或过滤(第 29 课展开)。 - 开源模型换壳要换 template 。本地部署 Qwen/Llama/GLM 系模型时,template 用错是"模型突然变笨"的头号原因;vLLM/Ollama 等推理框架已内置各家模板,走
/v1/chat/completions端点即可自动套用。
2.3 Function Calling / Tool Call:模型输出的是"意图",不是执行
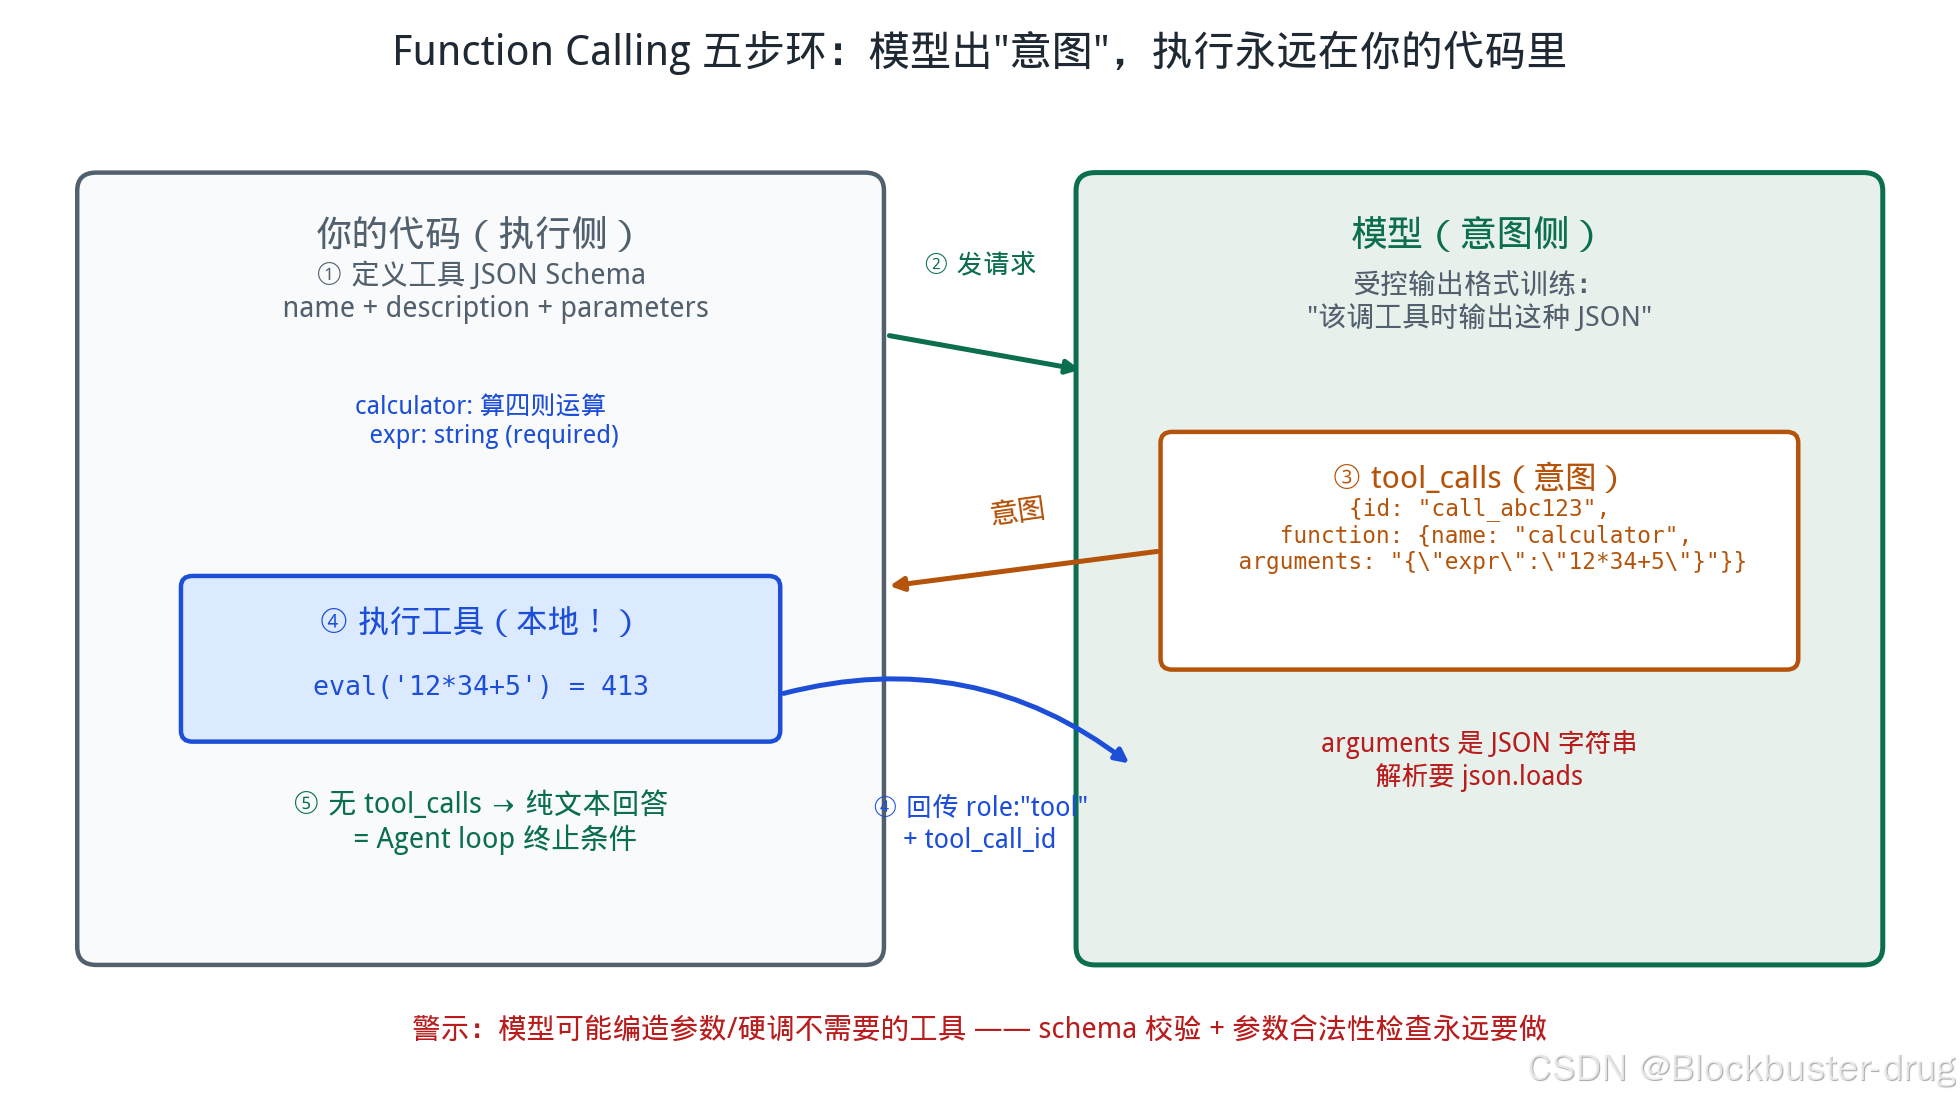
微软第 4 课把 Tool Use 立为独立设计模式,其定义值得原文引用:"Tools are code that can be executed by an agent... tools are designed to be executed by agents in response to model-generated function calls "(工具是 Agent 执行的代码,其触发由模型生成的函数调用驱动)------注意 "model-generated":决策在模型、执行在代码 ,这正是本节要拆开的机制。2023 年 6 月 OpenAI 引入 function calling,现演化为 tools 参数。当前 API 层的工作流(OpenAI 兼容口径,五步):
① 定义工具 JSON Schema ──► ② 连同 messages 发给模型
     ▲                              │
     │                              ▼
⑤ 模型给出最终回答 ◄──── ④ 结果以 role:"tool" 消息回传
     ▲                      ▲
     │                      │
     └── ③ 模型返回 tool_calls(你要自己执行!)
关键点逐条:
① 工具定义是 JSON Schema 。name + description + parameters,其中 description 是写给模型看的------它就是工具的"prompt"(第 8 课 ACI 的核心议题)。
② 模型返回的是结构化意图:
json
{"role": "assistant", "tool_calls": [{
    "id": "call_abc123",
    "type": "function",
    "function": {"name": "calculator",
                 "arguments": "{\"expr\": \"12*34+5\"}"}
}]}
注意 arguments 是JSON 字符串 (不是对象),解析时要 json.loads。
③ 模型不执行任何东西。它只是说"我想调 calculator,参数是这"。执行永远发生在你的代码里------这就是为什么同一个协议能对接数据库、HTTP API、本地脚本:执行器是你写的。
④ 结果回传要带 tool_call_id 。模型靠 id 把结果和请求配对。一次返回多个 tool_calls(并行调用)时逐个配对回传。
⑤ 停止信号 。当模型不再返回 tool_calls 而返回纯文本,循环结束------这就是 Agent loop 的终止条件(第 6 课)。
最后一条容易被忽略:function calling 不是魔法,是受控输出格式训练。模型被训练成"该调工具时输出这种 JSON 结构",但"何时该调"仍由概率决定------所以参数可能错、可能编造不存在的工具参数值、可能在不需要时硬调。工程上永远要校验(schema 验证 + 参数合法性检查)。
2.4 上下文窗口与 token 计费:Agent 的资源约束
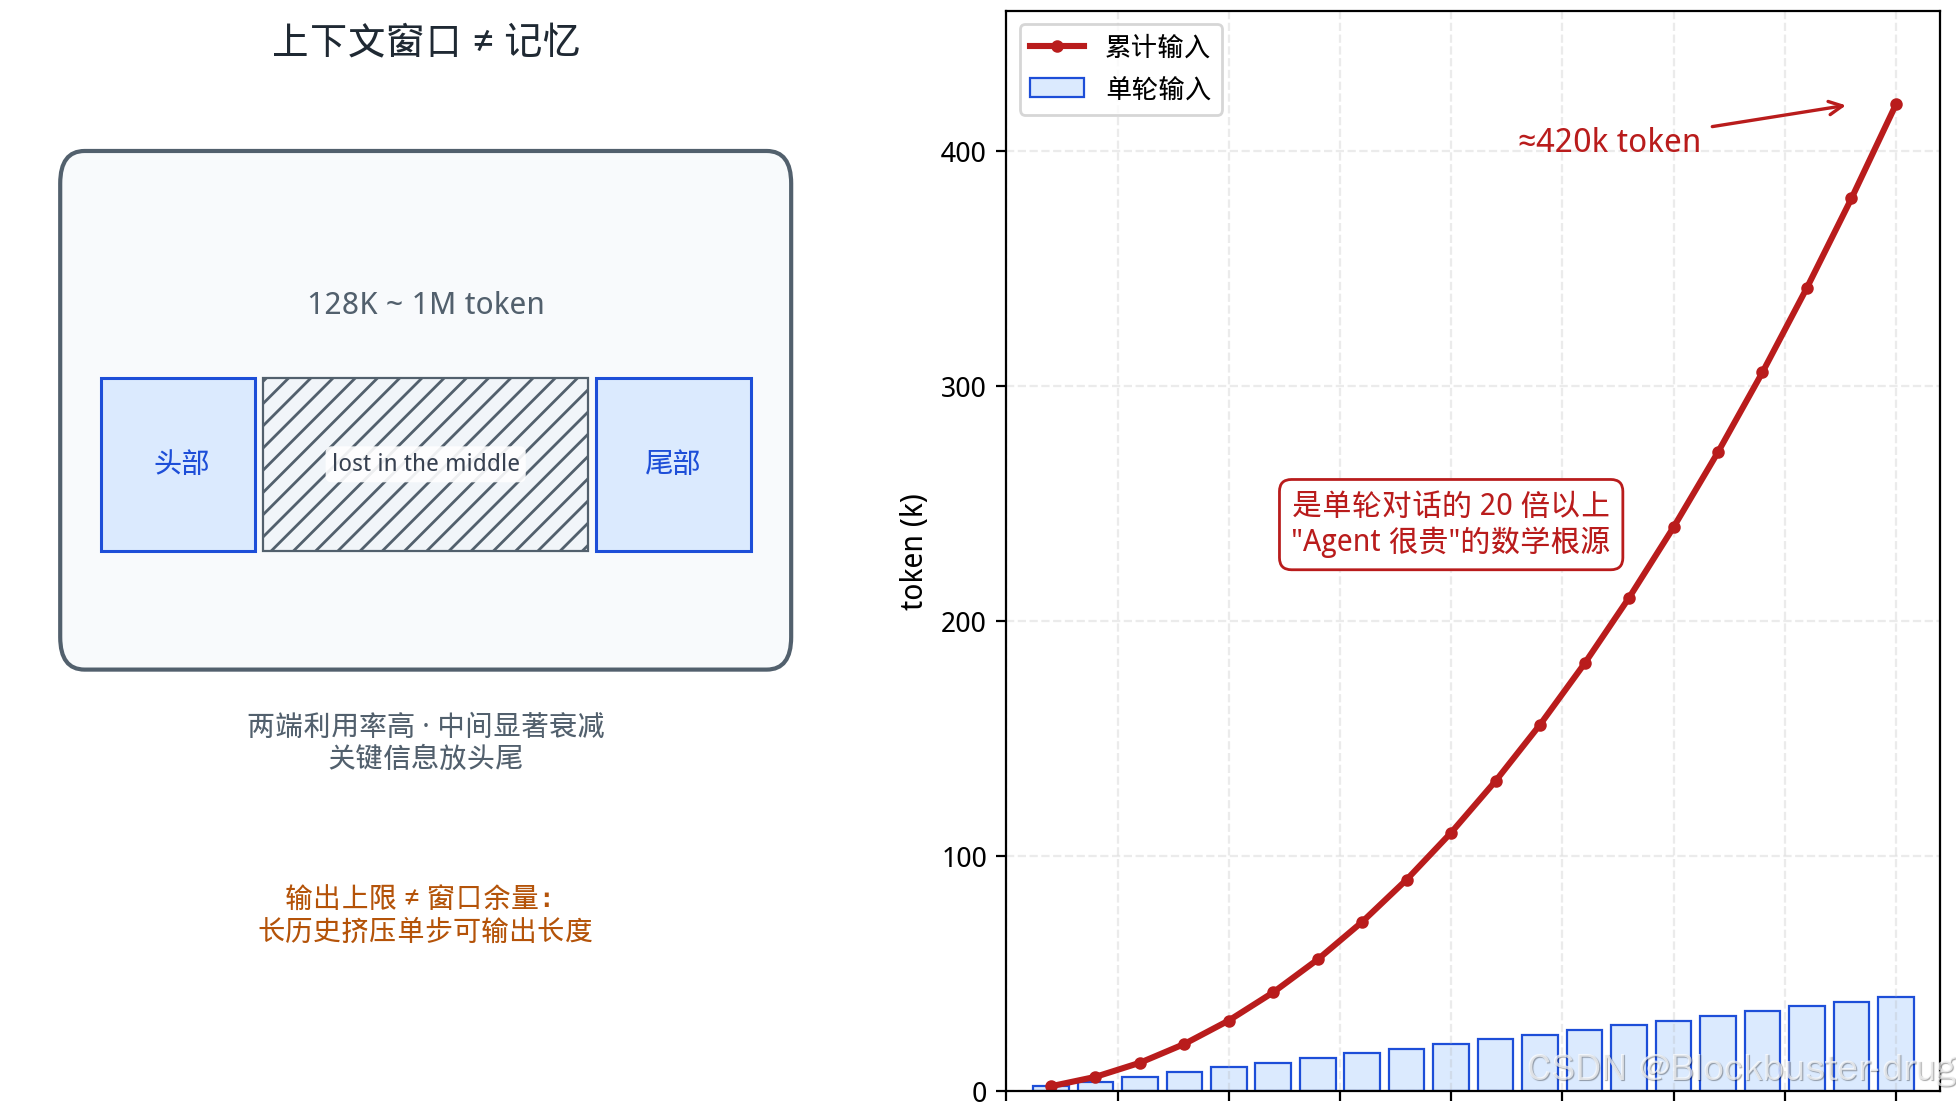
Token 是什么:文本的计量单位。英文约 1 token ≈ 0.75 个单词;中文常见 1 汉字 ≈ 1~2 token(不同分词器差异大)。模型输入输出都按 token 计费。
上下文窗口 = 单次请求 messages 的最大 token 数。2026 年主流旗舰模型窗口普遍在 128K~1M token 量级,但注意三个坑:
- 窗口 ≠ 记忆。长上下文中间部分的信息利用率显著低于两端("lost in the middle" 现象),关键信息要放头尾。
- 计费按输入+输出全算。Agent 每轮循环都重发全部历史------一个 20 轮工具循环,累计输入 token 是 O(N²) 增长的(第 1 轮发 1k,第 20 轮发 20k+,总计远超单轮 20k)。
- 输出上限 ≠ 窗口余量 。
max_tokens受剩余窗口约束,长历史会挤压单步可输出长度,工具结果(如整页网页文本)是隐性大户。
粗算一笔账(示意数字):假设每轮工具往返增加 2k token,20 轮循环的累计输入 ≈ 2k×(1+2+...+20) = 420k token------是单轮对话的 20 倍以上。这是"Agent 很贵"的数学根源,也是第 13 课(压缩/截断)与第 26 课(成本控制)存在的原因。
案例实战:用裸 API 完成一次最小工具调用
目标 :不用任何框架,用标准库 urllib 走完 2.3 节的五步流程,看清"模型出意图、代码去执行、结果再回传"的完整环。
运行环境(两平台任选其一):
| 环境 | 组成 | 获取方式 |
|---|---|---|
| A. 云端 API(Windows/Linux 通用,推荐入门) | Python 3.8+;任意 OpenAI 兼容 API key | 装 Python 后无需 pip install 任何包------本例只用标准库;改 API_URL/MODEL/API_KEY 三行 |
| B. 本地模型(离线可跑) | Ollama 0.34 + glm-4.7-flash(官方 tag,约 19GB)或任意支持 tools 的对话模型 | Ollama 官网下载安装包(Windows/macOS/Linux 均有),ollama pull glm-4.7-flash 拉模型 |
国外主流模型速览(先全球视野,国内落地见下表;详细来头/价格/合规路线见第 16 课 16.6 节,2026-10-01 检索口径):
| 厂商 | 当前旗舰(API 模型 ID) | OpenAI 兼容 | 国内可及性 |
|---|---|---|---|
| OpenAI | gpt-6-astra / gpt-6-sol / gpt-6-luna |
✅ 原生(行业模板) | 需代理+境外支付;企业走 Azure OpenAI |
| Anthropic | Claude Opus 5.5 | ❌ 自有 Messages API | 需代理+境外支付;MCP 协议发起方 |
gemini-3.1-pro(1M 上下文) |
❌ 自有 Gemini API | 企业走 Vertex AI | |
| xAI(马斯克) | Grok 4.5 / 4.6 | ✅ api.x.ai/v1 |
需代理 |
| Mistral(法国) | Mistral Large 3(675B MoE) | 部分 | ✅ 开放权重 Apache 2.0,Ollama 自托管无门槛 |
| Meta | Llama 开放系(新一代命名调整中) | --- | ✅ 开放权重,Ollama/HF 国内直用 |
国内读者记两条:① 前四家 API 有网络+支付双重门槛,个人直接开通隐性成本常高于 token 费;② 后两家走开放权重路线,
ollama pull即用、零账号------这是国内体验海外模型的主要路径。
国内模型接入速查(面向国内读者;以下端点/模型名/鉴权方式均于 2026-10-01 逐一实测或验证):
| 提供商 | 端点(API_URL) | 模型名(MODEL) | 鉴权方式 | 本课验证 |
|---|---|---|---|---|
| DeepSeek | https://api.deepseek.com/v1/chat/completions |
deepseek-chat |
Bearer | ✅ 实测:正确返回 tool_calls |
| 智谱 GLM | https://open.bigmodel.cn/api/paas/v4/chat/completions |
glm-4.7-flash |
Bearer | ✅ 实测:正确返回 tool_calls |
| MiniMax | https://api.minimaxi.com/v1/text/chatcompletion_v2 |
MiniMax-M2.5 |
Bearer | ✅ 实测:正确返回 tool_calls |
| 小米 MiMo | 按量付费 sk- key:https://api.xiaomimimo.com/v1/chat/completions;Token Plan tp- key:https://token-plan-cn.xiaomimimo.com/v1/chat/completions(key 前缀决定端点,打错一律 401) |
mimo-v2.5-pro(V2 系列 2026-06-30 已下线) |
Bearer(主端点亦接受 api-key 头) |
✅ 实测:Token Plan 端点正确返回 tool_calls(2026-10-01,详见第 7 课) |
| Kimi | https://api.kimi.com/coding/v1/chat/completions |
kimi-k2.7(亦验证 kimi-latest) |
Bearer | ✅ 实测:正确返回 tool_calls(2026-10-01,sk-kimi- 前缀 key;裸 /v1 端点 404,必须带 /coding 段) |
| Qwen(阿里) | https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions |
qwen-plus / qwen-max(模型 ID 以百炼控制台当日为准) |
Bearer | ◐ 端点规格验证(无 key 探测返回 401 invalid_api_key,说明端点与鉴权口径正确);tool_calls 行为按官方文档口径,本机无 key 未跑通------有 DASHSCOPE_API_KEY 的读者可按第 7 课 code/07b_cn_models.py 探针一行复测 |
两个真实的坑("OpenAI 兼容"并不完全统一):① MiniMax 官方文档主推的端点是 /v1/text/chatcompletion_v2,实测标准路径 /v1/chat/completions 也能用(2026-10-01 双路径均返回 200)------但文档主推路径才是承诺支持的接口,换模型前以官方文档当日为准;② 小米 MiMo 按 key 前缀分两套端点(tp- 打主端点一律 401),且 V2 系列模型名已下线------第 7 课有完整排坑记录。上表就是"换三行跑通"的全部成本。
本课实测环境为 B(Linux + 消费级 GPU,输出见下)。A 路线在 Windows 上零差异(纯 HTTP 调用,无平台相关依赖);B 路线在 Windows 上装好 Ollama 后命令完全一致,第 6 课附 Windows 具体步骤。
python
# -*- coding: utf-8 -*-
# 裸 API 最小工具调用:仅标准库,无框架
# 依赖:Python 3.8+;实测环境:Ollama 0.34 + glm-4.7-flash(64K 变体 tag),2026-10-01
import json
import urllib.request

API_URL = "http://localhost:11434/v1/chat/completions"
API_KEY = "YOUR_API_KEY"
MODEL = "glm-4.7-flash:latest"    # 官方 tag;实测用同权重 64K 变体 -100k

def chat(messages, tools=None):
    body = {"model": MODEL, "messages": messages, "temperature": 0.2}
    if tools:
        body["tools"] = tools
    req = urllib.request.Request(
        API_URL, data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "Authorization": f"Bearer {API_KEY}"})
    with urllib.request.urlopen(req, timeout=120) as r:
        return json.load(r)["choices"][0]["message"]

tools = [{"type": "function", "function": {
    "name": "calculator",
    "description": "计算四则运算表达式,如 '12*34+5'",
    "parameters": {"type": "object",
                   "properties": {"expr": {"type": "string"}},
                   "required": ["expr"]}}}]

# ①② 发起带工具的请求
messages = [{"role": "user", "content": "用计算器算 12*34+5"}]
msg = chat(messages, tools)

# ③ 模型返回意图(注意 arguments 是 JSON 字符串)
print("tool_calls:", json.dumps(msg.get("tool_calls"), ensure_ascii=False))
tc = msg["tool_calls"][0]
args = json.loads(tc["function"]["arguments"])   # {"expr": "12*34+5"}

# ★ 执行发生在你的代码里------模型只是"想"调用
expr = args["expr"]
assert all(c.isdigit() or c in "+-*/(). " for c in expr), "非法字符"
result = eval(expr, {"__builtins__": {}}, {})

# ④ 结果以 role:"tool" 回传
messages.append(msg)
messages.append({"role": "tool", "tool_call_id": tc["id"],
                 "content": str(result)})

# ⑤ 模型给出最终回答
final = chat(messages, tools)
print("最终回答:", final.get("content"))【已实测】(2026-10-01,Ollama 0.34 + glm-4.7-flash-100k〔64K 变体〕,Linux/消费级 GPU)实际输出:
tool_calls: [{"id": "call_crevitxs", "index": 0, "type": "function",
              "function": {"name": "calculator",
                           "arguments": "{\"expr\": \"12*34+5\"}"}}]
本地执行结果: 413
最终回答: 计算结果是 **413**。

计算过程:
- 12 × 34 = 408
- 408 + 5 = 413
观察三个细节:模型正确地把意图装进了 JSON(finish_reason: "tool_calls");arguments 是字符串需要二次解析;执行后一轮模型就停止调用、转入文本回答------没有循环,只有一次往返。把这次往返套上 while 循环和终止条件,就是第 6 课的 Agent。
预期输出 :同上。若你换用其他 OpenAI 兼容服务,注意个别实现要求 tool_choice 显式传 "auto";云端 API 下首个 tool_call 的 id 格式会不同(如 call_abc123),不影响逻辑。
小结
- messages 数组是 Agent 的全部状态:无状态 API + 客户端重发历史 = "记忆"的真相。
- chat template 决定模型实际吃什么;绕过 template 手拼 prompt、special token 注入,都是工程雷区。
- function calling 五步环:定义 schema → 发请求 → 收 tool_calls 意图 → 本地执行 → role:"tool" 回传;执行永远在模型之外。
- arguments 是 JSON 字符串;配对靠 tool_call_id;终止信号是"不再返回 tool_calls"。
- Agent 成本按 O(轮数²) 累计输入 token 增长------上下文管理不是优化项,是生存项。
交叉引用:工具定义怎么写才"好用"参见第 8 课《工具设计与 ACI 工程规范》;把五步环升级为完整循环参见第 6 课《从零写一个最小 Agent Loop》。
扩展阅读
🌐 网络提示:openai.com 系需代理(协议层知识已进正文,实测均可用国产端点替代);huggingface.co 走镜像:
export HF_ENDPOINT=https://hf-mirror.com;pip 安装建议加清华镜像-i https://pypi.tuna.tsinghua.edu.cn/simple。详见总纲附录《国内网络访问与国产适配指南》。
- OpenAI Function Calling 官方指南(五步流程与各语言示例):https://developers.openai.com/api/docs/guides/function-calling (2026-10-01 检索;部分网络环境可能 403,可检索"OpenAI function calling guide"替代入口)
- HuggingFace Chat Templates 文档(special tokens 与模板机制):https://huggingface.co/docs/transformers/chat_templating (中国大陆网络建议镜像入口 hf-mirror.com 同路径访问)
- Liu et al.《Lost in the Middle: How Language Models Use Long Contexts》(arXiv:2307.03172)
我的专栏
| 蛋白 / 抗体 / 多肽 / 核酸 | 分子模拟 / 动力学 / 对接 | 药物 / 设计 / 案例 | AI / Agent / 大模型 |
|---|---|---|---|
| 开源蛋白结构预测 | 分子模拟基础 | 小分子药物设计案例 | AI Agent系列 |
| 开源蛋白生成方法实践 | 分子动力学模拟-Amber | 蛋白药物设计案例 | 化学大模型 |
| 开源多肽设计模型 | 分子动力学模拟-Gromacs | 多肽药物设计案例 | 《AI Agent原理与实战》 |
| 开源多肽性质预测 | 分子动力学模拟-OpenMM | 开源小分子生成设计 | CADD中的机器学习模型 |
| DNA/RNA药物设计 | 結合自由能 | 开源药代动力学软件 | 高效计算配置 |
| siRNA药物设计模型 | UCSF DOCK系列 | 我胡师兄说药 | |
| ASO药物设计模型 | rDock系列 LeDock系列 gnina系列 |