本文摘要:uvicorn --workers 4 起 FastAPI 服务,4 个进程共用 app.db,库已执行 PRAGMA journalmode=WAL。
一、问题与结论
压测 100 并发写请求时,P50 从 2ms 涨到 400ms,P99 超过 800ms,日志里间歇出现 sqlite3.OperationalError: database is locked。把 sqlite3.connect(timeout=...) 从默认 5 秒调到 30 秒后报错消失,但 P99 涨到 2s 以上,写吞吐没有变化。
结论先行:
- WAL 只解除「读阻塞写、写阻塞读」,写写互斥仍是全局独占,任意时刻只有一个连接能持有写锁。
timeout与PRAGMA busy_timeout只是把立刻失败改成排队等待,不增加写吞吐,反而放大尾延迟。- WAL 下多出
SQLITE_BUSY_SNAPSHOT:读事务升级为写时快照已过期,报错文案同样是database is locked,根因与写锁冲突不同。
写并发仍是 1。可调整的方向只有三个:减少写者数量、压缩单次写事务的固定开销、或者换掉存储引擎。
二、排查与选择依据
现象一:写锁冲突,报 database is locked
一个连接 BEGIN IMMEDIATE 持写锁 3 秒,另一个连接只等 0.5 秒就会抛 sqlite3.OperationalError: database is locked;把等待调到 10 秒则能拿到锁完成写入。timeout 只是等待上限,不会缩短排队。
单位陷阱:sqlite3.connect(..., timeout=5) 是 5 秒 ,PRAGMA busy_timeout=5000 是 5000 毫秒 ,两者等价,混用会把超时设成预期的千分之一或一千倍。跨线程复用同一连接还要处理 check_same_thread(默认 True):要么设为 False 并自行加锁,要么每线程独立连接。
现象二:-wal 文件膨胀
长读事务持有旧快照时 checkpoint 无法推进:一个连接 BEGIN 不提交,另一个连接连续写入几千行后执行 PRAGMA wal_checkpoint(TRUNCATE),返回值是三个整数 busy, log, checkpointed:
text
PRAGMA wal_checkpoint(TRUNCATE);
-- 返回 (busy, log, checkpointed)
-- busy=1, checkpointed=0   checkpoint 被长读事务挡住,-wal 只增不减
-- 读事务结束后重跑:busy=0,-wal 被截断为 0判据很直接:busy=1 时先去查有没有未提交的长读事务。
现象三:单写者排队
4 个线程各写 500 行、逐行 commit,按写锁串行化计算,总耗时应接近单线程的 4 倍而不是 1/4;改为一次 executemany 加单次 commit 后耗时明显下降。后者只是把 N 次写锁获取压缩成 1 次,属于减少固定开销,并非提高写并发(脚本见第四节)。
替代方案与取舍
| 方案 | 选择条件 | 代价与边界 |
|---|---|---|
批量合并写 + executemany |
写入可延迟几十毫秒到秒级 | 降低实时性,需业务层判断哪些写可合并 |
| 应用层单写者队列 | 写请求可控、允许异步落库 | 队列积压与崩溃恢复要自己处理,故障时可能丢内存中的写 |
| 分库:多个 SQLite 文件按 shard 拆分 | 数据可按租户/时间分片 | 跨库聚合查询变难,路由逻辑进应用层 |
| 迁移 PostgreSQL / MySQL | 需要多写者并发或多机访问 | 部署、运维、资源成本显著上升 |
当写入频率超过单连接的消化能力、或需要多个进程互为写者、或数据必须跨库关联查询时,不该继续用 SQLite 做写入主存储。
三、关键原理
WAL 的收益是读者不再被写者挡住:读者读 WAL 尾部的旧快照,写者继续往 WAL 追加。但写者之间没有变宽松------写事务开始时必须取得写锁,提交后才释放。
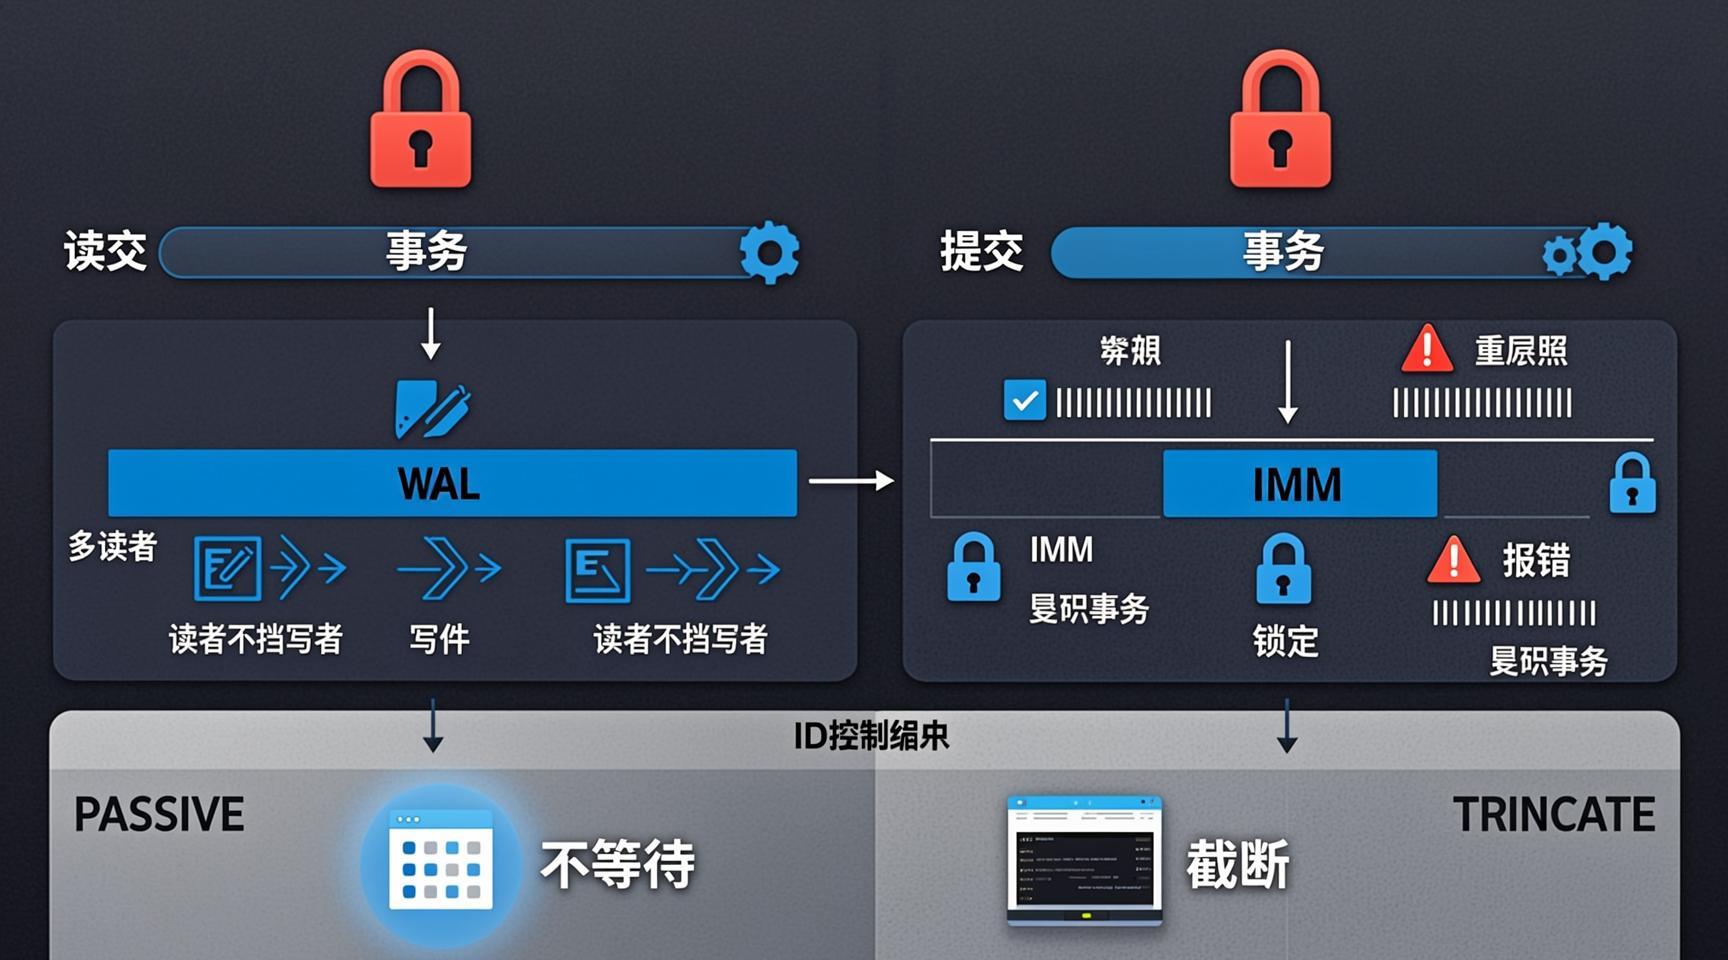
busy_timeout 只决定在 SQLITE_BUSY 上重试多久,重试期间线程被占用,请求堆积在外层队列里,尾延迟因此放大。BEGIN IMMEDIATE 在事务起点就拿写锁,把「先读后写、快照过期」的 SQLITE_BUSY_SNAPSHOT 提前暴露成开头的 database is locked,排查更直观,但同样不增加并发;rollback journal 模式下不存在这种快照过期场景。
PRAGMA synchronous 降到 OFF 能减少刷盘,代价是断电时可能丢事务甚至损坏数据库,只适合可重建的写入。wal_checkpoint 的 PASSIVE 不等待读写,TRUNCATE 会等读者释放并把 -wal 截断为 0;日常清理用 TRUNCATE,长读事务未结束时它返回 busy=1。
四、可运行示例
环境:Linux,CPython 3.x 自带 sqlite3,无需第三方库。四个线程各写 500 行,对比逐行提交与批量提交:
python
import os
import sqlite3
import threading
import time

DB = "/tmp/wal_demo.db"

def init():
    for s in ("", "-wal", "-shm"):
        if os.path.exists(DB + s):
            os.remove(DB + s)
    c = sqlite3.connect(DB)
    c.execute("PRAGMA journal_mode=WAL")
    c.execute("CREATE TABLE events(id INTEGER PRIMARY KEY, tid INT, ts REAL)")
    c.commit()
    c.close()

def writer(tid, n, res, batch):
    c = sqlite3.connect(DB, timeout=30)
    t0 = time.perf_counter()
    if batch:
        c.executemany(
            "INSERT INTO events(tid, ts) VALUES(?, ?)",
            [(tid, time.perf_counter()) for _ in range(n)],
        )
        c.commit()
    else:
        for _ in range(n):
            c.execute("INSERT INTO events(tid, ts) VALUES(?, ?)", (tid, time.perf_counter()))
            c.commit()
    res[tid] = time.perf_counter() - t0
    c.close()

def run(batch):
    init()
    res = {}
    ts = [threading.Thread(target=writer, args=(t, 500, res, batch)) for t in range(4)]
    t0 = time.perf_counter()
    for t in ts:
        t.start()
    for t in ts:
        t.join()
    wall = time.perf_counter() - t0
    print(("批量" if batch else "单行"), f"总耗时 {wall:.2f}s 吞吐 {2000 / wall:.0f} rows/s")

if __name__ == "__main__":
    run(False)
    run(True)
    c = sqlite3.connect(DB)
    print("journal_mode =", c.execute("PRAGMA journal_mode").fetchone()[0])
    print("wal_checkpoint =", c.execute("PRAGMA wal_checkpoint(TRUNCATE)").fetchone())
c.close()预期输出(结构固定,数值随机器浮动,不写未实测数字):
text
单行 总耗时 x.xx s 吞吐 xxxx rows/s
批量 总耗时 x.xx s 吞吐 xxxx rows/s
journal_mode = wal
wal_checkpoint = (0, 0, 0)
实际输出 :在你的机器上运行后核对三点------journal_mode 必须是 wal;单行模式总耗时应是批量模式的数倍而非持平;wal_checkpoint 返回的第一个整数必须为 0,否则仍有连接持有读事务。
常见失败:容器里报 sqlite3.OperationalError: attempt to write a readonly database,原因是 /tmp 或数据目录挂载为只读,或上次运行残留 -shm 且属主不符。换到可写目录并删除 -wal、-shm 残留文件后重跑。
五、验证结果与边界
验证口径:在同一台机器对比逐行提交与批量提交的 rows/s,以及四线程与单线程的耗时比。若耗时比接近线程数,即证明写入被串行化;批量提交的提升来自压缩写锁获取次数,属于减少固定开销,不是提高写并发。
边界:单机单文件、写少读多、写入允许延迟时,「批量事务 + 写队列 + 定期 wal_checkpoint(TRUNCATE)」的组合足够。一旦出现多机写、写入频率超过单连接消化能力,或 P99 必须稳定在毫秒级,SQLite 的单写者模型就是硬约束,调参无法绕开。
思考
- 写队列积压上限设多大,才能在存储变慢时既不丢写也不拖垮进程内存?
synchronous=NORMAL在断电丢事务与写吞吐之间,可接受的丢失窗口是多长?