"边际相关性检索" 是 Chroma 里的高级查询模式,MMR(Maximal Marginal Relevance,最大边际相关)
它解决什么问题
普通相似度检索只按 "和查询最像" 返回,结果往往扎堆重复
比如查 "如何健身",可能返回的 10 条全是讲举铁的
MMR 的目标是:既相关,又不重复,让你拿到一个 "相关且多样" 的结果集
核心公式
对每一条候选结果算一个分数:
最终分 = λ × 与查询的相似度 − (1−λ) × 与已选结果的相似度- 第一项:越相关分越高(跟查询像)
- 第二项:跟已选的越重复,扣分越多(多样性惩罚)
选结果时贪婪地一条条挑:每轮选当前 "相关度高 + 与已选最不重复" 的那条,直到选满
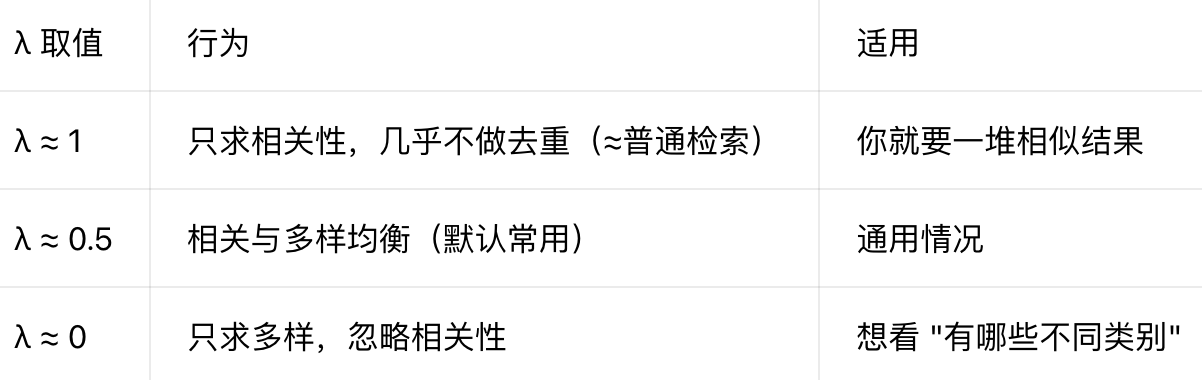
λ 参数的作用
在 Chroma 里怎么用
results = collection.query(
    query_texts=["健身"],
    n_results=10,
    # MMR 相关参数
    lambda_param=0.5,        # 多样性 vs 相关性的权衡
    fetch_k=50,                     # 先取50个候选,再从中做MMR挑10个
    mmr_threshold=0.8         # 相似度低于此阈值的不选(可选)
)
关键点:fetch_k 要大于 n_results,否则没有多余候选可做去重;系统先粗取 fetch_k 个,再用 MMR 精挑出 n_results 个
什么时候该用
- RAG 检索增强生成:给大模型喂上下文时,避免喂一堆同质化片段,让回答覆盖面更广
- 推荐系统:推荐结果不想全是同一个类型的商品 / 文章
- 知识库问答:同一问题想看多个角度的答案
什么时候不要用
- 就是要最相关的 N 条 (比如精确找最相似的向量做匹配),用普通
similarity就行,MMR 反而可能丢掉最相关的 1 条 - 数据量很小或本身就多样,MMR 收益不大
总结
MMR = 在 "跟查询相关" 和 "结果彼此不重复" 之间做平衡,用 λ 控制天平
在 Chroma 里就是 query 时传上 lambda_param、fetch_k 等参数即可