****论文题目:****Effective Diffusion Transformer Architecture for Image Super-Resolution(一种用于图像超分辨率的有效扩散变换结构)
会议:AAAI 2025
****摘要:****近年来的研究表明,扩散模型在图像超分辨率领域有着广阔的应用前景。虽然最新的方法主要是基于卷积神经网络的潜在扩散模型,但很少有人尝试探索变压器,这种变压器在图像生成方面表现出了显著的性能。在这项工作中,我们设计了一种有效的图像超分辨率扩散变换(DIT-SR),它达到了基于先验方法的视觉质量,但通过从头开始训练的方式。在实践中,DIT-SR采用整体U型架构,并对跨不同阶段的所有变压器块采用统一的各向同性设计。前者便于多尺度分层特征提取,而后者将计算资源重新分配到关键层以进一步提高性能。此外,深入分析了目前广泛使用的AdaLN模型的局限性,提出了一种频率自适应的时间步长调节模型,增强了模型在不同时间步长处理不同频率信息的能力。大量实验表明,DIT-SR的性能明显优于现有的基于从头开始训练扩散的随机共振方法,甚至超过了一些基于先验的方法,证明了扩散变换在图像超分辨率方面的优越性。
DiT-SR:用扩散Transformer从零训练,挑战预训练先验方法的图像超分辨率新范式
一、背景与问题
图像超分辨率(Super-Resolution, SR)的目标是从低分辨率(LR)输入重建高分辨率(HR)图像。近年来,扩散模型(Diffusion Models)在图像生成领域大放异彩,并被广泛引入图像超分辨率任务。
当前扩散模型在图像超分辨率中的方法大致分为两类:
第一类:从零训练方法(Training-from-Scratch)
代表工作如 SR3、LDM、ResShift,将 LR 图像直接注入扩散模型进行训练。这类方法灵活,架构修改后可方便地重新训练,适合轻量级应用场景。但其性能往往与第二类方法有明显差距。
第二类:基于先验的方法(Prior-based Methods)
代表工作如 StableSR、DiffBIR、SeeSR、PASD,借助在海量数据上预训练了数千 GPU 天的 Stable Diffusion 模型的生成先验来增强图像超分辨率。这类方法效果出色,但参数量巨大(DiffBIR 达 1670M、SeeSR 达 1619M),推理慢,且几乎不可能在不大规模重训的情况下修改架构。
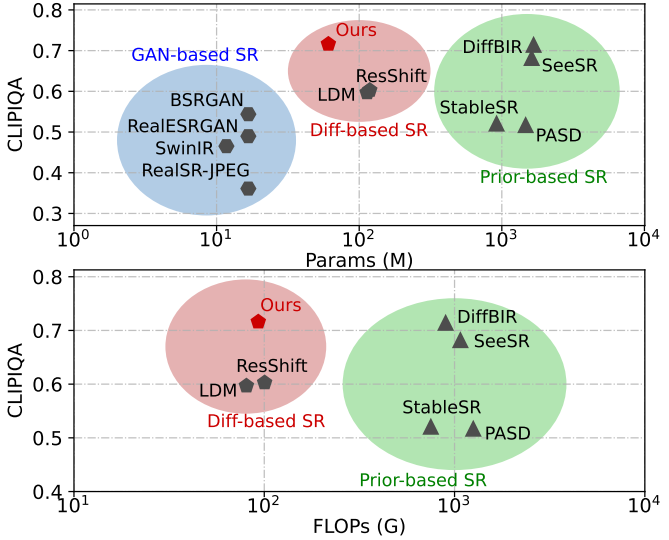
【配图】Figure 1:本文方法与近期 SR 方法在 RealSR 数据集上的对比(CLIPIQA vs. 参数量 / FLOPs)
可以清晰看到:从零训练的方法(Diff-based SR 区域)性能明显低于先验方法,而本文的 Ours 以极少的参数量实现了与先验方法相当甚至更优的效果。
核心问题:能否设计一个从零训练的扩散架构,在无需依赖 Stable Diffusion 等大规模先验的前提下,逼近甚至超越先验方法的性能,同时兼顾灵活性与轻量化?
二、现有方法的核心局限
论文识别出两个主要瓶颈:
2.1 扩散模型架构设计的局限
标准扩散模型(如 DDPM、LDM)普遍采用 U-Net 架构作为去噪器,具备多尺度层次特征提取能力。2023 年提出的 Diffusion Transformer(DiT) 则采用等向同构(isotropic)的全 Transformer 架构,保持分辨率和通道维度不变,在图像生成中展现出卓越的可扩展性。
然而,直接将标准 DiT 应用于图像超分辨率存在问题:
- 纯 DiT(等向同构):缺乏多尺度特征提取,对图像细节恢复不利。
- U 型 DiT(加入上下采样后的 U 型结构):引入多尺度能力后,不同阶段使用不同的通道维度,计算资源大量集中在低分辨率层,高分辨率层反而资源不足,导致参数量激增(264M)但性能提升有限。
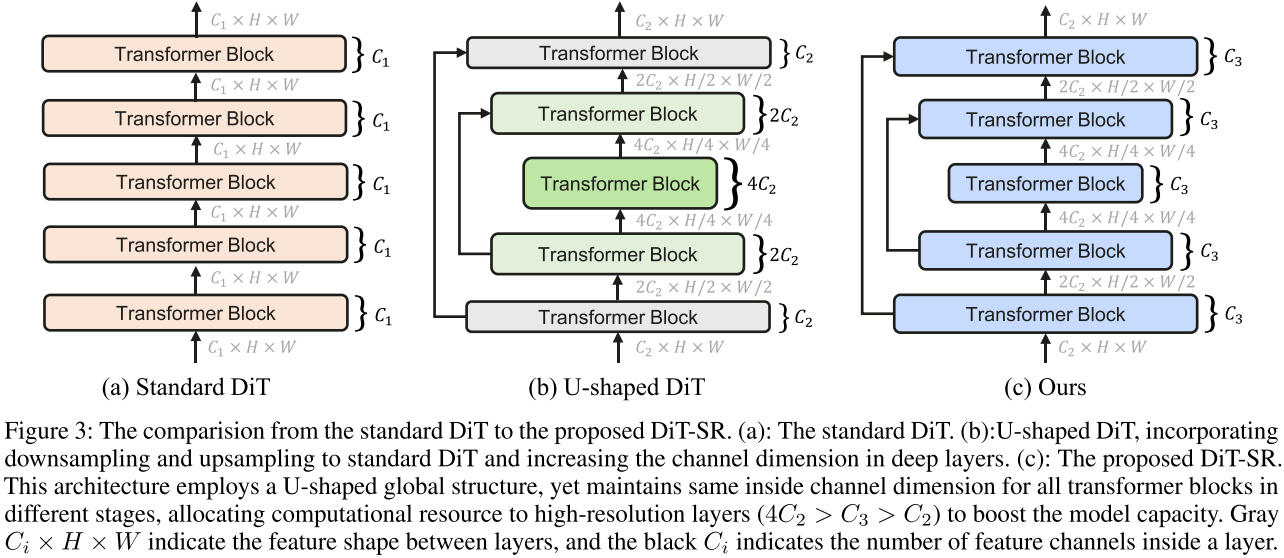
【配图】Figure 3:从标准 DiT 到 U 型 DiT 再到本文 DiT-SR 的架构演进示意图
图中灰色标注为层间特征形状,黑色标注为层内通道数,展示了等向设计如何将计算资源重新分配到高分辨率层。
2.2 时间步条件注入机制的局限
扩散模型在不同去噪阶段处理不同频率的信息------早期阶段主要重建低频成分(图像结构),后期阶段逐步精化高频细节(纹理)。
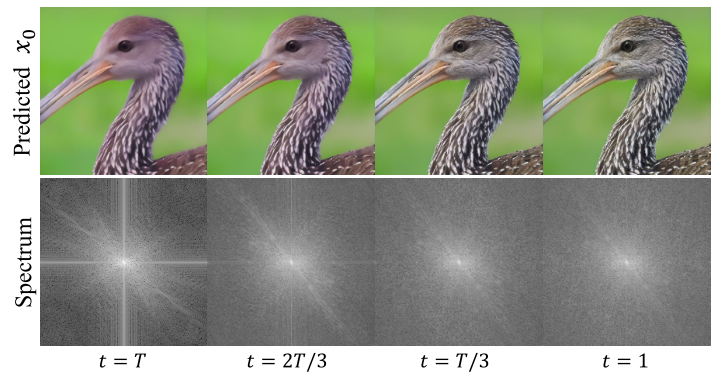
【配图】Figure 2:扩散超分辨率模型在不同去噪阶段生成图像的分析(预测的清晰图像与对应傅里叶频谱)
第一行为各时间步预测的清晰图像,第二行为对应的傅里叶频谱。可以看到:早期(t=T)频谱中心亮(低频主导),后期(t=1)频谱边缘亮(高频逐步显现)。
然而,广泛使用的 自适应层归一化(AdaLN) 仅在通道维度对特征图进行调制,对所有空间位置施加统一的调制参数,无法区分高低频分量的空间位置,也就无法有效感知时间步与频率之间的关联。
三、本文提出的方法:DiT-SR
3.1 整体架构:U 型全局结构 + 等向同构块设计
本文提出的 DiT-SR 的核心思路是将 U 型全局架构与等向同构块设计结合:
- U 型全局结构:编码器逐步降低特征图分辨率、增加通道维度;解码器做反向操作,实现多尺度层次特征提取,有助于恢复图像在不同尺度上的细节。
- 等向同构块设计:在 U 型的不同阶段内部,所有 Transformer 块统一使用相同的内部通道维度(记为 C₃),而非随层变化。该通道数设置得比 U-Net 中高分辨率阶段的通道数更大,但远小于低分辨率阶段的通道数。
这一设计带来的效果是:计算资源从低分辨率层流向高分辨率层。因为高分辨率层负责捕捉更丰富的高频细节(对超分辨率至关重要),且高分辨率 DiT 的可扩展性更强,这样的资源分配显著提升了模型容量。
【配图】Figure 4:U 型 DiT 在有/无等向设计下各阶段 FLOPs 和参数量占比对比
引入等向设计后,高分辨率阶段(H×W)占据了更多的计算资源,而非集中在低分辨率阶段(H/4×W/4、H/8×W/8)。
量化结果:相比 U 型 DiT(264M 参数),本文带等向设计的架构在使用 AdaLN 时仅需 100.64M 参数(减少 62%),FLOPs 从 122.87G 降至 93.11G(减少 24%),而性能反而提升(RealSR CLIPIQA 0.688→0.700)。
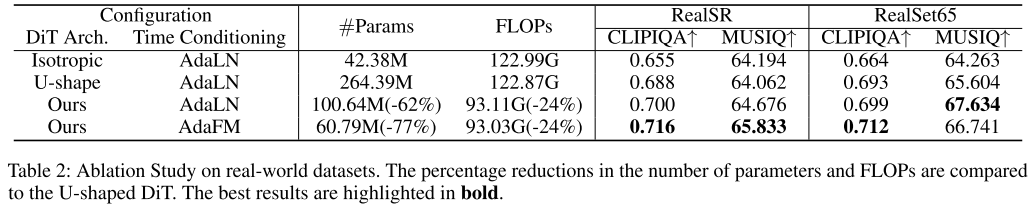
【配表】Table 2:消融实验结果------不同架构配置与时间步条件模块的性能对比
3.2 自适应频率调制(AdaFM):时间步与频域的桥梁
为解决 AdaLN 无法感知频率的问题,论文提出 Adaptive Frequency Modulation(AdaFM) 模块,将时间步条件注入从空间域切换到频率域。
具体流程如下:
- 将空间域特征图
切分为
- 对每个窗口做 快速傅里叶变换(FFT) ,得到频谱
- 将一维时间步向量映射为
- 将
- 做逆 FFT(iFFT),恢复至空间域。
关键优势 :在频谱中,每个像素位置对应确定的频率成分,这由特征图的空间维度唯一决定,与内容无关。因此,同一个 可以跨所有窗口和通道共享,极大提升了效率。
参数量对比 :AdaLN 需要 个映射参数,而 AdaFM 仅需
,参数量仅为 AdaLN 的一个零头。
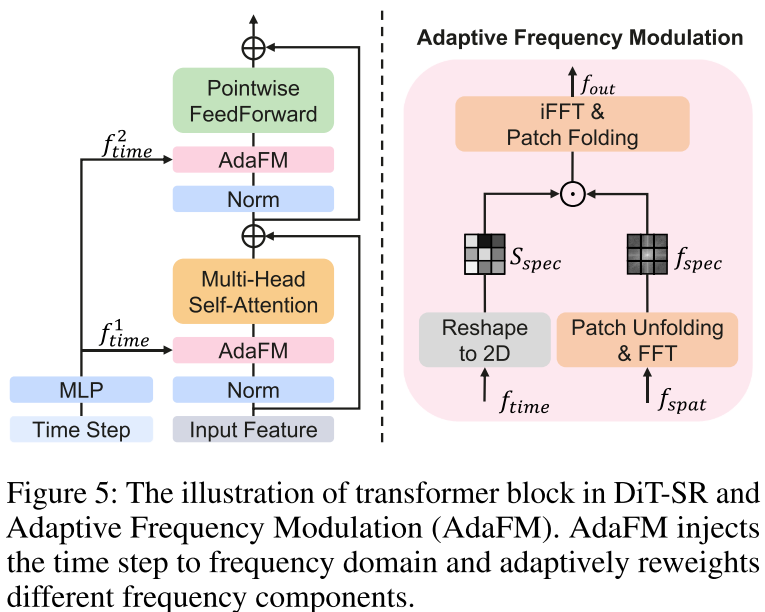
【配图】Figure 5:DiT-SR 中 Transformer 块与 AdaFM 模块的结构示意图
左侧为整体 Transformer 块,右侧为 AdaFM 的详细流程:空间域→FFT→频率加权→iFFT→输出。
可视化验证:论文通过可视化特征图及其频谱证明了 AdaFM 的有效性------在去噪早期(t=T),AdaFM 增强低频成分;在去噪后期(t=1),AdaFM 增强高频成分,与扩散模型的频率演化规律高度一致。
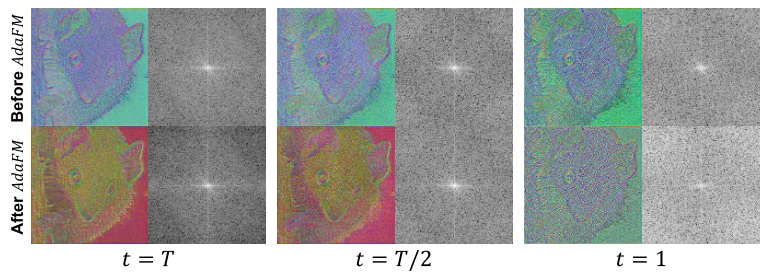
【配图】Figure 6:AdaFM 作用前后特征图及其频谱的可视化(t=T、t=T/2、t=1)
可以清楚看到,AdaFM 在早期去噪阶段使频谱外围(高频区域)变暗(增强低频),在后期使频谱外围变亮(增强高频)。
量化结果:将 AdaLN 替换为 AdaFM 后,参数量从 100.64M 进一步降至 60.79M(减少 77% vs. U 型 DiT),RealSR CLIPIQA 从 0.700 提升至 0.716,同时 FLOPs 几乎不变(93.03G)。
3.3 完整 Transformer 块设计
每个 Transformer 块由以下组件构成:
- 多头自注意力(MHSA) :由于高分辨率输入下全局注意力计算代价过高,采用 局部窗口注意力+窗口位移 替代;
- 逐点前馈网络(MLP):由两个全连接层 + GELU 激活组成,作为通道混合器;
- 组归一化(Group Norm):分别在 MHSA 和 MLP 前各加一层;
- AdaFM:跟在每个归一化层之后,注入时间步信息。
LR 图像与带噪图像在通道维度拼接后,连同时间步一起作为去噪器的输入,预测干净图像 。整体训练范式遵循 ResShift 的残差位移扩散过程,有效缩短马尔可夫链长度,仅需 15 步去噪。
四、实验结果
4.1 数据集与实现细节
- 训练集:LSDIR(82991 张)+ DIV2K + DIV8K + OutdoorSceneTraining + Flicker2K + FFHQ 前 10K 张人脸图像;HR 图随机裁剪为 256×256,使用 RealESRGAN 的降质流程合成 LR/HR 对。
- 测试集:合成数据集 LSDIR-Test(2000 张,512×512 中心裁剪+同样降质);真实数据集 RealSR(100 张,Canon 5D3 / Nikon D810 实拍)和 RealSet65(65 张)。
- 训练配置:在潜在空间(VQGAN 下采样因子 4)运行,Adam 优化器,学习率 5×10⁻⁵,batch size 64,300K 次迭代,8 块 NVIDIA Tesla V100。
4.2 真实场景数据集上的定量对比
在 RealSR 和 RealSet65 两个真实场景数据集上,本文方法(Ours-15 ,仅 61M 参数,15 步去噪):
- 全面超越所有从零训练的扩散方法(LDM-100:114M 参数;ResShift-15:119M 参数);
- 在 RealSR 上,CLIPIQA(0.7161)超越 先验方法 DiffBIR-50(0.7142)和 SeeSR-50(0.6819),仅用约 5% 的参数量(vs. DiffBIR 的 1670M);
- MANIQA 指标(0.5022)仅略低于 SeeSR-50(0.5035)。
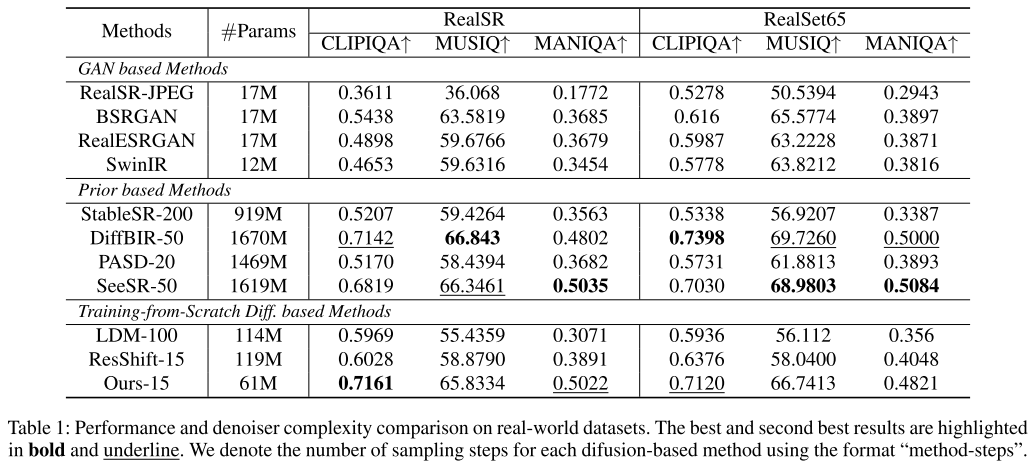
【配表】Table 1:真实场景数据集(RealSR、RealSet65)上的性能与去噪器复杂度对比
(包含 GAN 方法、先验方法、从零训练扩散方法三大类共 9 种对比方法)
4.3 合成数据集上的定量对比
在合成数据集 LSDIR-Test 上,参考指标(PSNR、LPIPS)和无参考指标(CLIPIQA、MUSIQ、MANIQA)均表明:
- 本文方法(Ours-15)在 LPIPS(0.244)上优于所有方法;
- MUSIQ(69.32)超越 LDM-100(66.84)和 ResShift-15(67.74),并优于大多数先验方法(StableSR-200:68.91,DiffBIR-50:70.05,PASD-20:69.07)。
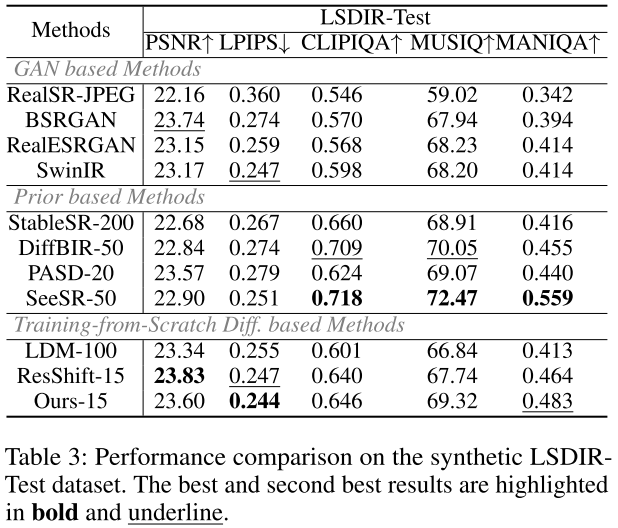
【配表】Table 3:合成数据集(LSDIR-Test)上的性能对比
4.4 定性对比
论文展示了在真实场景和合成场景数据集上的视觉对比。本文方法在细节纹理恢复(如砖墙纹理、动物毛发)上视觉效果优秀,与先验方法相当,明显优于其他从零训练方法。
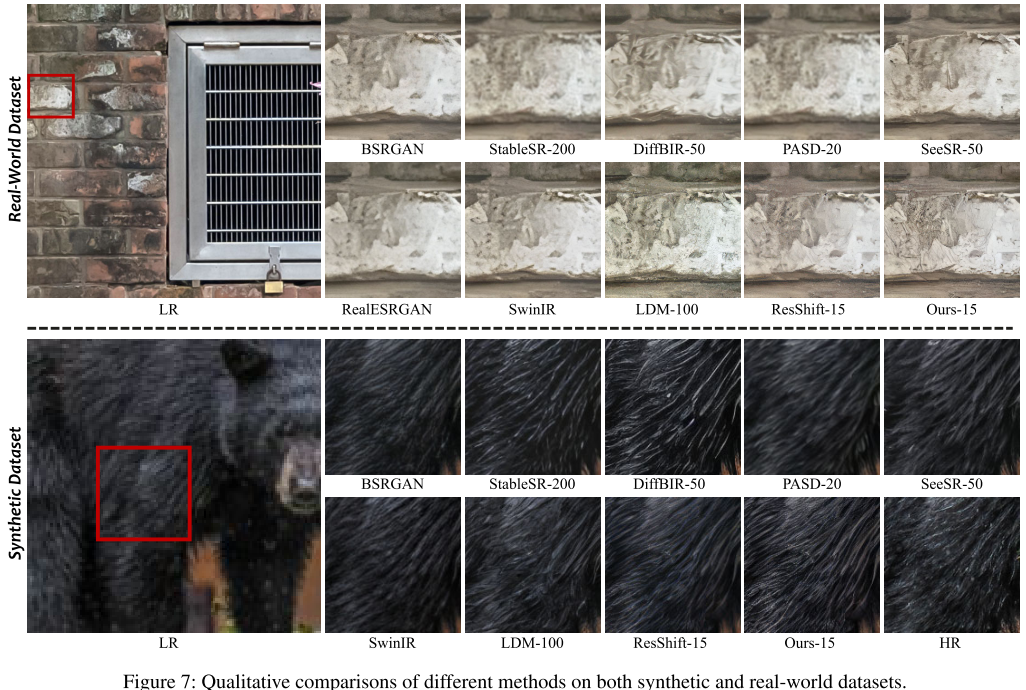
【配图】Figure 7:不同方法在真实场景(上)和合成场景(下)数据集上的定性对比图
上:真实场景数据集,LR/RealESRGAN/SwinIR/LDM-100/ResShift-15/Ours-15 及 BSRGAN/StableSR-200/DiffBIR-50/PASD-20/SeeSR-50;下:合成数据集,含 HR 参考。
五、消融实验深度分析
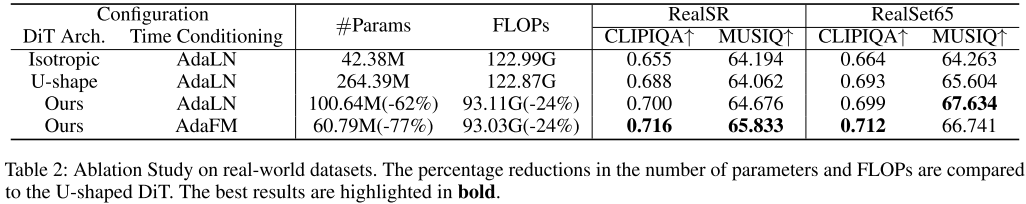
【配表】Table 2:消融实验(建议结合阅读)
这个消融实验揭示了几个关键结论:
- U 型 vs. 等向同构:相同 FLOPs 下,U 型 DiT(CLIPIQA 0.688)优于纯等向同构(0.655),但代价是参数量增大 6 倍以上(264M vs. 42M)。
- 等向设计的价值:在 U 型 DiT 中引入等向同构设计后(Ours + AdaLN),参数量从 264M 大幅降至 100.64M(减少 62%),FLOPs 减少 24%,性能反而进一步提升至 0.700。
- AdaFM 的双重红利:将 AdaLN 替换为 AdaFM,参数量再降 40%(100.64M→60.79M),同时 CLIPIQA 继续提升至 0.716,充分说明频率域的时间步条件注入既节省参数又提升性能。
六、总结与展望
核心贡献回顾
本文提出的 DiT-SR 做出了三个核心贡献:
- 架构创新:首次将 U 型全局架构与等向同构块设计无缝结合,将计算资源重新分配到关键的高分辨率层,以远少于传统 U-Net 的参数量大幅提升 Transformer 在多尺度框架下的能力;
- 条件机制创新:提出 AdaFM 模块,在频率域进行时间步条件注入,以极少的参数开销让模型具备频率感知能力,弥补了 AdaLN 在 SR 任务上的核心局限;
- 性能突破 :以 61M 参数 从零训练,在真实场景 SR 任务上超越了所有从零训练的扩散方法,并与参数量是其 27 倍 的先验方法持平甚至超越,为轻量化、可灵活修改的 SR 架构树立了新标杆。
局限性
作者也坦诚指出:尽管 DiT-SR 以极少参数实现了与先验方法相竞争的性能,但在语义结构恢复方面仍与先验方法有差距------因为缺乏 Stable Diffusion 那样通过海量数据积累的强语义先验。此外,和其他内容生成方法一样,需注意防范潜在的滥用风险。
未来方向
AdaFM 有望成为扩散模型通用的时间步条件注入新范式,不仅适用于图像超分辨率等低层视觉任务,也适用于文生图等遵循"先低频后高频"生成规律的任务。