AI 给了一条能执行的 SQL
活动报名已经跑了一段时间。现在要给报名记录补一个 source 字段,区分从网页还是后台创建。AI 很快给出:
sql
ALTER TABLE activity_signup
  ADD COLUMN source VARCHAR(16) NOT NULL DEFAULT 'web';
语法看起来没问题,执行也可能成功。可这条 SQL 还替你回答了一个业务问题:过去所有报名都是从网页来的。如果旧记录里有后台导入,这个默认值就是在给历史数据编故事。以后你按来源统计,数字会很漂亮,也会是错的。
改表最危险的地方,不是 SQL 写不出来,而是它会把一个没想清楚的假设,直接变成整张表的事实。AI 可以替你补语法;它不知道旧数据代表什么,也不知道此刻线上跑着哪一版代码。
先看懂 SQL 在动哪一行
SQL 不需要背成一门语言,但交给 AI 生成之后,至少要看懂四件事:读哪张表、筛哪些行、改哪些列、可能影响多少行。
先看一条读取:
sql
SELECT id, activity_id, user_id, status, created_at
FROM activity_signup
WHERE activity_id = 42
  AND status = 'active'
ORDER BY created_at DESC
LIMIT 50;
它读的是报名表,只挑活动 42 的有效报名,按时间倒序取 50 条。这里的 WHERE 是边界;删掉它,查询就从「这个活动的名单」变成「全站所有有效报名」。
写操作也按同样的顺序读:
sql
UPDATE activity_signup
SET status = 'canceled', canceled_at = CURRENT_TIMESTAMP
WHERE id = 123
  AND user_id = 456
  AND status = 'active';
先看 WHERE:目标是 id 为 123、属于用户 456、而且仍有效的那一行。再看 SET:只改状态和取消时间。执行后还要检查影响行数;0 行代表条件没匹配,不能当成功回给用户。
AI 生成 UPDATE 或 DELETE 时,先找 WHERE。然后问:条件是不是精确到本次目标?没有条件是不是我真的想要全表?同理,INSERT 也要检查唯一约束和必填列,不要只看有没有报错。
迁移不是「把生产库改一下」
SQL 改的是某个时刻的数据库;迁移则是把这次结构变化写成有版本、可重复执行、能在不同环境按顺序应用的文件。它跟应用代码一起评审、测试、部署,而不是上线当天临时开控制台手敲。
先回到 source。旧报名的来源未知,不能擅自填成 web。我们可以分三步走:先加一个可空字段,让旧版本程序仍能工作;新代码开始写真实来源;查清旧数据如何标记后,再决定是否补值、是否收紧为必填。
第一步迁移可以是:
sql
-- migrations/20260930_add_signup_source.sql
ALTER TABLE activity_signup
  ADD COLUMN source VARCHAR(16) NULL;
这一步只增加结构,不伪造历史值。部署兼容新列的代码后,新报名写入 web 或 admin_import;旧记录仍为 NULL,表示「来源未知」。
确认需求方接受「未知」这个状态后,才能制定回填规则。例如,只有在有可信证据证明某一批旧记录全部来自网页时,才可这样回填:
sql
UPDATE activity_signup
SET source = 'web'
WHERE source IS NULL
  AND created_at < '2026-09-30 00:00:00';
这里的时间条件只是示意,不能从例子里抄进生产:要先找出可信分界,先用同一条件 SELECT COUNT(*) 估算行数、抽样核对,再执行更新并核对影响行数。若来源根本无法还原,就保留 NULL 或显式写成 unknown,别为了让字段非空而假装知道。
等所有代码路径都能写来源、存量也按已确认的规则处理,再评估要不要 NOT NULL。收紧约束是后续迁移,不必跟加列、部署、回填塞在一个「大 SQL」里。
加列、回填、收紧:让新旧代码都能活下来
线上部署通常不是一个瞬间:滚动发布时,新旧版本可能同时处理请求。假设新代码一上线就要求 source 非空,而数据库还允许旧版本插入没有 source 的报名;或者迁移先删掉旧列,旧代码还在读它。两边单独看都合理,拼在一起就会出故障。
遇到这类需要新旧代码并存的改动,按「扩展 → 迁移数据 → 收紧」走:
- 扩展:先加兼容字段或结构,旧代码继续能读写。
- 迁移数据:部署兼容新旧形态的代码;按明确规则回填,检查空值、重复和影响行数。
- 收紧 :确认没有旧代码依赖、数据满足新约束后,再删旧字段或加
NOT NULL/ 唯一约束。
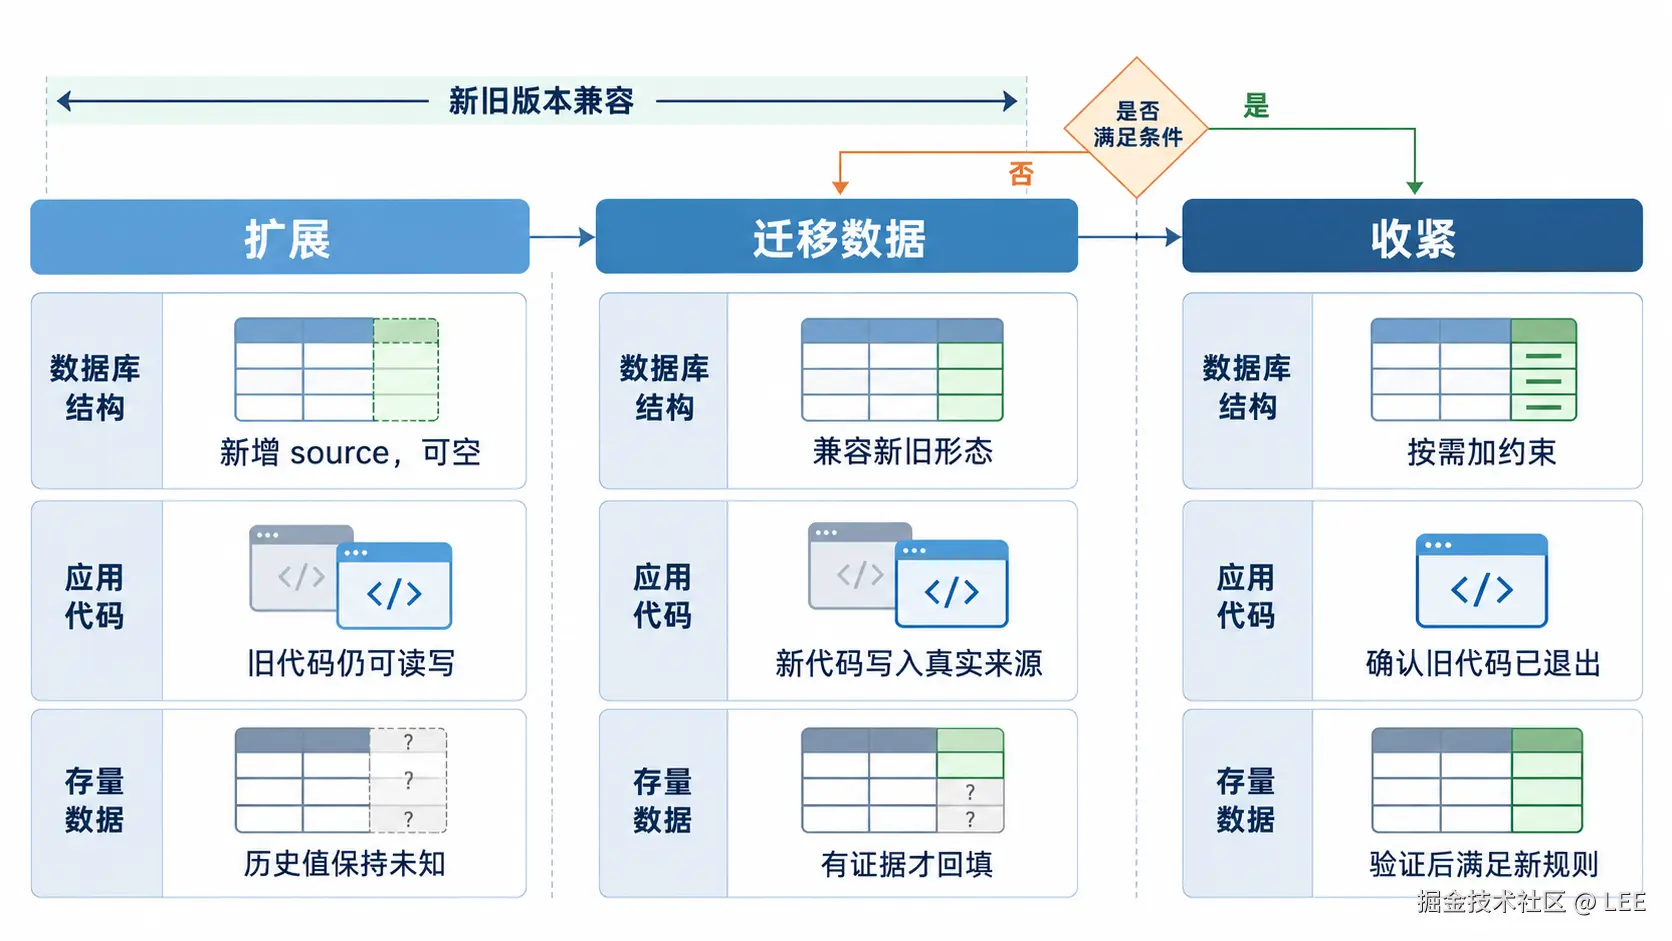
这不是每次 ALTER TABLE 都得走的仪式。纯新增、可空、旧代码完全不受影响的列,可能一步足够;但删除或改名、补非空列、加唯一约束、回填大表,都值得先画出「迁移前 / 迁移后」的读写兼容关系。
「能回滚」不是一句 SQL
事务里的数据修改可以用 ROLLBACK 撤销;但不要把它想成所有改表语句的撤销按钮。MySQL 的 DDL 会隐式结束当前事务;MySQL 8.4 的原子 DDL 保证单条 DDL 在故障时整体提交或回滚,不等于可以把已成功的 ALTER TABLE 放进事务再用 ROLLBACK 撤销 。MySQL 8.4 原子 DDL 说明
迁移工具里的 down 文件,也不一定能恢复数据。加列容易写逆向 DROP COLUMN,可若新程序已经往里写了几天数据,删列就把这几天的值一并删了;删除旧列之后再「加回同名空列」,结构回来了,数据没有回来。
所以回滚计划要拆成三问:
- 代码怎么退? 新旧版本能否都兼容当前 schema?
- 结构怎么退? 逆向操作会不会阻塞、锁表或丢值?
- 数据怎么恢复? 有可验证的备份 / binlog 恢复路径吗?恢复演练最近何时做过?
备份不是「我跑了个 dump」就算完成:至少要知道备份覆盖什么、保留多久、谁能恢复,以及恢复到隔离环境是否成功。故障时如果唯一做法是「希望回滚脚本没问题」,那就还没有回滚计划。
AI 能替你做多少
AI 很适合把已定好的目标翻译成 SQL、迁移文件和检查脚本。你要审核的不是它的排版,而是它替你做了哪些假设:
UPDATE/DELETE的WHERE是否圈准目标?会影响几行?- 新列的默认值代表什么?历史数据有证据能这样回填吗?
- 约束是不是先查过现存脏数据?加唯一约束前,重复值怎么处理?
- 新旧版本同时在线时,读写是否兼容?
- 失败后,代码、结构和数据分别怎么处置?
把「给报名表加 source」交给 AI,它可以给你 ALTER TABLE。但「旧数据从哪来」「业务是否接受未知」「什么时候能删旧字段」,这些决定得来自系统和产品规则,不在 SQL 语法里。SQL 是动作,迁移是你对这个动作的责任说明。
你能拿走什么:一张迁移上线清单
每次改生产数据库之前,先把下面几项填完。任何一项答不上来,都先别执行:
| 检查项 | 上线前要写清楚 |
|---|---|
| 目标 | 改哪个库、哪张表、哪几列;预期影响多少行? |
| 现状 | 当前 schema、数据量、空值 / 重复值检查结果是什么? |
| 兼容 | 新旧代码同时运行时,读写是否都成立? |
| 执行 | 迁移文件版本、执行顺序、耗时 / 锁风险、监控项是什么? |
| 验证 | 执行后查什么,影响行数和数据抽样的预期结果是什么? |
| 失败 | 停止条件是什么?代码、结构、数据分别怎么恢复? |
下面这段可以复制到迁移 PR 描述里:
sql
变更目标:
涉及表 / 字段:
迁移前检查(空值 / 重复 / 行数):
新旧代码兼容方式:
执行顺序与预计影响:
执行后验证 SQL:
失败停止条件:
代码回退方式:
结构与数据恢复方式:
从「让 AI 写一条 SQL」,到「我对线上变化负责」
以前,数据库改动看起来像代码改动:写完 SQL,跑通就结束。可那张表里有旧版本留下的数据,有正在运行的代码,也有之后每次请求都会经过的约束。一次 ALTER TABLE 并不是编辑器里改了一行;一次 UPDATE 也不是本地变量赋值。
AI 可以替你写动作,不能替你知道这份数据的来历,更不能替你承担它被改坏的后果。上线前,把「影响范围、兼容顺序、失败后怎么办」写下来。从此你审核的不是一条 SQL,而是数据库从旧状态走到新状态的整段路。
参考
- MySQL 8.4:Atomic Data Definition Statement Support(原子 DDL 与隐式提交;原子性不等于事务性)
- MySQL 8.4:Online DDL Limitations(在线 DDL 仍可能等待元数据锁)
- MySQL 8.4:Database Backup Methods(备份与恢复方式)