下面按你确认的经历整理:保留实际做过的操作,纠正深度数据,合并重复内容,删去计划中的验证方法。几毫米的结果按观察描述,不写成严格的精度指标。
机器人项目实战(1):选相机、试深度,再到手眼标定
这是我从零开始做的第一个机器人项目,准备通过这个系列,把实际操作、遇到的问题和解决过程记录下来。
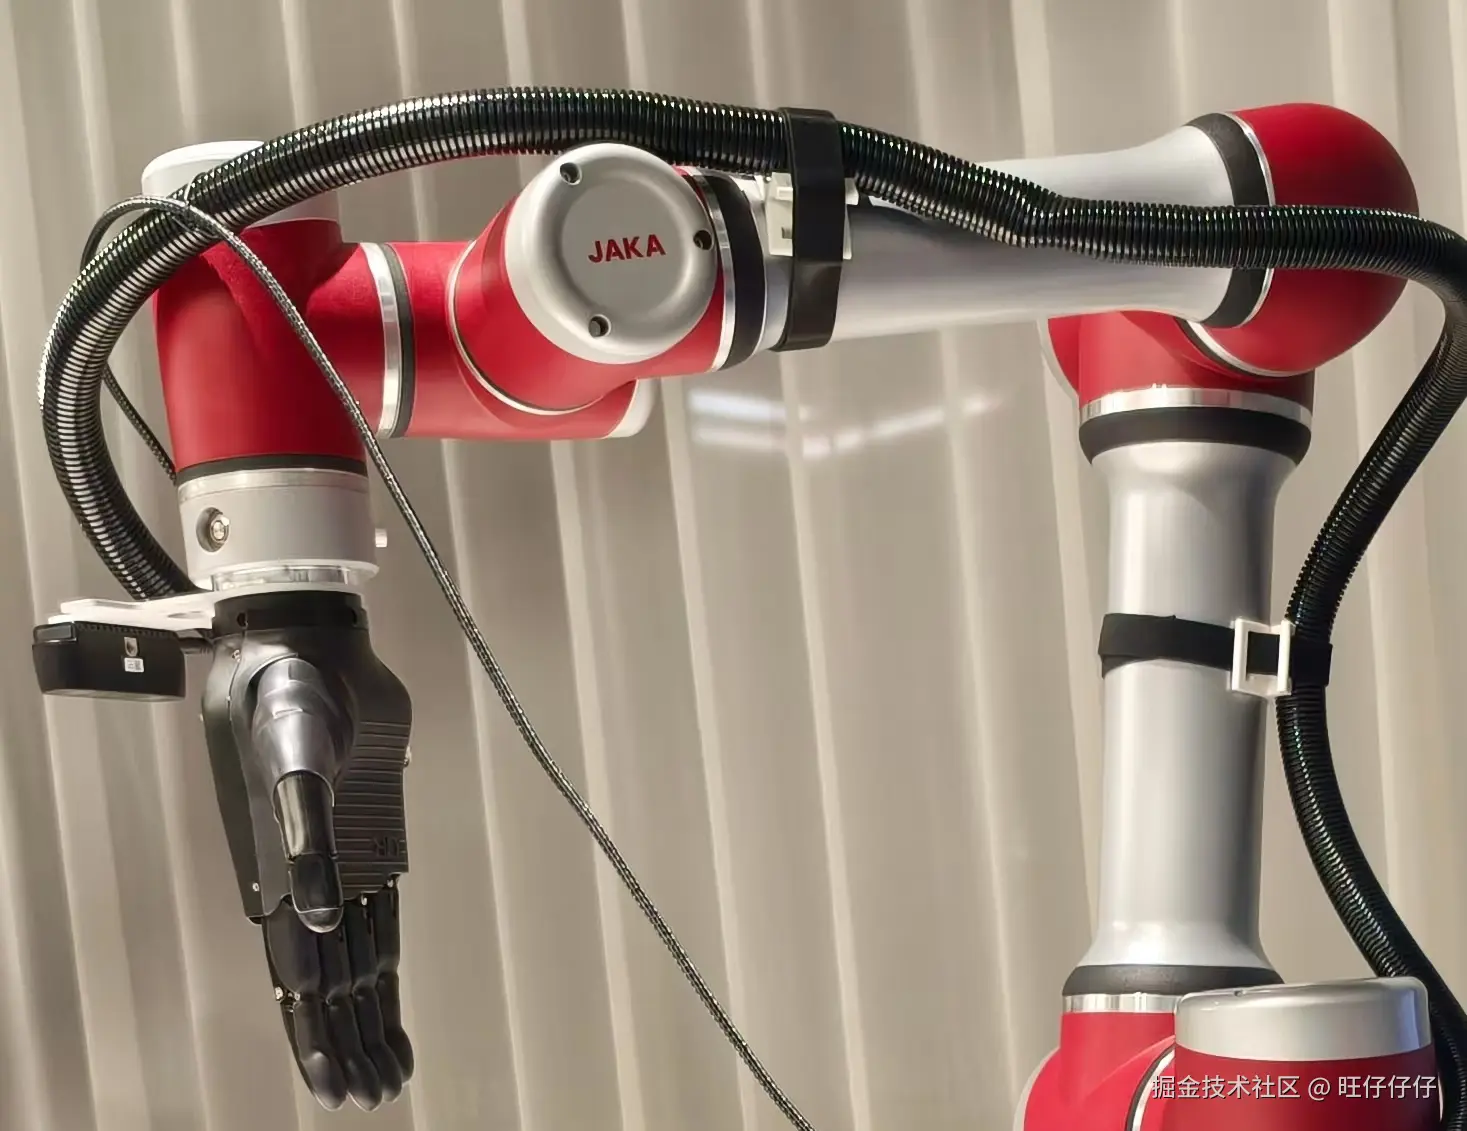
项目用到了 JAKA A5 机械臂、自研灵巧手,以及安装在机械臂末端的相机。围绕这些设备,需要实现物体识别、搬运、按类别抓取放回等任务。
刚开始,我最关心的是两个问题:相机拍到物体后,怎么知道它的三维位置?得到位置之后,又怎么让机械臂使用?
第一篇就从这里开始。最初考虑海康工业相机,后来尝试用 MoGe-2 和 InfiniDepth 补充深度,最终选择了 Gemini 2。相机确定后,再做眼在手上的手眼标定,把相机看到的位置转换到机器人基坐标系下。
一、先把物体拍清楚:海康工业相机
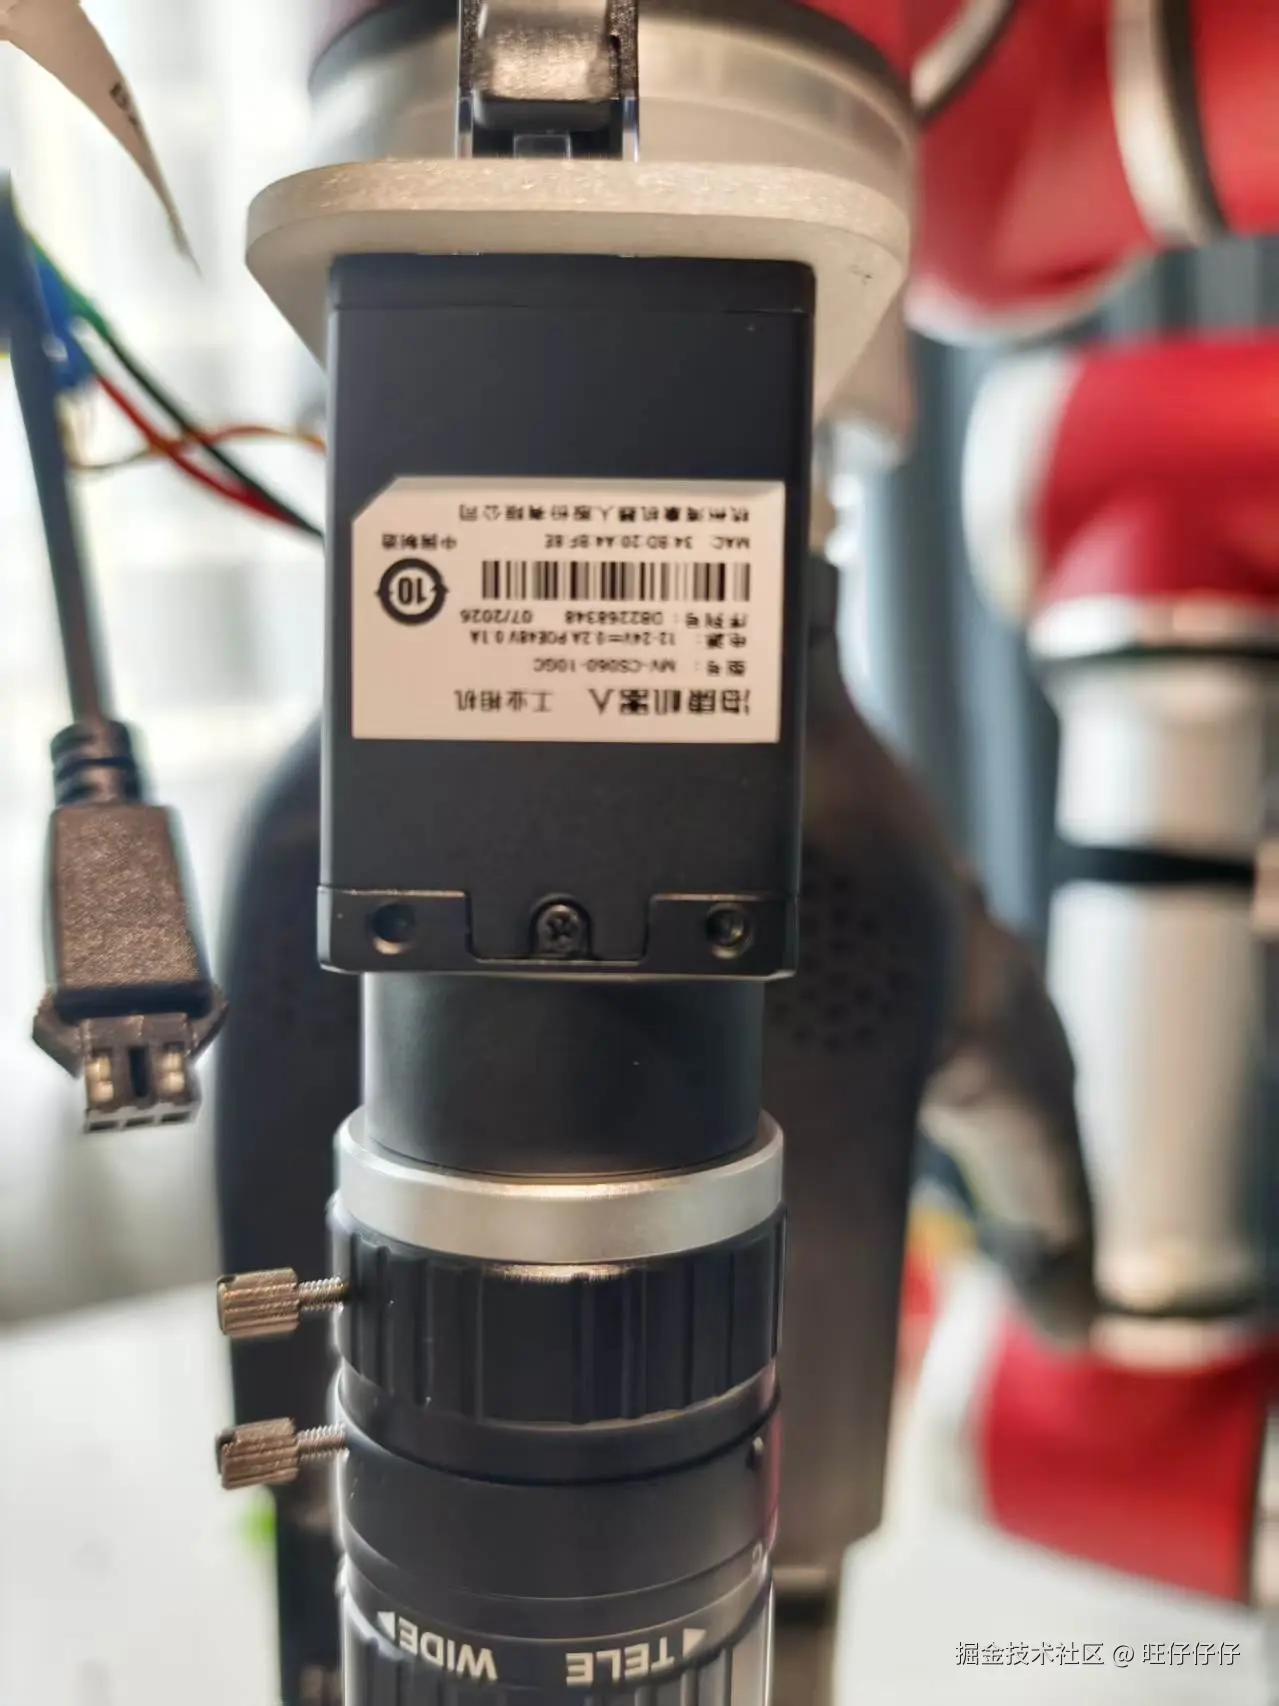
最初考虑的是海康工业相机。对于后面的识别和定位,首先得有一张清楚、稳定的图像。
实际接触之后,我发现相机需要和镜头一起考虑,不能只看分辨率。镜头焦距、工作距离、视野、光照和曝光,都会影响最后拍出来的效果。
相机装在机械臂末端,还得考虑距离变化:这个位置拍得清楚,换一个高度是否仍然清楚?视野能不能覆盖需要识别的区域?物体在画面里是不是太小?
调焦和调焦距,不是一回事
我一开始也容易把这两个说法混在一起。
焦距主要影响视野和成像比例。在传感器尺寸和工作距离相同的情况下,短焦距通常能拍到更大的范围,长焦距会让物体在画面里占得更大。
调焦则是让某个距离上的物体成像清楚。如果用的是定焦镜头,转动调焦环是在调整对焦位置,不是像变焦镜头那样改变视野。
实际调试时,我们还用到了海康的 MVS 软件。我觉得里面的一键调整功能很方便,调整之后,画面的清晰程度改善了不少。不过,镜头对焦和软件里的成像参数调整还是两件事,需要分开看。
这些设置也影响后面的标定。安装位置、镜头和成像状态确定后,再进行标定会更合适;如果后面明显改变了镜头设置,就需要重新检查内参是否还适用。
拍清楚之后,距离从哪里来?
本项目最初考虑的是二维成像方案。它能给我一张图,却不会直接给出每个像素到相机的距离。
对于固定平面上的定位,可以利用已知几何关系处理。但这个项目里,物体有高度,相机也会随着机械臂移动。我想知道的不只是物体在图像的什么位置,还包括它离相机有多远。
于是,我开始尝试:能不能保留这套成像方案,用模型把深度补出来?
二、能不能通过模型把深度补出来?
我先后尝试了 MoGe-2 和 InfiniDepth。
MoGe-2 支持从单张图像估计带有度量尺度的三维几何。InfiniDepth 关注任意分辨率和细粒度深度表达,在官方仅输入 RGB 的推理流程中,会借助 MoGe-2 提供尺度参考。MoGe 官方项目、InfiniDepth 官方项目
对我来说,最终还是要看一件事:预测出来的距离,能不能用来定位?
用机械臂位姿,给深度找一个参考值
当时我用了一个比较"取巧"的办法。
先把场景简化:工作台水平,相机朝下,让光轴尽量沿机器人基坐标系的竖直方向。读取机械臂的 TCP pose,再结合相机的安装偏移,计算相机光心相对工作台的高度。
这里不能直接拿 TCP 的 Z 值当相机高度。TCP 和相机光心不是同一个点,工作台也有自己的高度,需要先把它们放到同一个坐标系里计算。
如果图像中选取的目标点高度已知,就可以得到参考深度:
参考深度 = 相机光心到工作台的垂直距离 − 目标点相对工作台的高度在光轴竖直向下的假设下,这个高度差对应目标点沿相机光轴方向的深度。
取点也要对应起来。例如,选的是苹果顶部,就减去顶部相对桌面的高度;如果选的是侧面,就不能直接减去整个苹果的高度。
这样,我就有了一个可以和模型输出比较的几何参考值。
MoGe-2 更接近参考值,但误差仍然不小
比较后,我发现 MoGe-2 在当时选取的测试点上,比 InfiniDepth 更接近参考深度。
不过,"更接近"并不等于已经能用了。一次测试中,参考深度是 800 mm ,MoGe-2 预测的是 600 mm ,相差 200 mm,也就是 20 cm。
对于机械臂定位,这个差距显然不能忽略。
我把这个现象拿去问了 AI,再结合论文和官方实现,重点看了两个方向:深度细节和实际距离是不是同一回事,以及度量尺度是怎么恢复的。
InfiniDepth 通过神经隐式表示预测连续位置的深度,支持任意输出分辨率,能表达更细的几何结构。但边缘更清楚、形状更细致,不意味着我选取的那个点,距离就一定更准。论文里的相对深度评估会先将预测结果与真实深度对齐,再计算指标;而我检查的是直接读出来的距离,能不能对应实际场景。InfiniDepth 论文
尺度恢复也值得注意。InfiniDepth 并不是简单地在 MoGe-2 上继续训练得到的模型。官方 RGB 推理流程可以使用 MoGe-2 的预测提供尺度参考,但最终结果仍然包含 InfiniDepth 自己对局部几何的预测,并不是直接保留 MoGe-2 的深度值。官方推理代码
所以,一种可能的解释是:整体尺度有了参考,局部形状也更细致了,但苹果表面那个点的距离未必比 MoGe-2 更接近实际值。这是我结合流程得到的理解;这次测试能直接说明的,仍然是所选测试点上的差异。
既然距离存在明显偏差,我接着想:能不能再做一次修正?
用固定场景里的苹果做尺度修正
这个场景里会固定出现苹果,于是我把它作为参考物,尝试建立预测深度和参考距离之间的关系:
css
a = b × x + c其中:
x是模型预测的深度;a是修正后的深度;b是尺度系数;c是偏移量。
我的思路是利用已知的参考距离,把模型输出拉回更接近实际距离的范围。
这里的苹果不是"放进画面就能自动校准"的东西,真正起作用的是它提供的已知几何条件。取哪个点、这个点离桌面多高,都得对应清楚。一个参考点也不能同时确定尺度系数和偏移量,需要多组数据来约束这两个参数。
从当时的效果看,修正后确实好了不少。但这条路线也逐渐变成了"模型预测,加参考物,再做修正",不再只是输入一张图就能得到可用的距离。
综合考虑之后,我还是决定换成直接提供深度的相机,把精力放回坐标转换和抓取流程上。
三、最终使用 Gemini 2
最后,我选择了奥比中光的 Gemini 2。
它是一款采用主动红外双目技术的 RGB-D 相机,可以提供彩色图像和深度数据。与通过单张 RGB 图像预测深度不同,它利用双目成像和深度处理获取距离信息。Gemini 2 官方介绍
对这个项目来说,图像用来找到目标,深度用来补充三维位置。直接拿到这两类数据,少了模型尺度恢复和参考物修正这些中间环节。
折腾了一圈,我的想法变得很实际:既然设备能直接提供需要的深度信息,用起来不是很香吗?
四、有了深度,还要对应到正确的像素
拿到彩色图和深度图之后,还不能直接在两张图上用相同像素坐标取值。
彩色和深度的成像位置、分辨率可能不同。目标是在彩色图里识别出来的,就需要让它对应到正确的深度位置。
项目采用深度图对齐到彩色图的方式,内部统一使用米作为深度单位。
像素和深度对应后,就可以结合相机内参,将它反投影为相机坐标系下的三维点:
ini
X = (u - cx) × Z / fx
Y = (v - cy) × Z / fy
Z = 深度值其中,u、v 是像素坐标,fx、fy、cx、cy 来自相机内参,Z 是沿相机光轴方向的深度。
项目里的 pose_estimator.py 承担这一步。第一版取检测框中心附近的深度中位数,减少单个像素噪声的影响。
这里得到的是选取位置的三维坐标,还不能直接等同于最终抓取点。检测框中心不一定落在合适的物体表面,这两个问题需要分开。
五、相机坐标还不是机械臂坐标
经过反投影,得到的是相机坐标系下的位置。
机械臂使用的却是机器人坐标系。相机又装在末端,会跟着机械臂移动:桌上的物体没动,相机换一个姿态拍摄,它在相机坐标系里的位置就会改变。
所以,还需要把这条链路接起来:
markdown
目标像素和深度
    ↓ 相机内参
相机坐标系下的三维位置
    ↓ 手眼外参、机械臂位姿
机器人基坐标系下的三维位置
相机内参解决的是像素与相机三维坐标之间的关系;手眼标定解决的是相机与机械臂末端之间的固定关系。
到这里,我才开始处理眼在手上的手眼标定。
六、眼在手上的手眼标定
这个项目的相机固定在机械臂末端,随末端一起运动,属于"眼在手上"。
只要安装结构没有变化,相机和安装末端之间的相对位置、姿态就是固定的。手眼标定要解出的,就是这组固定变换。
采集图像和对应的机械臂位姿
我把棋盘格标定板固定在工作区域内,改变机械臂姿态,从不同位置拍摄标定板,同时记录对应的末端位姿。
每组数据包括:
- 一张标定图像;
- 拍摄时对应的机械臂位姿。
采集时让机械臂停止并稳定,再保存图像和位姿,保证它们对应同一个状态。
最后采集了 20 张图片,但过程中也踩了一个坑:图片数量有了,位姿变化却不够。
最初采集时,平移、旋转和高度的变化都不大,相机基本是在一个接近固定的角度拍摄。图片看起来不是同一张,但提供的姿态约束很相似,求出的结果偏差比较明显。
后来,我调整了采集方式,拉开拍摄高度、位置和旋转角度,同时保证棋盘格完整可见、角点清楚。
这次让我意识到,标定不是拍够多少张就结束了。相比多拍几张相似图片,让不同姿态提供有效约束更重要。
求标定板在相机坐标系下的位姿
检测棋盘格角点后,结合相机内参和棋盘格的实际尺寸,通过 PnP 求出标定板到相机坐标系的变换。
这里有两个容易填错的地方:棋盘格填写的是内角点数量,不是格子数量;格子边长需要按实际尺寸设置,并和机器人平移数据统一单位。
求相机到末端的变换
再把各组机械臂位姿和标定板位姿送入 OpenCV 的 calibrateHandEye,求出相机到末端的变换。OpenCV 手眼标定文档
这一步需要特别注意方向。"相机到末端"和"末端到相机"是两组互逆的变换,不能看变量名差不多就直接使用。
机器人接口返回的末端位姿,也要弄清楚是法兰还是配置后的 TCP。标定和后续转换必须使用一致的坐标系定义。
七、把标定结果接进项目
在 robo_dex_flow 中,手眼外参放在 calibration.yaml,坐标转换集中在 geometry/handeye.py。
采用法兰作为安装参考时,变换关系为:
ini
T_base_camera = T_base_flange × T_flange_camera这里约定 T_A_B 表示将 B 坐标系中的量转换到 A 坐标系。
如果机器人接口返回的是 TCP 位姿,就先计算法兰位姿:
ini
T_base_flange = T_base_tcp × inverse(T_flange_tcp)然后再组合相机到基坐标系的变换。
项目带有灵巧手,工具操作点和法兰不一定重合,所以单独保留了 flange_tcp 配置。
内部位姿统一采用米和 xyzw 顺序的四元数,设备接口的原始数据在适配层转换。这样组合变换时,不需要每一步都重新猜单位和姿态顺序。
八、用桌面点云检查转换结果
得到标定矩阵后,我没有只看旋转和平移数值,而是把它们用到实际数据里检查。
我的方式是固定拍摄桌面,先按各项输入都正确的假设,把深度数据还原为相机坐标系下的三维点,再结合手眼外参和拍摄时的机械臂位姿,转换到机器人基坐标系下,导出为 PLY 点云。
然后,将转换后的桌面点云和基坐标系下的标准桌面平面对照。
主要观察三个地方:桌面有没有整体偏高或偏低,有没有明显倾斜,以及不同位置的点与参考平面相差多少。
从当时的检查结果看,差距在几毫米。这比只看一组矩阵直观得多,也让我能判断转换后的桌面位置是否接近实际场景。
这里检查的是深度、内参、手眼外参和机械臂位姿共同组成的定位链路,几毫米的差距是当时的验证结果,不单独等同于手眼标定的精度。
写在最后
一开始,我以为选好相机、拿到图像,就可以往后做抓取了。真正动手后才发现,从"看见物体"到"知道机械臂该往哪里走",中间还有不少事情要确认。
海康相机让我先接触了成像调试;MoGe-2 和 InfiniDepth 的尝试,让我发现深度图看起来不错,和里面的距离能直接使用,是两回事。用已知参考修正后,效果改善了不少,但综合考虑,我还是选择了 Gemini 2。
手眼标定也一样。采集了 20 张图片,不代表姿态就足够丰富;求出矩阵,也不代表坐标已经可靠。把桌面点云转换到基坐标系,再与标准平面对照,才让我看到这些变换用起来到底是什么效果。
这篇先记录到这里:相机选型、深度尝试,以及手眼标定和坐标检查。这些步骤,也是我第一次把图像里的位置和机械臂使用的坐标真正联系起来。