
**🎬 博主名称**:迷途之人不知返
🔥 个人专栏 : 《C语言》、《数据结构》、《C++》、《Linux》
🗂️ Gitee仓库 : 《C语言》、《数据结构》、《C++》、《Linux》
</> 算法专栏 : 《算法精选集》
模拟
- [1 ···> 替换所有的问号](#1 ···> 替换所有的问号)
- [2 ···> 提莫攻击](#2 ···> 提莫攻击)
- [3 ···> Z 字形变换](#3 ···> Z 字形变换)
- [4 ···> 外观数列](#4 ···> 外观数列)
- [5 ···> 数青蛙](#5 ···> 数青蛙)
模拟的思想就是依葫芦画瓢,即题目叫你做什么,你就做什么。
但是,直接模拟,有些情况下可能不是最优的解法。这时我们往往可以找规律。
1 ···> 替换所有的问号
题目的要求有两个:
- 替换"?"成小写字母;
- 替换后的小写字母,不能与相邻小写字母重复
此时我们就可以遍历字符串s,遇到"?"就开始替换,不过我们要注意边界条件,即串首与串尾:
cpp
class Solution {
public:
    string modifyString(string s) {
        int n = s.size();
        for (int i = 0; i < n; ++i)
            if (s[i] == '?')
                for (char ch = 'a'; ch <= 'z'; ++ch)
                {
                    if ((i == 0 || ch != s[i - 1]) && (i == n - 1 || ch != s[i + 1]))
                    {
                        s[i] = ch;
                        break;
                    }
                }
        return s;
    }
};代码中,if ((i == 0 || ch != s[i - 1]) && (i == n - 1 || ch != s[i + 1]))处理的就很巧妙:
- 如果
i == 0,- 如果ch命中了
ch != s[i + 1],那么就替换,然后break,寻找下一个"?"; - 如果没命中,ch就++,继续判断。
- 如果ch命中了
- 如果
i == n - 1,- 如果ch命中了
ch != s[i - 1],那么就替换,然后break; - 如果没命中,ch就++,继续判断。
- 如果ch命中了
- 其余的情况,就可以判断ch与当前位置的左右两边是否相同。
2 ···> 提莫攻击
对于这道题,我们来找一个规律:
假设有相邻两个攻击的时间点[a, b],差值为x = b - a
- 如果
x >= duration,说明在这两次攻击之间,中毒效果持续了duration; - 如果
x < duration,说明在这两次攻击之间,中毒效果只持续了x,然后在时间点b时,中毒效果的剩余持续时间又会刷新成duration。
知道了这个规律,那么我们就可以直接遍历timeSeries,进行上面的处理,得出中毒效果的总时间:
cpp
class Solution {
public:
    int findPoisonedDuration(vector<int>& timeSeries, int duration) {
        int ret = 0;
        for (int i = 1; i < timeSeries.size(); ++i)
        {
            int x = timeSeries[i] - timeSeries[i - 1];
            ret += (x >= duration) ? duration : x;
        }
        return ret + duration; // 最后的中毒时间是持续 duration 的,要加上
    }
};
3 ···> Z 字形变换
对于这道题,我们当然可以直接进行模拟,即创建一个矩阵,然后按要求填写矩阵,最后按顺序做出要返回的字符串:
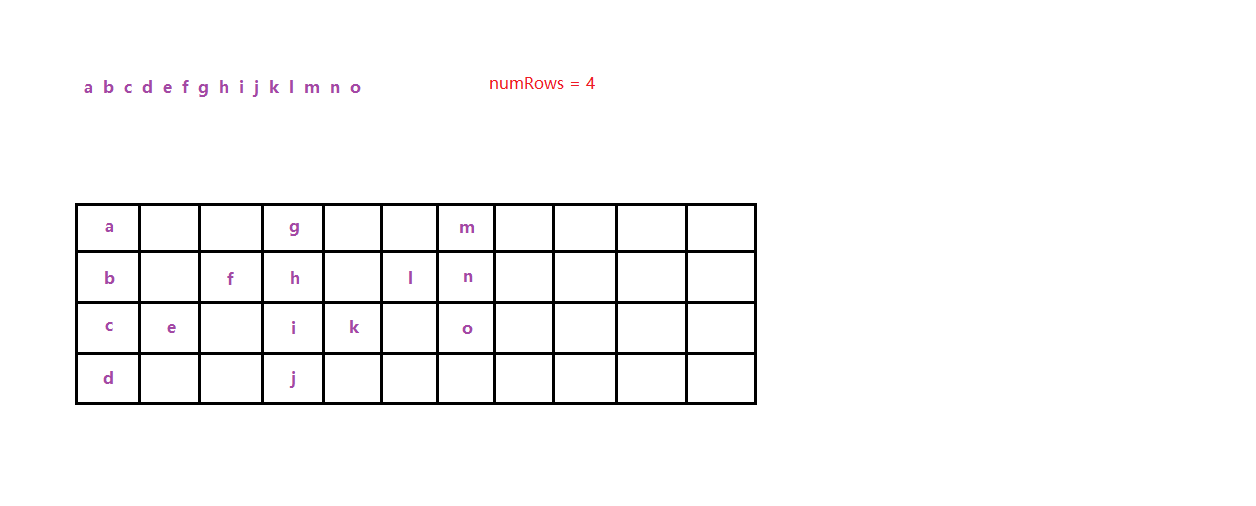
但是这样做,时间复杂度和空间复杂度就太大了。
对于"模拟"的题型要想优化,我们可以来找规律。
还是用上面的例子。我们把字符下标填进矩阵里:
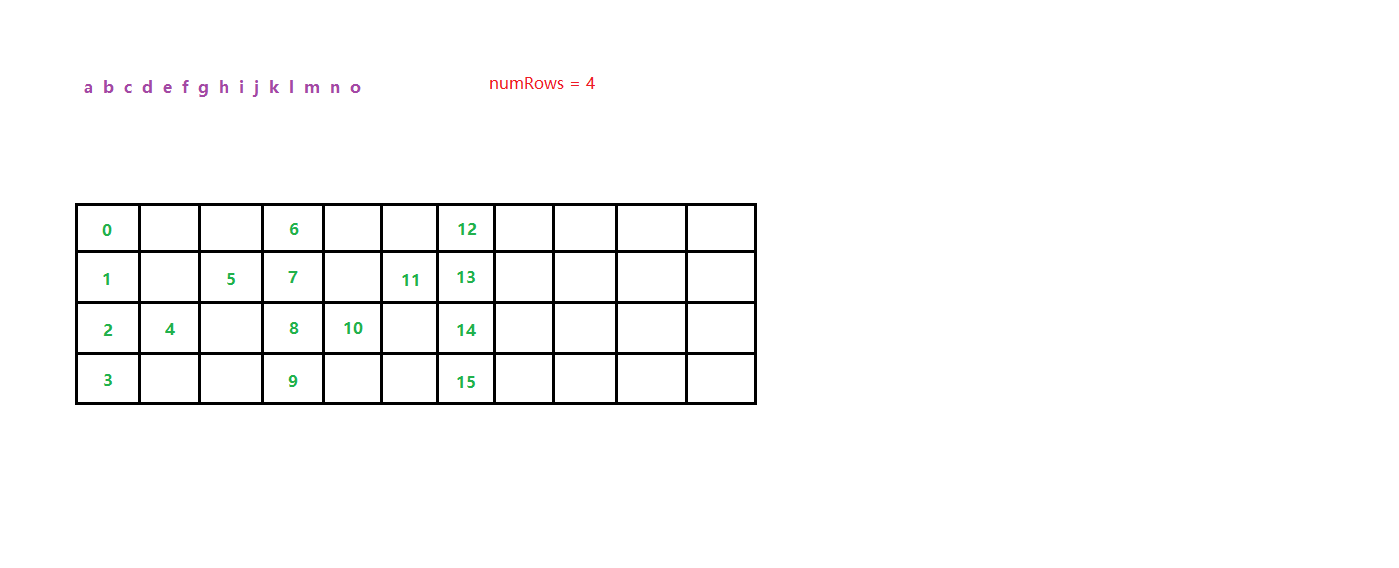
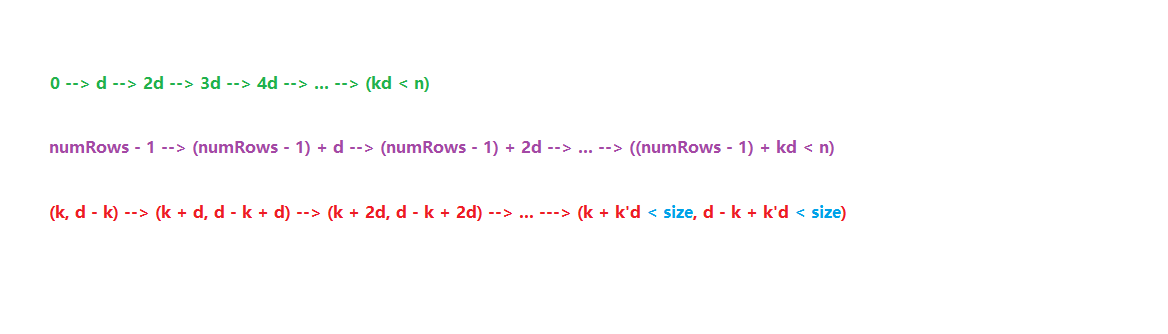
对于第0行,
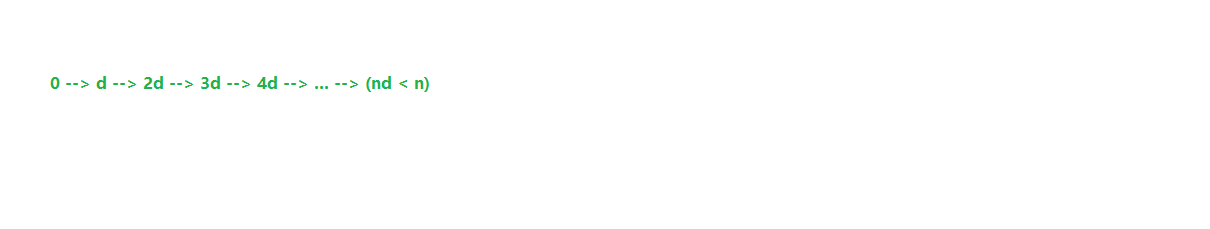
- 我们可以发现,字符下标的规律是等差数列 ;大胆猜想,设相邻的公差为
d,那么有d = 2 * numRows - 2 - 那么我们就可以从
i = 0开始,遍历原字符串,每次 +d ,写入字符,直到越界。
同理。对于第numRows - 1行,
- 相邻也是相差d;
- 我们可以从
i = numRows - 1开始,遍历原字符串,每次 +d ,写入字符,直到越界。
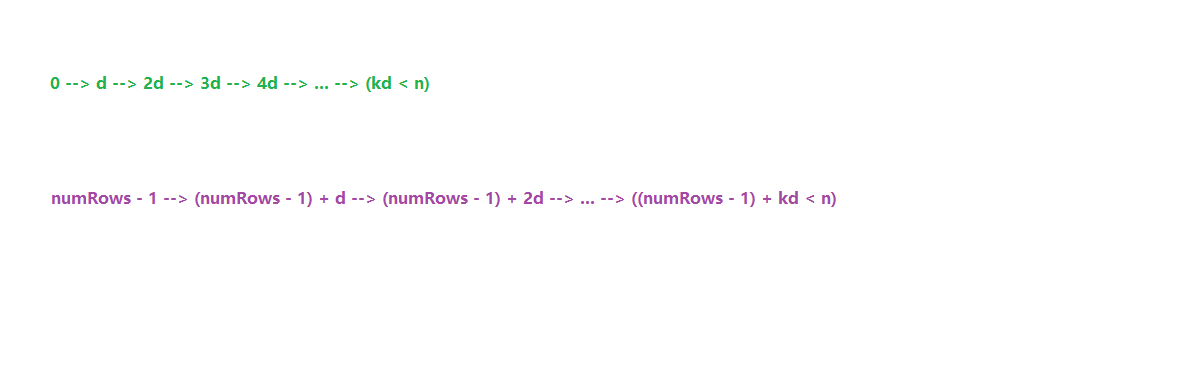
对于中间行k行(1 <= k < numRows - 1),
- 从最左侧开始,每相邻两个下标,加和为
k + n*d (n = 0, 1, 2, ...) - 我们就可以对每一行,
- 创建
i j,表示相邻的两个下标; i = k, j = d - k开始,遍历原字符串,每次 +d ;- 只要
i j其中一个没有越界,都可以继续遍历; - 写入的时候,要判断是否越界。
- 创建
c
class Solution {
public:
    string convert(string s, int numRows) {
        // numRows == 1 的时候,不用处理直接返回
        // 而且如果向下处理,计算得出 d == 0 ,处理第1行就会陷入死循环
        // 所以我们另外处理
        if (1 == numRows) return s;

        string ret;
        int d = 2 * numRows - 2, n = s.size();

        // 1. 处理第1行
        for (int i = 0; i < n; i += d)
            ret += s[i];

        // 2. 处理第2行
        for (int k = 1; k < numRows - 1; ++k)
            for (int i = k, j = d - k; i < n || j < n; i += d, j += d)
            {
                if (i < n) ret += s[i];
                if (j < n) ret += s[j];
            }

        // 3. 处理第3行
        for (int i = numRows - 1; i < n; i += d)
            ret += s[i];

        return ret;
    }
};
4 ···> 外观数列
4.1、题目理解
首先来理解"行程长度编码"。
例如这里有一组源码:
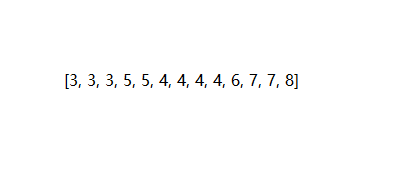
进行编码:
3有3个,编码:33,意为"3个3"5有2个,编码:25,意为"2个5"4有4个,编码:446有1个,编码:167有2个,编码:278有1个,编码:18
编码完成后,结果:
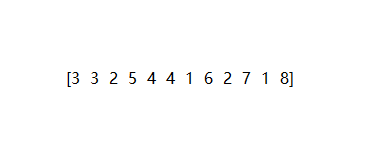
其次来分析外观数组。
当 n = 1 ,外观数组定义为
1
当 n = 2 ,对 n = 1 时的外观数组做行程长度编码,结果为
1, 1
当 n = 3 ,对 n = 2 时的外观数组做行程长度编码,结果为
2, 1
当 n = 4 ,对 n = 3 时的外观数组做行程长度编码,结果为
1, 2, 1, 1
当 n = 5 ,对 n = 4 时的外观数组做行程长度编码,结果为
1, 1, 1, 2, 2, 1
当 n = 6 ,对 n = 5 时的外观数组做行程长度编码,结果为
3, 1, 2, 2, 1, 1
......
4.2、原理分析
这道题的核心思路,其实就是"模拟",即
- 对上一个外观数组,进行行程长度编码;
- 将编码结果作为新数组,覆盖上一个外观数组。
那么当务之急,就是如何用编程语言,完成行程长度编码的过程。
我们随便创建一个数组做示范。我们可以采用双指针的策略:
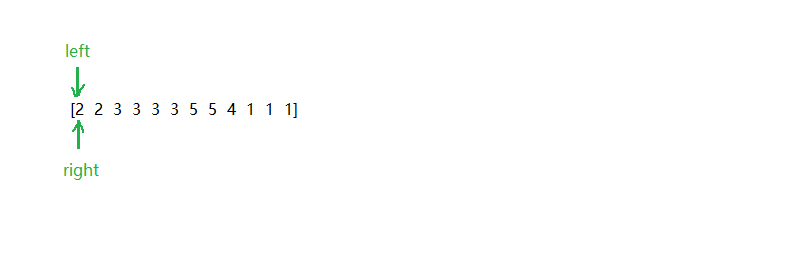
right向前走,
- 遇到与
left相同的数,继续向前; - 遇到与
left不同的数,停止。
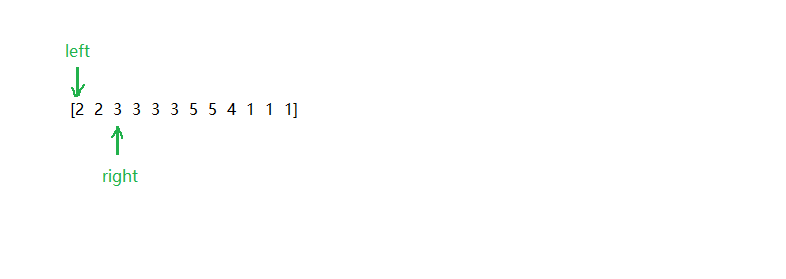
此时,left指向的数就是要写入的数,这样的数一共有right - left个。
我们就可以,
- 写入字符串;
left来到right的位置,right继续向前。
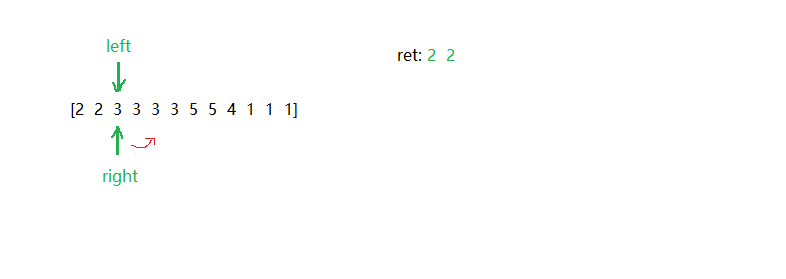
重复操作,直到right越界。
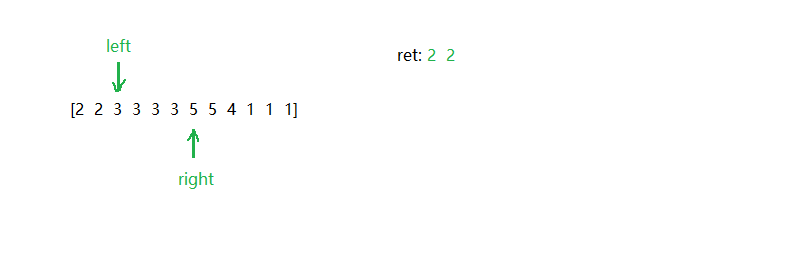
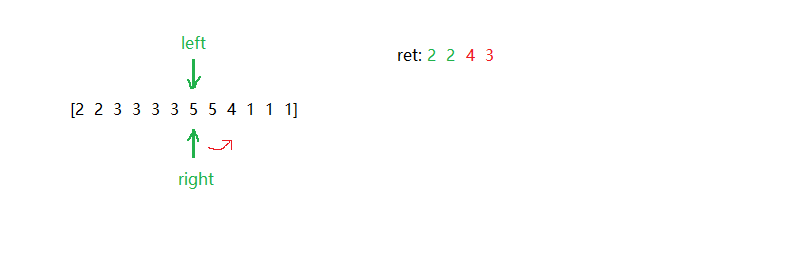
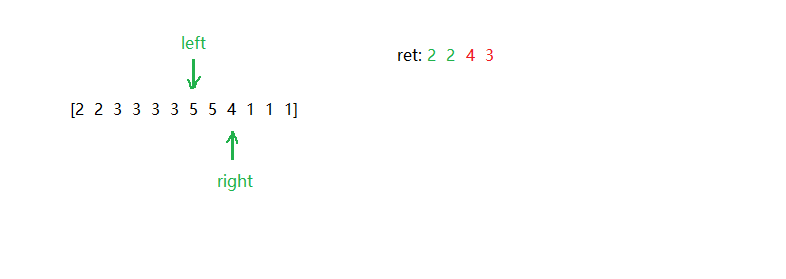
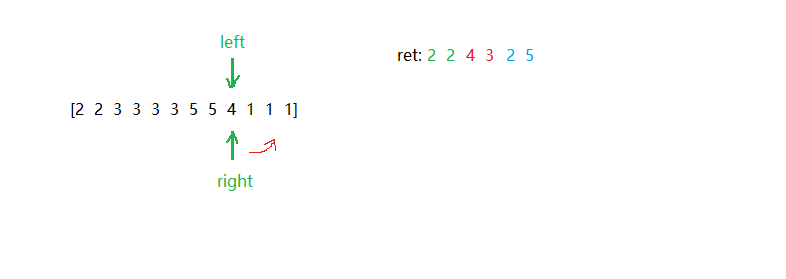
(接下来的就不画了,自己画吧)
4.3、代码演示
cpp
class Solution {
public:
    string countAndSay(int n) {
        string ret = "1";
        for (int i = 1; i < n; ++i) // n == 1的情况做好了,所以我们只需做n - 1次编码操作
        {
            string tmp = ""; // 临时string变量,存储每一次编码的结果
            int len = ret.size(); // 记录i - 1时外观数组的长度
            for (int left = 0, right = 0; right < len;)
            {
                while (right < len && ret[right] == ret[left]) ++right;
                tmp += to_string(right - left) + ret[left]; // to_string()保证数字转换成字符串
                left = right;
            }
            ret = tmp;
        }

        return ret;
    }
};
5 ···> 数青蛙
5.1、题目理解
比如我们有这样一个序列:
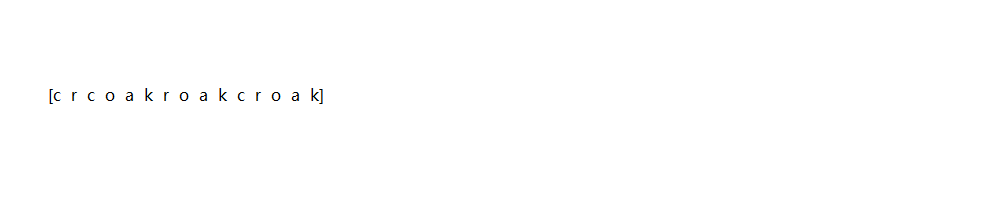
前面10个字符,需要2个青蛙才能完整地叫出每一个"croak":
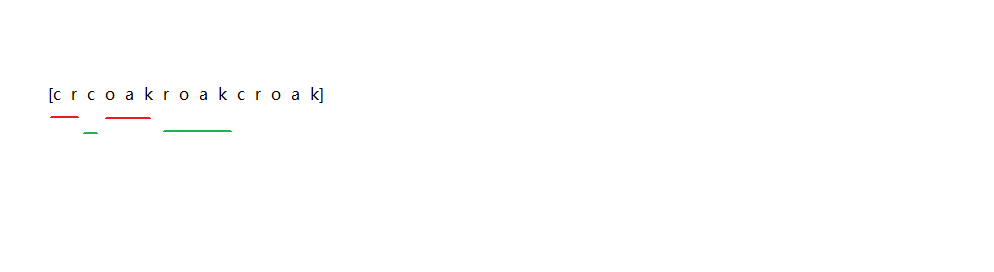
但是,对于最后一个"croak",由于之前已经有青蛙叫完了,所以这个"croak"只需要由前面2个青蛙的其中1个交出来就可以。
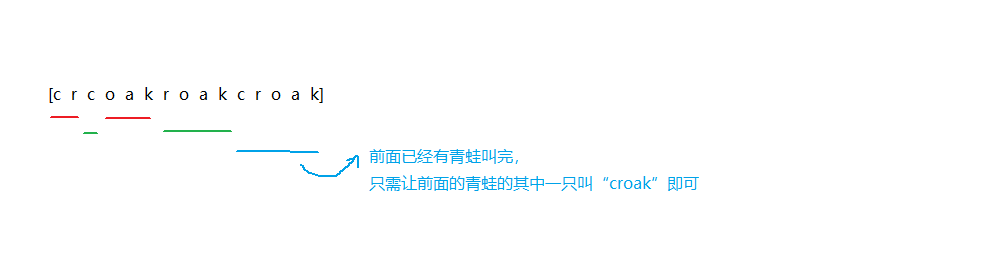
所以对于这个序列,最少需要2只青蛙。
5.2、原理总结
我们另外建立一个存"croak"的哈希表。然后遍历给出序列,做如下操作:
- 如果遇到
c,看哈希表里是否存在k:- 如果存在,
k-- c++ - 如果不存在,直接
c++
- 如果存在,
- 如果遇到
r o a k中的其中一个,看前一个字符是否存在(比如遇到r,就看c存在与否;遇到a,就看o存在与否):- 如果存在,
前--,此++ - 如果不存在,说明不能叫出正确的序列,
return -1
- 如果存在,
遍历完成后,我们还要检查哈希表,如果有k之前的字符存在,也说明不能叫出正确的序列,return -1。
(当然,如果你还记得这道题的思路,不妨蒙起上文,自己举例遍历一遍,然后自己做一个像上面一样的总结)
5.3、代码实现
我们当然可以写很多个if else,但是那样不通用。(如果题目把固定的"croak",设置为可变的string变量,传递进来呢?)
我们来实现一个通用的做法。
首先是哈希表的制作(用数组模拟哈希表?):
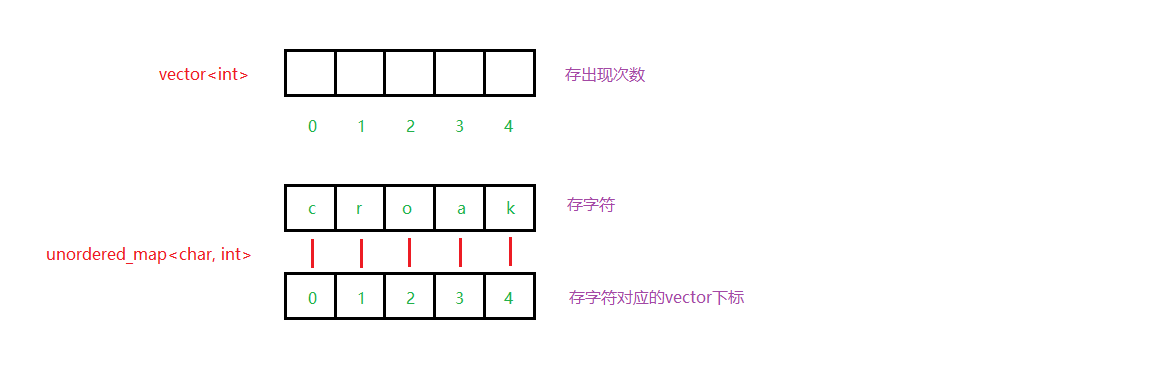
这样定义哈希表,我们就可以对当前字符,
- 字符映射到vector下标;
- 下标自减找到前一个字符;
就可以以一个通用的方法,找到当前字符的前一个字符,就不需要设计那么多if条件了。
cpp
class Solution {
public:
    int minNumberOfFrogs(string croakOfFrogs) {
        string sound = "croak";
        int len = sound.size();

        // 1. 制作哈希表
        vector<int> hash(len);
        unordered_map<char, int> index;
        for (int i = 0; i < len; ++i)
            index[sound[i]] = i;

        // 2. 遍历原序列,按总结填表
        for (auto& ch : croakOfFrogs)
        {
            if (sound[0] == ch)
            {
                // if (hash[map[sound[len - 1]]] != 0) hash[map[sound[len - 1]]]--;
                // hash[map[ch]]++;
                if (hash[len - 1] != 0) hash[len - 1]--;
                hash[0]++;
            }
            else
            {
                // if (hash[map[ch] - 1] == 0) return -1;
                // else
                // {
                //     hash[map[ch] - 1]--;
                //     hash[map[ch]]++;
                // }
                int i = index[ch];
                if (hash[i - 1] == 0) return -1;

                hash[i - 1]--; hash[i]++;
            }
        }

        // 3. 填完表后,检查是否还有除最后字符外的其它字符存在
        for (int i = 0; i < len - 1; ++i)
            if (hash[i] != 0)
                return -1;

        return hash[len - 1]; // 返回最后字符出现的次数
    }
};
(保留了本人一开始,尝试写代码的痕迹。可以对比学习老师写代码的思路)
实际上,对于可变的sound(不仅仅是"croak"),那么原理总结中,
c就是sound的首字符k就是sound的尾字符- 其它字符都是
sound的中间字符