同题对画:Qwen-Image-2512 与 Qwen-Image-2.1 实测对比
一句话结论:20B 的 2512 会自己构图,7B 的 2.1 会自己拉近;单步 2.1 更快,但算上步数,2512 靠加速 LoRA 把总采样时间压到了三分之一。要商用,只有 2512 能用。
一、先厘清:它们不是"上一代 / 下一代"
很多人第一眼会把 2.1 当成 2512 的升级版。其实 2026 年这条产品线分过家:
| Qwen-Image-2512 | Qwen-Image-2.1 | |
|---|---|---|
| 发布 | 2025-12-31 | 2026-09-20 |
| 血统 | 20B 文生图分支的收官版 | 换代后回归开源的新分支 |
| 主干 | 20.4B MMDiT(总参 28.8B) | 7B 单流 DiT,32 层 |
| 文本编码器 | Qwen2.5-VL-7B | Qwen3-VL-8B |
| 全量 BF16 | 约 41 GB | 约 14.2 GB |
| 协议 | Apache 2.0,可商用 | Qwen Research License,非商用 |
| 图像编辑 | 不支持(编辑在独立模型) | 内置,最多 10 张参考图 |
| 透明 RGBA | 不支持 | 原生支持 |
| 原生分辨率 | 约 1328² | 原生 2K(2048²、2752×1536 等 7 种比例) |
| 加速 LoRA | 有(Lightning 4 步) | 暂无 |
中间还有两个过客:2.0 (2026-02,架构换代但没放权重)和 3.0(2026-07,纯闭源商业 API)。2.1 是 9 月回到开源线的那一版------所以版本号看着像"倒退",其实是换了条支线重开。
选型分界线很硬:要商用,2.1 直接出局;要透明贴纸、多图编辑、2K 大图,2512 做不了。
二、实测环境
不报具体型号,只说够用的信息:
- 显卡:16 GB 显存的中端消费级显卡
- 内存:32 GB
- 系统:Windows
- 平台:ComfyUI 0.37.0
两套模型用的都是量化权重(不是全量 BF16):
| 2512 | 2.1 | |
|---|---|---|
| 主模型 | fp8_e4m3fn,19.03 GB | Q8_0 GGUF,7.12 GB |
| 文本编码器 | 8.74 GB | int8,8.71 GB(放内存) |
| VAE | 0.24 GB | 0.63 GB |
| 加速 LoRA | 有,0.79 GB | 无 |
三、同题对画
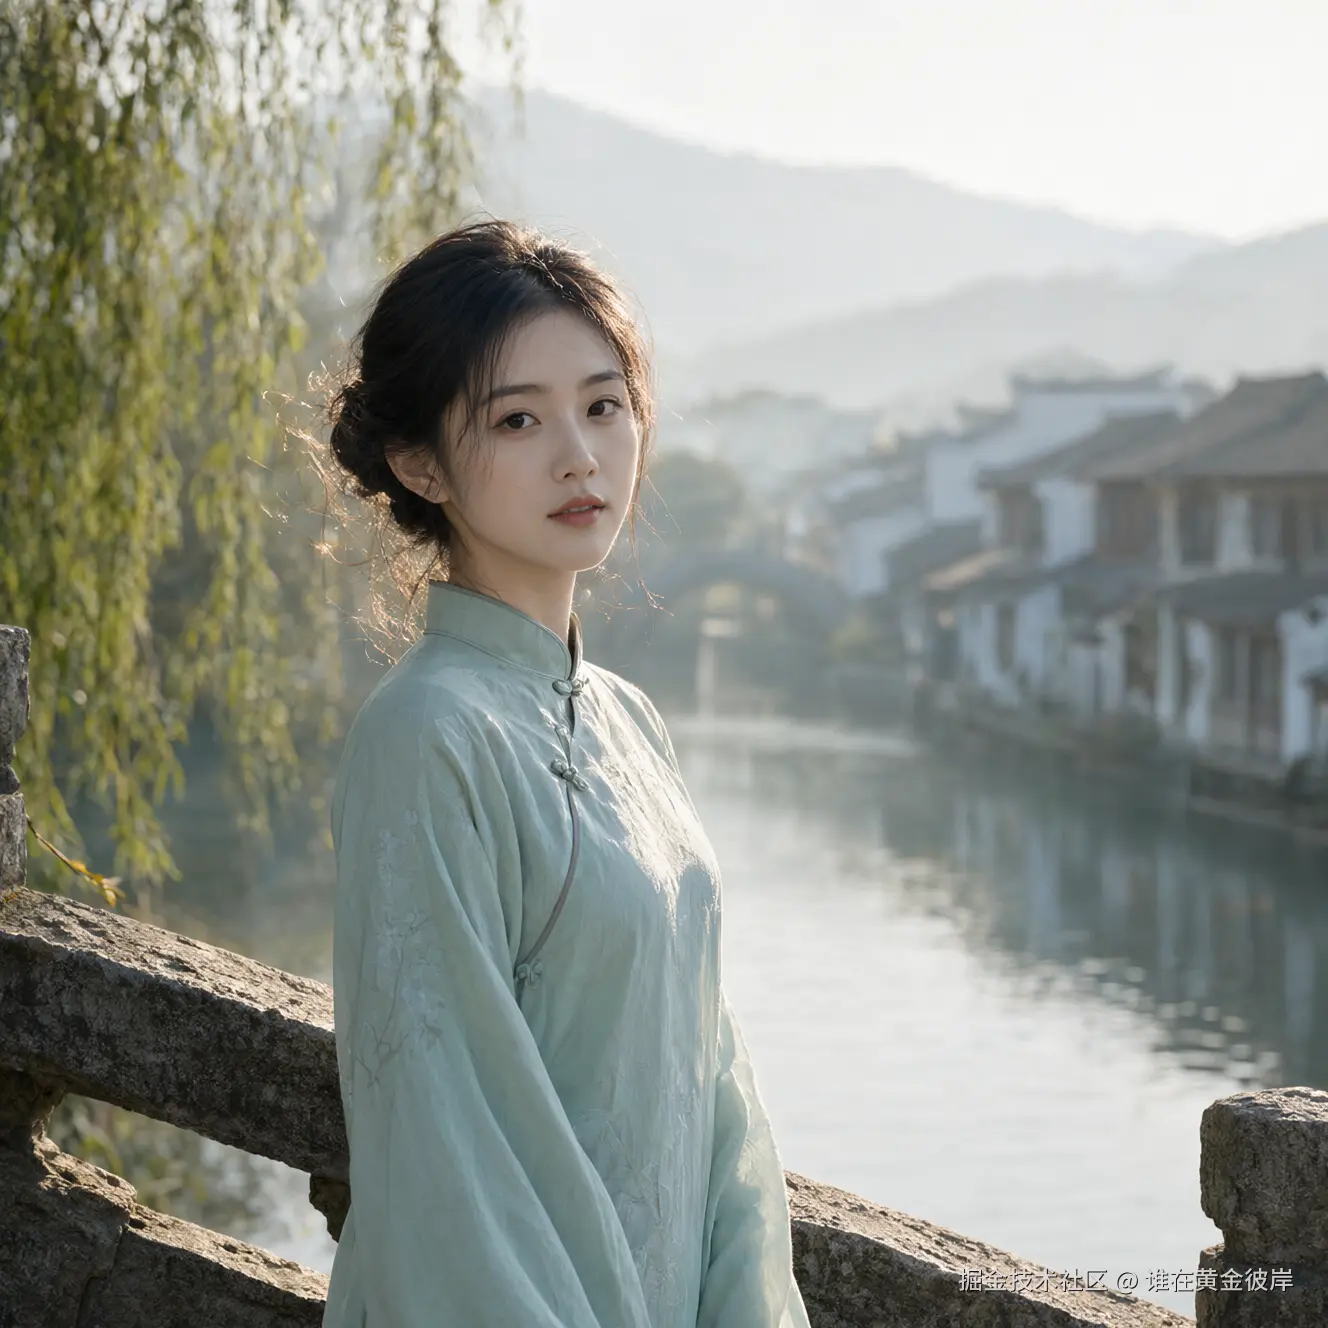
用逐字相同的中文提示词,同分辨率 1328×1328,各出一张。
提示词大意:一位身着浅青色新中式长裙的中国年轻女子,立于江南水乡的石拱桥畔,晨雾弥漫,垂柳依依,白墙黛瓦的民居与层叠远山在薄雾中若隐若现,清晨侧逆光在发丝上勾出金色轮廓,皮肤细腻真实......(后面跟一串英文摄影参数收尾)
图 1|Qwen-Image-2512
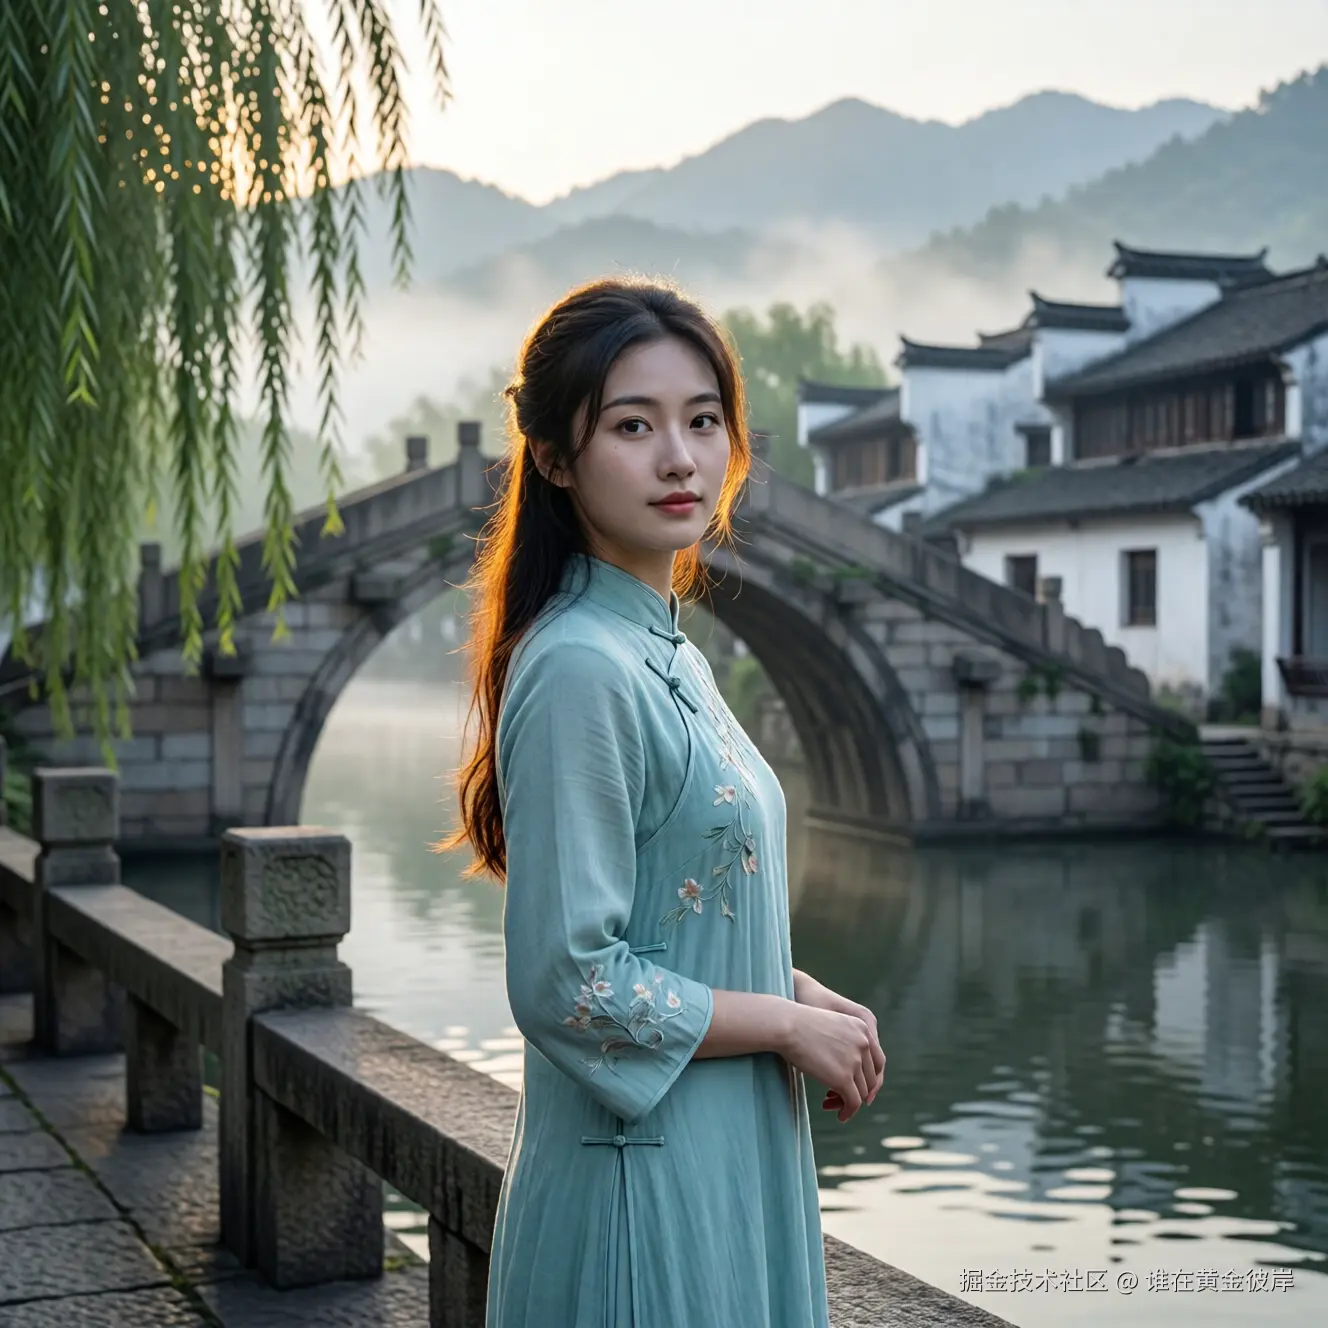
图 2|Qwen-Image-2.1
结果很有意思------两个模型都没有完全"听话":
- 2512 自己选了远景:石拱桥的桥拱正好把人物框在画面中央,桥、垂柳、水乡民居、远山一个不少,是一张"人在景中"的完整构图。
- 2.1 自己选了近景半身:人物占画面主体,桥被虚化进背景,柳条与水面作为陪衬。脸部微细节的密度明显更高。
提示词写的是"立于石拱桥畔",两边都给了桥,但**"人像优先"还是"风景优先"的默认倾向不同**。这不是谁对谁错------是同一种描述下,20B 和 7B 对"重点在哪"的理解差异。
一致的地方:中文提示词两边都完整吃下(服饰、水乡、光线、雾气全部命中);手部结构和皮肤质感都没有出现畸形或塑料感。
四、速度账:单步快 ≠ 总时间短
这是最容易被误读的地方。2.1 是 7B,2512 是 20B,直觉上 2.1 应该快得多------但按可用画质算,它更慢。
| 2512 | 2.1 | |
|---|---|---|
| 步数 | 8 步(挂 Lightning LoRA) | 40 步(无加速 LoRA) |
| 单步耗时 | 4.01 s/it | 2.87 s/it |
| 纯采样总时长 | 约 32 秒 | 约 115 秒 |
| 端到端(含模型加载) | 235 秒 | 342 秒 |
| 显存驻留 | 19.4 GB,动态分载 | 7.5 GB,满载无卸载 |
怎么读这张表:
- 单步上,7B 的 2.1 确实快约 40%------参数少就是快,这条没毛病。
- 但 2.1 没有加速 LoRA ,得老实跑 40 步;2512 被蒸馏到 8 步。乘完步数,2512 的总采样时间只有 2.1 的三分之一。
- 端到端的差距会被模型加载稀释:2512 那次光模型初始化就花了 149 秒。第二次跑(权重已在缓存里)差距会更明显。
- 2.1 的显存账好看得多:7.5 GB 一次装满,全程不需要来回搬运。
一句话:慢的模型靠少步数赢,小的模型靠能装下来赢。
五、部署路上踩的坑(这部分比画质更有参考价值)
坑 1:社区量化的 GGUF 元数据是空的
下载的 unsloth 版 2.1 GGUF,265 个张量齐全,但元数据段的 KV 对数是 0 ------连最基础的 general.architecture 都没有。ComfyUI-GGUF 直接报:
sql
Unknown model architecture!修法是自己重写文件头,补一条 KV 记录,数据区一个字节都不动(文件只长了 64 字节)。
但这里有个陷阱值得单独说:GGUF 里每个张量的 offset 是相对数据段起点 的。补完头部后,只要数据段起点和新偏移同步后移,相对偏移应当保持不变 。我第一版顺手给 offset 也加了 64,造成双重平移------文件结构看上去合法,实际数据全部错位。校验方式是逐段哈希比对修复前后的数据区,确认逐字节一致。
坑 2:2.1 的提示词不走普通节点
2512 用 CLIPTextEncode,2.1 用专用的 TextEncodeQwenImage21------一个节点同时吐正条件、负条件,还能接受最多 16 张参考图。拿 2512 的工作流改个模型名是跑不通的,得按 2.1 的官方模板重构。
坑 3:cfg=1 时负向提示词是摆设
2.1 官方说明里写得很清楚:negative_prompt: unused while cfg is 1。而它的默认路径就是 cfg=1,所以负向提示词填了也不生效------想用负向必须先提高 cfg。这跟 2512(cfg 4 + 中文负向)的玩法正好相反,照搬参数会白写一屏。
坑 4:复制仓的 license 标签是错的
官方复制仓把 2.1 的 license 标成了 apache-2.0,而上游的原文是 Qwen Research License,仅授非商业使用。别拿复制仓的标签当商用依据,以 HF 上游仓库的 LICENSE 原文为准。
附:一个该记住的性能开关
2.1 的文本编码器(8.71 GB)只需要在编码提示词 时上场,整个采样阶段完全用不到。把加载器节点的 device 从 default 改成 cpu,这 8.7 GB 全程不碰显存,对出图速度几乎零影响。
在只有一张 16GB 卡的时候,这个开关是 2.1 跑得舒服的关键。
六、怎么选
| 需求 | 选择 |
|---|---|
| 写实人像、商用交付、频繁改提示词迭代 | 2512 ------ Apache 2.0 干净、有加速 LoRA、画面组织能力强 |
| 透明贴纸/抠图、图生图编辑、多图合成、要 2K 大图 | 2.1 ------ 这些 2512 根本做不了 |
| 只有一张 8GB 显存的卡 | 2.1 更有希望 ------ 主模型有 4~7 GB 档位可选,文本编码器扔内存;2512 的 fp8 是 19 GB,8GB 卡上必然大量卸载 |
两台机器上并存不冲突,按任务选就行,不必二选一。
七、两句免责
- 2.1 的协议是非商用,下载前先确认自己的用途。协议判断以 HF 上游仓库的 LICENSE 原文为准。
- 本文的画质判断基于单张同题对照,样本量很小,只能当"方向性印象"看,不能当排行榜用。
实测日期:2026-10-08