大家好,我是孟健。上周我把团队自动化编程 Agent 矩阵的主力调用通道重新梳理了一遍,并复盘了全月的算力账单。
同样是每月 200 美元的高阶订阅,你以为两家给出的算力池差不多?据 SemiAnalysis 在 2026 年 10 月 6 日公布的极限测试数据,在日常主力模型与 Agent 工作流下,Claude 200 美元计划给出的实际 API 等价价值,大约是 OpenAI 对应计划的 5 倍左右。对于重度依赖编程 Agent 的独立开发者和一人公司而言,算力采购成本直接决定了项目的现金流安全边际。这篇文章不谈虚无的概念,适合正在搭建自主 Agent 或重度消耗模型算力的开发者,看完你能彻底算清高阶订阅背后的真实吞吐账本,并获得可落地的模型路由降本方案。
01、日常主力模型对决:5 倍 API 等价价值从何而来
很多技术人在选型时容易陷入一个误区:跑通 Demo 不等于具备生产吞吐能力。当我们把上下文交给全自动编程 Agent 运转时,Token 消耗模型与普通的单次对话完全不同。
根据 SemiAnalysis 在 2026 年 10 月 6 日给出的基准测试,真实的 Agent 工作流分布表现为极端的上下文重用:新输入仅占 0.4%,缓存输入高达 96.6%,缓存写入占 2.6%,最终输出仅占 0.3%。相比之下,普通 Chat 场景的新输入占 2%,缓存输入为 75%,缓存写入占 13%,输出占 10%。
在日常主力中档模型这一关键战场上,两者的算力释放呈现出显著断层:
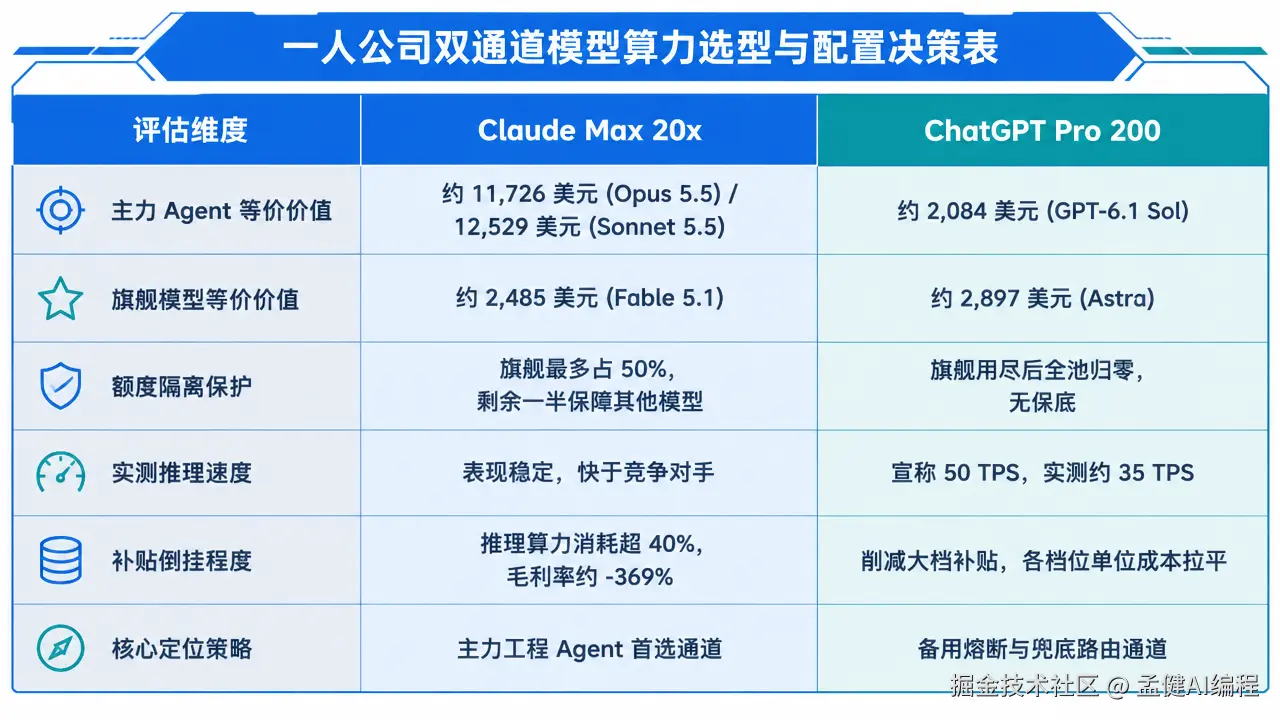
- 在 Agent 混合负载下,200 美元的 Claude Max 20x 释放出了约合 11,726 美元的 Opus 5.5 API 等价用量。
- 相比之下,ChatGPT Pro 200 仅跑出约合 2,084 美元的 GPT-6.1 Sol 等价用量,前者几乎是后者的 5 倍左右。
- 若在 Claude Max 20x 中配合 Sonnet 5.5 运行 Agent,其等价价值更高达 12,529 美元,相当于月费订阅成本的 62.6 倍。
算力账的核心从来不是看月费标价,而是看单位产出能复用多少低成本缓存。 OpenAI 在 2026 年 10 月 2 日公布的 GPT-6.1 Sol 定价中,虽然将缓存命中压到 0.10 美元/百万 token,但一旦单次上下文超过 272K token 阈值,就会触发超长上下文惩罚机制,输入与缓存成本翻倍,输出成本乘 1.5。这使得 OpenAI 在需要吃进海量代码库的长上下文 Agent 循环中,吞吐额度被快速吞噬。
02、额度熔断机制:业务容错率的架构级分水岭
在代码构建与重构场景中,旗舰档模型的兜底能力往往决定了系统能否收敛。在这个层级,两家的 API 等价账面价值看似接近:ChatGPT Pro 200 对应约 2,897 美元 Astra,Claude Max 20x 对应约 2,485 美元 Fable 5.1。真实工程交付不看理论峰值,拼的是异常边界下的安全边际。
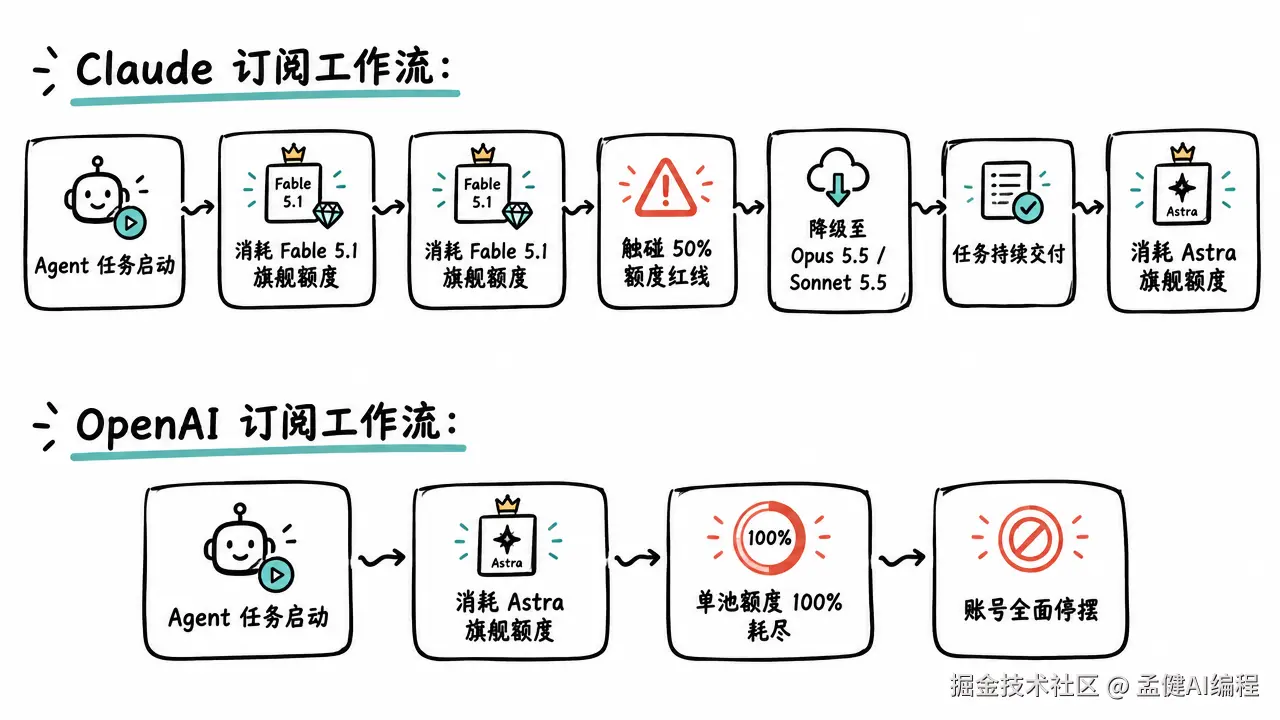
两家底层配额机制的设计哲学截然相反:
- OpenAI 的共享见底机制:ChatGPT Pro 采用统一资源池。一旦 Astra 在高难度任务中跑满,整个账户的总额度会彻底见底,连降级调用 Sol 的机会都没有,直接导致自动化流水线彻底停摆。
- Claude 的配额隔离机制:Fable 5.1 最多只能消耗订阅总额度的 50%。即便旗舰模型额度全部耗尽,系统依然保留了整整一半的独立额度供 Sonnet 5.5 或 Opus 5.5 继续工作。
做工程不能只盯调用上限,必须给任务中断留出降级通道。 配额隔离本质上是一种原生的容错熔断设计,避免了单一子代理的递归死循环拖垮整个产品交付体系。
03、OpenAI 的梯度调整:被抹平的大档溢价与速度落差
2026 年 10 月 6 日,OpenAI 针对 200 美元套餐进行了重大额度调整:各个模型档位可用的 token 数量直接减半,叠加 GPT-6.1 Sol 缓存输入价格下调的影响,Sol 级模型的 API 等价价值跌幅超过 50%。新购用户立即适用新规,仅允许降额前购买的老用户保留旧额度至 2026 年 10 月 29 日。
更值得开发者精算的是其定价阶梯的重构:
- 调价后,Pro 100、Pro 200 与新推出的 Pro 500 三个档位,每 1 美元换取的 token 数量完全一致。此前大额订阅用户享有的超额算力补贴梯度被彻底取消。
- 新推出的 500 美元新档位,其 Astra 额度仅比旧版 200 美元套餐高出约 21%,Sol 级等价价值不升反降,其溢价主要压注在号称 300 TPS 的 Ultrafast 模式。
在推理吞吐速度上,OpenAI Codex 负责人 Tibo 宣布开启「连续 28 天发布或重置」,首日宣称 GPT-6 系列默认提速 50% 达到 50 TPS。但从第三方与用户的连续 4 小时实测反馈来看,其实际速度仅维持在 35 TPS 左右,依然慢于 Claude 系列模型与 Gemini 3.8 Flash。
04、补贴倒挂的商业真相:一人公司的算力防守策略
商业竞争的本质是资源配置效率。SemiAnalysis 披露的数据揭示了一个惊人的事实:Anthropic 的高阶订阅目前仅占其总收入的约 10%,却消耗了超过 40% 的推理算力,导致每兆瓦混合收入减少约 3,600 万美元。
在 100% 使用率及 92% API 毛利率的极端测算假设下,用户若用满 Opus 5.5,对应的订阅毛利率甚至倒挂至 -369%;即便用满 Fable 5.1,毛利率也仅有 1% 左右。这意味着 Anthropic 当前正在用激进的资本补贴,换取一线开发者的工作流绑定。
做技术时我们习惯盯紧代码产出与系统实现,但做生意必须首先面对真实用户与经营结果。
作为自负盈亏的一人公司或小团队,追求技术情怀不等于无视商业红利。在现阶段的工程落地中,合理的策略不是被动等待,而是主动构建具备弹性的双通道路由架构。下面的 TypeScript 示例展示了一个精简的具备额度熔断降级的 Agent 执行器:
typescript
import { Anthropic } from '@anthropic-ai/sdk';
import OpenAI from 'openai';

type TaskPriority = 'flagship' | 'agent-loop';

interface ExecutionResult {
  content: string;
  provider: 'anthropic' | 'openai';
  cachedTokens: number;
}

export class ResilientAgentRouter {
  private claude = new Anthropic({ apiKey: process.env.ANTHROPIC_API_KEY });
  private openai = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

  async execute(prompt: string, priority: TaskPriority): Promise<ExecutionResult> {
    // 优先吃满 Claude 的激进补贴与 96.6% 缓存复用优势
    try {
      const model = priority === 'flagship' ? 'fable-5.1' : 'opus-5.5';
      const res = await this.claude.messages.create({
        model,
        max_tokens: 4096,
        messages: [{ role: 'user', content: prompt }],
      });
      return {
        content: res.content[0].type === 'text' ? res.content[0].text : '',
        provider: 'anthropic',
        cachedTokens: res.usage.input_tokens || 0,
      };
    } catch (error: any) {
      // 当 Claude 触发单模型 50% 额度硬限制或限速时,优雅降级到 OpenAI
      if (error?.status === 429 || error?.message?.includes('quota')) {
        const fallbackModel = priority === 'flagship' ? 'gpt-6-astra' : 'gpt-6.1-sol';
        const res = await this.openai.chat.completions.create({
          model: fallbackModel,
          messages: [{ role: 'user', content: prompt }],
        });
        return {
          content: res.choices[0]?.message?.content || '',
          provider: 'openai',
          cachedTokens: res.usage?.prompt_tokens_details?.cached_tokens || 0,
        };
      }
      throw error;
    }
  }
}
在具体工程落地中,还需要注意几个边界条件:SemiAnalysis 的测试指出不同第一方订阅账号存在静默 A/B 测试,部分账号可用额度存在约 20% 的浮动;同时尽量避开第三方封装平台,其综合性能与 Token 吞吐稳定性通常劣于第一方原生订阅。
05、总结与下一步
做独立开发快一年,我越来越坚信:经营上要保持轻量,对算力成本更要学会做减法。面对当前两家巨头的竞争格局,一人公司的算力底牌非常明确:主力 Agent 与重度代码上下文复用坚决押注 Claude 高阶订阅,榨取其极高的算力补贴价值;同时保留 OpenAI 通道作为超限熔断的容错后盾。
专栏里我会持续拆解这套双路由架构在海外 SaaS 项目持续集成(CI)中的真实压测数据。觉得这篇拆解对你的算力选型有帮助,欢迎点赞、收藏支持。你在实测中遇到了哪些额度坑?有更好的方案评论区交流。
👋 我是孟健,前腾讯 T11、前字节技术 Leader,现在全职做 AI 编程。
🔥 更多 AI 编程实战:
- GitHub:@mengjian-github
- 专栏:AI编程实战
觉得有用?点赞+收藏 就是最大支持 🙏
本文由作者借助 AI 辅助整理,内容经作者实测与审校。