GROUP BY 先别想当然,查汇总前把规则跑清楚
写查询条件、分页、JOIN、子查询时,结果错了通常还比较容易看出来。统计 SQL 不一样,它经常能正常执行,也能返回一张看起来很规整的表,但口径可能已经偏了。尤其是列表页里那些"订单数""总金额""最近下单时间""每个状态多少条",字段不多,却最容易在 count(*)、count(字段)、where、having 这些细节上出问题。
从 MySQL 切到金仓数据库 KingbaseES 后,GROUP BY 不能只凭旧习惯写。不是说语法本身难,而是统计类 SQL 一旦写错,接口返回的数据也许不会报错,只是悄悄变成另一个含义。比如用户没有订单时,left join 后 count(*) 到底是 0 还是 1;分组后想把订单号也查出来,数据库会不会接受;先过滤明细再分组,和分组后再筛选,结果是不是同一回事。
这次还是复用用户、订单、支付那组三张表。数据不复杂,但里面留了几处特意安排的数据:有人没有订单,订单表里也有一个用户表不存在的 user_id = 6。用这组数据跑分组统计,足够把常见口径问题暴露出来。
先把环境和底表定住
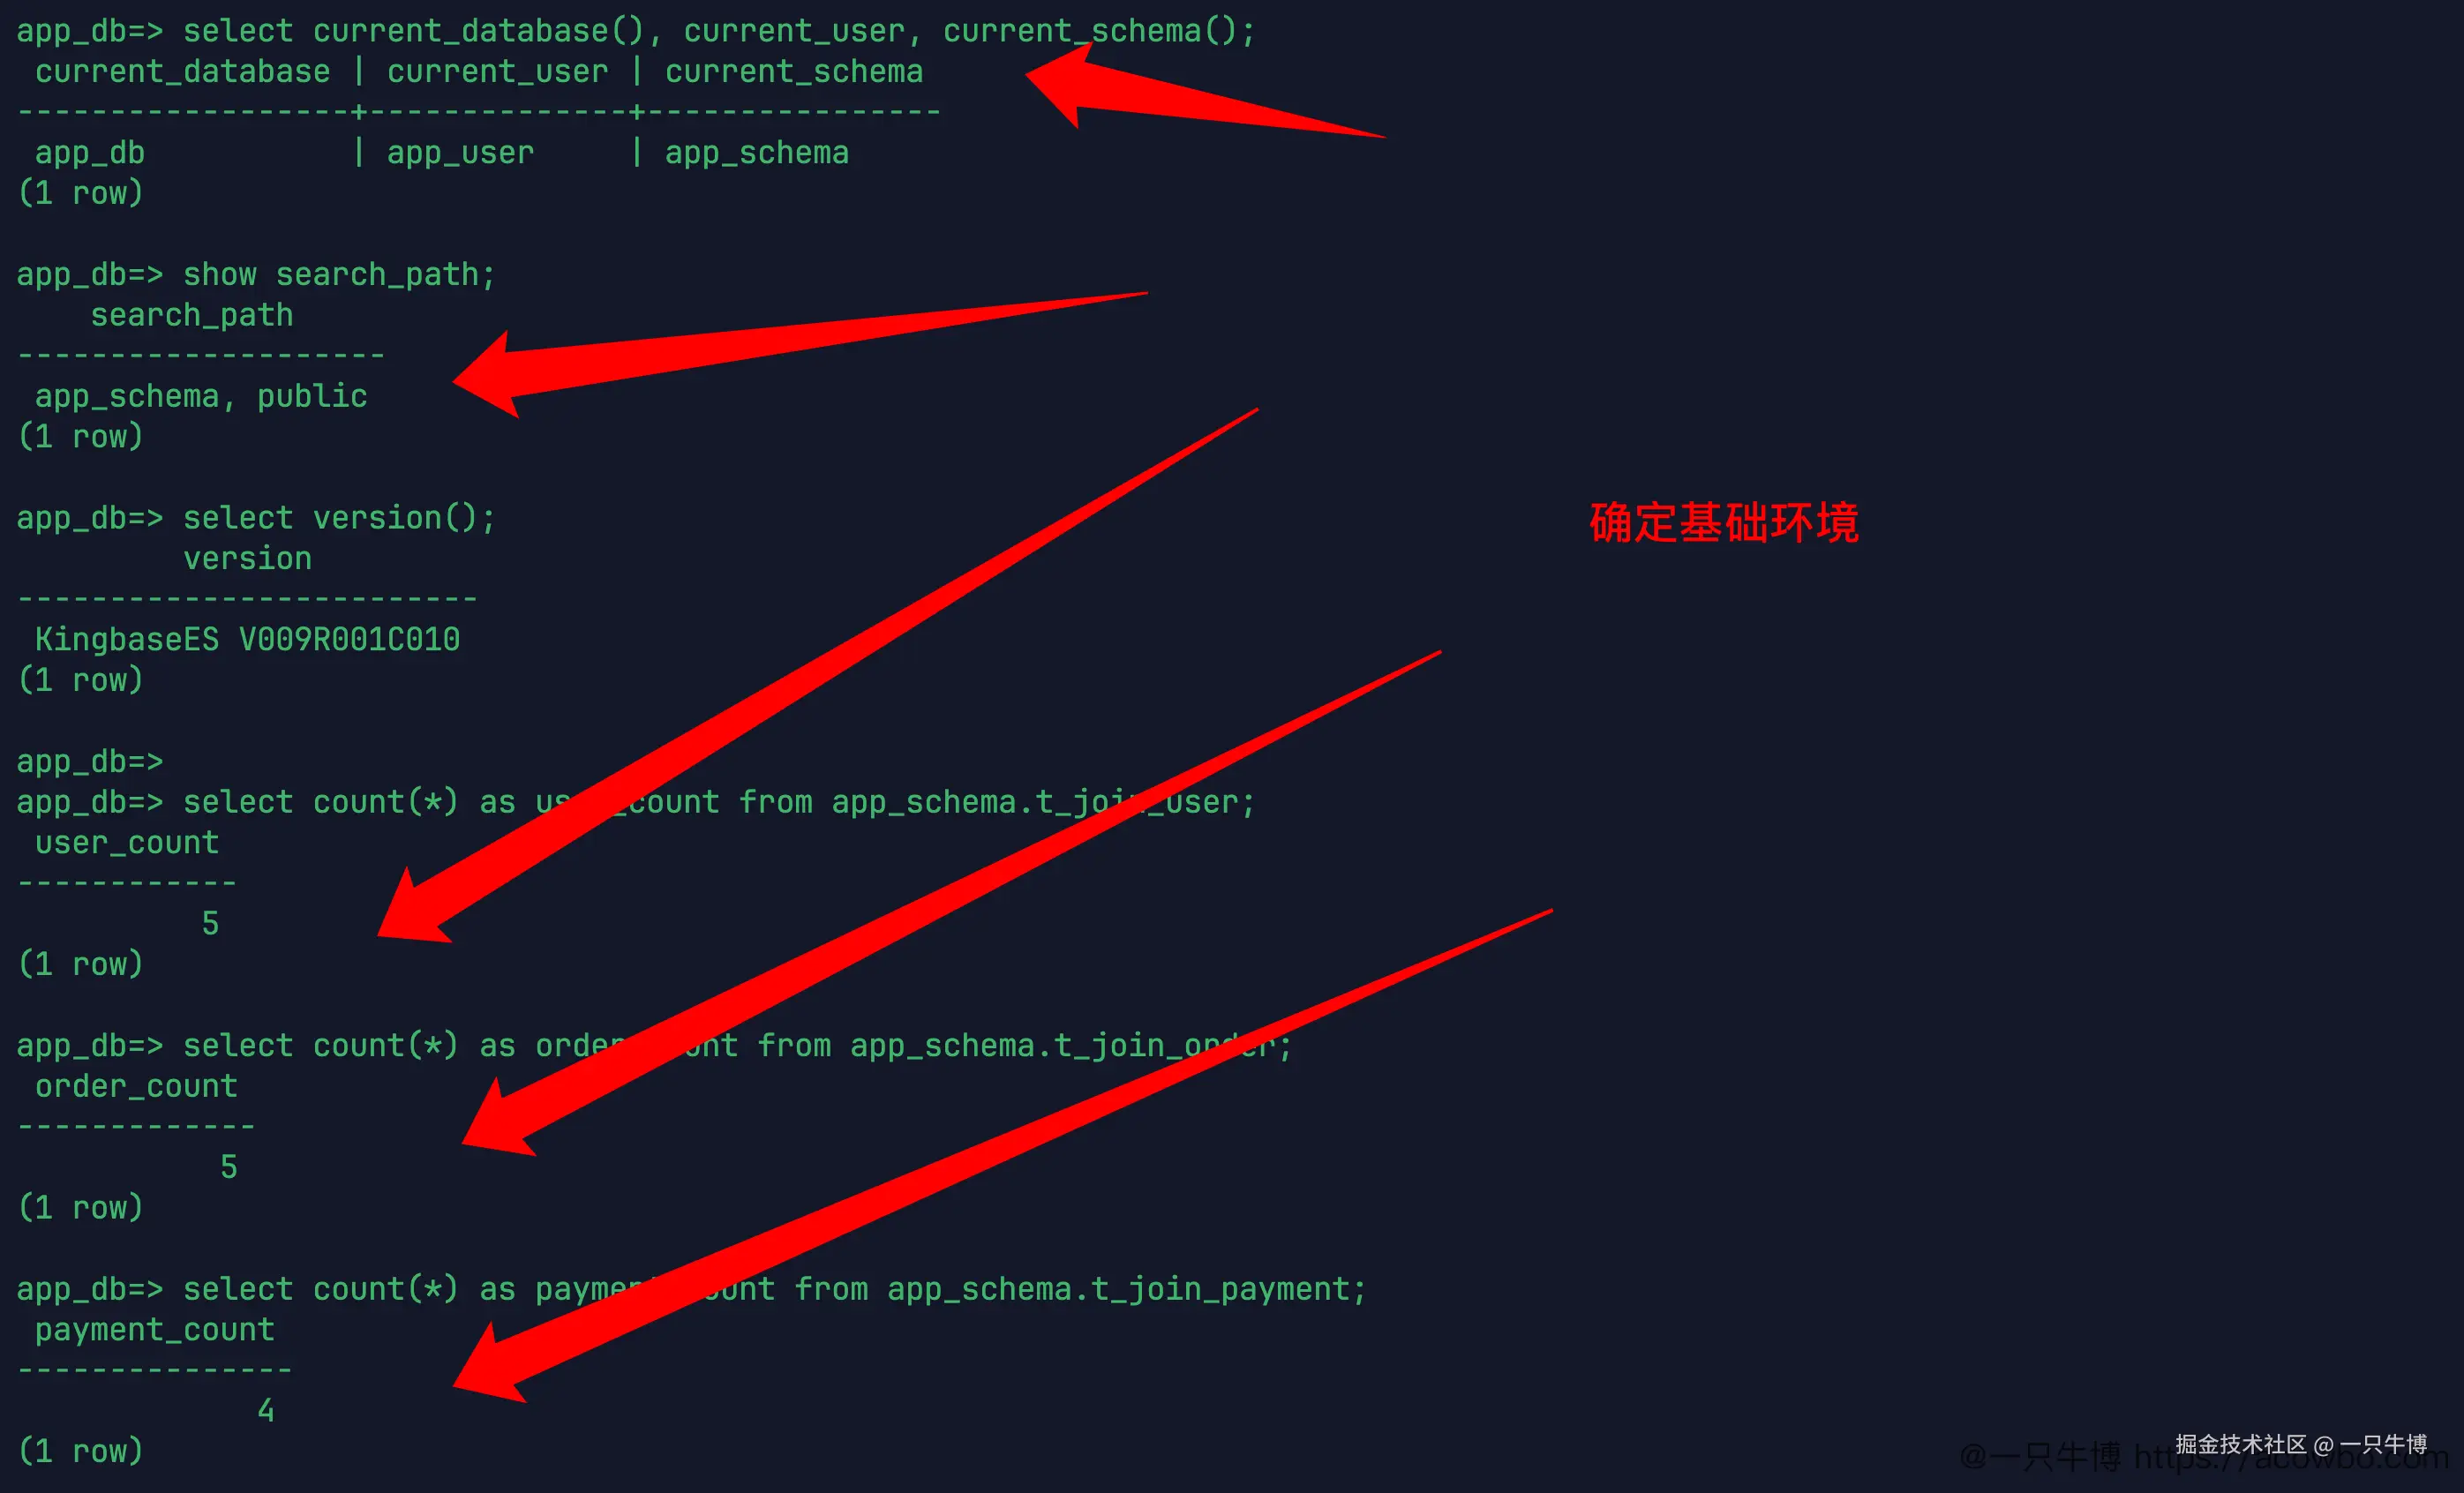
当前连接在 app_db,用户是 app_user,默认 schema 是 app_schema。版本信息返回的是 KingbaseES V009R001C010。继续确认三张表的数据量:用户表 5 行,订单表 5 行,支付表 4 行。
统计 SQL 最怕底表不清楚。后面所有结果都建立在这 5 笔订单上:
text
101:user_id = 1,paid,金额 199
102:user_id = 1,created,金额 59
103:user_id = 2,paid,金额 399
104:user_id = 3,closed,金额 88
105:user_id = 6,paid,金额 128
其中 user_id = 6 在用户表里没有对应用户。这条数据不是业务建模建议,只是为了看不同查询从哪张表出发时,结果会不会把它带出来。
先按订单状态分组
最普通的分组从订单状态开始。先看订单明细,再按 order_status 聚合:
sql
select
  order_status,
  count(*) as order_count,
  sum(amount) as total_amount,
  min(amount) as min_amount,
  max(amount) as max_amount,
  avg(amount) as avg_amount
from app_schema.t_join_order
group by order_status
order by order_status;
结果分成 3 组:closed、created、paid。
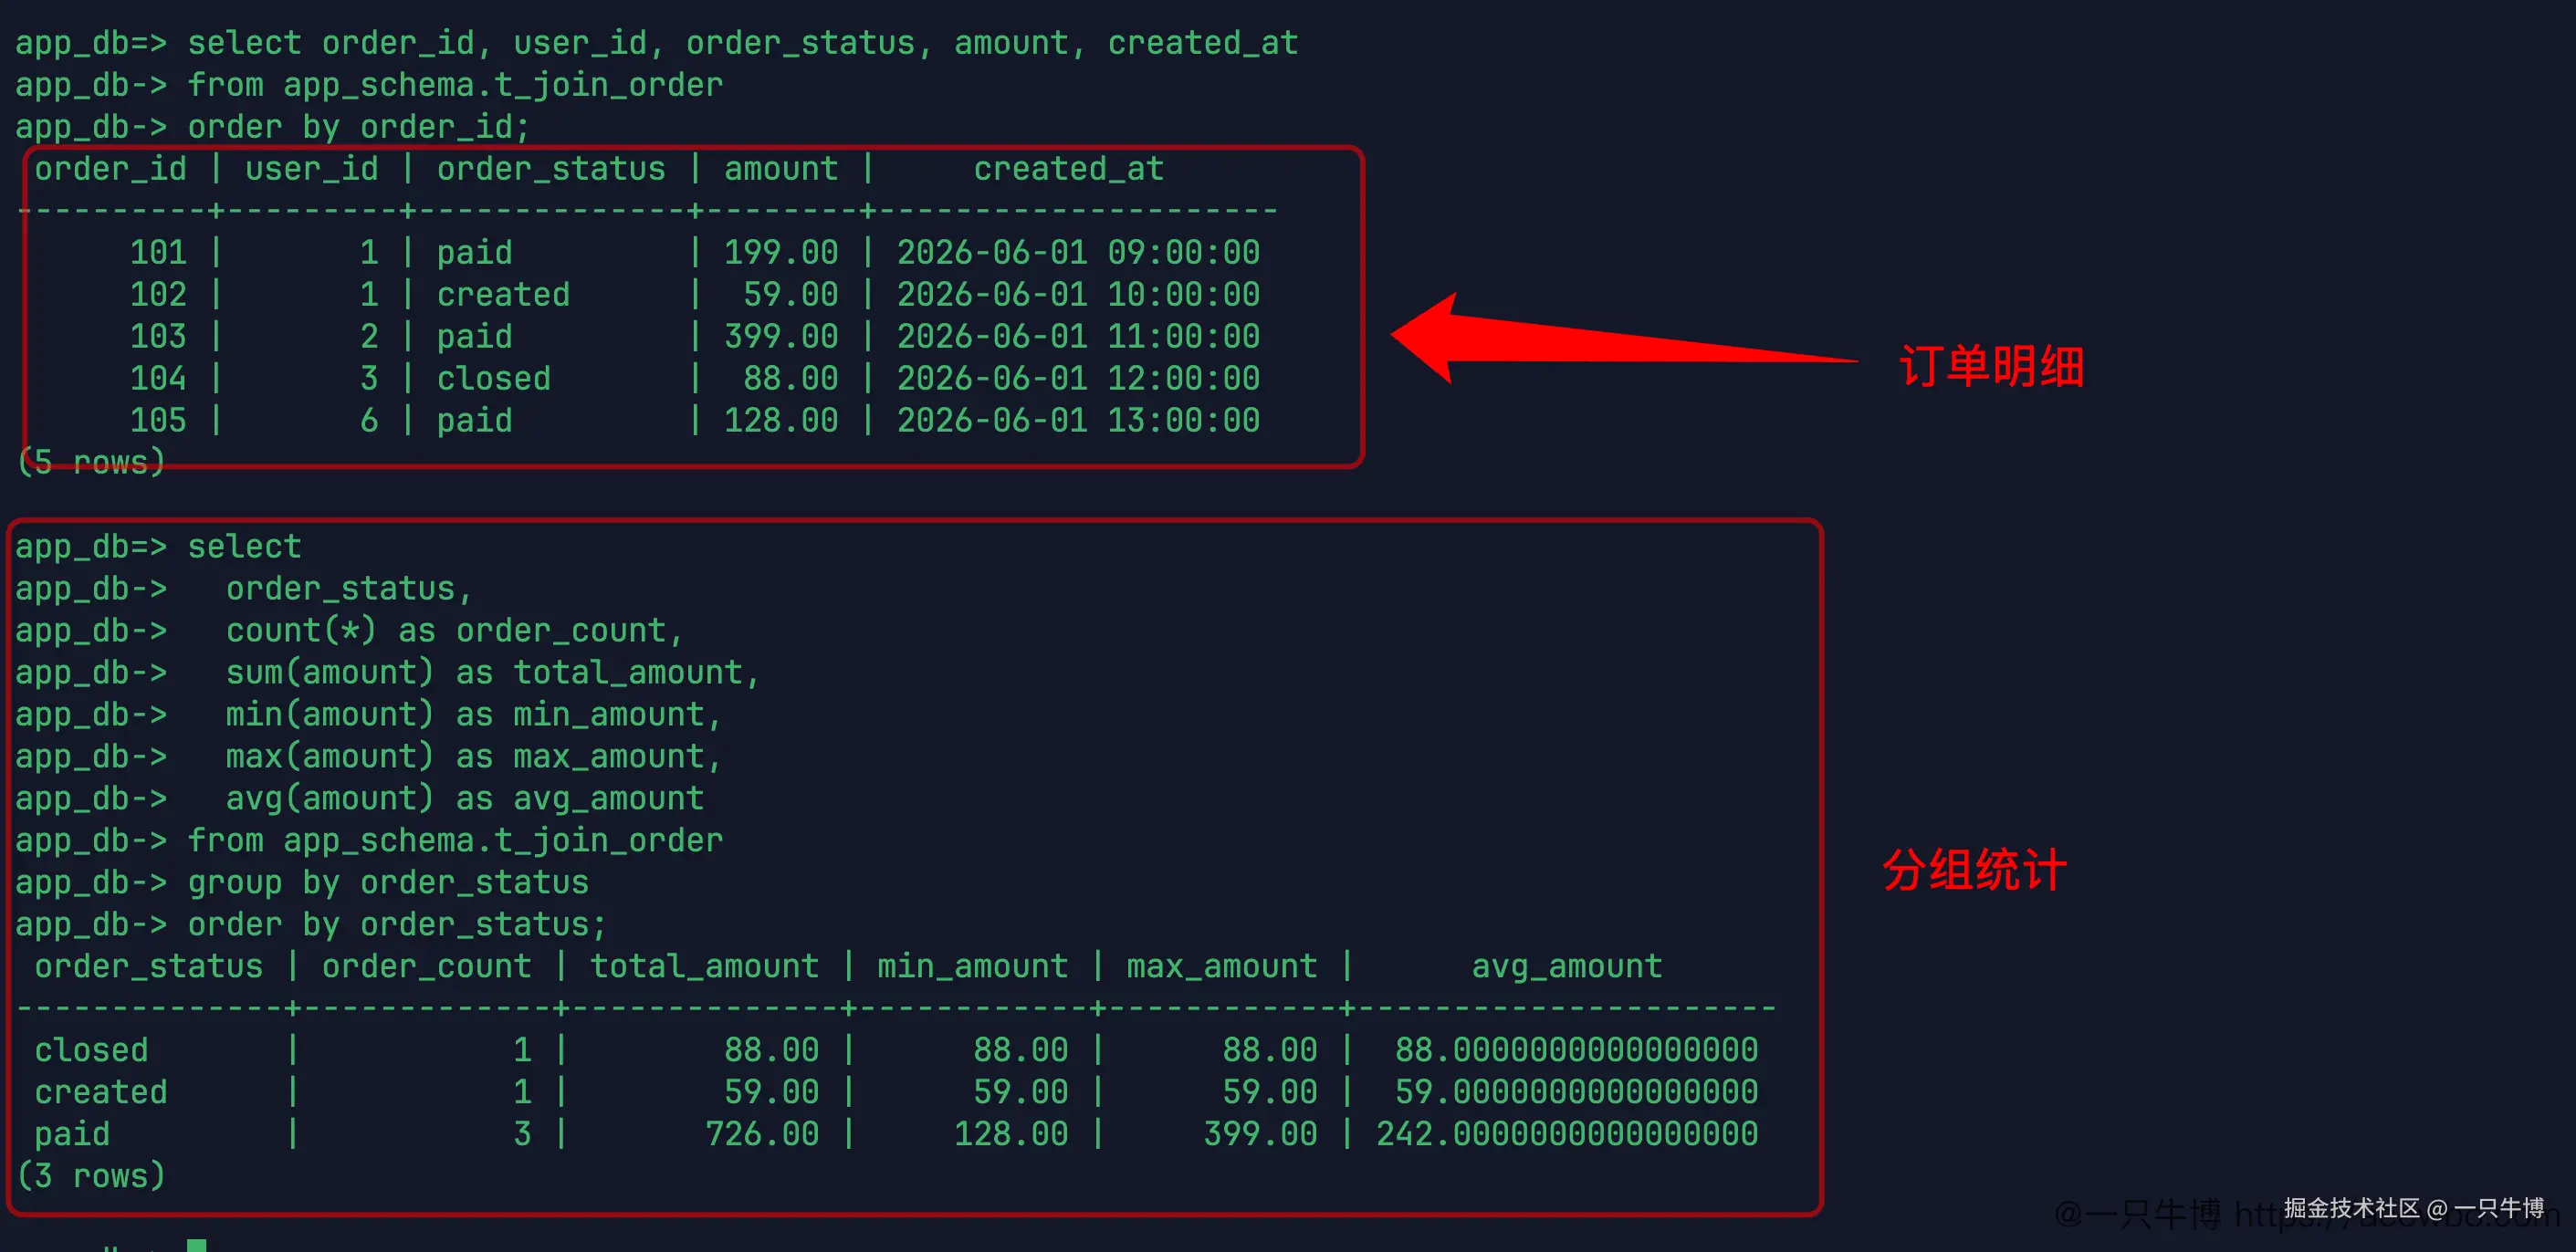
这里的 paid 有 3 笔,金额分别是 199、399、128,所以总金额是 726,最小金额 128,最大金额 399,平均金额 242。created 和 closed 各 1 笔,聚合结果就和单行金额一致。
这一步很基础,但它把 GROUP BY 的结果形状说明白了:分组字段相同的多行会被压成一行,聚合函数在这一组内部计算。sum(amount) 不是全表金额,avg(amount) 也不是所有订单平均值,而是每个订单状态各算一次。
如果接口要展示"每个订单状态的订单数和金额",这类写法够直接。此时不用 JOIN,也不用子查询,因为统计对象就在订单表本身。
还有一个小细节:分组字段不是排序标签,而是统计粒度。order by order_status 只是让结果看起来稳定,真正决定返回几行的是 group by order_status。如果后面把 created_at 也放进分组字段,结果就会变成"每个状态 + 每个时间"一行,统计粒度马上被拆细。
LEFT JOIN 之后,count(*) 很容易误导
真正容易写错的是用户列表统计。用户表左连接订单表后,每个用户都要保留,即使没有订单也要出现在结果里。这个时候同时查 count(*)、count(o.order_id) 和 count(distinct o.order_id),差异就出来了:
sql
select
  u.user_id,
  u.user_name,
  count(*) as join_row_count,
  count(o.order_id) as order_count,
  count(distinct o.order_id) as distinct_order_count,
  coalesce(sum(o.amount), 0) as total_amount
from app_schema.t_join_user u
left join app_schema.t_join_order o
  on o.user_id = u.user_id
group by u.user_id, u.user_name
order by u.user_id;
alice 有两笔订单,三个计数都是 2,这没问题。bob 和 cindy 各有一笔订单,计数都是 1。到了 david、eric,差异变得很明显:join_row_count 是 1,order_count 是 0。
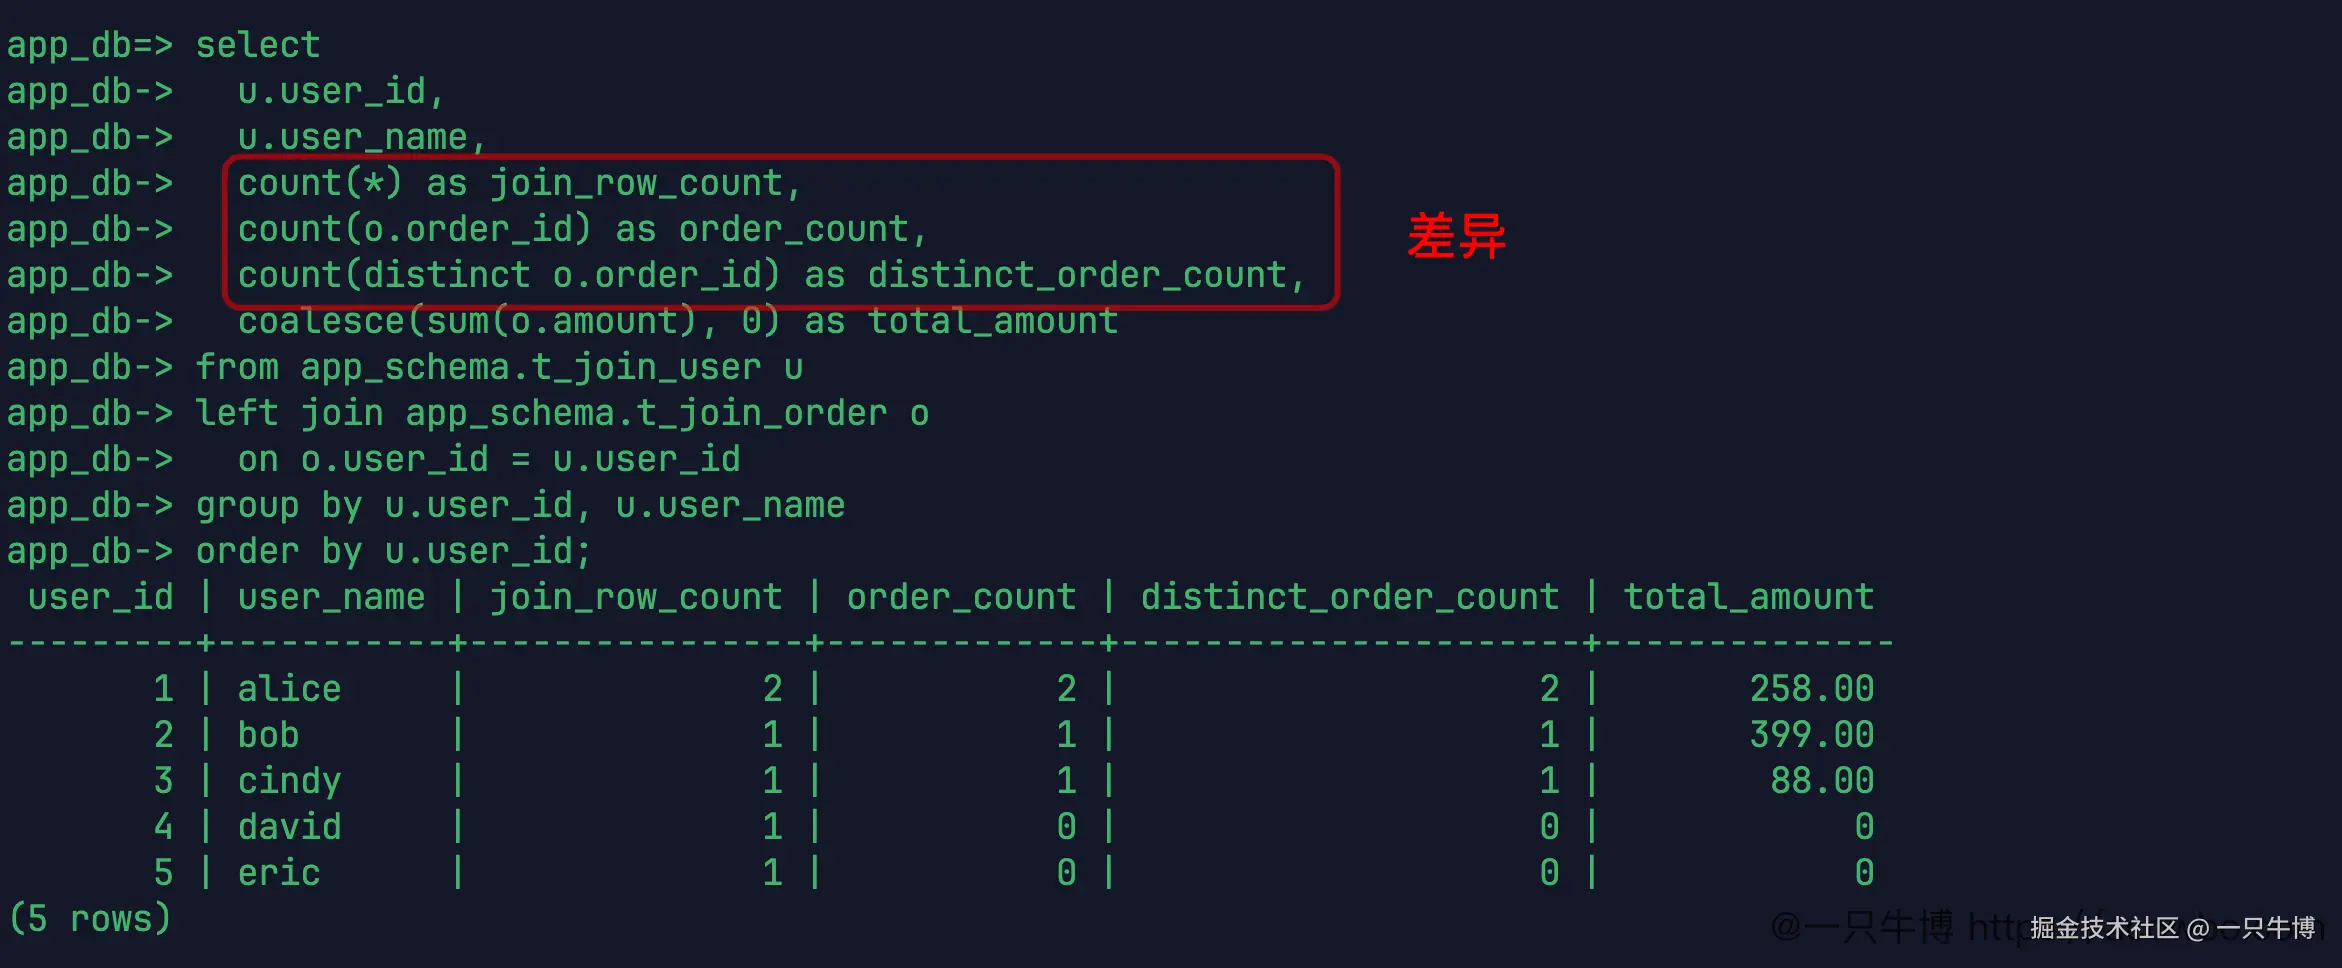
原因在 left join 的结果形状上。没有订单的用户不会被丢掉,右表字段会补空值,但这一行用户仍然存在。count(*) 数的是 JOIN 之后的结果行,所以它看到 david 这一行,就会计为 1。count(o.order_id) 只统计订单表里非空的订单号,右表没有匹配时就是 0。
这类 SQL 在接口里非常常见。如果要统计"用户有多少笔订单",应该数订单表字段,不能直接数 count(*)。count(*) 没有错,它只是回答了另一个问题:JOIN 之后这个用户占了几行。
count(distinct o.order_id) 在当前数据里和 count(o.order_id) 一样,因为订单号没有重复。后面如果 JOIN 到支付、明细、标签这类一对多表,订单行可能被放大,distinct 的意义就会更明显。
比如订单再关联支付流水,如果一笔订单有两次支付尝试,订单行就可能被展开成两行。那时 count(o.order_id) 会把同一笔订单数两次,count(distinct o.order_id) 才能回到"订单数"这个口径。统计 SQL 不能只看当前能不能跑,还要看后面会不会继续 JOIN 到更细的表。
用户列表统计,要把空值处理清楚
继续按用户汇总,字段换成更像接口返回的内容:订单数、总金额、最大订单金额、最后下单时间。
sql
select
  u.user_id,
  u.user_name,
  count(o.order_id) as order_count,
  coalesce(sum(o.amount), 0) as total_amount,
  max(o.amount) as max_amount,
  max(o.created_at) as latest_order_time
from app_schema.t_join_user u
left join app_schema.t_join_order o
  on o.user_id = u.user_id
group by u.user_id, u.user_name
order by u.user_id;
alice 的订单数是 2,总金额 258,最大金额 199,最后下单时间是 2026-06-01 10:00:00。bob 是 399,cindy 是 88。david 和 eric 没有订单,订单数是 0,总金额也显示为 0。
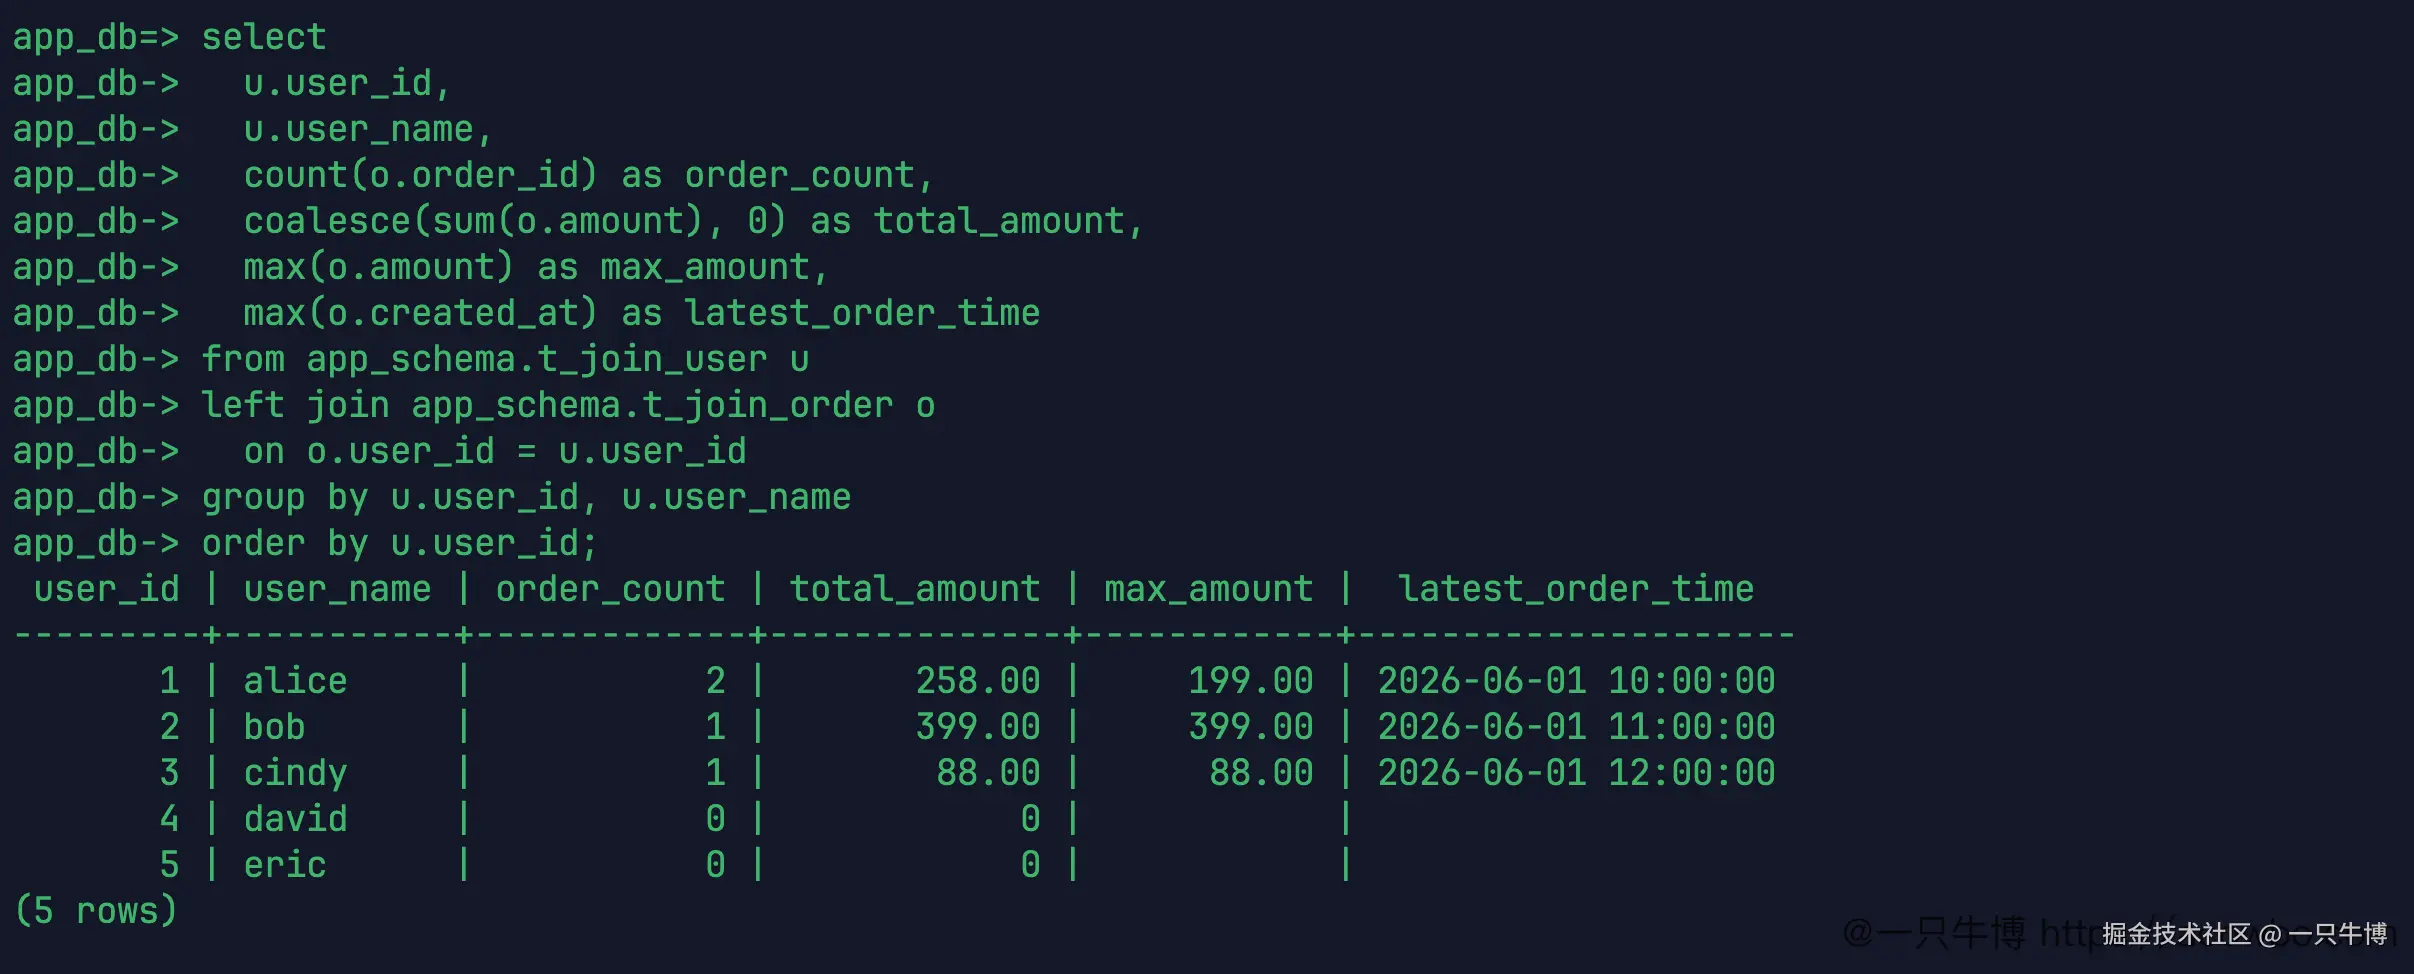
这里有两个不同的空值处理。sum(o.amount) 在没有匹配订单时会返回空值,所以外层用了 coalesce(sum(o.amount), 0),把它转成 0。max(o.amount) 和 max(o.created_at) 没有做转换,因为没有订单时,最大金额和最后下单时间本来就不存在,保留为空更自然。
这也说明,聚合字段不能一律套 coalesce。金额汇总没有订单时显示 0,通常说得通;最后下单时间没有订单时硬塞一个默认时间,反而容易误导业务侧。
WHERE 先过滤明细,再进入分组
只统计已支付订单时,where 发生在分组之前:
sql
select
  o.order_status,
  count(*) as order_count,
  sum(o.amount) as total_amount
from app_schema.t_join_order o
where o.order_status = 'paid'
group by o.order_status;
结果只有 paid 一组,订单数 3,总金额 726。
再按 user_id 统计已支付订单:
sql
select
  o.user_id,
  count(*) as paid_order_count,
  sum(o.amount) as paid_amount
from app_schema.t_join_order o
where o.order_status = 'paid'
group by o.user_id
order by o.user_id;
结果里出现了 user_id = 6。
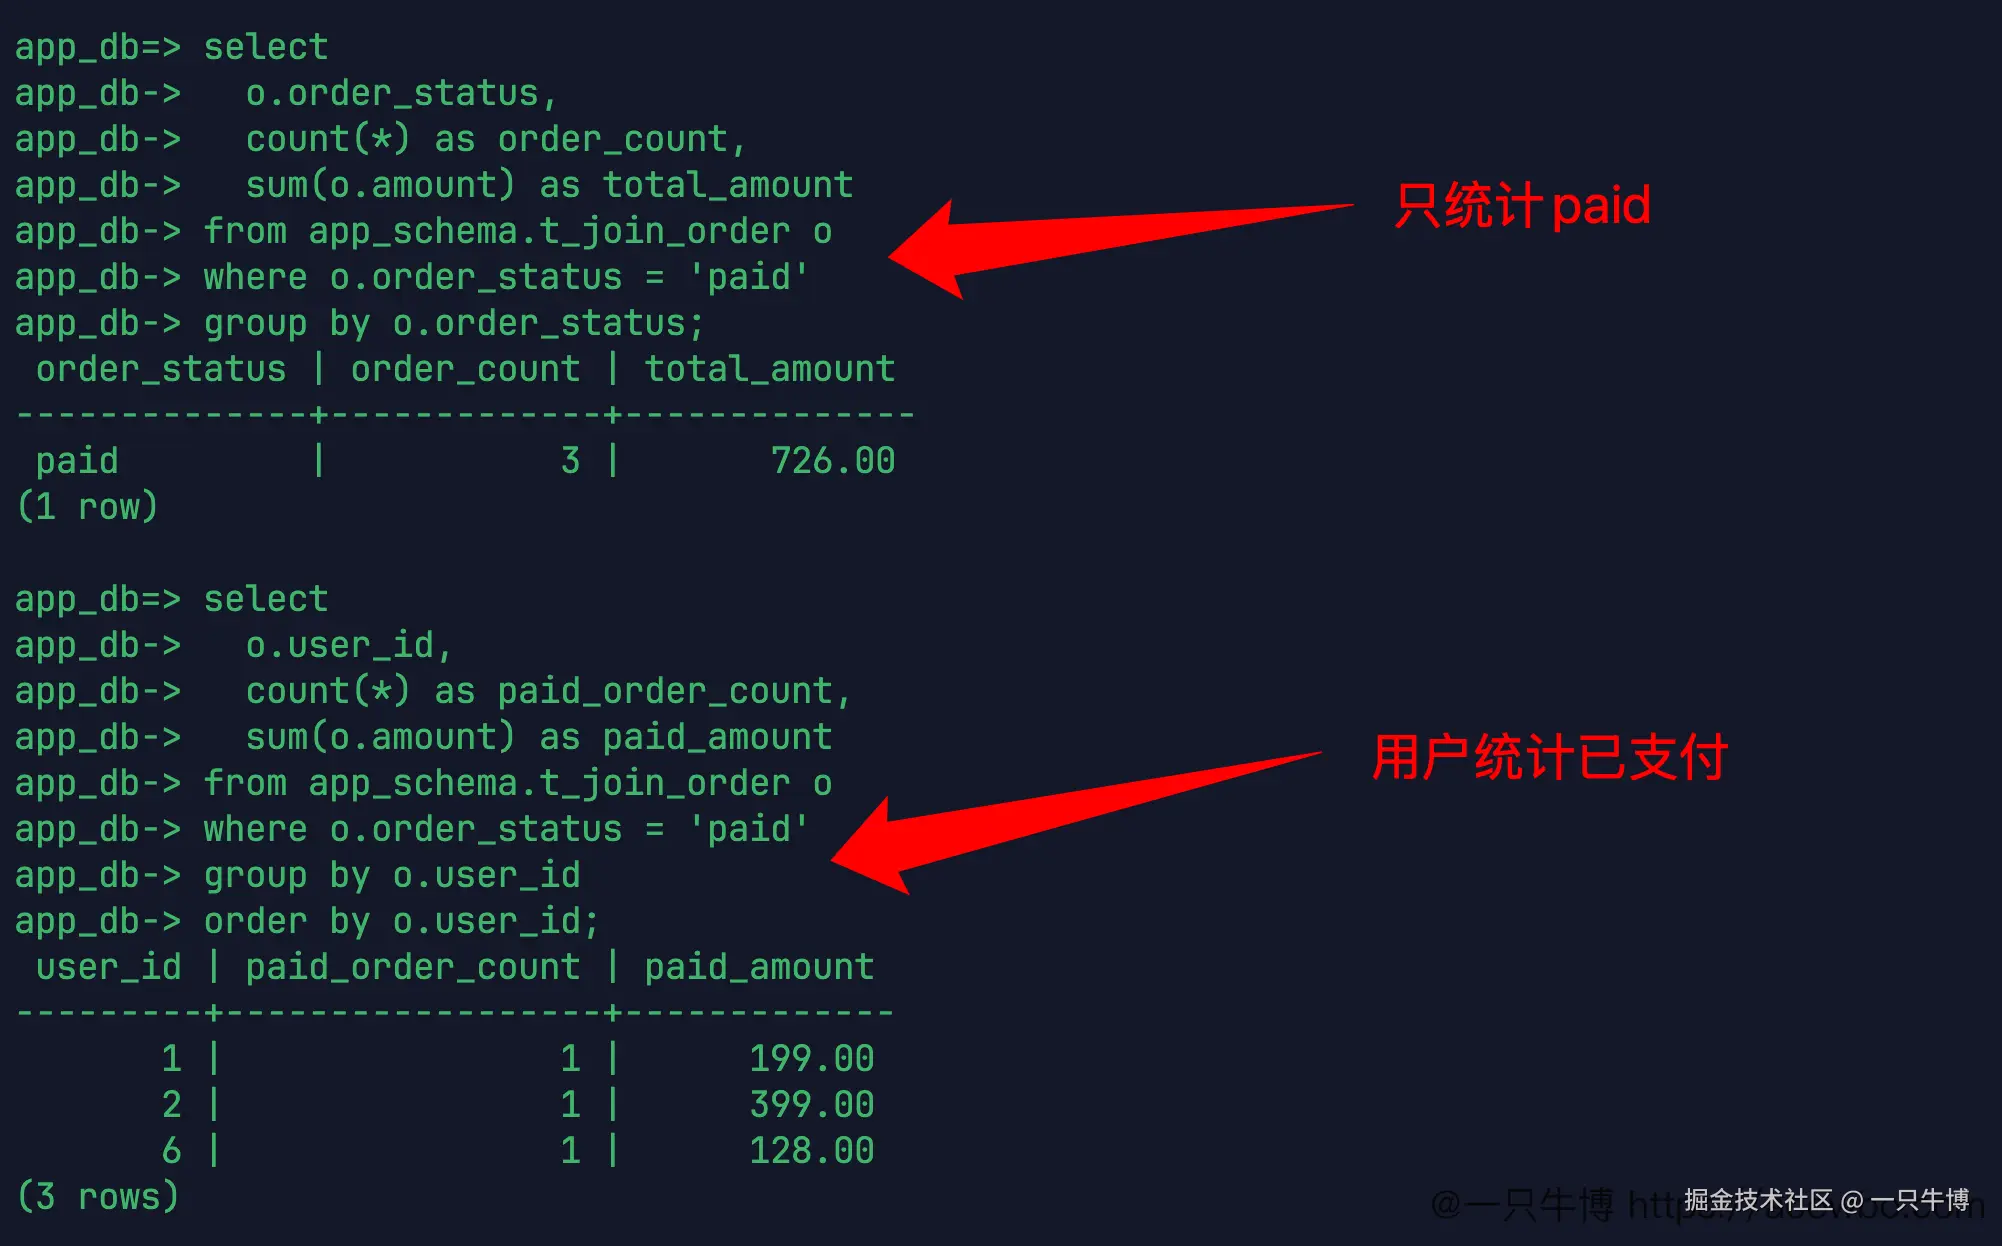
这不是 KingbaseES 多查了一行,也不是权限或数据质量配置导致的结果。SQL 从订单表出发,订单表里确实有一条 user_id = 6 且状态为 paid 的记录。where 先把 paid 明细筛出来,再按 user_id 分组,6 自然会进入统计结果。
如果需求是"统计用户表里存在的用户的已支付订单",就不能只从订单表出发,需要回到用户表做 JOIN。统计 SQL 的出发点很重要:从订单表统计,会看到订单表自己的全部事实;从用户表左连接订单表统计,结果会受用户表边界约束。
HAVING 筛的是聚合后的结果
where 处理明细行,having 处理分组后的结果。比如查订单数大于 1 的用户:
sql
select
  u.user_id,
  u.user_name,
  count(o.order_id) as order_count,
  coalesce(sum(o.amount), 0) as total_amount
from app_schema.t_join_user u
left join app_schema.t_join_order o
  on o.user_id = u.user_id
group by u.user_id, u.user_name
having count(o.order_id) > 1
order by u.user_id;
当前只有 alice 有两笔订单,所以只返回 alice。
再查总金额大于等于 200 的用户:
sql
select
  u.user_id,
  u.user_name,
  count(o.order_id) as order_count,
  coalesce(sum(o.amount), 0) as total_amount
from app_schema.t_join_user u
left join app_schema.t_join_order o
  on o.user_id = u.user_id
group by u.user_id, u.user_name
having coalesce(sum(o.amount), 0) >= 200
order by total_amount desc;
结果返回 bob 和 alice,并按总金额倒序排列。
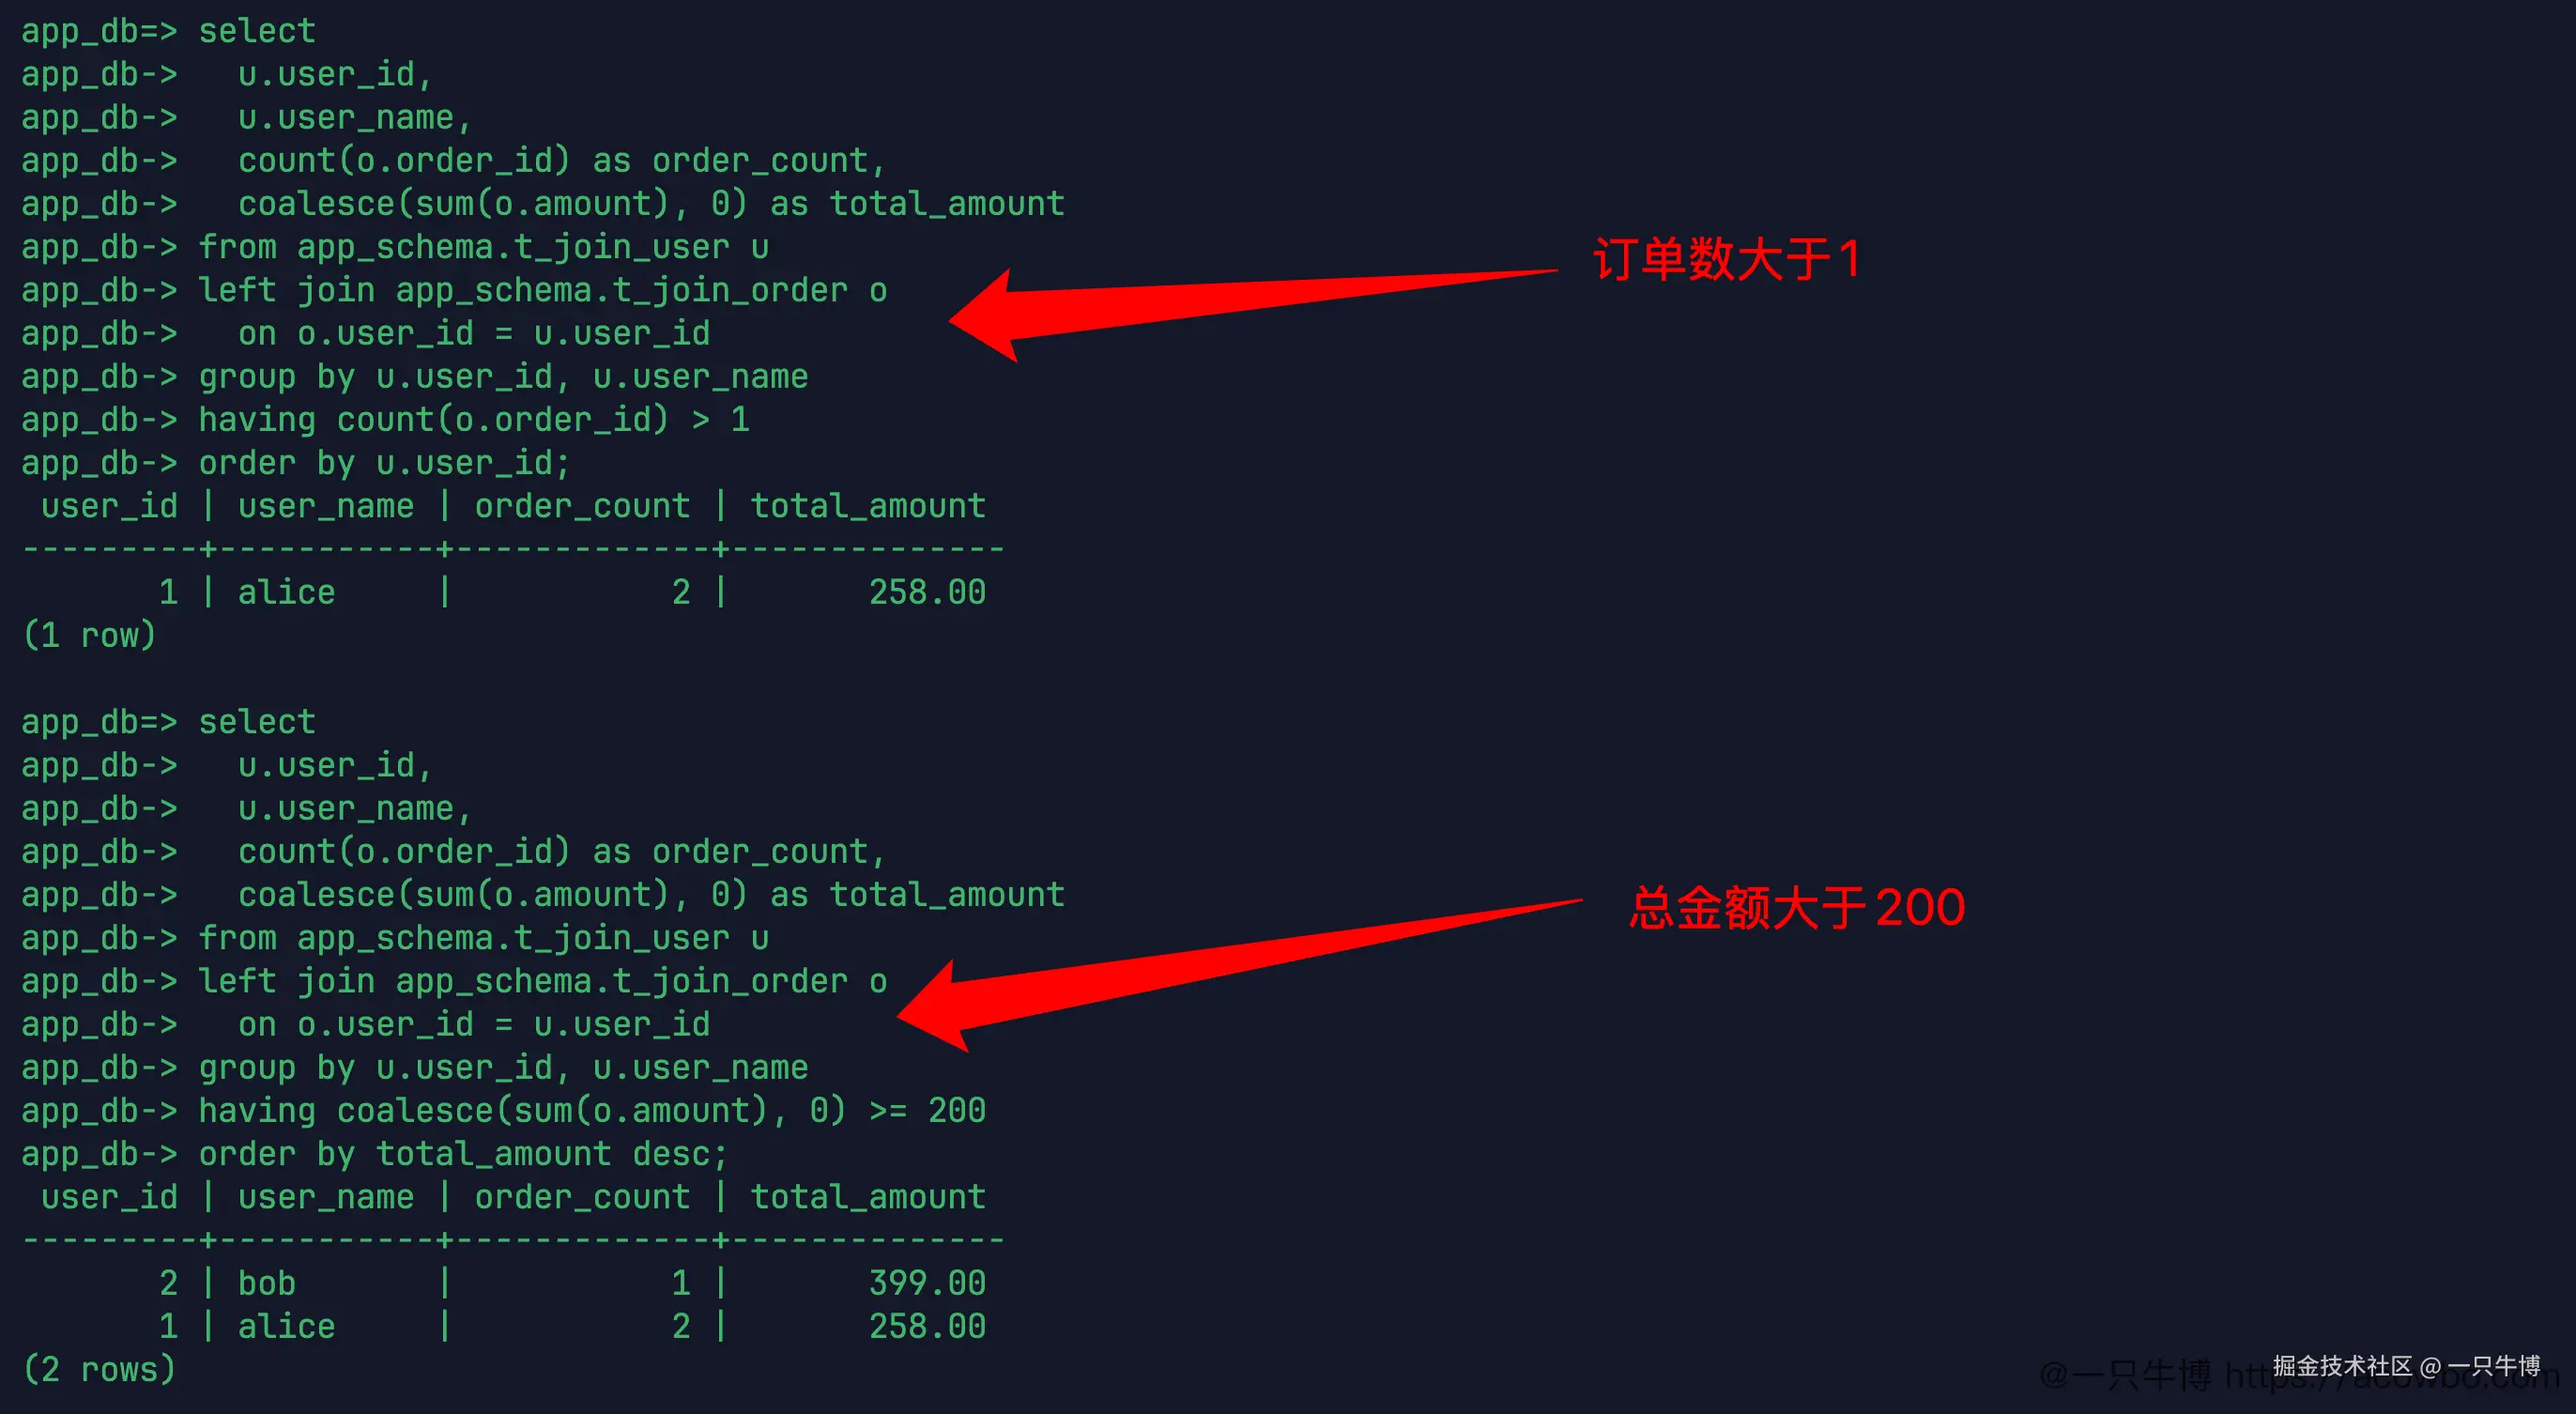
having count(o.order_id) > 1 里的 count 已经是分组后的订单数。它不能提前放进 where,因为 where 执行时还没有分组结果。这个顺序写错,通常不是结果偏一点,而是 SQL 直接不成立。
这也是很多统计 SQL 的分界线:筛明细条件,用 where;筛统计结果,用 having。订单状态、创建时间、城市这类明细字段通常放在 where;订单数大于多少、总金额超过多少、最大金额是否达标,这类聚合结果放在 having。
两者也可以同时出现。比如只统计 paid 订单,再筛总金额超过 200 的用户,where o.order_status = 'paid' 负责先缩小明细范围,having sum(o.amount) >= 200 负责筛聚合后的用户。把这两步混在一起,SQL 不是读起来别扭,就是结果口径变了。
多字段分组会改变统计粒度
单字段分组看的是一个维度,多字段分组看的是多个维度组合。按城市和订单状态统计:
sql
select
  u.city,
  o.order_status,
  count(o.order_id) as order_count,
  coalesce(sum(o.amount), 0) as total_amount
from app_schema.t_join_user u
left join app_schema.t_join_order o
  on o.user_id = u.user_id
group by u.city, o.order_status
order by u.city, o.order_status;
结果里 beijing 出现两行:一行是 created,一行是 paid。因为 alice 在北京,她有两笔不同状态的订单。hangzhou 是 closed,shanghai 是 paid。chengdu 和 shenzhen 没有订单,order_status 为空,订单数是 0。
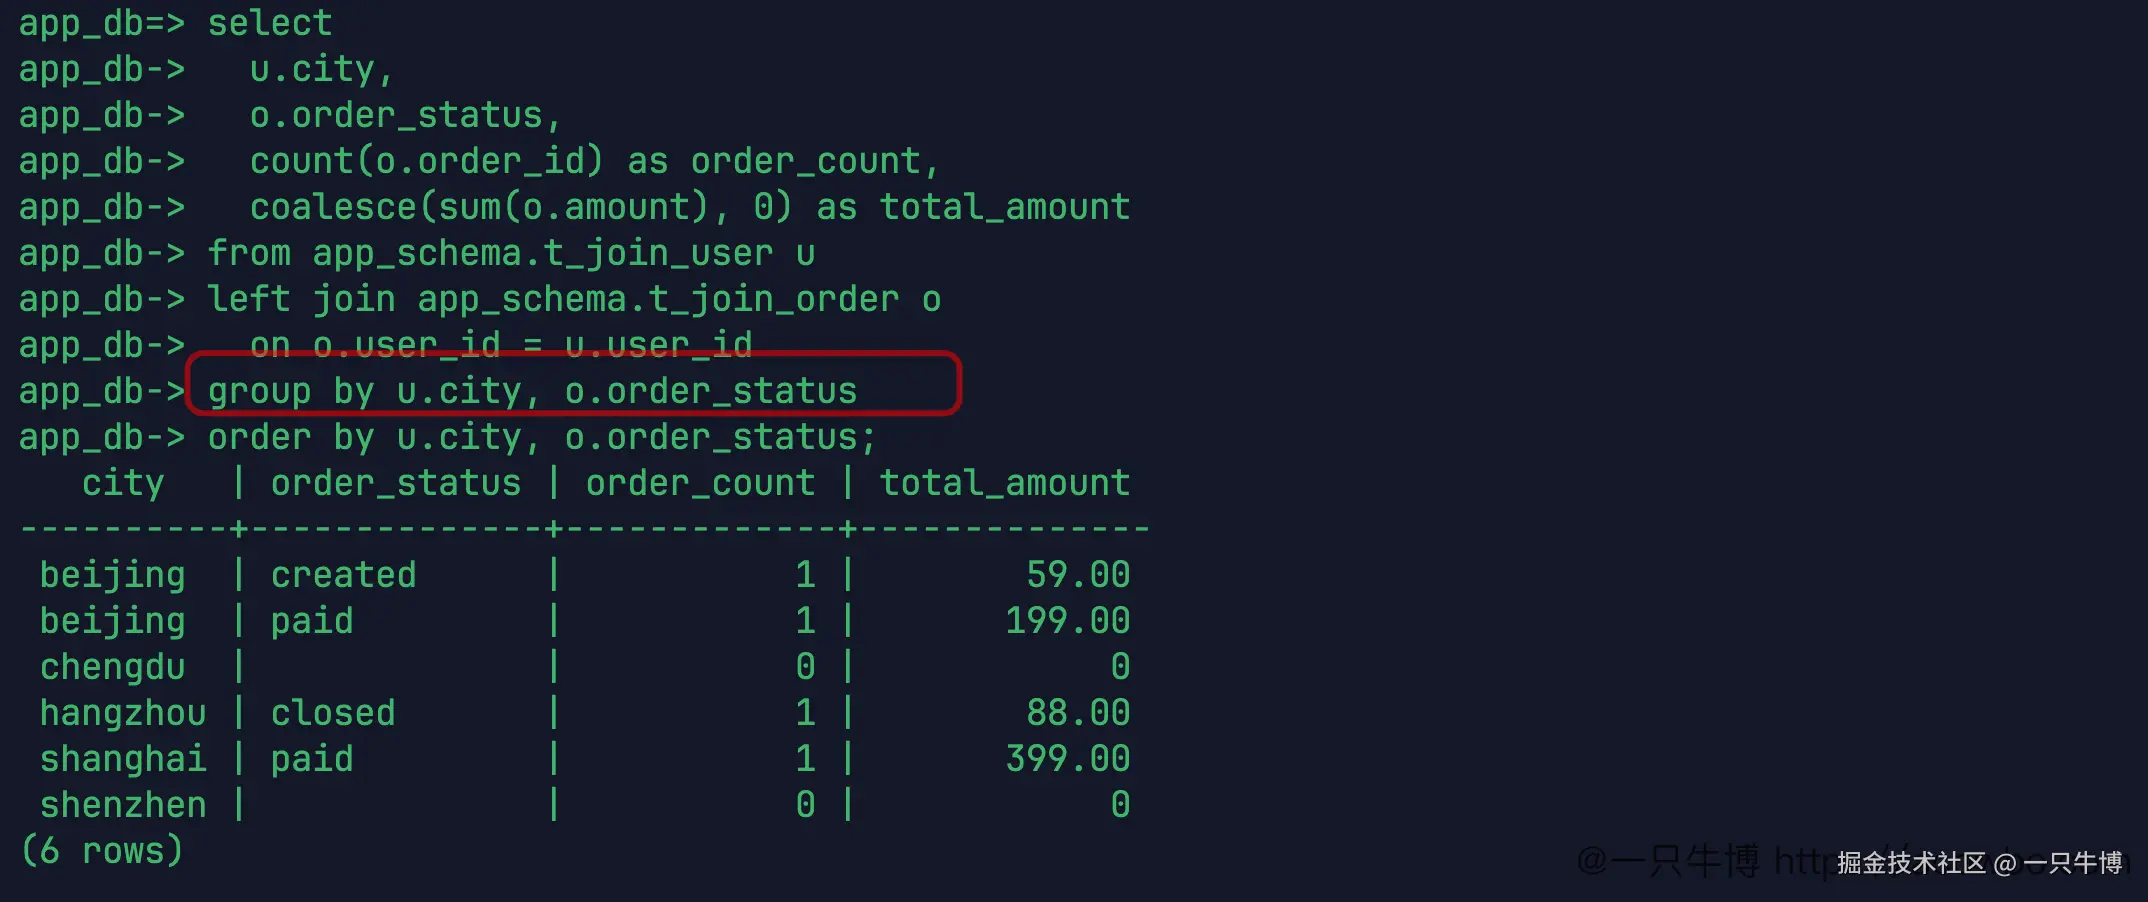
这类结果容易被误读。它不是"每个城市一行",而是"每个城市 + 每个订单状态一行"。分组字段多一个,粒度就细一层。前端如果只想要城市维度统计,就不要把 order_status 放进 group by;如果要城市下再拆状态,那现在这种写法才是对的。
没有订单的用户被保留下来,是因为 SQL 从用户表出发,并且用了 left join。右表没有匹配订单时,o.order_status 为空,count(o.order_id) 是 0。这个结果和前面 count(*) 的差异是一套逻辑。
非分组字段不能随手放进 SELECT
从旧项目迁移 SQL 时,可能会碰到一种写法:按状态分组,同时把订单号也查出来。
sql
select
  order_status,
  order_no,
  count(*) as order_count
from app_schema.t_join_order
group by order_status;
在当前 KingbaseES 环境里,这条 SQL 直接报错:
text
ERROR: column "t_join_order.order_no" must appear in the GROUP BY clause or be used in an aggregate function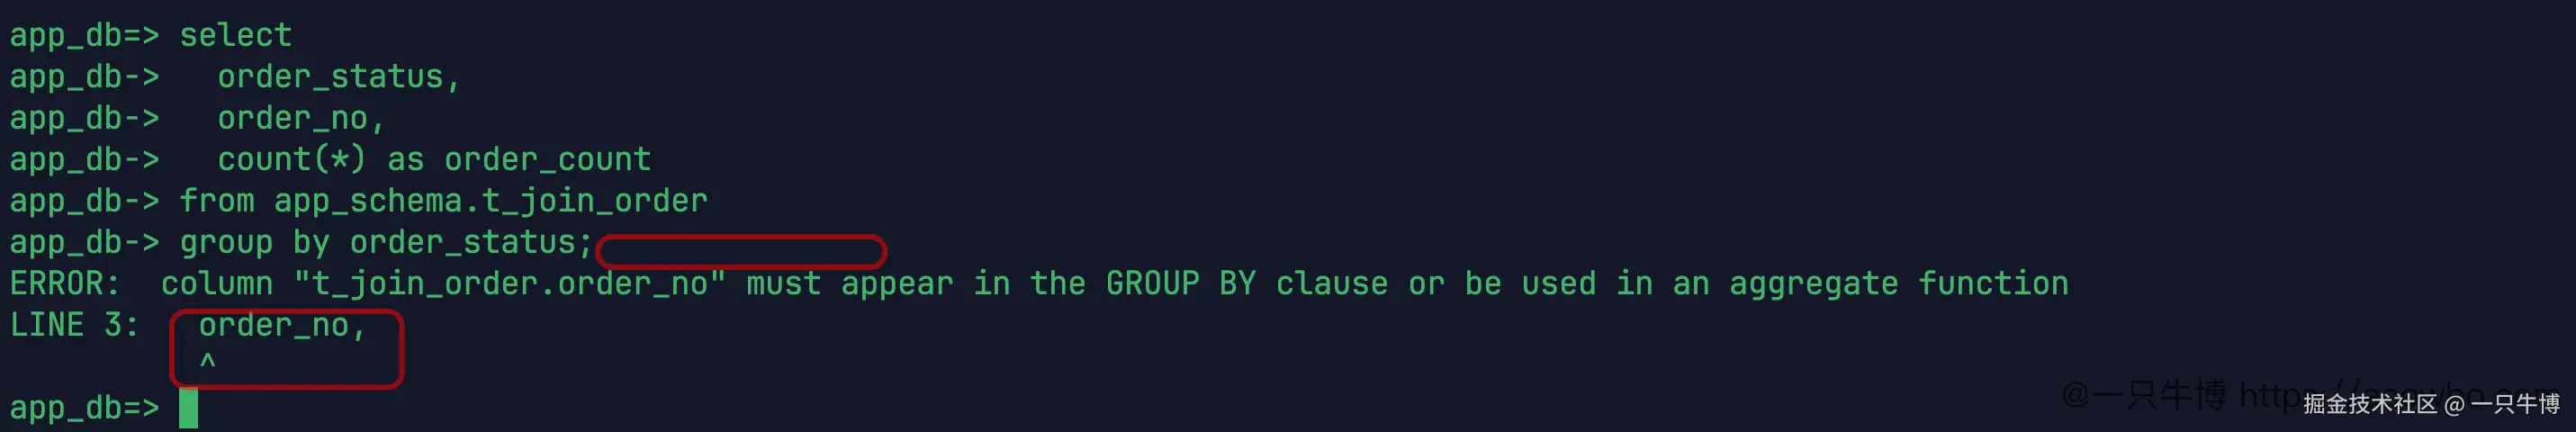
这个错误很有价值。按 order_status 分组后,paid 这一组里有 3 个订单号:KO-202606-001、KO-202606-003、KO-202606-005。如果 select 里直接写 order_no,数据库没法知道这 3 个订单号应该返回哪一个。
有些旧 MySQL 环境里可能见过类似 SQL 能跑出结果,但那种结果不适合作为统计口径。分组查询里,非聚合字段要么进入 group by,成为分组维度;要么交给聚合函数,明确取值规则。否则就是把一个多值问题硬塞成单值。
这个报错反而是好事。它逼着 SQL 把问题讲清楚:到底是要"按状态统计",还是要"按状态和订单号一起统计";到底要每组任意订单号,还是要最早、最晚、最大金额对应的那一笔。前者只是碰巧能返回,后者才是可以维护的统计口径。
想拿代表值,就把规则写出来
如果确实需要每个状态带一个订单号,先想清楚这个订单号代表什么。比如拿最小订单号、最后下单时间和总金额,可以这样写:
sql
select
  order_status,
  count(*) as order_count,
  min(order_no) as first_order_no,
  max(created_at) as latest_order_time,
  sum(amount) as total_amount
from app_schema.t_join_order
group by order_status
order by order_status;
结果里每个状态仍然只返回一行,但 first_order_no 来自 min(order_no),latest_order_time 来自 max(created_at),规则是明确的。
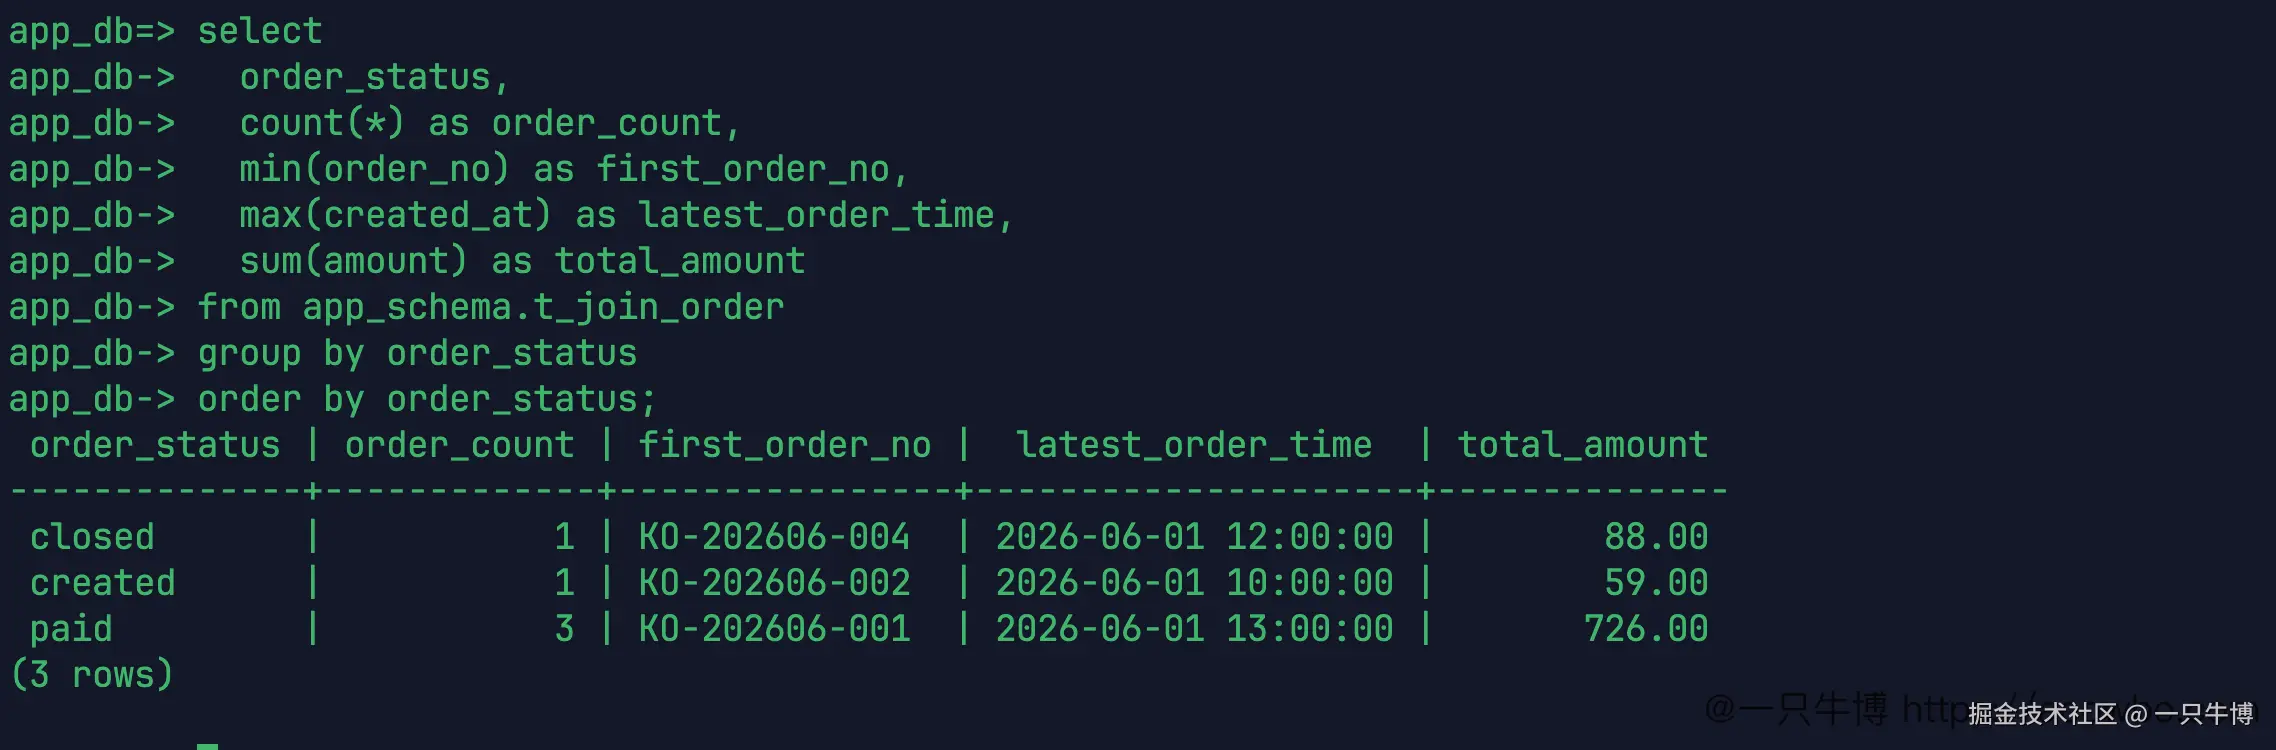
paid 这一组有 3 笔订单,first_order_no 是 KO-202606-001,最后下单时间是 2026-06-01 13:00:00,总金额 726。这个结果能解释清楚,因为每个字段都有自己的聚合规则。
不过这里也要分清需求。如果真正要的是"每个状态下最新的一整行订单",只拿 max(created_at) 还不够。因为订单号、金额、时间要来自同一行,不能分别用几个聚合函数拼出一条看似完整的记录。那类需求更适合单独看窗口函数或者先求最新时间再回表关联。
这里的 min(order_no) 只是一个明确规则,不代表业务上一定要最小订单号。真实项目里更常见的是"最新一笔订单""金额最高的一笔订单""最后一次成功支付"。这些都不是单纯把字段塞进 select 能解决的,要么补排序规则,要么换成能保留整行关系的写法。
统计 SQL 先把三个问题说清楚
GROUP BY 写起来不长,真正麻烦的是口径。按订单状态统计,和按用户统计,是两种粒度;从订单表出发,和从用户表左连接订单表出发,边界也不一样;count(*)、count(o.order_id)、count(distinct o.order_id) 看起来都在数,数的东西却不同。
在 KingbaseES 里跑完这几组结果后,写分组统计前可以先问三个问题:
text
按什么分组?
到底数的是行,还是某个非空字段,还是去重后的对象?
过滤发生在分组前,还是分组后?
这三个问题回答清楚,SQL 基本就不会偏太远。需要状态维度,就把状态放进 group by;只想按城市统计,就不要顺手把订单状态也塞进去;要筛订单数、总金额这类聚合结果,就放到 having;想在分组结果里带非分组字段,就给它一个明确的聚合规则。
从 MySQL 切到 KingbaseES 时,GROUP BY 最不该想当然。统计结果不像语法错误那样醒目,错了也可能返回得很整齐。先用小数据把口径跑明白,再把 SQL 放进业务接口里,会少很多后面解释不清的数字。