Oceanbase数据库系列之:向量数据库核心知识
- 非结构化数据
- 向量
- 向量嵌入(Embedding)
- 向量最近邻搜索
- [为什么选择 OceanBase 向量搜索?](#为什么选择 OceanBase 向量搜索?)
- 分布式可扩展
- 高性能
- 高可用
- 事务性
- 低成本
- 数据安全
- 简单易用
- 完备的工具体系
- 应用场景
- 向量搜索核心功能
- 核心步骤解析
-
- [1. 非结构化数据经过向量嵌入处理转换为特征向量](#1. 非结构化数据经过向量嵌入处理转换为特征向量)
- 什么是向量嵌入?
- [使用 AI 函数服务在 OceanBase 中生成向量嵌入](#使用 AI 函数服务在 OceanBase 中生成向量嵌入)
- 常见的文本嵌入方法
-
- 使用离线、本地的预训练嵌入模型
- [使用 Hugging Face Transformers](#使用 Hugging Face Transformers)
- Ollama
- 常见的图像嵌入方法
-
- [使用 CLIP](#使用 CLIP)
- 存储向量数据
- 向量索引概述
- 稠密索引概述
- [HNSW 还是 IVF?](#HNSW 还是 IVF?)
- 索引语法及说明
- 搜索
- 创建
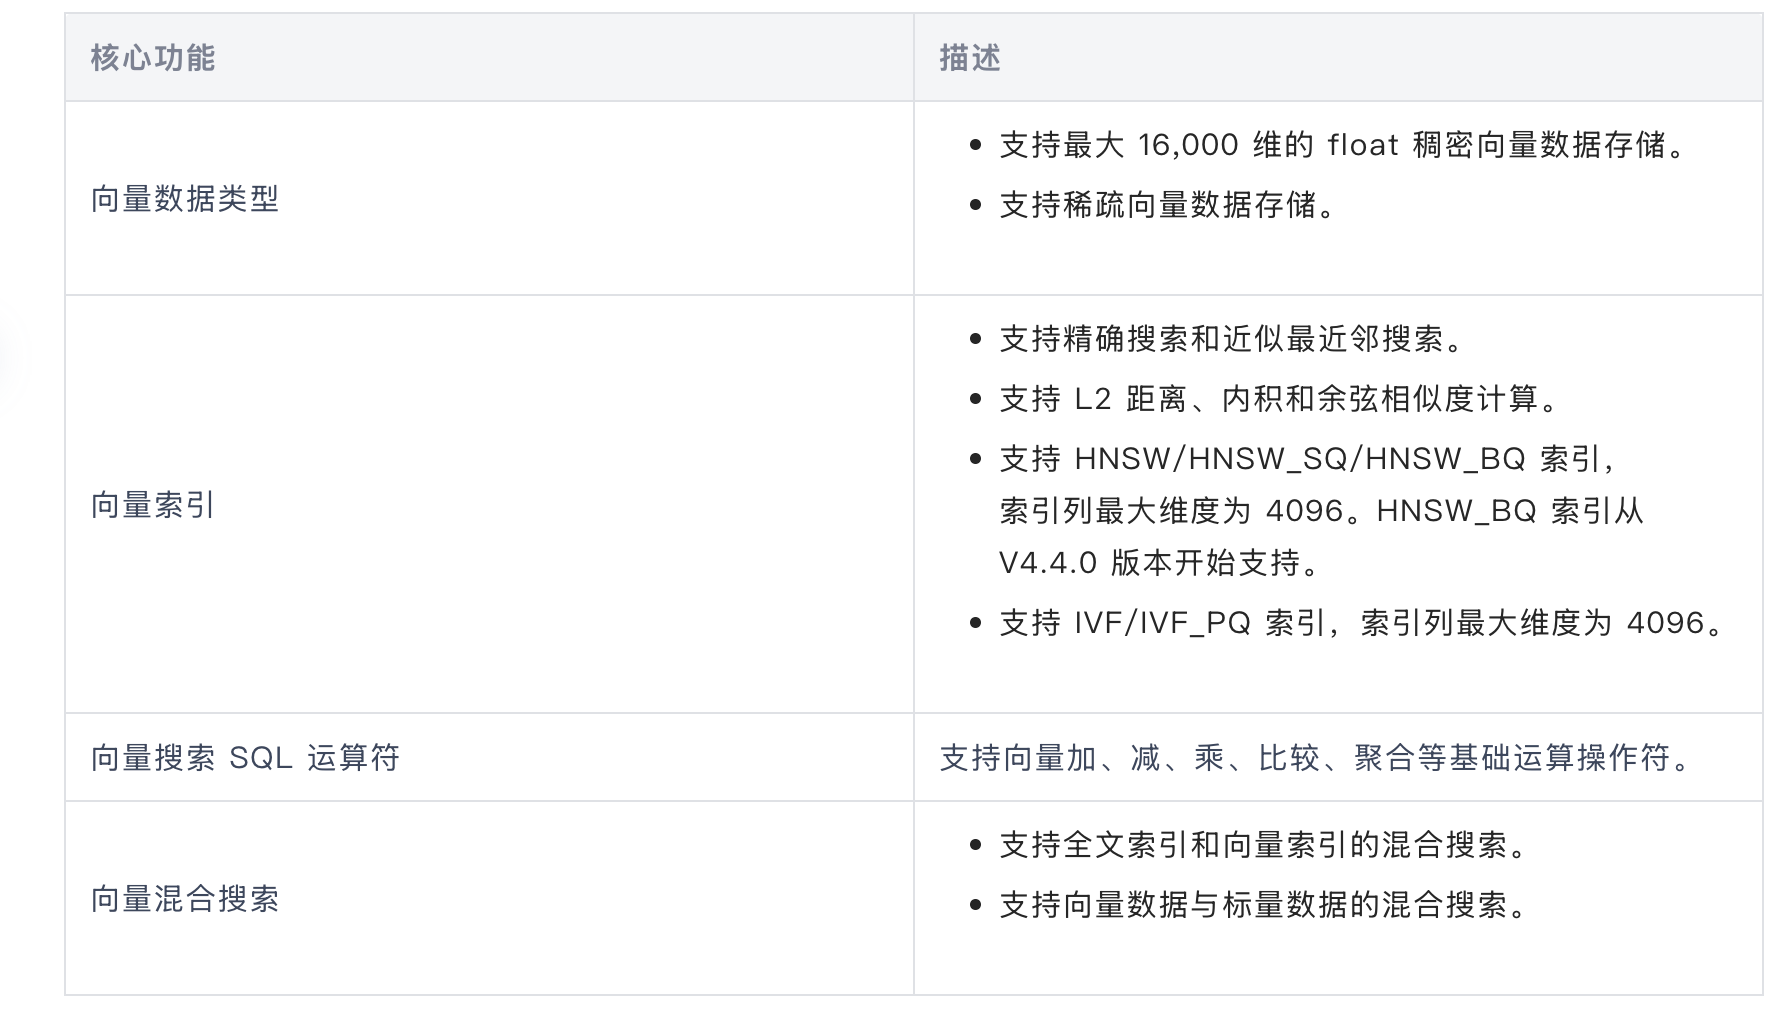
OceanBase 数据库最高支持 16000 维的 Float 类型的稠密向量,支持稀疏向量,支持曼哈顿距离、欧式距离、内积、余弦距离等多种类型向量距离的计算,支持 HNSW/IVF 向量索引的创建,支持索引维护。
OceanBase 向量搜索具备混合搜索能力。同时提供灵活的访问接口,不仅支持通过 MySQL 协议各种语言客户端使用 SQL 访问,也可以使用 Python/Java SDK 访问。同时 OceanBase 数据库也完成了对 AI 应用开发框架 LlamaIndex、DB-GPT 及 AI 应用开发平台 Dify 的适配,更好的服务于 AI 应用开发。
非结构化数据
- 非结构化数据是指没有明确定义的数据格式和组织结构的数据。
- 非结构化数据通常包括文本、图像、音频、视频等形式的数据,以及社交媒体内容、电子邮件、日志文件等。
- 由于非结构化数据的复杂性和多样性,处理这些数据需要采用特定的工具和技术,例如自然语言处理、图像识别、机器学习等。
向量
- 向量本质上是一个对象在高维空间的投影。数学意义上向量则是一个浮点数组,有以下两个特点:
- 数组中每个元素表示向量的某个维度,每个元素都是一个浮点数。
- 向量数组的大小(元素个数)表示整个向量空间的维度。
向量嵌入(Embedding)
- 向量嵌入(Embedding) 指的是通过深度学习神经网络提取非结构化数据里的内容和语义,把图片、视频等变成特征向量的过程。
- Embedding 技术将原始数据从高维度空间映射到低维度空间,将具有丰富特征的多模态数据转换为多维向量数据。
向量最近邻搜索
- 在当今信息爆炸的时代,用户常需要从海量数据中迅速搜索所需信息。例如在线文献数据库、电商平台产品目录、以及不断增长的多媒体内容库,都需要高效的搜索系统来快速定位到用户感兴趣的内容。随着数据量不断激增,传统的基于关键字的搜索方法已经无法满足用户对于搜索精度和速度的需求,向量搜索技术应运而生。向量最近邻搜索使用特征提取和向量化技术将文本、图片、音频等不同类型的非结构化数据转换为向量,使用相似性度量方法来比较它们之间的相似性,进而捕捉数据的深层次语义信息,从而提供更为准确和高效的搜索结果。
- "搜索"和"查询"的区别主要在于结果的准确性,搜索返回近似结果,不保证返回结果 100% 准确,查询返回精确结果,保证返回结果 100% 准确。
为什么选择 OceanBase 向量搜索?
OceanBase 向量搜索能力基于 OceanBase 多模一体化能力上构建,在融合搜索、扩展性、高性能、高可用、低成本、多租户、数据安全等方面均有优异的表现。
混合搜索
OceanBase 支持两个维度的混合搜索,真正实现用一套数据库解决应用多样存储搜索需求:
- 向量数据与标量数据的混合搜索。
- 向量索引与全文索引的混合搜索。
向量索引与全文索引的混合搜索也支持同时叠加标量过滤条件。
分布式可扩展
OceanBase 作为原生分布式数据库,其水平扩展能力及多分区能力,支撑 OceanBase 对海量向量数据的支持。
高性能
OceanBase 向量搜索能力集成了索引算法库 VSAG,VSAG 算法库在 960 维的 GIST 数据集上表现出色,在 ANN-Benchmarks 测试中远超其他算法。
高可用
基于 Paxos 协议的数据同步容灾方案,OceanBase 向量搜索也支持主备/跨机房/跨地域容灾,对于基于内存的 HNSW 索引,容灾切换后也能实时访问。
事务性
OceanBase 数据库基于 Multi-Paxos 协议的分布式事务能力不仅保证了向量数据的一致性和完整性,还提供了有效的并发控制和故障恢复机制。
低成本
OceanBase 的存储编码压缩能力能够显著降低向量存储空间,节省应用的存储成本。
数据安全
OceanBase 数据库已经支持比较完整的企业级安全特性,包括身份鉴别和认证、访问控制、数据加密、监控告警、安全审计,可以有效保证向量搜索场景下的数据安全。
简单易用
OceanBase 向量搜索提供灵活的访问接口,不仅支持通过 MySQL 协议各种语言客户端使用 SQL 访问,也可以使用 Python SDK 访问。同时 OceanBase 也完成了对 AI 应用开发框架 LangChain 和 Llamaindex 的适配,更好的服务于 AI 应用开发。
完备的工具体系
OceanBase 具备完备的数据库工具体系,支持数据开发、迁移、运维、诊断等数据全生命周期的管理,给 AI 应用的开发维护保驾护航。
应用场景
- RAG(Retrieval Augmented Generation)搜索增强生成:RAG 是一个人工智能框架,用于从外部知识库中搜索事实,以便为大型语言模型 (LLM) 提供最准确、最新的信息,并让用户深入了解 LLM 的生成过程,常应用于智能问答、知识库等。
- 个性化推荐:推荐系统可以根据用户的历史行为和偏好,向用户推荐可能感兴趣的物品。当发起推荐请求时,系统会基于用户特征进行相似度计算,然后返回与用户可能感兴趣的物品作为推荐结果,如饭店推荐、景点推荐等。
- 图搜图/文本搜图:图像/文本搜索任务是指在大规模图像/文本数据库中搜索出与指定图像最相似的结果,在搜索时使用到的文本/图像特征可以存储在向量数据库中,通过高性能的索引存储实现高效的相似度计算,进而返回和搜索内容相匹配的图像/文本结果,如人脸识别等。
向量搜索核心功能
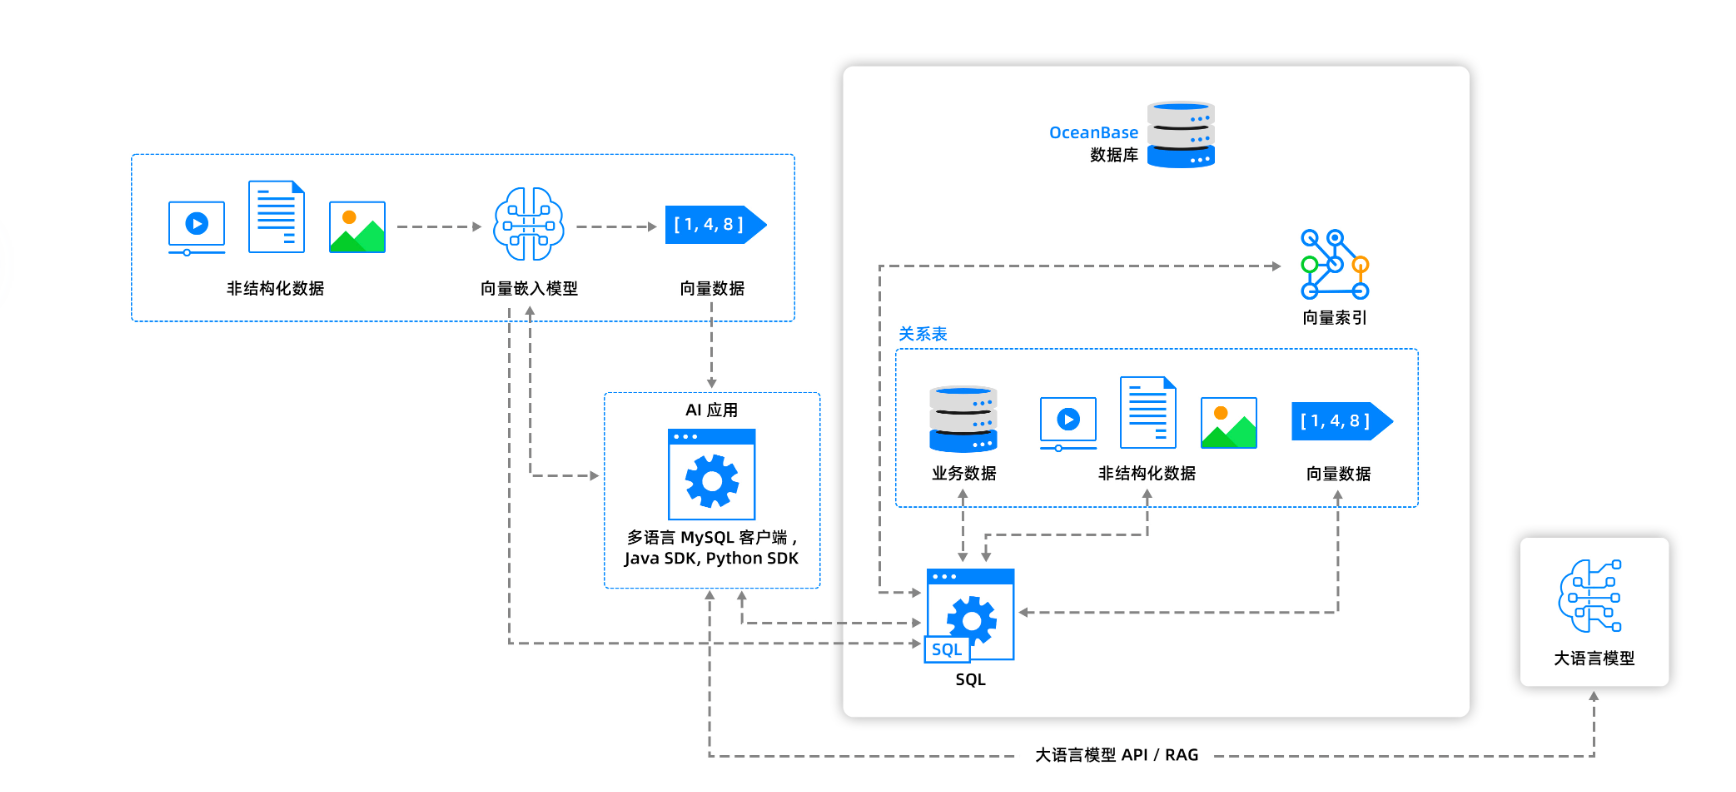
这个架构图展示了一个典型的现代 AI 应用模式,它将传统的关系型数据库能力与先进的向量搜索、大语言模型技术相结合,实现了对多模态数据的智能处理和高效利用。OceanBase 数据库在其中扮演了关键角色,提供了强大的数据存储和向量搜索能力,为构建此类 AI 应用提供了坚实的基础。
核心步骤解析
1. 非结构化数据经过向量嵌入处理转换为特征向量
非结构化数据(视频、文档、图片等)是整个工作流的起点。各种形式的非结构化数据,如视频、文本文件(文档)和图像,经由向量嵌入模型转化为向量数据表示。这个模型的任务是将这些原始的、难以直接计算相似度的非结构化数据,转换成高维的向量数据(Vectors)。这些向量能够捕捉数据的语义信息和特征,同时可以通过向量空间中的距离来表达数据的相似度。具体请参见向量嵌入技术。
什么是向量嵌入?
- 向量嵌入是一种将非结构化数据转换为数值向量的技术。这些向量能够捕捉非结构化数据的语义信息,使计算机可以"理解"和处理非结构化数据的含义。具体来说:
- 向量嵌入将文本、图像或音视频等非结构化数据映射到高维向量空间中的点。
- 在这个向量空间中,语义相似的非结构化数据会被映射到相近的位置。
- 向量通常由数百个数字组成(如 512 维、1024 维等)。
- 可以用数学方法(如余弦相似度)计算向量之间的相似度。
- 常见的向量嵌入模型包括 Word2Vec、BERT、BGE 等。例如,在开发 RAG 应用时,我们通常需要将文本数据进行嵌入处理转换为向量数据之后存储在向量数据库中,而其他结构化数据存储在关系型数据库中。
- OceanBase 4.3.3 版本开始支持将向量数据作为一种数据类型在关系表中进行存储,使得向量和传统标量数据能够有序、高效地存储在 OceanBase 这一款数据库中。
使用 AI 函数服务在 OceanBase 中生成向量嵌入
- OceanBase 数据库支持使用 AI 函数服务生成向量嵌入。用户无需安装任何依赖,只需注册好模型信息,即可在 OceanBase 数据库中使用 AI 函数服务生成向量嵌入
- 目前支持的函数有 AI_SPLIT_DOCUMENT、AI_EMBED、AI_COMPLETE、AI_PROMPT 和 AI_RERANK。
- AI 函数通过 SQL 表达式,将 AI 模型能力直接集成到数据库内的数据处理中。它极大地简化了利用 AI 大模型进行数据读取、分析、总结和保存等操作,是当前数据库和数据仓库领域的重要新特性。在 MySQL 模式下,OceanBase 数据库通过 DBMS_AI_SERVICE 包提供 AI 模型和端点管理,并新增了几个内置 AI 函数表达式,并支持通过视图监控 AI 模型调用情况。
常见的文本嵌入方法
使用离线、本地的预训练嵌入模型
使用预训练模型在本地进行文本嵌入是最灵活的方式,但需要较大的计算资源。常用的模型包括:
- 使用 Sentence Transformers
- Sentence Transformers 是一种用于自然语言处理(NLP)的模型,旨在将句子或段落转换为向量嵌入。它们基于深度学习技术,特别是使用了变换器(Transformer)架构,能够有效捕捉文本的语义信息。因为在国内直接访问 hugging face 的域名通常会超时,请提前设置 hugging face 的镜像地址 export HF_ENDPOINT=https://hf-mirror.com,设置完成后再执行下面的代码:
python
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-m3")

sentences = [
    "That is a happy person",
    "That is a happy dog",
    "That is a very happy person",
    "Today is a sunny day"
]
embeddings = model.encode(sentences)
print(embeddings)
[[-0.01178016  0.00884024 -0.05844684 ...  0.00750248 -0.04790139
  0.00330675]
[-0.03470375 -0.00886354 -0.05242309 ...  0.00899352 -0.02396279
  0.02985837]
[-0.01356584  0.01900942 -0.05800966 ...  0.00523864 -0.05689549
  0.00077098]
[-0.02149693  0.02998871 -0.05638731 ...  0.01443702 -0.02131325
 -0.00112451]]
similarities = model.similarity(embeddings, embeddings)
print(similarities.shape)
torch.Size([4, 4])
使用 Hugging Face Transformers
Hugging Face Transformers 是一个开源库,提供了大量预训练的深度学习模型,特别是用于自然语言处理(NLP)任务的模型。由于地域问题,直接访问 hugging face 的域名可能会超时,请提前设置 hugging face 的镜像地址 export HF_ENDPOINT=https://hf-mirror.com,设置完成后再执行下面的代码:
python
from transformers import AutoTokenizer, AutoModel
import torch

加载模型和分词器
tokenizer = AutoTokenizer.from_pretrained("BAAI/bge-m3")
model = AutoModel.from_pretrained("BAAI/bge-m3")

准备输入
texts = ["这是示例文本"]
inputs = tokenizer(texts, padding=True, truncation=True, return_tensors="pt")

生成嵌入
with torch.no_grad():
    outputs = model(**inputs)
#使用 [CLS] token 的输出
    print(embeddings)
#tensor([[-1.4136,  0.7477, -0.9914,  ...,  0.0937, -0.0362, -0.1650]])
print(embeddings.shape)
#torch.Size([1, 1024])
Ollama
Ollama 是一个开源的模型。运行时,它让用户能够在本地轻松运行、管理和使用各种大语言模型。除了支持 Llama 3 和 Mistral 等开源语言模型外,它还支持 bge-m3 等嵌入模型。
部署 Ollama
在 MacOS 和 Windows 上可以直接从官网下载安装包进行安装,安装方法可参考 Ollama 的官网。安装完成后,Ollama 会作为一个服务在后台运行。
在 Linux 上安装 Ollama:
bash
curl -fsSL https://ollama.ai/install.sh | sh拉取嵌入模型
Ollama 支持使用 bge-m3 模型用于文本嵌入:
bash
ollama pull bge-m3Python SDK 方式
首先安装 Ollama 的 Python SDK:
bash
pip install ollama
python
import ollama

#示例使用
texts = ["第一个句子", "第二个句子"]
embeddings = ollama.embed(model="bge-m3", input=texts)['embeddings']
print(embeddings)
#[[0.03486196, 0.0625187, ...], [...]]
Ollama 的优势和局限
优势:
- 完全本地部署,无需网络连接
- 开源免费,无需 API Key
- 支持多种模型,便于切换和比较
- 资源占用相对较小
局限:
- 嵌入模型选择较少
- 性能可能不如商业服务
- 需要自行维护和更新
- 缺乏企业级支持
常见的图像嵌入方法
此部分介绍图像嵌入方法。
使用离线、本地的预训练嵌入模型
使用 CLIP
CLIP (Contrastive Language-Image Pretraining) 是一种由 OpenAI 提出的模型,旨在通过结合图像和文本来进行多模态学习。CLIP 可以理解和处理图像和文本之间的关系,使得它能够在多种任务中表现出色,如图像分类、图像搜索和文本生成等。
python
from PIL import Image
from transformers import CLIPProcessor, CLIPModel

model = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")

准备输入图像
image = Image.open("path_to_your_image.jpg")
texts = ["这是第一句话", "这是第二句话"]

调用嵌入服务
inputs = processor(text=texts, images=image, return_tensors="pt", padding=True)
outputs = model(**inputs)

获取嵌入结果
if outputs.status_code == 200:
    print(outputs.output['embeddings'])
[{"embedding": [-0.03193652629852295, 0.08152323216199875, ...]}, {"embedding": [...]}]
存储向量数据
本文档介绍了如何在 OceanBase 中统一存储非结构化数据、半结构化数据和结构化数据。这不仅充分利用了 OceanBase 数据库的基础能力,还为混合搜索提供了强大支持。
存储原理
OceanBase 数据库能够存储不同模态的数据,支持混合搜索的原理是将不同模态的数据(如文本、图片、视频等)统一转换为向量,通过计算向量之间的距离来实现搜索。混合搜索分为两种方式:简单搜索基于单个向量的相似度搜索,复杂搜索则涉及向量与标量的混合搜索。
由于向量搜索本身具有近似性,实际应用中需结合多种手段提高精度,精确的搜索结果才能为业务带来更大价值。
配置向量索引内存
OceanBase 向量搜索通过设置 ob_vector_memory_limit_percentage 配置向量索引内存。
向量搜索功能默认启用。默认值为 0 表示自适应模式,即系统自动调整租户中的向量索引数据的内存占用比例,无需手动调整:
- 租户实际内存为 8GB 及以下时,该值自适应为 40。
- 租户实际内存为 8GB 以上时,该值自适应为 50。
创建向量列
下述示例体现了一张表同时存储了向量数据、空间数据和关系型数据。向量列的数据类型为 VECTOR,并且必须在创建时指定维度,维度最高支持 16000;空间列的数据类型为 GEOMETRY:
python
CREATE TABLE t (
    -- 存储关系型数据(结构化数据)
    id INT PRIMARY KEY,
    -- 存储空间数据(半结构化数据)
    g GEOMETRY,
    -- 存储向量数据(非结构化数据)
    vec VECTOR(3)
);
使用 INSERT 语句插入向量数据
一旦创建了包含 VECTOR 数据类型列的表,就可以直接使用 INSERT 语句将向量插入表中。在插入数据时,向量必须与表定义时指定的维度相匹配,否则会报错。这种设计确保了数据的一致性和查询的效率。向量的格式采用标准的浮点数数组表示,每个维度的值必须是有效的浮点数。这是一个简单的示例:
sql
INSERT INTO t (id, g, vec) VALUES (
  -- 插入结构化数据
  1,
  -- 插入半结构化数据
  ST_GeomFromText('POINT(1 1)'),
  -- 插入非结构化数据
  '[0.1, 0.2, 0.3]'
);
向量索引概述
本文档介绍 OceanBase 数据库支持的向量索引类型及其特点。
索引类型
OceanBase 数据库支持以下类型的向量索引:
- 稠密索引
- 稀疏索引
- 语义索引
稠密索引
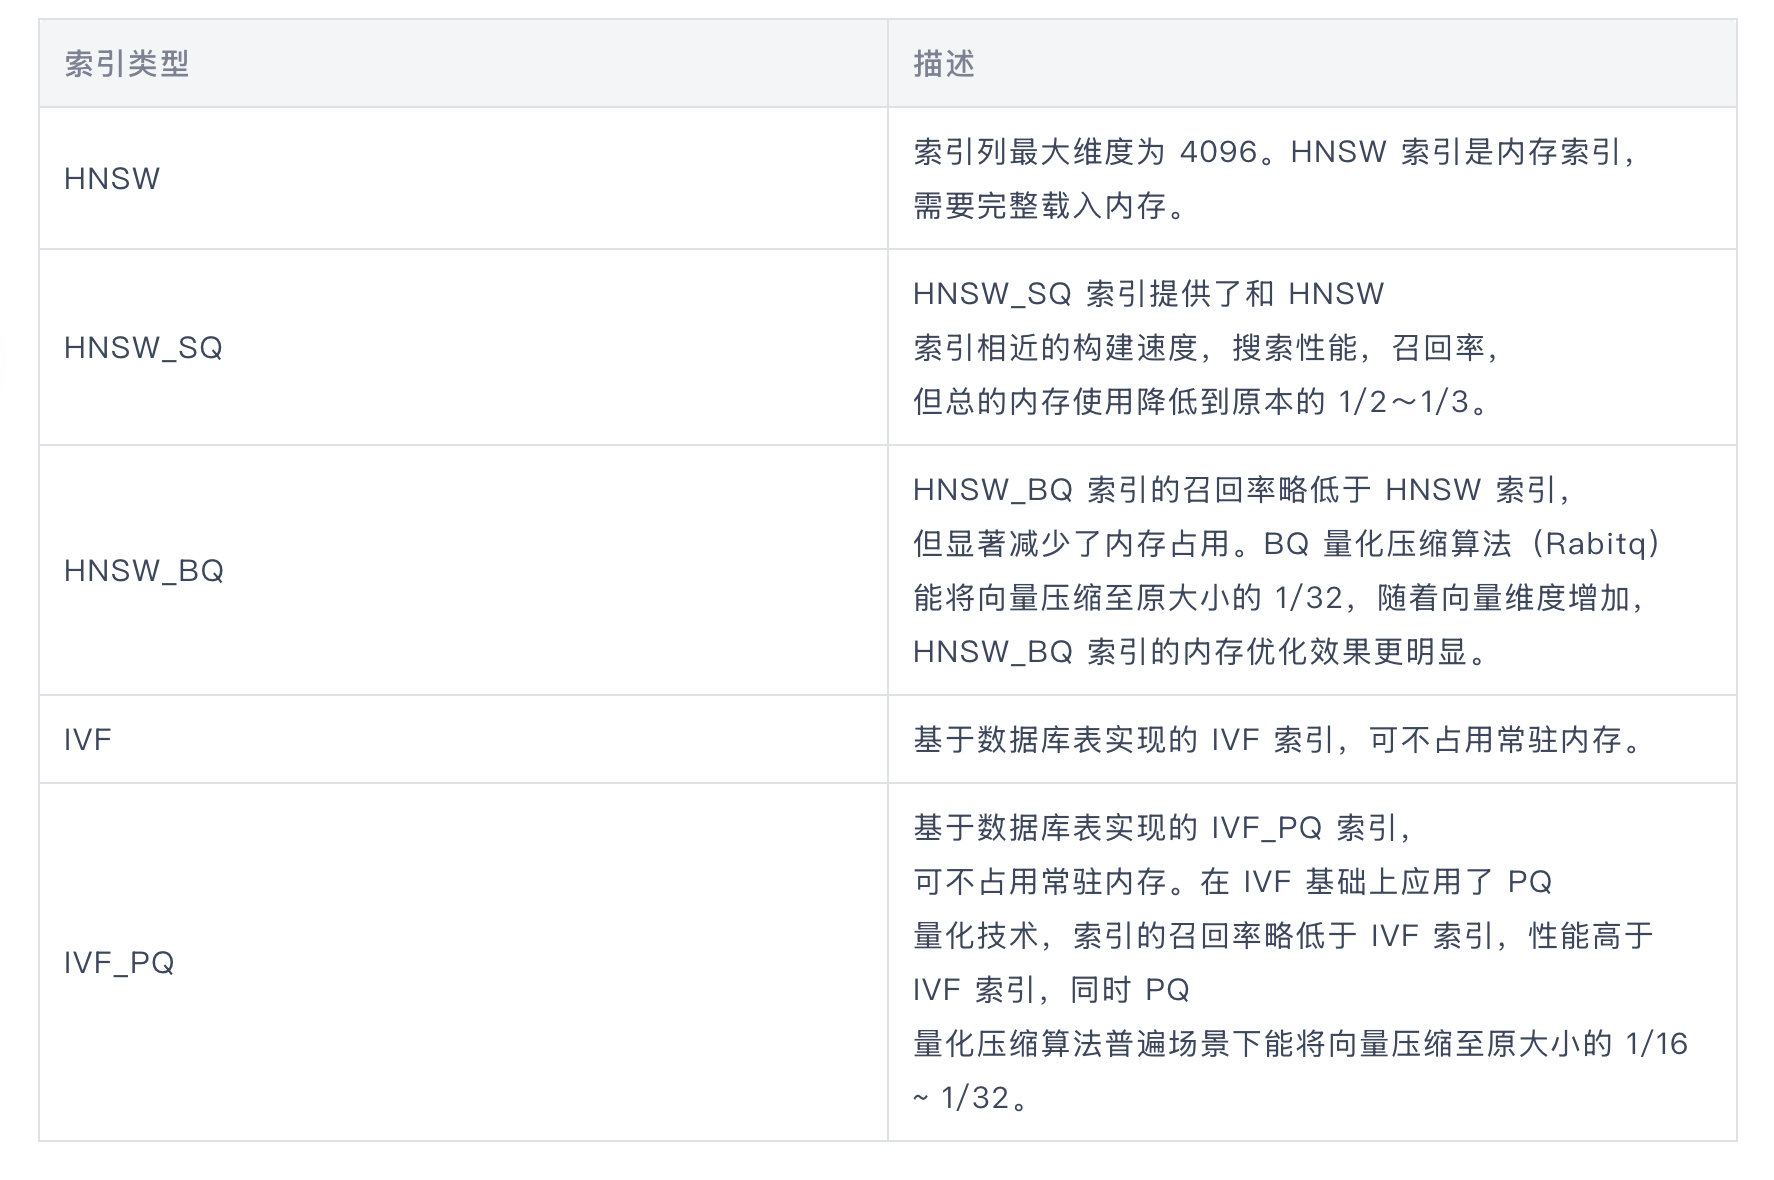
OceanBase 数据库支持稠密向量索引,包含 HNSW 系列和 IVF 系列。
稀疏索引
OceanBase 数据库当前版本支持基于内存的稀疏向量索引,为方便阅读简称为内存稀疏索引。内存稀疏索引是 OceanBase 数据库针对稀疏向量数据(大部分元素为零的向量)提供的高效索引类型,需要将索引完整的载入内存,支持 DML 和实时搜索。
语义索引(Semantic Index)
OceanBase 数据库支持语义索引,其利用 OceanBase 数据库内置的嵌入(Embedding)能力,极大地简化了向量索引的使用流程。它实现了向量概念对用户的透明化:你可以直接写入需要存储的原始数据(如文本或图片 URL),OceanBase 数据库会在内部自动将其转换为向量并建立索引。在搜索时,你同样只需提供原始搜索内容,OceanBase 数据库也会自动进行嵌入并搜索向量索引,从而显著提升了使用的便捷性。除文本外,还支持创建图片 URL 语义索引,实现以图搜图、以文搜图等场景。目前支持在单列上创建多个语义索引,可用于不同模型、距离算法或索引参数组合。
说明与限制
- 距离算法:稠密向量索引支持 L2、内积(IP)、余弦距离作为索引距离算法。
- 距离函数:向量索引搜索支持调用部分距离函数。
- 过滤条件:支持带有过滤条件的向量搜索。过滤条件可以是标量类型的条件,可以是空间关系,如 ST_Intersects 等。暂不支持多值索引/全文索引/全局索引作为预过滤器。
- 混合搜索:支持同表创建向量索引和全文索引,向量索引包含稠密和内存稀疏。
- Offline DDL:向量索引对 Offline DDL 的支持情况请见 Offline DDL。
- 列存索引:当前版本暂不支持创建列存向量索引。
稠密索引概述
稠密索引是 OceanBase 数据库针对稠密向量数据(大部分元素为非零值的向量)提供的高效索引类型。稠密向量索引主要用于加速向量搜索,支持通过距离函数(L2、内积、余弦距离)进行最近邻搜索。
索引类型
OceanBase 数据库的稠密索引主要包含 HNSW 系列和 IVF 系列。
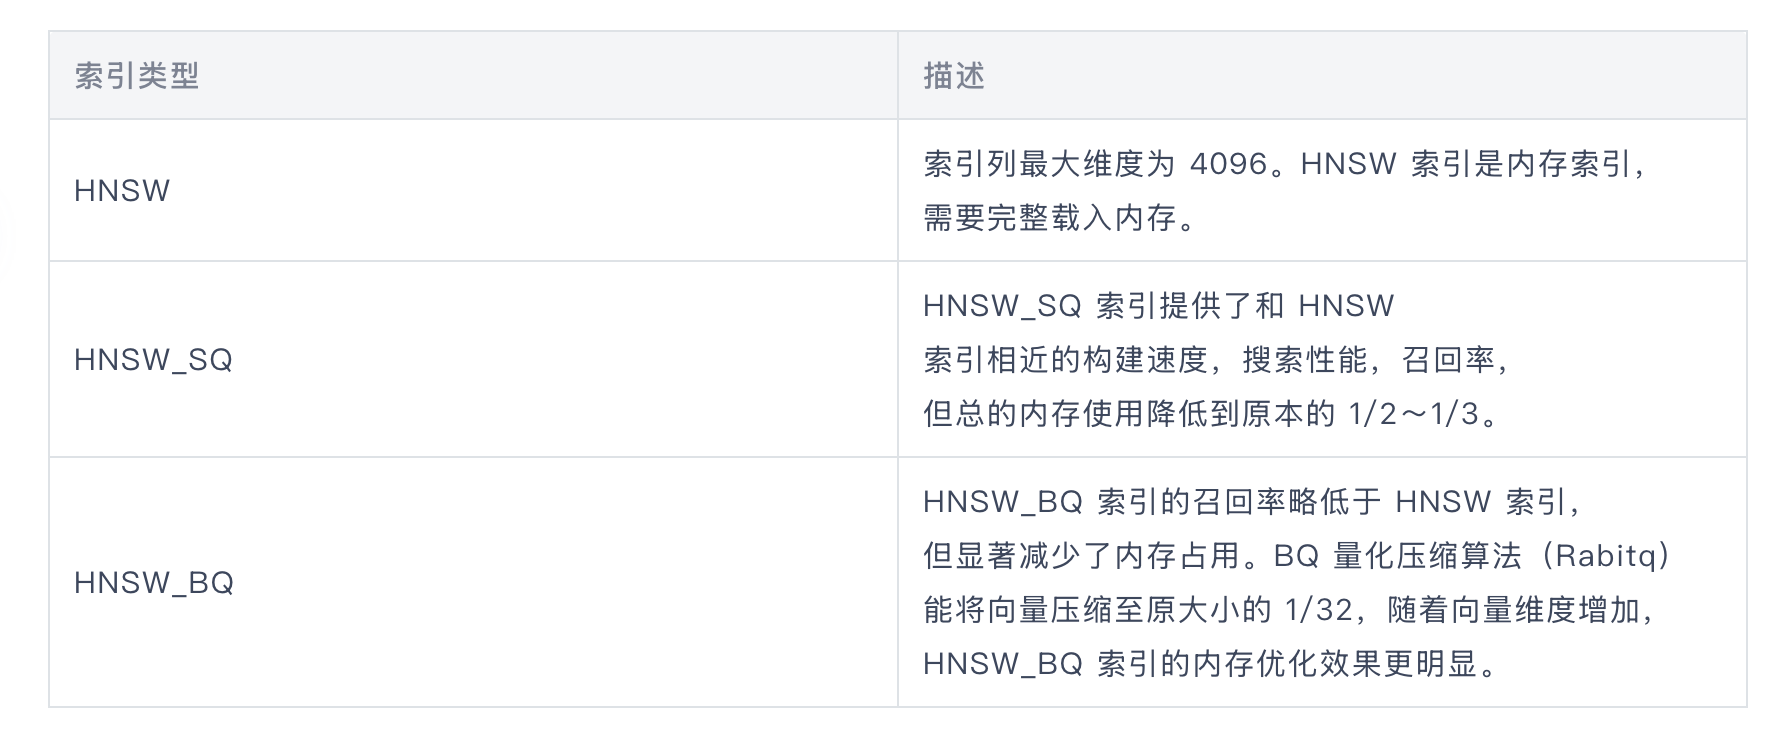
HNSW 系列
基于内存的图结构索引,需要完整载入内存,支持 DML 和实时搜索,具有较高的搜索性能和召回率。
IVF 系列
基于磁盘的索引,可不占用常驻内存,适合数据量较大、成本敏感的场景。
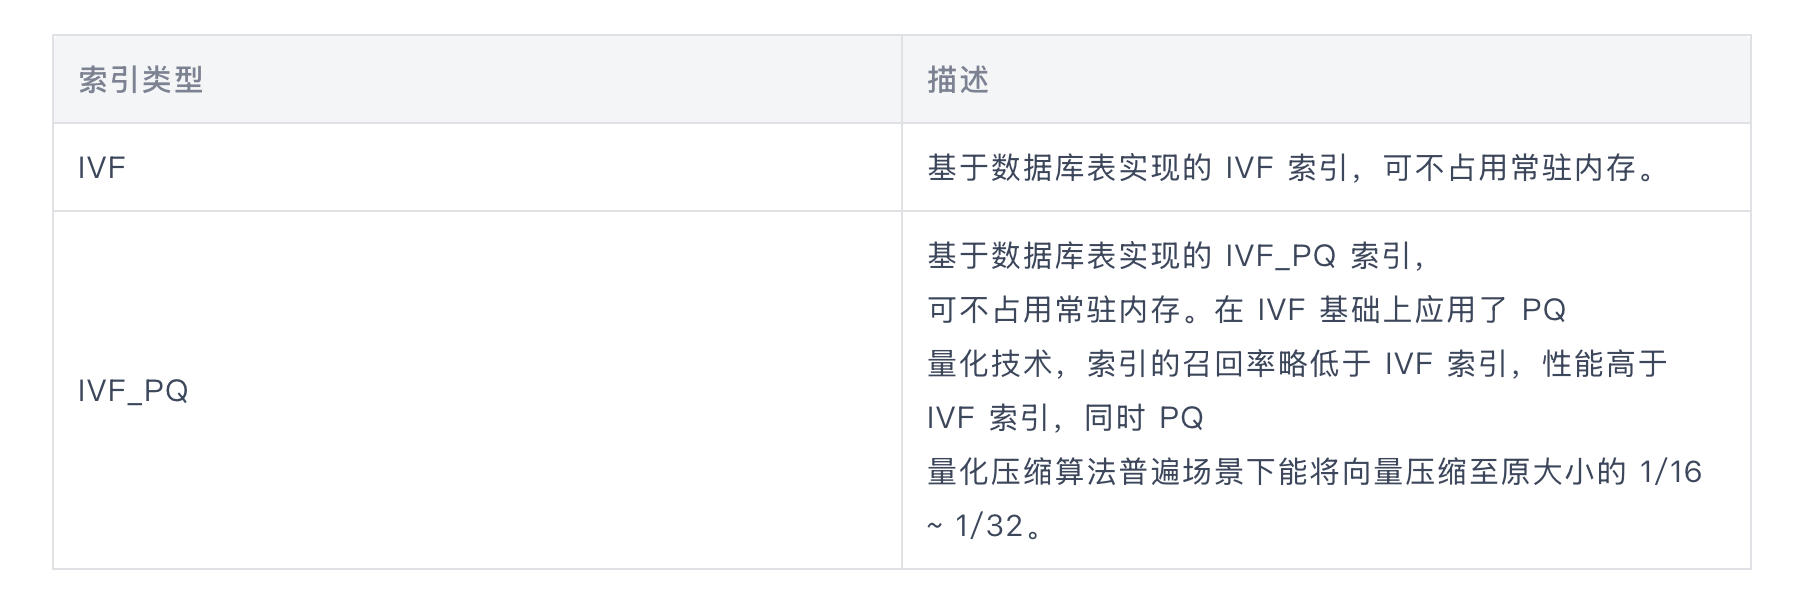
语法说明
稠密索引中,HNSW 系列支持建表时创建和后建两种创建方式,IVF 系列仅支持后建。搜索语法和删除语法与常规向量索引一致。
HNSW 还是 IVF?
OceanBase 的稠密索引分为两大类:
- 基于图的 HNSW 系列索引:HNSW、HNSW_SQ、HNSW_BQ。
- 基于磁盘的 IVF 系列索引:IVF、IVF_PQ。
这两种索引类型各有侧重。HNSW 系列索引通常提供更高的查询性能,但需要占用更多常驻内存;而 IVF 系列索引在缓存充足时性能表现良好,且能够不依赖常驻内存运行。然而,选择 HNSW 还是 IVF 并非仅基于内存考量,业务场景、数据规模、性能指标以及资源约束等多个维度都需综合评估,下文将详细对比其核心差异并提供选择建议。
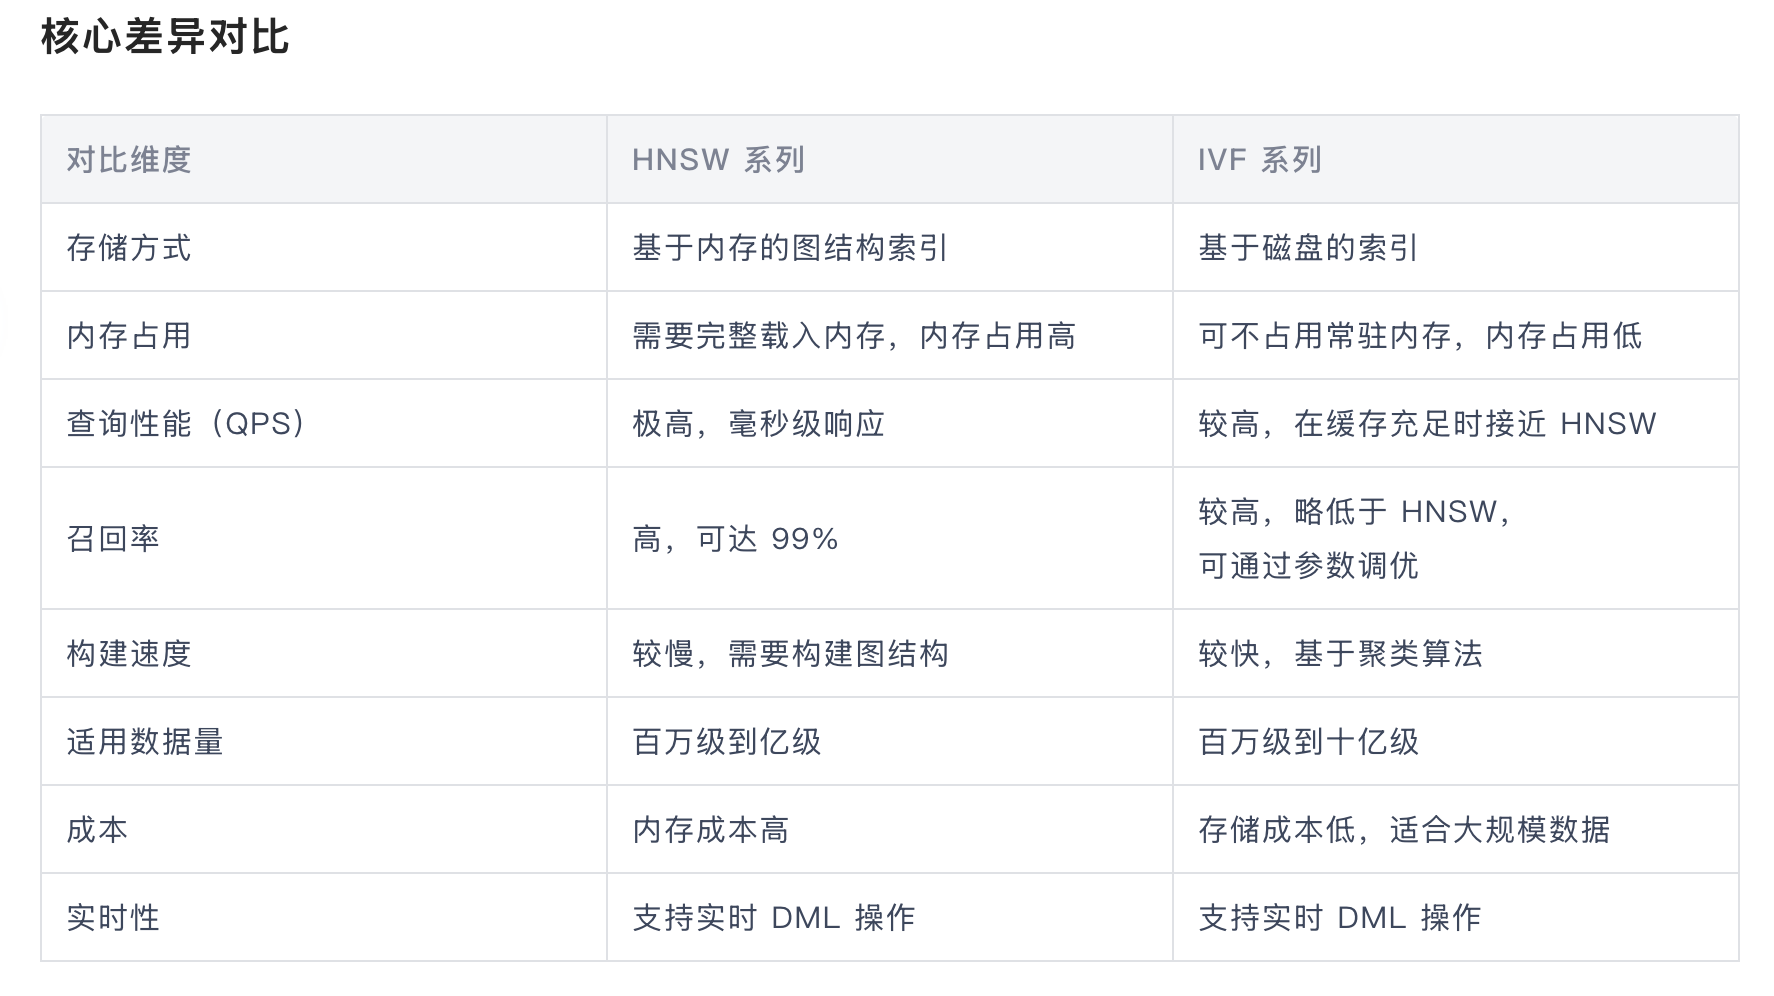
是否使用分区表?
使用分区表的主要目的是为了解决大数据量的场景,其次是如果查询条件可以用于做分区键,那么通过分区裁剪可以提升查询性能。在以下两种场景下建议使用分区表:
数据量达到几千万或亿级以上:当数据量非常大时,使用分区表可以将数据分散到多个分区,每个分区独立构建索引,从而降低单次查询负载,提升整体查询性能。
查询条件中有明确的标量列可以用作分区裁剪:例如,如果 label 字段总是会出现在 WHERE 条件中,那么就可以考虑以 label 作为分区键创建分区表,通过分区裁剪减少需要查询的分区数量。
分区划分
在使用向量索引时,分区数量不宜过多。与标量索引不同,向量索引(如 HNSW)在相同配置下,索引规模从 100 万向量增大到 200 万向量,查询 TopK 所需的计算开销并不会显著增加。因此,如果不能利用分区裁剪,过多的分区反而可能降低性能。另外,单个分区过大不仅会导致索引重建耗时增加,还会影响与标量条件联合查询时的效率。
综上,推荐将每个分区内的数据量控制在 2000 万以下,并优先选择能够支持分区裁剪的字段作为分区键。
索引语法及说明
创建
HNSW 系列索引包含 HNSW、HNSW_SQ 和 HNSW_BQ 三种索引,其创建支持在建表时创建和后建两种方式。创建时需要注意:
- 创建向量索引必须带有 VECTOR 关键字。
- 后建索引的参数和说明与建表时创建索引一致。
- 如果数据量较大,建议先写完数据,再创建索引,以获得最佳搜索性能。
- HNSW_SQ 索引建议在写入数据后再创建索引,并在写入较多增量数据后进行索引重建。每个索引具体的创建说明见下文具体示例。
- 创建 HNSW 索引时,索引名长度暂不支持超过 25 个字符,否则可能因为索引辅助表名长度超过 index_name 限制导致异常。未来版本会支持更长的索引名。
- 建议在堆表上创建 HNSW 系列索引,以获得最佳搜索性能。
sql
CREATE TABLE table_name (
    column_name1 data_type1,
    column_name2 VECTOR(dim),
    ...,
    VECTOR INDEX index_name (column_name2) WITH (param1=value1, param2=value2, ...)
);
sql
-- 后建索引支持设置并行度,以提升索引构建性能,并行度最大设置不超过 CPU 核数 * 2
CREATE [/*+ paralell $value*/] VECTOR INDEX index_name ON table_name(column_name2) WITH (param1=value1, param2=value2, ...);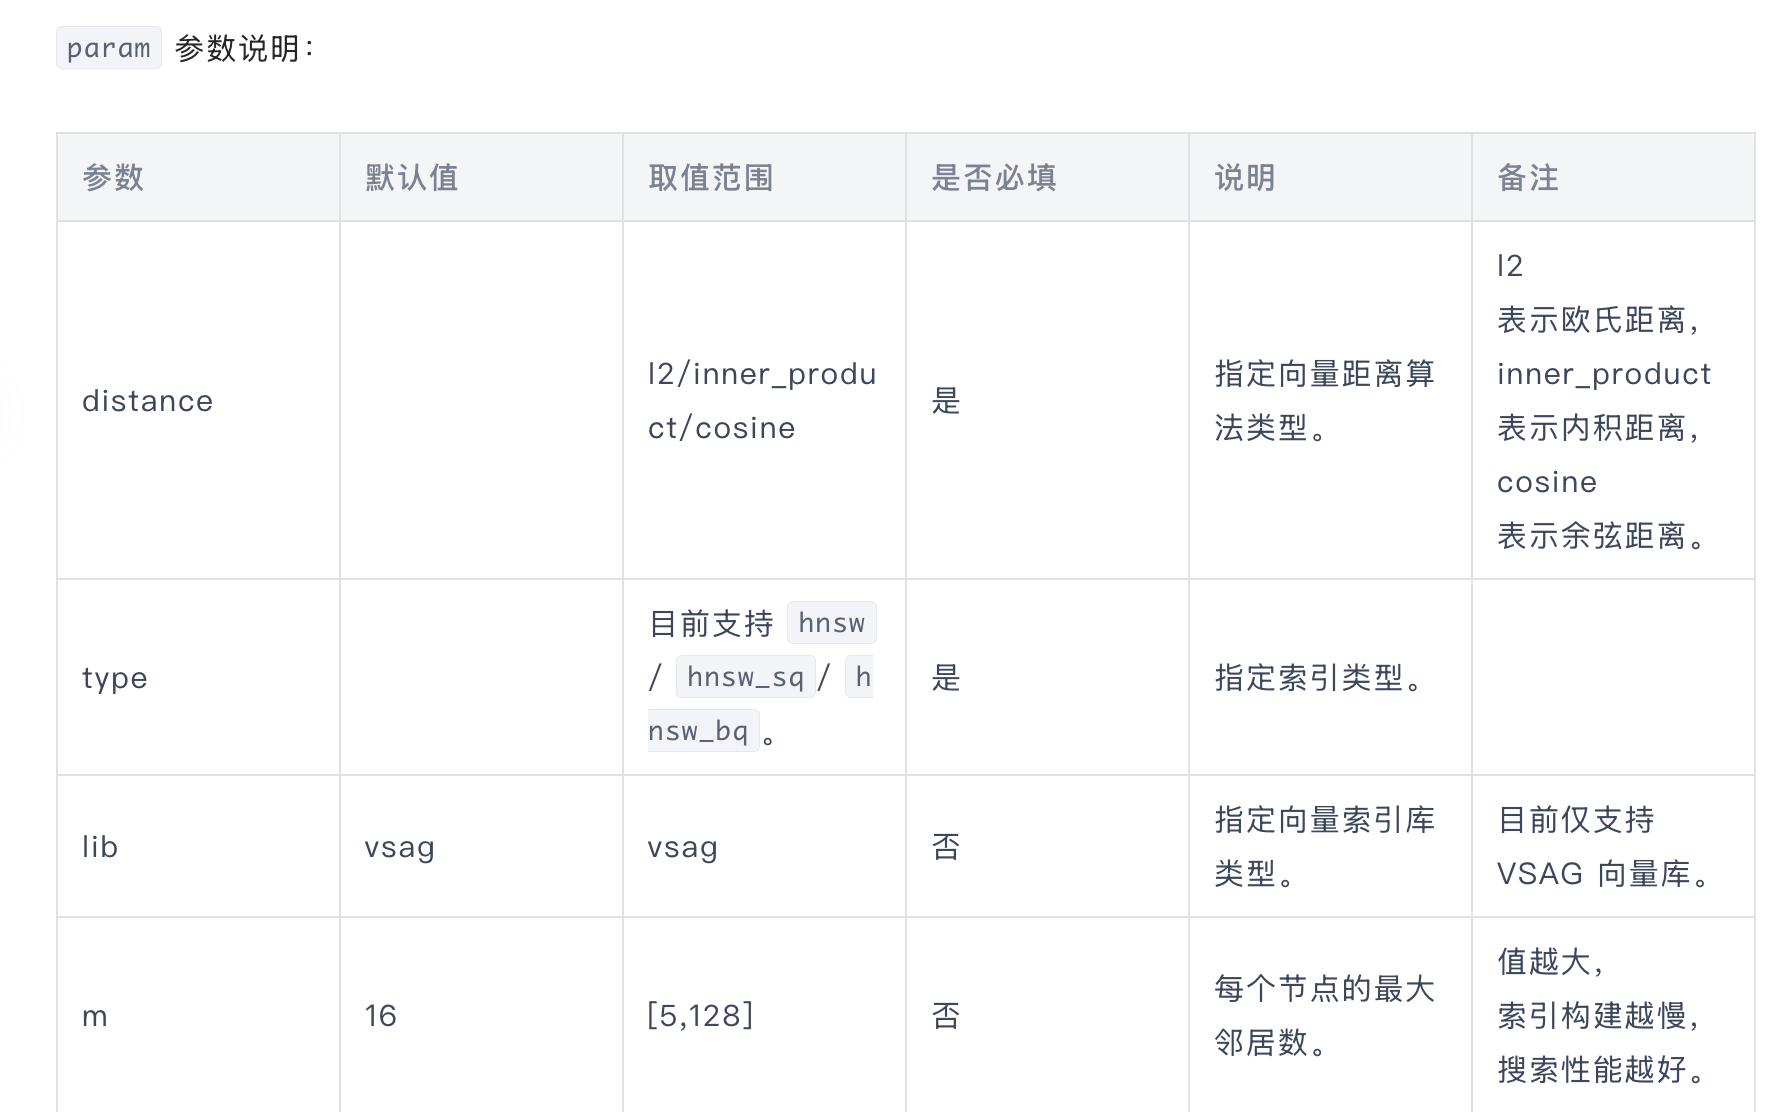
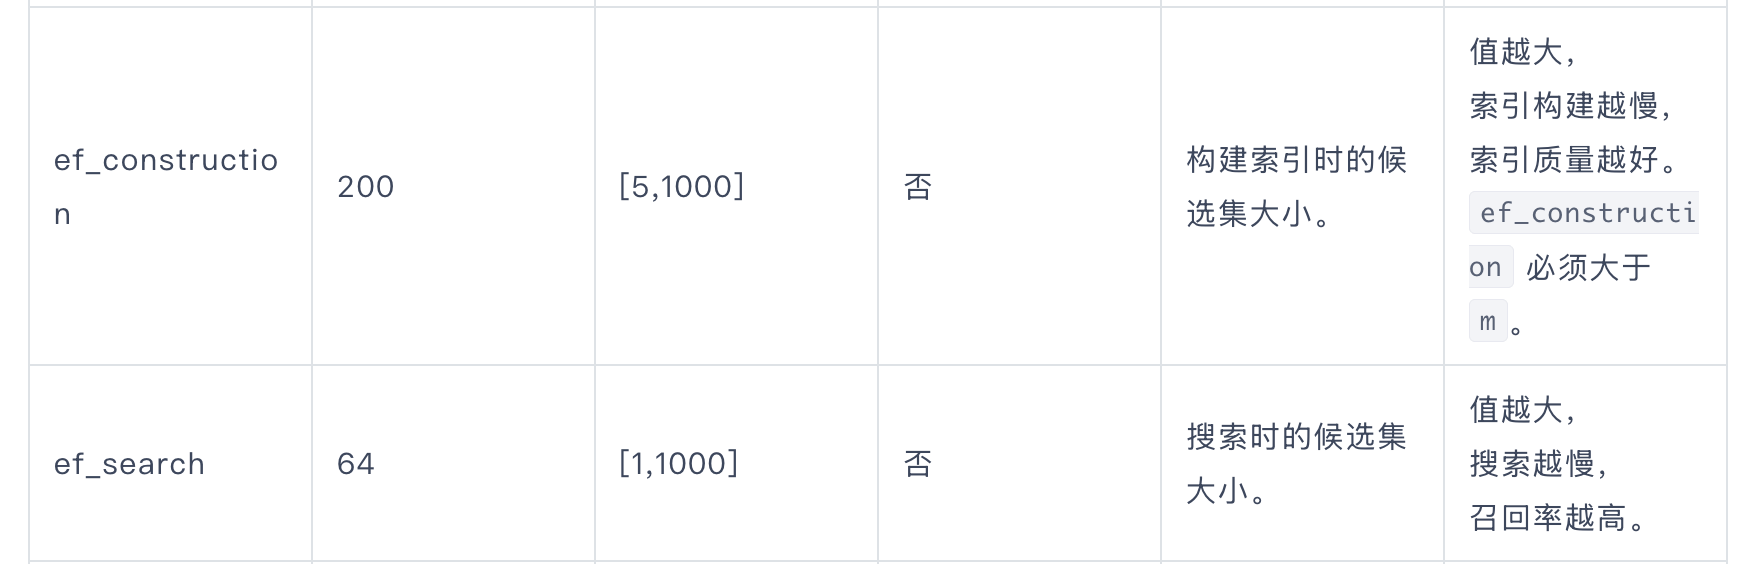
搜索
HNSW 系列索引的搜索是一种近似最近邻(ANN)搜索,不保证 100% 的结果准确性。衡量其准确率的指标是召回率,例如在查询 10 个最近邻时,若能稳定返回 9 个正确结果,则召回率为 90%。
sql
SELECT ... FROM table_name
ORDER BY distance_function(column_name, vector_expr) [APPROXIMATE|APPROX]
LIMIT num [(OFFSET num)]
[PARAMETERS(param1=value1, param2=value2, ...)];
搜索语法要求:
- 必须指定 APPROXIMATE/APPROX 关键字,搜索才会使用向量索引而非全表扫描。
- 必须包含 ORDER BY 和 LIMIT 子句。
- ORDER BY 只支持单个向量条件。
- LIMIT + OFFSET 的取值范围为 (0, 16384]。单次近似搜索最多返回 16384 条;若需更大规模相似召回,可使用迭代翻页查询(Search Iterator),在 PARAMETERS 中通过 last_distance 分批继续取数(从 V4.6.0 BP1 版本开始支持)。
- 不指定 LIMIT 子句会报错。
- PARAMETERS 为可选的查询级参数,可设置 ef_search、refine_k、last_distance。
sql
CREATE TABLE t1(c1 INT, c0 INT, c2 VECTOR(10), c3 VECTOR(10), PRIMARY KEY(c1), VECTOR INDEX idx1(c2) WITH (distance=l2, type=hnsw, lib=vsag), VECTOR INDEX idx2(c3) WITH (distance=l2, type=hnsw, lib=vsag));- c1 INT:普通整型列,被指定为主键。
- c0 INT:普通整型列,没有索引,只是陪衬。
- c2 VECTOR(10):10 维向量列,用来存嵌入向量。
- c3 VECTOR(10):另一个 10 维向量列。
- PRIMARY KEY(c1):主键是 c1,不是自增,需要插入时自己指定
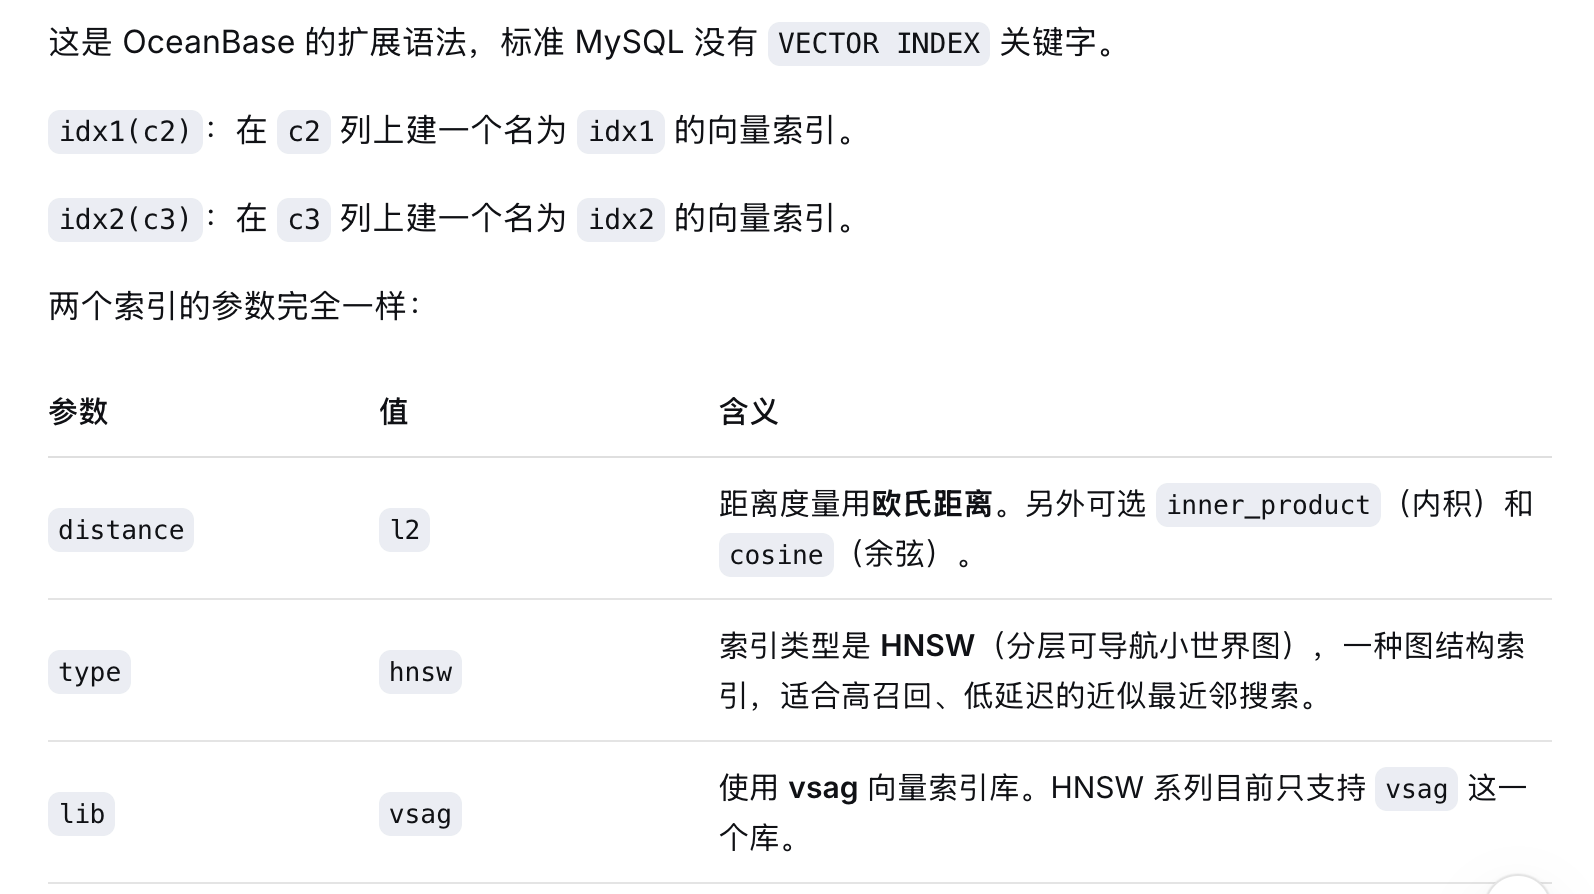
写入测试数据。
sql
INSERT INTO t1 VALUES(1, 1,'[0.203846,0.205289,0.880265,0.824340,0.615737,0.496899,0.983632,0.865571,0.248373,0.542833]', '[0.203846,0.205289,0.880265,0.824340,0.615737,0.496899,0.983632,0.865571,0.248373,0.542833]');
INSERT INTO t1 VALUES(2, 2, '[0.735541,0.670776,0.903237,0.447223,0.232028,0.659316,0.765661,0.226980,0.579658,0.933939]', '[0.213846,0.205289,0.880265,0.824340,0.615737,0.496899,0.983632,0.865571,0.248373,0.542833]');
INSERT INTO t1 VALUES(3, 3, '[0.327936,0.048756,0.084670,0.389642,0.970982,0.370915,0.181664,0.940780,0.013905,0.628127]', '[0.223846,0.205289,0.880265,0.824340,0.615737,0.496899,0.983632,0.865571,0.248373,0.542833]')
使用近似最近邻搜索。
sql
SELECT * FROM t1 ORDER BY l2_distance(c2, [0.712338,0.603321,0.133444,0.428146,0.876387,0.763293,0.408760,0.765300,0.560072,0.900498]) APPROXIMATE LIMIT 1;后建
HNSW 示例
创建测试表。
sql
CREATE TABLE vec_table_hnsw (id INT, c2 VECTOR(10));创建 HNSW 索引。
sql
CREATE VECTOR INDEX vec_idx1 ON vec_table_hnsw(c2) WITH (distance=l2, type=hnsw);查看创建的表。
sql
SHOW CREATE TABLE vec_table_hnsw;IVF 系列索引包含 IVF 和 IVF_PQ 两种索引。IVF 索引的聚类中心构建需要依赖于主表的数据,为了保证 IVF 索引的正常使用,仅放开后建 IVF 索引功能,即创建主表且完成数据导入后再新建 IVF 索引。其创建仅支持后建方式。创建时需要注意:
- 如果数据量较大,建议先写完数据,再创建索引,以获得最佳搜索性能。
- IVF/IVF_PQ 索引均建议在写入数据后再创建索引,并在写入较多增量数据后进行索引重建。每个索引具体的创建说明见下文具体示例。
- 创建 IVF 索引时,索引名长度暂不支持超过 33 个字符,否则可能因为索引辅助表名长度超过 index_name 限制导致异常。未来版本会支持更长的索引名。
- 在处理大规模向量数据时,适当增大 nlist 参数有助于提升 IVF 索引的召回率。当 nlist ≥ 5000 时,IVF 粗聚类中心缓存的存储结构将由数组切换为 HGraph(图结构),进一步优化索引性能与空间利用效率。
sql
-- 后建索引支持设置并行度,以提升索引构建性能,并行度最大设置不超过 CPU 核数 * 2
CREATE [/*+ paralell $value*/] VECTOR INDEX index_name ON table_name(column_name2) WITH (param1=value1, param2=value2, ...);
这段是 OceanBase 中后建向量索引的语法说明,重点是可以通过 HINT 指定并行度来加速索引构建。
CREATE VECTOR INDEX index_name ON table_name(column_name2):在已有表的某个向量列上创建向量索引。这里是在 table_name 表的 column_name2 列上建名为 index_name 的索引。
WITH (param1=value1, ...):索引参数,和建表时用的参数完全一致(distance、type、lib 等)。
/*+ paralell $value*/:可选的 HINT,用来指定构建索引时的并行度。
为什么需要并行度
向量索引构建(尤其是 HNSW 和 IVF)是计算密集型操作,需要:
计算向量之间的距离;
构建图结构或聚类中心;
训练量化器(IVF_PQ)。
这些操作可以拆分到多个线程并行执行。适当提高并行度能显著缩短建索引时间,但设得过高会争抢 CPU 资源,反而拖慢其他查询,所以上限被限制在 CPU 核数 × 2。
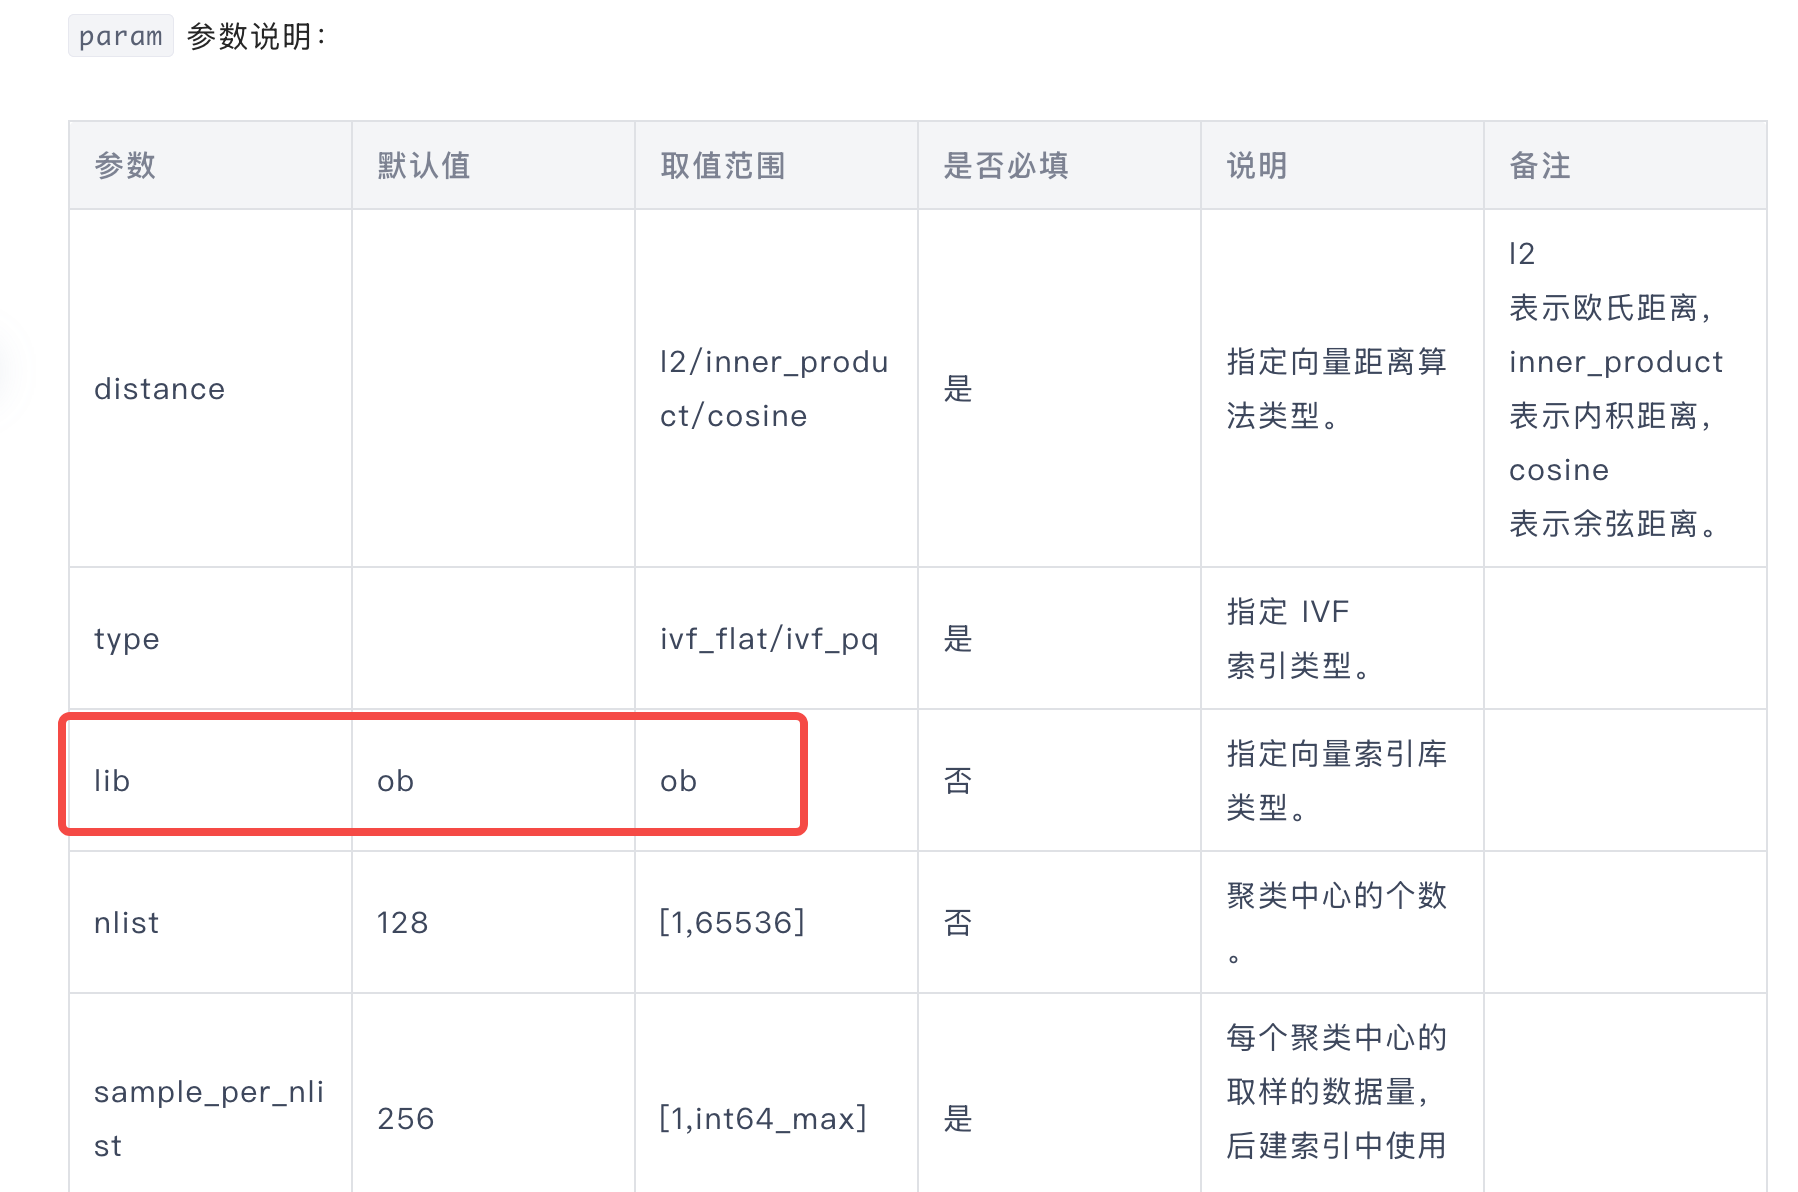
搜索
IVF 系列索引的搜索是一种近似最近邻(ANN)搜索,不保证 100% 的结果准确性。衡量其准确率的指标是召回率,例如在查询 10 个最近邻时,若能稳定返回 9 个正确结果,则召回率为 90%。
sql
SELECT ... FROM table_name
ORDER BY distance_function(column_name, vector_expr) [APPROXIMATE|APPROX]
LIMIT num (OFFSET num);
搜索语法要求:
- 必须指定 APPROXIMATE/APPROX 关键字,搜索才会使用向量索引而非全表扫描。
- 必须包含 ORDER BY 和 LIMIT 子句。
- ORDER BY 只支持单个向量条件。
- LIMIT + OFFSET 的取值范围为 (0, 16384]。
- 不指定 LIMIT 子句会报错。
后建
创建测试表。
sql
CREATE TABLE vec_table_ivf (c1 INT, c2 VECTOR(3), PRIMARY KEY(c1));创建 IVF 索引。
sql
CREATE VECTOR INDEX vec_idx3 ON vec_table_ivf(c2) WITH (distance=l2, type=ivf_flat);搜索
sql
SELECT *
FROM vec_table_ivf
ORDER BY l2_distance(c2, '[0.1, 0.2, 0.3]') APPROXIMATE
LIMIT 10
PARAMETERS (nlist=1000);
内存稀疏索引是 OceanBase 数据库针对稀疏向量数据(大部分元素为零的向量)提供的高效索引类型,需要将索引完整的载入内存,支持 DML 和实时搜索。为了提升稀疏向量的查询性能,OceanBase 数据库集成了 VSAG 算法库的稀疏向量索引(SINDI),该索引在性能上优于基于磁盘的稀疏向量索引,适合在内存资源充足的情况下使用。
创建
内存稀疏索引支持建表时创建和后建两种方式。创建时需要注意:
- 维度上限:创建稀疏向量索引的列最大支持 500,000 维。
- 列类型:创建稀疏向量索引必须指定在 SPARSEVECTOR 类型的列上。
- 关键字:创建索引必须带有 VECTOR 关键字。
- 索引类型:支持 sindi 和 sindi_sq:sindi 表示全精度内存稀疏索引,sindi_sq 表示标量量化稀疏索引。SINDI_SQ 需在一定规模数据上建索引以降低精度损失,逻辑与 HNSW_SQ 一致。
- 距离算法:仅支持 inner_product(内积)。
- 参数一致:后建索引的参数和说明与建表时创建索引一致。
- SINDI_SQ 索引建议在写入数据后再创建索引,并在写入较多增量数据后进行索引重建:
- 如果是随表创建,则先建 SINDI,数据超过 1 万条后可重建为 SINDI_SQ。
- 如果是后建,则单分区数据不超过 1 万条创建 SINDI,超过 1 万条可直接创建 SINDI_SQ。
建表时创建
sql
CREATE TABLE table_name (
    column_name1 data_type1,
    column_name2 SPARSEVECTOR,
    ...,
    VECTOR INDEX index_name (column_name2) WITH (param1=value1, param2=value2, ...)
);
sql
CREATE VECTOR INDEX index_name ON table_name(column_name) WITH (param1=value1, param2=value2, ...);搜索
稀疏向量索引的搜索语法与稠密向量索引类似,使用 APPROXIMATE/APPROX 关键字进行近似最近邻搜索。语法如下:
sql
SELECT ... FROM table_name
ORDER BY inner_product(column_name, query_vector) [APPROXIMATE|APPROX]
LIMIT n [PARAMETERS(param1=value1, param2=value2)];- column_name:稀疏向量索引创建时指定的 SPARSEVECTOR 列。
- query_vector:查询向量,可以是稀疏向量格式的字符串,如 '{1:2.4, 3:1.5}'。
- n:返回的结果行数。
- PARAMETERS:可选的查询级参数,用于设置 drop_ratio_search 和 refine_k。
建表时创建
SINDI 示例
创建测试表 sparse_t1 并创建稀疏向量索引:
sql
CREATE TABLE sparse_t1 (
    c1 INT PRIMARY KEY,
    c2 SPARSEVECTOR,
    VECTOR INDEX sparse_idx1(c2)
    WITH (lib=vsag, type=sindi, distance=inner_product)
);
向测试表插入稀疏向量数据:
sql
INSERT INTO sparse_t1 VALUES(1, '{1:0.1, 2:0.2, 3:0.3}');
INSERT INTO sparse_t1 VALUES(2, '{3:0.3, 2:0.2, 4:0.4}');
INSERT INTO sparse_t1 VALUES(3, '{3:0.3, 4:0.4, 5:0.5}');
SINDI_SQ 示例
sql
CREATE TABLE sparse_t1_sq (c1 INT AUTO_INCREMENT, c2 SPARSEVECTOR, PRIMARY KEY(c1), VECTOR INDEX sparse_idx1_sq(c2) WITH (distance=inner_product, type=sindi_sq, lib=vsag));后建索引
SINDI 示例
创建测试表后再创建稀疏向量索引:
sql
CREATE TABLE sparse_t2 (
    c1 INT PRIMARY KEY,
    c2 SPARSEVECTOR
);

CREATE VECTOR INDEX sparse_idx2 ON sparse_t2(c2)
WITH (lib=vsag, type=sindi, distance=inner_product,
      prune=true, refine=true, drop_ratio_build=0.1,
      drop_ratio_search=0.5, refine_k=2.0);
向测试表插入稀疏向量数据:
sql
INSERT INTO sparse_t2 VALUES(1, '{1:0.1, 2:0.2, 3:0.3}');SINDI_SQ 示例
创建测试表。
sql
CREATE TABLE sparse_t2_sq (c1 INT AUTO_INCREMENT, c2 SPARSEVECTOR, PRIMARY KEY(c1));创建 SINDI_SQ 索引。
sql
CREATE VECTOR INDEX sparse_idx_sq ON sparse_table_sindi_sq(c2) WITH (distance=inner_product, type=sindi_sq, lib=vsag);搜索
sql
CREATE TABLE t1 (
    c1 INT PRIMARY KEY,
    c2 SPARSEVECTOR,
    VECTOR INDEX idx1(c2)
    WITH (lib=vsag, type=sindi, distance=inner_product)
);

INSERT INTO t1 VALUES(1, '{1:0.1, 2:0.2, 3:0.3}');
INSERT INTO t1 VALUES(2, '{3:0.3, 2:0.2, 4:0.4}');
INSERT INTO t1 VALUES(3, '{3:0.3, 4:0.4, 5:0.5}');
INSERT INTO t1 VALUES(4, '{5:0.5, 4:0.4, 6:0.6}');
INSERT INTO t1 VALUES(5, '{5:0.5, 6:0.6, 7:0.7}');

SELECT * FROM t1
ORDER BY negative_inner_product(c2, '{3:0.3, 4:0.4}')
APPROXIMATE LIMIT 4;
使用查询参数
sql
SELECT *, negative_inner_product(c2, '{3:0.3, 4:0.4}')
AS score  FROM t1
ORDER BY score APPROXIMATE LIMIT 4
PARAMETERS(drop_ratio_search=0.5);