摘要:
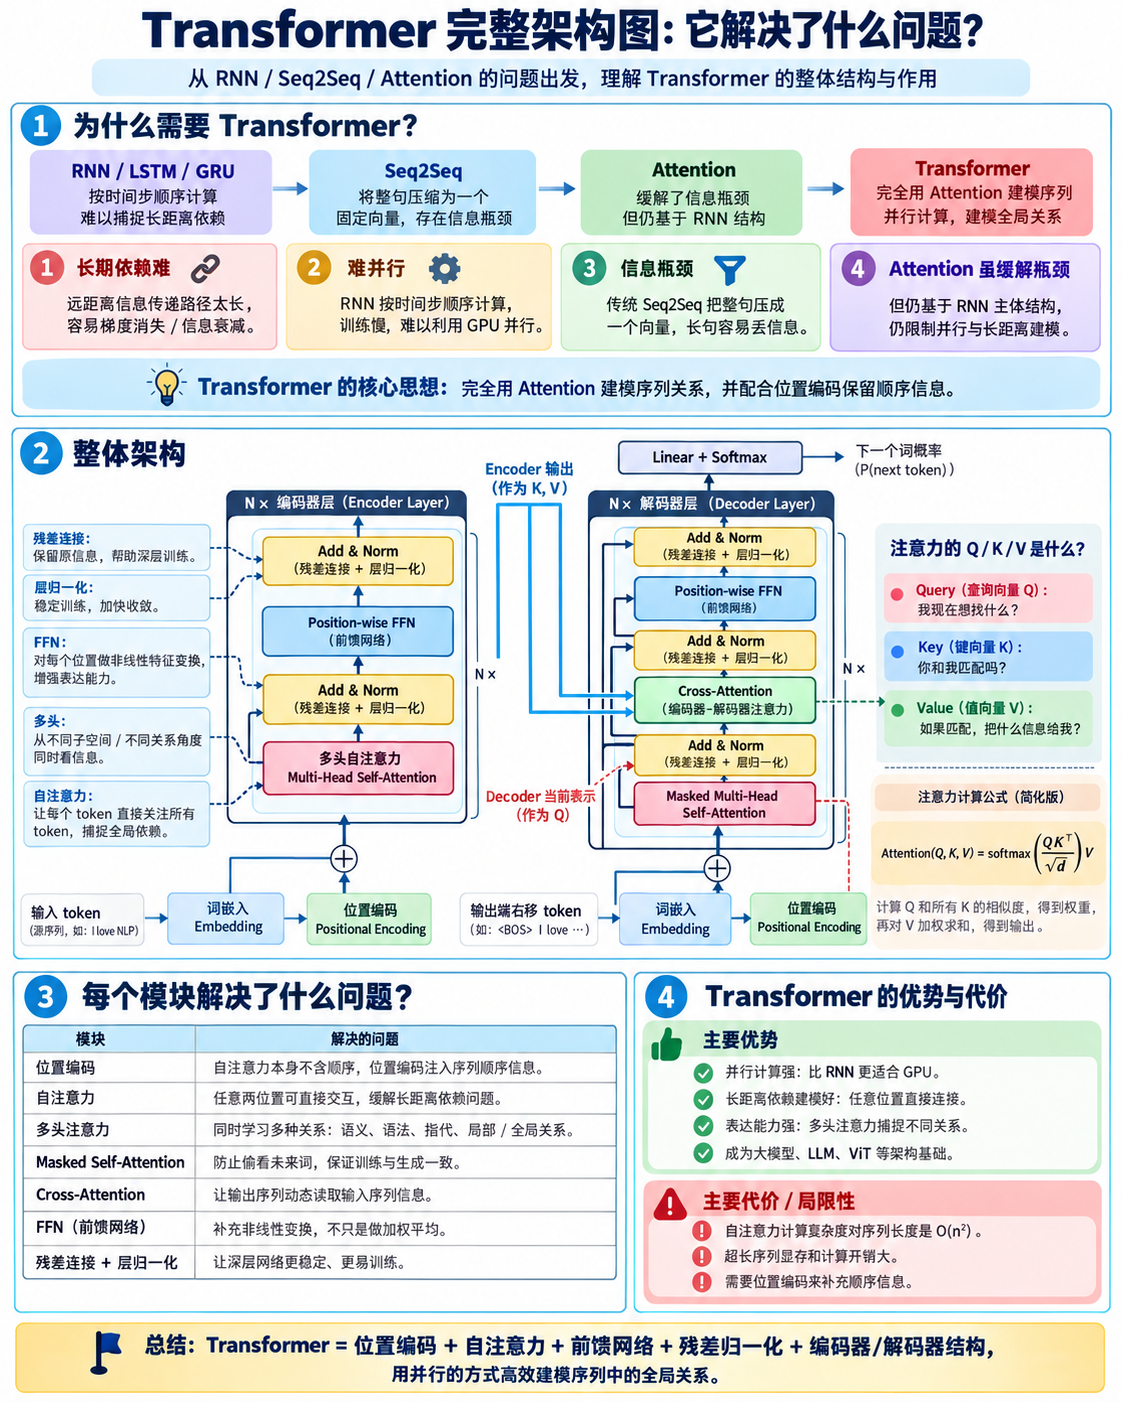
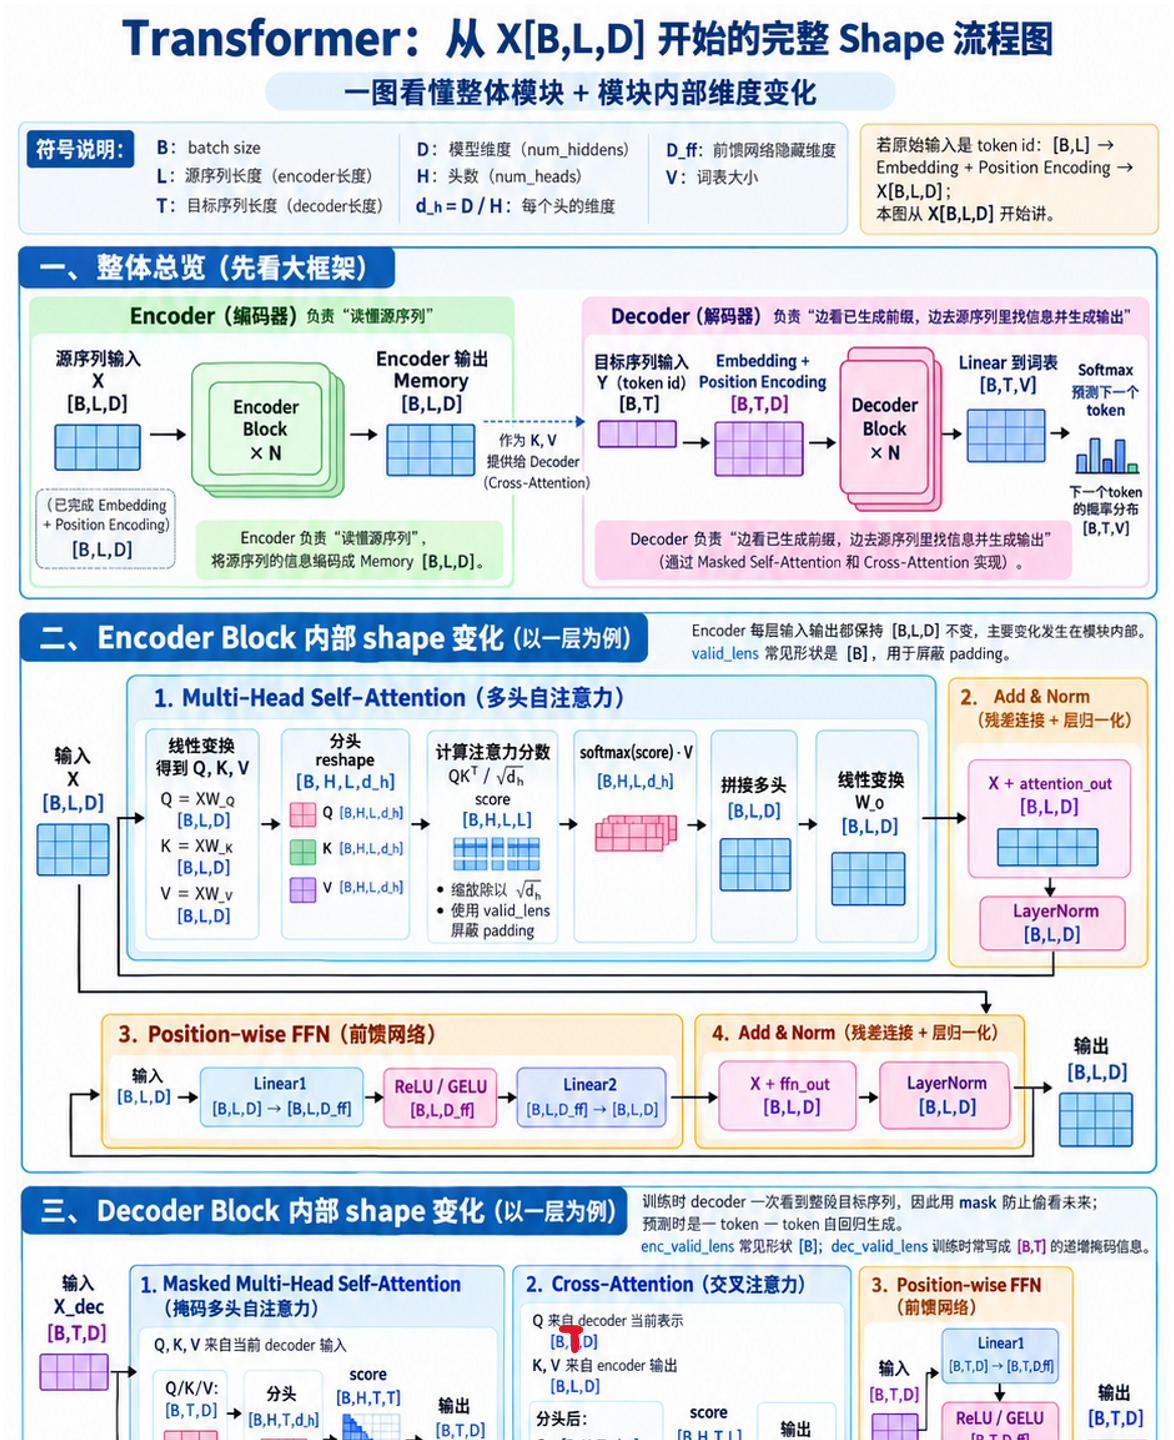
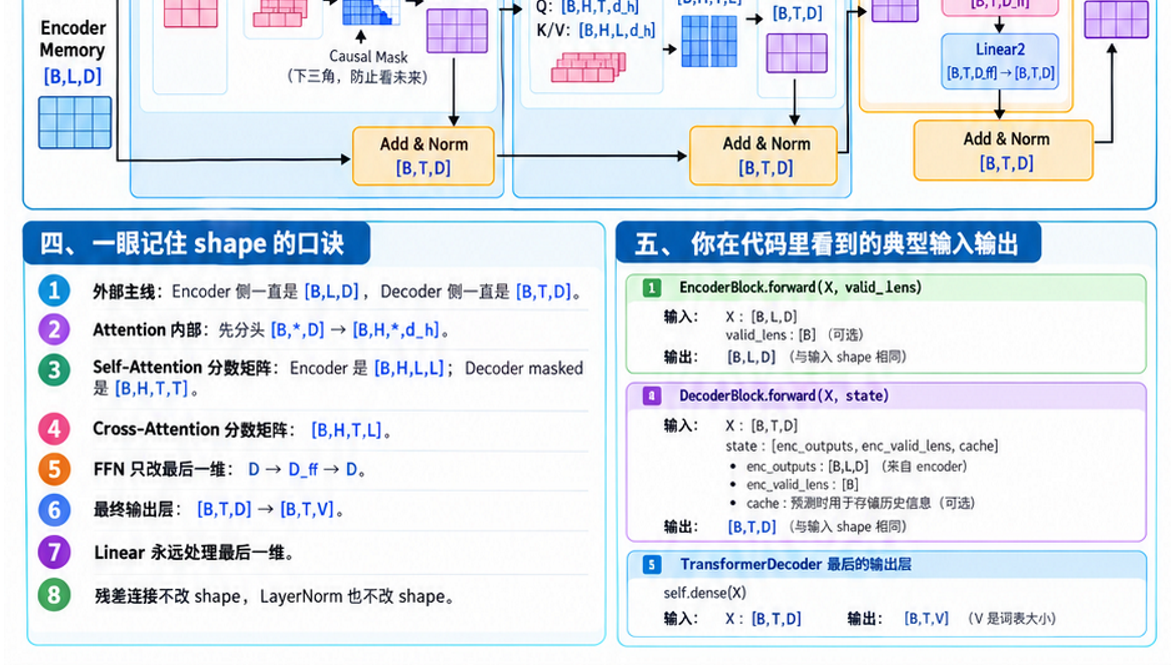
本文围绕 Transformer 架构的核心设计展开,逐步拆解自注意力机制、位置编码、多头注意力、前馈网络、残差连接与层归一化等关键组件,并深入分析 Encoder-Decoder 结构、Masked Self-Attention、Cross-Attention 与自回归生成机制,帮助读者理解 Transformer 为何能取代 RNN 成为现代序列建模的基础架构。
关于正则化:
正则化是用在损失函数里面用来防止模型追着噪声点学习把模型搞得特别复杂,惩罚因子越大模型正则化水平越高越不容易过拟合,但是过大的正则化也会导致模型捕捉细节能力不强
关于对模型的思考:
这个问题的数据结构是什么?模型认为信息应该怎样传播?为什么这种传播机制适合这个问题?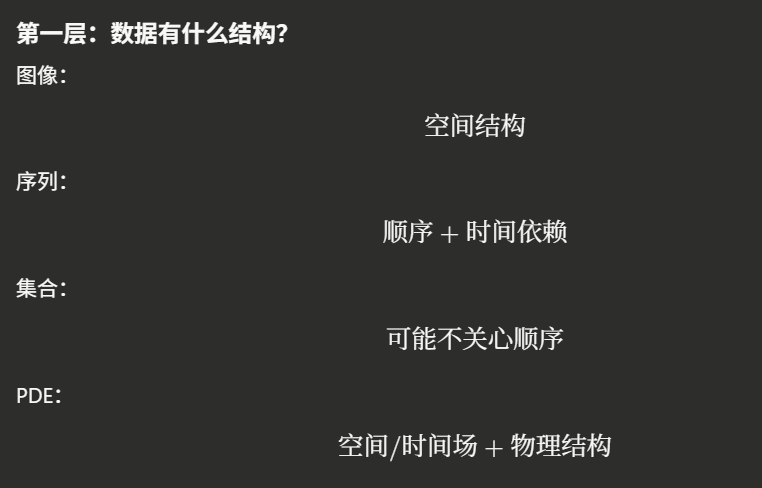
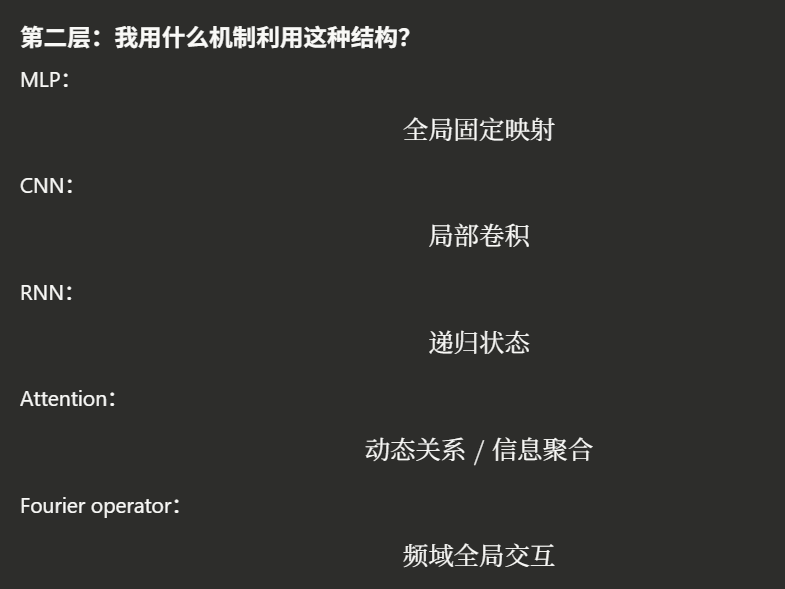
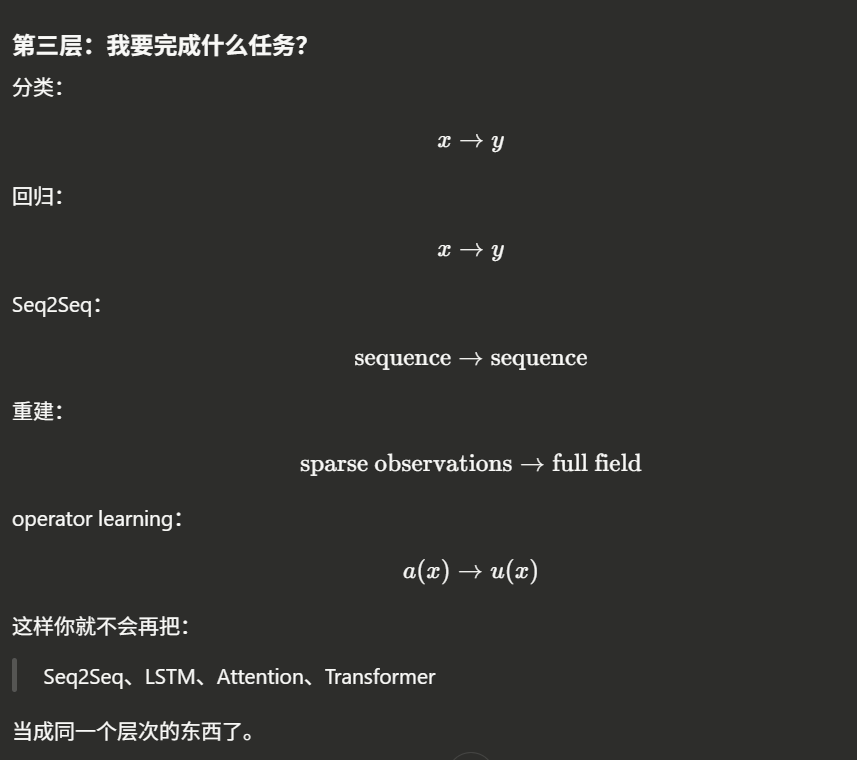
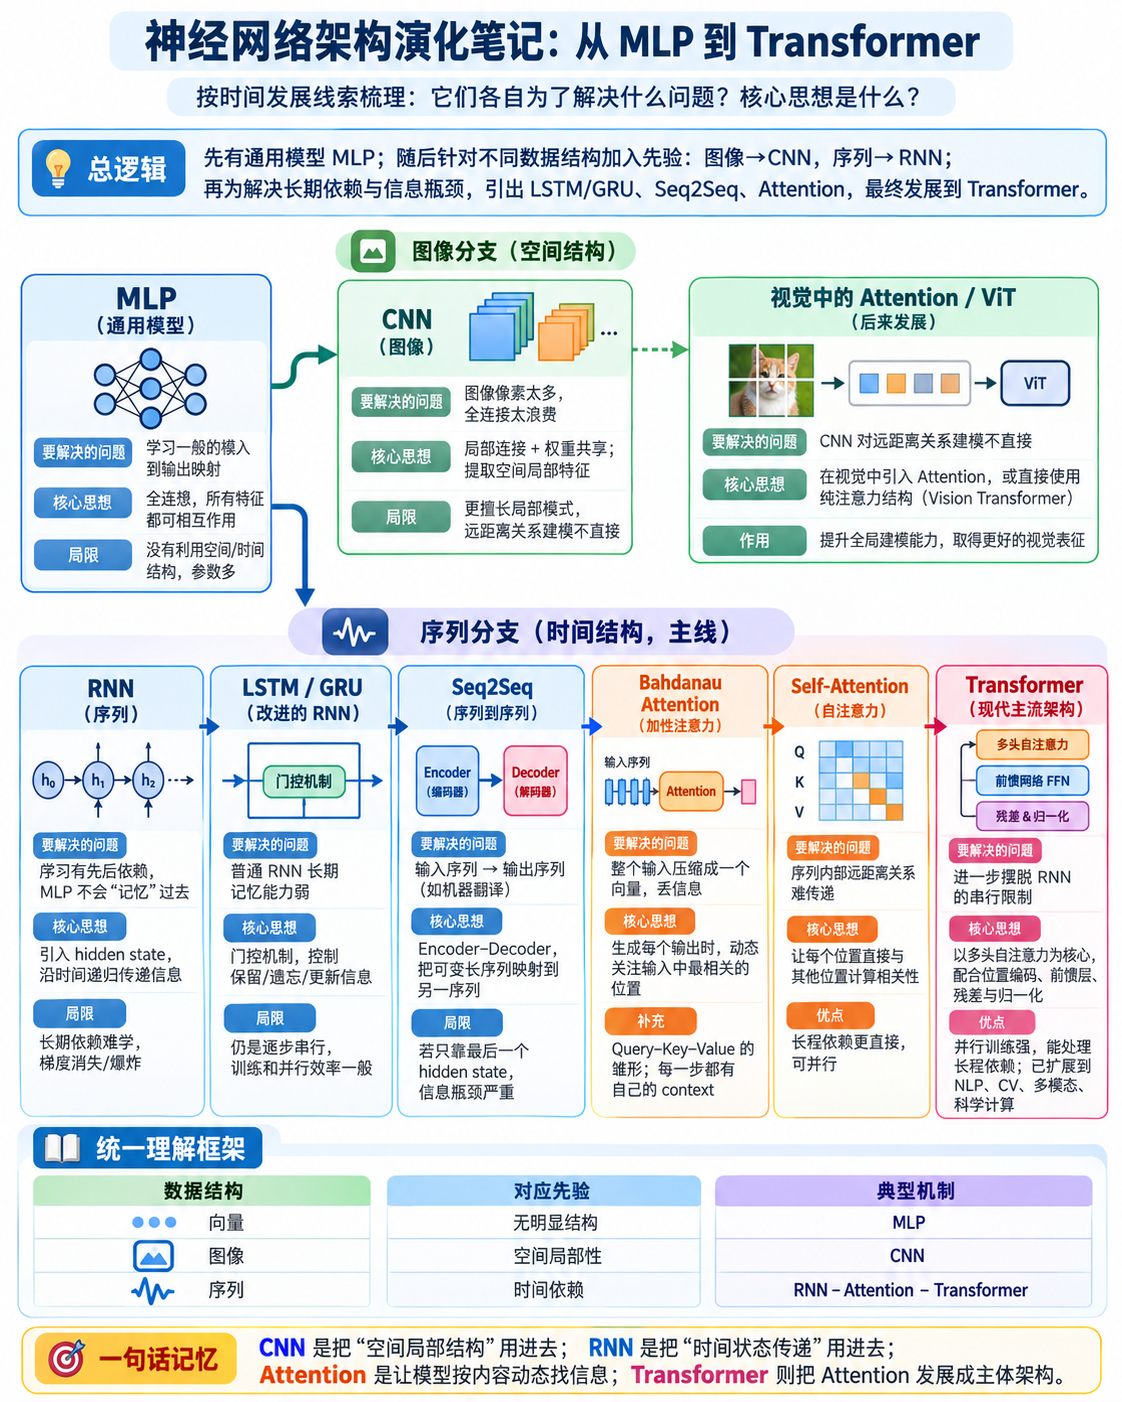
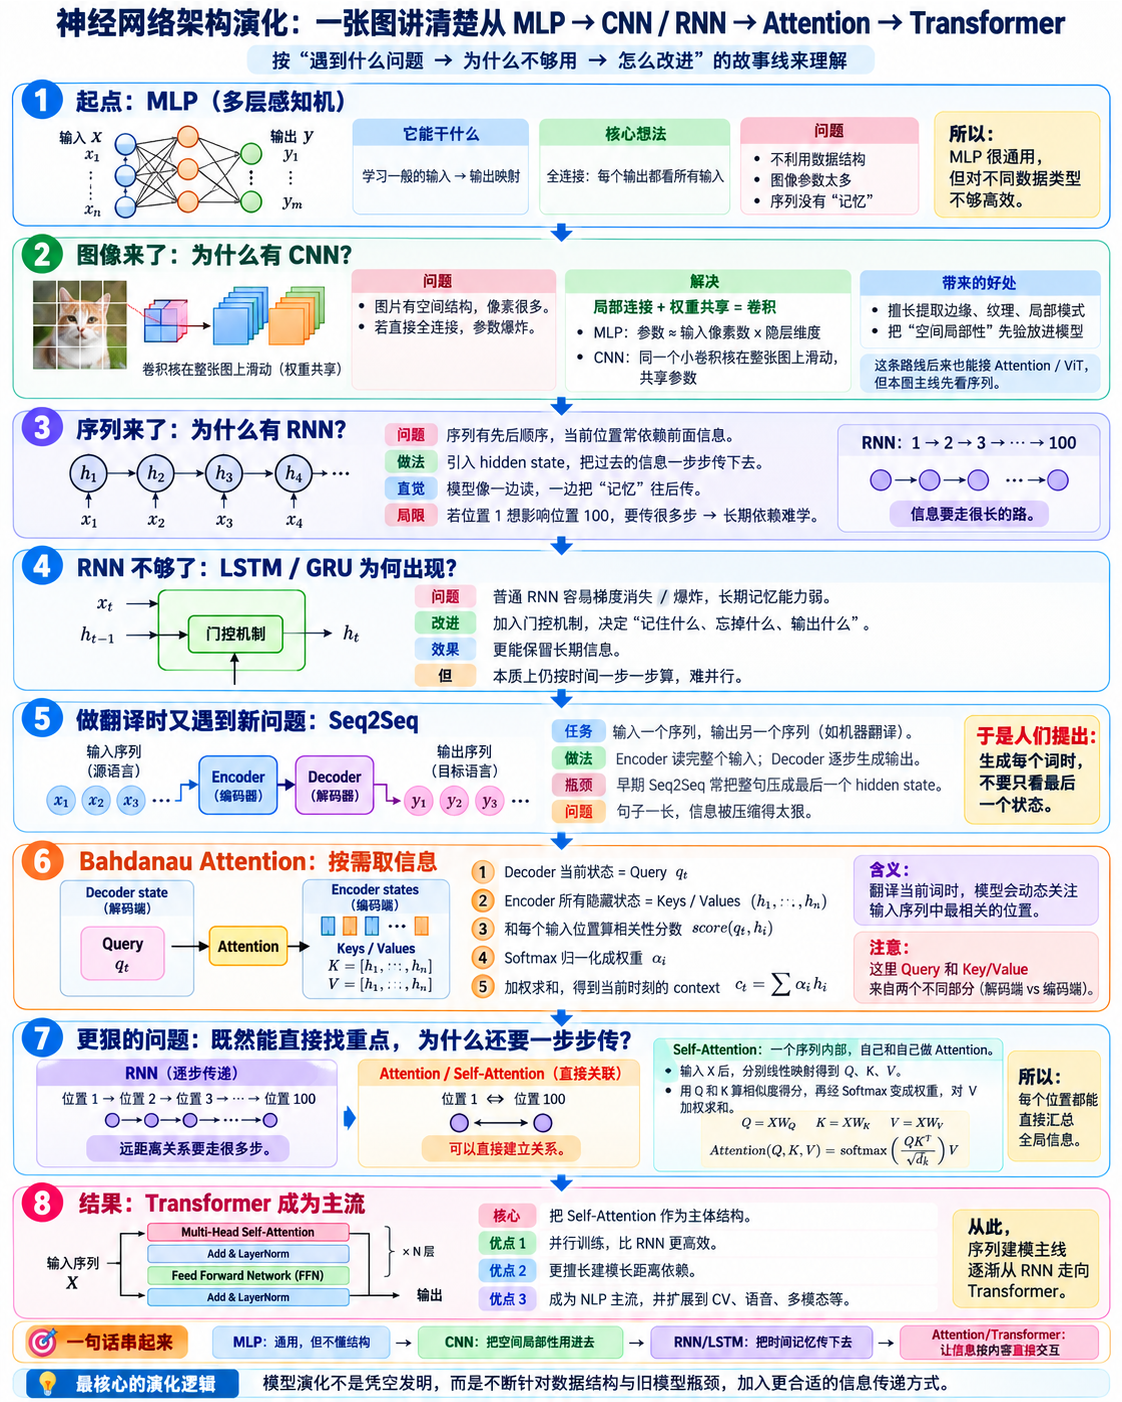
神经网络演化:
Transformer:
自注意力+位置编码?
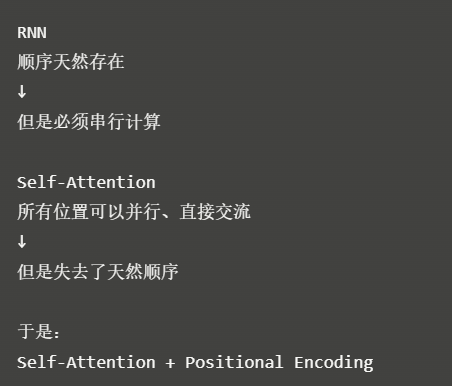
位置编码从何而来:
如果 Self-Attention 天生不知道顺序,那我要人为给每个位置发一张什么样的"位置身份证"?
绝对信息位置vs相对信息位置
编码要求:连续+有规律+任意编码------>偶sin,奇cos---->多频率位置编码:p_i=sin(i),sin(i/100),....
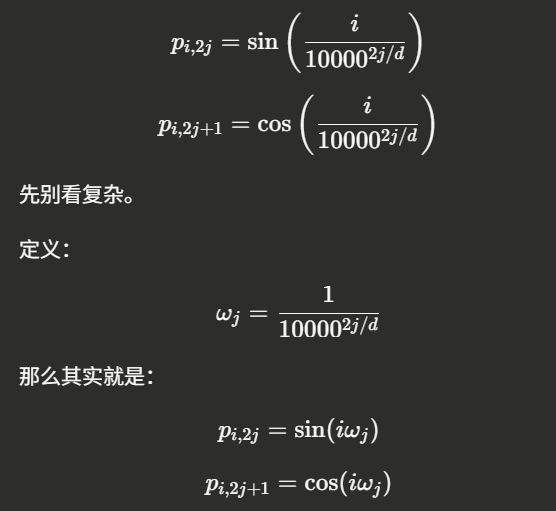
i:当前位置编号;j:第几个频率;d:维度
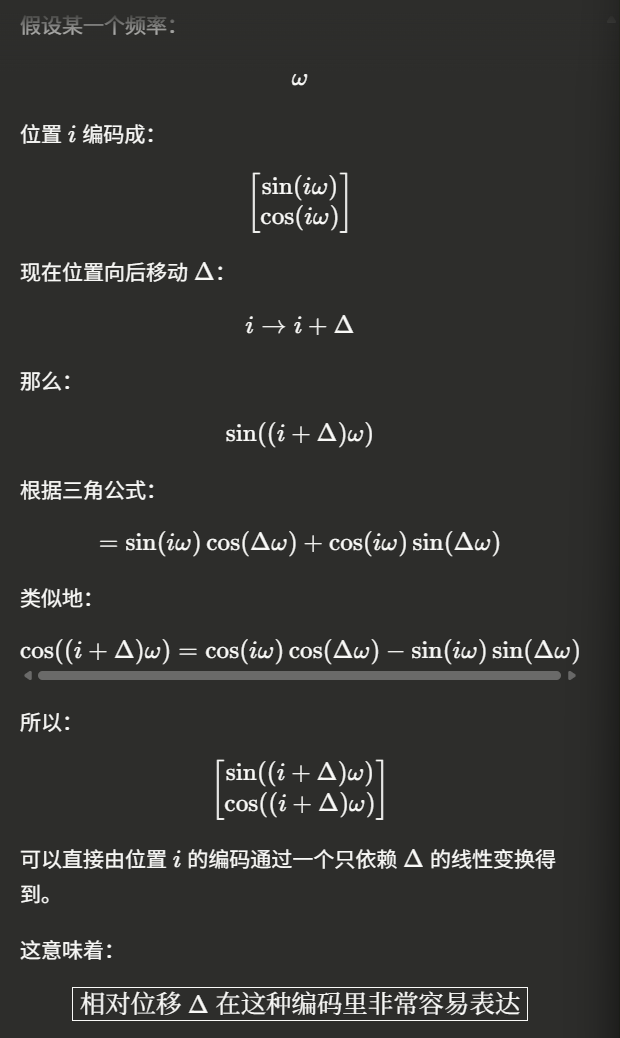
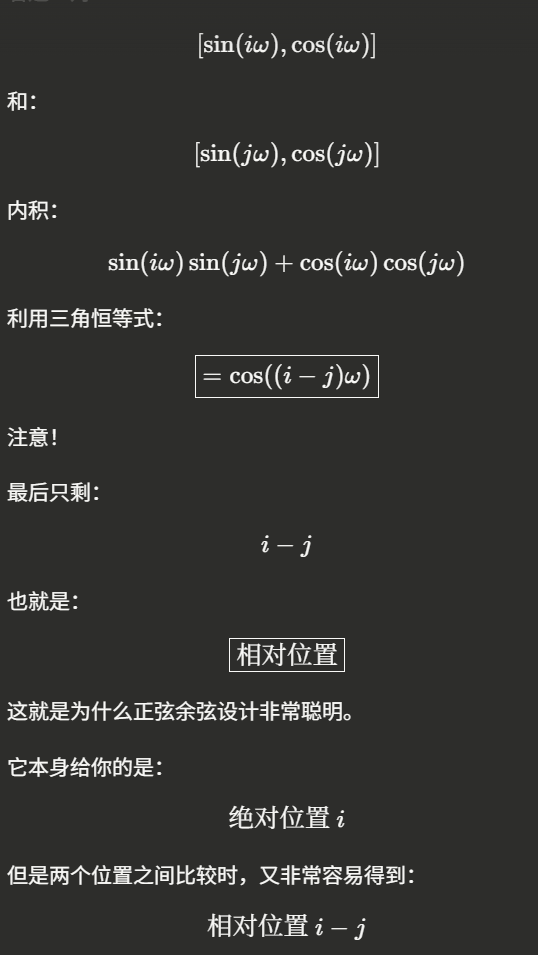
优点1:相对位移好表达 优点2:内积出现位置差
transformer的来源:
seq2seq(输入-->输出)我保留,里面的RNN我能不能用Attention把encoder和decoder重新造一遍?
面临的一系列问题:
没有RNN了
↓
顺序信息没了
→ Positional Encoding
一层Attention表达关系太单一
→ Multi-Head Attention
Attention主要负责"从别人那里拿什么"
但拿回来之后还要加工
→ FFN
堆很多层以后网络不好训练
→ Residual Connection + LayerNorm
我要做翻译:
输入英文,输出中文
→ Encoder + Decoder
Decoder训练时能看到完整中文答案
那岂不是偷看未来?
→ Mask
预测时又不可能一次知道整句答案
→ Autoregressive
解决问题的模块及其作用:
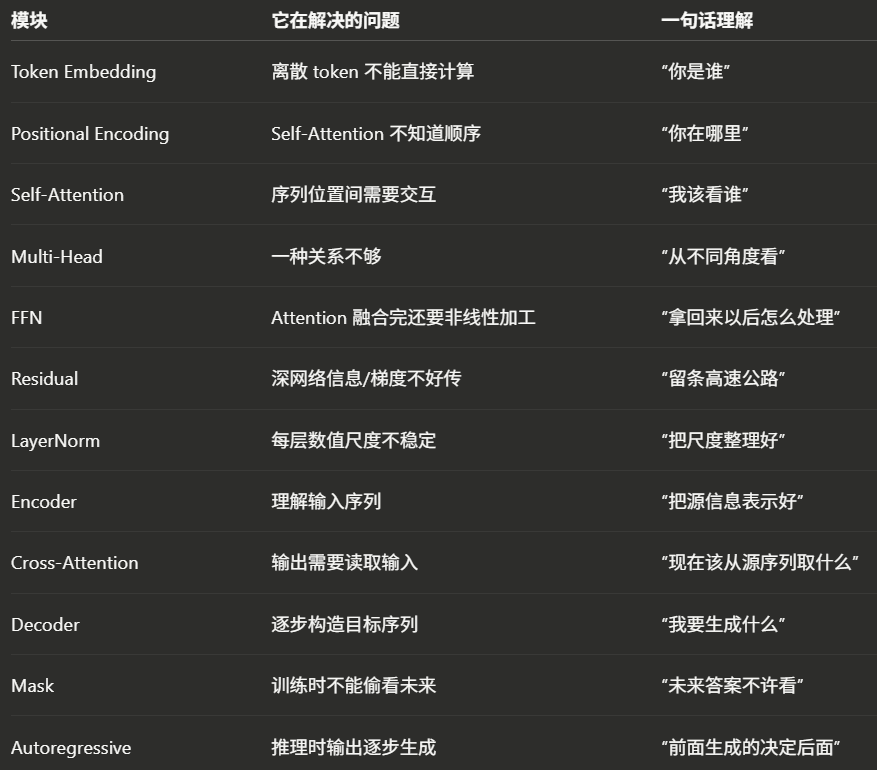
注:
**多头注意力:**多个head学习不同特征彼此独立,关于得分函数:transformer中一般采用放缩点积注意力。
attention得到了什么: layernorm解决的:
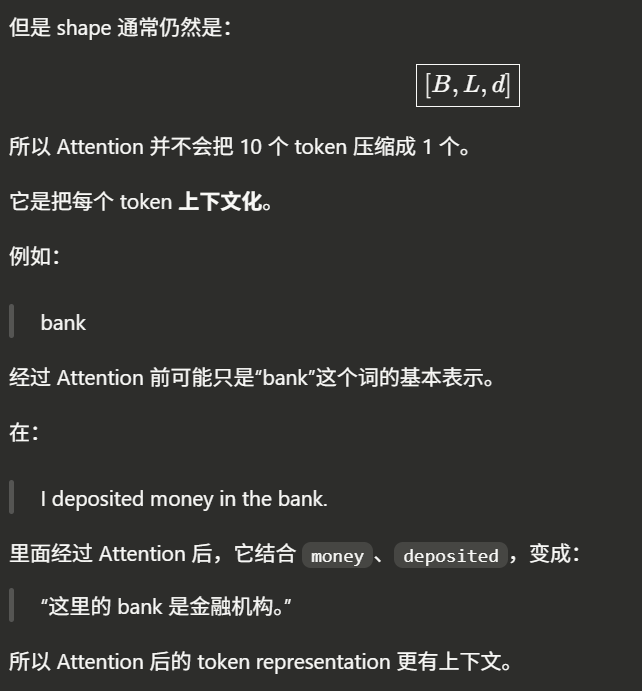
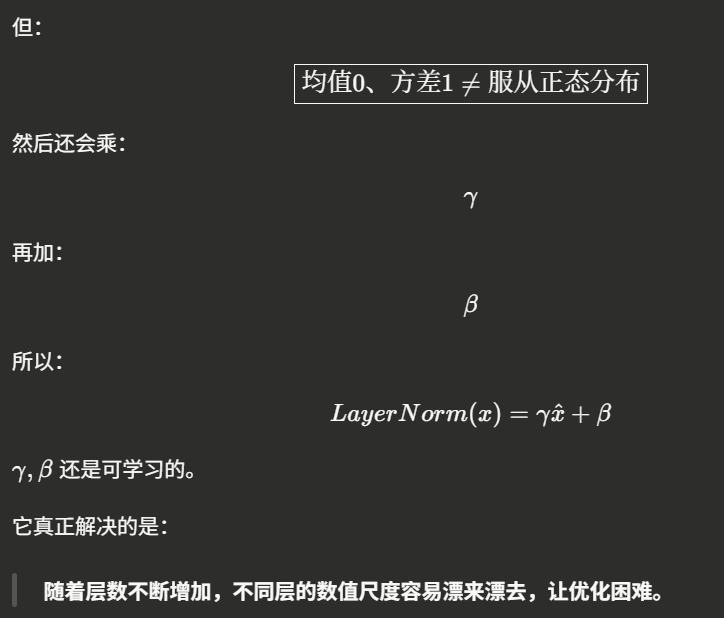
FFN全称:position-wise feed-forward network 逐位置前馈网络 小mlp 先升维后降维
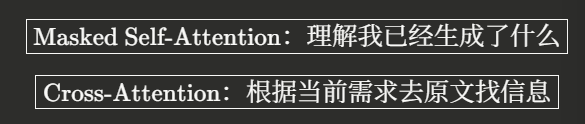
为啥先masked self-attention后cross-attention?
以翻译模型为例,要想知道我要去英文里面查什么,取决于我中文现在已经写到哪里了。
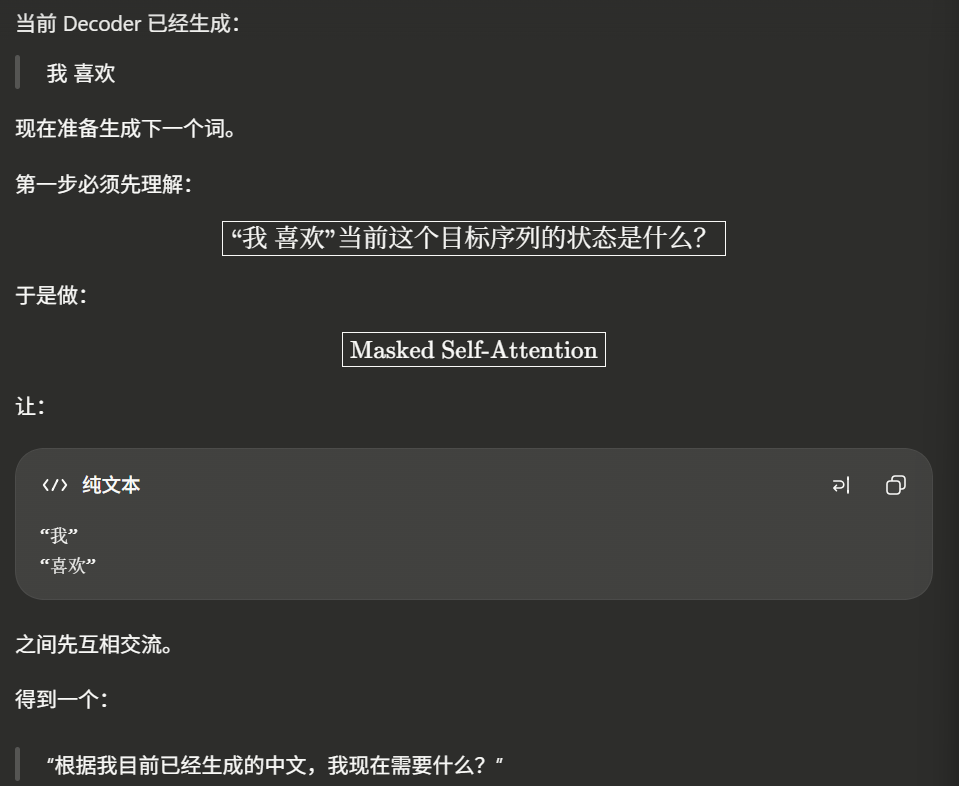
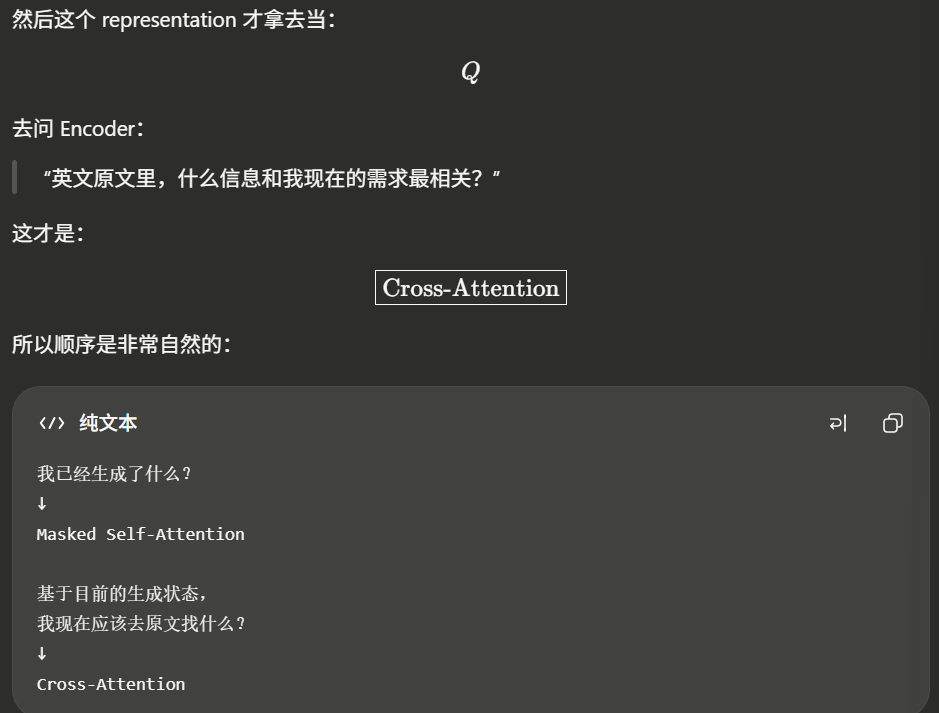
masked self-attention:当前位置只允许利用已经生成的过去,不允许利用未来答案。
cross attention:以我当前生成状态来看,原文哪个位置对我有用。(Bahdanau attention)
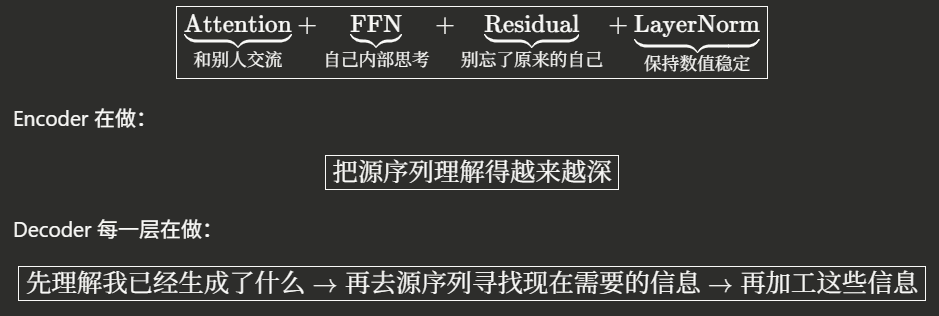
Q1:Bahdanau Attention 已经有 Attention 了,Transformer 为什么还值得出现?
Bahdanau Attention 虽然允许 Decoder 动态关注 Encoder 的不同位置,但 Encoder 和 Decoder 主体仍然是 RNN,存在串行计算和长距离依赖的问题。Transformer 进一步使用 Self-Attention 替代 RNN 的主要递归结构,使序列内部任意位置可以直接交互,并能够并行计算。
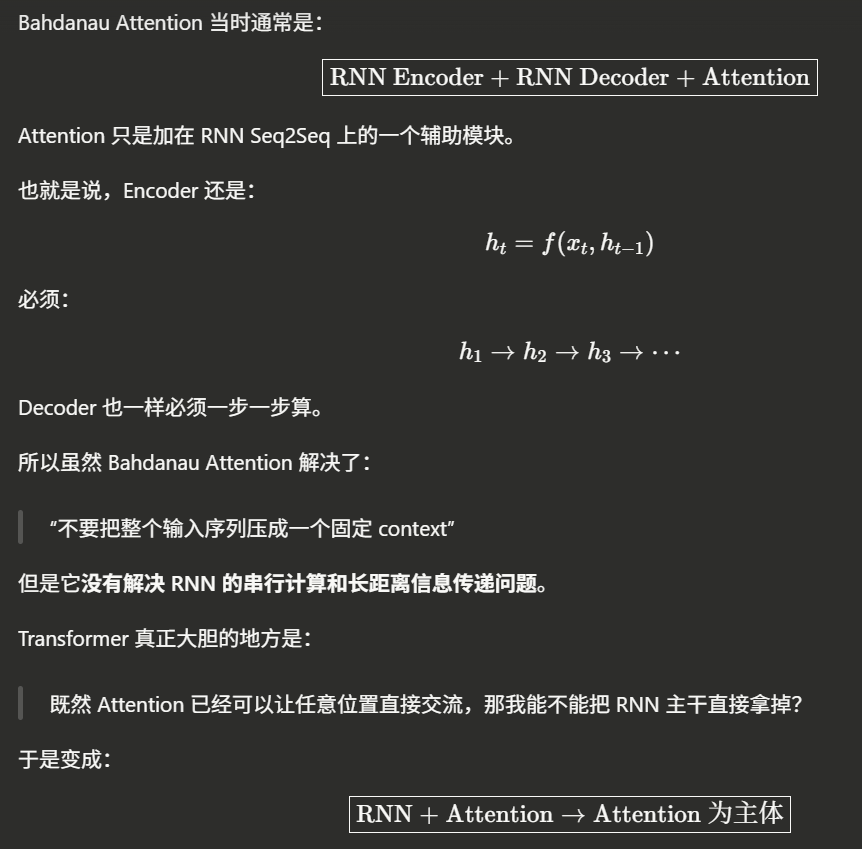
Q2:Decoder 为什么有 Masked Self-Attention 和 Cross-Attention?
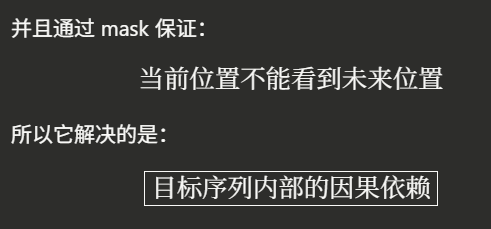
Q3:如果把 Mask 拿掉,训练翻译模型时会发生什么?
mask防止训练时偷看答案,使训练符合自回归生成规则。
transformer架构: