摘要:AIGC多模态内容生产系统正在成为内容工厂、电商运营、教育实训的"下一代生产力"。本文以一套落地级系统为蓝本,从底层架构、模型接入、ControlNet 控制网络、Lora 风格化、画面分区、后期修复、OpenPose 姿态编辑,到 Lora 模型训练的全链路,逐层拆解一套生产级 AIGC 多模态内容生产系统的工程实现。
一、为什么我们需要一套 AIGC 多模态内容生产系统
过去两年,团队陆续接到三类典型需求:
- 教学场景:老师每周要做 50~80 张配图,Stable Diffusion WebUI 用得太深;
- 电商场景:运营每款商品需要"模特 + 场景 + 风格"多版本图生图,Photoshop 改不完;
- 实训场景:学生要系统学 SD3.5 / Flux.2 / ControlNet / Lora 训练,光装环境就劝退 80%。
三类需求背后是同一个问题:零散的 WebUI 工具无法支撑"流水线化、可审计、可复训"的生产诉求。因此我们落地了一套 AIGC 多模态内容生产系统,把文生图、图生图、ControlNet、Lora 训练、姿态编辑、画面分区、后期修复、反推标签全部收口到一个统一 Web 平台里。
二、整体架构:一张图看懂 AIGC 多模态内容生产系统
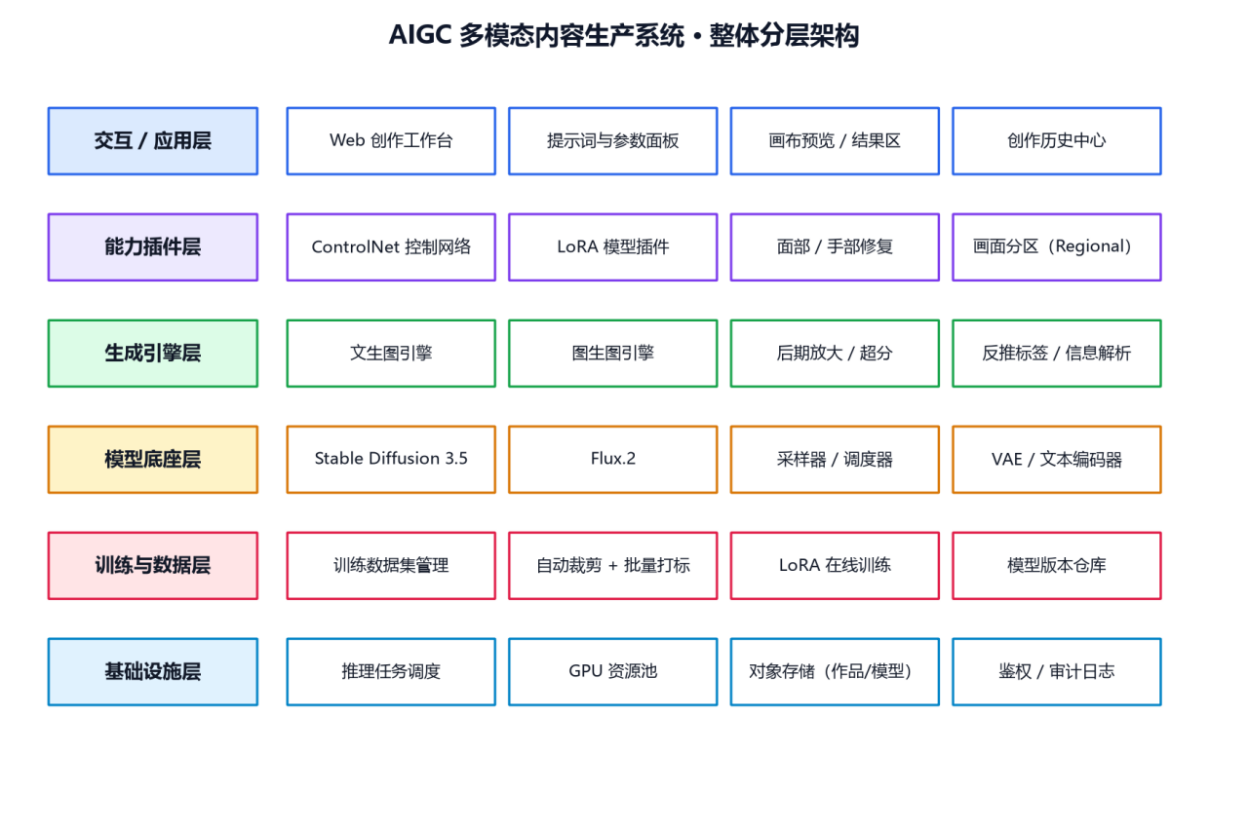
AIGC多模态内容生产系统整体架构
系统自下而上分为四层:
- 模型层:Stable Diffusion 3.5、Flux.2 作为生图主模型;ControlNet 作为控制网络;Lora 作为风格适配器;人脸修复、手部修复、画面分区、反推标签作为附加模型集。
- 服务层:模型调度器负责加载/卸载/显存复用;任务队列把 Web 请求转成推理 Job;缓存层保存提示词、参数、历史图与训练数据集元信息。
- 能力层:将底层模型封装为可调用能力------文生图、图生图、ControlNet 生成、Lora 推理、脸手修复、画面分区、后期放大、OpenPose/3D OpenPose 编辑、反推标签。
- 应用层:Web 工作台(创作入口)、训练工作台(Lora 训练)、OpenPose 编辑器、历史画廊、标签检索。
这套架构有一个关键设计:模型层与能力层解耦。模型层允许同时挂多个 SD3.5 / Flux.2 实例,能力层只通过统一的"模型 ID + 参数 schema"访问,新增模型不需要改前端。
三、文生图:从提示词到像素的完整链路
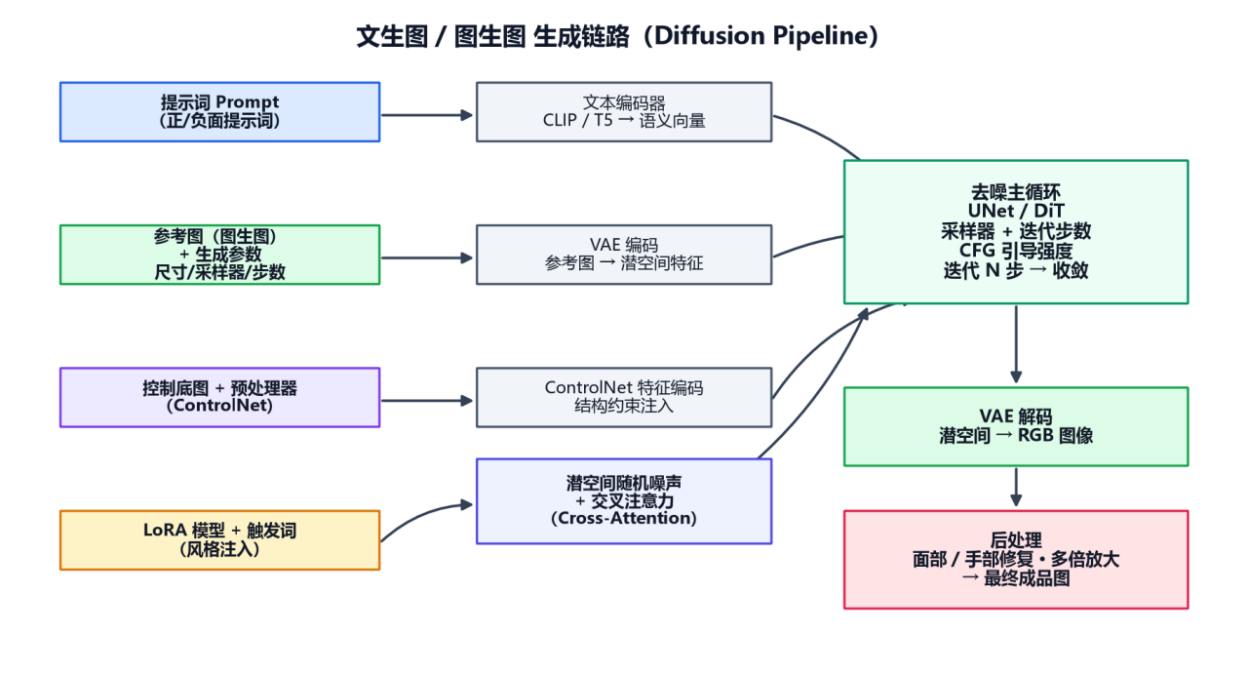
文生图与图生图生成链路
文生图入口参数包含:模型选择(SD3.5 / Flux.2)、提示词(正向/负向)、图片尺寸、采样方法(DPM++ 2M / Euler / DPM++ SDE)、迭代步数(Steps)、CFG Scale、Seed、批次(Batch)。系统把这些参数组装成一个 `GenerationJob` 对象提交到任务队列。
工程上有三个细节值得展开:
细节 1:采样方法与迭代步数的组合。SD3.5 在 30 步 + DPM++ 2M Karras 下出图稳定,Flux.2 在 20~28 步 + Euler 下更锐利。生图系统在保存历史时会同时记录 `sampler_name` 与 `steps`,这样复算时不需要猜。
细节 2:提示词版本管理。很多团队出图效果忽好忽坏,问题就出在提示词没归档。我们把每次出图的提示词写入数据库的 `prompt_history` 表,配合创作历史页可按提示词反查。
细节 3:显存复用。同一张显卡同时跑 SD3.5 和 Flux.2 极易 OOM。系统采用"模型实例懒加载 + 显存上限阈值",空闲 5 分钟自动卸载,下次请求时按队列延迟加载。
四、图生图:参考图 + 提示词 + 参数的三元组
图生图与文生图共用同一推理后端,差异在输入侧:除了提示词,还要上传一张参考图,并设置去噪强度(Denoising Strength)。强度 0.3~0.45 适合"换风格保构图",0.55~0.7 适合"保留大意重画细节",0.8 以上基本等于文生图。
落地经验:电商场景中图生图的 80% 失败案例都源于"参考图尺寸与目标尺寸不一致"。系统强制要求参考图长宽比与目标尺寸一致,否则自动 padding 到同一长宽比,避免人脸/产品被拉伸。
五、ControlNet 控制网络:让生成结果"听话"
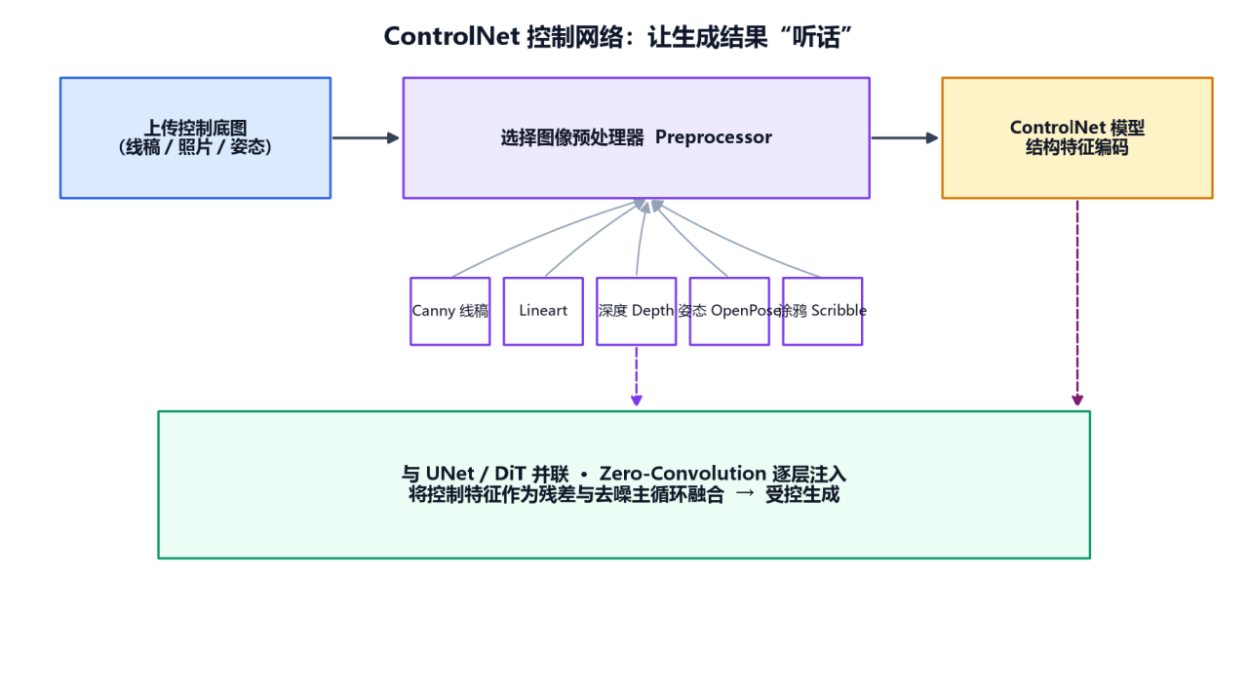
ControlNet控制网络流程
这是整套 AIGC 多模态内容生产系统里复用度最高的模块。
工作流:
- 用户上传一张控制底图(线稿 / 深度图 / 姿态图);
- 选择图像预处理器(Preprocessor):Canny 线稿、Lineart、深度 Depth、姿态 OpenPose、涂鸦 Scribble 等;
- 选择 ControlNet 模型(与预处理器配套);
- 系统生成条件特征图,通过 Zero-Convolution 逐层注入到 UNet/DiT;
- 生成结果在构图、姿态、深度上严格遵循控制底图。
工程实现要点:
- 多 ControlNet 串联:支持同时启用多个 ControlNet(如线稿 + 姿态),每个通道独立配置权重(Control Weight)与起始/终止步数(Start/End Step);
- 预处理器缓存:同一张底图 + 同一预处理器的结果会被缓存,避免重复跑 Canny;
- 可视化对照:生成页左侧显示"控制底图 + 预处理结果 + 最终成图"三栏,定位问题非常快。
六、Lora 模型插件:把风格装进模型
Lora(Low-Rank Adaptation)是生产流水线里成本最低的"风格定制"方案。本系统支持:
- Lora 选择器:每个 Lora 有专属缩略图与风格描述,便于运营挑选;
- 权重调节:单 Lora 权重 0~1.2,多 Lora 叠加时按"主风格权重高、辅风格权重低"的经验排布;
- 触发词提示:每个 Lora 可配置 trigger words,自动追加到正向提示词前。
实践中我们发现一个常见误区:把所有 Lora 都拉到 0.8~1.0。正确做法是"主 Lora 0.7 + 辅 Lora 0.3",再叠加 Lora Hairstyle Fix 0.4 修发型,效果会干净很多。
七、脸部手部修复与画面分区:把"细活"交给专门模型
7.1 脸手修复
生图最大的痛点之一就是脸崩和手指畸形。本系统接入专门的人脸修复模型(如 GFPGAN、CodeFormer)与手部修复模型,作为后处理插件挂在生成链路尾部:
- 在 `face_fix_strength` ≥ 0.5 时启用全脸修复;
- 在手部检测置信度低于阈值时启用手部修复;
- 修复结果与原图通过泊松融合,避免"修复脸很清晰但和脖子断层"的尴尬。
7.2 画面分区
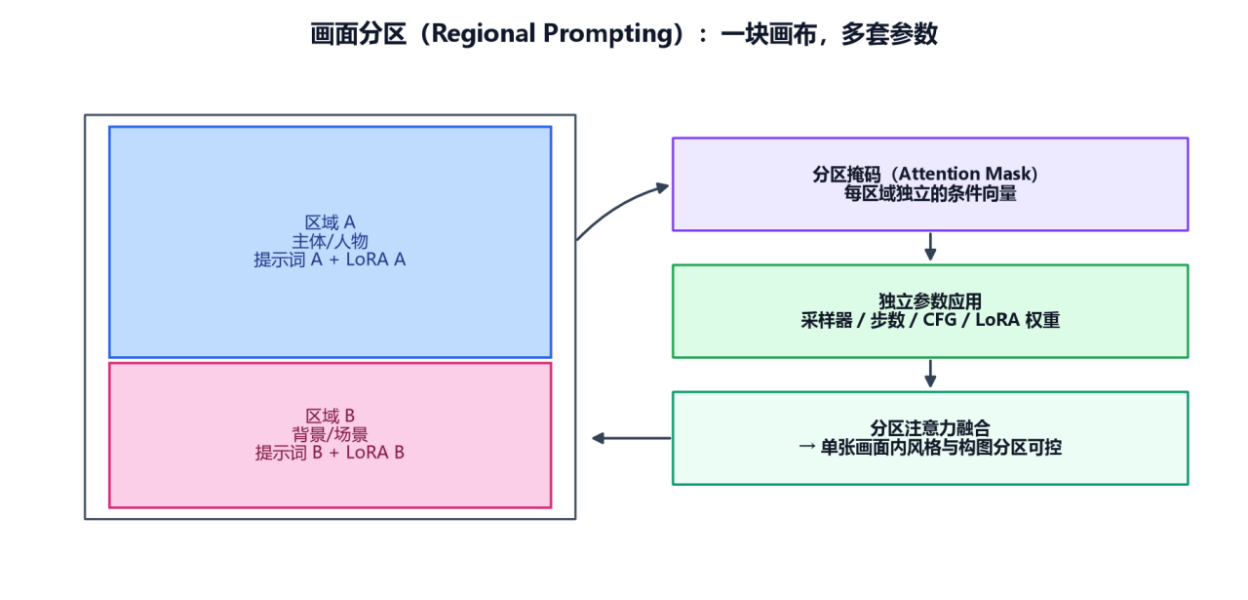
画面分区原理
一张图里不同区域需要不同 Lora、不同提示词、不同参数,这在电商场景特别常见------人物区域要"写实人像 Lora",产品区域要"商业摄影 Lora",背景区域要"风景 Lora"。
实现思路:
- 用户在画布上用矩形/笔刷画出多个 Region;
- 每个 Region 绑定独立的提示词 + Lora + 参数;
- 系统为每个 Region 生成一张与原图同尺寸的注意力掩码(Attention Mask),推理时按区域分别施加控制;
- 最终结果在边界处做 alpha blending,避免硬接缝。
这套机制在"同一画面内出现人 + 物 + 背景"且需要不同风格时,效果显著优于"全局统一提示词"。
八、后期处理与图片信息解析
8.1 后期放大
生产环境下,分辨率永远不够。系统内置多倍放大器(2x / 4x),底层是 Real-ESRGAN 系列的轻量化版本,并支持 Tile 模式以降低显存占用。
8.2 图片信息解析
每张生成图都会写入 PNG 元信息(Metadata),包含完整提示词、参数、模型哈希、Lora 列表、Seed。用户把生成图拖回系统的"图片信息"页面,可以一键还原所有参数并重新出图。这一步看似不起眼,却是团队协作的命脉------运营把图丢给设计师,设计师能直接"复算"。
九、OpenPose 与 3D OpenPose 编辑器
9.1 OpenPose 编辑器
很多场景需要"先定姿态,再生成画面",比如教学插画、动态漫画。系统的 OpenPose 编辑器支持:
- 在画布上手动调整关节点(17 个 Keypoint);
- 多人姿态组合(最多 6 人);
- 一键发送到 ControlNet,作为姿态控制底图。
9.2 3D OpenPose 编辑器
3D 版更进一步:用户可以在三维空间里旋转、缩放人体模型,导出多视角姿态图,再交给 ControlNet。这种工作流在"生成多角度同人物图"场景下比 2D 编辑器高效得多。
十、图片反推标签器:从画面反推提示词
反向需求同样高频:手上有一张图,想知道用什么提示词能复现。系统的反推标签器会输出:
- 主体识别(人物 / 物品 / 场景);
- 风格标签(写实 / 二次元 / 油画);
- 构图标签(特写 / 全身 / 俯视);
- 关键词权重建议(哪些词在原图中可能更关键)。
反推结果可以直接作为新一次文生图的提示词初值,再人工微调。
十一、创作历史与按提示词搜索
所有出图都会写入历史画廊,关键字段:
- 缩略图、模型、提示词、参数、Seed、生成耗时、用户;
- 支持按"提示词关键字"全文检索;
- 支持按模型、Lora、参数组合筛选;
- 一键"复算"------把历史参数作为模板再次提交。
这一步把 AIGC 多模态内容生产系统从"工具"升级为"团队的资产库"。
十二、Lora 模型训练:从数据集到模型文件
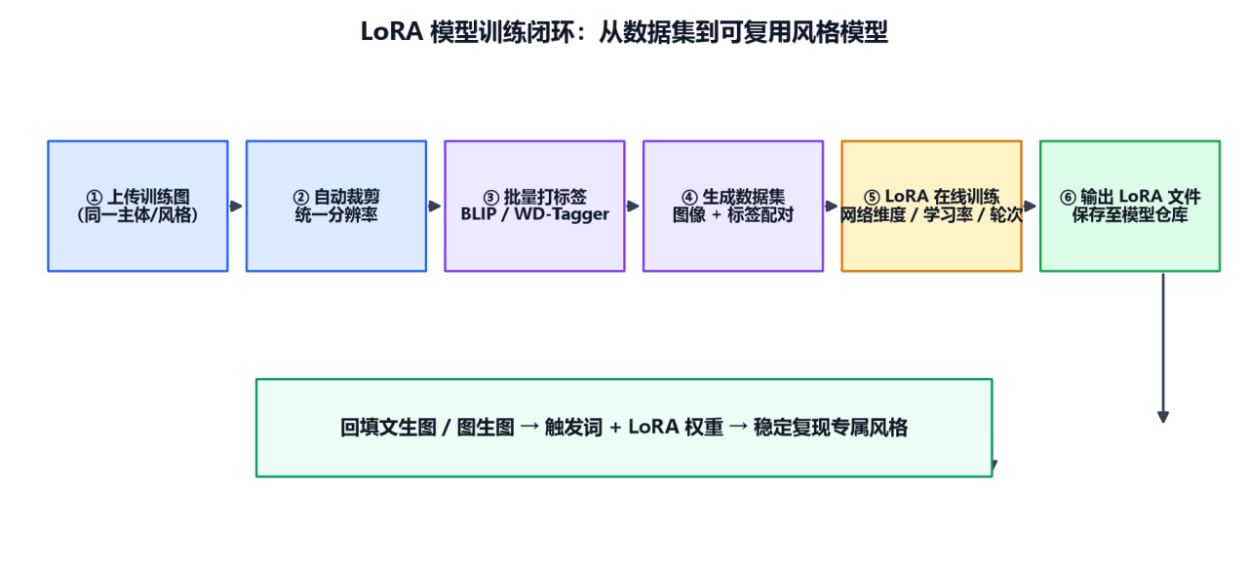
Lora训练与推理链路
12.1 训练数据集
- 上传图片:支持批量上传,自动按上传时间/批次归类;
- 自动裁剪:对非正方形图片按主体居中自动裁剪到 512x512 / 768x768 / 1024x1024;
- 批量打标签:调用反推标签器为每张图生成初始标签,用户在 UI 里二次微调(改词、删词、加权重);
- 标签版本化:每改一次标签生成一个新版本,可回滚。
12.2 Lora 训练
- 训练参数:底模型(SD3.5 / Flux.2)、训练步数、学习率、Batch Size、Lora Rank、网络结构(LoRA / LoCon / LoHa);
- 过程监控:每隔 N 步保存一个 checkpoint,可在画廊中预览训练曲线效果;
- 训练完成:返回 `.safetensors` 文件,自动写入 Lora 库,下次文生图/图生图直接选用。
生产经验:训练一个稳定的角色 Lora 通常需要 30~50 张图、1500~3000 步、Rank 32~64。少于此容易欠拟合,多于此容易过拟合------判断标准是"不同提示词下,角色的脸部/服饰/关键特征是否稳定"。
十三、落地挑战与生产级实践
把上面所有模块装进一个生产系统,远比 demo 复杂:
- 显存调度:多用户并发抢卡,需要"显存配额 + 排队 + 优先级";
- 任务可重试:推理失败要自动重试,并切换备用模型实例;
- 生成审计:所有出图必须留痕,满足合规;
- 训练沙箱:Lora 训练吃满显卡,要隔离到专用节点;
- 模型热更新:SD3.5 / Flux.2 升级不能停服;
- 教学友好:实训场景下,老师要能一键锁定参数模板,让学生只调提示词。