↵现代 Agent 不只有模型和提示词。这一节把竞争从「哪个模型更强」挪到模型外面:上下文、工具、约束、验证和纠正,合在一起才是能跑起来的系统。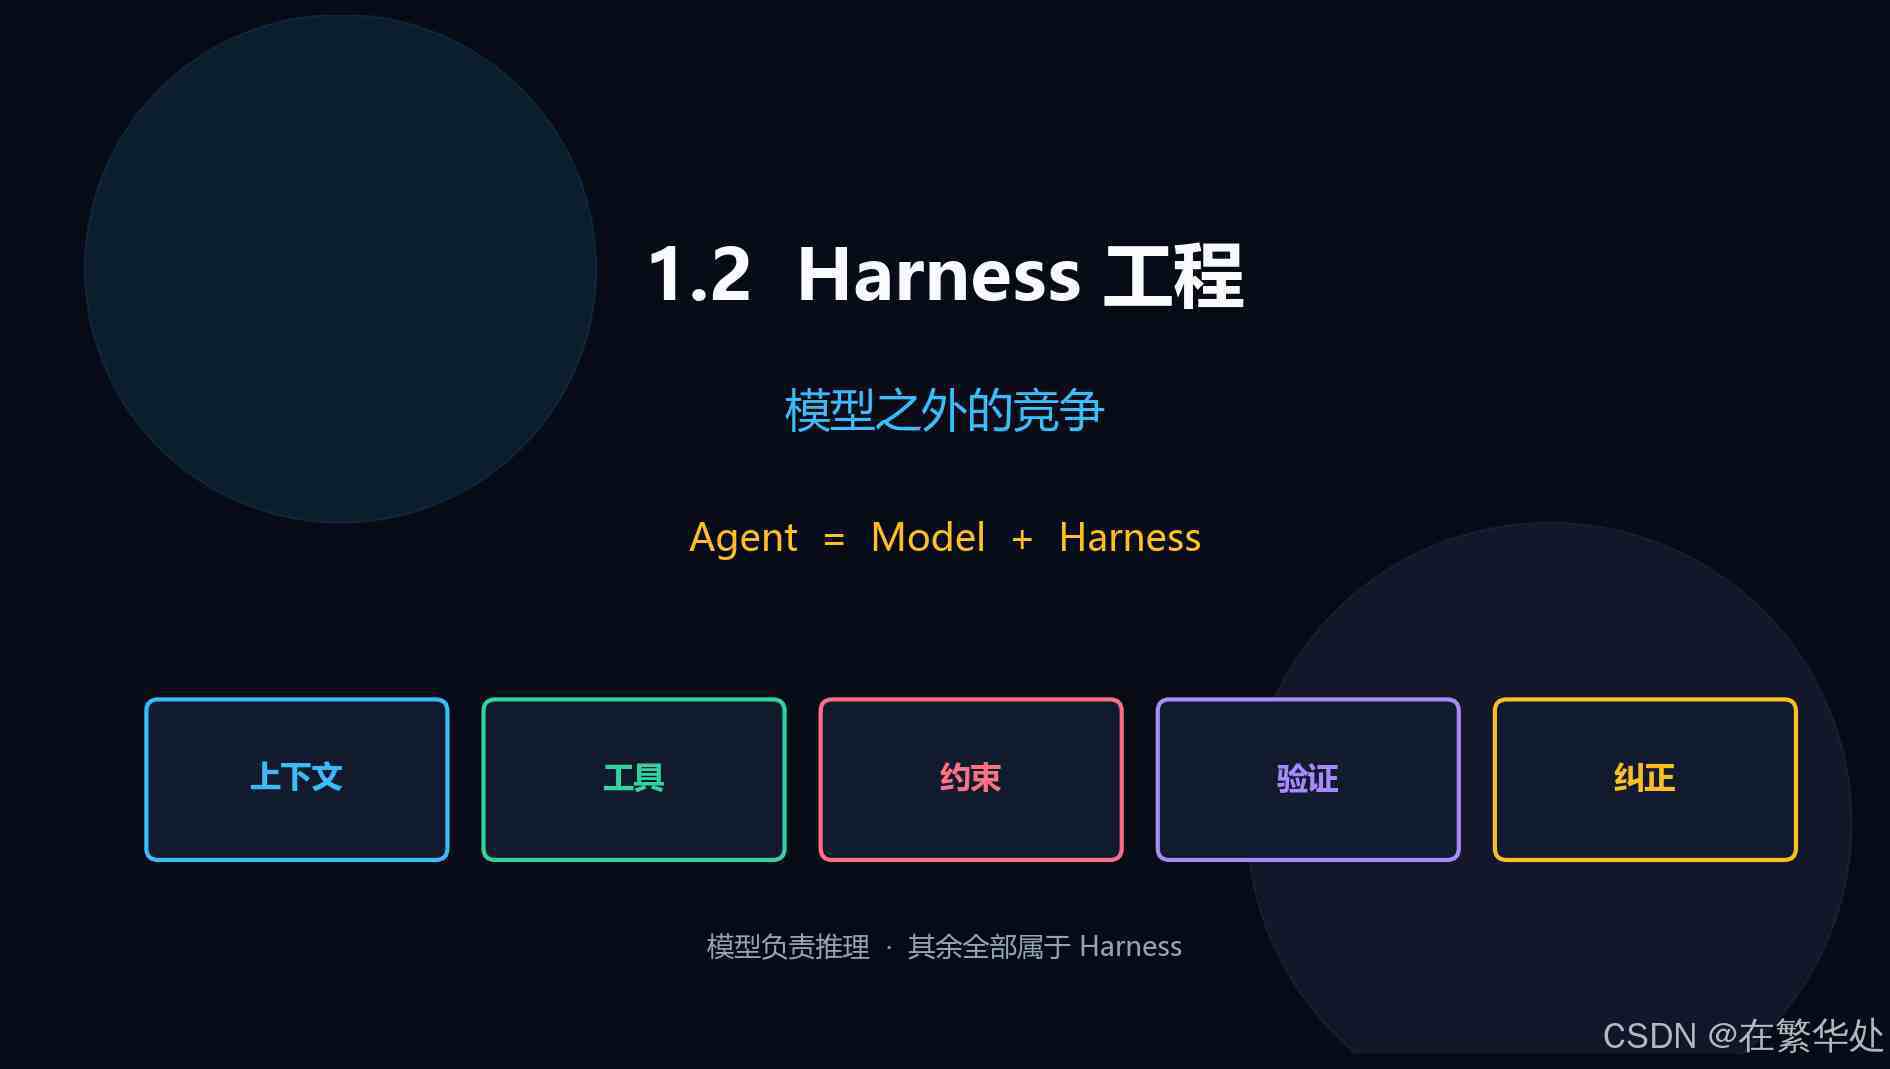
Agent = LLM + {上下文 + 工具 + 约束 + 验证 + 纠正} = Model + Harness
设计和优化这套模型以外的基础设施,就是 Harness 工程。说得更精确一点:模型之外的全部基础设施都属于 Harness。换模型只能换大脑;眼睛看什么、手脚能不能动、边界在哪、做错了谁来发现和收回,都在 Harness 里。
目录
- [1. 先把等式写清楚](#1. 先把等式写清楚)
- [2. 从提示工程到 Loop 工程](#2. 从提示工程到 Loop 工程)
- [3. 五个功能,各管一件事](#3. 五个功能,各管一件事)
- [4. 构建有效 Agent 的三条原则](#4. 构建有效 Agent 的三条原则)
- [5. 三种工作模式,怎么选](#5. 三种工作模式,怎么选)
- [6. 安全是架构问题](#6. 安全是架构问题)
- 参考链接
1. 先把等式写清楚
上一节的等式是 LLM + 上下文 + 工具。这一节把花括号撑开,补上三件模型自己做不到的事:约束、验证、纠正。
| 部分 | 谁负责 | 模型能不能自己搞定 |
|---|---|---|
| LLM | 推理和生成 | 这是模型本身 |
| 上下文 | 这一步能看见什么 | 不能。窗口里有什么,由 Harness 装配 |
| 工具 | 观察和行动的入口 | 不能。模型只能发出调用请求 |
| 约束 | 什么默认不许做 | 不能。边界必须在模型外面生效 |
| 验证 | 这一步对不对 | 不能只听模型说「我做好了」 |
| 纠正 | 错了怎么收回 | 不能把半成品直接丢给用户 |
公开文章里,同一句等式写得很直白。Birgitta Böckeler 在 Martin Fowler 站点把 harness 定义为编码 Agent 里「模型之外的一切」,并分成事前引导和事后传感:Harness engineering for coding agent users。Addy Osmani 用的也是 Agent = Model + Harness :提示、工具、钩子、沙箱、恢复路径都算 Harness,原始模型本身不是 Agent:Agent Harness Engineering。Hugging Face 的术语表把社区里的说法收成一句:你如果不是模型,你就是 Harness:Agent glossary。
笔记用的是宽定义,不是只谈写代码。文件系统、权限、重试、熔断,只要在模型外面,都算。
2. 从提示工程到 Loop 工程
工程范式不是互相替代,而是视野一次比一次宽。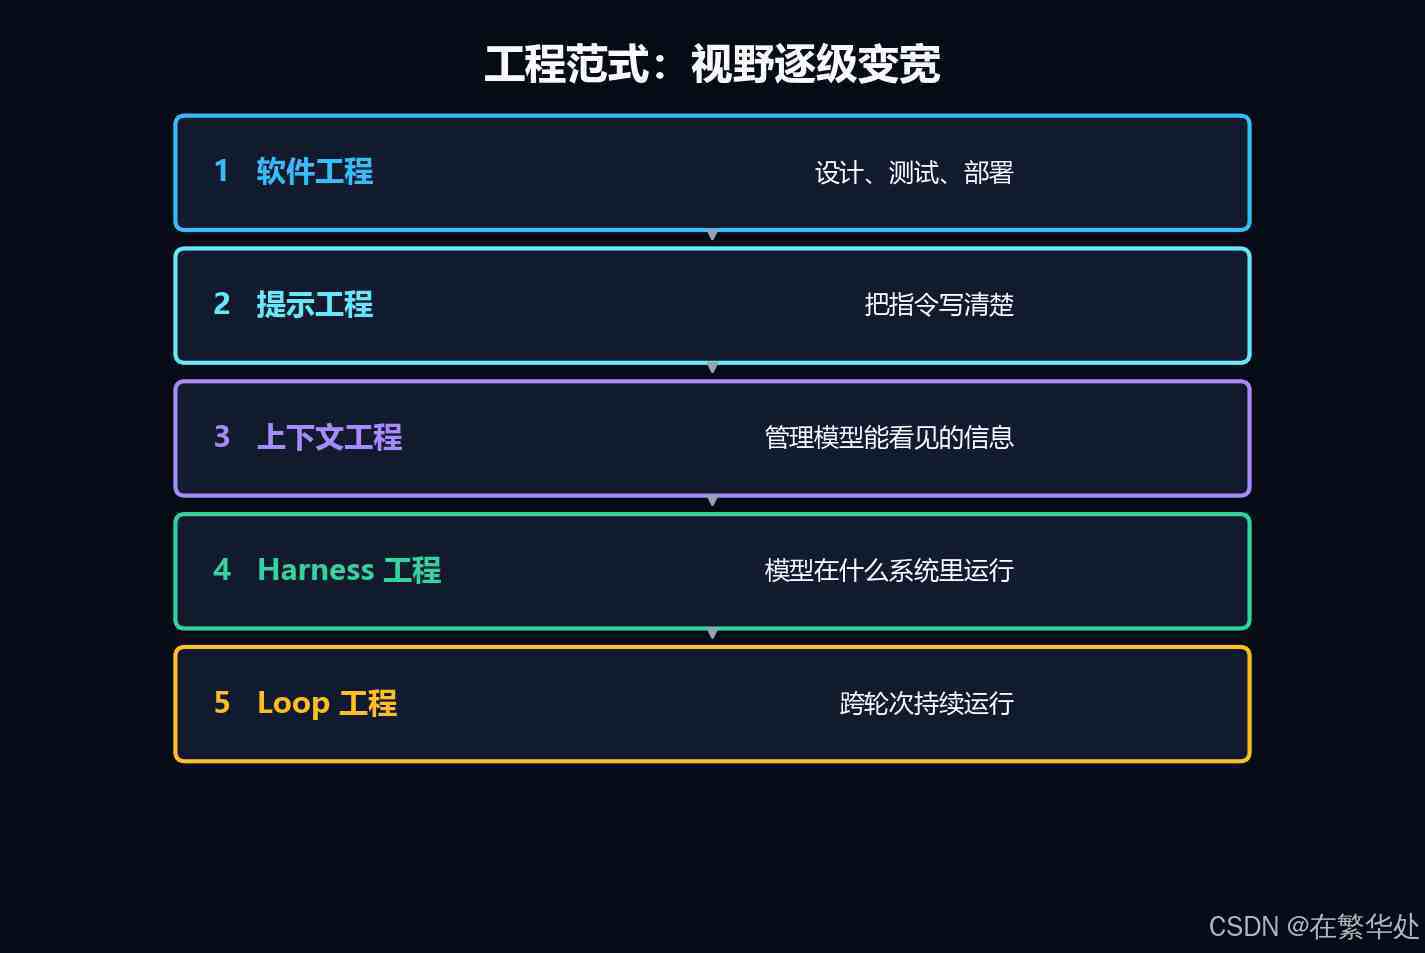
| 阶段 | 视野停在哪 | 我怎么记 |
|---|---|---|
| 软件工程 | 系统怎么设计、测试、部署 | 基础还在,Agent 没有取消它 |
| 提示工程 | 怎么把自然语言指令写清楚 | 第一波。优化的是单次输入 |
| 上下文工程 | 模型这一步能看到的全部信息 | 第二波。只改一句提示词不够 |
| Harness 工程 | 模型在什么样的系统里运行 | 第三波。从「看见什么」扩到「在哪运行」 |
| Loop 工程 | 跨轮次的持续运行 | 第四波。从单次跑完,扩到一轮接一轮 |
提示工程解决「这句话清不清楚」。上下文工程解决「这一步该看见什么」。Harness 工程解决「调用、权限、失败和恢复由谁负责」。Loop 工程再往前一步:系统能不能在没有人每轮踢一脚的情况下继续跑,并且知道何时停。
四层不是后者否定前者。没有软件工程,约束和验证没有地方落地;没有提示词和上下文,Harness 只是空转的循环。
3. 五个功能,各管一件事
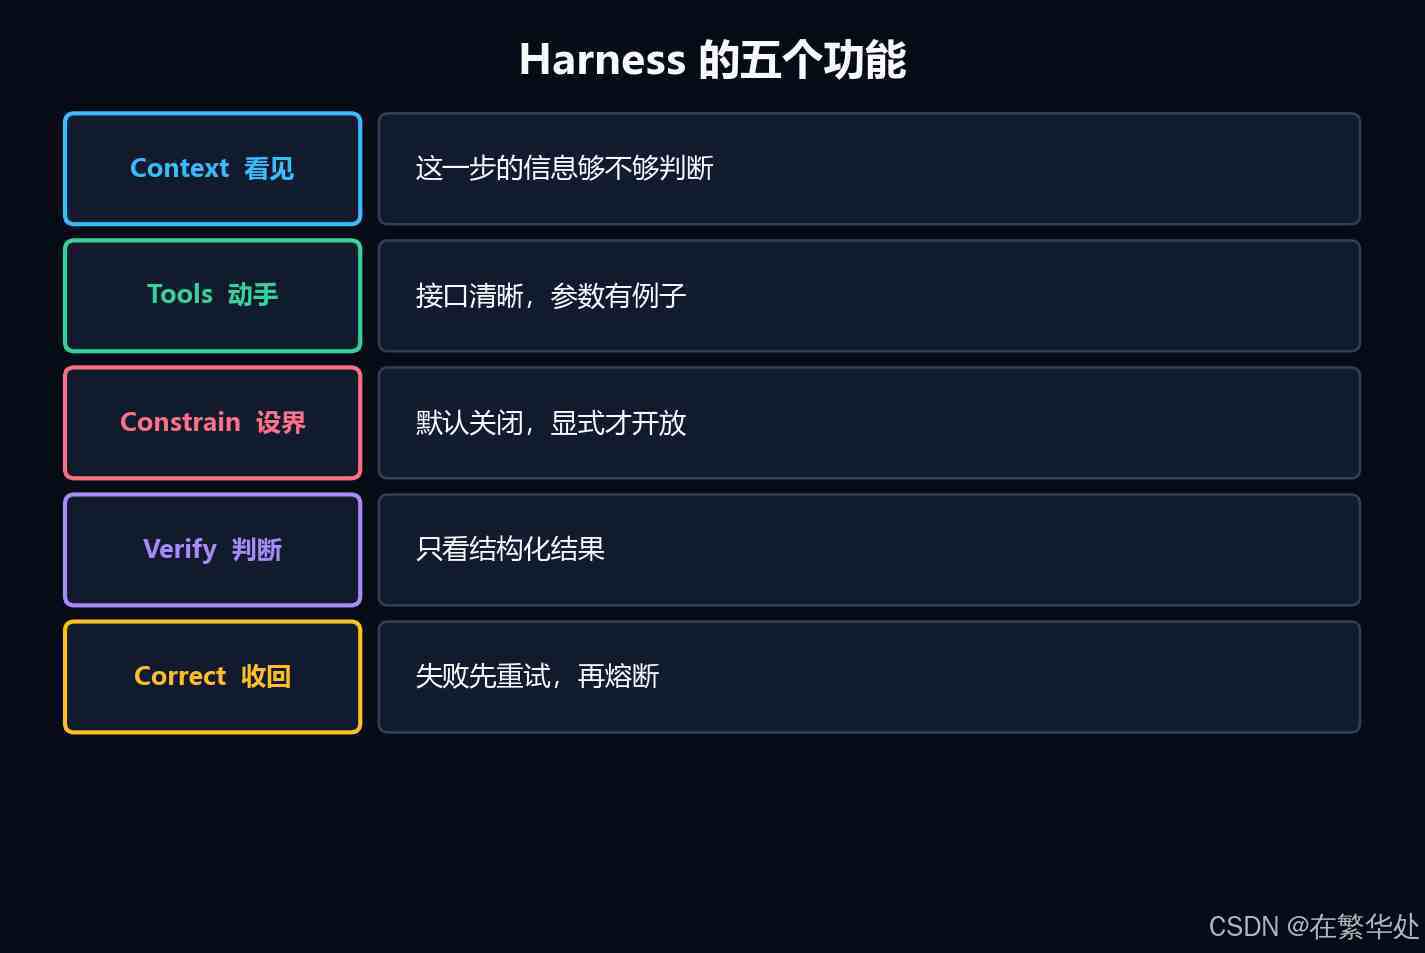
Harness 在笔记里收成五个功能。职责不要混:上下文负责看见,工具负责动手,约束负责边界,验证负责判断对错,纠正负责收回。
| 功能 | 职责与核心原则 | 实际例子 | 详见 |
|---|---|---|---|
| Context(上下文) | 为模型提供充分的感知信息,让 Agent 在每个决策点都能基于足够的信息判断 | 系统提示词、知识库、Agent 状态栏、Sidecar 旁路查询 | 第二、三章 |
| Tools(工具接口) | 提供观察与行动手段。接口要清晰,命名直观,参数有例子,边界有说明 | MCP 工具、代码解释器、搜索工具 | 第四章 |
| Constrain(约束) | 设定行为边界。故障安全默认值:能力默认关闭,必须显式开放,类似手机 App 的权限管理 | 每个工具默认需要用户授权才能执行 | 第四章 |
| Verify(验证) | 自动判断操作结果的对错。安全检查只看结构化数据,例如工具返回的 JSON 字段,不看可能被提示注入操纵的模型自由生成文本 | Linter、类型系统、工具调用结果校验 | 第五、六章 |
| Correct(纠正) | 发现问题后修正或回退。在确认无法恢复之前不暴露中间态:失败时先静默重试,不把半成品展示给用户 | 静默重试、接续生成、连续失败后回到人工判断(熔断) | 第二、五章 |
 下面这段只演示约束、验证、纠正的形状。
call 在真实系统里是一次工具执行,这里不展开某个厂商的 SDK。
python
GRANTED = {"read_file"}  # 没写进名单的工具,默认不能执行

def allow(tool_name: str, granted: set[str]) -> None:
    if tool_name not in granted:
        raise PermissionError(f"未显式开放: {tool_name}")

def verify(result: dict) -> bool:
    # 安全判断只看结构化字段,不看模型生成的解释文字
    return (
        isinstance(result, dict)
        and result.get("ok") is True
        and result.get("exit_code") == 0
    )

def correct(call, retries: int = 2) -> dict:
    last = {"ok": False, "exit_code": 1}
    for _ in range(retries + 1):
        last = call()
        if verify(last):
            return last
return {"status": "needs_human", "last": last}三件事在这十几行里是分开的。allow 在执行前拒绝未开放的工具。verify 不读取「我已经修好了」这种自由文本。correct 在确认无法恢复之前,不把失败的中间结果当成完成。
4. 构建有效 Agent 的三条原则
笔记里的三条,和 Anthropic 在《Building effective agents》里的建议是同一组:
- 保持简单:能用一次模型调用或一条固定路径解决的,不要先上多 Agent。
- 保持透明:规划步骤要看得见,不要只交一个最终结论。
- 设计好工具接口:工具文档和参数边界,值得和提示词花同样的功夫。
原文把第三条叫作 Agent--computer interface:名称、例子、边界写清楚,模型才不容易用错。Building effective agents
简单不是简陋。五个功能可以都在,但每一轮只保留完成这一步所必需的上下文和工具。透明也不是把内部思考原样贴给用户,而是失败、重试和熔断在轨迹里查得到。
5. 三种工作模式,怎么选
编排、工作流、自主 Agent,不是三个互相打架的产品名。编排说的是组织方式;后两个说的是路径由谁决定。
- 编排模式:在上下文和工具这一层决定执行路径。路径可以预先写死,也可以留给模型动态生成。它回答的是「谁来排程」,不是某一种固定流程图。
- 工作流模式:用预定义的代码路径编排 LLM 和工具。优势是流程控制和安全边界清楚。局限是缺少变通,输入一偏离预设,路径就不会自己改。
- 自主 Agent:根据环境反馈和任务,动态调整执行路径。模型保持对「下一步做什么」的控制。
Anthropic 的划分和后两条对齐:工作流是代码把模型和工具编排好;Agent 是模型自己决定过程和工具用法。他们也写了选择标准:任务边界清楚、要稳定,用工作流;需要临场判断,再用 Agent。很多应用连 Agent 都不需要,把单次调用和检索做好就够。
笔记里的选择不是非此即彼,而是混合。固定的门禁、权限和校验放在工作流里;只有真正无法事先写死的那几步,交给自主循环。
python
def workflow(steps, context):
    """路径事先写死。每步可以有门禁,但不能临场改路线。"""
    for step in steps:
        context = step.run(context)
        if not step.gate(context):
            return "stopped", context
    return "done", context

def agent_loop(model, context, limit=8):
    """路径由模型根据观察决定。步数上限是约束,不是建议。"""
    for _ in range(limit):
        decision = model(context)
        if not decision.tool_calls:
            return decision.text, context
        allow(decision.tool_calls[0].name, GRANTED)
        observed = execute(decision.tool_calls[0])
        if not verify(observed):
            observed = correct(lambda: execute(decision.tool_calls[0]))
        context.append({"role": "tool", "content": observed})
    return "step_limit", context
混合的常见接法:外层用 workflow 固定「先取数、再校验、再写回」;中间某一步发现分支无法预写,才进入 agent_loop。循环出来的结果,仍然要过外层的 verify,不能因为是模型决定的路径就免检。
6. 安全是架构问题
安全从第一行代码就要考虑,而不是上线前再补。护栏按防护落点分成三层,后文的安全讨论都挂在这个骨架上。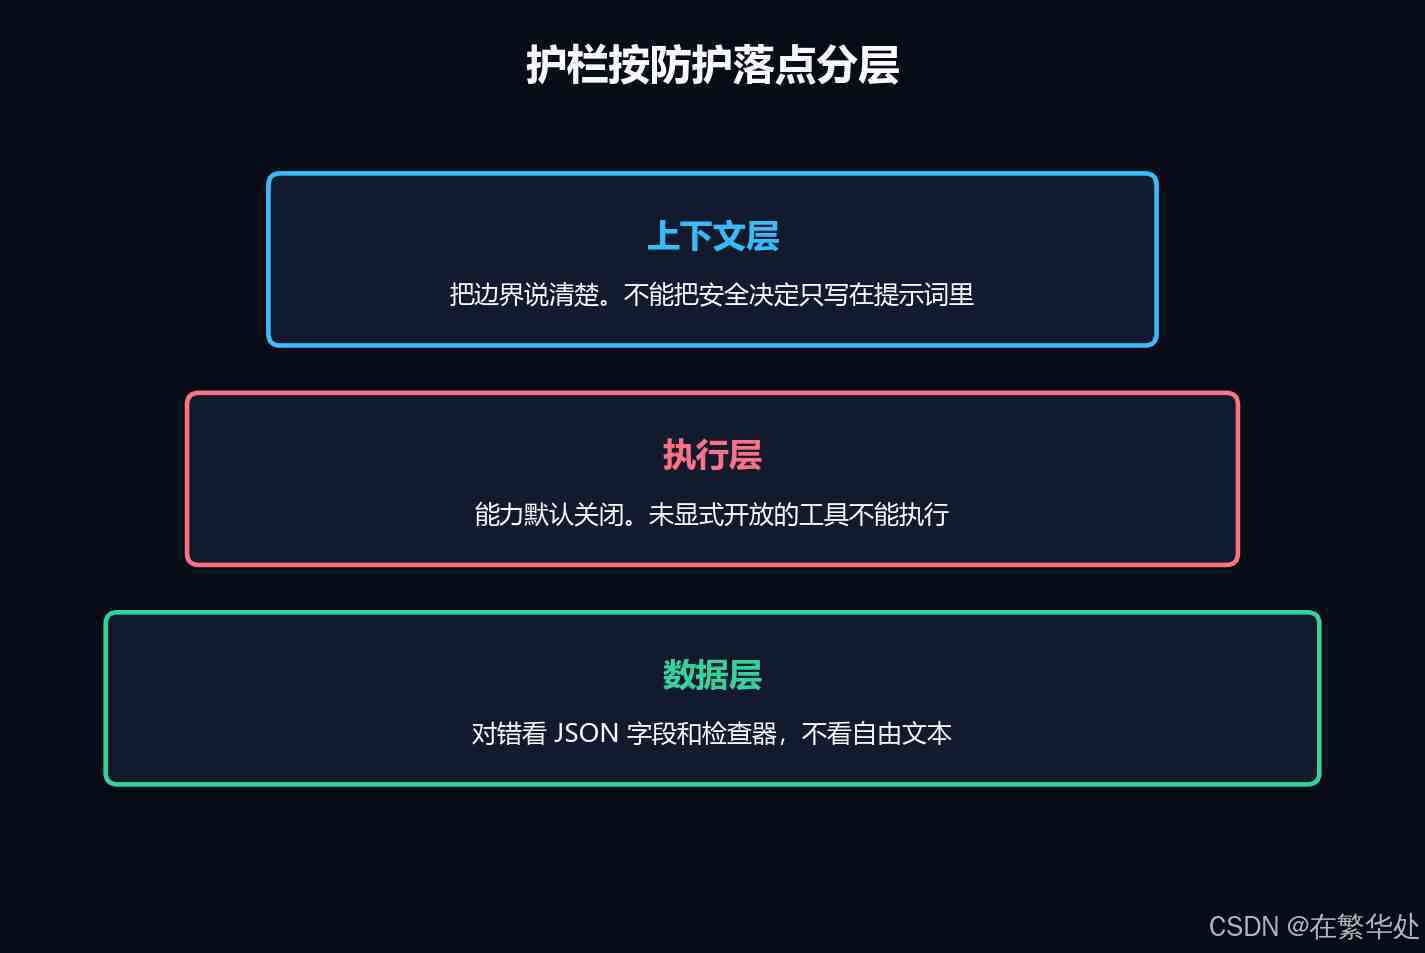
| 层 | 落在哪 | 为什么不能只靠它 |
|---|---|---|
| 上下文层 | 系统提示词、工具说明、行为准则 | 它告诉模型「不要做什么」,但安全决定若只写在这里,会被后续文本改写 |
| 执行层 | 工具是否开放、默认授权、沙箱 | 未显式开放的能力根本执行不了。这是权限,不是一句劝告 |
| 数据层 | 结构化结果、类型、Linter、状态字段 | 对错看 JSON 字段和检查器输出,不看模型生成的自由文本 |
三层要同时在,但硬度不同。上下文层负责把边界说清楚,方便模型少犯错。执行层负责默认关闭。数据层负责不相信「看起来像成功」的句子。提示注入能操纵的是模型生成的文字;所以验证函数读的是 ok、exit_code 这种字段,不是模型事后补的解释。
纠正也挂在这三层上。一次失败先静默重试,不把半成品展示出来。连续失败就熔断,回到人工判断。熔断是架构的一部分,不是上线后才想起的补丁。