💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
目录
- 基于大数据的高频电力消耗数据可视化与分析介绍
- 基于大数据的高频电力消耗数据可视化与分析演示视频
- 基于大数据的高频电力消耗数据可视化与分析演示图片
- 基于大数据的高频电力消耗数据可视化与分析代码展示
- 基于大数据的高频电力消耗数据可视化与分析文档展示
基于大数据的高频电力消耗数据可视化与分析介绍
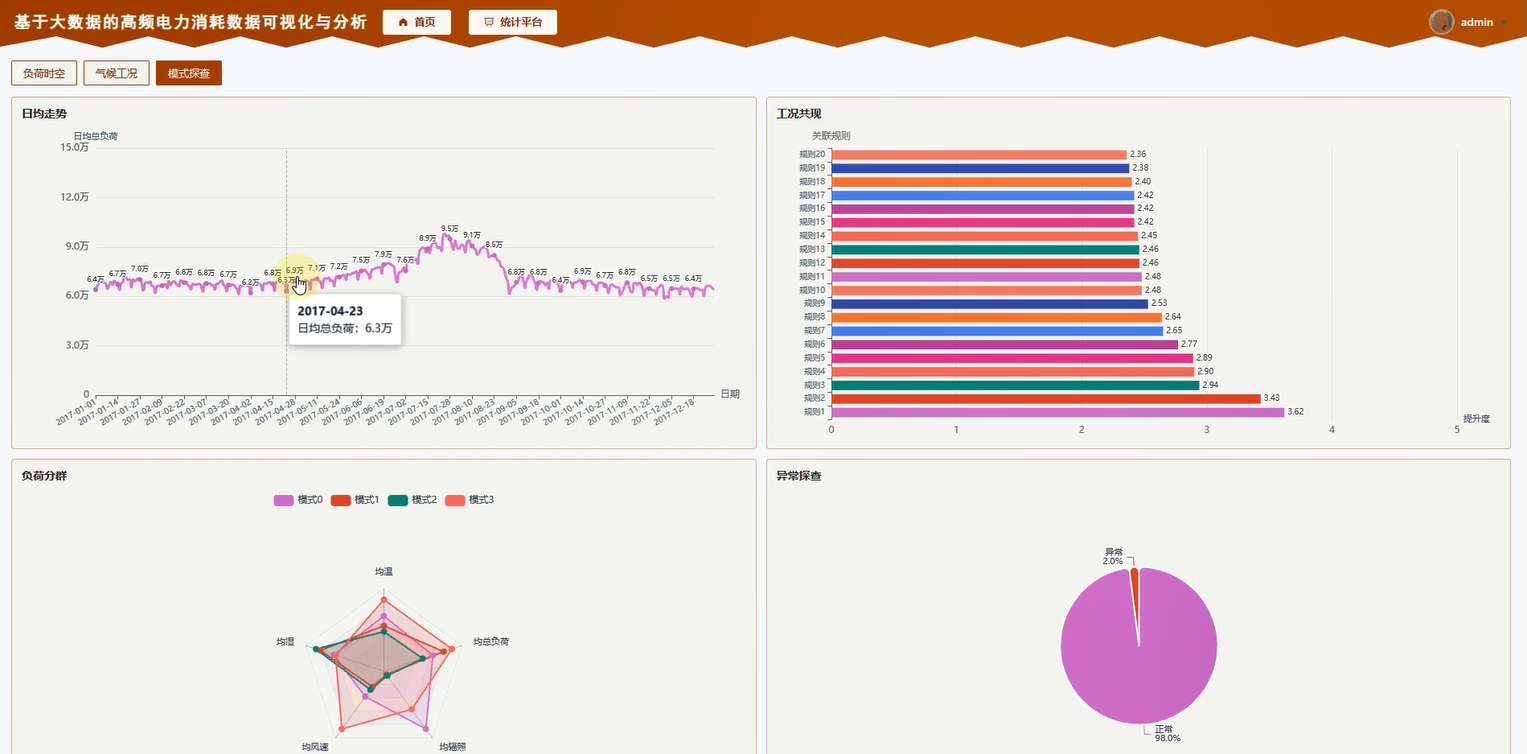
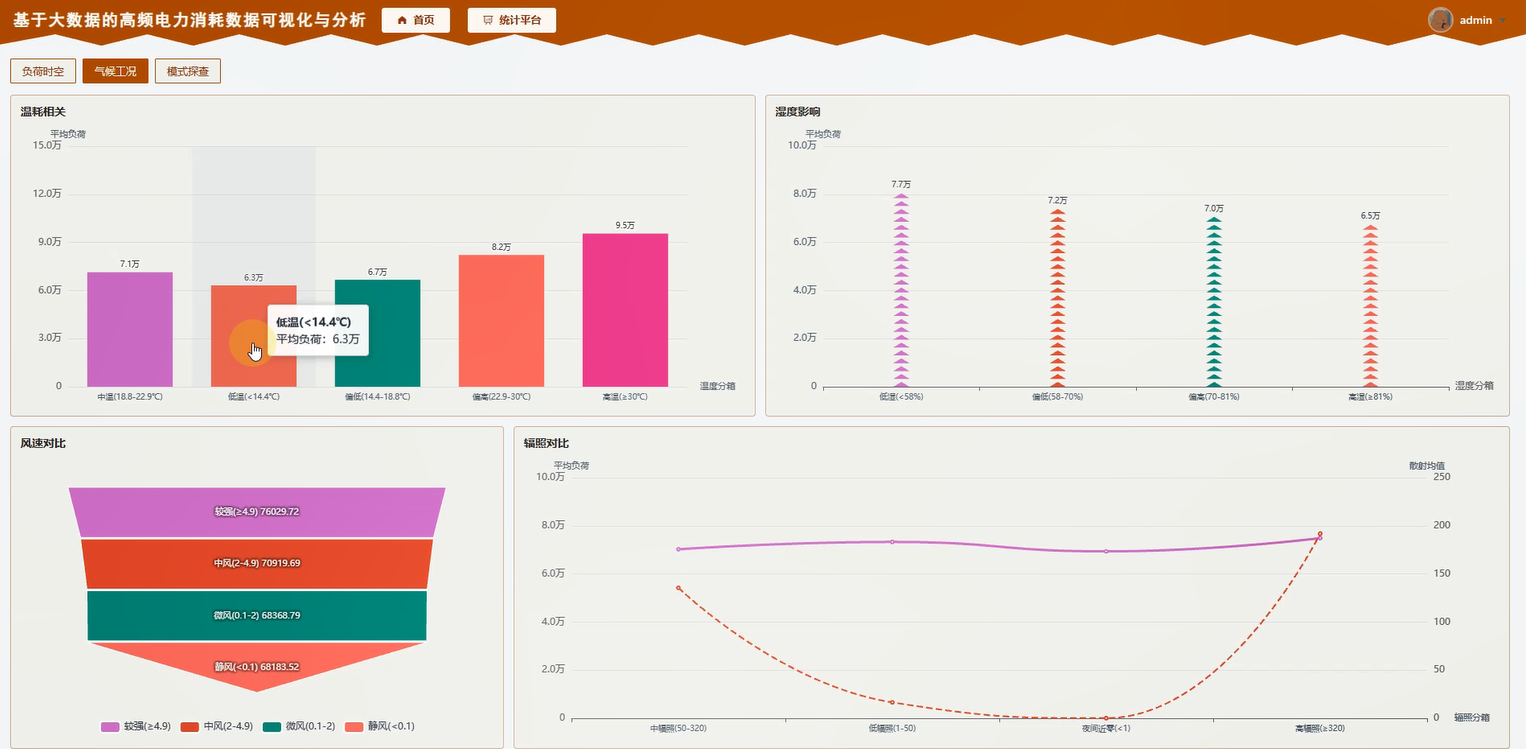
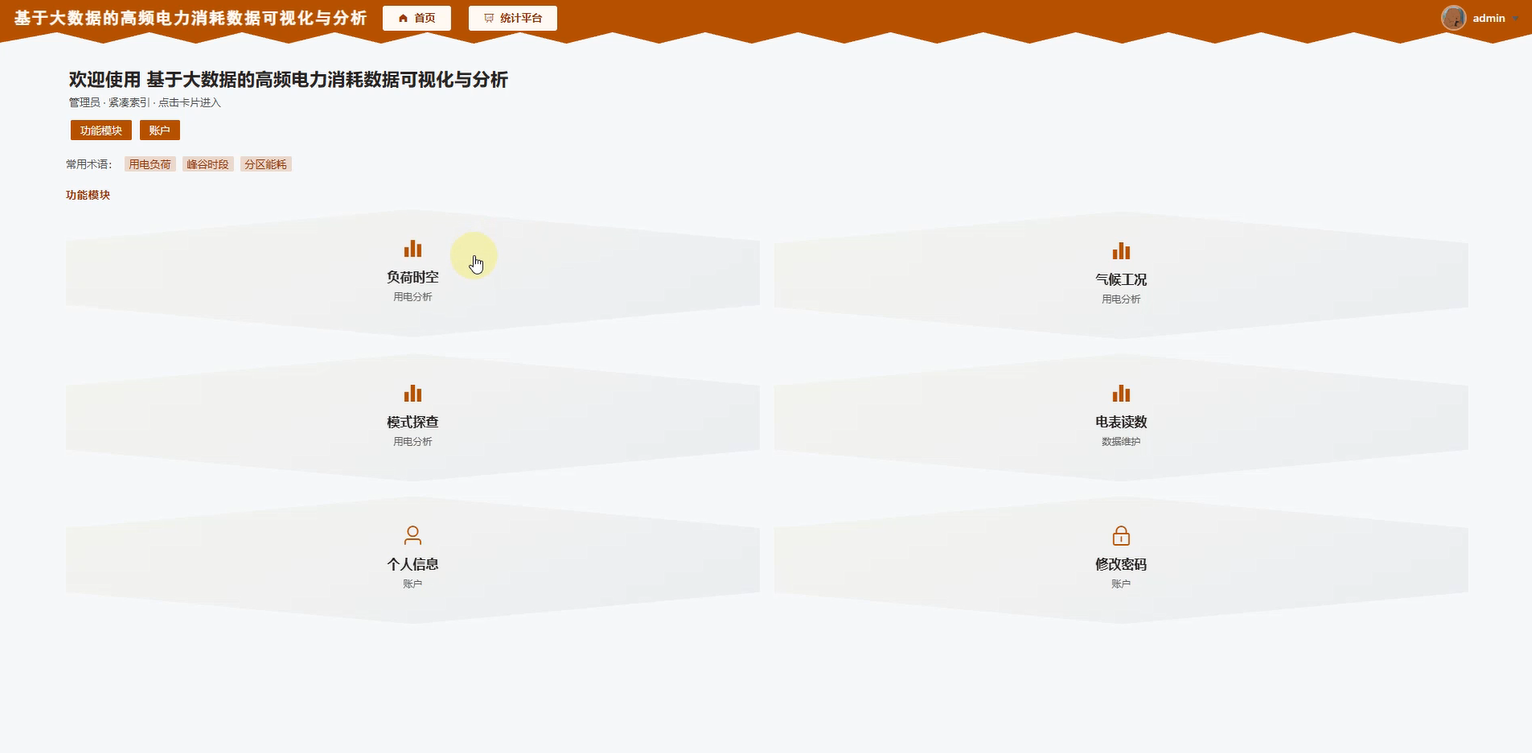
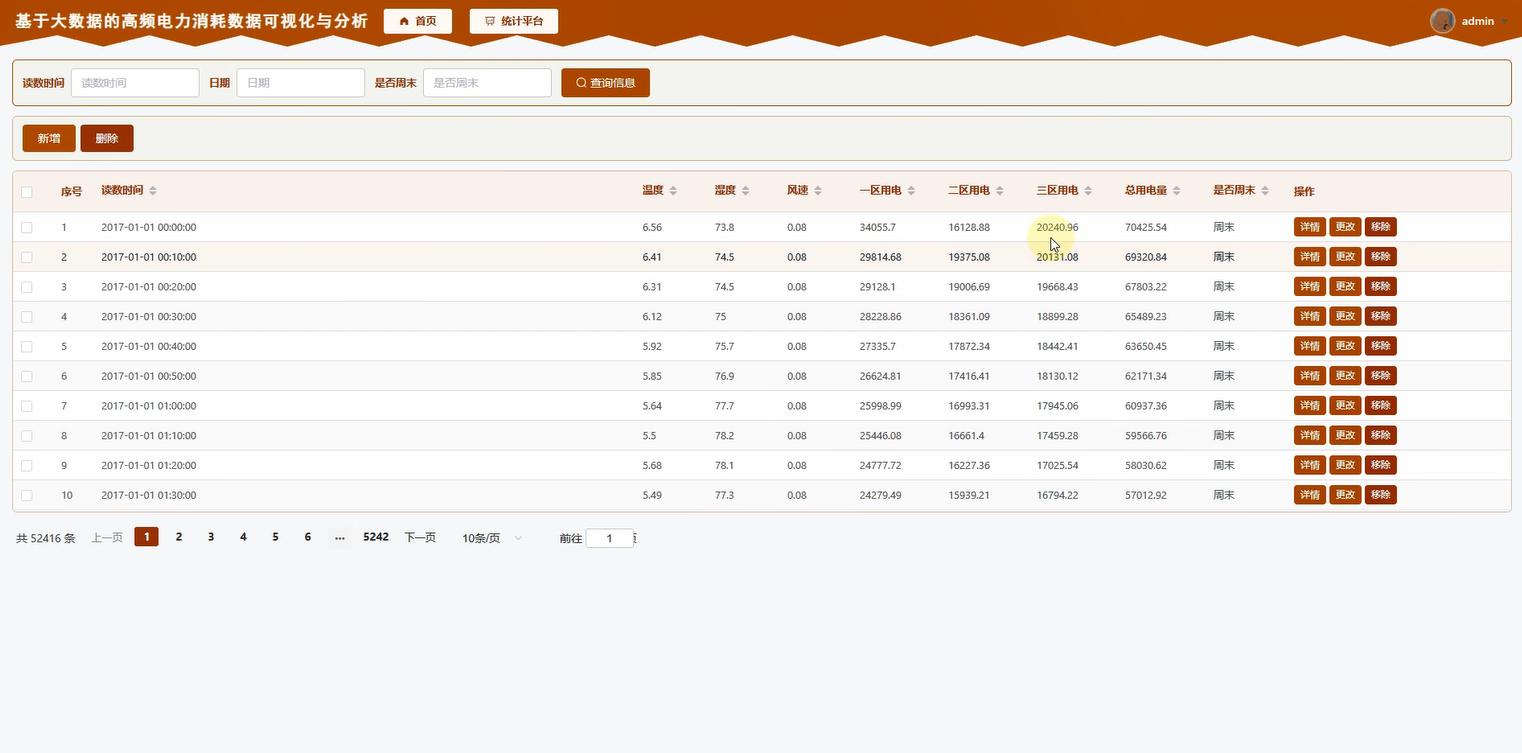
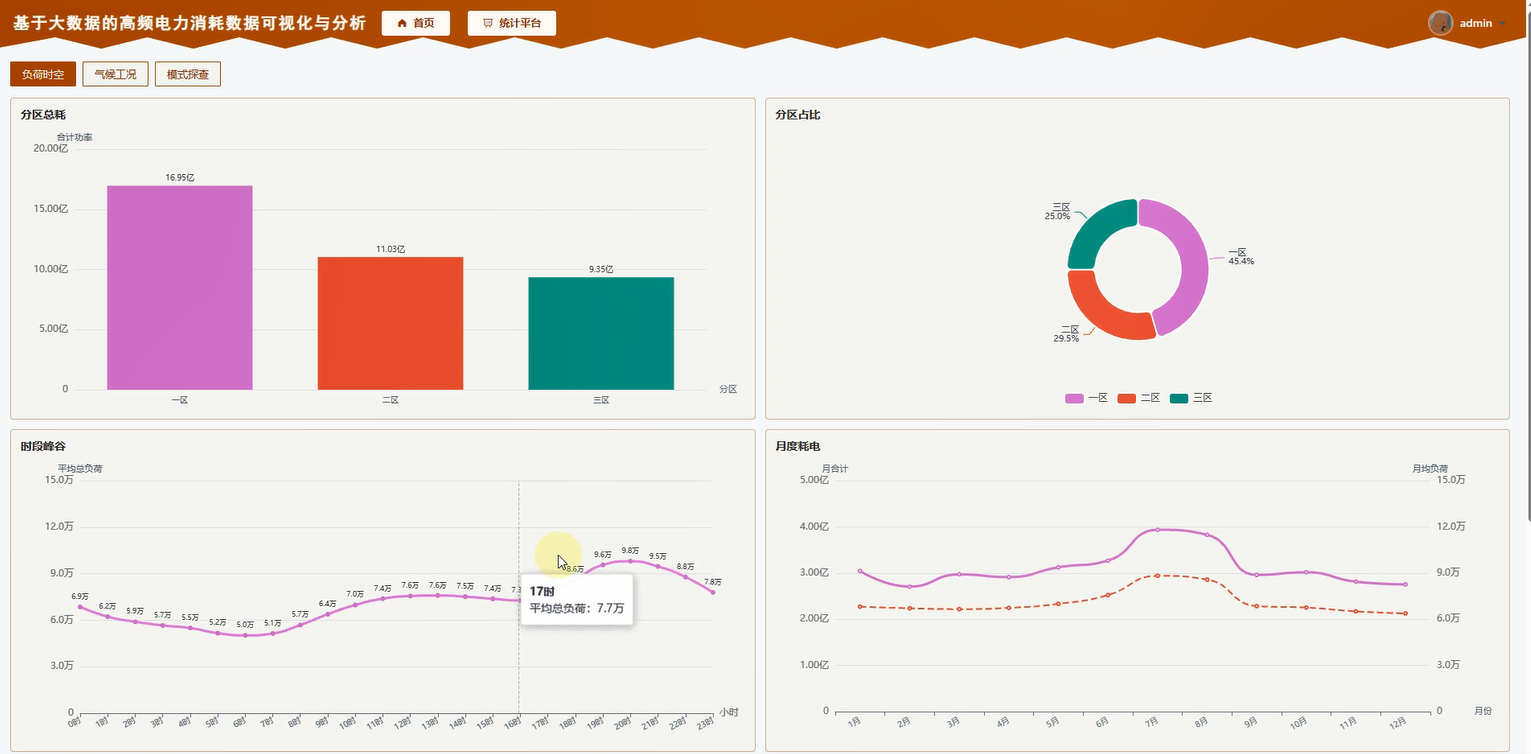
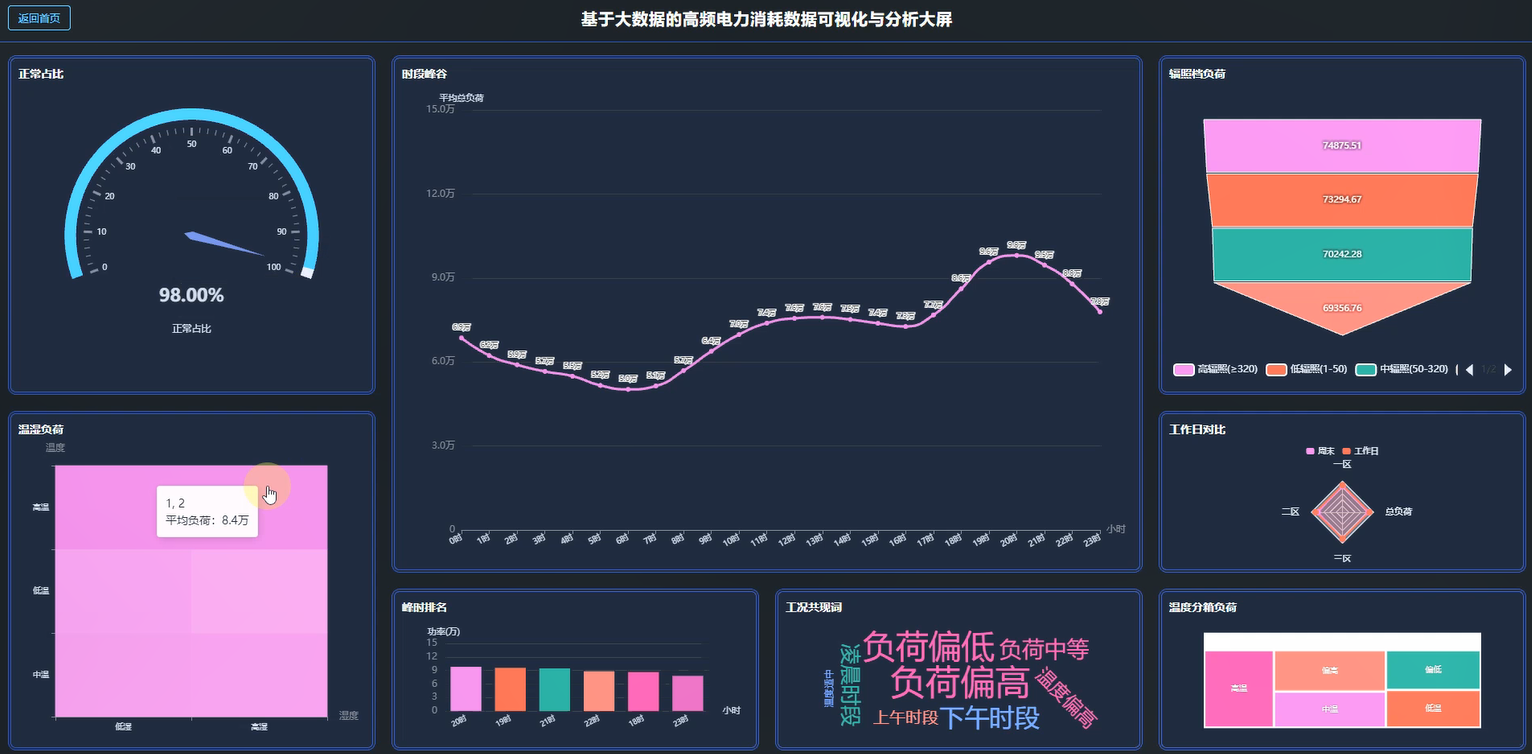
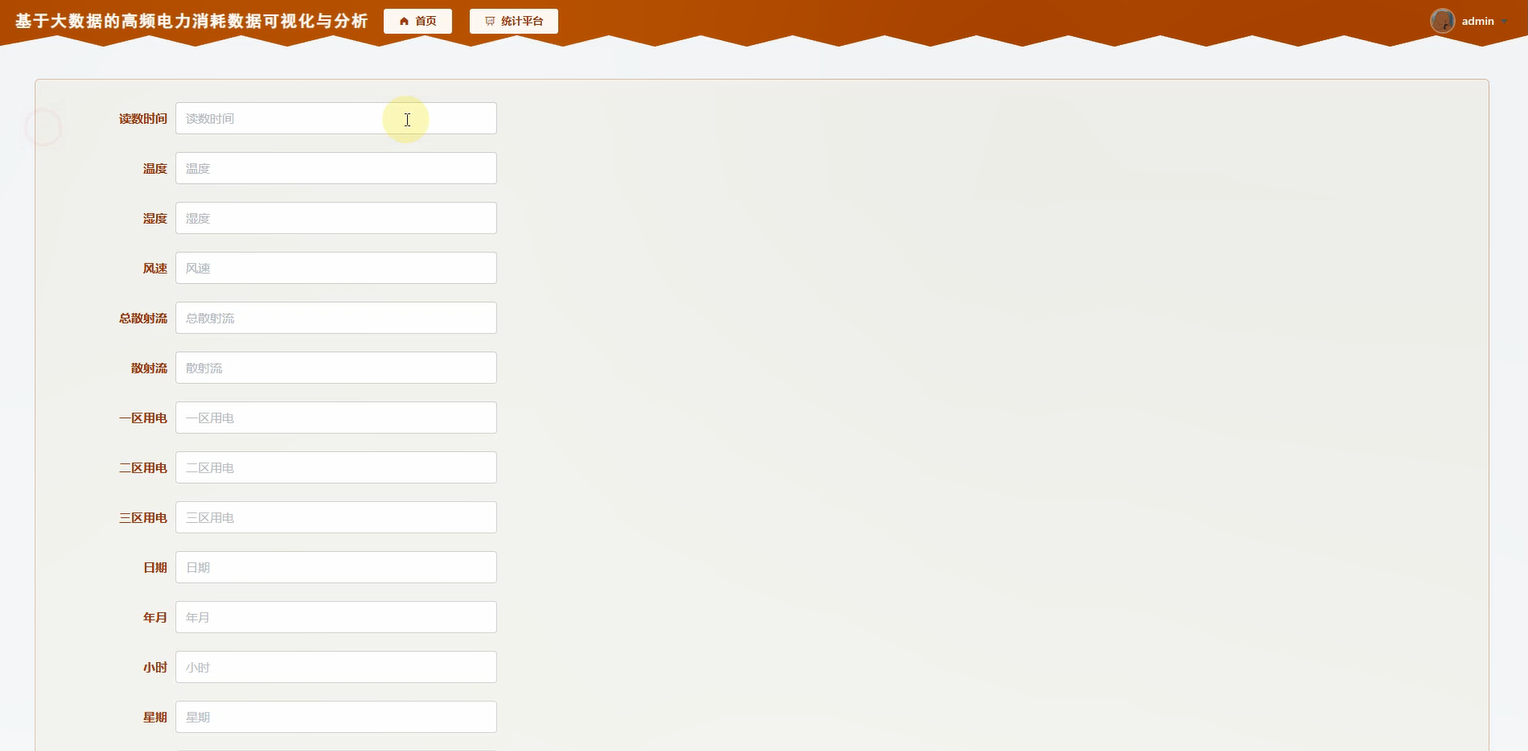
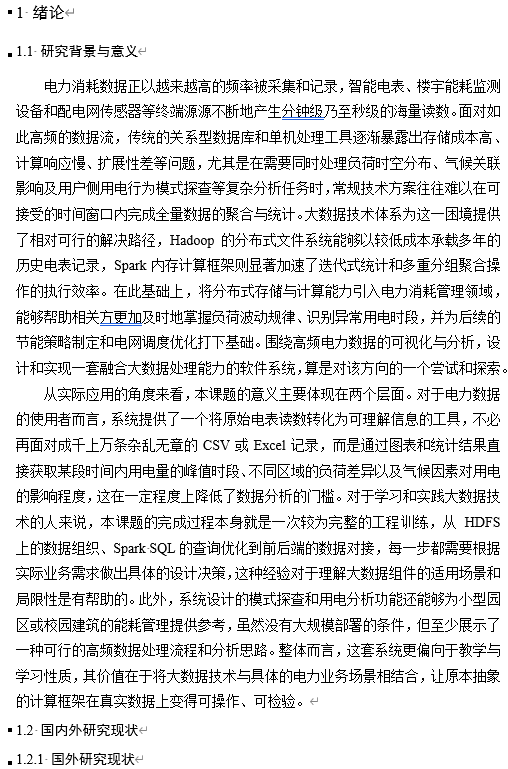
本系统《基于大数据的高频电力消耗数据可视化与分析》面向电力行业中海量高频用电数据的存储、计算与展示需求,以Hadoop分布式文件系统(HDFS)作为底层数据存储底座,承担原始电表读数、气候工况记录及负荷时空相关日志的持久化保存职责。系统在计算层面采用Spark作为核心分析引擎,利用Spark SQL对结构化用电数据进行聚合、过滤与多维度统计,并结合Pandas与NumPy进行辅助的数据清洗与格式转换,以支撑"负荷时空"、"用电分析"、"模式探查"等业务模块的高效运算。后端服务同时支持Django与Spring Boot双版本,前端基于Vue框架配合ElementUI、Echarts及原生JavaScript完成交互界面与可视化图表的渲染,使得经Spark处理后的聚合结果能够以折线图、柱状图、热力图等形式直观呈现给用户。系统内置账户管理、个人信息维护、密码修改及数据维护等基础功能,确保用户能够在安全可控的环境下对高频电力数据进行持续的探查、分析与管理,最终为电力消耗的模式识别与异常发现提供可直接操作的软件工具支撑。
基于大数据的高频电力消耗数据可视化与分析演示视频
基于大数据的高频电力消耗数据可视化与分析演示图片
基于大数据的高频电力消耗数据可视化与分析代码展示
python
SparkSession spark = SparkSession.builder().appName("PowerDataAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "8").getOrCreate();
Dataset<Row> meterDF = spark.read().option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/data/meter_readings/*.csv");
Dataset<Row> climateDF = spark.read().option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/data/climate_conditions/*.csv");
Dataset<Row> joinedDF = meterDF.join(climateDF, meterDF.col("record_time").equalTo(climateDF.col("time_point")), "left");
Dataset<Row> aggregatedDF = joinedDF.groupBy("region_id", "date_format(record_time, 'yyyy-MM-dd') as stat_date").agg(functions.sum("power_consumption").alias("total_power"), functions.avg("power_consumption").alias("avg_power"), functions.max("power_consumption").alias("peak_power"));
Dataset<Row> filteredDF = aggregatedDF.filter(aggregatedDF.col("total_power").gt(1000));
Dataset<Row> sortedDF = filteredDF.orderBy(filteredDF.col("stat_date").desc());
List<Row> resultList = sortedDF.collectAsList();
for (Row row : resultList) { System.out.println(row.mkString(", ")); }
Dataset<Row> pivotDF = joinedDF.groupBy("region_id", "hour(record_time) as hour_of_day").pivot("weekday").agg(functions.avg("power_consumption"));
Dataset<Row> anomalyDF = joinedDF.groupBy("meter_id").agg(functions.avg("power_consumption").alias("avg_consume"), functions.stddev("power_consumption").alias("std_consume"));
Dataset<Row> anomalyFlagged = anomalyDF.withColumn("anomaly_threshold_high", functions.col("avg_consume").plus(functions.col("std_consume").multiply(2))).withColumn("anomaly_threshold_low", functions.col("avg_consume").minus(functions.col("std_consume").multiply(2)));
Dataset<Row> dailyProfile = joinedDF.groupBy("meter_id", "date_format(record_time, 'HH') as hour_slot").agg(functions.avg("power_consumption").alias("hourly_avg"));
Dataset<Row> climateImpact = joinedDF.groupBy("weather_type").agg(functions.avg("power_consumption").alias("avg_under_weather"), functions.count("record_time").alias("sample_count"));
Dataset<Row> topConsumers = joinedDF.groupBy("user_id").agg(functions.sum("power_consumption").alias("total_used")).orderBy(functions.col("total_used").desc()).limit(10);
Dataset<Row> timeSeriesDF = joinedDF.select("record_time", "power_consumption", "region_id").where("region_id = 'R001'").orderBy("record_time");
List<Row> timeSeriesList = timeSeriesDF.collectAsList();
for (Row r : timeSeriesList) { System.out.println(r.getTimestamp(0) + " -> " + r.getDouble(1)); }
Dataset<Row> loadFactorDF = joinedDF.groupBy("region_id", "date_format(record_time, 'yyyy-MM') as month").agg(functions.max("power_consumption").alias("peak_monthly"), functions.avg("power_consumption").alias("avg_monthly")).withColumn("load_factor", functions.col("avg_monthly").divide(functions.col("peak_monthly")));
Dataset<Row> weekendCompare = joinedDF.withColumn("is_weekend", functions.when(functions.dayofweek(functions.col("record_time")).isin(1, 7), "weekend").otherwise("weekday")).groupBy("region_id", "is_weekend").agg(functions.avg("power_consumption").alias("avg_power_by_type"));
Dataset<Row> correlationDF = joinedDF.select("temperature", "humidity", "power_consumption").stat().corr("temperature", "power_consumption").alias("temp_power_corr");
Dataset<Row> hourlyRank = joinedDF.groupBy("date_format(record_time, 'HH') as hour").agg(functions.sum("power_consumption").alias("total_hourly")).orderBy(functions.col("total_hourly").desc());
Dataset<Row> regionSummary = joinedDF.groupBy("region_id").agg(functions.count("meter_id").alias("meter_count"), functions.sum("power_consumption").alias("region_total"), functions.avg("power_consumption").alias("region_avg"));
Dataset<Row> exportDF = joinedDF.groupBy("record_time", "region_id").agg(functions.sum("power_consumption").alias("agg_power")).filter("agg_power > 500");
exportDF.write().mode("overwrite").csv("hdfs://localhost:9000/output/aggregated_results");
spark.stop();
基于大数据的高频电力消耗数据可视化与分析文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜